[2026-09-01] HarnessDev: Can LLMs Create and Evolve Their Own Agent Harness?
模型先编写一套能调用工具、修改文件和检查结果的 Agent 程序,再根据执行反馈继续改进。本文说明开发与隐藏评测的边界、真实失败案例、跨模型迁移,以及 2,207 个下游实例上的结果。
模型先编写一套能调用工具、修改文件和检查结果的 Agent 程序,再根据执行反馈继续改进。本文说明开发与隐藏评测的边界、真实失败案例、跨模型迁移,以及 2,207 个下游实例上的结果。
Agent 一边操作原软件弄清行为,一边写代码复刻,再运行自己的版本检查差异。本文用 Logbert 固定日志案例说明任务与隐藏测试的来源、两种评分通道、五平台结果和训练迁移。
让 Claude Code 读取历次候选的代码、分数与执行记录,改进包在模型外的运行程序。本文说明搜索过程、真实样例的判分,以及分类、数学和终端实验各自能证明什么。
同一批编程执行记录,按接口分别比较成绩,或把同题不同接口的成绩合起来比较:两种训练都只有小幅提升,评测接口带来的差异更大;换到未见接口后,谁更好仍没有稳定证据。
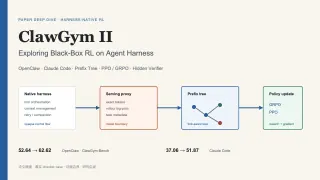
ClawGym II 保留 Claude Code 和 OpenClaw 的工具执行流程,通过模型调用记录和任务评分训练模型。本文解释分支怎样恢复、哪些生成不参与训练,并实际运行公开周报任务的检查程序,核对评分与实…
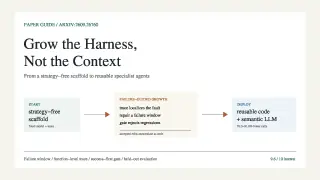
从空程序起步,把失败任务暴露出的重复处理步骤写进代码,供后续任务复用。用论文的 Repair 31 案例说明怎样找出错误、修改函数和验收,并核对成功率与成本的计算范围。
先为弱模型调整提示、工具和运行时检查,再让它完整模仿强模型,成绩反而下降。本文沿着两条真实失败记录,解释为何改用学生自己的执行记录,只修错误发生的那一轮,并核对数据和实验限制。
RIVER 先检查任务说明、容器和测试程序是否一致,再让强模型各试两次,从原训练集筛出约 3.5K 个环境。两条真实误判记录说明答案泄漏和脆弱测试怎样带偏训练,以及重复操作的扣分加在何处。
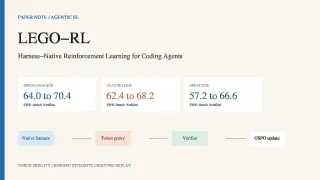
LEGO-RL 保留 Claude Code 等编码助手原有的执行流程,记录模型实际生成的内容,再按隐藏测试结果训练模型。用真实进度条修复任务讲清生成记录、任务筛选、评分和训练更新,并区分验证集最高分与最后一次验证。
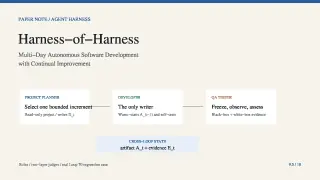
让现成编码助手反复规划、开发和独立测试同一个项目,保留代码与对应版本的验证记录。结合真实第 70 轮失败记录,核对方法、评分、成本,以及论文设计与公开实现的差别。