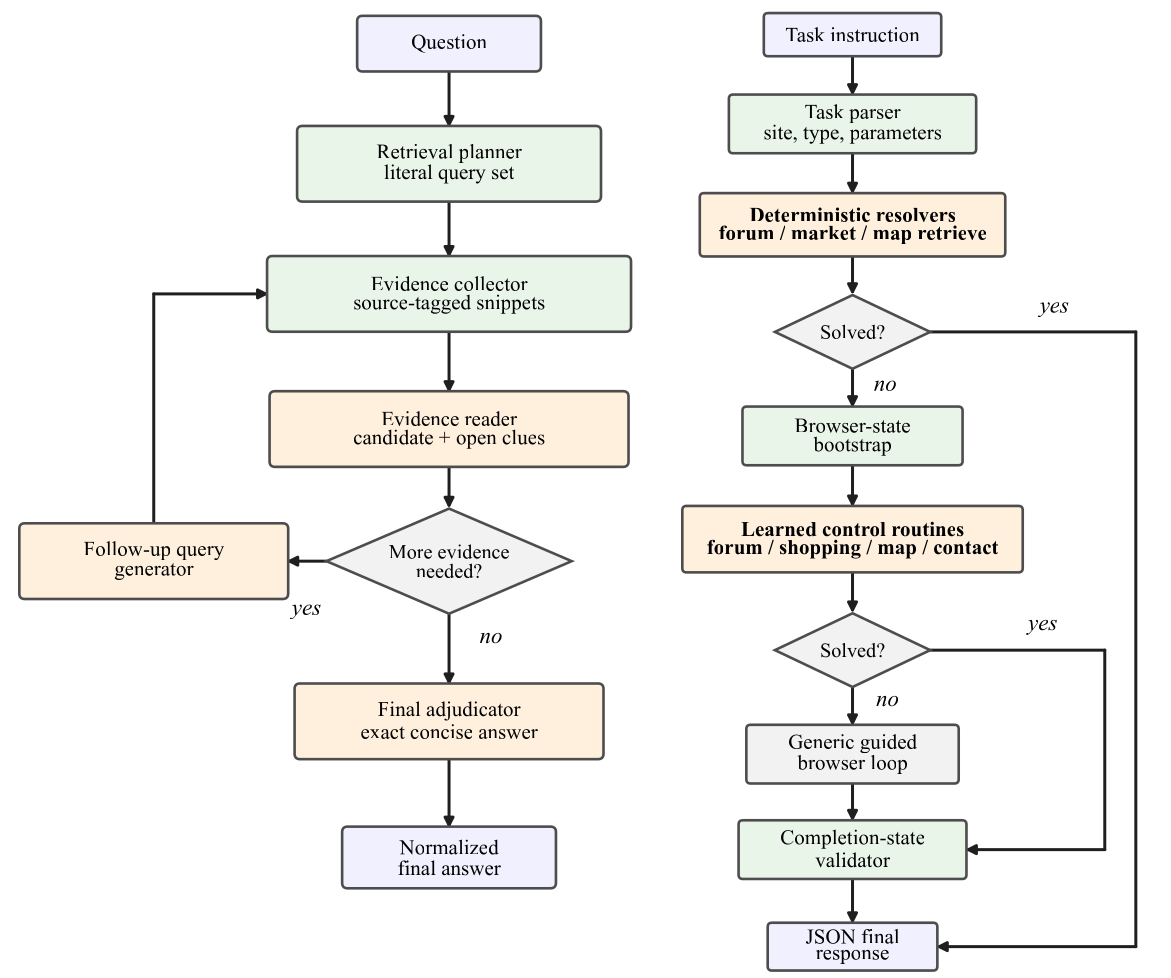
很多 agent harness 把搜索、重试、验证和停止都交给 LLM。即使连续处理的是同一类任务,模型仍要在每次任务的执行中重新做这些控制判断。Growing Harness 从一个几乎为空的起始程序开始,根据实际失败记录改执行程序,把解析、重试、预算检查等重复逻辑写进代码,理解网页和形成答案仍由模型完成。
1. Motivation:重复控制为什么应跨任务保留在程序里?
因为同类任务反复需要相似的控制,而当前上下文不会自动保留到下一道题。 普通 Tool-Calling agent 每一步都把历史交给模型,让它再次决定搜索什么、是否继续、怎样恢复错误。这样做很灵活,但模型调用、输入 token 和上下文压力都会随执行记录增长。
作者提出三个具体要求。第一,训练任务上学到的行为要能复用于同分布的新任务;第二,重复控制要从在线推理移到低成本代码,语义判断仍由 LLM 处理;第三,起点不应预设完整控制流程,否则最后得到的结构可能只是手工模板的小修小补。
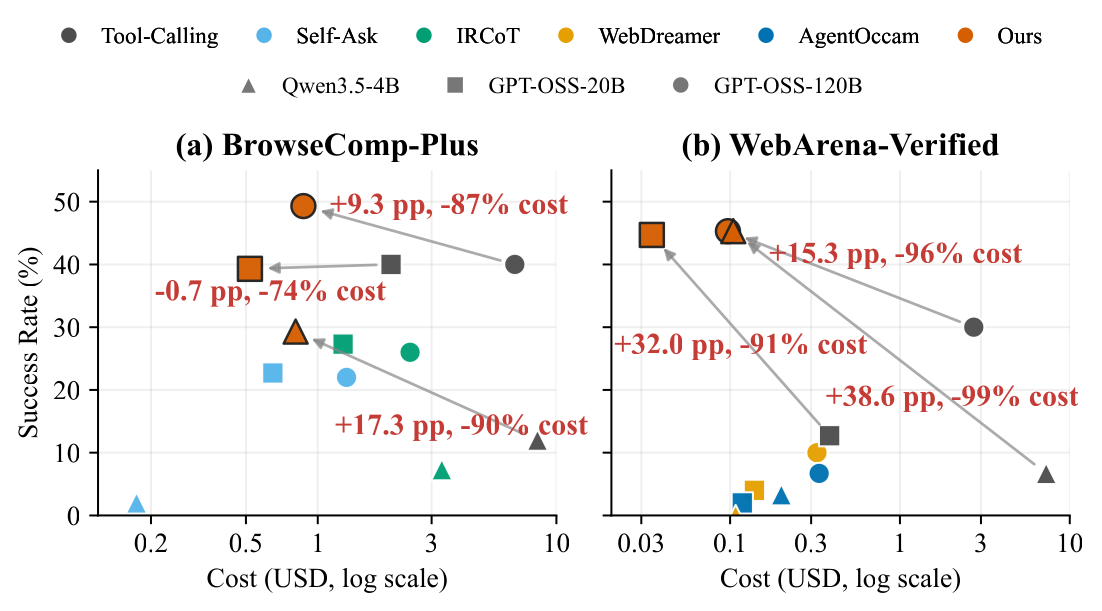
这项工作的目标不是让一个 harness 适配所有问题。作者为 BrowseComp-Plus 和 WebArena-Verified 分别训练一套专门的执行程序;复用范围是同类的新任务。
2. Related Work:与工作流搜索、技能库、记忆和其他执行程序优化的区别
最清楚的比较轴是:训练后到底留下什么,以及部署时还要让 LLM 做多少控制。
展开:相关路线的逐项对照
| 路线 | 持续积累的对象 | 部署时怎样运行 | 与 Growing Harness 的边界 |
|---|---|---|---|
| ReAct / Self-Ask / IRCoT | 固定交互循环与当前任务历史 | LLM 在线重做大部分控制判断 | 本文把跨任务重复的控制写成可执行代码。 |
| ExpeL / Agent Workflow Memory | 可检索的文字经验或工作流 | LLM 取回并解释经验 | 本文让积累后的控制程序直接执行。 |
| Voyager / LATM / CRAFT | 技能或工具库 | 现有 Agent 选择并调用技能 | 本文修改共享 harness 本身,包括主控制流。 |
| AFlow / ADAS | 代码化工作流或 Agent 程序 | 运行搜索得到的结构 | 本文从失败出发,用实际执行记录限定修改范围,再逐次积累。 |
| AutoHarness / Meta-Harness | 执行代码或配置 | 固定模型运行优化后的 harness | 本文强调无解题策略的起点、多条失败共同修复,以及 gate 未通过时整段回滚。 |
| Harness-Zero | 专用执行程序产生的行为数据 | 训练后的模型在更简单的执行程序上运行 | Harness-Zero 想移除训练用的专用程序;本文保留并部署改进后的专用程序。 |
它和 Meta-Harness 最接近,但解决的问题更窄、更具体:如何让一份不断变大的程序继续从失败中局部修复,同时防止新补丁破坏旧能力。论文没有训练模型权重,也没有尝试跨任务基准共用一套控制程序。
3. Method:从失败记录到局部修改,再到完整回归
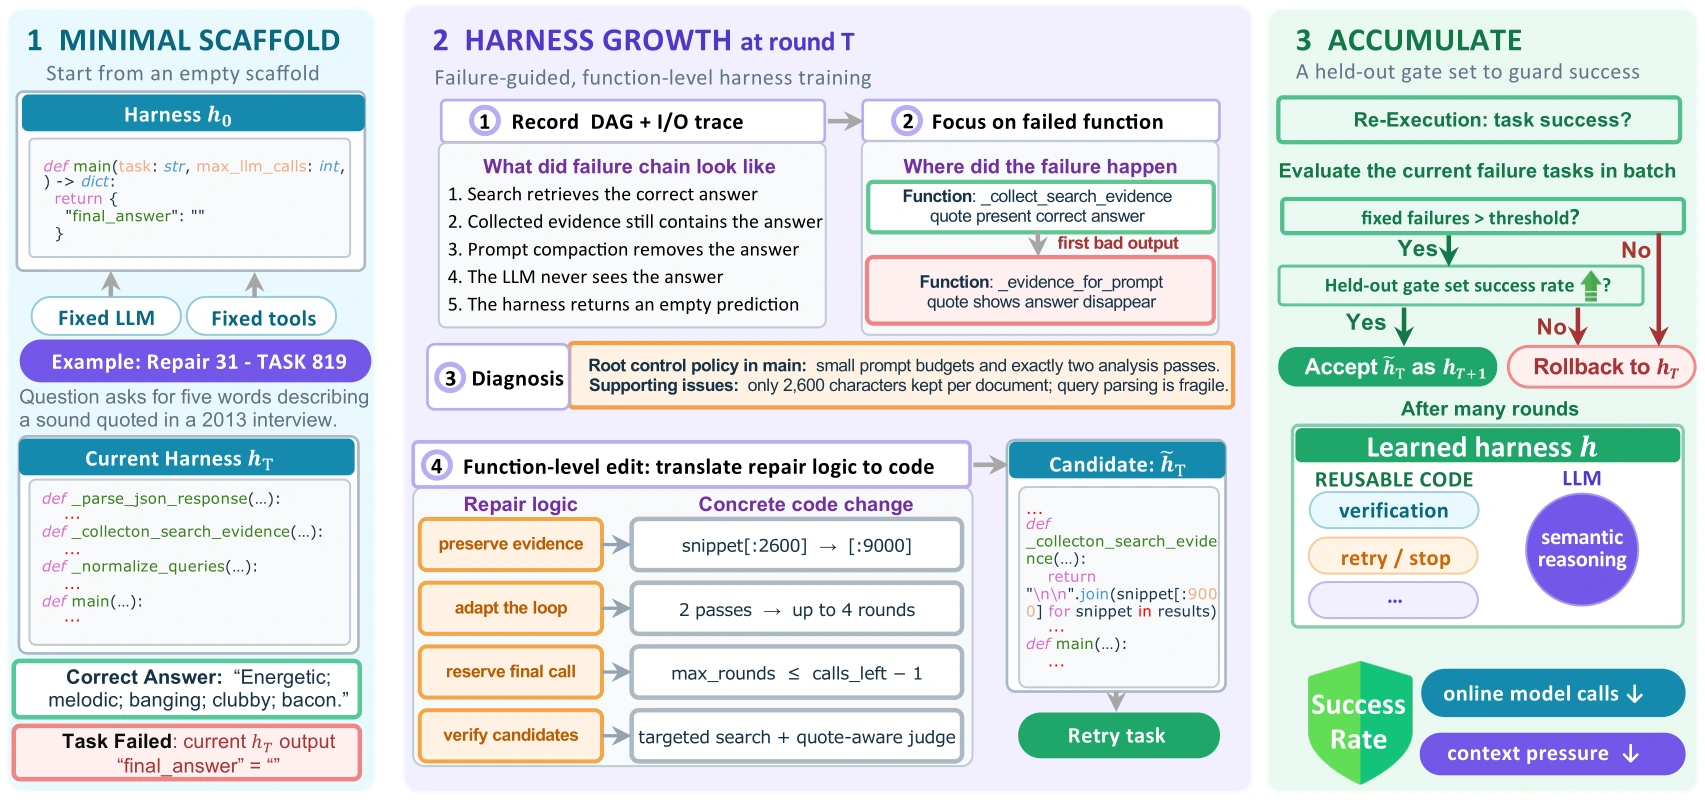
完整路径是:运行当前程序,记录函数级执行过程,把多条失败放进窗口,局部修改代码,重跑失败,再按间隔用单独留出的 gate 任务验收。 以下按 §3.5–3.6 与设置表说明;Algorithm 1 的不同写法另行标出。
3.1 用实际调用的函数限定修改范围
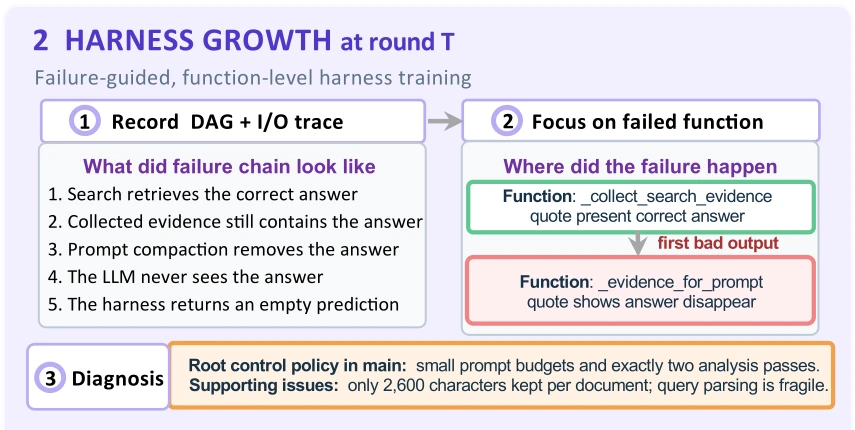
每条 trace(执行记录)包含任务、函数调用 DAG(有向无环图,用父子关系表示谁调用谁)、模型与工具调用、输入输出、运行错误、最终判定和资源用量。负责改代码的模型(optimizer)只能修改入口 main、当前失败记录中实际调用过的函数,以及少量新增辅助函数。已有但未被调用的函数不能顺手重写。
候选必须保留既有函数签名和工具接口,不能删除函数,也不能把题目 ID、参考答案或固定解法硬写进去。被修改的函数与新增函数合计最多 L=10 个。程序先通过语法、入口、接口、修改范围和数量检查,再运行任务;这些约束不是由任务成功率代替的。
这条限制解决了一个实际问题:harness 越长,把整份程序交给修改模型,可选择的改法就越多。函数级执行记录把修改限制在与失败直接相关的代码上;修改预算 L 再限制被改和新增函数的总数。
训练时,离线修改模型还会看到评分反馈、检索文档标识、证据、动作统计和报错。这些诊断信息只用于生成修改,不会暴露给部署中的 harness。论文因此把“训练监督”和“Agent 执行时可见的信息”分成了两层。
3.2 多条失败一起检查,已修任务退出窗口
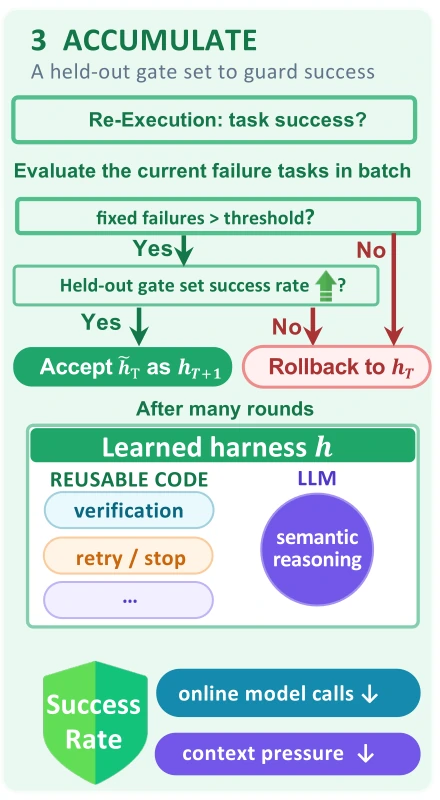
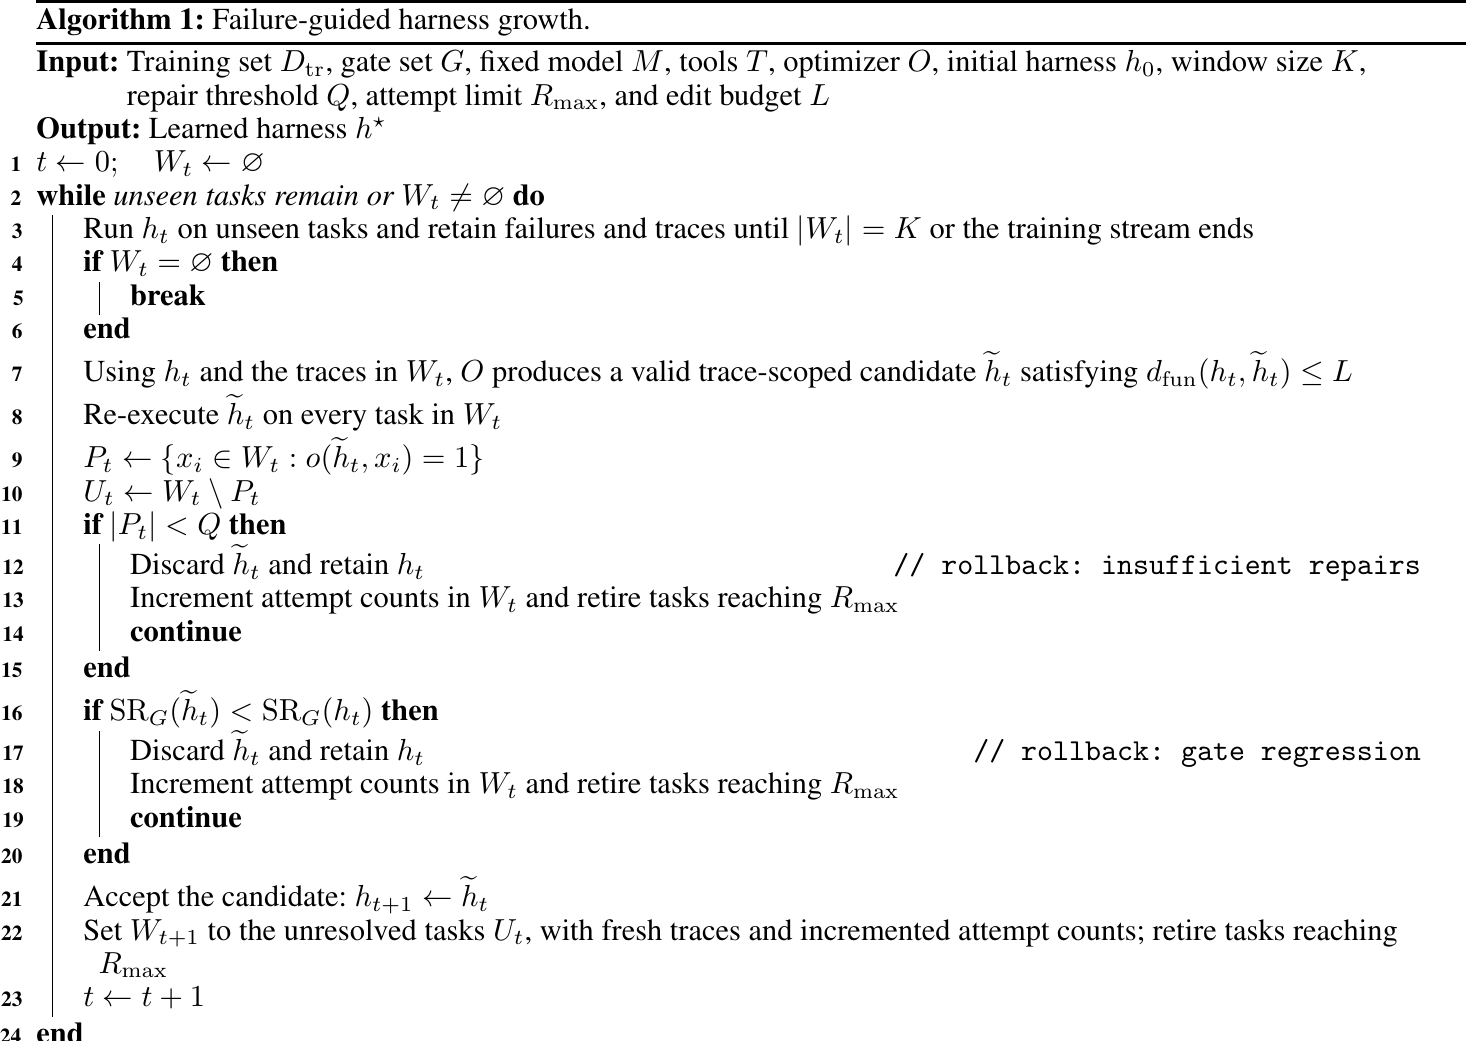
当前 harness 顺序处理训练任务。直接成功的任务不进入修复;失败任务与最新执行记录进入容量为 K 的窗口。修改模型同时看这些失败,生成一份完整候选;候选先通过语法、入口、接口和修改范围检查,再重跑整个窗口。
按 §3.5,合法候选成为临时使用的程序,修好的任务离开窗口,未修好的任务保留新 trace 并增加尝试次数;达到 Rmax 后退出,后续失败补进窗口。开始优化完整窗口前保存进度;若整窗都耗尽尝试仍没有修复,则恢复窗口开始前状态。论文没有公开代码,候选未修好任何题时的完整接受条件不能靠实现进一步确认。
3.3 累计修复后做 gate;伪代码与正文定义冲突
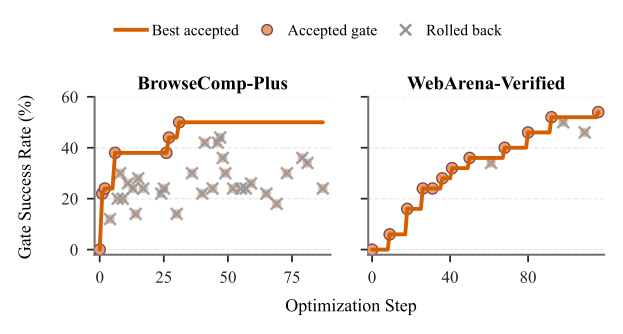
§3.6 先在 50 道 gate 任务上评估初始程序,之后每累计修复 Q 条任务,再评估当前程序,与上次已接受的检查点比较:
通过后,当前代码、窗口、任务游标、计数器和训练记录一起成为新检查点;失败则恢复上次 gate 的全部状态,撤销中间整段修复。训练结束时,最后尚未经过 gate 的改动再验收一次。成本只记录,不允许用更便宜抵消成功率下降。
论文内部冲突,不能忽略:Algorithm 1 把 Q 称为“repair threshold”,要求单个候选在当前窗口修好至少 Q 题,然后立即 gate;§3.6 和 Table 5 则称它为“gate interval”。WebArena 的 K=4、Q=8 最能说明问题:窗口最多四题,不可能一次修好八题。本文采用与设置表一致的累计间隔说明,但并不声称已从代码解决歧义;官方实现与执行日志未公开,精确复现仍需作者澄清。
3.4 Repair 31:检索已找到答案,证据却被截断
BrowseComp-Plus Task 819 的完整因果链
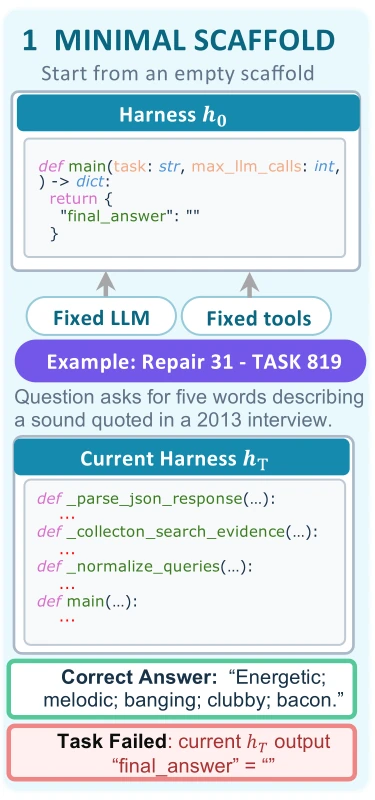
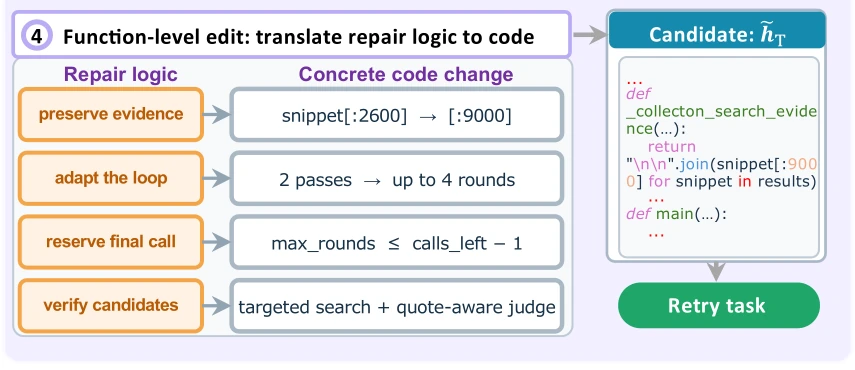
- Figure 2 选取 BrowseComp-Plus 训练题 Task 819,要求找出一篇 2013 年访谈里描述某种声音的五个词。Agent 能看到问题、固定搜索工具和自己的执行历史;参考答案不提供给执行任务的 Agent。
- Harness 已经找到包含正确引文的材料。
_collection_search_evidence的输出保留了五个词:Energetic; melodic; banging; clubby; bacon. - 组装提示的函数
_evidence_for_prompt把每篇文档截到 2,600 个字符,包含答案的片段被切掉。后续模型调用没有看见正确证据,最终final_answer为空。 - 修改模型把截断上限从 2,600 提到 9,000 个字符,把两轮分析放宽到最多四轮,同时用
max_rounds ≤ calls_left − 1为最终回答保留一次调用。它还加入定向搜索与核对原句的判断步骤。 - 按论文的验收规则,候选需要重跑当前失败窗口;累计修复达到间隔后,再在 gate 上检查是否退化。Figure 2 展示了问题与改法,没有公开这份候选的每次重跑结果或 gate 分数,不能把图当作独立复现的通过日志。
这个案例也说明为什么要按执行记录定位:任务的 0/1 分数只能告诉你失败了;调用图与中间输入输出才能区分检索失败、证据丢失和最终回答失败。
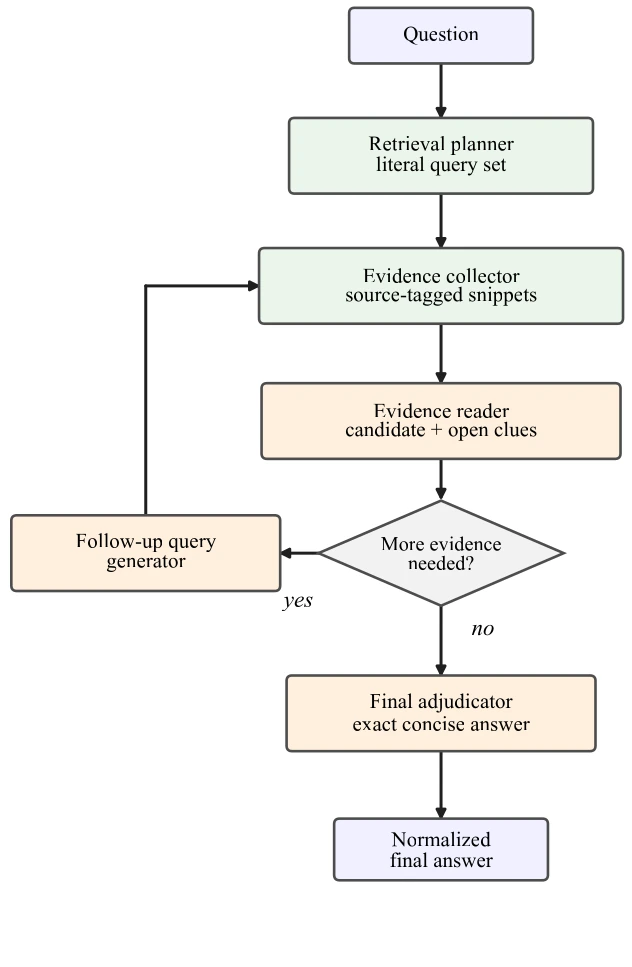
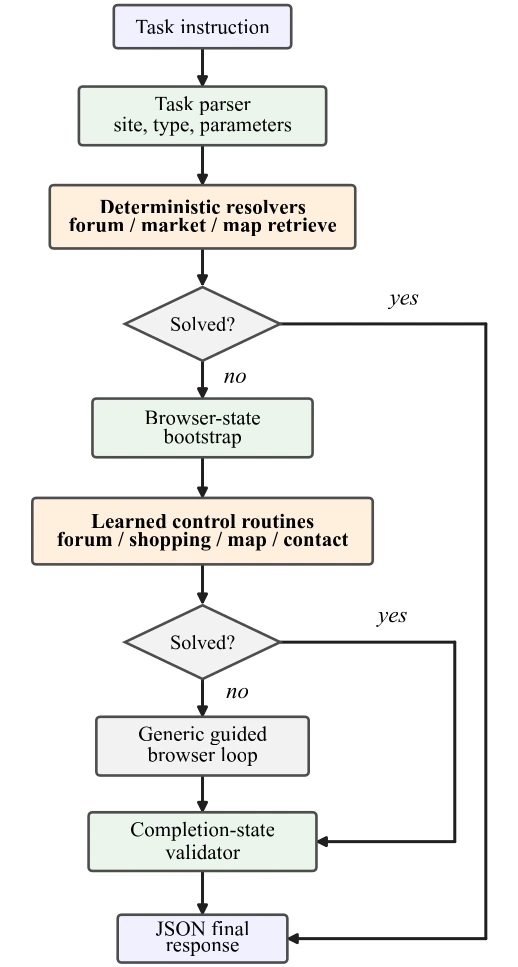
4. Experiments:两套基准的评分、主结果与成本
两项任务基准都留 200 道训练题、50 道验证题和 50 道最终测试题,划分随机种子为 42。每个设置独立测试三轮,每轮每题只尝试一次;报告全部题目与尝试的平均成功率。
4.1 任务、可见信息与评分
BrowseComp-Plus 是一套多步检索任务,使用固定、人工核验过的检索语料。Agent 看到问题和相同的搜索工具;Growing Harness、Tool-Calling、Self-Ask、IRCoT 共用任务划分、工具、模型与预算。最终答案由模型判断与参考答案是否语义等价。论文没有给出评分模型、评分提示或人工复核率。
WebArena-Verified 是经过审计和修正的多步网页操作基准。本文只取 shopping、reddit、map 三类站点,按意图模板、任务类型和网站分层抽样。所有方法只看无障碍树文本(accessibility-tree text,用文字表示页面元素),不看截图;任务结束后运行基准自带检查程序。Growing Harness 与 Tool-Calling、WebDreamer、AgentOccam 使用相同工具 API、任务划分、部署模型和调用上限。
最终评测(Table 3)每题最多 50 次模型调用、每次最多输出 8,192 tokens,采样温度 1.0、推理强度为 Medium,超时 1,800 秒。训练阶段(Table 5)则是 BrowseComp 超时 900 秒、WebArena 1,800 秒;不能把训练与最终评测预算混为一谈。Agent 不会收到“还剩几次调用”的文本提醒,预算由 harness 执行。
4.2 指标如何聚合
最终测试有 50 道题,每种设置独立跑三轮,所以分母是 150 次任务尝试:
不是给同一道题三次机会后取最好结果。模型调用、token 和时间在这 150 次尝试上取平均。Total Online Cost(在线总费用)是完成一轮 50 题时执行 Agent 的模型费用,再对三轮取平均;不含评分与离线修改程序的费用。
费用根据输入、输出和缓存读取的 token 数乘提供商单价估算。缓存读取量按同一道任务中与此前请求共有的最长前缀估算,不假设跨题缓存,也不是实测账单。Table 4 的单价单位是美元/百万 tokens;例如 gpt-oss-120b 的输入、缓存读取、输出分别为 $0.15、$0.075、$0.60。
置信区间按题目成组重抽样(cluster bootstrap):重复 10,000 次,每次有放回抽 50 道题,并保留每题的三次尝试。表里的 ± 是重抽样标准误乘 1.96,即正态近似 95% 置信区间的半宽,不是标准差。
4.3 六组主结果
| 任务基准/模型 | Tool-Calling SR | Growing Harness SR | 模型调用 | 一轮 50 题的在线费用 |
|---|---|---|---|---|
| BrowseComp / gpt-oss-120b | 40.0 ± 11.6 | 49.3 ± 11.7 | 32.7 → 6.0 | $6.70 → $0.87 |
| BrowseComp / gpt-oss-20b | 40.0 ± 11.7 | 39.3 ± 12.6 | 24.8 → 6.0 | $2.03 → $0.52 |
| BrowseComp / Qwen3.5-4B | 12.0 ± 7.1 | 29.3 ± 11.8 | 29.6 → 5.5 | $8.33 → $0.81 |
| WebArena / gpt-oss-120b | 30.0 ± 11.4 | 45.3 ± 13.4 | 26.3 → 3.8 | $2.72 → $0.10 |
| WebArena / gpt-oss-20b | 12.7 ± 7.3 | 44.7 ± 13.4 | 22.3 → 1.8 | $0.39 → $0.03 |
| WebArena / Qwen3.5-4B | 6.7 ± 4.9 | 45.3 ± 13.4 | 37.8 → 5.4 | $7.26 → $0.10 |
五组设置中,Growing Harness 的平均成功率最高;BrowseComp + gpt-oss-20b 低于 Tool-Calling 0.7 个百分点。相对 Tool-Calling,六组减少 76.0% 至 91.8% 的模型调用和 74.4% 至 98.6% 的执行模型在线费用。
平均分排第一,不等于差异已达到统计显著。 最终测试只有 50 道题,表中的置信区间较宽;论文没有报告逐项配对差值的置信区间或显著性检验。它也没有在每个指标上都胜过所有其他基线:较便宜或较快的方法可能成功率更低。
WebArena 的结果尤其醒目:模型从 120B 缩到 4B,Growing Harness 仍在 44.7% 至 45.3%;Tool-Calling 则从 30.0% 降到 6.7%。这与“代码承担重复网页操作,小模型保留语义判断”的解释一致。这项实验没有进行跨模型训练:每套基准的执行程序由指定模型训练,再换三种部署模型评测。
展开:逐题 context、费用与 token 分布
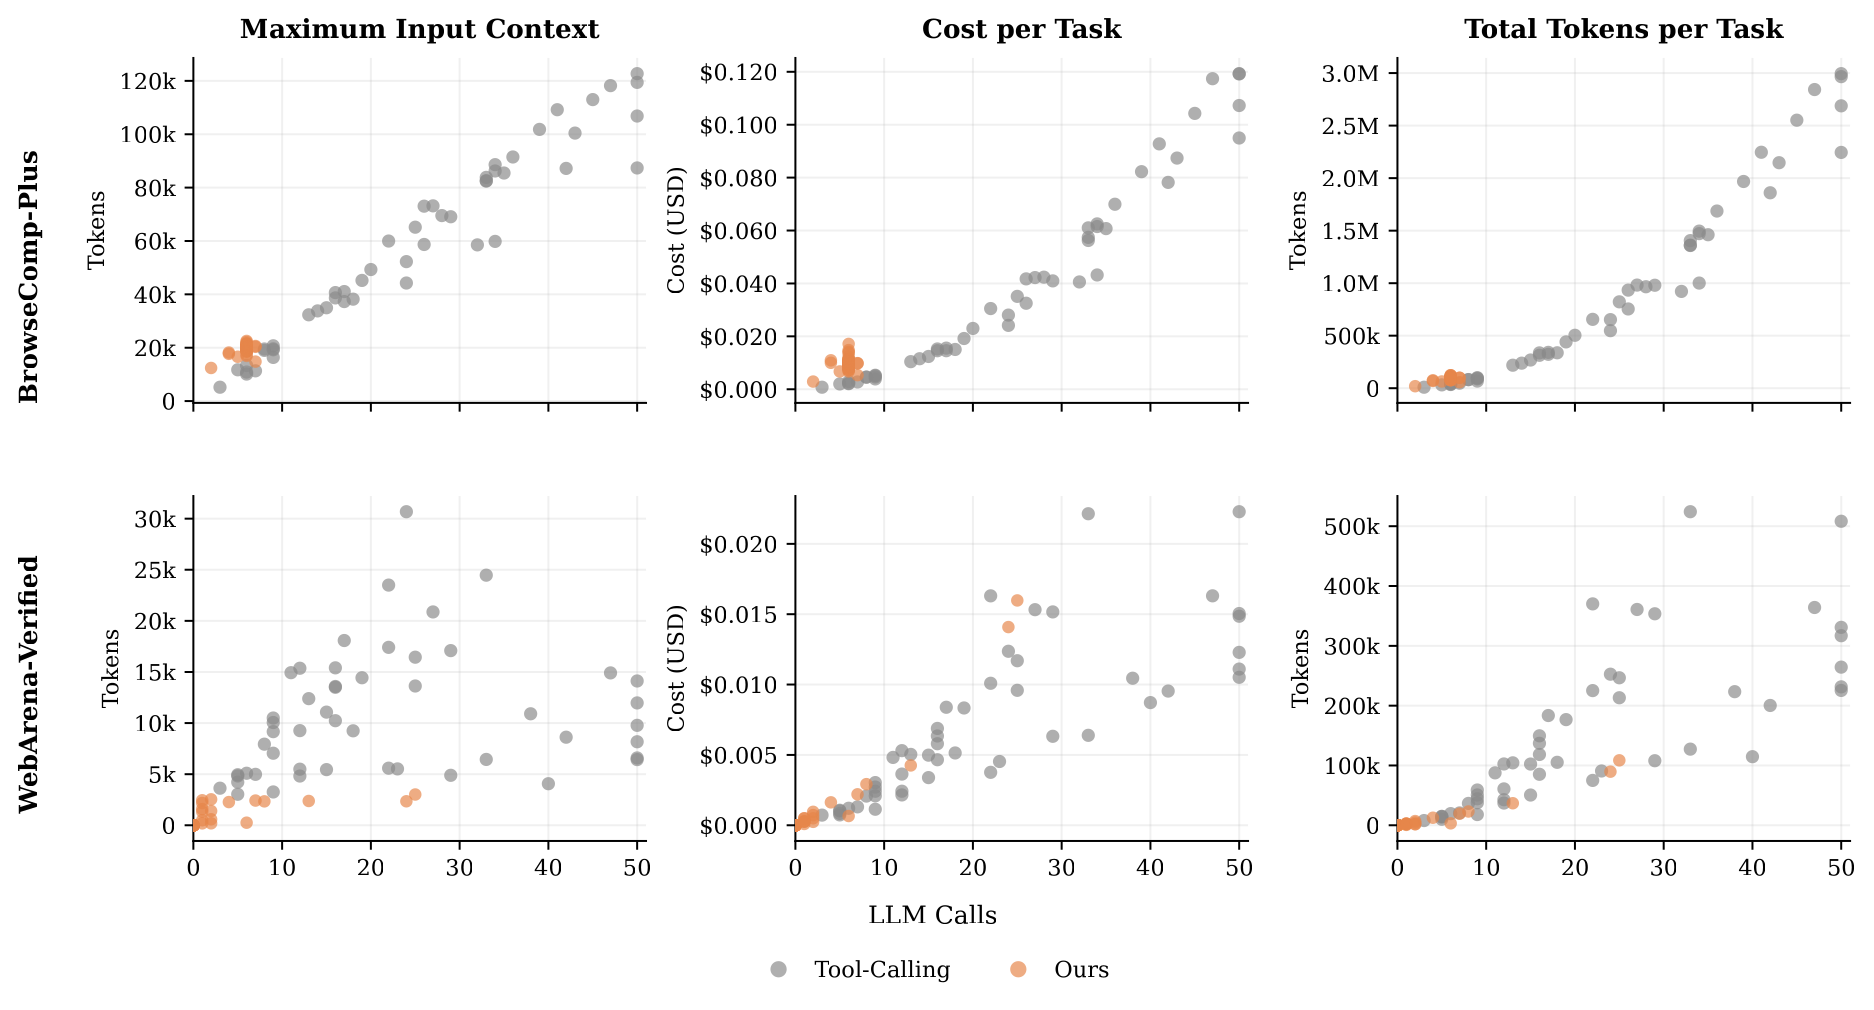
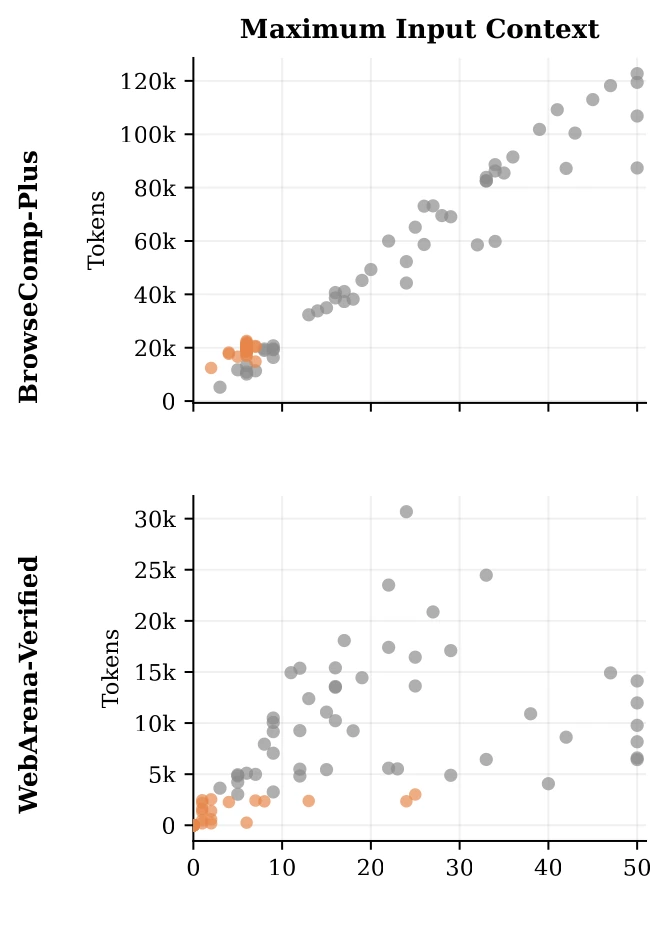
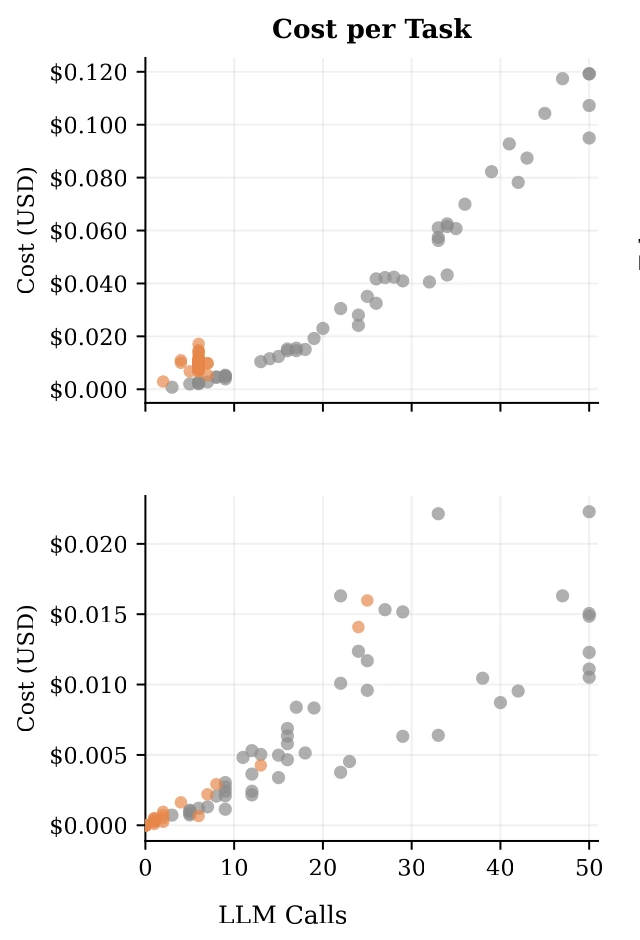
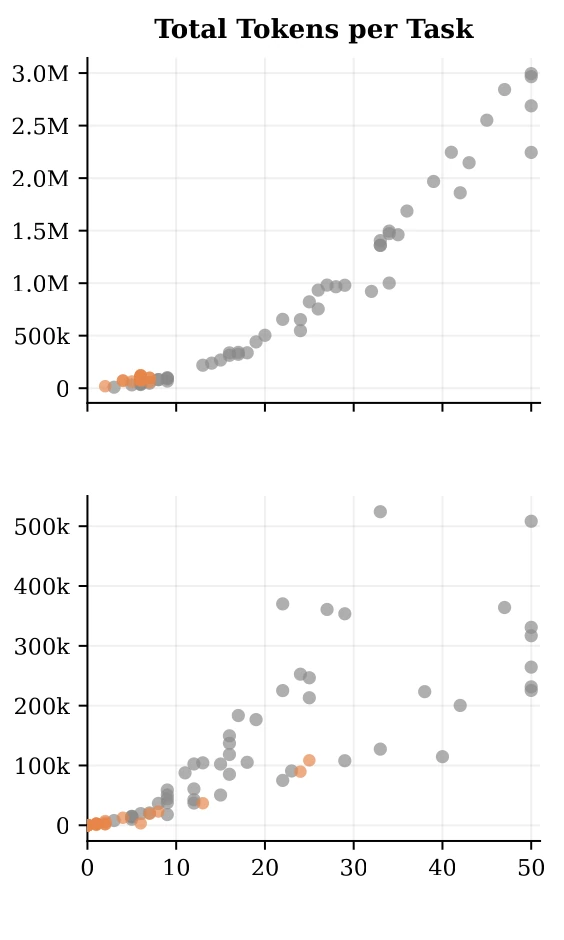
4.4 三项组件消融:方向一致,重复次数不足
展开:原论文的训练曲线和消融曲线
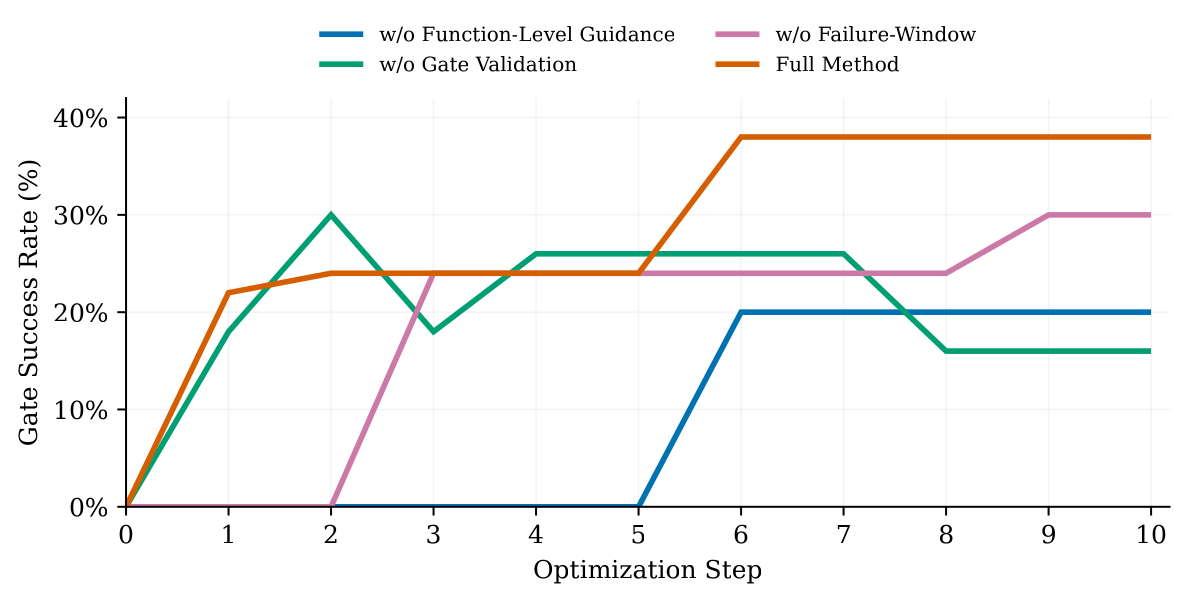
BrowseComp-Plus + gpt-oss-20b 的单次消融结果是:完整方法 36%,去掉失败窗口 28%,去掉 gate 验收 22%,去掉函数级修改指引 18%。每种方案只优化一次,共 10 步,没有重复运行的误差条,因此可以说明组件与这一次训练结果相关,不能当成稳定的效应量。
这里有两处容易误读。第一,Table 2 的分母是 50 道最终测试题,Figure 4 则是另外 50 道 gate 题的训练曲线;无 gate 方法的 22% 与曲线的 30% → 16% 不是同一组任务。第二,去掉 Function-Level Guidance 时,作者同时去掉函数级执行记录、由记录确定的修改范围,以及函数数量预算 L,允许改整份程序。36% → 18% 不能单独证明“函数定位”贡献了 18 个百分点。
训练阶段的固定超参数也值得保留:BrowseComp 用 gpt-oss-20b 作为实际执行任务的模型、GPT-5.6-terra High 作为修改程序的模型,K=8, Q=1, Rmax=5, L=10;WebArena 用 gpt-oss-120b 与 GPT-5.4 High,K=4, Q=8, Rmax=5, L=10。每步只生成一个候选程序。
5. Discussion:局部修复与回归测试应怎样迁移到 coding harness?
可复用的是局部修改与完整回归的规则,不是照搬有歧义的伪代码。
对 coding harness,记录提示模块、工具适配代码、调用钩子、子 Agent、命令、文件修改、测试和超时之间的实际调用关系,只改失败路径相关模块。失败窗口也可按“误读测试输出”“重复读文件”“工具报错后丢进度”等类型组织,检验一个修改能否修多个仓库的同类问题。
Gate 要覆盖旧任务、不同代码库、权限拒绝、长上下文和模型升级;生产环境还要限制破坏性操作、运行预算、用户中断与恢复行为。成功率不降低只是最低要求。
后续应比较整份程序重写、函数级局部改动和模块级改动;统计离线优化与评分的总费用,计算需要复用多少次才回本;在不同模型和代码库上交叉部署同一程序,测增益是否保持。
6. Conclusion:已有证据与复现限制
论文把“agent 从经验中学习”落到了一个可执行、可回滚的程序更新过程上。 它从无解题策略的控制程序开始,说明执行记录怎样定位错误、失败窗口怎样更新、候选何时验收,以及回滚恢复什么;Repair 31 也展示了怎样从 0/1 失败分数定位到具体函数与丢失的引文。实验同时报告成功率、调用、token、时间和在线成本,主结论不靠一个单独指标支撑。
还需要保留以下限制:
我的判断是:它应该和 Meta-Harness、Harness-of-Harness、Harness-Zero、Multi-Harness RL 一起读。Meta-Harness 关注如何搜索 harness;Harness-of-Harness 关注多日任务中的上层调度;Harness-Zero 研究怎样把专用程序诱导的行为迁移到更简单的执行环境;Multi-Harness RL 讨论跨执行程序训练是否真的提高部署迁移能力。Growing Harness 补上的问题是:当任务会重复到来时,一份专用执行程序怎样根据失败持续改进,又不把已有能力改坏。
来源与授权:论文为 arXiv:2609.26760v2,arXiv 页面标注 CC BY 4.0。本文引用 Figures 1 至 6 与 Algorithm 1 并逐一注明来源;结果、公式与设置来自 Tables 1 至 5。2026-10-14 核查论文主页;主页与论文仍未给出本工作的官方代码或数据链接。上游基准公开,不代表本次训练程序和记录已公开。
留言