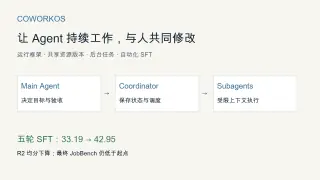
[2026-11-02] CoworkOS: Scaling Agent Coworkers for Real-world Automation
让模型持续处理后台任务,与人共同修改有版本的产物。精读三层运行框架、真实交互案例与五轮监督微调,查清谁生成数据、哪个模型被更新,以及SFT收益、负面结果和公开实现的边界。
让模型持续处理后台任务,与人共同修改有版本的产物。精读三层运行框架、真实交互案例与五轮监督微调,查清谁生成数据、哪个模型被更新,以及SFT收益、负面结果和公开实现的边界。
训练时,让模型多走一遍检索或规划流程,再用这份额外材料训练它直接作答。OPHSD 在两套短流程上有效;本文用真实法律与数学题解释训练、判分,以及论文和公开实现的差异。
平台逐阶段加入新工具、操作指南或专门处理某类任务的 Agent,旧题和评分规则不变。EvoHarnessBench 检查系统能否用好新增能力,以及选择越来越多时会不会连原来会做的题也做错。
让九个模型修改同一套调用模型、工具与执行步骤的代码,最多评测 20 次、工作 48 小时。Evo-Bench 不只测最终得分,还检查模型是否保住好版本、是否把系统改坏,以及怎样使用开发预算。
给模型 12 至 24 小时,让它写出一个会答题、会修代码或会操作终端的程序,再用未见过的任务测试这份程序。Meta-Agent Challenge 比较了 39 组开发配置,也记录了开发接口泄露答案的真实案例。
VeRO 管理 Agent 自动改进 Agent 时的代码版本、评测额度、可见文件和运行记录。本文解释一次修改怎样被评测,并用 Terminal-Bench 的逐题结果说明:消除程序异常,未必让任务成功率提高。
HarnessFix 先把失败记录对应到具体代码:哪些信息没传下去,程序为什么过早结束,再限制补丁可改的范围。本文用 AppWorld 支付请求解释完整诊断与验证过程,并核对四个 benchmark 的评分和证据缺…
Self-Harness 让同一个模型做任务、阅读失败原因,再修改自己的运行程序。重点是候选如何生成和保留、真实测试怎样判补丁成功,以及反复用于筛选的验证题为什么不等于最终盲测。
Harness-R1 训练一个 9B 模型读取失败记录、修改 Agent 的运行程序,再用实际重跑的成绩变化奖励补丁。重点是四个可修改位置、训练奖励与最终成功率的区别,以及补丁对未见任务是否仍有效。
固定被修改的 Agent、它调用的模型和评分规则,让不同模型在有限试验额度内改进同一套程序。本文拆解开发与隐藏测试、真实预算记录、增益计算及 111 次有正式分数的优化实验。