查看论文原图与完整表格
arXiv 页面标注的是 non-exclusive distribution license。本站用重新绘制的图解释数据;完整原图请在论文中查看:Figure 1 · 实验流程、Figure 2 · 原接口矩阵、Figure 3 · 未见接口与身份诊断、Figure 4 · 动作组成。完整数值表见 Tables 1–2、Table 3、Tables 4–6、Tables 7–8、Table 9、Table 10。
把同一批编程执行记录拿来训练,模型能涨多少分?涨分能否带到另一套工具和交互规则里?作者让 Qwen3-8B 通过四套负责提示构造、工具执行和历史管理的程序(harness)采集数据,固定模型起点、数据和更新预算,比较两种分数分组方式。两种方式在原接口上都只有小幅提升;换一个评测接口带来的成绩差异明显更大。未见接口的实验也没有确定谁更好。
1. Motivation:多接口训练的收益,能带到另一套执行接口吗?
训练接口上的涨分和换接口后的涨分,需要分别测量。 模型通过某套 harness 看到的工具、命令输出、错误提示和历史记录都带有这套程序的特点。训练后更善于使用它,不一定意味着换一套程序还能保持同样的提升。
Harness 不是薄薄的一层提示。它决定模型收到什么反馈、能调用哪些工具、怎样重试、何时截断上下文,以及最终怎样提交代码补丁。论文先用六个模型版本 × 四套评测程序 × 500 题 × 两次尝试构造 24,000 次评测。列均值从 2.14% 到 9.27%,相差 4.3 倍;训练方案的行均值只有 5.55% 到 6.46%,相差 1.16 倍。
论文把这个问题拆成三项比较:RL 与共同的 SFT 起点相比涨多少分;同一模型换 harness 后成绩变多少;跨接口分组的 Cross 是否比接口内分组的 Within 更容易把增益带到未见接口。前两项说明收益和接口差异的规模,最后一项才是对分组规则的受控检验。
横向总览(可打开原尺寸)
2. Related Work:相关系统已经做了什么,本文还要单独检验什么?
本文固定采集数据和训练预算,单独比较分数的分组方式。 ClawGym II 与 HarnessX 已经训练多接口模型,但完整系统还改变了数据采集、模型版本或训练设置,不能直接从最终成绩判断跨接口分组的作用。
| 工作 | 多 harness 怎样进入训练 | 怎样评测 | 本文关心的证据边界 |
|---|---|---|---|
| ClawGym II | 一个模型接收多套程序的记录,按“题目 × 程序”计算相对分 | 原程序与换程序测试 | 对应本文的 Within 思路,但它还改变了数据和训练系统。 |
| HarnessX | 同题在连续演化的 harness / model 版本间共享 GRPO 比较组 | 整套训练方案的最终结果 | 对应 Cross 思路;版本演化与得分分配规则没有被拆开。 |
| Polar | 分别在真实部署程序中执行 GRPO | 每个模型在各自的训练接口中测试 | 原接口增益从 Qwen Code 的 +0.6 pp 到 Codex 的 +22.6 pp;没有统一检验换接口。 |
| OpenForgeRL | 比较 ZeroClaw 单接口与三接口的 SFT+RL | ClawEval;单接口模型换到 OpenClaw / Codex,较 Base 增益为 +3.3 / +4.6 pp | 三接口模型的 +9.5 / +20.3 pp 来自它已经见过的 OpenClaw / Codex,不能叫未见接口收益;两阶段的接口接触也同时变化。 |
| Orchard | 分别用 mini-swe-agent 或 OpenHands 的记录做 SFT | 两个训练接口 × 两个评测接口 | 训练评测匹配时 53.5%–57.9%,不匹配时 19.0%–28.0%;这里比较的是 SFT 接口匹配。 |
| 本文 | 四套训练程序相同,只改变 GRPO 分组 | 四个原接口 + 未见 weak-ReAct | 能回答“跨程序比较分数是否额外改善迁移”。 |
这些相关工作数字来自本文 v2 的 §2 与 Appendix D,数据集、模型和预算不同,不能排成统一榜单。本文的增量是提供一个范围较窄的对照:在固定数据上,Cross 没有显示出稳定优于 Within 的未见接口表现。它没有否定增加接口数量、继续在线采集或更长训练的价值。
3. Method:数据、比较组与隐藏测试怎样连接?
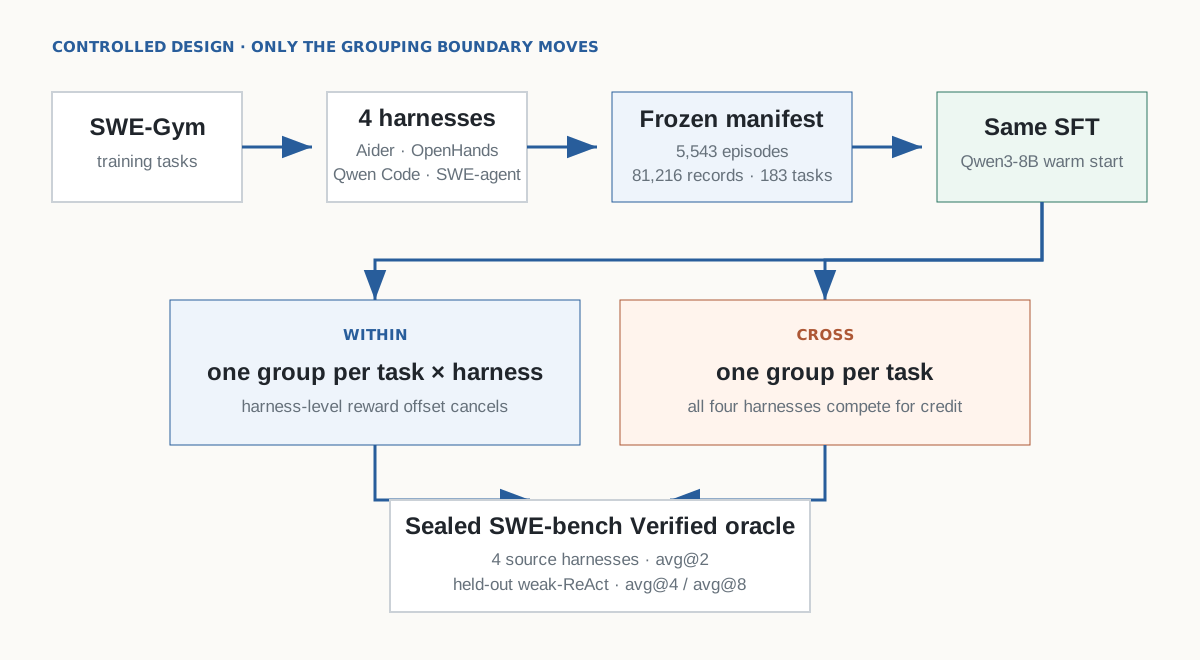
四个训练方案重放同一批已采集记录,最后由相同的隐藏测试判修复是否成功。 作者不在训练过程中继续采新任务记录,因此这是一组冻结数据上的受控比较。
3.1 训练集从哪里来,谁产生什么
训练执行记录来自 SWE-Gym,评测使用 SWE-bench Verified;作者声明本研究的训练与评测任务不重叠。从 1,008 个采集任务里,作者选择 183 个同题合并所有接口的尝试后,既有成功又有失败的任务。这不要求不同接口各自全对或全错,同一个接口内的成功与失败也能满足条件。这个筛选保证 Cross 的每个任务组都存在分数差异。
监督微调起点使用 186 个任务的成功执行,处理成 8,841 条训练记录。四个 RL 方案都重放同一份固定清单:183 个任务、5,543 次完整执行、81,216 条处理后的训练记录,实际日志记录 81,200 个 optimizer steps(优化器更新步骤)。任务数、完整执行次数、训练记录数、更新次数是四种不同单位。 v2 没有披露每条 record 的具体切分规则或这 16 条记录与更新次数差异的原因,不能把它们直接等同。任务问题和测试来自上游数据集;本文作者负责采集、筛选、分组、训练和统计。
论文也把运行环境锁到了具体版本,避免“同名 harness”掩盖实现差异:Aider 0.86.2,OpenHands SDK 1.0.0a6 与 openhands-ai 0.62.0,Qwen Code 0.19.3,SWE-agent / SWE-ReX 1.1.0 / 1.4.0;训练栈是 torch 2.6.0、transformers 4.51.3、verl 0.4.1,评测使用 swebench 4.1.0 与 udocker 1.3.17。
3.2 Within 与 Cross 改变的是组均值和标准差
对 task x、harness h、第 i 条 rollout,reward r(x,h,i) 只有 0 或 1:
μ 是所在组的平均测试分,σ 是标准差,ε 防止除零。Within 对每个“任务 × harness”组单独减均值;Cross 对整道题只减一次均值。如果某个接口在这道题上的平均分高于混合组均值,Cross 下它的平均 advantage 就偏正。入选训练集里,OpenHands 的总体成功率为 27.0%,Aider 为 6.9%,但这两个总体数不意味着每条 OpenHands 记录都得到更高 advantage。
可以用一个小组看清差别。以下是按公式构造的例子,不是论文任务日志:同题在 A 接口四次全成功,在 B 接口四次全失败。Within 里 A 的分数都等于 A 均值 1,B 都等于 B 均值 0,两组 advantage 全为 0;Cross 把八次放一起,均值 0.5、总体标准差 0.5,于是 A 约为 +1、B 约为 −1。Cross 会鼓励 A 接口下的生成,即使差别来自工具和执行程序,而非模型本身的解题策略。 原文实验有四种接口,这个两接口例子只用于说明公式。
一次更新的顺序是:读取冻结记录及其当时的输入、生成 token 和 0/1 分数;按选定规则预先计算这次完整执行的 advantage;用当前模型重算生成 token 的概率;比较当前概率与采集时的概率,用 GRPO 的截断目标更新模型。工具输出等 observation token(环境返回的文本)不参与生成损失,但仍在模型输入里。同一条完整执行的 advantage 加权它的各个生成 token,作者没有提供逐步奖励。
jt = min[ρtA, clip(ρt, 1−δ, 1+δ)A] − β DKL(πθ ∥ πref)
a_t 是这一步已采样的生成 token,s_t 是之前的交互历史,π_old 是生成记录的模型,π_θ 是当前训练模型;δ 控制概率比截断,π_ref 提供 KL 约束。正 advantage 鼓励这条记录的生成,负 advantage 压低它。advantage 为 0 只去掉奖励项的贡献,KL 项仍可能产生梯度。四种方案共用学习率 3e-7、KL 系数 0.01、一个 epoch 和相同 GPU 分配;v2 未给出 δ、ε 的实际数值或更详细的批量设置。
Within 共形成 698 个“任务 × harness”组,其中 44.8% 的组既有成功又有失败;全对或全错的组对应 55.1% 的完整执行。前者以组为分母,后者以执行为分母。Cross 的 183 个任务组都有混合结果,零 advantage 执行占比为 0%。Coverage-matched 从 Cross 出发,把 55.1% 执行的 advantage 置零,保留全部训练记录和剩余相对分;它没有减少更新次数。旧记录重放的平均概率比为 0.996–0.999,有效样本比例 ESS 至少 0.993,说明权重没有明显集中到少数记录,不等于进行了持续在线采集。(Appendix A.1–A.2、Table 1)
3.3 一次完整任务尝试怎样得到 0 或 1
模型提交候选补丁后,独立评分程序在每题的隔离容器中运行隐藏测试;论文称它为 sealed per-instance oracle。模型执行时能看到 GitHub issue、固定在 base_commit 的仓库、当前 harness 提供的提示和工具,以及命令输出。作者声明最终复测用的测试与执行时的反馈测试分开;复测成功记 1,失败记 0。这套专用复测代码尚未公开,不能只凭它使用 swebench==4.1.0 就推断每项内部判定。
公开 SWE-bench 数据则把测试组织成两份清单。FAIL_TO_PASS(F2P)列出修复前失败、参考修复后通过的测试;PASS_TO_PASS(P2P)列出修复前后都应通过的测试,防止修新问题时破坏旧功能。评测器应用候选修复与上游 PR 提供的 test_patch(新增或修改测试的补丁),运行测试,再解析逐项状态。测试补丁和参考修复不作为模型输入;仓库原有的测试代码仍可能可见,不能笼统说模型看不到任何测试。
为什么不用执行中的测试反馈直接当分数?作者的初步检查发现,它与隔离评分器有 2.58% 的判定不一致,超过预设的 1% 容许值,而且全是执行中误以为成功。最终表格一律采用独立隐藏测试判定。(Appendix B.2)
例如同一道题四次有效判定为 1, 0, 0, 0,avg@4 的题级分数是 1/4=25%;另外一道题四次都失败,分数为 0。只对这两题取平均,得到 12.5%。它与“尝试四次至少成功一次”的 pass@4 不同。
原接口每题尝试两次;未见接口先尝试四次,再给 SFT、Within、Cross 增加到八次。每个“模型 × harness”条件至少 95% 的尝试必须有有效判定,否则不接受这一条件的结果。没有判定的基础设施故障不进入分母;已完成但测试失败的尝试计为 0。置信区间以题目为单位重采样 10,000 次,保留同题多次尝试的关联,不能把每次尝试当独立样本。
3.4 真实 Astropy 任务:括号不应改变输入与输出的依赖关系
下面用公开任务 astropy__astropy-12907 走一遍输入、修复和标准判分。这是固定数据版本 c104f840… 的第 0 行,属于论文声明使用的 500 题范围,但不是作者公开的模型执行日志,也不代表这道题实际获得了有效判定。
Astropy 是 Python 天文学库,其中 & 可以把两个数学变换并排组合。一个输出依赖哪个输入,用 separability_matrix 返回的布尔矩阵表示:行是输出,列是输入,True 表示存在依赖。两个一维线性变换并排执行,本应互不影响。上游 issue #12906 指出:给两个 Linear1D 先加括号,再放到一个二维变换右侧,右下角却从对角矩阵变成全 True;括号错误地改变了依赖分析。
问题与参考 PR #12907 都由 Stuart Mumford(GitHub 用户 Cadair)提交。test_patch 来自这个 PR 的测试改动,不是本文作者临时生成的检查。Verified 对上游样本做人工质量验证,但公开材料没有提供这条任务的逐项人工审查表。
PR 的一个真实测试把二维旋转 rot = Rotation2D(2) 与两次平移 sh1 = Shift(1)、sh2 = Shift(2) 组合成 rot & (sh1 & sh2)。旋转的两个输出都依赖前两个输入;后两次平移各自只依赖自己的输入。期望与错误输出如下,1/0 分别表示 True/False:
1 | 期望 修复前的错误结果 |
原因就在 _cstack:右侧子模型已经算好了自己的依赖矩阵,旧代码却把整块覆盖成常量 1。参考修复只改一行,保留右侧原矩阵。下面是官方 PR 的原始代码差异,适用 Astropy 4.3 的该基线版本,NumPy 数组操作:
1 | - cright[-right.shape[0]:, -right.shape[1]:] = 1 |
一份候选修复怎样被检查
- 模型收到 issue 正文、Astropy 的
d16bfe05…基线代码与执行工具,交付修复补丁。输入不含参考修复或 PR 新增测试;原有测试代码仍在仓库中。 - 标准评测器在任务容器中应用候选修复,恢复评测用测试文件到基线,再应用上游
test_patch,运行pytest -rA astropy/modeling/tests/test_separable.py。 - 两项 F2P 分别检查
rot & (sh1 & sh2)与rot & sh1 & (scl1 & scl2);后者在末尾增加两个独立 Scale 变换。每项测试同时断言各输出是否独立,以及完整依赖矩阵是否正确。 - 13 项 P2P 检查原有坐标矩阵、拼接、算术组合和其他组合形式。PR 新增四种组合,但其中两种原本就通过,属于 P2P,不能把“四个新增测试”都叫失败修复测试。
- 正常全部运行时,2/2 F2P 与 13/13 P2P 都通过,标准 grader 返回
resolved=True。若第一种嵌套已修好、第二种仍错,F2P 得 1/2,返回部分修复但resolved=False,整次尝试仍记 0。若修新问题却破坏一项旧测试,同样记 0。
实际 F2P 的 pytest 名称是下面两项。测试字典跳过了 cm6,参数序号按插入顺序产生,所以名字里的 6 对应 cm8,9 对应 cm11,不能按字典标签猜测试 ID。
1 | astropy/modeling/tests/test_separable.py::test_separable[compound_model6-result6] |
3.5 标准评分器有一个需单独说明的边界
核对 swebench 4.1.0 的 grading.py 与 Astropy 日志解析器后,标准规则比“所有测试必须实际运行并通过”宽松。它把 PASSED 和 XFAIL(pytest 标记的预期失败)放进成功列表;FAILED、ERROR 和日志中缺失的测试放进失败列表;SKIPPED 两边都不放,因而不进入分母。F2P 与 P2P 各自按“成功数 ÷(成功数+失败数)”计算,分母为 0 时返回 1,两个分数都是 1 才算完整修复。
1 | # 本文写的简化计算例,Python 3.10+。 |
我对下载的原函数做了独立的源码级微测:一项 F2P 为 SKIPPED、其他项为 PASSED 时,它确实返回完整修复。这是构造状态和日志的检查,不是模型运行结果,更不是完整容器复现。论文专用复测代码如何处理跳过测试没有公开,不能把标准包的这个边界当成论文已证实的问题。
完整案例重绘图(可打开原尺寸)
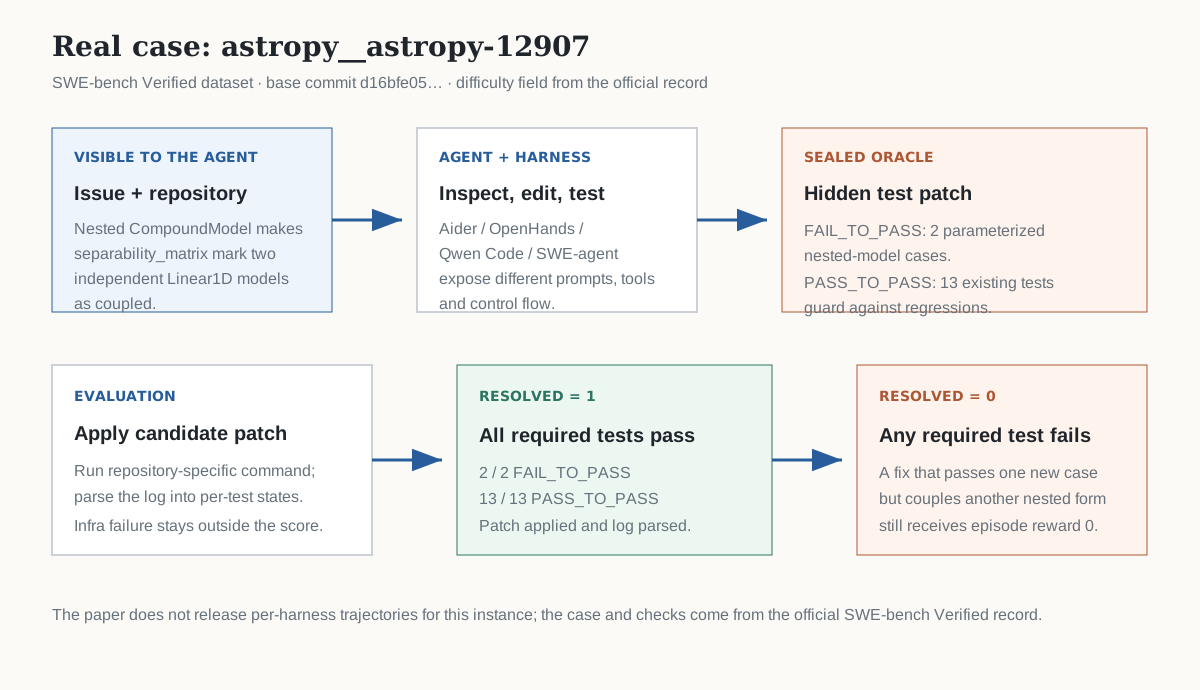
本文专用的执行日志和评分器还没有公开。2026-10-14 核对的 v2 Appendix E.1 明确说:evaluation harness、grading oracle、分析代码、结果和分析计划拟在以后发布,投稿时尚未公开;arXiv source archive 也只有论文材料。上面的任务来自公开数据,源码微测只验证标准包的局部分支,不能据此声称已复现本文各接口下的执行或成绩。
4. Experiments:原接口小幅提升,未见接口没有稳定额外收益
两种规则在原接口上只有小幅估计增益,未见接口上都没有显著超过 SFT。Cross 也没有显示出跨训练随机种子稳定优于 Within 的表现。
4.1 原接口有小幅增益,但最大变量是评测接口
横向总览(可打开原尺寸)
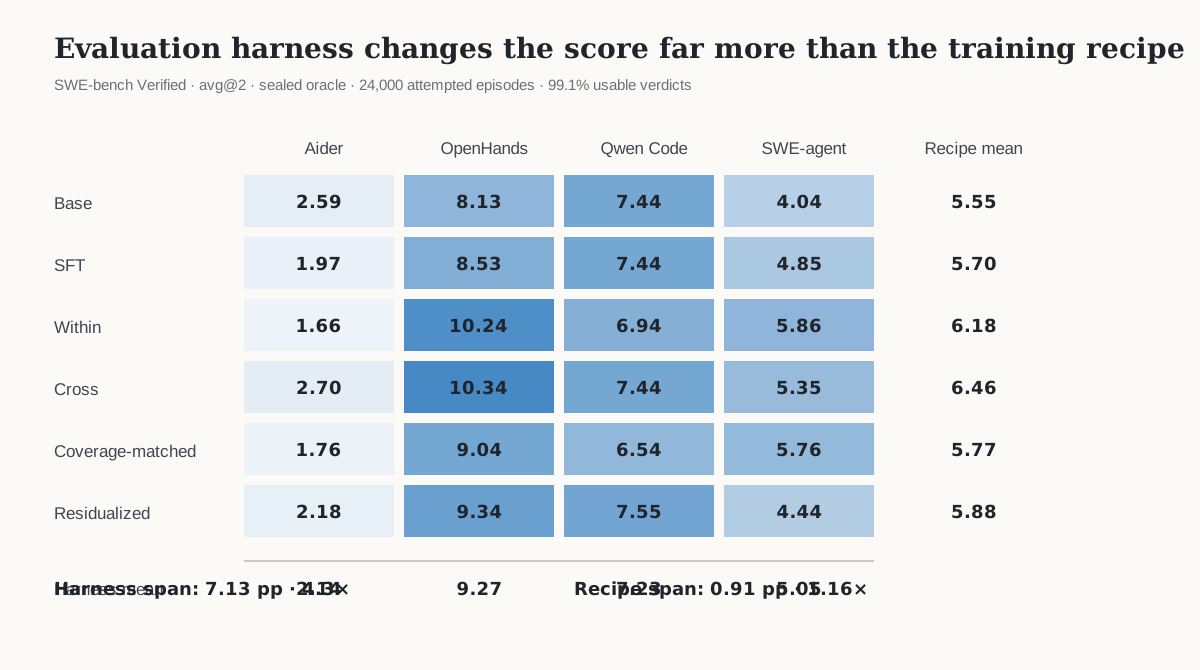
Within 在四个原接口上的行均值为 6.18%,Cross 为 6.46%,SFT 为 5.70%;相对 SFT 的估计增益为 +0.48、+0.77 pp。Cross 的配对增益在 Table 6 报为 +0.77 pp,95% CI [+0.03,+1.52];对五次模型比较做 Bonferroni 修正后,99% CI 为 [−0.21,+1.75],包含 0。最大单列增益都在 OpenHands:Within 为 +1.71 pp,Cross 为 +1.81 pp。
列均值从 Aider 的 2.14% 到 OpenHands 的 9.27%,差 7.13 pp;模型行均值从 Base 的 5.55% 到 Cross 的 6.46%,差 0.91 pp。这个描述性比较说明本设置下接口差异更大,不说明具体哪种工具导致差异,也不能把不同模型的列平均说成“每个模型都相差四倍”。
第二个预训练模型 Seed-Coder-8B 在 weak-ReAct 上是 5.00%,Qwen3-8B 为 4.07%;Seed-Coder 换成 Aider 或 SWE-agent,较自己的 weak-ReAct 分别下降 4.41、4.40 pp。它在 OpenHands、Qwen Code 下各 1,000 次尝试全部发生 harness error,没有产出补丁,这两项记为无法测量。另一方面,Seed-Coder 的 2,000 次 weak-ReAct 尝试中,32 次超过 32,768 token 上下文限制,论文把它们计为失败 0。不能笼统说所有执行错误都排除。(Table 8)
4.2 未见接口上没有检测到 Cross 的额外迁移收益
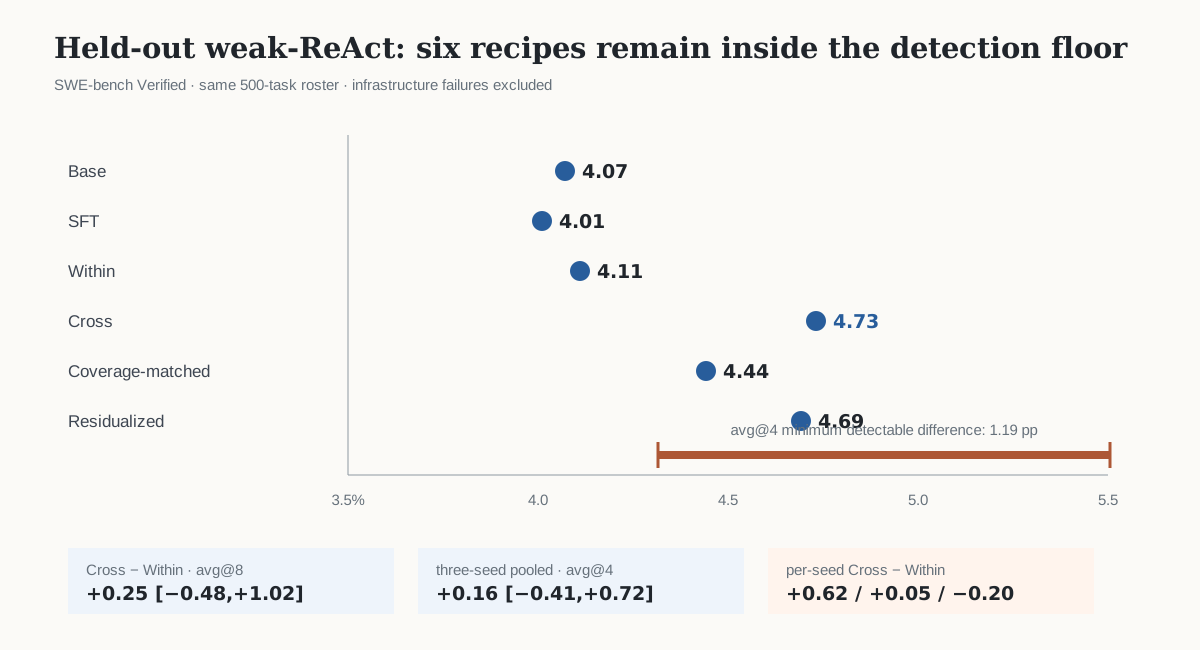
在匹配题目集合的预算比较中,每题尝试从四次增至八次,Cross − Within 从 +0.58 pp 缩到 +0.25 pp,95% CI [−0.48,+1.02]。八次尝试的 Cross − SFT 为 +0.13 pp [−0.65,+0.92],Within − SFT 为 −0.03 pp [−0.64,+0.59];都没有显著超过 SFT。三种训练随机种子的 Cross − Within 分别为 +0.62、+0.05、−0.20 pp,合并为 +0.16 pp [−0.41,+0.72]。合并区间对题目重采样、固定这三种已观察的 seed,不能当成覆盖所有训练随机性的区间。
为什么 Table 5 的八次尝试绝对分是 SFT 4.38%、Within 4.28%、Cross 4.38%,Table 6 的配对差值却不能直接相减出来?它们用的题目和有效尝试集合不同。Table 5 纳入三种模型都有分的 500 题,每题用实际获得判定的尝试。Table 6 先筛到三种模型都至少有七次有效判定的 486 题,再对每一对模型只保留双方八次判定完整的题;三项比较的最终题目集合可以不同,所以差值不必可加。Table 7 又匹配四次与八次预算的题目,这也是其 +0.58 pp 不等于主要四次对比 +0.62 pp 的原因。
这组结果没有建立两种规则的等价性。作者估计,avg@8 的最小可检出效应在 0.88–1.14 pp:这是按区间宽度近似计算、检出概率达到 80% 所需的真实差异,不是“已经排除的差异上限”。较小的收益或损失仍与当前区间相容。(Appendix B.2)
4.3 从 advantage 能猜出接口,但行为差异仍主要由接口决定
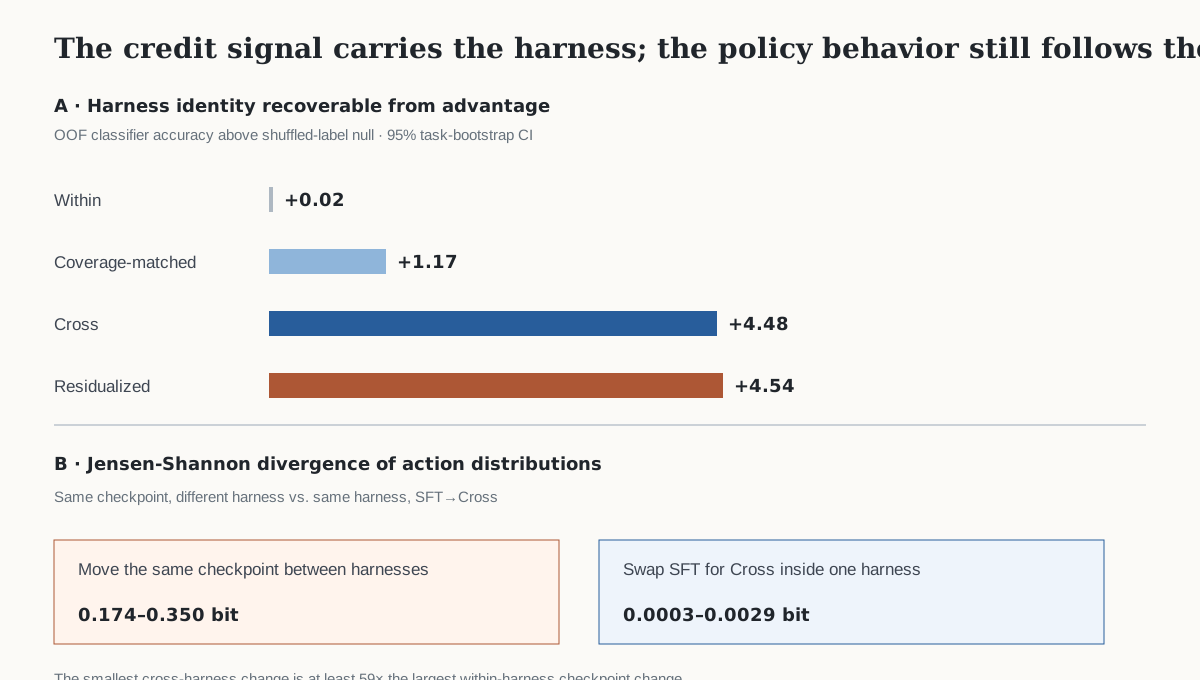
作者将 183 题分为五折,同题所有执行必须留在同一折。分类器只输入一个 advantage 数值,用其他四折训练,在剩下一折猜记录来自哪套 harness;再把每题内部的 harness 标签打乱,得到各方案自己的基准准确率。Cross 是 30.63%−26.15%=+4.48 pp [3.22,5.83],Within 是 26.41%−26.39%=+0.02 pp,区间包含 0。它测出相对分与接口身份的关联,没有证明模型已经“记住接口”或因此不能迁移。(Table 9)
两个辅助对照也没有解决因果归因。Coverage-matched 把部分 advantage 置零,同时把分类器超出基准的准确率降到 +1.17 pp,因此它既改变非零信号数量,也改变接口可预测性。Residualized 先减去各 harness 在其他任务上的平均分,再按任务混合标准化;基准来自全部 1,008 题,其中多数全失败,训练却只用 183 个混合结果任务,分布不匹配。调整后接口仍可预测,超出基准 +4.54 pp。两项对照相对 Cross 的未见接口差值为 −0.28、−0.03 pp,置信区间都包含 0;不能据此说已经单独检验并排除了某个原因。
动作分析比较的是 SFT 与 Cross,没有比较 Within 与 Cross。规则程序给每个 assistant turn(模型的一次回复)一个优先级最高的动作标签,顺序为提交、编辑、写文件、测试、运行脚本、搜索、读取等;同一回复先编辑再测试,会只记为编辑。各次执行内先算动作占比,再对题目取平均。因此 weak-ReAct 的测试主标签占比 0.6% 不表示几乎没有运行测试:允许一条回复记多个标签后,SFT / Cross 的测试占比为 3.2% / 2.9%。(Appendix C.2)
作者用 Jensen–Shannon divergence(JSD)衡量两组动作频率分布的差异,单位 bit,0 表示分布相同。同一模型换接口的六组两两比较在 0.174–0.350 bit;同接口比较 SFT 与 Cross 只有 0.0003–0.0029 bit。160 条回复人工抽查中错标 11 条,其中 8 条来自 SWE-agent。频率接近不代表每一步决策一样,也不评价动作是否正确。它只能辅助说明动作组成对接口敏感,迁移结论仍要看隐藏测试成绩。
4.4 重采执行记录后,结论是否改变?
论文额外训练了一条 re-collected Cross:前半程重放冻结数据;中途让当前模型通过四套 harness 重跑原来的 183 题,其中 131 题仍同时出现成功与失败,供后半程更新使用。新数据第一次更新时,概率比与 ESS 均为 1.000,因为它刚由这个模型采集。未见接口的 avg@4 为 4.85%;较离线 Cross 高 +0.13 pp [−0.85,+1.10],较 Within 高 +0.75 pp [−0.10,+1.65],仍没有显著差异。它只检验 Cross 的一次中途重采,不是 Within 与 Cross 的持续在线训练对照。
Appendix A.4 披露了作者排查过的五类故障:不同条件共用容器导致代码相互污染,服务还没注册模型便返回 404 导致受影响批次约 20% 执行被跳过,严格 UTF-8 解码使评分器崩溃,容器 Git 损坏,以及镜像缓存不全导致每轮固定停在 25 题。作者说修复并重新验证后才纳入分析;原始材料未公开,本解读不能独立证实修复效果。
5. Discussion:对完整 coding harness 研究的实验建议
训练报告应分别写清模型见过什么接口、分数怎样分组、原接口涨多少、未见接口涨多少。 一个多接口总分无法区分这些因素。
后续优先做四组对照:
- 用 Claude Code、Codex CLI、OpenHands 做完整的训练接口 × 评测接口矩阵,固定模型、任务、预算和评分程序。
- 比较整题二值分数与工具级、阶段级反馈,检验更细的归因是否有助于换接口。
- 若要扣除接口本身的平均分偏移,在实际训练任务分布上验证调整确实有效,再检验迁移;预测回报的 value model 可以作为另一种对照。
- 增加多个未见接口,分别改提示格式、工具名称、上下文规则和错误恢复策略,定位哪一层阻碍迁移。
产品评测也应一起记录模型、harness 名称和版本、工具格式、尝试次数和评分程序。同一模型换执行接口,成功率和动作分布都可能明显改变。
6. Conclusion:负结果的价值与适用范围
值得保留的是受控比较,结论须限于这组数据、模型和接口。作者区分了原接口增益、未见接口增益、分组规则差异,并报告了随机种子、有效题目集合和检出能力;这比只给一个总分更容易判断证据。
对 Claude Code、Codex 相关研究,这篇最有用的是实验问题的拆分:在原流程中训练得更好、换流程后仍然更好、仅改变分组就能更好,是三项需要分别证明的主张。本文没有为最后两项提供稳定的正证据,也没有证明多接口 RL 无用。
留言