HarnessDev 研究的是:模型能否先写出一套让其他模型做任务的程序,再根据运行结果继续改进它。作者只提供能启动、调用模型和保存日志的最小代码。被测模型补齐工具调用、上下文管理、结束条件等功能后,作者冻结程序,再让它执行软件修复、终端操作、机器学习实验、写作和搜索任务。交付物是可以反复使用的 Agent 程序,不是某一道题的答案。
1. Motivation:从“会做题”到“会写做题的系统”
固定 harness 的评测,不能回答模型是否会开发 harness。普通 Agent benchmark 给定工具和调用流程,然后看模型完成多少题。现实中的开发者还必须决定:如何保留历史,工具报错后怎么办,什么时候检查结果,模型说“完成”后是否应该马上退出。
这不是无关紧要的配置。论文引用的 Terminal-Bench 2.1 结果中,同一个 GPT-5 在 Terminus 2 下通过率是 35.2%,在 Codex CLI 下是 49.6%。这里没有训练模型权重,差别来自外部运行程序。HarnessDev 因而把这段程序本身变成评测对象。
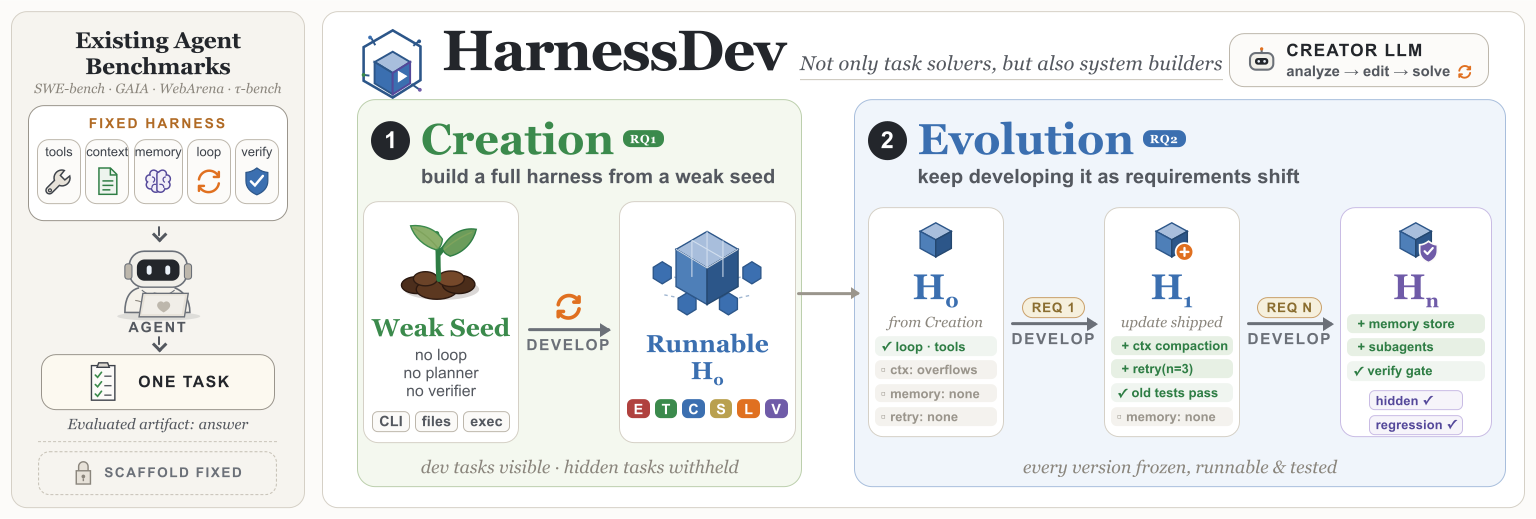
与普通软件修复相比,难处还在于反馈不直接。某次结束检查可能帮助一个模型,却干扰另一个模型;开发题上的高分也可能来自偶然成功。论文同时测任务成绩、执行 token(模型处理的文本单位)、未见任务上的表现和换 executor 后的变化,避免只凭“程序能启动”判断它已经成熟。
2. Related Work:创建、修复与演化不是同一道题
最接近的区别是:是否从一个现成 Agent 开始,以及是否测试整条修改历史。HarnessDev 把从零创建与反馈驱动演化接在一起,并分别看自用模型和统一执行模型。
| 工作 | 开发者拿到什么、交付什么 | 如何检查改进 | 与 HarnessDev 的主要区别 |
|---|---|---|---|
| Meta-Agent Challenge | 任务说明 → 可执行 Agent 文件 | 开发接口、保护起来的最终测试 | 接近 Creation;没有在本协议中跟踪自己产物的持续演化 |
| HarnessOpt-Bench | 固定初始 harness → 一个选定版本 | 开发轨迹、验证总分、不可见测试上的归一化增益 | 最接近 Evolution;主要优化给定起点,而非连接 Creation 与 Evolution |
| Evo-Bench | 以生成和执行代码调用工具的 CodeAct 结构为公共起点 → 最终修改版本 | 固定 executor、多领域保留集、评测噪声校准 | 侧重最终版本跨领域表现;HarnessDev 还对每个正式中间版本测保留集 |
| Self-Harness / HarnessFix / Harness-R1 | 现成程序、失败记录 → 局部或模型专用修复 | 回归测试或训练奖励 | 提出修复方法;HarnessDev 提供比较通用前沿模型开发能力的协议 |
VeRO 的重点是版本化、预算控制和执行记录等实验基础设施;Meta-Harness 的重点是如何利用历史候选、成绩和轨迹提出下一次修改。它们能作为优化方法或开发工具参加这种评测,但不能因此替代 benchmark 的信息隔离和最终测试。
3. Benchmark / Protocol:两阶段协议:开发者看见什么,一次提交如何给分
先理解冻结与判分,再看创建和演化的成绩。creator 能编辑的是自己的 harness;隐藏测试、标准答案和评分程序不在可编辑范围内。
3.1 任务从哪里来,最小代码提供什么
作者沿用五个公开 benchmark 的任务和原生评分规则,没有另起一批人工编写的下游题:SWE-bench Pro 公共分区 731 题,Terminal-Bench 2.1 为 89 题,MLE-bench 为 75 个竞赛,EQ-Bench3 为 46 题,BrowseComp 为 1,266 题。总计 731+89+75+46+1266=2207,覆盖四个领域;软件修复和终端操作同属 Code 领域。
作者额外提供的是 harness 开发合同、弱初始代码和 1–3 个开发案例。附录 C/E 展示了接口与系统提示词,但没有公开全部任务专用提示、完整检查文件或逐题原始记录;开发案例怎样筛选、是否由多人独立复核,也没有单独报告。
初始代码只保证 python -m harness 能接收任务与模型配置,执行基础文件或进程操作,并保存日志。它最多做一次不执行任务的模型调用,然后返回 partial。真正的多轮工具调用、历史压缩、失败恢复、持久状态和结果检查,都要由 creator 实现。
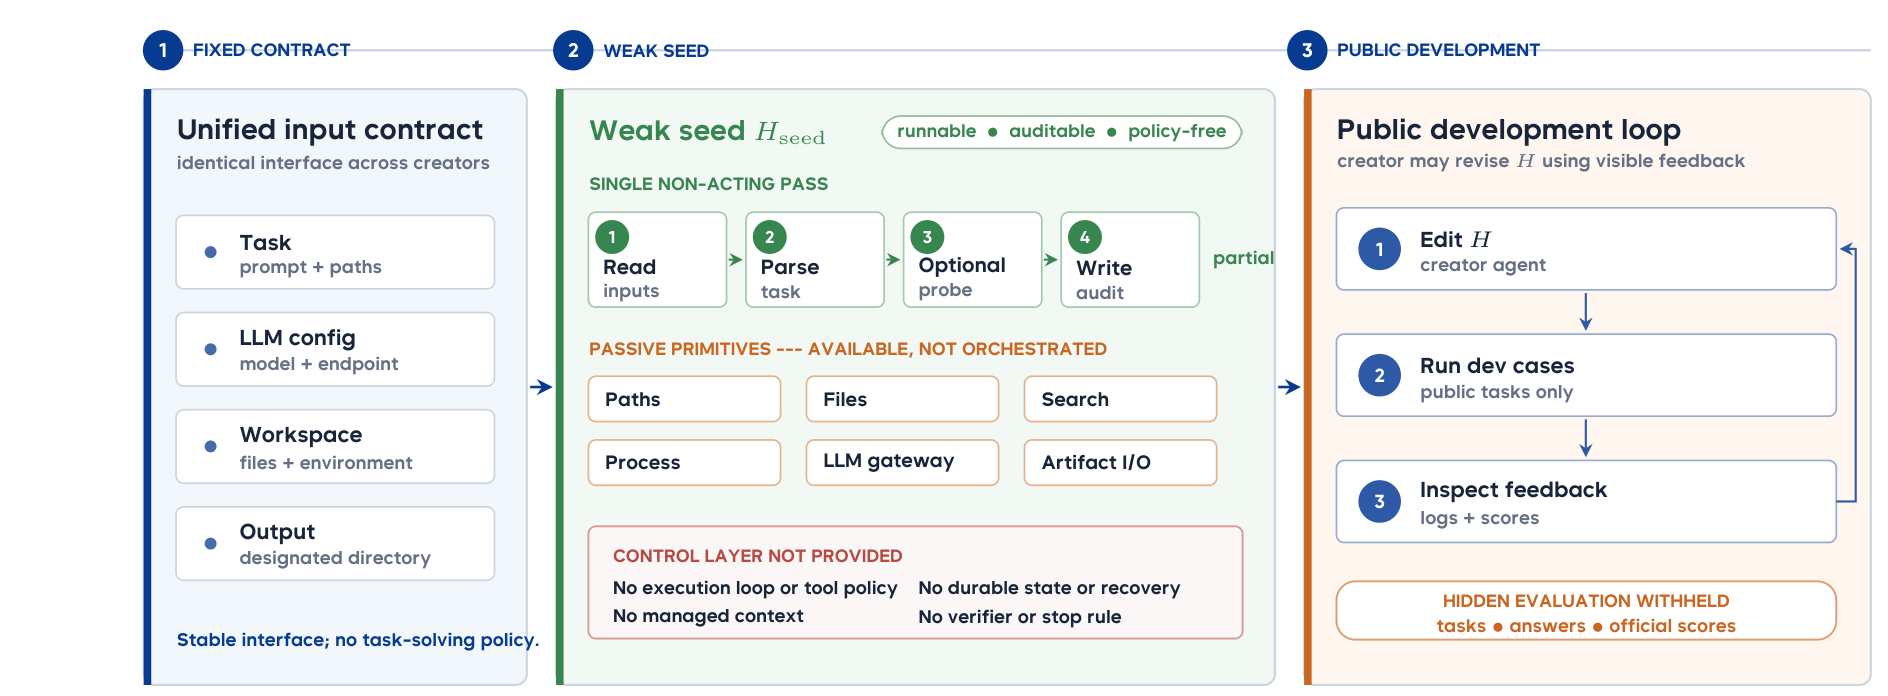
Creator 可以保留、替换或删除初始代码,但必须保留调用入口和产物要求。result.json 是 harness 写出的状态与文件路径记录,trajectory.jsonl 是逐步行动和观测日志;这些文件来自作者规定的输出格式,不是隐藏测试,也不由被测程序给自己评分。
3.2 一次正式运行的完整路径
- 冻结评测执行程序保存指定 commit 的代码快照。后续工作目录里的修改不会自动进入已经启动的容器。
- 执行executor 收到任务、工作目录和允许使用的工具,通过冻结 harness 调用模型、修改文件、运行命令,留下执行日志。
- 交付SWE-bench Pro 读取任务仓库中的真实 diff;Terminal-Bench 检查最终环境状态;MLE-bench 读取竞赛提交;写作和搜索分别读取正文、答案与证据。
- 外部判分原 benchmark 的 evaluator 给出任务成绩。程序报告 success、写出非空补丁、调用过测试,都不能代替它。
创建阶段的隐藏题与成绩不回传给 creator。演化阶段的指定反馈题可以返回任务分数、运行诊断和原始文件路径,但标准答案、隐藏测试与评分器内部实现仍不可查看。score=null 表示还没有判定,不能算成失败;没有启动或没有完成的基础设施诊断,也不能作为正式成功或失败记录。
预算也要按角色区分。附录 B.1 给 MLE-bench 的每个下游任务配置一张 A800 80GB GPU、14 个 CPU 核和 227 GiB 内存,限 500 步、36,000 秒;其中 34,200 秒给生成的 Agent,1,800 秒留给外部 grader,数据准备不计时。演化阶段的每道 SWE/Terminal 题限 500 步、7,200 秒。这些是 executor 做一道题的限制,不是 creator 修改整套程序的总时限。附录 E.2 对 creator 使用正式评测次数限制,没有设置总等待时限,但设有长期无活动的结束规则。
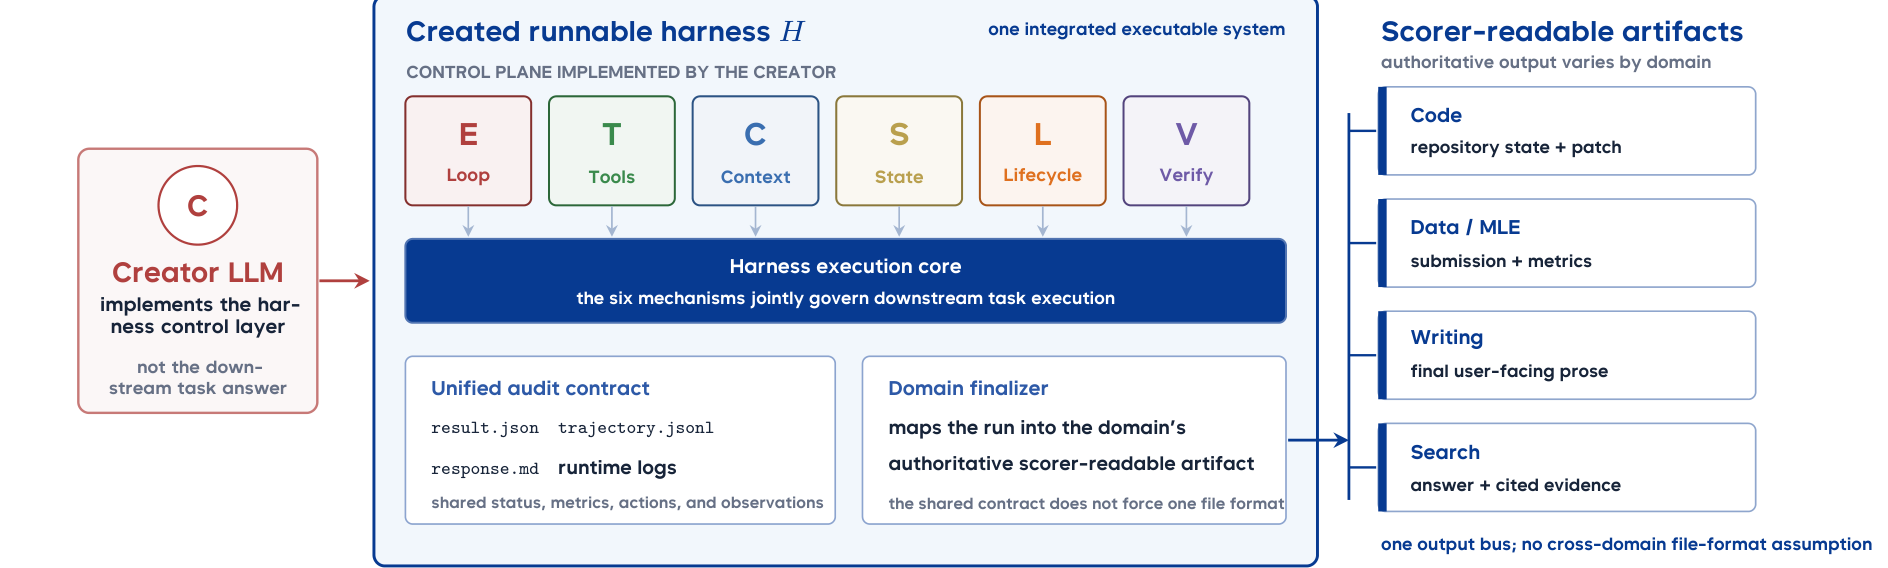
result.json 等文件记录执行过程;右侧的补丁、竞赛提交、正文或答案才是各领域评分程序读取的产物。Yuhao Wu 等,原论文,CC BY-NC-ND 4.0。3.3 真实案例:写出了文件或补丁,为什么仍可能失败
真实开发题:同样写出 /app/gpt2.c,为什么分数不同
论文附录 F/G 保留了两次 Terminal 开发运行。能确认的任务目标是编写并编译 /app/gpt2.c;完整任务 prompt(任务提示词)和逐项隐藏 assertion(必须满足的检查条件)没有发布,因此不能还原 verifier 的具体测试步骤。
- GPT-5.5 的运行
dev-20260804-190052创建、编译/app/gpt2.c,等待官方 verifier 完成后得到1.0。通过发生在外部 verifier 检查最终环境之后。 - Opus 的另一开发运行也写出了该文件,执行了 94 步和 81 次 Bash 调用,但 verifier 给
0.0。公开记录没有指出哪条隐藏检查失败;文件存在和编译动作都不能单独构成 PASS 条件。
GPT 在通过的运行启动后,又修改了重复命令的去重规则。运行中的容器使用启动时冻结的旧代码,所以 1.0 不能归因于这次后续修改。这两条是作者公开的运行记录,不是本文独立重跑。
另两条记录:本地文件检查与 SWE 补丁
GPT-5.5 的本地检查先暴露了产物记录缺陷:模型在非 Git 目录创建了文件,patch.diff 仍为空,harness 因而报告 partial。修正文件路径记录后,模型创建内容为 OK 的 result.txt,日志显示两次模型调用、两次工具调用和一次写文件,状态变为 success。这只验证了普通文件的交付路径。
Opus 的正式 SWE 开发题从 Ansible 仓库开始。Executor 找到 shebang(脚本首行指定解释器的声明)相关逻辑,修改源文件和 changelog,并执行 pytest 与 import 检查;记录有 38 步、19 次 Bash 调用和约 5.9K 字符的非空补丁,原 SWE grader 仍给 0.0。具体失败的隐藏 assertion 未公开。
3.4 演化:同一份代码必须完成两套正式评测
Evolution 从自己的创建版本 H0 开始。作者先评 H0,这次不占额度;之后 creator 最多花 10 个正式评测对的额度。每对冻结同一 commit,同时运行 100 道 SWE-bench Pro 反馈题与全部 89 道 Terminal-Bench 题。两边都完成,代码才成为正式版本。一边启动或运行失败仍会占用额度,但同一 commit 补跑缺失的一边不额外收费。不完整的版本不能作为最终声明,也不进入正式版本统计。
两次正式提交之间最多用两个固定小检查,每次只跑两套题的前五题,论文称为 probe。它们用于检查程序是否崩溃或明显退化,不进入正式得分。一道题就能让五题 probe 改变 20 个百分点;即使五题全对,也不能替代完整评测。
两套反馈成绩的平均是 P=(SWE100%+Terminal89%)/2,不是把 189 题直接合并。结束后,作者再把每个正式版本放到另外 630 道 SWE 题上运行,分数不回传。论文说这 100 与 630 道题都来自创建阶段的 731 题公共分区,但没有解释剩下的一题为何不进入两者。
3.5 统计口径:67.8 怎样算出来
创建阶段为每个“creator × benchmark”独立创建三份程序,报告三份成绩的平均,记作 avg@3。每项沿用原指标:软件/终端看任务通过率,MLE 看达到竞赛奖牌线的比例(medal rate),写作看按评分项给出的分数(rubric score),搜索看答案准确率。
Table 3 的 Avg. 不包括 MLE-bench。Opus 为 (69.3+64.8+84.6+52.4)/4=67.775,四舍五入得 67.8;参考行为 (80.0+88.8+83.7+92.2)/4=86.175,得到 86.2。因此它既不是五项平均,也不是 2,207 题的统一通过率。执行成本统计 executor 做题消耗的 token;creator 开发、外部 judge 和小规模 probe 的消耗分别记录,不包含在这个执行成本中。
4. Experiments:局部进步与通用改进相差多远
模型已经能写出可运行系统,但“更会做题”“模块真的起作用”“修改能迁移”是三件不同的事。六个 creator 为 Opus 4.8、GPT-5.5、Gemini 3.1 Pro、DeepSeek V4 Pro、Qwen 3.7 Max、Seed 2.0 Pro。除 GPT-5.5 在 Codex 0.144.3 中开发,其余使用 Claude Code 2.1.177;所以自用成绩同时包含模型、程序及二者配合的影响。
4.1 创建结果与运行时审计
自用模型下,Opus 的四项均分最高,为 67.8,低于人工工程参考 86.2。后者是不同 harness–model 系统的参考,不是同一 executor 的配对控制:软件、终端和搜索带星号,是没有在本实验重跑的外部结果;MLE 与写作有本实验运行值。不能把差距全部归因于生成 harness,也不能把写作超过参考解释为超过人类。
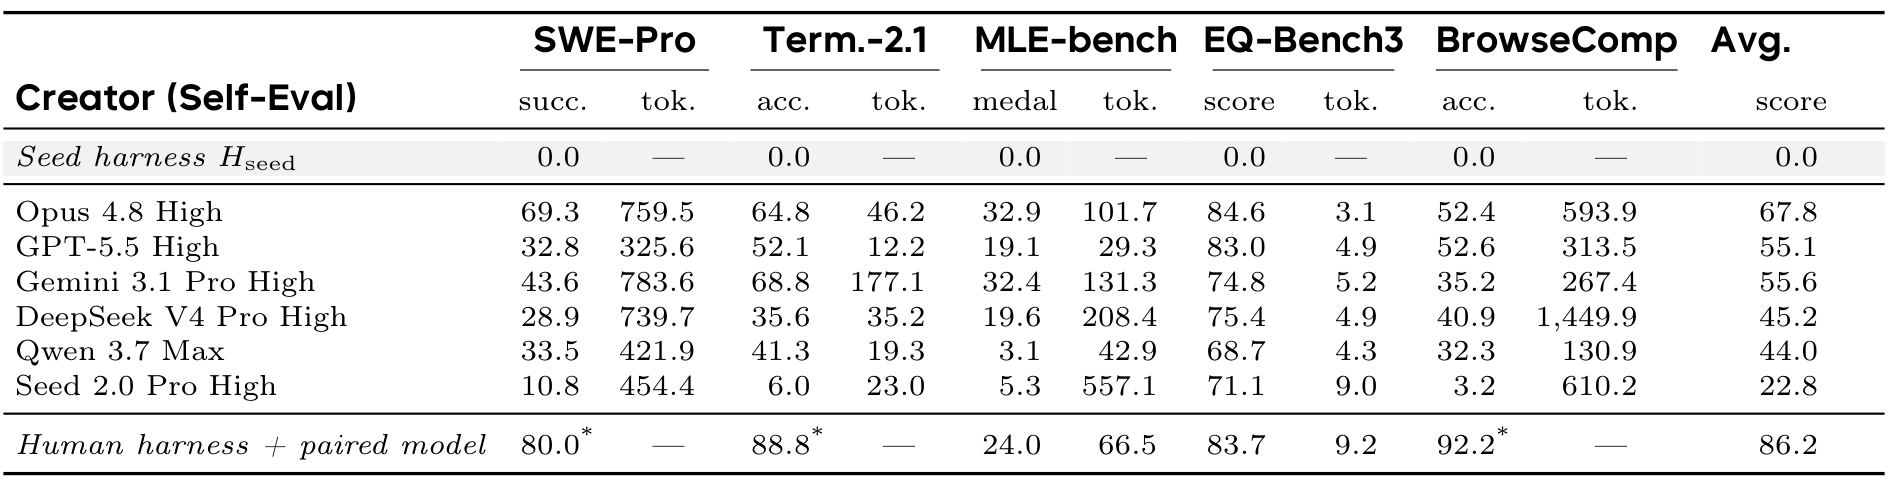
avg@3;tok. 为每份程序的平均执行 token(百万),Avg. 不含 MLE-bench。星号是未在本实验重跑的外部参考。Yuhao Wu 等,原论文,CC BY-NC-ND 4.0。18 份 Code harness 都有执行循环,共增加 17,111 行代码。作者没有止于检查类名:在 26,679 条任务轨迹中审计 108 个组件实例,72 个有完整运行证据,18 个只有部分证据,18 个完全没触发,未触发项全属状态或记忆功能。11 份代码定义了 State 类,却只有一份暴露保存接口、一份实现周期检查点;正式轨迹里没有任何保存检查点的事件记录(checkpoint event)。
4.2 换执行模型后的退化,不要误读成单份程序成绩
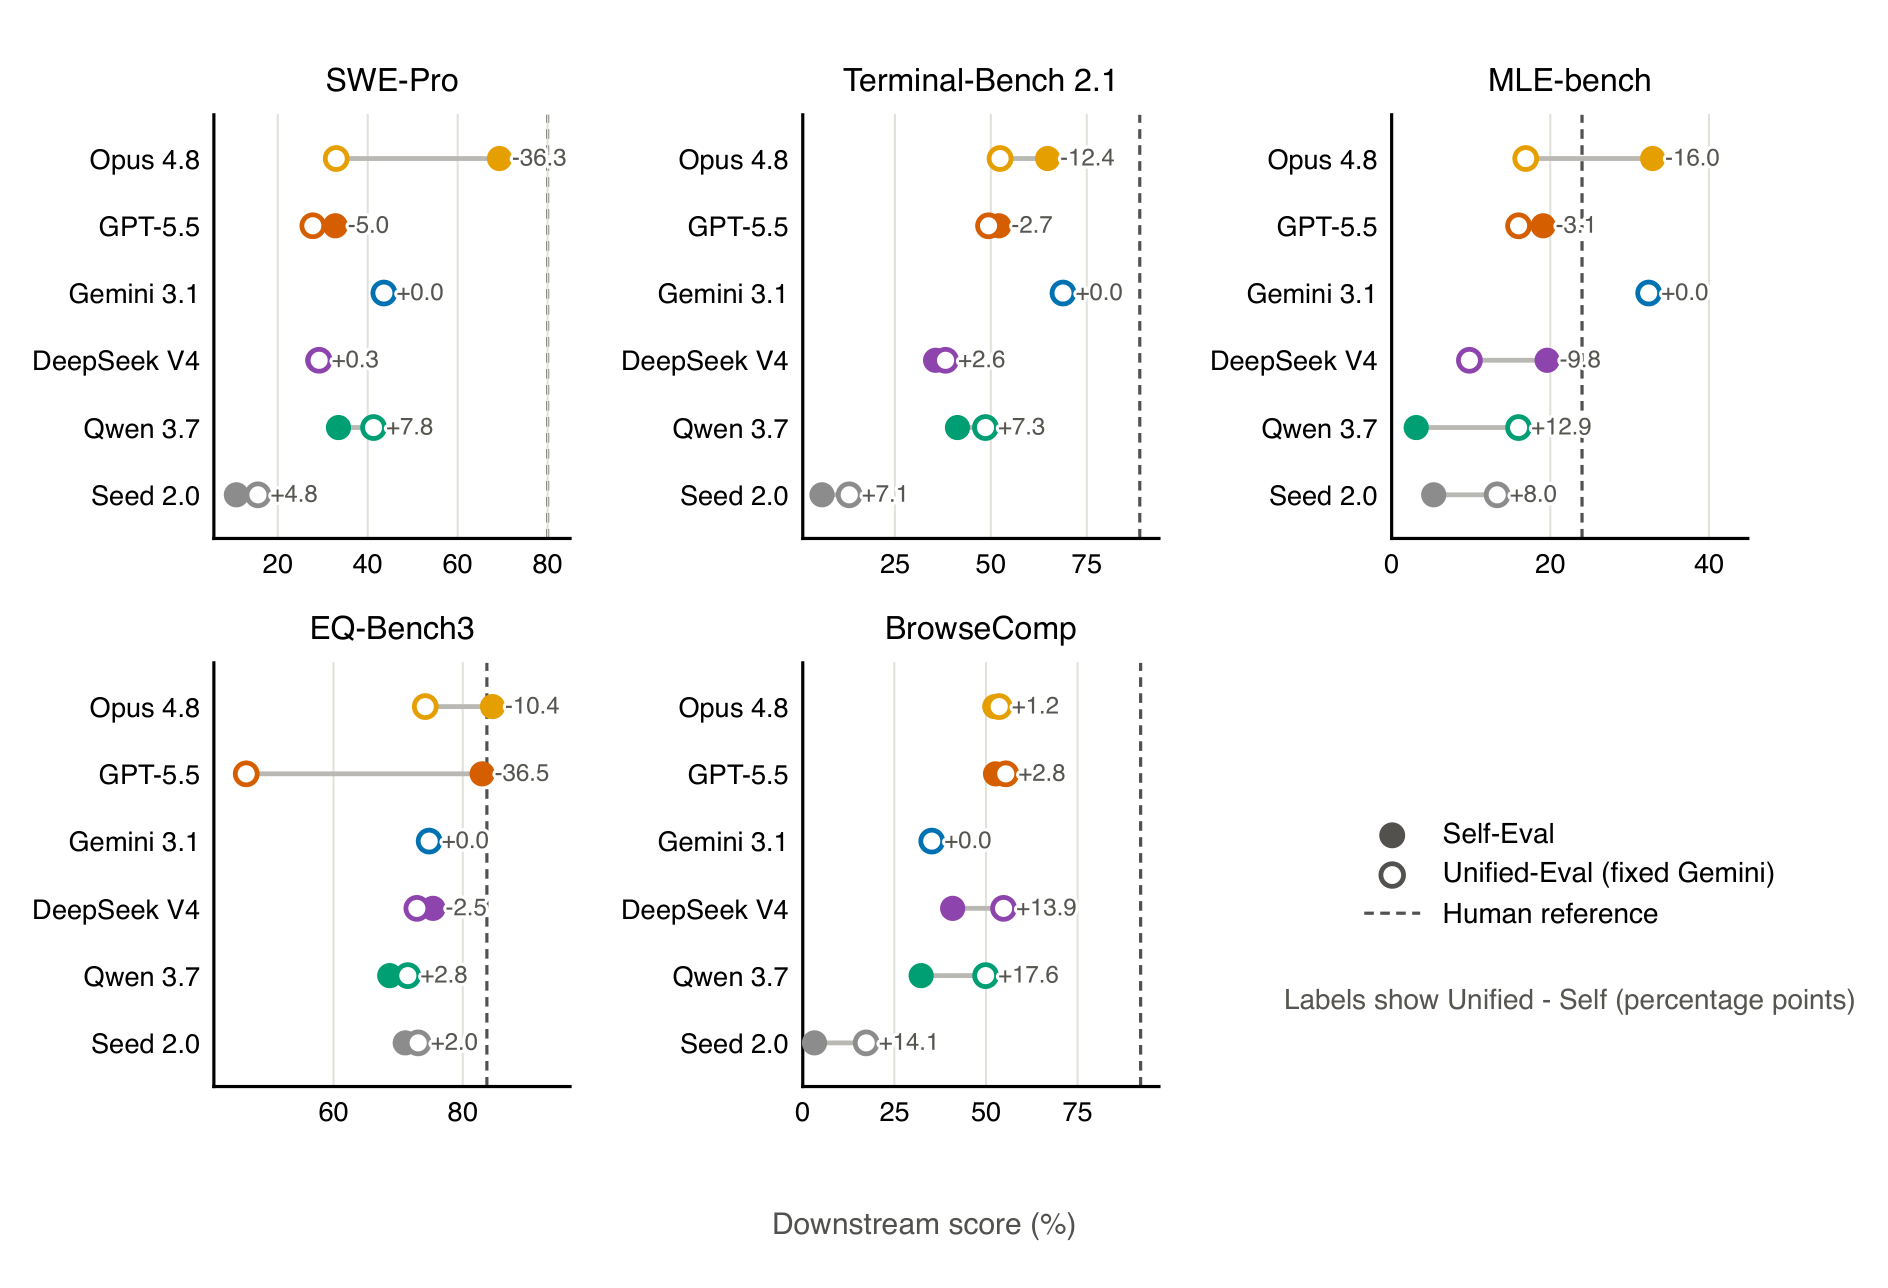
保持已创建代码不变、统一换 Gemini 后,Opus 的 SWE avg@3 从 69.3 降到 33.0。这里是三份程序的平均,不是某一份 harness 的两次成绩。Table 4 特别标注:第三份程序完全退化;事后去掉它,剩余均分为 49.1。后者只是敏感性分析,不能取代预先规定的 33.0。
论文把硬编码的 120 步限制列为退化机制之一。Search harness 中,换模型后的重复查询率从 10.1% 变成 88.2%,也说明去重、审阅和退出策略依赖原模型的行为。只证明接口兼容,不代表控制策略已经迁移。
4.3 一条完整演化记录:诊断、修改、重评、选择
附录 I 的 Opus 轨迹从 SWE 68/100、Terminal 66/89=74.157% 开始。Creator 没把事件流中的空分数当失败;它回到原始结果,发现 32 道 SWE 失败中约 10 道涉及构建、编译或 import。接下来三次正式修改如下:
| 版本 / commit | 新增行为与证据 | SWE100 | Terminal89 | 两项均分 |
|---|---|---|---|---|
| H0 | 原创建版本 | 68.0 | 74.157 | 71.079 |
| T1 / 9d6f78e | 改完必须执行检查,再允许结束;异常或超时也保存交付物 | 73.0 | 75.281 | 74.141 |
| T2 / 881b01b | 给模型真实 git diff,要求一次提交前审阅 | 75.0 | 73.034 | 74.017 |
| T3 / 76de0e6 | 记录非 Git 文件和命令产物,终端任务也做最终审阅 | 74.0 | 74.157 | 74.079 |
模型最后选 T3,不是因为它的平均分最高:T1 高约 0.06 个百分点,三版通过的总题数都相同。它选择较平衡、检查覆盖较完整的版本,并拒绝用七次剩余额度反复采样碰运气。这是有诊断过程的改进记录,但每个版本只是一条演化轨迹,不能把微小分差当成可靠因果效果。
全体结果更谨慎:自用模型的五条轨迹在 630 题上提高 1.43–4.44 个百分点,平均 +3.11;换成固定 Gemini 后,只有 Opus 仍提高,GPT-5.5 反而从 42.22 降到 31.90。64 次正式相邻修改中,反馈与保留集变化方向一致的只有 34/64=53.1%,最终所选版本是保留集最好版本的只有 2/9。可见分数适合指导局部搜索,不足以保证选对最终版本。
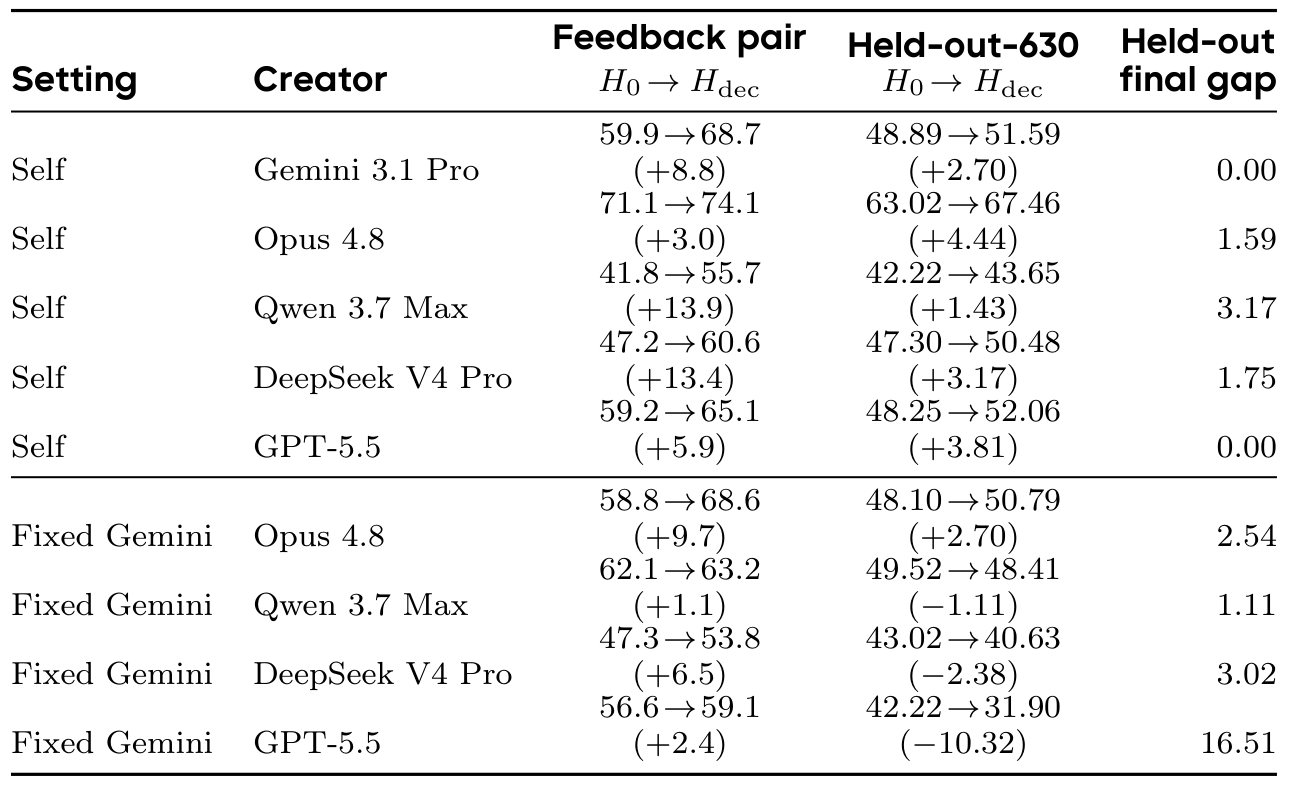
Feedback pair 是 100 道 SWE 与 89 道 Terminal 的通过率等权平均;Held-out-630 只含未回传的 SWE 题。固定 Gemini 下,GPT-5.5 行的反馈提高 2.4 点,保留集却下降 10.32 点。Yuhao Wu 等,原论文,CC BY-NC-ND 4.0。单个版本重跑时,两项均分可波动约 ±4.75 个百分点。64 次修改中,27 次表面上涨仍落在重复运行的波动范围内,只有两次有超出该范围的明确正向证据。这不是说其他改动都无效,而是现有重复次数不足以把这些小幅上涨归因于代码。
5. Discussion:哪些实验能分清真实改进与偶然高分
最需要补的是同条件对照和重复演化,而不是继续统计代码量。第一,统一 executor、开发预算和工具,把生成 harness 与成熟人工 harness 配对重跑,才知道系统差距有多少来自代码。第二,对同一个版本重复评分,并把更多 creator–executor 轨迹作为独立重复,避免把一次幸运运行当改进。
第三,保留集应覆盖终端、搜索和数据实验,而不只 SWE。当前 Evolution 的最终泛化证据来自软件修复,不能据此宣称所有领域的 harness 都能持续变好。第四,状态保存和恢复要通过实际中断任务来测试:要求文件写入、重启读取、工具输出和最终产物仍一致,不能用 State 类存在代替恢复能力。
这些是本文根据结果提出的下一步,不是论文已经验证的能力。项目页在已有核验记录(2026-10-08)中可访问,但未提供独立的完整 HarnessDev 代码、任务包与 checker 下载;论文附录公开了合同和案例摘要,不等于完整可复现 release。
6. Conclusion:怎样使用这篇论文
它的价值是把 harness 开发拆成可检查的过程,并暴露“能运行”与“能稳定改进”的距离。创建阶段说明模型能补齐不少运行功能;换模型和保留集测试说明这些功能常与原 executor 或反馈题绑定;运行日志审计又揭示部分状态与记忆代码根本没有起作用。
阅读时值得保留三个方法:creator、executor、evaluator 分开;候选在评测前固定快照;结果报告中同时放真实任务得分、运行证据和未见任务表现。最重要的保留意见是:人工参考并非统一条件控制,Evolution 每个配置只有一条轨迹,隐藏检查文件与完整案例尚未公开。因此这是开发能力的系统性评测,不是“自动演化已经胜过工程师”的证据。
主要来源:arXiv:2609.01437v1,§§3–6、Tables 2–7、附录 C–I。上面的案例与 commit 记录来自论文附录,本文没有获得隐藏 checker 或独立重跑数据。项目代码可用性的既有核验日期为 2026-10-08。
留言