如果把 Claude Code 或 Codex 周围的 prompt、memory、retrieval、tool loop 都视为可编辑代码,谁来调这套代码?Meta-Harness 的答案是:再放一个 coding agent 在外层,让它读取历次候选的源码、分数和原始执行轨迹,提出下一版 harness;但候选能不能运行、得多少分、哪些结果可以进入最终测试,仍由独立程序控制。
Q1. 为什么已有 prompt optimizer 不足以处理完整 harness?
因为 harness 的错误往往隔很多步骤才显现,而现有优化器通常在 proposer 看见历史之前就把反馈压缩掉了。 一次 retrieval 选错例子,可能直到十轮以后才表现为错误答案;一次 completion-state 修改,可能让已经完成任务的 Agent 又重复验证几十步。单个 scalar score 只能告诉 proposer “变差了”,不能告诉它哪段状态转换造成了回归。
论文估算,已有 text optimizer 每次迭代提供给 proposer 的反馈规模大约在 100 到 30,000 tokens,而最重的 harness 评测一次可以产生约 1,000 万 tokens 的诊断材料。Meta-Harness 不把这些内容硬塞进一个 prompt,也不先写成摘要。它把每个候选的 source code、score、model output、tool call 和 state update 放到文件系统里,让 coding agent 用 grep、cat、脚本和局部读取主动取证。
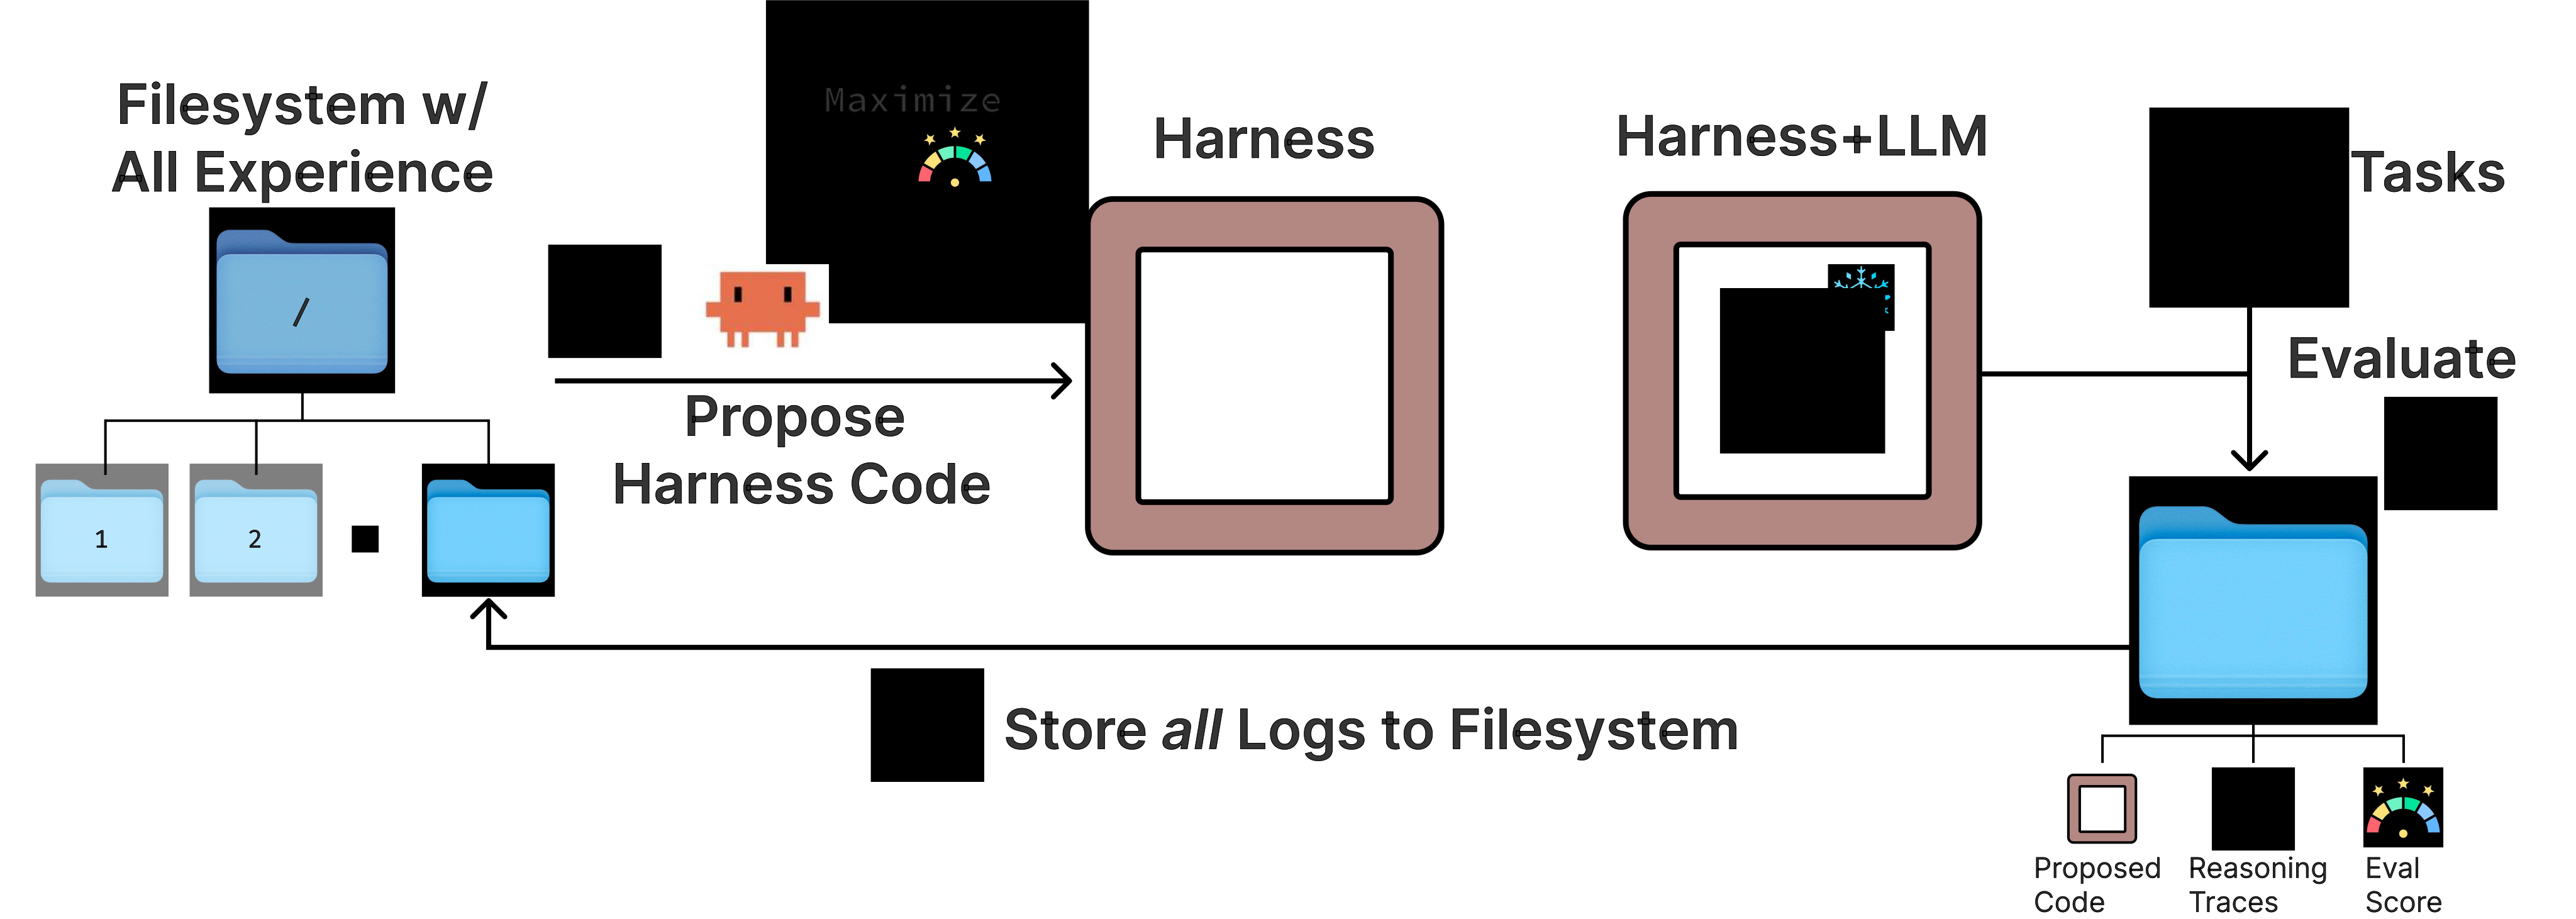
TerminalBench search 的读取记录说明 proposer 确实使用了这套历史:十轮里,每轮读取 69 到 99 个文件,中位数 82 个;其中 41% 是旧 harness 源码,40% 是 execution traces,只有 6% 是 score 或 summary 文件。它会跨候选查证,不是只在最新版本附近做局部修改。
Q2. 它与 GEPA、OpenEvolve、TTT-Discover、ACE/MCE 和共同进化方法差在哪?
Meta-Harness 的位置可以用三条轴看清:优化对象是完整代码,反馈是跨 population 的 raw history,模型权重保持冻结。 它没有发明复杂的 parent-selection rule;population 与 Pareto frontier 由外层保存,但读哪个旧候选、改哪一层、做局部 patch 还是整体重写,交给 coding agent 决定。
| 工作 | 优化对象 | 反馈接口 | 与本文的关键边界 |
|---|---|---|---|
| GEPA | prompt / text artifact | 单候选 rollout 的 reflective feedback / summary | 反馈比 scalar 丰富,但没有让 proposer 自由检索全部候选的 raw traces。 |
| AlphaEvolve / OpenEvolve | 指定函数或可执行程序 | program database + evaluation scores | 同样搜索 code;Meta-Harness 强调完整诊断历史,而不是固定 mutation operator。 |
| TTT-Discover | test-time artifact | 最近 solution fragment + PUCT reuse | 更依赖手写搜索结构;本文让 proposer 自己选择证据与 edit granularity。 |
| ACE / MCE | 在线 memory 或 natural-language skills | 样例、反思与技能库 | 它们是分类实验里的手写 harness baseline;Meta-Harness 搜索产生新的 retrieval / prompt program。 |
| HarnessForge / Co-Harness | harness 与 model weights | 失败归因 + 成功 trajectory | 最终产品是共同进化的 model/harness pair;本文只改 harness,因此产物更容易跨 base model 复用。 |
Table 3 直接检验了这条边界。在线分类 search 中,scores-only 的 candidate accuracy 中位数 / 最优值为 34.6 / 41.3;加入 LLM summary 后是 34.9 / 38.7;保留 raw execution traces 的完整版本达到 50.0 / 56.7。这些数字来自 search-set candidates,并非最终 test score。结果表明,一段看似合理的总结不能代替可回溯证据。
Q3. 从一个旧候选到一版新 harness,具体经过哪些步骤?
3.1 主循环的责任边界
- 1 · READProposer 检索历史 code、scores 与 raw traces。
- 2 · DIAGNOSE它提出失败原因与可证伪改动。
- 3 · WRITE生成新的单文件 Python harness。
- 4 · VALIDATE外层程序先做 import / interface check。
- 5 · EVALUATE固定 base model 在 search tasks 上运行。
- 6 · LOG新 code、score、trace 进入 filesystem。
论文中的一个典型 run 约 20 轮、评测 60 个候选。多目标场景不先把 accuracy 与 context cost 压成单一分数,而是保留 Pareto frontier。Test result 不回传给 proposer;最终只对 search 阶段留下的 frontier 做 test evaluation。
官方 classification release 把这些责任分得很清楚:meta_harness.py 先调用 Claude Code proposer,读取 pending_eval.json;随后单独 import-check 每个候选,再由 benchmark.py 评分、更新 frontier。--test 是显式 finalization 路径。这里的 test 隔离是运行协议,不靠访问控制实现。公开仓库中仍有 test data,复现实验时必须保持同样的流程纪律。
3.2 一个真实搜索 case:为什么 iteration 7 才找到有效方向
TerminalBench-2 的搜索日志给出了一条完整的因果链。起点 Terminus-KIRA 的 search score 是 64.4%。Iteration 1 同时做 marker stripping、loop breaker、prompt cleanup 和 checklist,降到 58.9%;Iteration 2 改 completion state machine,却继续沿用新 prompt,降到 57.8%。
到了 iteration 3,proposer 没有简单判断“结构修复无效”,而是发现两个失败候选共享的是 cleanup-heavy prompt:它会让 Agent 在任务真正结束前删除仍有用的状态。于是 iteration 3 恢复原 prompt,只保留 structural fixes,分数回到 63.3%。这仍低于 baseline,但回归大幅缩小,支持了 confound diagnosis。
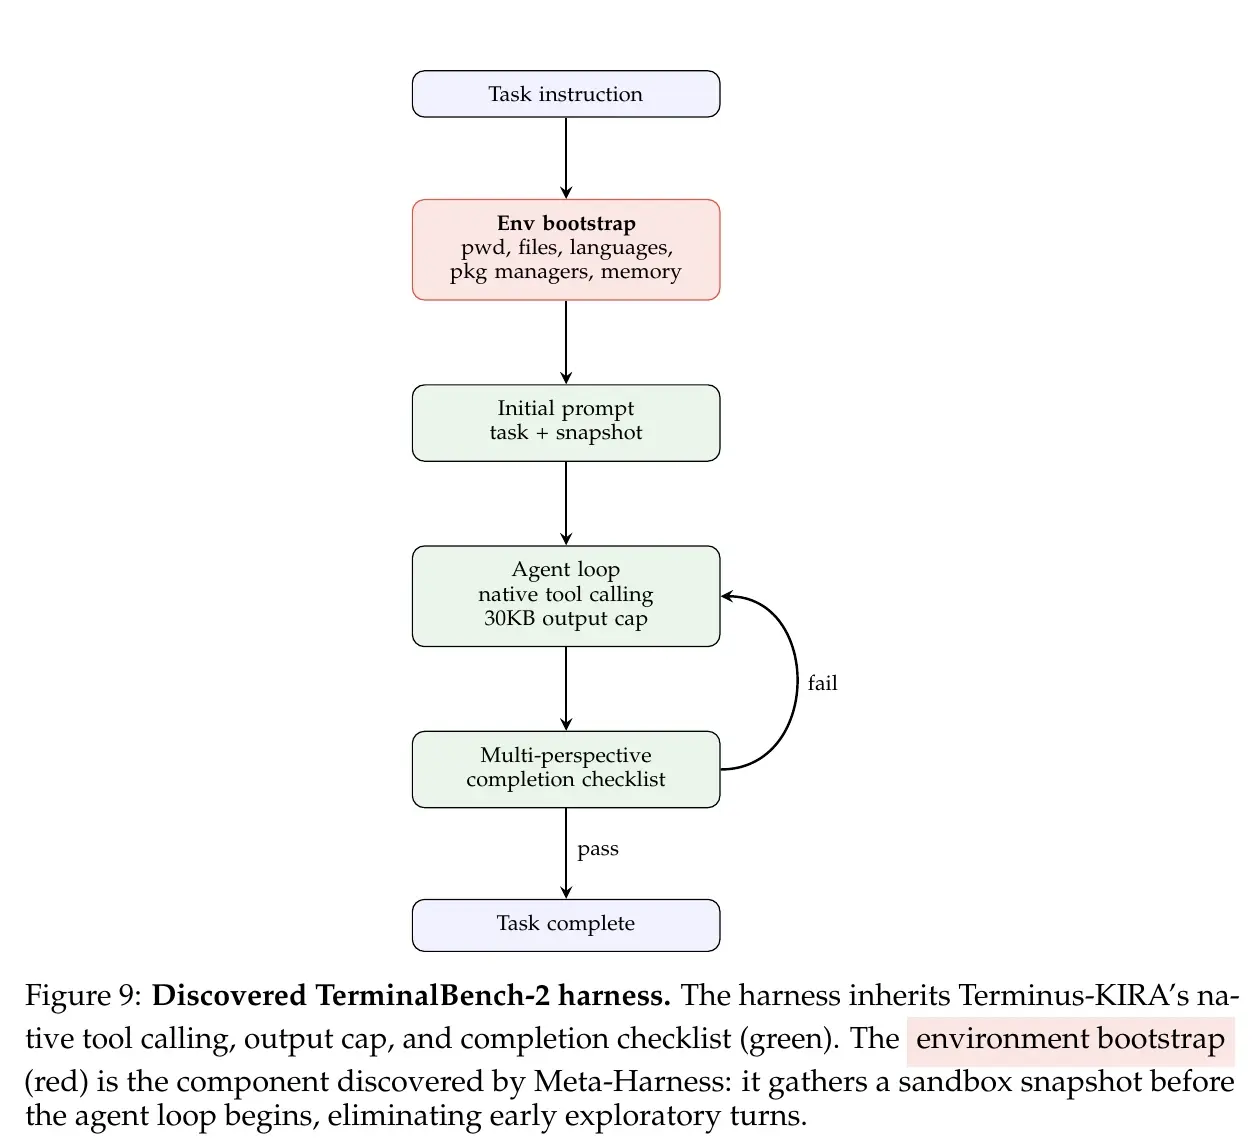
Iterations 4 到 6 又尝试 completion flag 修复、弱化 cleanup 语言和 smart waiting,仍然回归。Iteration 7 因而换了策略:不再碰已知脆弱的 prompt、completion flow 或 observation processing,只在第一次模型调用前追加环境快照。 Proposer 根据前六轮失败,把改动从“重写控制流”收缩为“额外提供信息”。
官方 artifact 中 `_gather_env_snapshot()` 到底收集什么
- 运行 `pwd`,列出 `/app`;超过 25 行时只保留前 20 个条目和剩余数量。
- 查询 Python、GCC、G++、Node、Java、Rust 与 Go 版本。
- 查询 `pip3`、`pip`、`apt-get` 与可用内存。
- 内部命令超时 15 秒;外层 `asyncio.wait_for` 超时 20 秒。
- 成功时把 `[Environment Snapshot]` 追加到 initial prompt;任何异常都返回空串或被捕获,Agent 回到原本的探索路径。
# 官方 agent.py 的忠实节选;为阅读删去 section parsing
result = await asyncio.wait_for(
    env.exec(command=bootstrap_cmd, timeout_sec=15),
    timeout=20,
)
snapshot = "[Environment Snapshot]\n" + format_sections(result.stdout)
if snapshot:
    initial_prompt = f"{initial_prompt}\n\n{snapshot}"
# 异常时 silent fallback,不阻断原 agent loop
这段改动让 Agent 少花 2 到 4 个 turns 用 ls、which python3 之类的命令摸环境,尤其帮助依赖 bioinformatics library、rendering pipeline、chess engine 或 crypto utility 的任务。论文报告,相比 Terminus-KIRA,它在 89 个任务中的 7 个上取得增益,最大改善出现在 protein-assembly 与 path-tracing。
Q4. 三组实验分别证明了什么?
4.1 在线分类:既提高 accuracy,也压低 context cost
作者用 GPT-OSS-120B 做固定分类模型,在 LawBench、Symptom2Disease 和 USPTO-50k 上搜索 40 个候选。最终 harness 的平均 test accuracy 为 48.6%,比 ACE 的 40.9% 高 7.7 pp,比 MCE 的 40.0% 高 8.6 pp;论文 Table 2 报告的 context 是 11.4K,而 ACE 为 50.8K。
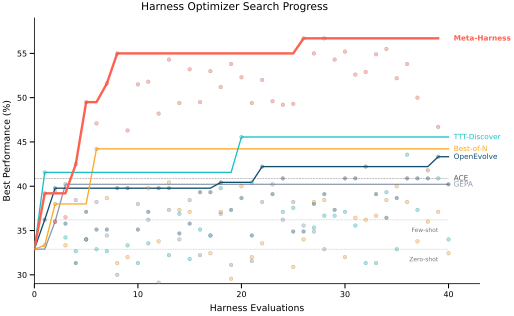
最终程序并非“再塞更多 few-shot”。它先列出有效 label,再为每个 label 取一条与 query 相关的 coverage example,最后补上局部相似但 label 不同的 contrastive pairs。九个 search 中未出现的 OOD datasets 上,平均 accuracy 为 73.1%,ACE 为 70.2%;Meta-Harness 在 6/9 个数据集上最好。
这里有一个原论文没有解释的记账冲突:Table 2 把 context 标成 tokens,Figure 3 和 Appendix Table 9 却写 characters。 因而“11.4K vs 50.8K”可以安全地视为论文内部同表比较,但不能把图表的横轴单位无条件当成 token 精确换算。
4.2 Math:有效的是 retrieval policy,不是“有 retrieval 就行”
Math search 用 GPT-OSS-20B 在 250 道 Olympiad-difficulty problems 上跑 40 轮,产生 109 个候选。最终 harness 先用关键词和 regex 把题路由到 combinatorics、geometry、number theory 或 algebra/other,再为不同 route 使用不同的 BM25、去重、difficulty reranking 和 sample count。
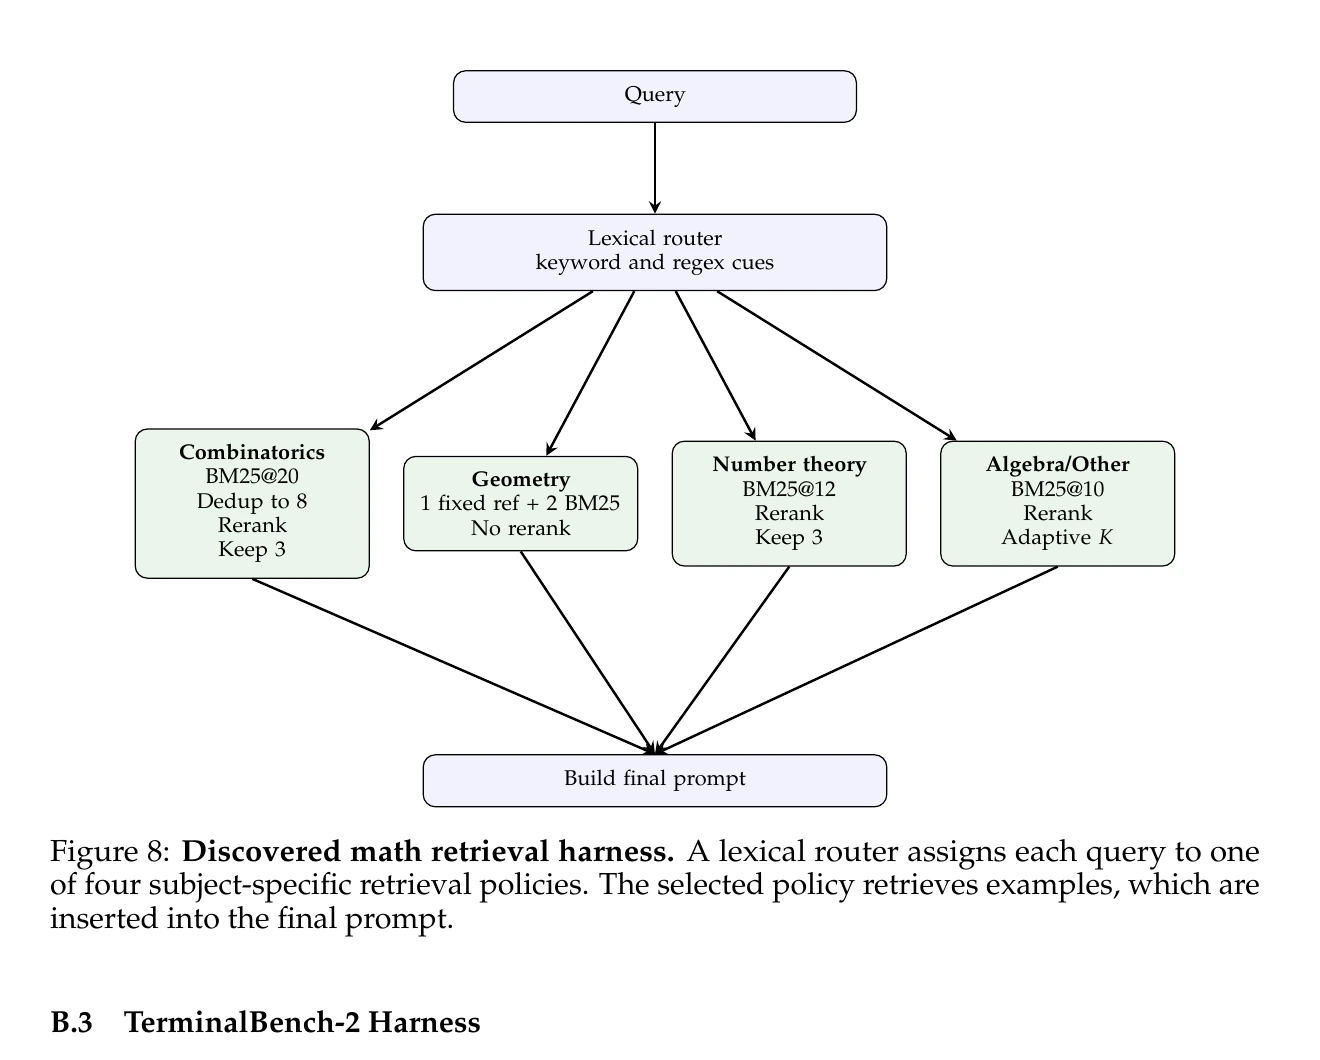
最终评测是 200 道未见 IMO-level problems,每题采样三次后计算 pass@1。No Retriever 平均 34.1%,固定 BM25 为 37.5%,Meta-Harness 为 38.8%。五个模型列都比 no-retrieval 高,平均提升 4.7 pp。
不过论文把它写成“five held-out models”略显宽松:GPT-OSS-20B 同时用于 search 选 harness 和 final evaluation;真正没有参与 search 的 base models 是 GPT-5.4-nano、GPT-5.4-mini、Gemini-3.1-Flash-Lite 与 Gemini-3-Flash 四个。更准确的结论是:harness 在未见题上有效,并迁移到了四个未见模型。
4.3 TerminalBench-2:强结果,但不是 held-out task 泛化
这组实验从 Terminus 2 与 Terminus-KIRA 出发,在 TerminalBench-2 的全部 89 个公开任务上搜索;最终也在同一 89 题上评测。作者把它明确称为 discovery problem,并用人工检查和 regex audit 排查 task-specific string leakage,但没有独立 task split。
官方 artifact 报告 Claude Opus 4.6 上 89 tasks × 5 trials = 445 trials,总体 pass rate 76.4%;论文中的 Terminus-KIRA 是 74.7%。按难度分层,Easy 4 题为 100.0%,Medium 55 题为 81.1%,Hard 30 题为 64.7%。在 Claude Haiku 4.5 上,Meta-Harness 为 37.6%,高于当时列出的 Goose 35.5%。
因此这组结果能支持“自动搜索可以在一个公开、竞争激烈的 benchmark 上找到比强手写 harness 更好的实现”,不能单独支持“这段 environment bootstrap 对未见 terminal tasks 也有相同增益”。
Q5. 对 Claude Code、Codex 这类完整 harness,最值得复用的是什么?
History store 应当是一套可查询的证据库。 对完整 coding agent,失败诊断往往需要同时查看旧代码、terminal transcript、tool result、timeout 与 evaluator output。目录结构、稳定命名和小型检索脚本,本身就是 optimizer 的一部分。
Proposal 与 acceptance 需要分开。 Proposer 可以自由写代码,但不应自己控制 benchmark split、final test、timeout 处理和 frontier 更新。官方 release 里,提出候选、import validation、benchmark、frontier update 与 test finalization 都是独立阶段。这种分层也适用于日常 Claude Code / Codex harness 迭代。
每次改动都应记录可反驳的 hypothesis。 TerminalBench 的日志同时保留了前六轮失败原因、共同变量和 iteration 7 选择 additive change 的理由。后续 Agent 因此可以沿证据链检查,而不是重复尝试同类修改。
评测要区分四种泛化:未见 example、未见 task/dataset、未见 base model、未见 benchmark/interface。这篇论文三个 domain 各自覆盖不同层级;以后如果优化 Claude Code 或 Codex 的 harness,至少要明确 search set、selection model 与 deployment environment 哪些重合。
一个直接可做的后续实验:固定同一批 coding tasks,把 Claude Code、Codex CLI 与一个极简 ReAct runner 同时作为被优化 harness;每套只在自己的 search split 上进化,再做 cross-harness × unseen-task 的完整矩阵。这样才能区分“找到了普适的环境信息策略”与“学会了某个 runner 的私有控制流”。
Q6. 最后怎样评价这篇论文?
论文把“工程师翻日志改 harness”做成了一套简洁、完整的优化闭环。 信息访问权交给强 coding agent,外层只负责验证和计分;scores-only、summary 与 raw-trace 消融则说明高带宽历史确实重要。TerminalBench 的 iterations 1 到 7 还给出了一条可追踪的失败归因过程。
但结论需要收窄:
我的最终判断是:Meta-Harness 很好地证明了 raw execution history 能把 coding agent 从“随机改代码”提升为“基于历史证据做局部实验”的 optimizer;它还没有证明同一搜索 recipe 能自动产生跨 benchmark 的通用 harness。 对准备研究 Claude Code、Codex 等完整系统的人,这两句话都很重要:前一句给出可复用方法,后一句规定下一篇论文该补的实验。
来源说明:论文为 CC BY 4.0,本文复用的原图均在图注标明 Figure 编号。代码行为核查基于官方 `meta-harness` revision 0cbc31e 与 `meta-harness-tbench2-artifact` revision 57fefdb;代码库自述为 cleaned release,本文没有把它等同于完整训练日志。
留言