RecreationWorld 让 Agent 照着一个正在运行的软件,重做行为和画面相近的版本。Agent 先操作原软件,找出菜单、输入输出和状态变化;再写代码、构建并启动自己的版本;发现差异后,可以回到原软件继续观察。评测的是屏幕探索、软件实现和运行检查能否相互配合,不是只根据截图生成一张页面。
1. Motivation:复刻软件为什么适合研究混合操作能力
原软件同时提供可探索的规格和可核对的运行结果。 Agent 不只要做出外观,还要实现点击之后的结果。作者先在原软件上运行测试,再用同样输入和动作检查 candidate,避免靠想象规定标准答案。
现有软件操作评测通常给 Agent 一个现成应用,让它完成“发邮件、改表格、下单”一类操作;代码评测则给问题描述、仓库和测试,让它在终端里改代码。它们通常不要求在同一任务里同时探索软件、重新实现它并检查实现。RecreationWorld 反过来让 Agent 从一个运行中的 reference 开始:许多行为细节要从窗口、控件、菜单、输入输出和状态变化中发现。Agent 的交付物则必须是可构建、可启动的代码。
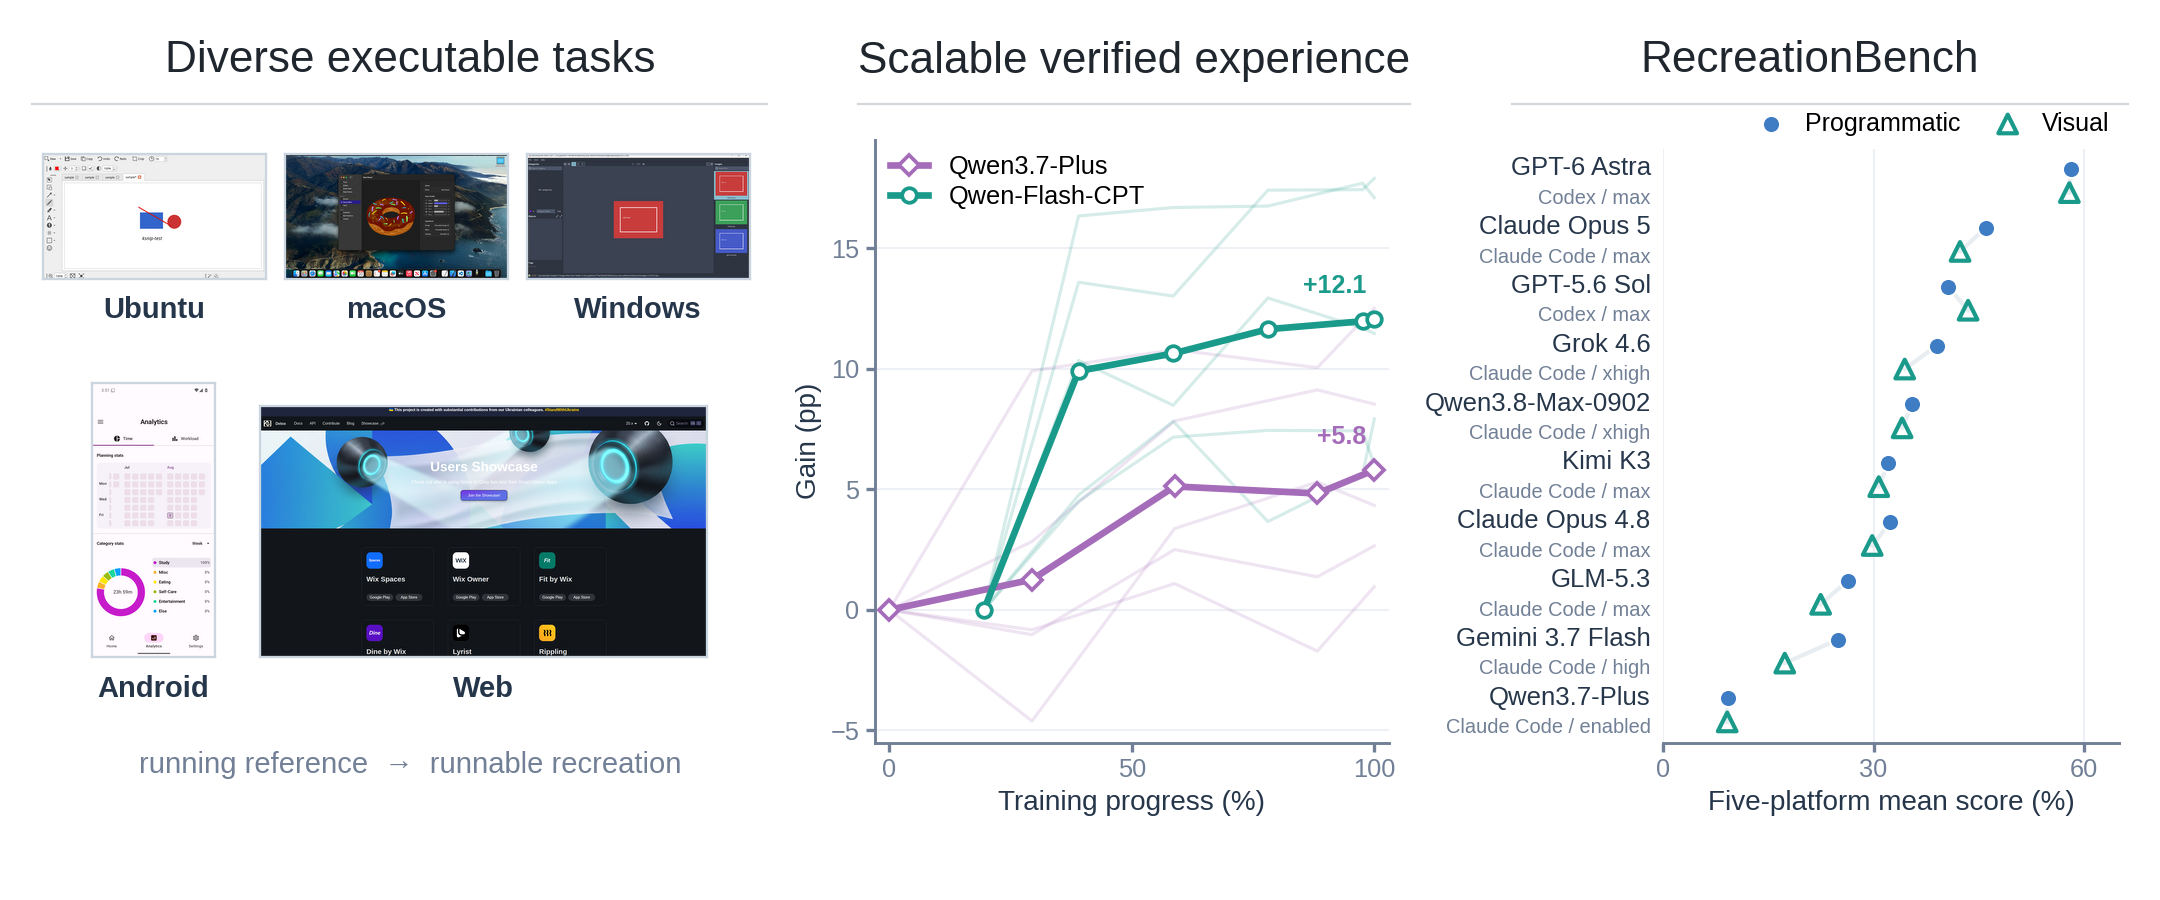
assets/overview.png,对应论文 Figure 1;经核对仓库采用 MIT License。左侧是五平台任务,中间是训练后在五项未见评测上的变化,右侧分别展示程序与画面两种检查得分。这个设计同时解决三个问题:
- 只点界面交不出源代码,只写代码又容易漏掉原软件的交互细节,任务要求两类工具配合。
- 同一组隐藏动作和断言(assertions,即必须成立的观察条件)先在原软件验证,再检查新版本;评分不要求两者使用相同语言或架构。
- 公开软件提供新的观察对象;高分执行记录可以被筛选成训练轨迹。
2. Related Work:软件使用、代码生成与复刻评测
它把五平台的任务、混合工具、基于原软件的检查,以及训练轨迹生产放在一起。 每条相邻路线都覆盖其中一部分;区别应看具体输入与评分,不应只看“首次”之类标签。
展开相邻工作:六条路线的输入与评测对象
| 路线 | Agent 接触什么 | 主要交付或评测 | 与 RecreationWorld 的关键差别 |
|---|---|---|---|
| OSWorld / AndroidWorld / WebArena | 现成应用或网站 | 完成指定操作,检查环境状态 | 侧重“使用软件”;一般不要求 Agent 同时重建软件并验证自己的产物。 |
| SWE-bench / ProgramBench | 仓库、问题描述、终端 | 代码补丁或程序行为 | 侧重“修改软件”;缺少通过界面主动发现行为细节、再检查运行画面的流程。 |
| Design2Code / Interaction2Code / WebGen-Bench | 截图、说明或网页交互 | 前端或网站实现 | 最接近根据视觉输入写代码的任务,但通常集中于 Web,对原软件的探索深度和平台范围更窄。 |
| APPFORGE / RealDevWorld / GameCraft-Bench | 移动应用、桌面软件或游戏目标 | 可执行软件,功能与视觉评测 | 也强调完整软件与可执行评分器;RecreationWorld 进一步统一五个平台,并研究界面操作与代码编辑交替的轨迹和训练迁移。 |
| Gym-Anything / CUA-Gym / GUI-GENESIS | 自动构造的环境、任务与奖励 | 规模化训练环境或可验证轨迹 | 同属可扩展训练环境路线;本文用原软件的运行结果产生任务依据、测试依据和训练经验。 |
| WeaveBench / PhoneHarness / StateAct | 图形界面与终端、API 或程序状态 | 混合工具工作流 | 直接研究两类工具配合;本文把重点放在探索、实现、检查相互衔接的完整复刻流程。 |
相邻工作已经做过部分相同的事。APPFORGE、RealDevWorld、GUI-GENESIS 等已经覆盖根据原应用生成新应用或功能+视觉评测。RecreationWorld 更有说服力的贡献是:同一套任务与交付规则横跨 Ubuntu、macOS、Windows、Android 与 Web,并且把 benchmark 和训练轨迹生产连接起来。
3. Benchmark / Protocol:从原软件构造任务,到隐藏检查给出分数
任务先有可运行的原软件,再有固定输入与隐藏检查。 作者为原软件固定版本和启动方式;测试前放入的文档、日志或目录等输入叫 fixture,它负责产生可复现状态,不是答案或断言。
RecreationBench 每个平台 50 个任务。三个桌面平台的发布清单记录上游仓库和版本;Android 选择未声明联网权限、核心状态保存在本机的应用;Web 包含 44 个合成站点与 6 个公开网站。作者按功能领域、界面框架、语言、规模和可测性筛选,排除构建不稳定、启动后被更新对话框挡住或依赖在线服务的应用。公开仓库提供 250 个任务清单、五平台执行程序、统一结果格式和评测代码;完整冻结任务包通过项目链接在 Hugging Face / ModelScope 分发。
这些原软件来自不同项目,保留各自的上游许可;Appendix A.2 的 Table 7逐平台列出许可分布。benchmark 公开不意味着其中所有软件都按同一许可证开放。
3.1 Benchmark 构造和提交评测是两条流程
构造阶段,作者先安排一个负责探索的 Agent 检查页面或源码,操作原软件,并记录功能入口、触发动作、前后状态与必要输入。专门生成测试的 Agent 再根据这些记录写检查模块。源码帮助发现功能,预期文字、状态与计算值取自实际运行结果。Desktop 和 Android 按结构、导航或菜单、交互、计算、状态、文字等职责分工,避免同一观察重复计分。每条测试还要在重置后的原软件上执行;不能稳定通过的测试被修复或丢弃。保留下来的输入、动作与预期观察经过人工复核后才冻结。论文没有报告复核人数、标注者一致性或驳回率,因此能确认有人审核,不能推断审核有多可靠。
Web 还做两类筛选。作者先在多种模型的重建版本上运行检查,删去所有版本都能通过、区分能力弱的项目;再合并重复链接与交互。最终要求只检查元素存在的项目不超过 30%,交互项目至少 60%,交互项目中至少 40% 有一层以上导航、10% 有两层以上导航。Table 2 的最终套件统计是五平台等权平均:约 77% 的检查不止停留在初始界面,94.2% 检查动作产生的结果,其中 40.7% 进一步要求精确结果;这里的导航层数不计算在同一界面内的独立点击。
评测阶段,Agent 只能看到任务提示、运行中的原软件、开发工具和自己的工作目录。Desktop 与 Android 尽量隐藏原软件源码,论文称为 source-blind:源码、测试、参考截图与凭证都放在受保护位置。部分 Ubuntu 与 Windows 输入文件可以提供给 Agent,规范副本和测试逻辑仍隐藏;macOS 与 Android 的测试输入由评分端安装。Web 是明确例外,浏览器运行静态站点必然收到 HTML、CSS、JavaScript 和资源文件;只能隐藏另行采集的参考结果与测试,并禁止新版本在评测时直接加载原站点。Android 已安装的 APK 原则上仍可提取,论文也没有证明它具有与桌面相同强度的网络隔离。
- 1 · 探索Agent 操作原软件,自己决定看哪些状态。
- 2 · 实现在工作目录写源代码、构建与启动入口。
- 3 · 检查启动自己的版本,操作并检查画面或行为。
- 4 · 冻结20 小时结束后终止 Agent 进程,冻结提交文件。
- 5 · 评分隐藏测试在隔离环境回放,不让 Agent 看评分器。
检查器先执行真实点击与输入,再通过 AT-SPI、AXUIElement、UI Automation、UiAutomator 或 DOM/ARIA 等平台接口,读取控件的文字、选中状态和计算结果。论文把这条结构化检查通道叫 Prog。颜色、绘图和布局不能总从控件树读取,所以另一条 VLM 通道把截图和基于原软件写好的文字标准交给视觉语言模型判断。二者都检查外部行为,不要求 candidate 使用与 reference 相同的语言或数据结构。
3.2 Logbert:固定日志如何产生一个 PASS / FAIL
这条检查要验证日志统计,不只是看到一个饼图。 作者提供十条日志,负责回放测试的执行程序(runner)打开它并进入 Statistic 页面,再检查精确百分比与对应图形。
把这个 case 按发生顺序读一遍
- 这是论文作者为 Windows 任务
couchcoding-logbert生成并复核的隐藏用例。公开任务清单能确认该任务存在;Figure 8 与 Appendix C.5 展示了测试函数摘录、输入、动作和断言。本文没有把完整隐藏任务包重新运行一遍。 - 评测程序提供固定日志
sample_log4net_mixed.log,共 10 条:5 条 Info、3 条 Error、2 条 Debug。整个 benchmark 的 81 个任务共打包 393 个输入文件,避免依赖用户机器上的偶然内容。这是打包文件数,不是 393 个独立测试用例。 - runner 打开 New Logger,选择 fixture,等待 Number 列出现,再点击 Statistic。从打开菜单、选择日志、加载记录到统计页,共经过三个导航层次,论文记为 depth 3。
- Windows UI Automation 必须读到且只读到
20%、30%、50%三个文字标签,并确认旧值17%不存在。因为总数是 10,Info 的计算是5 / 10 × 100 = 50%,Error 与 Debug 同理得到 30% 与 20%。 - Qwen3.7-Plus 在 temperature 0 下判断 50% 的扇区是否显著最大、20% 是否最小,图例是否为 Debug:2 / Info:5 / Error:3,以及标签页、列表和状态栏是否仍正确。只写对三个数字、饼图却画错,可以通过文字检查而失败于画面检查。
- 例如 ["50%","30%","20%","17%"] 会因为残留旧值和数量为四而失败;这是按已发布断言推演的说明,不是某模型的真实日志。缺少截图会让该视觉断言失败。论文把评分服务连接或解析错误视为应重新测量的基础设施问题,不算 candidate 失败;下文另外说明当前 Web 代码遇到这类问题时如何改变分母。无法构建或启动则整个任务为 0。
下面是根据 Figure 8 与 Appendix C.5 测试摘录改写的 Python 3 说明代码,运行时只需要标准库。它示范精确文字检查,不是完整隐藏 test bundle,也没有执行 GUI 或视觉评分。
展开示例代码:三个百分比与旧值检查
def check_statistic_labels(labels):
    observed = sorted(v.strip() for v in labels if v and v.strip())
    assert observed == ["20%", "30%", "50%"]
    assert len(observed) == 3
    assert "17%" not in observed
# PASS: ["50%", "30%", "20%"]
# FAIL: ["50%", "30%", "20%", "17%"]  # stale UI state remains
3.3 不同平台的分数怎样汇总
桌面与 Android 的 Prog 是固定测试 case 的通过比例;它们的 VLM 是视觉断言通过比例。Web 的功能检查按具体程度加权,行为与内容检查比“能启动、元素存在”更重;视觉分先在页面/视口内聚合,再合并桌面与手机版。
固定公开代码 b5cda868 的 scripts/web/evaluation/evaluator.py 给出功能权重:启动类 gate 为 0.1,结构类 struct 为 0.15,内容为 1.0,路由与交互各 0.4,其他为 0.3。分数是 通过检查的权重之和 / 全部检查的权重之和。例如四项检查的权重分别为 0.1、0.15、1.0、0.4,只通过前两项时,原始通过率是 2/4,加权得分却只有 0.25/1.65 = 15.15%。这是按公开公式算的教学例子,不是某个模型的成绩。
同版本 vlm_judge.py 先计算一个视口中视觉项目的加权平均,再按 desktop 0.6、mobile 0.4 合并,同一网站的页面等权。没有 candidate 截图是实际零分,judge 没能给出判断则是 None。 后者所在的视口从页面分母中去掉,剩余视口权重重新归一;整页都没有有效判断时,页面也从网站平均中去掉。如果整个网站都未判分,代码返回 -1 标记,再由汇总代码退回 SSIM/LPIPS 图像相似度。返回的判断数量不齐时,只对权重与判断都存在的项目计分。它支持重测错误视口,但这段当前代码不能证明论文历史榜单对所有失败都重试到有效。这些分母和备用指标应随运行报告一起检查。
随后每个平台内对各应用等权平均,避免测试较多的应用占据更多权重;五个平台再等权。两条通道的最终平均为:
公开仓库的 src/recreation_bench/result.py 是读取统一结果的 schema,不是重新计算平台总分的第二套评分器。它保留 Android 的应用平均与 Web 的原生加权结果,不用原始计数覆盖这些分数。task_score=None 表示没有得到评分,实际零分仍是 0.0。原始计数访问器 EvalCounts.rate 会优先读 passed/total,但它不能证明全榜都按断言简单平均。
展开公开结果 schema 的代码摘录
# Adapted from src/recreation_bench/result.py in the official MIT repository
@property
def graded(self) -> bool:
    return self.task_score is not None
@property
def prog_pass_rate(self):
    if self.eval_prog_n:
        return self.eval_prog / self.eval_prog_n
    return self.programmatic.rate if self.programmatic else None
4. Experiments:复刻程度、工具成本与训练迁移
平均部分检查做得不错,不等于整个应用复刻完成。 工具配置的成本实验和轨迹训练实验分别支持继续探索,但需要保留它们各自的控制边界。
十个模型中,GPT-6 Astra 以 Prog 58.19、VLM 57.92、overall 58.06 排第一;Claude Opus 5 是 45.99 / 42.34 / 44.16;GPT-5.6 Sol 是 40.63 / 43.49 / 42.06。Astra 与 Sol 使用 Codex 0.145.0,其他模型使用 Claude Code;各模型的上下文与输出上限并不相同,最长执行时间都是 20 小时,每个任务只运行一次。这是完整 Agent 配置的比较,不能把分差全算在模型权重上。2.8% 仅要求 Prog 满分,没有同时要求 VLM 满分。
论文的错误分析显示:模型更容易复制静态界面结构,交互和计算结果更难;生成应用通常比原软件小得多,也更集中在少数大文件里。Figure 10 还给出一个直接反例:最后改完源码后,重新启动并查看候选界面的比例,Astra 是 29.1%,Qwen3.8-Max-0902 是 47.5%,但后者榜单分更低。这个行为指标不等于功能真正验证通过,也不能单独解释模型排名。
4.1 用代码批量控制工具,成本下降来自哪套配置
主榜使用 direct MCP:每次点击、按键或观察都作为单独工具调用返回模型。Windows 配对实验则让 Claude Opus 4.8 在保持变量的 Node.js 执行环境中,用 JavaScript SDK 批量操作工具、写循环,只返回有用观察。前者与后者的区别是工具怎么组织执行,模型权重没有重新训练。下表的 token 是模型处理的文本单位,输入与输出分别计数。
展开 Windows 配对实验的分数、调用量与成本
| 比较项 | Direct MCP | Programmable SDK | 变化 |
|---|---|---|---|
| Prog 分数 | 35.05 | 35.60 | +0.55 个百分点 |
| VLM 分数 | 31.00 | 32.29 | +1.29 个百分点 |
| 界面操作工具调用数 | 对照起点 | 未列绝对数 | −39.9% |
| 输入 token | 对照起点 | 未列绝对数 | −40.7% |
| 工具返回文本量 | 对照起点 | 未列绝对数 | −65.5% |
| 每任务实际经过时间 | 4.12 h | 3.04 h | −26.1% |
| 每任务估算模型成本 | $90.50 | $41.58 | −54.1% |
| 输出 token | 对照起点 | 未列绝对数 | +15.7% |
效率统计只覆盖两种配置都没有终端错误、用量记录完整的 39 对;质量分覆盖全部 50 个 Windows 应用中评分有效的配对任务。每个任务/配置只执行一次,而且 driver 版本、给模型的操作说明、交互式运行环境、SDK、上下文返回方式一起变化,所以证据只支持“这一整套配置观察到更低开销”,不能把全部差值归因于持续保留变量的运行环境。成本使用公开 API 单价估算,假定 90% 的输入按缓存读取收费,不是账单,也不包含工具运行与基础设施开销。
4.2 筛选轨迹训练后的迁移证据
作者用 Qwen3.8-Max 生成执行记录,再用各任务行为检查筛选高分记录,每个平台选 7,000 条,组成 35,000 条监督微调数据。均衡的是轨迹条数,不是 token 数或训练权重,长短不同的轨迹可以贡献不同文本量。两条训练路线分别从已经完成后训练的 Qwen3.7-Plus,以及内部持续预训练后的 Qwen-Flash-CPT 开始。
Figure 5 比较的是训练过程中第一个与最后一个被评测的模型存档,不一定是训练前原模型。每个任务、每个存档只执行一次,全部使用 Claude Code,但外部 benchmark 的预算、工具版本和评分器不同:ProgramBench 200 题看测试通过比例;GameCraft-Bench 140 题看构建后规则分;Vision2Web 193 题按三个难度层级组合视觉与功能分;OSWorld 2.0 是 108 题的部分得分;WeaveBench 是 114 题经捷径审查后的分数。两条路线最后都高于自己的起点,曲线却并非一直上涨。最大 +17.9 个百分点 是 Qwen-Flash-CPT 在 OSWorld 2.0 的 28.2→46.1,不是五 benchmark 平均值;五项平均提升分别为 +5.8 和 +12.1。
Figure 6 显示后期模型更常检查自己的代码与画面、操作 GUI,但三组比例不能相加:代码验证的分母是 ProgramBench 的 Bash 调用,图片检查是两个视觉编程 benchmark 的读图比例,GUI 操作则来自两个计算机操作 benchmark。其 post-edit 指第一次源码修改之后,不保证检查发生在最后一次修改之后。行为比例与分数一起变化,仍未证明前者导致后者。
复刻数据与更强的跨任务表现相关,但还缺少关键控制:没有多个训练随机种子,也没有等量普通代码轨迹作对照;所选 35,000 条记录、训练检查点和完整超参数尚未发布。因此收益究竟来自工具交替、数据规模、筛选策略还是生成数据的强模型,尚未分清。
5. Discussion:分开验证评分可靠性与训练收益
先补评分校准和同条件训练对照,才能知道高分与迁移收益是否可靠。 给 VLM 断言做人工复核,报告它与人的分歧和误判;同一模型、同一任务重复执行,报告分数波动。固定数据量和生成轨迹的模型,再比较复刻软件、普通代码任务与纯界面操作的轨迹,才能单独估计交替探索与实现的训练价值。
公开测试还可以加入故意遗漏计算、保留旧值或只复制静态界面的新版本,看是否确实失败。这能检验隐藏测试是否真的区分功能与外观,而不只是把所有原软件能通过的浅层检查留下来。以上是本文根据证据缺口建议的实验,不是论文已经验证的结论。
6. Conclusion:可执行规格的价值与当前边界
最值得借鉴的是让原软件的运行结果同时服务任务说明与测试依据。 五平台共同验证 Agent 是否能把屏幕探索与写代码接起来;但有限测试、视觉误判、训练对照不足,仍限制结论。
留言