LEGO-RL 研究的是一个很具体的系统问题:Claude Code、OpenHands 或 OpenCode 会读仓库、改文件、跑命令、压缩历史,训练程序怎样准确知道模型生成了哪些 token(分词后的文本单元),并确认最终分数来自真正修复?论文在模型 API 边界记录生成,在独立环境里运行和测试项目,再用这些记录更新模型。它的重点不只是提高分数,还要防止“记录错了生成内容”或“测试被绕过”产生错误梯度。
1. Motivation:完整执行程序为什么会破坏普通 RL 的数据假设?
训练框架通常希望自己控制 token 序列,完整 harness 却会主动管理上下文和工具交互。 一次 Claude Code 执行可能包含多轮模型调用、终端输出、文件改动、工具格式、历史压缩和 SDK 消息重排。训练器若结束后再从完整文本编码,token 编号、生成位置标记或上下文边界,可能已经与实际生成时不同。
这个差异会直接破坏强化学习更新所用的概率比。分母如果对应另一串 token,或者 MoE 专家选择已经变化,优化目标就失去原来的统计含义。论文的要求很直接:在相同权重上,训练器对原始生成 token 重算的对数概率,应接近模型服务端记录的值。
第二个问题来自评分。代码 Agent 通常只得到任务结束后的 0/1 验收分。论文在系统开发期间看到过六类污染:
| 失败方式 | 部署防护前出现比例 | LEGO-RL 的处理 |
|---|---|---|
| 读取 git history | 4.6% 至 20.5% | Agent 执行时只保留一个基线提交,验收前恢复历史 |
| 下载公开参考修复 | 1.9% | 按执行与验收阶段设置出网防火墙 |
| 修改 tests | 2.4% 至 19.4% | 验收时才放入测试文件,并恢复被修改的测试路径 |
| 评分器意外应用参考修复 | 2.5% | 审计并剔除受影响任务,运行时检测明显异常得分 |
| 评分器依赖网络 | 未单独量化 | 把验收时依赖打包进环境 |
| 仓库构建不完整 | 未单独量化 | 封闭构建、失败立即退出;报告初始化失败,不记为模型得 0 |
LEGO-RL 要同时准确记录生成、确保验收分数可信。 前者回答“更新是否针对模型实际生成的内容”,后者回答“1 分是不是 Agent 真的修好了任务”。
2. Related Work:与现有 Agent RL 框架的区别
与 LEGO-RL 最接近的路线选择在模型 API 边界接入现成 harness。 论文把相关工作分成几类。
| 路线 | 任务执行由谁控制 | 强项 | 与 LEGO-RL 的区别 |
|---|---|---|---|
| verl、slime、MOLT、SkyRL、AReaL | 训练框架内部循环或规定接口 | 生成与参数更新靠得近,容易做异步与大规模训练 | 现成代码 Agent 往往要改成训练框架规定的交互方式 |
| ALE:ROLL + ROCK + iFlow | 训练器、隔离环境和命令行 Agent 协同设计 | 整栈一致性 | 通过共同控制全部运行层获得一致性,目标并非兼容任意现成 harness |
| Agent Lightning | 现有 Agent 增加 SDK 回调 | 能接多种 Agent 系统 | 论文 Table 1 没有报告历史核对、专家路由重放与评分防作弊 |
| Polar、rLLM、OpenForgeRL | 在模型 API 处观察原部署程序 | 保留既有 Agent 执行流程 | 与 LEGO-RL 最接近;各自对专家选择重放、隔离环境、运行管理与诊断记录的覆盖不同 |
| LEGO-RL | Claude Code、OpenHands、OpenCode 原有循环 | 原始 token 保存、专家选择重放、Harbor 验收、诊断界面与运行管理 | 贡献在完整系统组合;论文没有声称每项组件都是第一次提出 |
论文也和 SWE-RL、DeepSWE、LongContext 一类工作区分开来。SWE-RL 不执行工具交互;其他工作常在框架自有循环中训练。LEGO-RL 关注的是部署时会真实使用的 harness 是否也能原样参与训练。
这里要保留一个证据边界:Table 1 的功能勾选由 LEGO-RL 作者整理,本文没有逐个复现十个框架。它适合说明设计空间,不能当成独立 benchmark 排名。
3. Method:从一次修复到参数更新:记录、测试与筛选
论文要求只训练模型实际生成的 token,不把用户消息和工具输出当成模型行为;公开代码的异常回退路径还需要单独审查。
3.1 一次任务执行的数据流
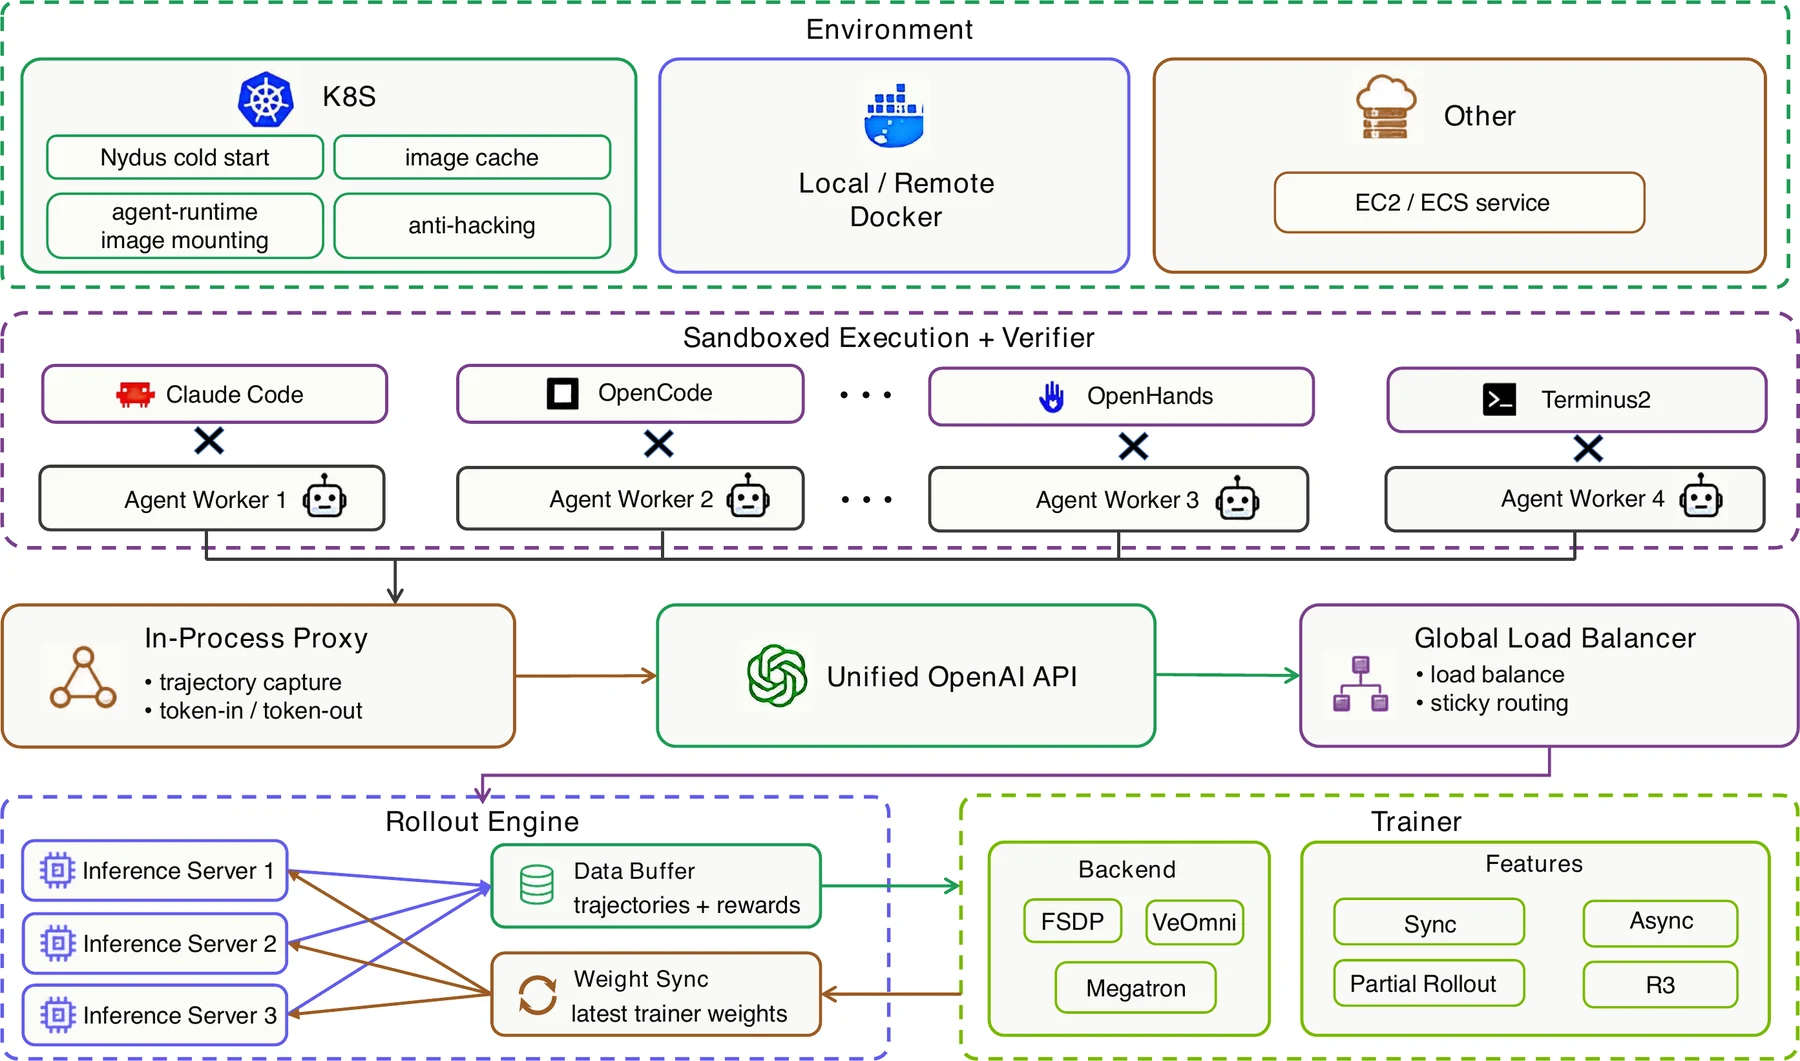
每个任务 x = (q_x, R_x, V_x) 包含问题描述、初始化仓库和对应测试程序。Harness 构造本轮上下文,模型生成回答或工具调用,harness 执行操作并改变仓库。
Proxy 是放在模型 API 前、转发请求并保存生成记录的代理程序。它需要处理一个麻烦细节:harness 可能在下一轮请求里重新序列化旧消息。官方实现 revision a3e28f171be165b5e8cda45030f336ec103690a7 直接把 proxy 捕获的 token、生成位置标记、对数概率和专家选择放进 AgentLoopOutput:
prompt_ids = traj_acc[:prompt_token_len]
response_ids = traj_acc[prompt_token_len:]
response_mask = tail_mask
response_logprobs = tail_lp
response_routing = (
    tail_routing if len(tail_routing) == len(tail_mask) else []
)

output = AgentLoopOutput(
    prompt_ids=prompt_ids,
    response_ids=response_ids[:self.response_length],
    response_mask=response_mask[:self.response_length],
    response_logprobs=response_logprobs[:self.response_length],
    routed_experts=self._build_routed_experts(
        prompt_ids, response_routing[:self.response_length]
    ),
    reward_score=reward_score,
)
这段代码来自官方仓库,不是重构伪代码。实现还分别记录超时、环境初始化失败、达到轮数上限和上下文溢出,再决定哪些记录能参与训练。
正常路径和异常回退不能混说。 论文 §3.2.2、§4.4 称不能可靠对齐的历史会被排除;但固定版本 a3e28f1 的 _compute_prompt_ids 遇到历史不再延续旧消息、或工具定义变化时,会逐消息重新编码。它保留与原记录完全相同的前缀及其概率,但重建后的 assistant 段仍标为模型生成,不能恢复的概率先填 0。官方启动脚本默认设置 HARBOR_RECOMPUTE_MISMATCH_LOGPROBS=0,关闭重算;如果绕过脚本、没有设置环境变量,Python 模块本身却默认开启。即使开启,重算失败的位置也可以保留 0。这条分支不必然禁用整条训练记录。builtin_swe_agent_loop.py 后续检查长度和禁用标记,并不逐项验证这些概率是原始采样值。因此,本文介绍的是论文的严格要求与公开实现的正常路径,不能保证公开版本所有回退记录都满足“原始 token、原始概率”的条件。
工具调用的匹配也有版本差异:论文说按调用 ID 和函数名关联,代码有 ID 时只核对 ID,允许 Claude Code 把 Task 改名为 Agent;无 ID 才用名称。子 Agent 的请求会进入独立、不收集训练 token 的会话。真实多模态请求则关闭这版 proxy 的 token 轨迹收集,不能把本文的代码训练结果直接推广到图像/视频输入训练。
3.2 一批记录怎样通过 GSPO 更新模型?
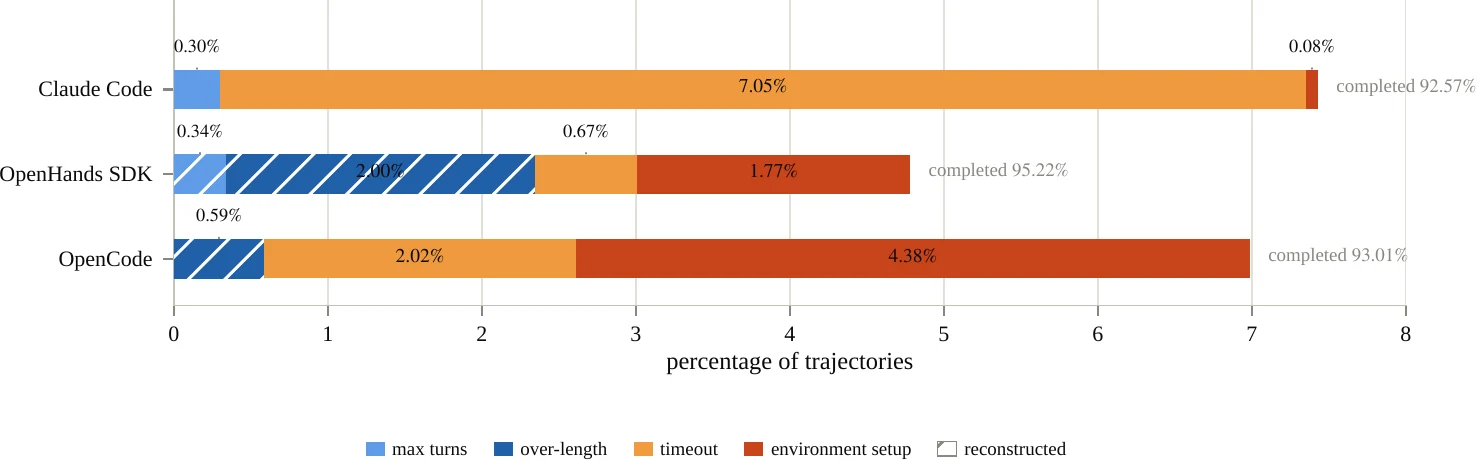
论文规定一轮更新按以下顺序进行:挑任务,用当前生成模型各跑八次;任务结束后运行隐藏测试;排除环境初始化失败、实际耗时超限和不能对齐生成内容的记录;仅用有效记录计算组内相对得分;训练程序重算同一批生成 token 的概率,再做 GSPO 更新,最后把新权重发回生成服务器。达到工具交互轮数或生成长度上限但记录有效的尝试仍保留测试结果,不一律当成设施故障。公开代码并未在所有历史重建分支严格执行上述排除规则,差别见前一节。
公开实现还解决了一个细节:异常记录可以保留在批张量中,但不能拉低同题其他记录的平均分。patches/verl_sao_7aed6b23.patch 中的过滤器先清零异常记录的 reward,再给它独立的组 ID,使它脱离原组的统计;计算 advantage 后再清零它的训练贡献。只把这条记录的 loss 乘零,仍不足以保护同组其他记录。
GSPO 不是对每个 token 独立算一个概率比。它先把一条执行记录里所有模型生成 token 的对数概率差取平均,再指数化:
这里 M_i 只含真实模型生成的位置;old 是生成这组记录时的模型版本。论文 Equation 1 对 σ_i × Â_i 使用上下界裁剪,再乘有效性开关 w_i ∈ {0,1}。好于组平均的记录被提高概率,差于组平均的被降低,裁剪限制单次改变幅度。原文允许上调幅度比下调更大;这不是本文新提出的算法。
例如八条里四条通过、四条失败,组平均为 0.5,成功与失败的 advantage 正负相反;若按总体标准差 0.5 计算,约为 +1 和 −1。这是公式说明例,不是作者发布的八条轨迹。同题全对或全错则全为 0,也解释了为什么后面要筛任务难度。
历史重写与异步旧权重是两种问题。 前者需要核对生成内容;论文要求无法对齐的内容排除,公开实现的重建回退仍有前述缺口。后者指训练已更新,但某些慢任务仍由旧权重生成,论文用生成版本对应的概率比处理受限的版本滞后。不能把 token 对齐错误当成正常异步差异。
3.3 训练任务从 36,884 条缩到 2,699 条
任务来自 OpenSWE 候选任务集合。作者先做规则过滤:
- 36,884来自 OpenSWE 的候选题
- 22,806通过基本有效性、仓库多样性和粗略复杂度筛选
- 21,681能构建且验收程序能运行
- 4 rolloutsQwen3.6-27B + OpenHands SDK
- 1-3 / 4保留既不全错也不全对的任务
- 2,699最终训练 index
训练集与 SWE-bench Verified 在仓库与任务两层都不重叠。难度筛选只使用一种模型与执行程序组合,可能偏向该组合擅长的任务。作者随后在 Claude Code 和 OpenCode 上也获得提升,说明这批任务可以迁移;现有实验没有证明三种执行程序都适合完全相同的训练任务分布。
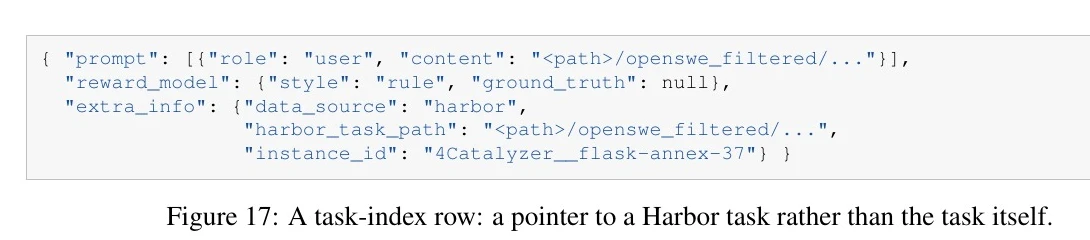
官方 utils/create_task_index.py 也说明了 index 的性质。Parquet 行里的 prompt 只是路径占位符,真实问题说明在 Harbor 任务的 instruction.md 中:
return {
    "prompt": [{"role": "user", "content": str(path)}],
    "reward_model": {"style": "rule", "ground_truth": None},
    "extra_info": {
        "harbor_task_path": str(path.resolve()),
        "instance_id": path.name,
        "data_source": "harbor",
    },
}
3.4 真实任务:12rambau__sepal_ui-814
这道任务来自 openforis/pysepal 的 issue #813 和 PR #814。原始需求由项目维护者提出:第一次调用 alert.update_progress(0, total=10) 后,循环内应该只写 alert.update_progress(i),不必每次重复传 total。
这里的参考修复和测试是上游维护者 Pierrick Rambaud 在 PR #814 中写的。OpenSWE 将需求、基线版本、修复补丁和测试列表组织成训练任务,LEGO-RL 再打包为 Harbor 任务;论文没有声称这段测试由训练中的 Agent 编写,也没有披露为本案例另做人工标注的过程。
从公开需求到测试程序给分
- 上游来源:issue #813 给出可运行示例;PR #814 的公开修复补丁修改
alert.py,并把test_update_progress改为先以 0/100 初始化,再调用update_progress(50)。 - OpenSWE 任务记录:作者保存 base commit
6d825ae167f96ad2e7b76b96ca07de562f74dcf0、问题描述、gold patch、test patch、FAIL_TO_PASS和PASS_TO_PASS。 - Agent 可见状态:Harbor 初始化仓库,只把问题说明交给 Agent。Agent 可以读写源代码、运行公开命令,但看不到参考修复、隐藏测试补丁、测试清单与评分器;出网防火墙阻止它下载公开 PR。
- Agent 输出:Agent 修改工作树。论文没有公开这道题的实际训练日志,因此本文不编造它具体读过哪些文件或用了哪条 shell 命令。
- 验收准备:Agent 结束后,宿主程序才把
tests/test.patch、parser.py和含原始记录的config.json放入隔离环境。test.sh重置测试、应用隐藏测试补丁、运行 pytest 并解析结果。 - PASS:
tests/test_sepalwidgets/test_Alert.py::test_update_progress必须从失败变通过,所有PASS_TO_PASS也必须继续通过。否则分数为 0;全部满足才是 1。
一个具体失败可以直接从公开补丁解释。先以 total=100 初始化,再调用 update_progress(50):旧实现每次都从本次参数取 total,省略参数就回到默认值 1,因此会抛出“50 不在 0 到 1 之间”的 ValueError。PR #814 改为在进度条已存在时读 self.progress_bar.total;更新后 n=50 且进度条可见,才满足上游测试。调用 reset() 后则重新接受初始化参数。这是按公开代码推导的失败路径,不是作者发布的某条模型执行日志。
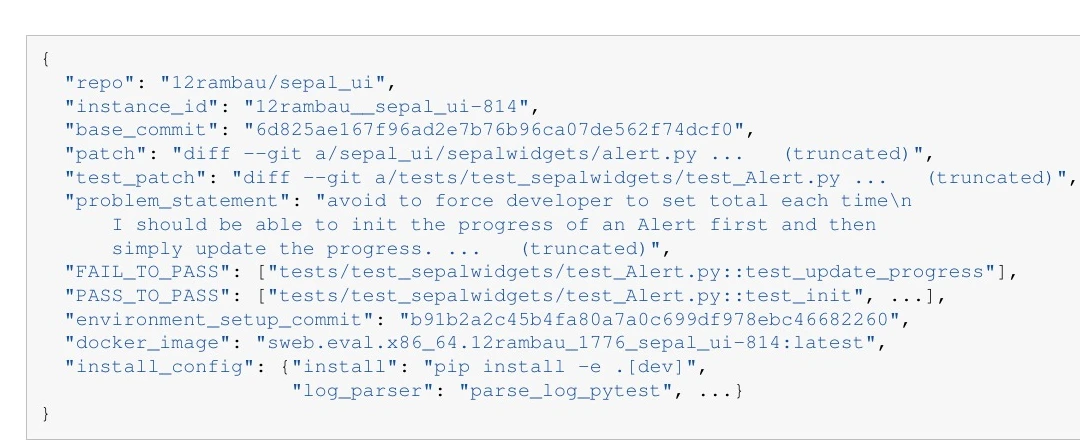
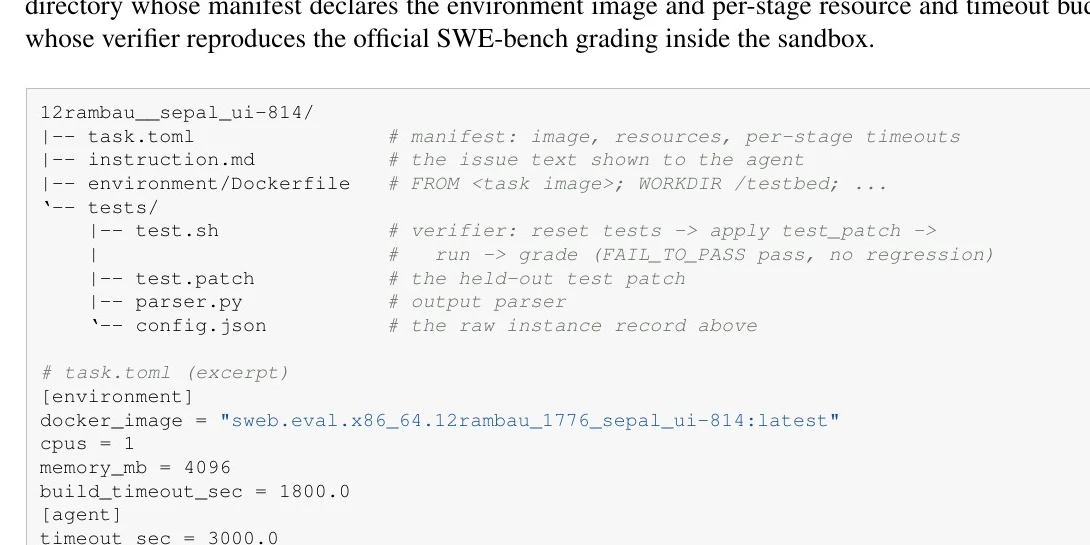
论文和官方 GitHub 仓库 revision a3e28f1 没有公开这条 instance 的完整 Harbor 任务目录;Figures 15-16 也明确标注长字段被截断。本文可以核验上游 issue、公开参考修复与总体验收协议,无法逐行审计作者实际使用的 test.sh 与完整 PASS_TO_PASS 清单。
4. Experiments:实验设置、概率核对与失败诊断
三种执行程序分别训练后都提高了成功率;轨迹概率、测试隔离和失败筛选决定这些更新是否可信。
4.1 主实验控制
三次主要训练都从 Qwen3.5-35B-A3B 开始,使用 GSPO、每批 64 题、每题 8 次尝试、训练 3 遍(126 步)。输入预算 30k token,生成预算 170k,两部分分别截断,不能互相挪用额度;训练时采样温度 1.0,验证时 0.7。每个 harness 单独训练一次,验证集固定为 SWE-bench Verified 500 道题,每题一次尝试、最多 200 轮交互。
Table 10 还规定学习率为 10^-6、梯度范数上限为 1.0、序列概率比的下/上裁剪幅度为 3×10^-4 / 4×10^-4。与参考模型的 KL 惩罚系数为 10^-3,只进入 loss,不改 verifier 的 0/1 分。主实验关闭额外的 importance-sampling correction(生成与训练概率出现偏差时使用的辅助修正),但保留前文 GSPO 本身的概率比;不能把两者混为一个开关。
| Harness | 初始 Qwen3.5 | 验证最高分 | 增益(百分点) | 同协议 KAT-Coder |
|---|---|---|---|---|
| OpenHands SDK | 64.0% | 70.4% | +6.4 | 67.0% |
| Claude Code | 62.4% | 68.2% | +5.8 | 66.8% |
| OpenCode | 57.2% | 66.6% | +9.4 | 64.8% |
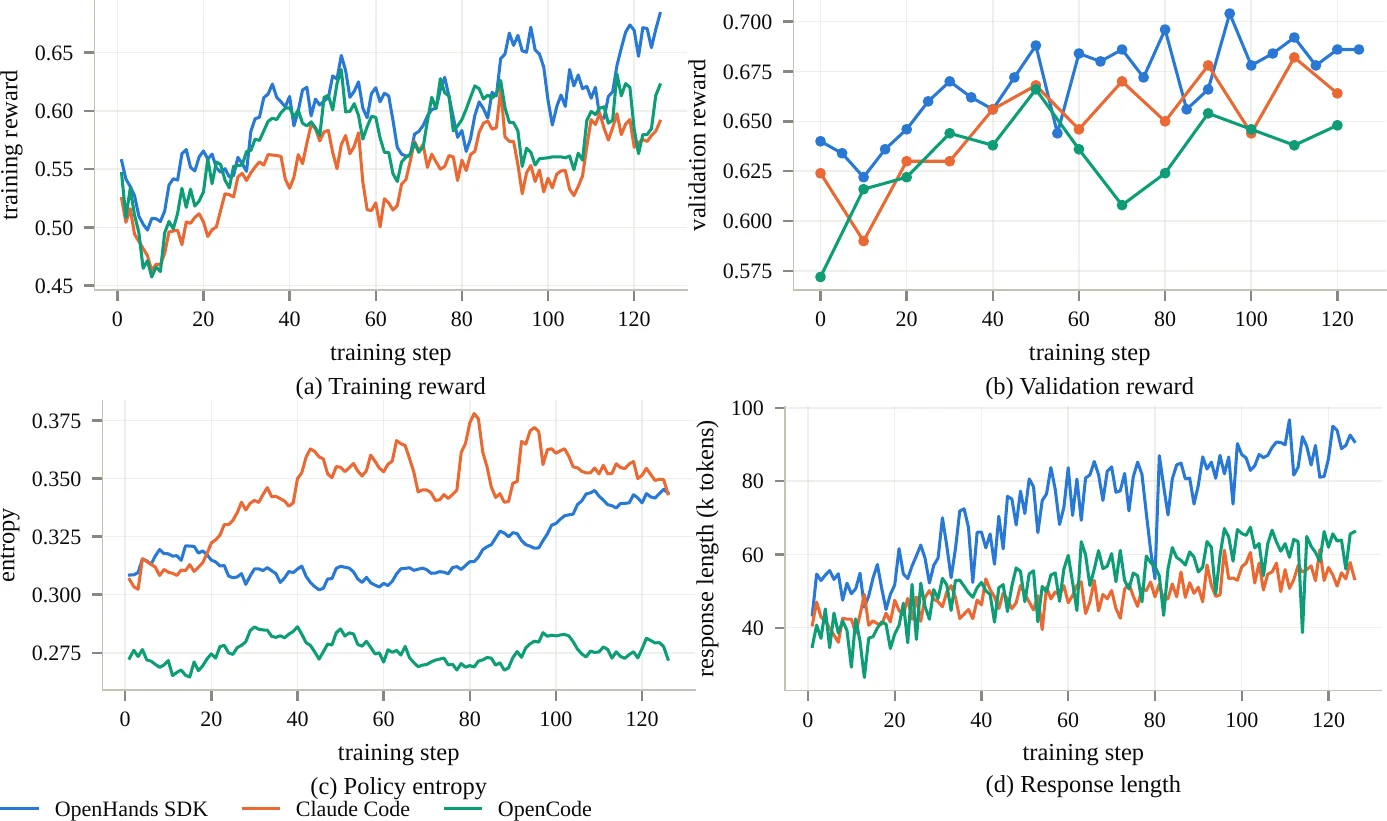
主表报告验证最高分,不能写成最终 checkpoint 的固定表现。 在 500 题分母下,70.4%、68.2%、66.6% 分别相当于 352、341、333 题通过。Appendix D 分析 OpenHands 的首尾两次验证时给的是 63.8% 和 68.6%;这组首尾分析和主表的初始/最高分不能混写。论文没有充分说明其中初始值 63.8% 与主表 64.0% 相差一题的原因。
每个主要配置只有一次训练。三次训练的最高分都超过各自起点,也超过作者在同协议下重测的 Qwen3.6-35B-A3B 和 KAT-Coder-V2.5-Dev,但不能给出重复训练的波动。KAT 的对照也说明收益依赖 harness:它在 Claude Code 比 Qwen3.6 高 3.4 个百分点,在 OpenHands 却低 0.4 个百分点。不能把一个执行程序下的提升自动推广到另一个。
4.2 概率核对:更新依据是否对应原始生成?
| Harness | Median Pearson r | KL ×10^-3 | p99 |Δ mean log p| ×10^-3 |
|---|---|---|---|
| OpenHands SDK | 0.9993 | 0.75 | 2.1 |
| Claude Code | 0.9980 | 1.35 | 2.7 |
| OpenCode | 0.9993 | 0.60 | 2.0 |
Pearson r 衡量生成端和训练端对同一批 token 计算的对数概率是否同步变化,越接近 1 越一致;KL 和对数概率绝对差补查“高度相关、但数值仍偏移”的情况。表中的 p99 是一条执行记录内平均差值的第 99 百分位,最后再对训练步取中位数,不是单个 token 的最大误差。
每步训练的 Pearson 都不低于 0.989。专家选择重放的负对照更有说服力:关闭 replay 时 Pearson 为 0.9946;正确对齐后是 0.9993;把每个 token 的专家路径故意错一位后跌到 0.7503。机制“在运行”不够,token 与专家路径必须逐位置匹配。
Appendix B 还记录过另一种故障:缓冲区太小,长记录中只有 24% 的专家选择被保存。修正后两次生产运行的覆盖率超过 99.8%;仍缺少路由记录的极长位置允许模型重新选择专家,不会硬塞一条错误路径。因此高相关系数不等于每个 token 都有完整的专家记录。
4.3 哪些任务和执行记录能提供有效训练信号?
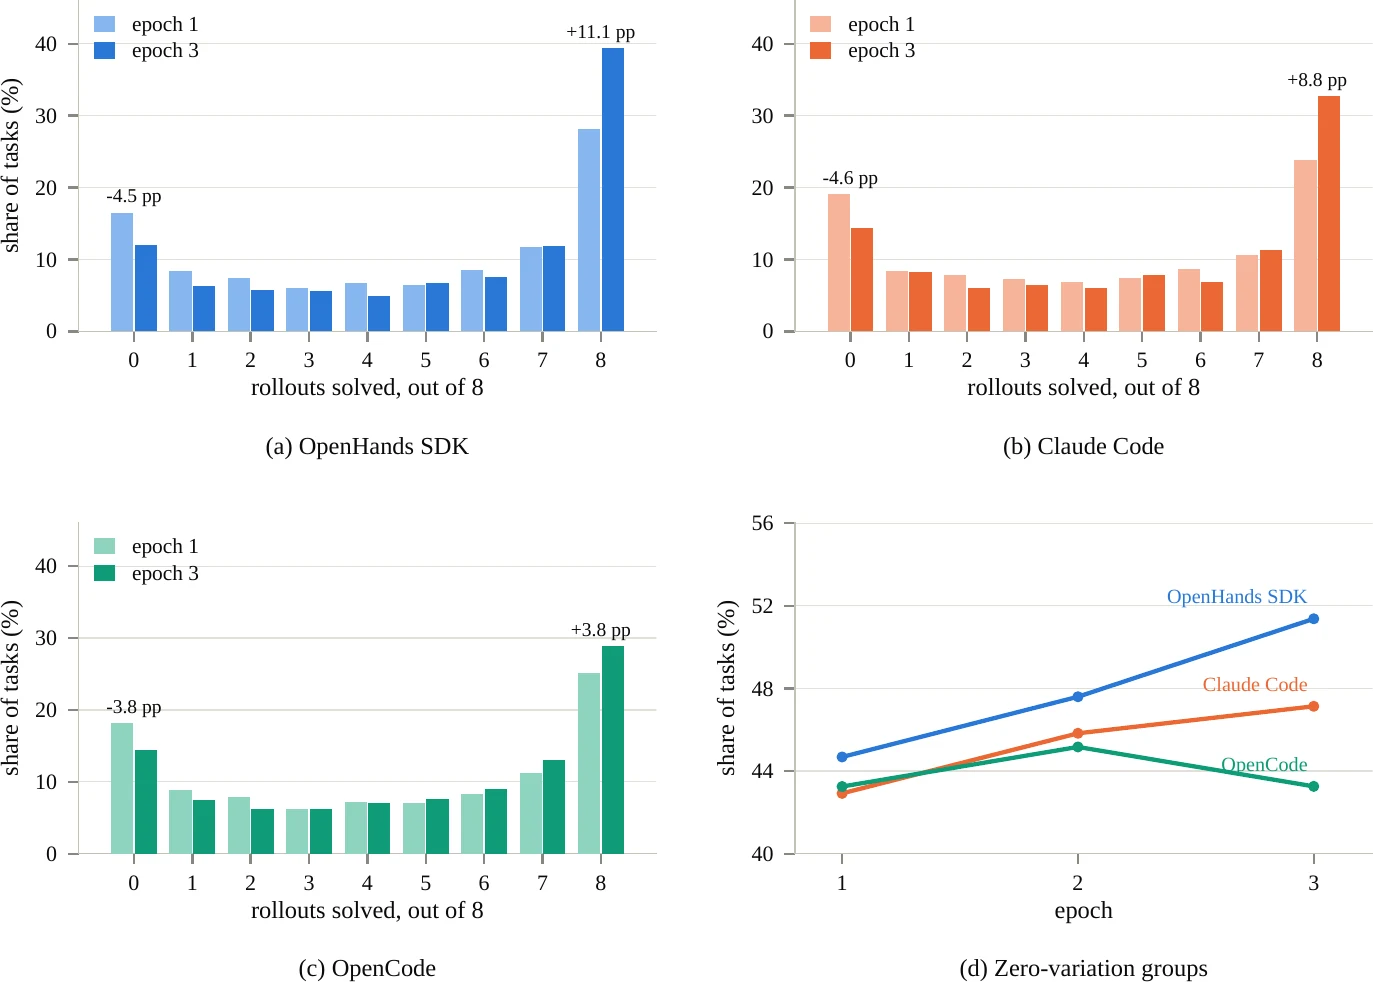
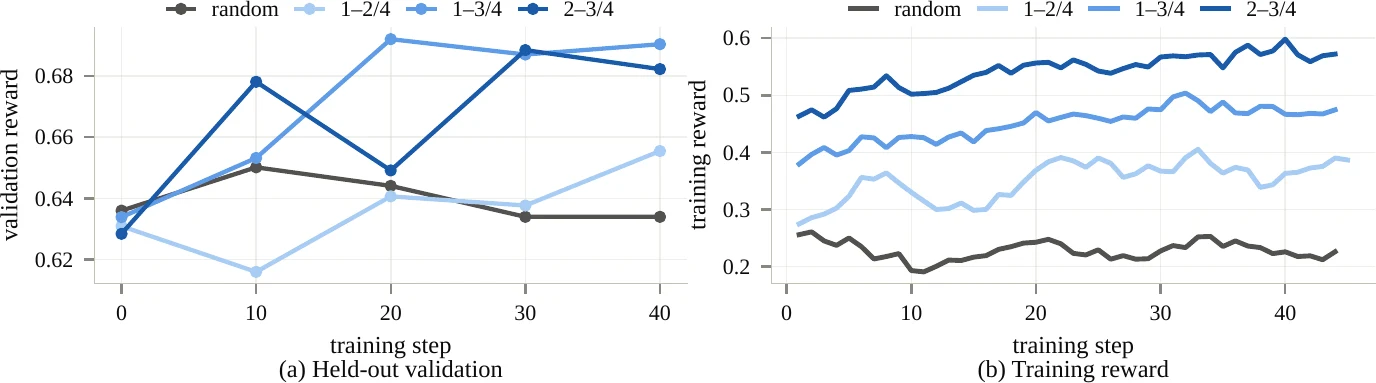
未筛选随机组在四次难度估计中有 72.7% 的任务从未解出,13.4% 总能解出,两类都难以提供组内差异。还要注意这里的评测分母:四组生成并发不同,设施故障曾被记成失败,作者在 Figure 6 中改为只除以实际执行的验证题数,修正幅度为 0.6 至 5.2 个百分点。图中 0.671 不能直接当成前面固定 500 题分母的主实验成绩;也不能把并发差异视为已被完全控制。
4.4 监控发现:模型不再真正调用工具
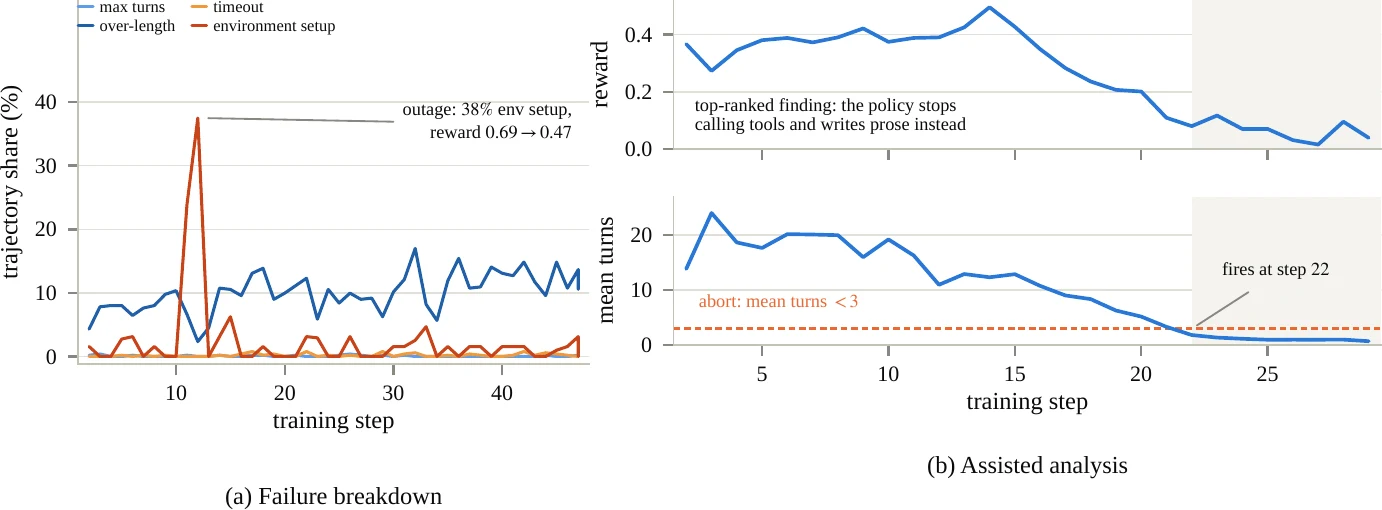
论文附录给出一个训练崩溃案例。模型是 Qwen3-30B-A3B,harness 是 OpenHands SDK,任务集合有 449 道题。29 步记录内,训练分从 0.351 降到 0.050,验证分从 0.230 降到 0.014,平均动作数从 18.9 降到 0.96。Agent 后期几乎不再真正调用工具,而是把 shell 命令写进回答中的代码块,环境并不会执行它们。
Figure 7(b) 的 mean turns < 3 在 step 22 触发,可以比等到训练终止更早报警。这里原文两处并不完全一致:§4.5 笼统说提前 8 步,Appendix C 明确将“提前 8 步”对应到 step 21 的概率一致性低于 0.95。本文不把这两个条件合成同一个阈值;它们也只在这次诊断案例上得到检查,跨任务是否有效尚未知。
4.5 训练后的行为和系统代价
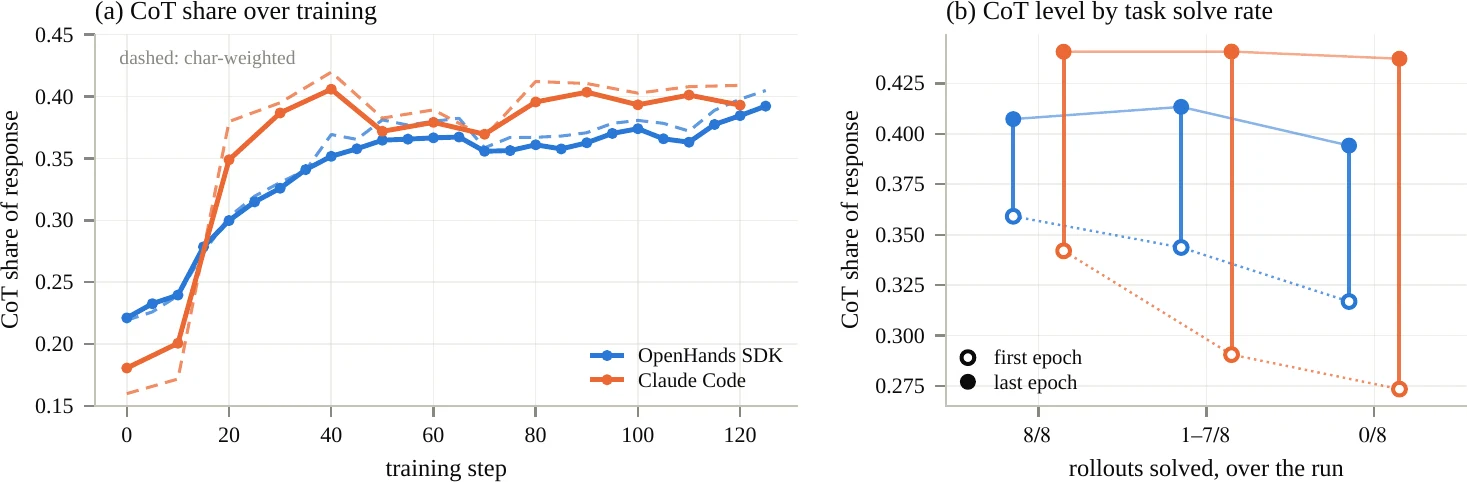
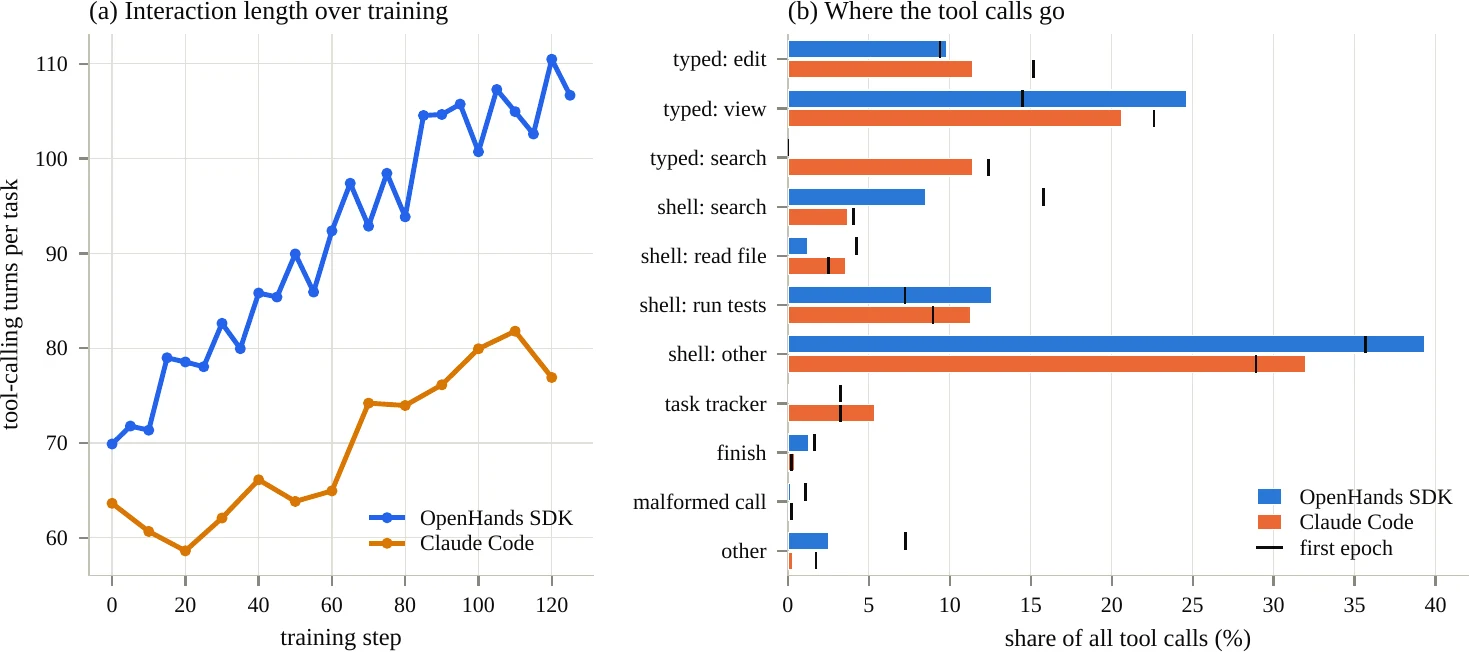
在 OpenHands SDK 主训练首尾各 420 条执行记录上,修改后重新读文件从 73.6% 增到 98.1%,运行测试从 85.0% 增到 93.6%,首次修改前检查的文件数从 3.45 增到 6.92,格式错误的工具调用从 1.07% 降到 0.15%。出错后仍解决任务的比例只从 63.9% 增到 66.8%,变化较小。
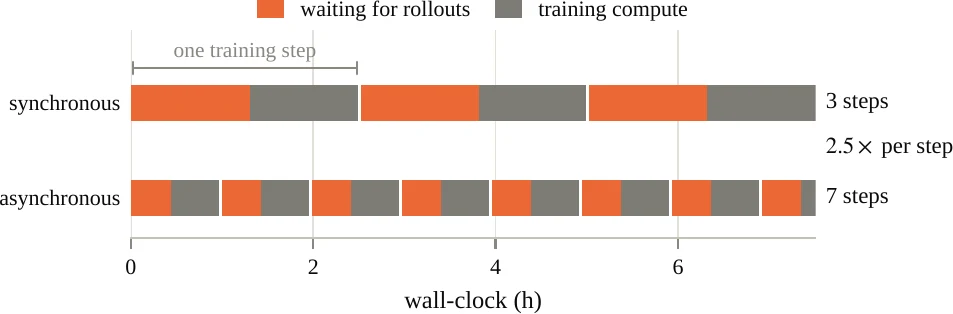
3,699 次 OpenHands SDK 尝试中,Agent 执行平均占 840.5 / 920.4 秒,也就是 91.3%。相同 7.5 小时内,同步训练完成 3 步、异步完成 7 步;论文按测得的每步耗时报告 2.5×,不是直接用 7/3 计算。同步组每训练一个 token 的参数更新耗时又是异步组的 2.1 倍;作者修正这项 GPU 吞吐差异后,估计每步约 1.9 小时对 1.0 小时。1.9× 是校正估计,不是另一次完全匹配硬件的实测。
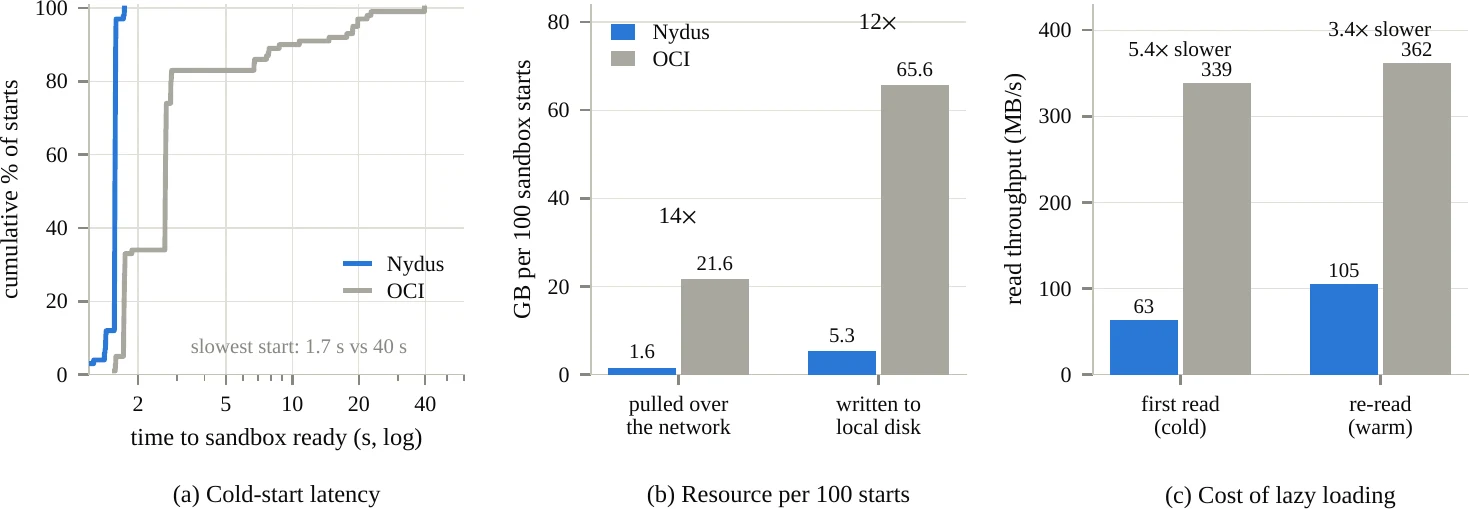
容器优化也有代价。Nydus(按需下载镜像数据块的组件)把 100 次启动的网络传输降到 1.59GB,但首次读取缺失数据块的吞吐低于完整拉取镜像;热启动时收益基本消失。Table 5 中把评分依赖预打包后的验收反而为 3.81 秒,未打包为 2.72 秒,作者保留这项措施是为稳定评分,不是为提速。
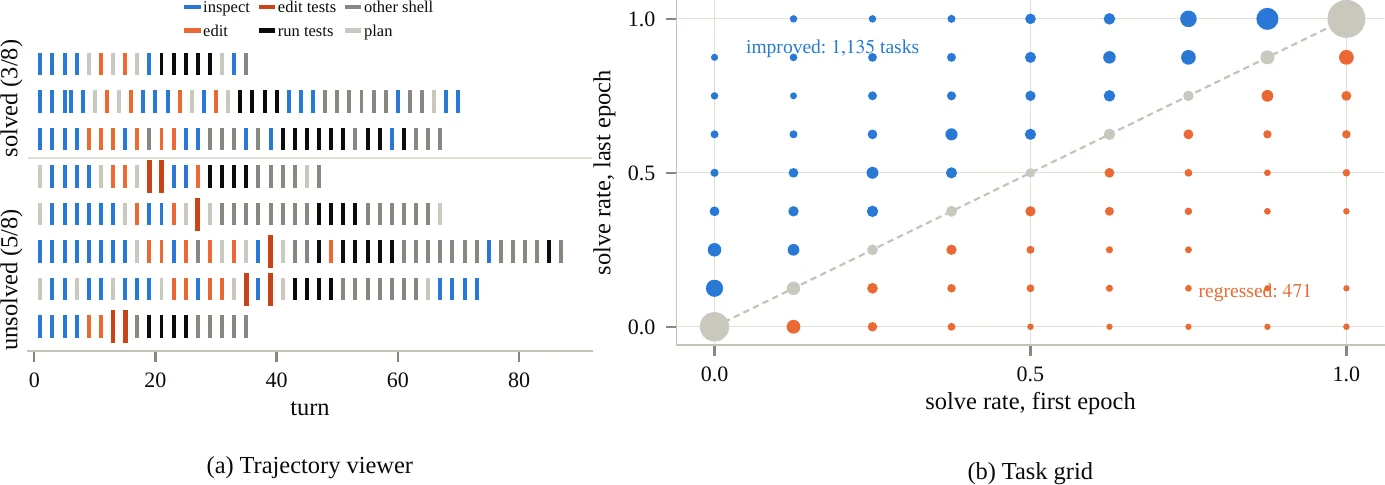
开头的交互图解还收录了 Figures 13-14 的任务网格与诊断面板。本文保留论文全部 17 幅图;10 张表的处理方式另有来源记录,正文只展开与方法和结果有关的部分。
5. Discussion:可复用的训练规则与后续对照
可复用的部分,是对生成记录、测试结果和任务难度分别做检查。
第一,准确记录原始生成。Harness 可以压缩历史,但训练系统必须保存生成时的 token ID、哪些位置由模型生成、对数概率和专家选择。最终聊天文本不足以重建这些信息。
第二,测试确实评判 Agent 的修改。Agent 可以看问题和仓库,但不能看参考补丁、隐藏测试或评分程序,也不能通过外网下载答案。环境错误要单独统计,不能一律当成模型没修好。
第三,区分任务有效和训练有用。能构建、能评分的任务,仍可能因为当前模型八次全错或全对而无法产生组内比较信号。
后续值得补做:同一模型在多种 harness 中联合训练,与分别训练做等预算对照;按近期成功率动态调整任务采样;逐项去掉防作弊措施检验贡献;重复至少三次训练估计波动;在 token 覆盖、专家路径或概率差异常时停止更新,而不是继续用不可信记录训练。
6. Conclusion:已有结果与复现限制
三套完整编码助手在保留原本执行流程的训练中,都提高了 SWE-bench Verified 验证最高分。 原始 token 核对、专家路径负对照、评分审计、任务筛选消融与系统性能记录,让读者能检查分数之外的训练过程;公开版本的历史重建缺口仍需单独处理。
LEGO-RL 最值得复用的是对训练数据来源的逐层检查。 正常路径记录模型实际生成的 token 和专家选择,隔离规则保护参考补丁与测试,诊断工具再检查概率和得分。研究 Claude Code、Codex 这类完整助手的训练时,这些检查能帮助识别错误更新;它们并不自动消除公开回退路径或一次训练结果的局限。
留言