这篇论文让 Codex、OpenCode、Pi 这类编码助手反复处理同一个项目:先由 Planner(规划者)安排本轮任务,再由 Developer(开发者)修改项目,最后由 QA Tester(独立测试者)检查。作者把这层长期开发程序称为 Harness-of-Harness(HoH)。每轮保留当前代码与资源,以及属于这个版本的测试记录;测试者不替开发者修源码,开发过程结束也不等于项目通过验收。
1. Motivation:多日开发为什么需要单独维护验证记录?
当开发持续几天,项目状态、验证结论和下一步决策会逐渐脱节。 普通 coding harness 往往在一次有时间或步数上限的会话里修一个问题或写一个局部功能。从零开始开发项目(greenfield development)持续几天时,会同时积累代码、资源、设计选择、已知缺陷和曾经通过的行为;后续局部修复还可能破坏早期功能。
论文把风险归为三类。第一,早期需求和设计决定会被遗忘。第二,高层 PRD 通常无法唯一确定“下一步最值得做什么”,Agent 容易在局部修补中循环。第三,完整软件的正确性分散在编译、交互、状态迁移、视觉、音频和运行稳定性里,单个通用测试很难覆盖。
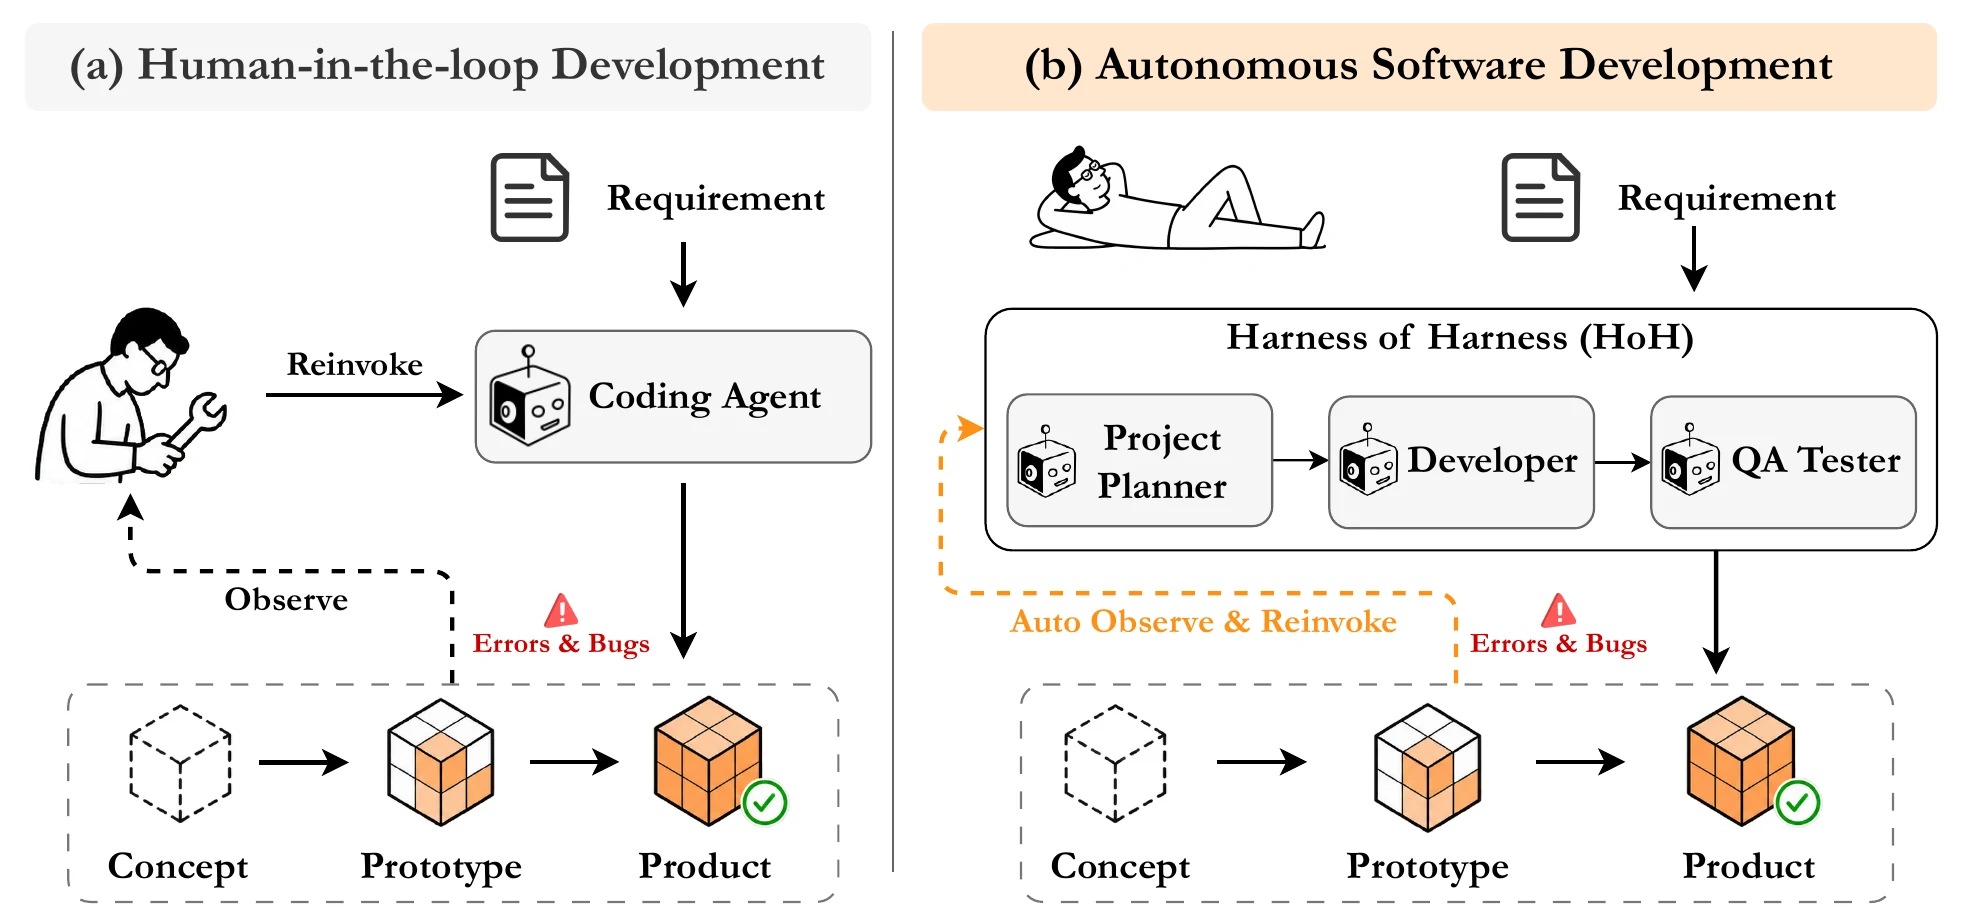
HoH 据此用“需求文档 + 当前项目 + 已验证记录”共同决定下一步。每轮只选择一个功能增量:范围有限,但局部完整、可测试。这样既避免一次改动扩散到整个项目,也避免只修一个文件却留下一条无法运行的半成品路径。
2. Related Work:与多 Agent、长上下文和执行程序自优化的区别
HoH 优化正在开发的项目,模型和底层 harness 保持不变。 它和角色式多 Agent 的表面结构相似,差别落在权限、跨轮状态和验收证据上。
| 路线 | 变化对象 | 状态怎样跨轮 | 与 HoH 的区别 |
|---|---|---|---|
| 长上下文/外部记忆 | 模型可见历史 | 对话、摘要或外部记忆 | 能记住过去,不等于把每个事实绑定到一个已测试候选 |
| MetaGPT / ChatDev | 固定的角色和消息流程 | 角色间文档与对话 | HoH 额外固定读写权限、冻结待测版本和验证记录格式 |
| AgileCoder / EvoDev / EvoMAC | 开发迭代、功能依赖或测试反馈 | 迭代计划和实现状态 | HoH 把当前项目和 QA 验证记录分别保存 |
| AutoHarness / Meta-Harness / Self-Harness | 提示词、工具、执行程序或调用流程 | 跨任务优化结果 | 它们改变模型外的执行机制;HoH 固定执行机制,持续改变项目 |
| LongHorizon-Harness | 单任务进度与有明确范围的验收要求 | 进度记录 + 只读核验报告 | 更通用地包裹 GUI/CLI 任务;HoH 针对软件开发保留版本化项目与独立质量检查 |
| Harness-of-Harness | 当前项目和开发验证记录 | (A_(t-1), E_(t-1)) → (A_t, E_t) | Planner、Developer、QA 每轮各调用一次同一 harness/model |
论文还引用 Proof-or-Stop、Self-Refine 和 Reflexion。它们都强调反馈或证据;HoH 进一步把“谁能写项目、谁能验收、证据属于哪个候选版本”落实成外层运行程序检查的规则。方法落在候选冻结、权限隔离和证据归属上。
3. Method:一轮 HoH:规划、开发、冻结版本、独立测试
每轮产生一份待测版本,只有 Developer 能写入,QA 的记录留给下一轮规划。
3.1 三个角色看到什么、能改什么?
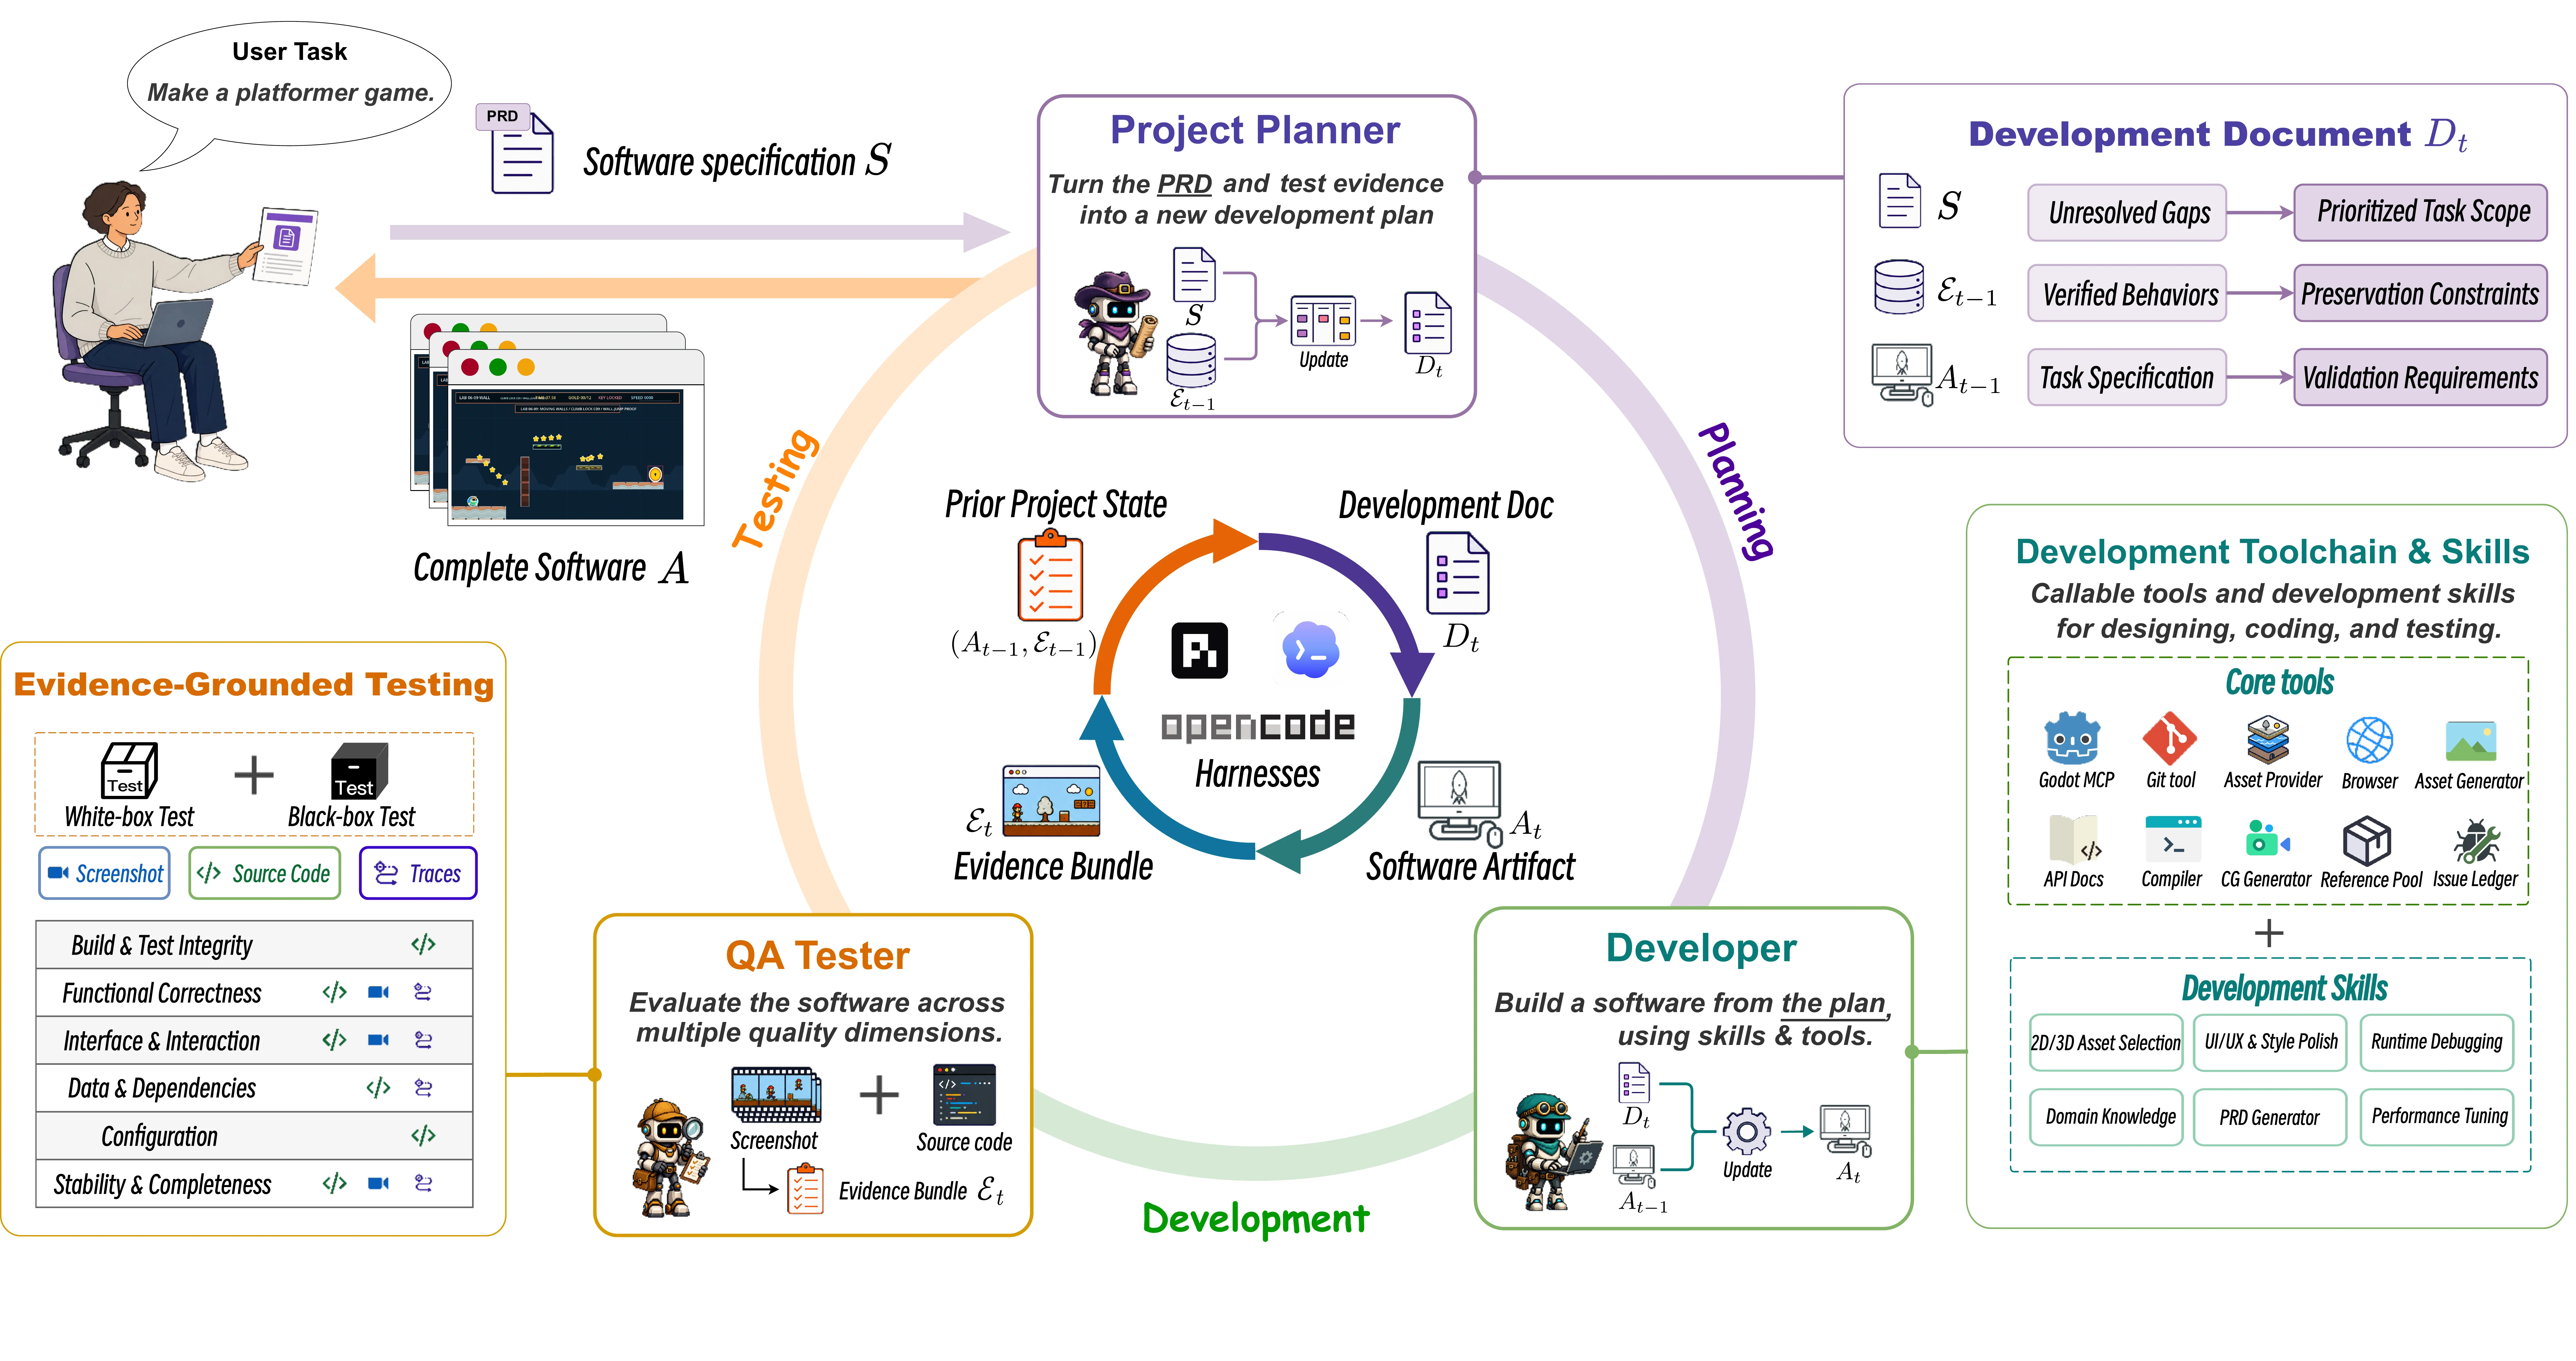
D_t。正文设计允许只读查看项目;公开实现的提示词禁止检查生产代码,并使用单独的规划目录。A_(t-1) 继续开发(warm-start),读取需求与 D_t;只有它能写项目,先测旧版本,再修改和自测。A_t,不能修代码;把已验证项和缺证据项分别写入 E_t。论文的 Algorithm 1 可以压缩成六步:
- 1 · PLAN用需求和旧验证记录选择一项可测的改动。
- 2 · PRESERVE列出不能回归的已验证行为。
- 3 · 开发前检查Developer 先测旧版本,确认哪些行为应保留。
- 4 · 修改并自测在现有项目上实现,再检查重要修改是否生效。
- 5 · FREEZE复制待测版本到隔离区,记录唯一版本标识。
- 6 · ASSESSQA 用黑盒和白盒证据生成下一轮
E_t。
3.2 外层代码也检查角色权限和调用顺序
公开的 hoh-lite(revision ae7cc6f,Python 3.12+,Apache-2.0)先用不可变 RoleBinding 检查角色配置。下面是官方源码摘录;Planner 或 Tester 如果被配置为读写工作区,初始化就会报错。这段代码校验的是配置,实际阻止读写还要看后续如何启动进程和挂载文件。
class WorkspaceAccess(str, Enum):
    READ_ONLY = "read-only"
    READ_WRITE = "read-write"
@dataclass(frozen=True)
class RoleBinding:
    role: RoleName
    workspace_access: WorkspaceAccess
    godot_mcp: GodotMCPAccess
    def __post_init__(self) -> None:
        if self.role is not RoleName.DEVELOPER:
            if self.workspace_access is WorkspaceAccess.READ_WRITE:
                raise ValueError(
                    f"{self.role.value} cannot receive a read-write candidate workspace"
                )
            if self.godot_mcp is GodotMCPAccess.READ_WRITE:
                raise ValueError(
                    f"{self.role.value} cannot receive read-write Godot MCP"
                )
Runtime 还检查调用顺序。正常调用顺序必须从 Planner 开始,Planner 后只能到 Developer;Developer 后才能到 Tester。每次调用的角色、状态、开始时间、耗时和摘要会写入 runtime_receipt.json。这让外层程序可以复核实际调用顺序,而不只是相信 Agent 的自述。
实际启动部分有三处值得区分。Planner 在单独的 planner/workspace 目录运行;Codex 适配器默认传入 --sandbox read-only,OpenCode 的 Planner 配置则禁用所有工具。正文 §3 允许 Planner 只读查看项目,但附录提示词和公开模板都写着“不检查生产代码”。因此,不能把公开 Planner 描述成实际浏览源码后作计划。
GameCraft 的 QA 在复制出的工作区运行。外层用 bubblewrap(Linux 文件挂载隔离工具)隐藏原任务、原提交目录和私有评测路径,并核对原提交源码的 SHA-256。Codex QA 在这个副本内反而使用 danger-full-access,方便写报告和更新 Godot 导入文件;不修产品代码是角色规则,保护原提交靠外层隔离与哈希核对。公开实现还有允许无隔离运行的显式开关,不能把默认路径的保护说成所有运行方式都具备。
公开 Planner 也不是从头自由重写整份计划:外层先生成文档框架,Planner 只补充最多三个优先事项及保留、验收要求。输出不合格式时会要求修正,仍失败则保留原框架并记录 fallback(规划调用失败后的备用结果)。这些实现细节来自固定代码版本,不能据此补写论文内部运行系统未公开的行为。
3.3 测试结论需要原始输出和文件路径
论文把每个待检查项写成 (claim, execution records, status):要验证的行为、实际执行证据、当前判定。例如“左右键会移动角色”需要引用操作回放和运行时位置变化;如果任务结束截图没有结果页,“出现结果页”就仍是缺项。下一轮 Planner 把前者列为不能破坏的功能,把后者列为需要补做并重新测试的目标。
{
  "verified_records": [{
    "claim_id": "player_control",
    "execution_records": [
      {"type": "replay", "observation": "Left and right inputs move the avatar."},
      {"type": "runtime_trace", "observation": "Position changes after each input event."}
    ],
    "status": "verified"
  }],
  "gap_records": [{
    "claim_id": "result_state",
    "execution_records": [
      {"type": "screenshot", "observation": "The objective ends without a result screen."}
    ],
    "status": "gap"
  }]
}
这段是论文 Listing 1 的缩减摘录。QA 可以引用截图、视频、操作回放、运行状态、日志和公开测试;代码里存在某个分支,不代表测试时已经执行过它。
4. Experiments:评分、对照实验与真实开发失败
HoH 的 QA 只看公开任务、当前项目和公开执行记录。
4.1 内部检查与最终任务评分是两套系统
Benchmark 在整次开发结束后才运行隐藏测试或按私有评分标准评判;结果不会进入 Planner、Developer 或 QA。
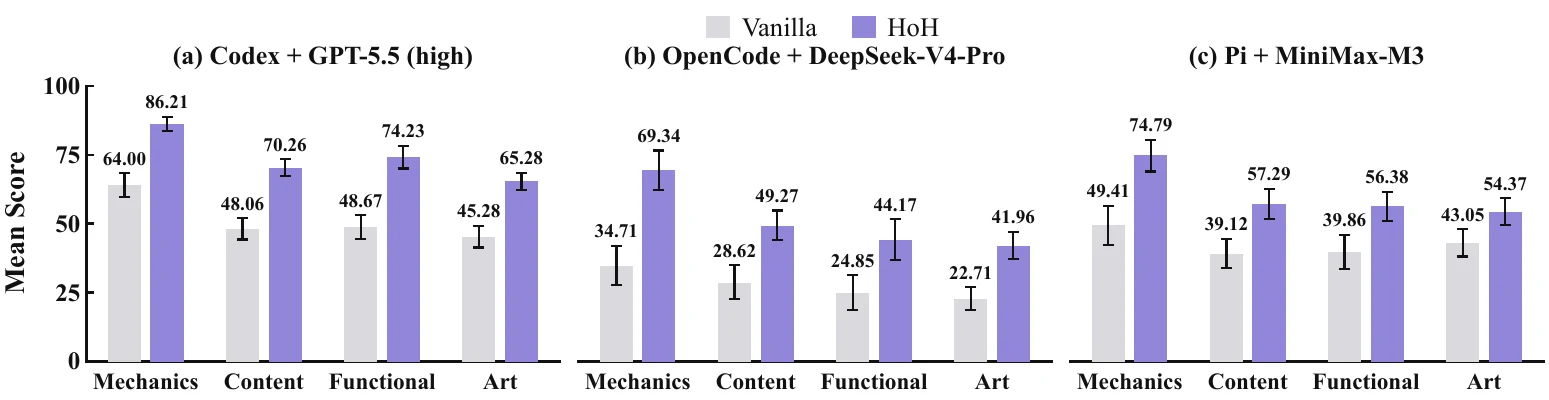
B=0,Overall 为 0;可运行时按四个维度加权。frogsgame-rl(需要当时不可用的 Tinker API 登录)和 modular-stack-wan21(要求 NVIDIA driver ≥580,实验 H200 worker 为 570.133.20)。每题由官方验收程序给分。其中 M/D/V/A 分别是核心玩法、内容深度、功能视觉、艺术与呈现四类评分项的均分。例如游戏可运行(B=1)且四项均为 0.8,总分就是 80;只要编译或启动失败(B=0),其他项再高也变成 0。这是公式说明例,不是作者案例的逐项分数。FrontierSWE 总分是 15 道题得分的算术平均;Dominance(相对优势分)先在同题上与其余 11 个配置逐一比较,胜/平/负记 1/0.5/0,再在领域内平均,再对三个领域平均。ProgramBench 的 Pass Rate† 是先算每题隐藏测试通过比例、再对题目取平均,不是整题全部通过的比例。
主实验使用 Codex CLI 0.142.5、OpenCode 1.14.30、Pi Coding Agent 0.80.10;对应模型如下表。每个任务在每种配置下只有一次有效实验。基础设施或模型服务通信故障会重跑,不算额外重复实验。不同客户端没有共同的可复现生成随机种子,论文也没有统一规定 temperature 或 top-p。
4.2 主结果:三种 harness 都有提升
| Harness + model | GameCraft Overall | FrontierSWE mean reward | ProgramBench Avg. Test Pass Rate |
|---|---|---|---|
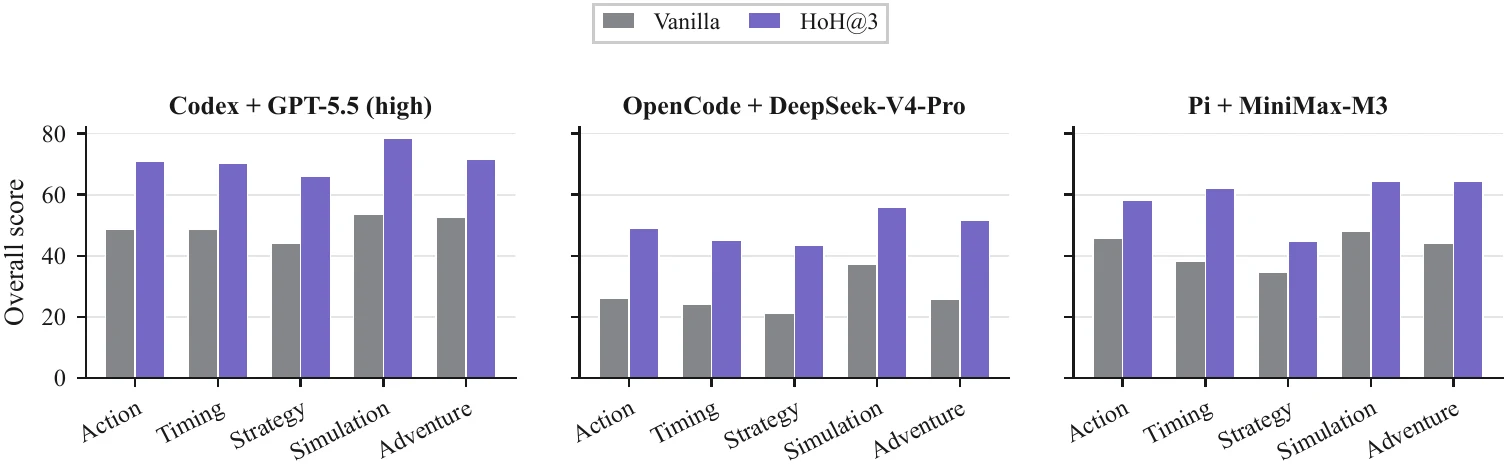
| Codex + GPT-5.5 high | 49.58 → 71.52 | 0.31 → 0.54 | 60.41 → 66.50 |
| OpenCode + DeepSeek-V4-Pro | 26.90 → 48.98 | 0.23 → 0.31 | 45.27 → 57.56 |
| Pi + MiniMax-M3 | 42.16 → 58.78 | 0.26 → 0.55 | 35.83 → 52.68 |
4.3 对照:普通继续开发能否获得同样收益?
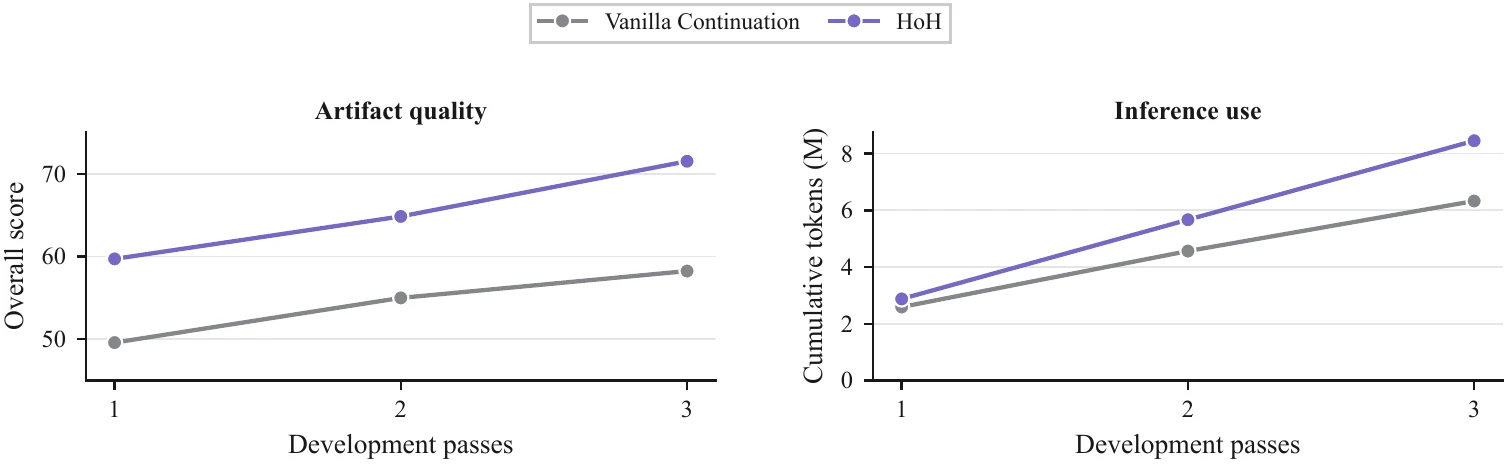
Vanilla Continuation 先做一次普通开发,再从最新项目继续做两次开发,固定提示是 Continue developing and testing the current game.;它没有新开发文档和独立 QA 记录。正文称其延续同一会话,附录 B.5 只规定同一 harness/model 的额外调用。公开包没有足够的实验记录确认三次调用是否共享完整对话,因此比较中能确定的是同样的开发次数、同样的模型和沿已有项目继续。一次 pass 指一次开发阶段:
| 方法 | 1 pass | 2 passes | 3 passes | 三轮 token / task |
|---|---|---|---|---|
| Vanilla / Continuation | 49.58 | 54.99 | 58.24 | 6.33M |
| HoH | 59.71 | 64.84 | 71.52 | 8.41M |
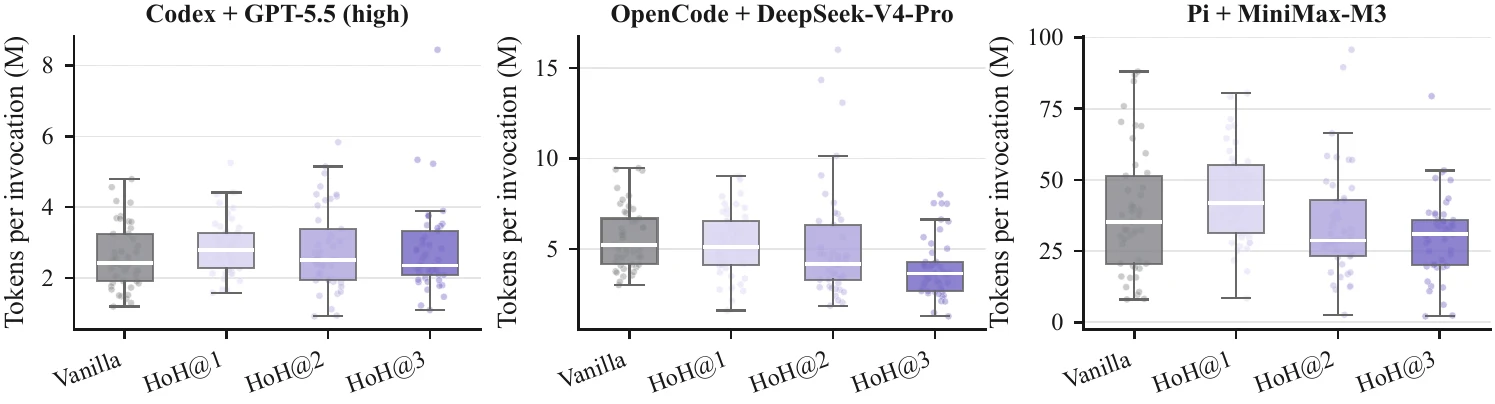
HoH@2 用 5.67M tokens 得到 64.84,已经超过三轮 Vanilla Continuation 的 58.24 和 6.33M。按论文公式,相对 Vanilla 每增加 1M tokens,三轮 Continuation 增加 2.32 分,HoH 增加 3.77 分。
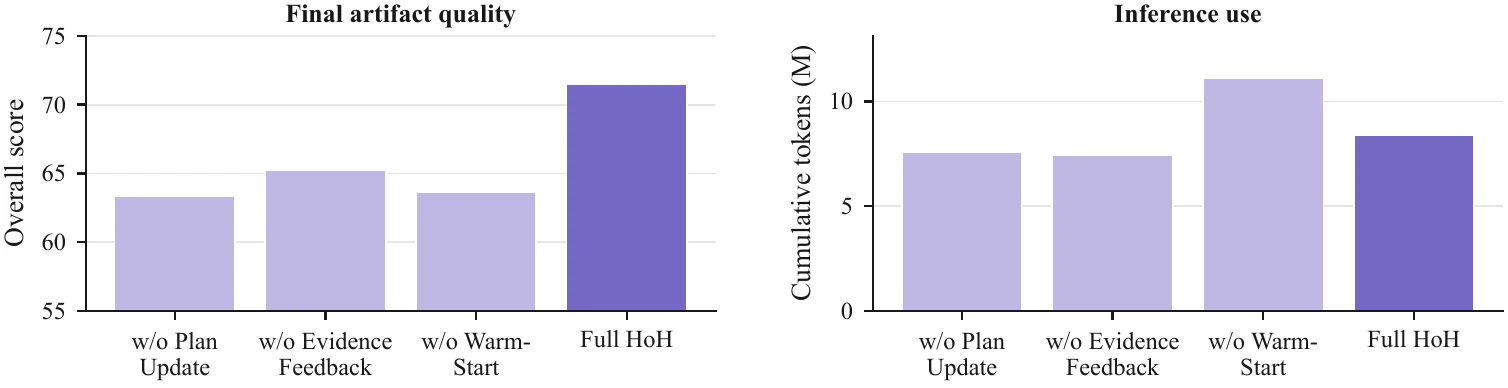
消融的 Full HoH@3 是 71.52。固定第一轮开发文档、不再更新计划(w/o Plan Update)后为 63.39;下一轮规划看不到 QA 记录(w/o Evidence Feedback)后为 65.23;每轮从初始工作区重建、不沿旧项目继续(w/o Warm-Start)后为 63.67。最后一项还把 token 从 8.41M 推到 11.12M。
三项消融降低的是总体均分,不是每道题都下降。 正文称所有消融在每题上都弱于完整 HoH,但 Table 22 的 Lighthouse 是反例:完整方法 80.90,去掉 Warm-Start 反而是 81.50。不能用平均收益推出单题必然收益。
4.4 FrontierSWE 能继续迭代,但仍有长期零分任务
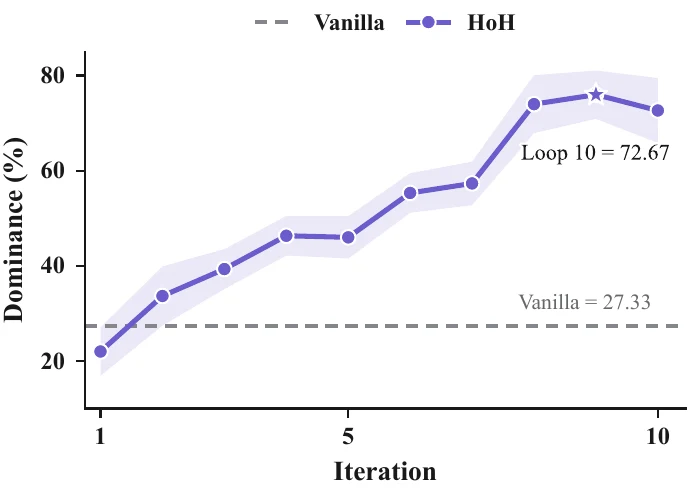
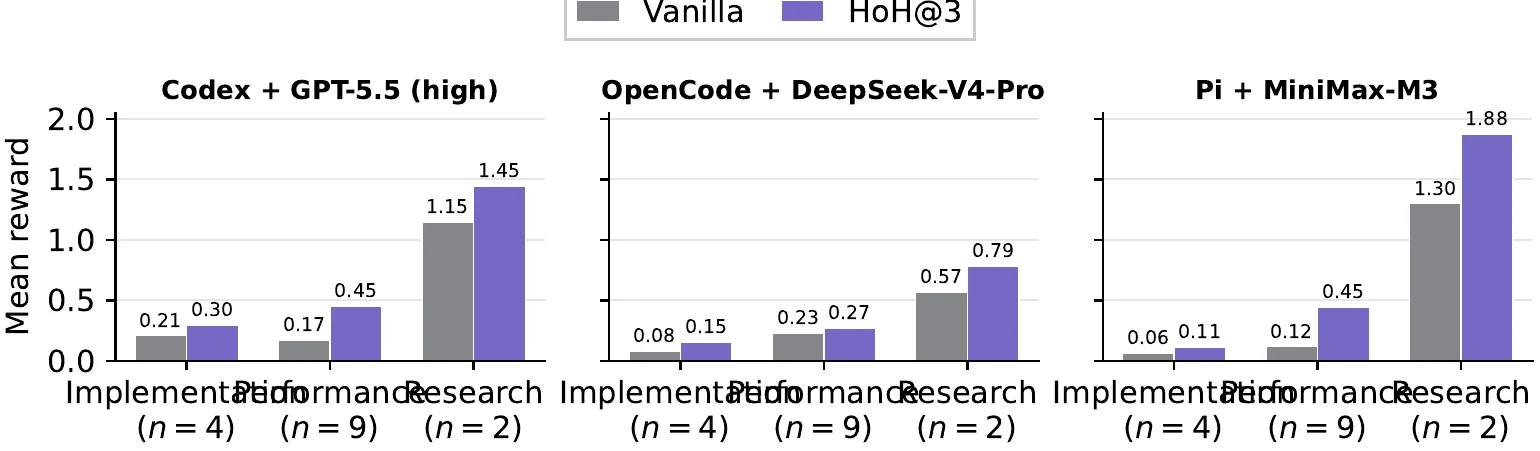
Figure 5 与主表的 Dominance 不能直接拼成一条曲线。Table 1 在三种系统各四个阶段组成的 12 配置池里比较,每题对手有 11 个;Figure 5 只比较 Codex 的 Vanilla 与 HoH@1–10,共 11 个阶段,每题对手有 10 个。所以同一个 Vanilla 在主表是 22%,到 Figure 5 变成 27.33%;这是比较池变化,不是重跑得到的准确率。十轮曲线的阴影表示 ±1 个标准误,也不是 Figure 4 的 95% bootstrap 区间。
聚合分数会遮住停滞项。Codex 在 Cranelift、Dependent Type Checker、FFmpeg 和 Inference System 四个性能任务上从 Vanilla 到 HoH@3 都是 0。Pi 的 Revideo 也一直是 0。持续迭代能提高部分任务,不保证跨过每个 verifier 的硬门槛。
4.5 真实 Loop 70:开发者说完成,独立检查为何不通过
Fusepoint · 第 70 轮战斗可读性修复 · loop-70-c3d32741612b
- 来源:作者公开 Fusepoint 仓库 revision
55b442fc的真实规划、开发与测试记录。Planner 从问题清单里选了四个待修项,同时要求保留正常启动、三组敌人数量、鼠标视角控制、武器组件和结局逻辑。 - 要求:步枪敌人不能误用手枪动画;Alpha/Bravo/Charlie 三组应分别准备出 3/5/10 个敌人,再进入实际战斗;剧情提示应等待玩家确认,而不是自行消失;战斗反馈也要完整清理。
- 开发阶段:公开 Planner 记录分配了动画绑定、敌人战斗流程、剧情提示与反馈清理三项任务。Developer 记录提供修改前后的源码哈希,证明产出了新候选;它只引用一份未在公开树中找到的详细开发回执,不能独立证明“修改了六个文件”或开发者如何自报 PASS。
- 测试操作:QA 先检查正常启动,再进入游戏,调用各组遭遇战的准备与推进路径,采集敌人运行状态、截图、日志和画面。测试的是冻结副本,不能现场改代码。
- 实际观察:3/5/10 个步枪敌人能生成,代码也不再把步枪状态映射到
Pistol_*动画。但推进后只看到待机和走路,没有发现目标、允许开火、射击、换弹、受击或死亡的证据。点击 Replay 回到部署前页面后,已测试的输入也不能通过 DeployButton 重新开局。 - 判定:正常启动通过,步枪动画绑定这个局部问题也有修复证据;但敌人战斗 AI、完整动作、战斗反馈、音效/视觉特效、运行稳定性未通过。测试者给出
status = fail,外层最终phase_status = blocked。规则要求所有必需检查通过、阻断项为空且无 major/blocker 级发现;局部启动 PASS 无法满足这条规则。
“代码修过了”和“当前版本实际通过验收”必须分开。 这轮敌人存在、动画名正确,都不能推出它们能瞄准、开火、换弹并完成战斗。QA 把这些尚未观察到的动作保留为待解决项,而不是用局部代码检查关掉整条问题。
这里的结论来自公开记录,不是我重新运行了游戏。测试前后的源码 SHA-256 相同,报告里的截图、操作与判定引用同一候选;公开 Developer 记录没有详细实现日志。另一个重要边界是,单案例使用 GPT-5.6-Sol high、Godot 4.7、专用素材/界面/测试 skills 和 GitHub issue 管理;主 benchmark 用 GPT-5.5 high 等三种配置、Godot 4.6.2,不能把两套配置的结果混作一次实验。
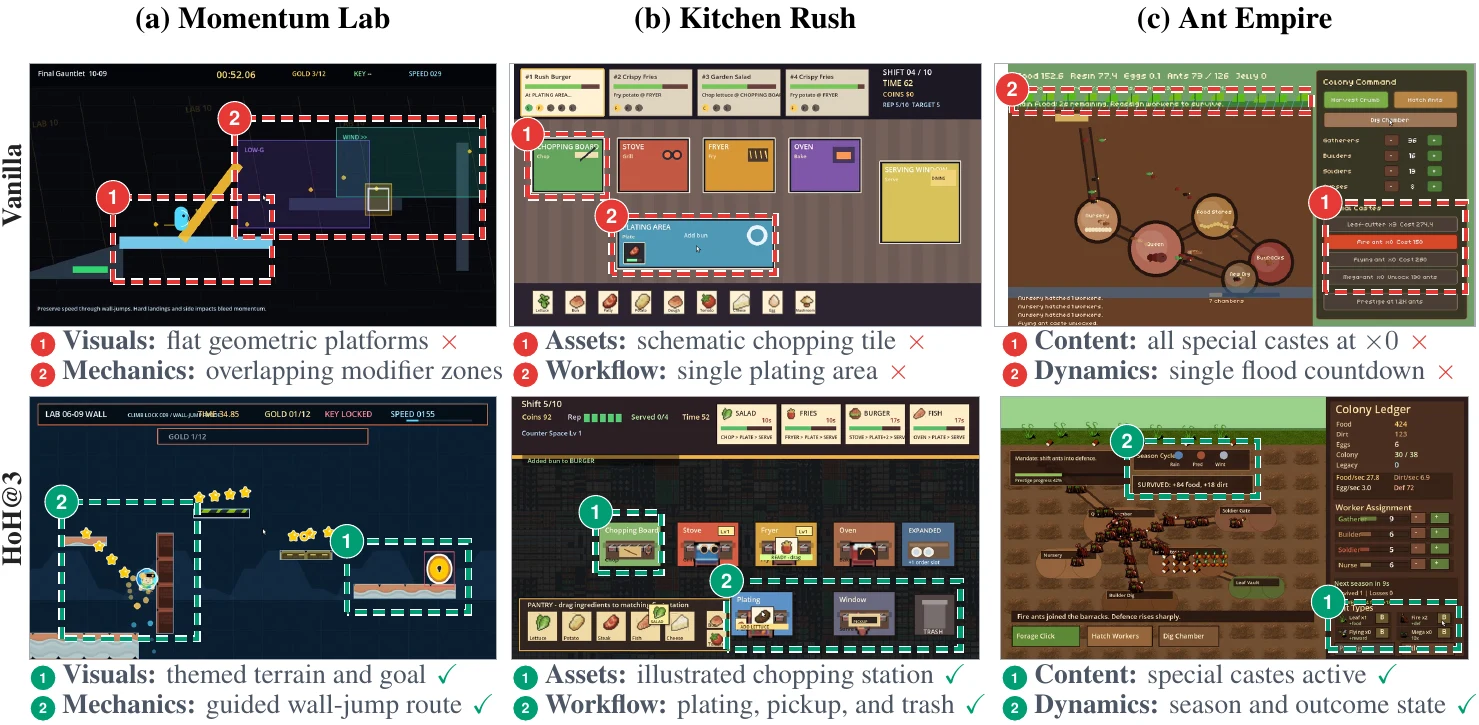
4.6 补充结果:按类别统计与作者挑选的产物
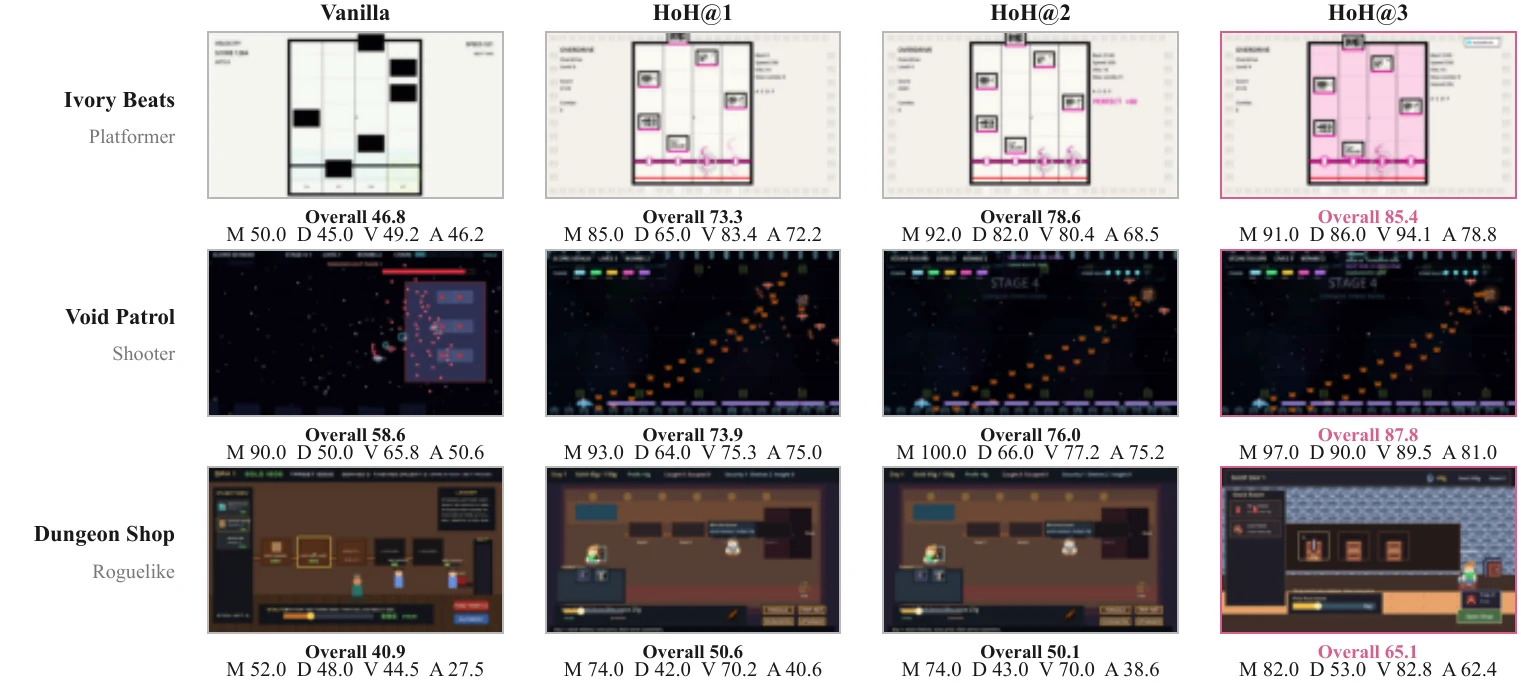
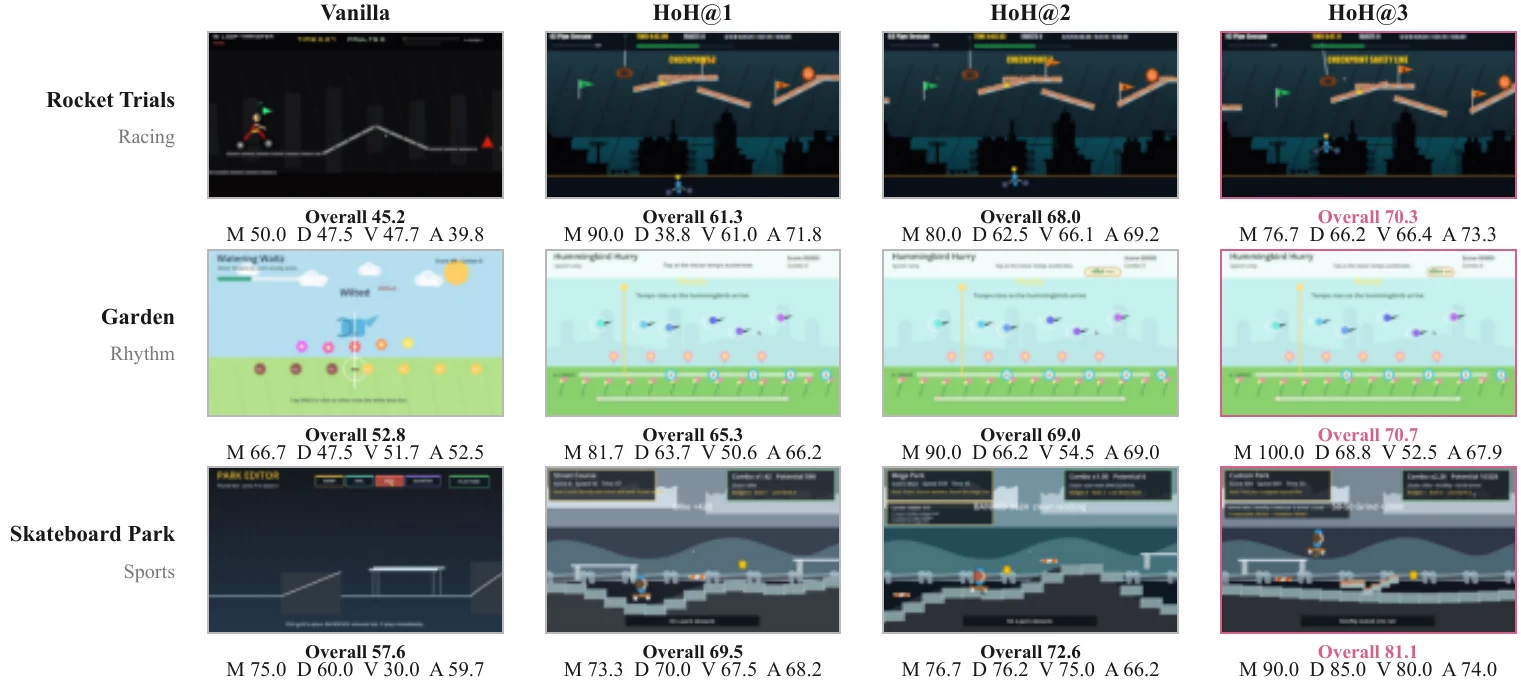
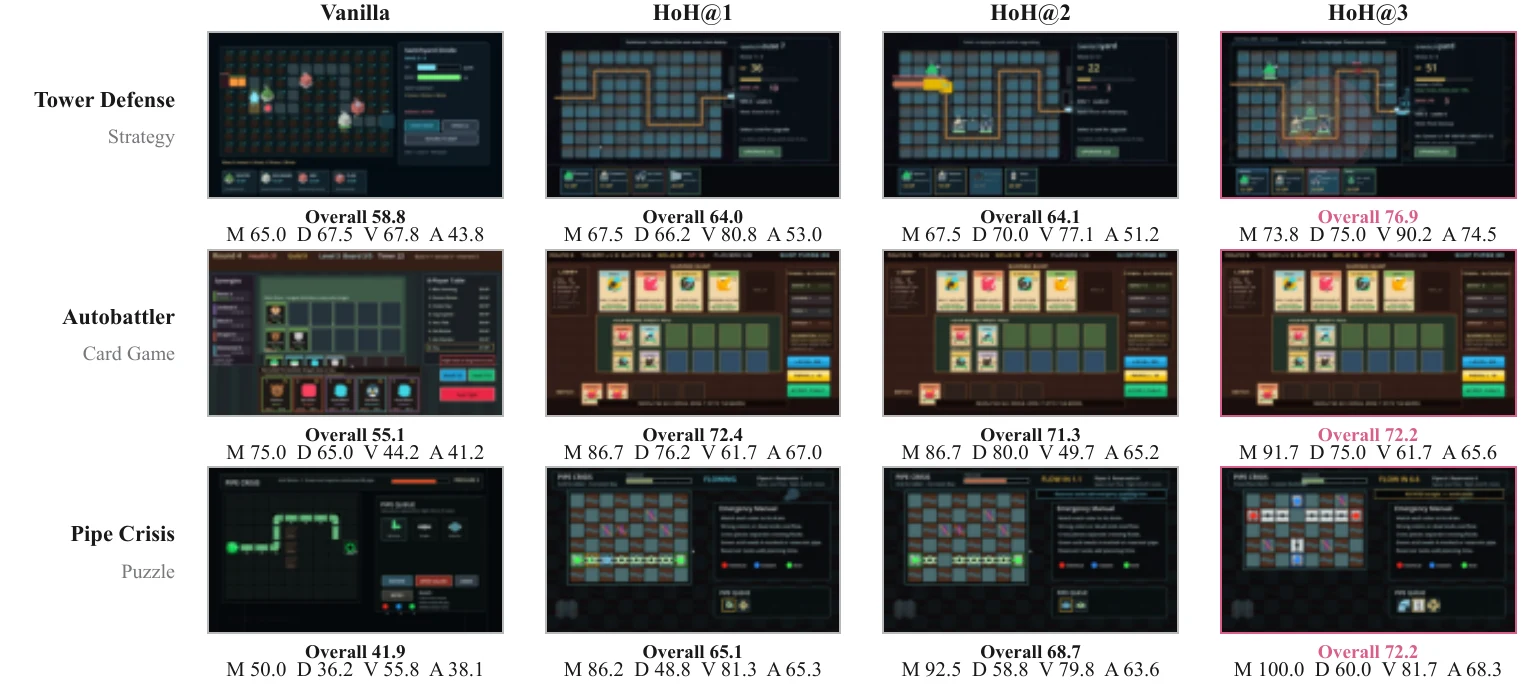
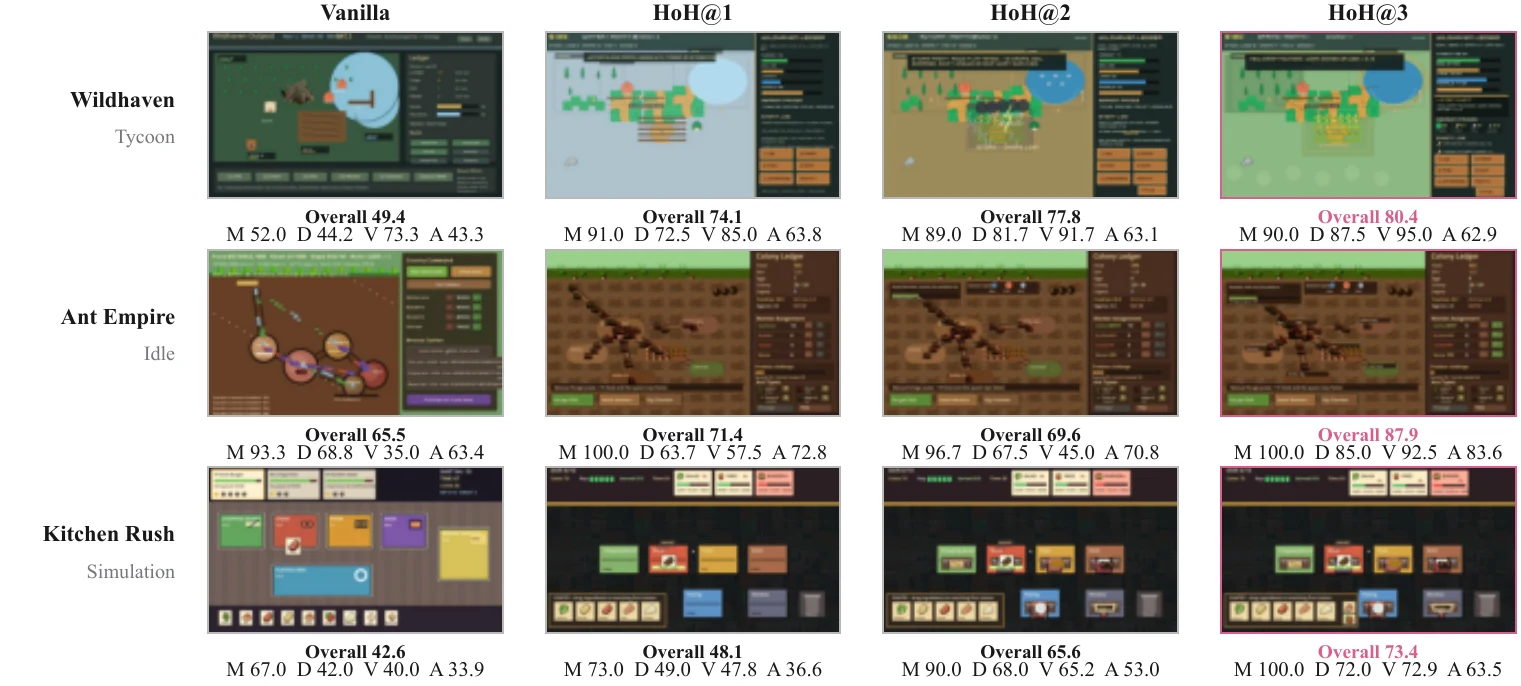
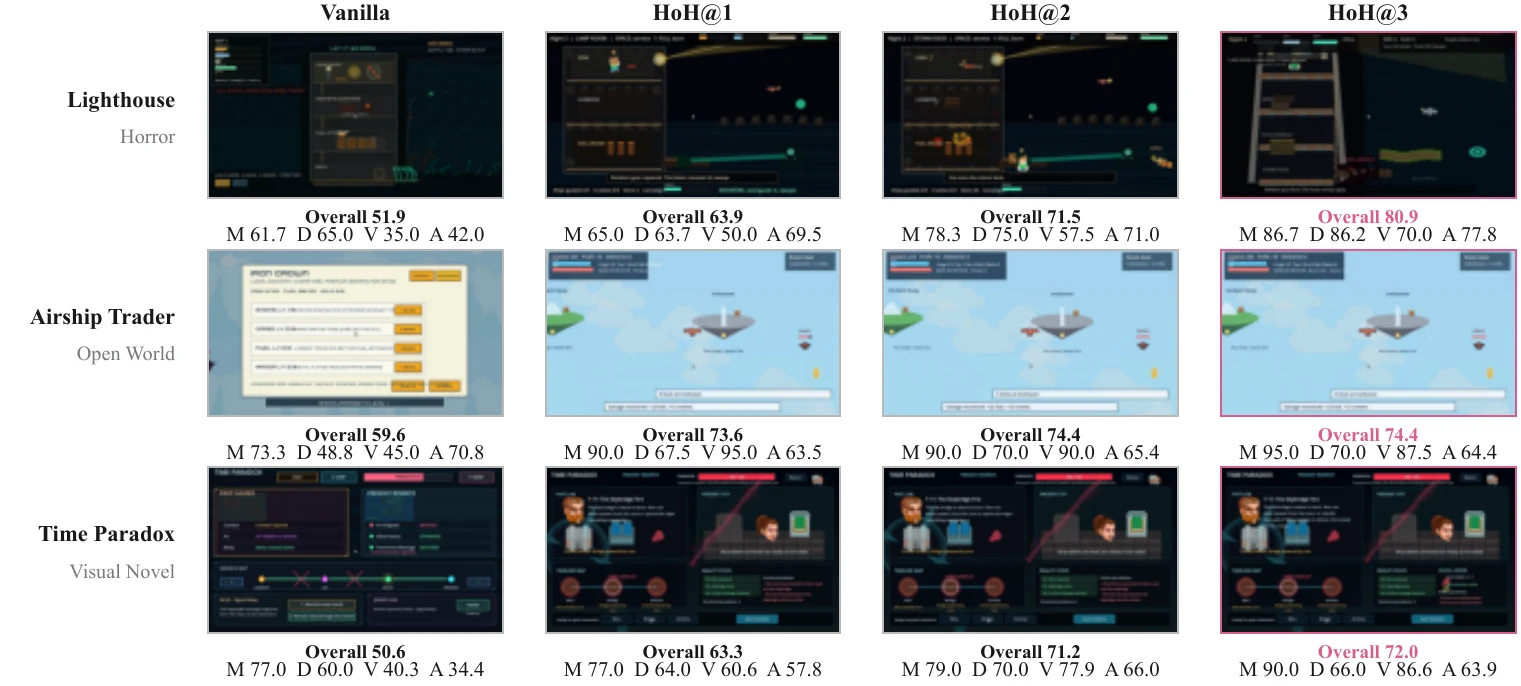
查看原论文 Figures 12–16:15 类游戏的产物对比
每类选取 HoH@3 分数最高的一题,共 15 题、60 个产物。图片能展示效果变化,不能代表随机抽样的成功率;精确分项分数见 Table 25。
5. Discussion:值得复用的规则与后续对照
对后续研究更有用的是四条可测试的系统约束。
第一,生产项目只由 Developer 修改。Planner 根据公开需求和已验证记录安排任务,QA 运行副本;公开实现对副本的权限与原项目的保护是两回事,都应检查。
第二,证据属于具体版本。截图、日志和回放必须对应同一份冻结代码;否则旧截图和新代码拼起来,可能给出一个任何真实版本都没有通过的结论。
第三,公开反馈与最终隐藏评测分开。开发过程可以使用公开测试和运行观察,不能使用最后评测的隐藏答案、分数和解释。
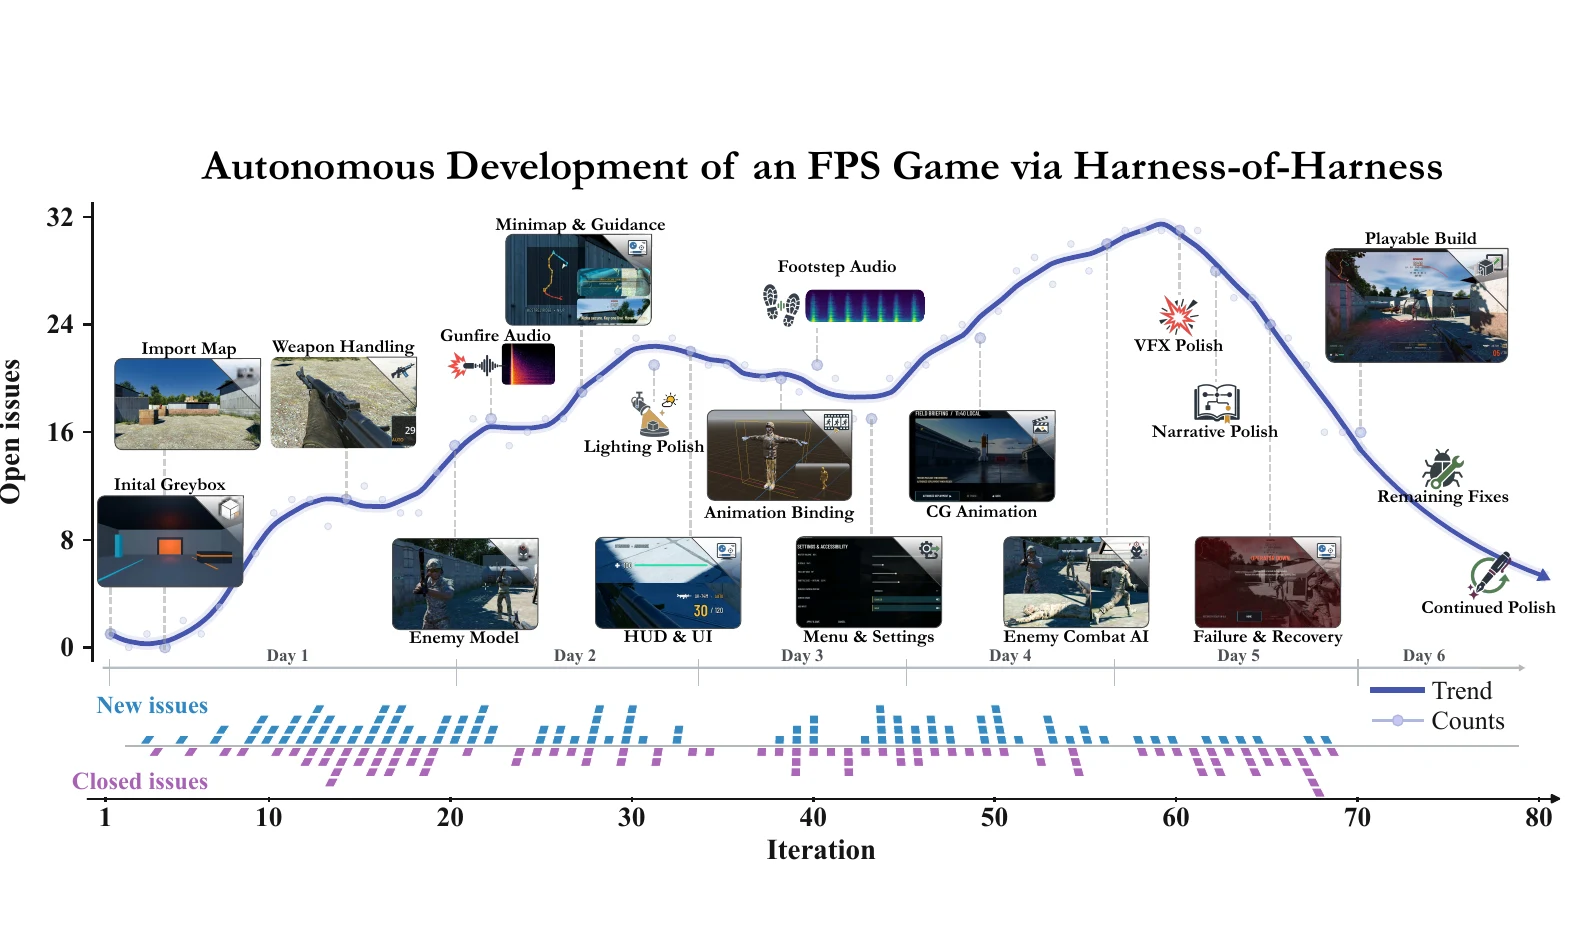
第四,下一轮不仅写“要修什么”,还写“哪些功能不能改坏”。Fusepoint 有 17 个曾关闭问题后来重新出现,说明长期开发的难点会逐渐从补功能变成防止回退。
后续需要的对照也很具体:
- 固定总 token、运行时间和模型调用次数,比较普通继续开发、HoH 与 LongHorizon-Harness。
- 测 QA 的误放行、误拒绝及跨模型一致性,分别去掉运行观察和代码检查,看哪类证据有效。
- 统一版本标识、测试操作、观察与判定的记录格式,让不同 coding harness 复用。
- 比较始终沿最新版本开发、回滚旧版本和保留多个候选的策略。本文尚未系统比较这些选择。
- 在总体均分上涨时,单独跟踪持续变差的任务,检验停止或回滚规则。
6. Conclusion:已证明的收益与仍未解决的限制
论文有一套完整、可执行、公开到角色权限和真实调用记录的 harness 设计;实验支持整套 HoH 有效,但还不足以精确分解收益或证明多日项目已经达到独立产品验收标准。
hoh-lite 足以检查运行编排协议,不足以复算全部表格。我的结论是:HoH 把“继续让 Agent 写”改造成“每轮产生一个版本化候选,再用独立证据决定下一步”。 对 Claude Code、Codex 这类完整 harness,这比再加一段更长 prompt 更接近真实项目里的版本管理和验收流程。后续最值得补的实验是:测 QA 的误判率,在固定预算下分配三类调用,以及验证何时该停止开发或回滚到旧版本。
留言