LongHorizon-Harness 解决的是一个很具体的问题:Claude Code 或 Codex 做几个小时的任务时,执行历史会越来越长,“已经完成了什么、哪些结果真的验证过、下一步应改哪一处”逐渐混在聊天记录里。论文单独保存任务进度:Manager 分派下一步,Executor 在新会话里执行,Auditor 只读检查结果。下一轮不继承完整聊天历史,只使用已经核验的进度和当前子任务。
1. Motivation:长聊天历史为什么仍会丢进度?
长上下文保存了历史,却没有把“可信的当前状态”单独维护出来。 同一个会话同时负责执行、记住进度和判断自己是否完成时,三个问题会互相放大。
论文列出三种失败。Compounding errors 指早期误判被后续步骤反复沿用,例如把“文件已保存”当成事实。Context rot 指历史越长,模型越难从截图、命令输出和试错里找准当前约束。Task-state loss 指某些必要进度被遗忘,例如任务要求先截错误状态、再修公式、最后截修复结果;只记住“公式修好了”就无法补回真实的修复前截图。
论文的结构性判断是:执行轨迹和任务状态不应该放在同一个不断增长的上下文里,执行者也不应该给自己的结果盖章。LongHorizon-Harness 因此把任务状态放到 Executor 外面,并让独立 Auditor 只读检查环境。
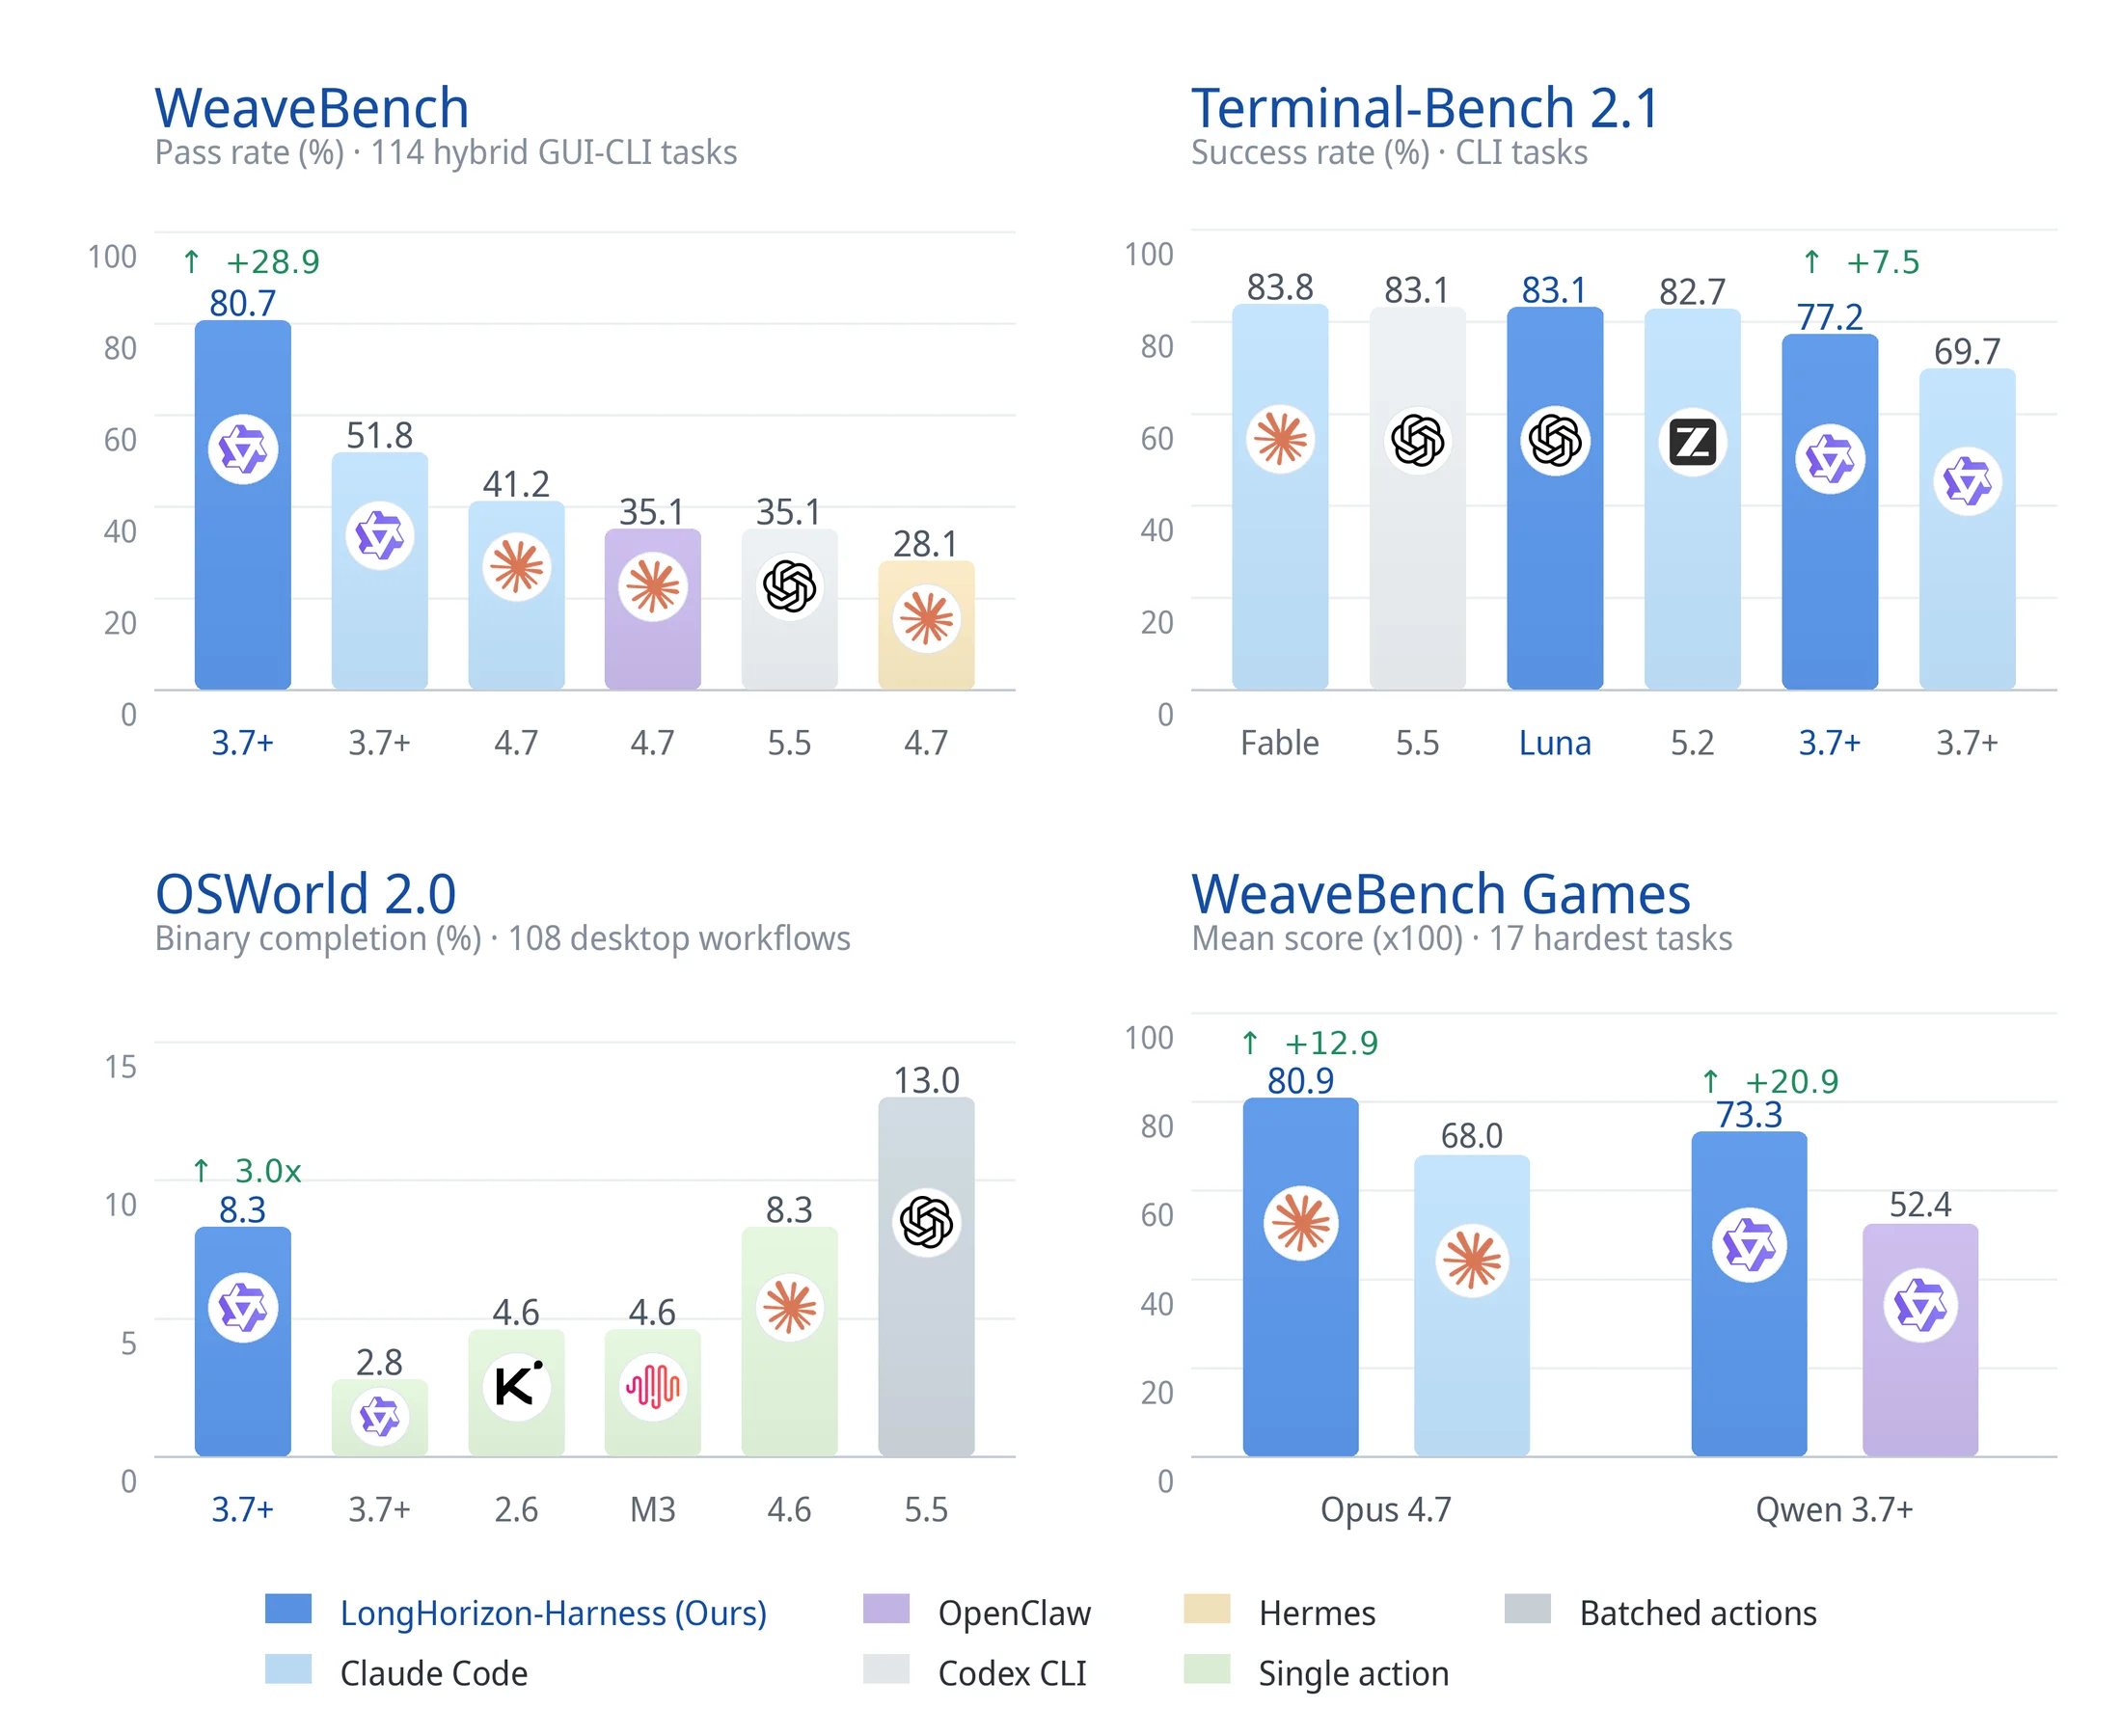
assets/harness_perf.png。图把本文结果和部分官方榜单放在一起;因果解释应以同模型、同执行程序的配对结果为主。官方仓库 MIT License。方法依赖明确的职责和权限边界:Manager 不接触环境,Executor 可以改变环境,Auditor 能观察环境但不能修复它。三个角色可以使用同一个模型,但每次调用必须拿到不同的上下文、工具和写权限。
2. Related Work:与模型蒸馏、执行程序演化和普通多 Agent 的区别
LongHorizon-Harness 优化的是一次任务运行中的状态推进,不训练模型,也不自动修改底层 harness。 它把 Claude Code、Codex CLI 等系统当作可替换的执行程序,在外层决定每轮做什么、保留哪些进度、何时结束。
| 路线 | 可变化的对象 | 发生阶段 | 本文与它的边界 |
|---|---|---|---|
| Harness-Zero | 用教师执行程序生成、筛选训练记录,再微调基础模型 | 训练阶段 | 目标是让模型学会 harness 提供的行为;LongHorizon 不更新模型 |
| Agentic Harness Engineering | 提示词、工具、中间处理逻辑、技能和记忆 | 跨任务演化 | 目标是自动改进 harness;LongHorizon 固定执行后端,在单个任务内控制状态 |
| Claude Code / Codex 原有运行循环 | 会话中的计划、工具调用和历史压缩 | 单次运行 | 执行和自我判断通常共享历史;LongHorizon 把持久状态与审计拆出来 |
| Planner / worker / reviewer 多 Agent | 角色与消息流程 | 单次运行 | 角色名相似不够;本文明确规定谁可写环境、哪些证据可跨轮、何时允许 done |
论文没有单列 Related Work,也没有系统性地把所有多角色编排方法放进同一张实验表。它引用了规划、子 Agent、计算机操作和长上下文相关工作,但实证问题收得更窄:单独保存已核验进度,能否让现成 harness 在长任务中少丢进度、少相信错误的自我判断。
3. Method:一轮执行:分派子任务、操作环境、核验结果
Manager 分派下一步,Executor 修改环境,Auditor 独立检查;只有核验支持的进度才能复用。
3.1 Manager 保存什么?
Manager 每轮读原始任务、当前任务进度与历史核验报告,但它没有 GUI、shell 或文件权限。它维护两份自然语言状态:Current task state 和 Task contract。
Task state 至少分四栏:已完成、未完成、阻碍与风险、尚未可信/不可复用。Task contract 保留原任务中的精确对象、文件名、路径、字段、格式和禁止项,同时写清五件事:最终结果保存在哪、以哪个输入为准、必须经过哪些操作、何时算真正保存完成、怎样验收。它限定本轮的检查范围,不是让 Manager 代替 Executor 写出每一步操作。
官方源码在 ManagedRound 中保留这些字段。下面是基于 revision a1dd930 的原始结构摘录,运行时为 Python 3.11+:
@dataclass
class ManagedRound:
    round_index: int
    next_step: RoleNextStep
    plan_text: str
    executor_output: str = ""
    auditor_report: str = ""
    harness_feedback: str = ""
    task_state: str = ""
    task_contract: str = ""
    related_report_refs: list[str] = field(default_factory=list)
3.2 每轮只执行一份有明确范围的验收要求
- 1 · 读取进度Manager 读取原任务、当前进度与历史核验。
- 2 · 写验收要求选择一个未完成目标,写验收条件和禁止改动。
- 3 · 选择执行方式按主要状态变化选择 GUI 或 CLI。
- 4 · 执行新会话只接收本轮信息,修改环境。
- 5 · 报告Executor 报告动作和产物,此时仍未验证。
- 6 · 核验新会话只读检查结果,记录证据与缺项。
- 7 · 更新进度Manager 采用审计事实,决定下一轮或结束。
Executor 收到原任务、任务进度、本轮验收要求,以及明确引用的历史核验报告。它看不到以前逐步生成的思考、命令与观察记录。官方通用适配器每轮创建唯一提示文件,再在同一工作区启动一个新的 CLI 进程。Claude Code adapter 额外设置 CLAUDE_CODE_DISABLE_AUTO_MEMORY=1 和 CLAUDE_CODE_SKIP_PROMPT_HISTORY=1;Codex adapter 通过 codex exec --json 从 stdin 读取本轮提示。
这里有一个安全细节:Codex adapter 默认在隔离环境中使用 --dangerously-bypass-approvals-and-sandbox,因为外层环境已经负责隔离。论文的角色边界不能替代部署隔离;如果把它放进真实项目,工作区、凭据和网络权限仍要单独设计。
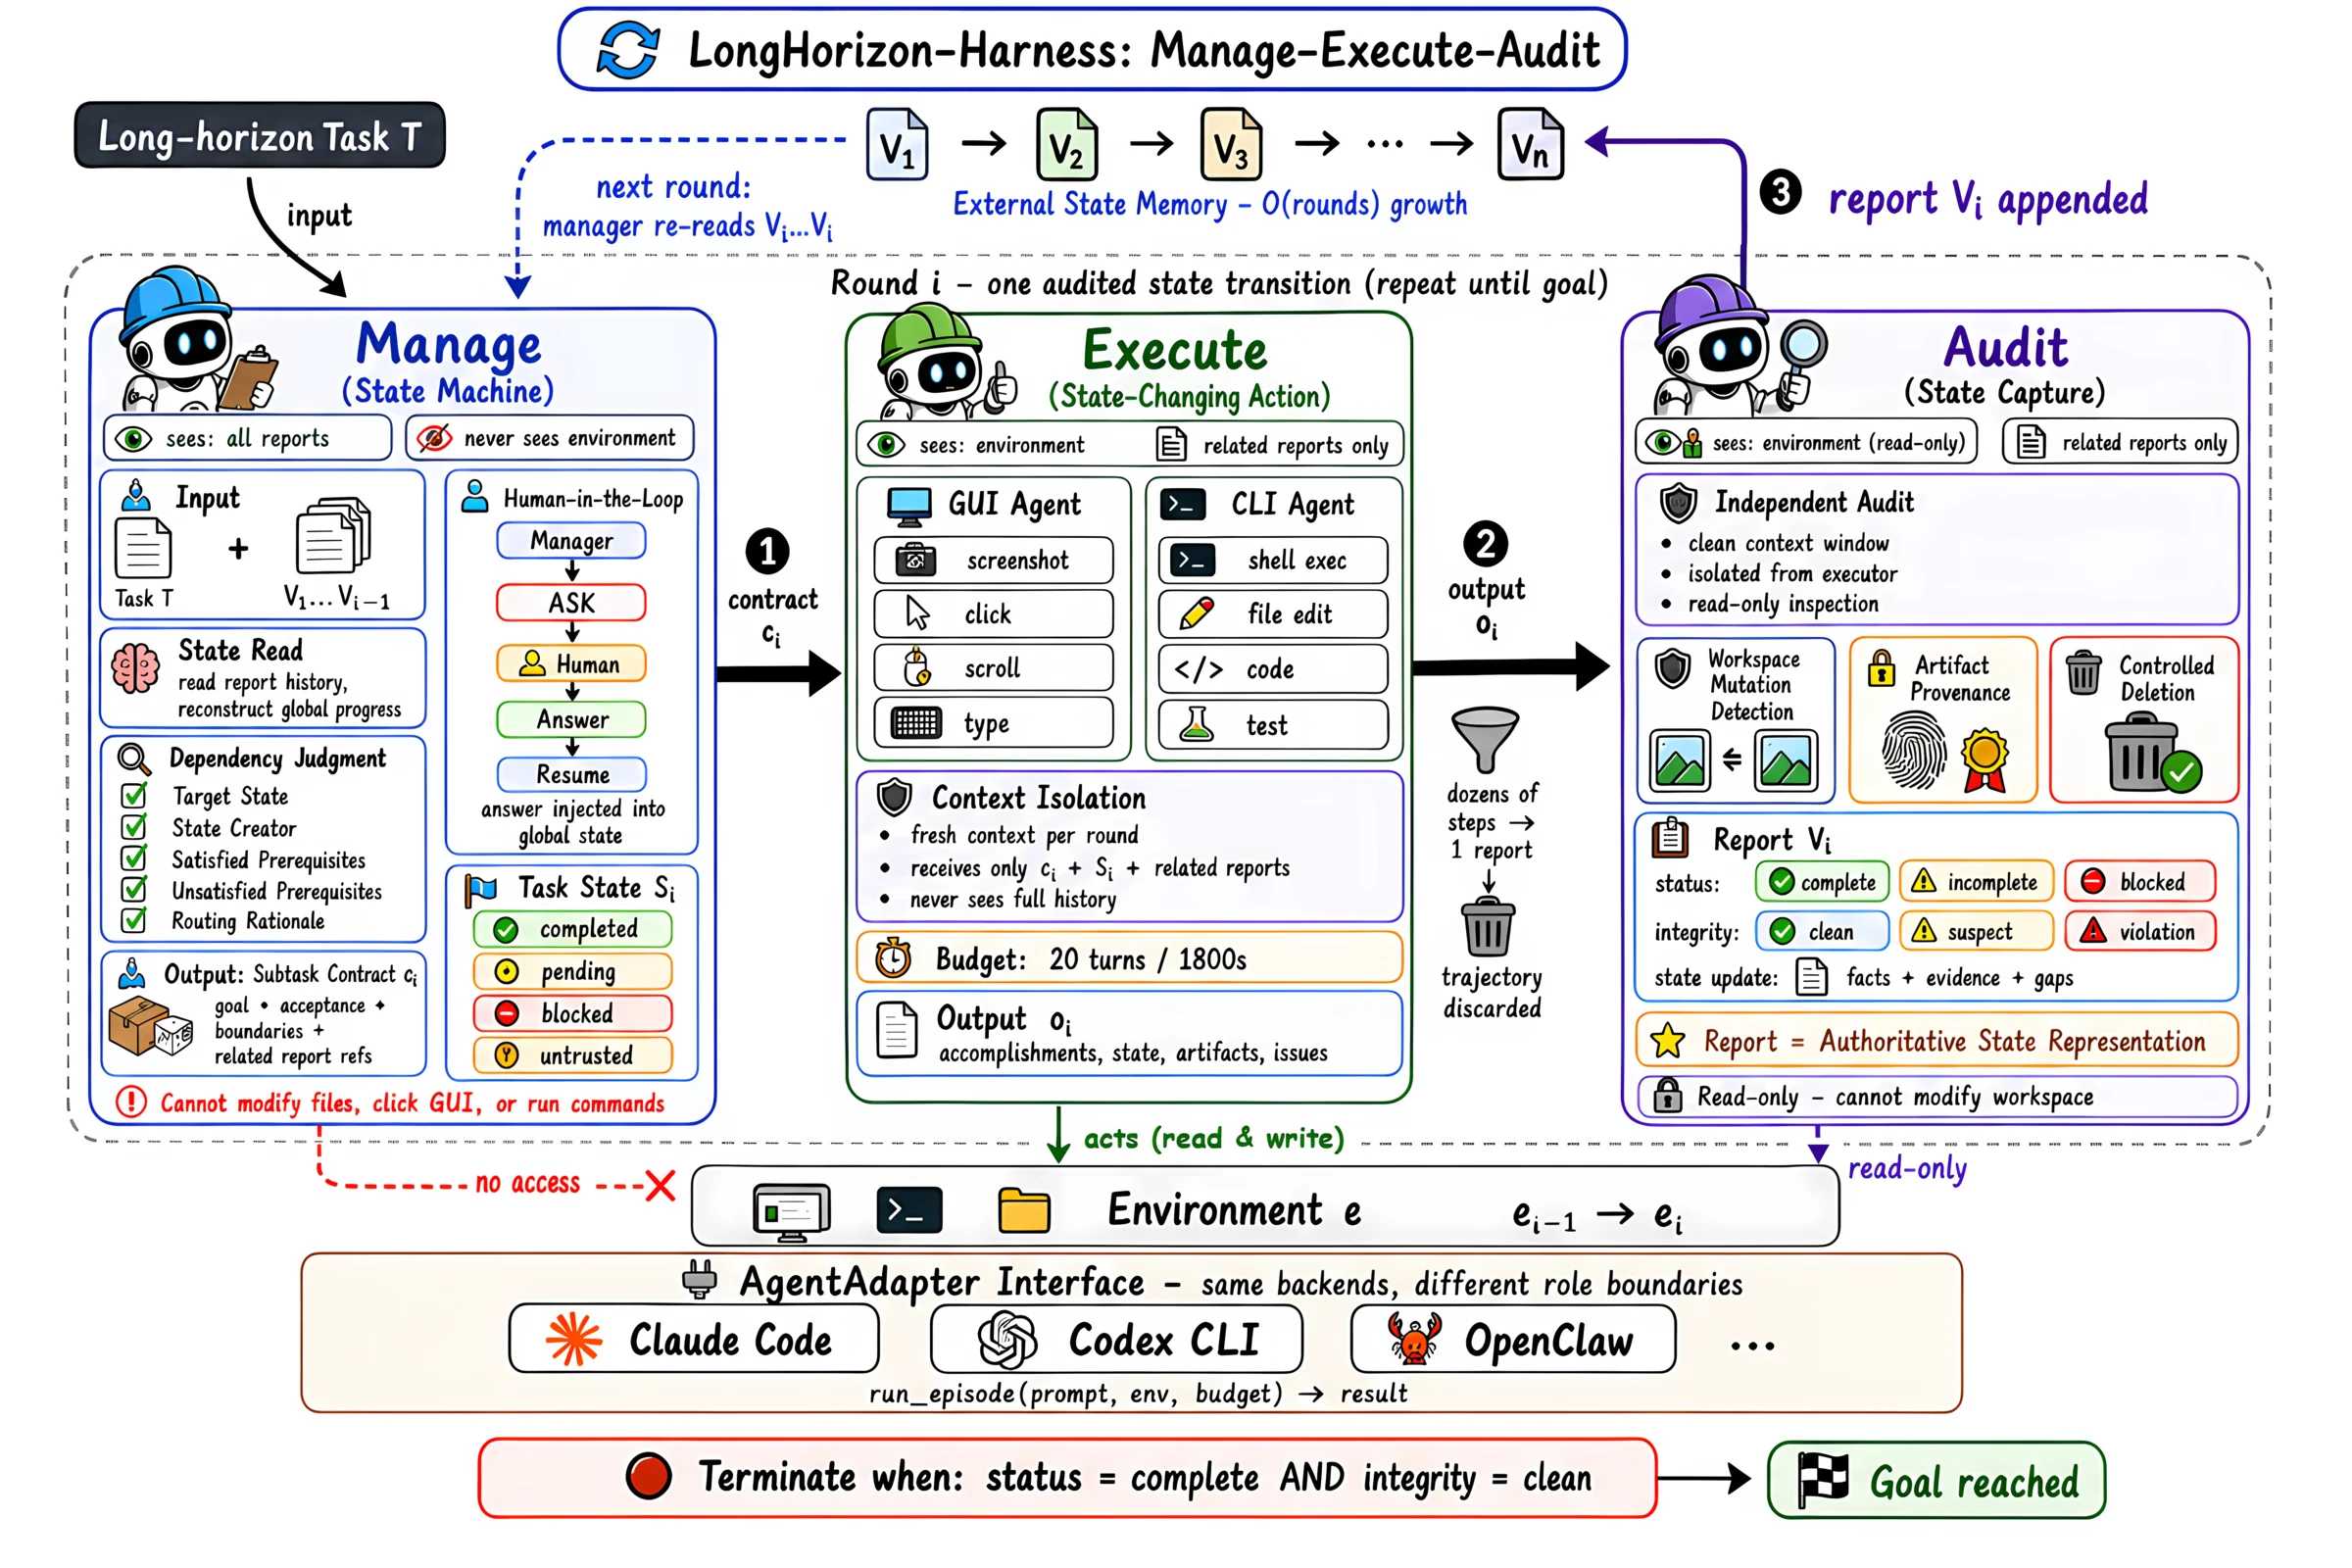
assets/mea_main.png。Manager 无环境访问;Executor 可读写;Auditor 只读。论文 Figure 2 与当前仓库流程一致,但当前源码还要求 contract audit 为 aligned。官方仓库 MIT License。3.3 Auditor 怎样把“看起来完成”变成可用状态?
Auditor 看到原任务、当前进度与验收要求、相关历史审计和 Executor 的简短报告。它不看 Executor 的内部推理文字或完整历史。论文要求它只观察环境,不改变待检结果。当前仓库的 GUI Auditor 提示词还更严格地禁止点击、输入、滚动和改变窗口,允许观察屏幕、检查已有截图与只读文件。Claude Code adapter 会比较审计前后的工作区快照;若检测到任务文件被修改,报告会被标为 integrity violation,即核验过程违反只读要求。
论文的权限设计与固定代码版本不能混成一件事。 在 revision a1dd930 中,GUI 和 CLI Executor 都能加载计算机操作工具,差别主要由任务提示限定;GUI 并非从工具层彻底失去 shell。Auditor 的禁用名单屏蔽 Write、Edit、NotebookEdit 和 Agent,却没有禁用 Bash 或全部计算机操作工具,只读命令也没有在这里实现为硬性允许名单。Manager 提示词要求不读取环境,但工具禁用名单没有排除 Read/Glob/Grep。因此这些角色规则加上快照检测,仍不等于文件系统或进程沙箱。
Auditor 的前三行是机器会解析的控制头:
Status: complete | incomplete | blocked
Integrity: clean | suspect | violation
Contract audit: aligned | unknown | needs_revision | invalid
源码强制检查完成条件:
return (
    report.status == "complete"
    and report.integrity_status == "clean"
    and report.contract_audit_status == "aligned"
)
complete 表示任务完成,clean 表示核验未发现越权修改,aligned 表示本轮验收要求与原任务一致。当前源码的三个条件缺一不可。 不满足时,即使 Manager 输出 Next: done,主循环也会拒绝结束,并把缺失条件送回下一轮;报告里仍有阻断项时,解析器还会把 complete 改成 incomplete。论文 §2.4 本身列的是完成状态、完整性状态和支持进度更新的证据;第三行 Contract audit 是固定仓库版本中能直接检查到的附加要求。
论文和当前配置都规定最多 25 轮,每轮 Executor 最多 1800 秒,Manager 和 Auditor 各 300 秒。它们是各角色调用的上限,不是每题实际平均耗时。附录 Figure 20 的一轮 Auditor 却记录了 600 秒调用上限以及命令在 660 秒超时;这一条展示轨迹与上述默认值不同,不能把默认值说成所有实验调用都严格遵循的事实。
4. Experiments:评分协议与真实失败案例
内部 Auditor 帮助继续执行,论文分数仍由各 benchmark 的最终评测器决定。
4.1 内部 Auditor 不负责论文表格里的分数
chat.jsonl,逐个产物核对要求,再给八个维度打分。env.evaluate()。Binary 只把 final score = 1 计为完成;Partial 是 108 题的平均细粒度分数。WeaveBench judge 的公开 prompt 规定:先逐项检查产物和要求,再评任务完成、产物正确性、质量、证据真实性、工具使用、最终状态、效率与遵循指令八个维度。发现利用评分漏洞,最终分数直接为 0;否则:
例如八维均分为 0.90、产物正确性为 0.70,最终分只能是 0.70,不能靠其他高分抵消错误;这是根据公式构造的说明例,不是作者的逐题结果。论文附录把 WeaveBench PassRate 定义为 score ≥ 0.8 的任务比例,Overall 是 114 题平均分。论文使用 Claude Opus 4.7 担任最终评分者,通过 OpenClaw 运行,思考档位为 medium。评分者没找到产物时还必须查完整轨迹;如果轨迹能证明文件确实创建过但没有被收进结果目录,可以记录 unstaged_evidence=true,同时降低分数。这个评分者不只查文件,也不是简单看最终截图。
三种聚合分别是:WeaveBench 的 PassRate = Σ 1[sᵢ ≥ 0.8] / 114;OSWorld 的 Binary = Σ 1[sᵢ = 1] / 108、Partial = Σ sᵢ / 108;Terminal-Bench 的 success rate = Σₜ Σᵣ rewardₜ,ᵣ / (89 × 3),其中测试全部通过时 reward 为 1,否则为 0。用 267 作分母,186/267 ≈ 69.7%,206/267 ≈ 77.2%;这只是按论文保留一位小数的总体值反算,不能据此指定哪道题的三次运行成功。
4.2 WEB_task_16:Wireshark 卡住后的恢复
WebRTC simulcast-layer audit · 0.59 → 0.92
- 任务来源与可见输入:WeaveBench 官方任务。Agent 要检查 WebRTC 同时发送的不同视频质量层(simulcast layers),用浏览器图表、JSON 状态和 Wireshark 抓包相互印证。
- Baseline 的真实轨迹:Claude Code 已经判断
Decode As对话框无响应,随后仍围绕同一个 GUI 交互重试 400 多步。它只解码了一个数据流,后续证据没有补完。 - LongHorizon 的处理:系统把已验证结果与未解决的 Wireshark 阻碍分别写入进度。后续轮次补证据:Figure 14 显示在约 46.5 秒处截取最高质量的 f 视频层
fps=0、frameWidth=0×0,确认帧率图在 38–52 秒区间为 0,再用 Wireshark 中的 21,018 个包交叉检查。Manager 不再派已经确认的前半段工作。 - 最终 judge:WeaveBench judge 对照任务要求、结果目录和完整轨迹。Baseline 因缺证据得 0.59;LongHorizon 补齐浏览器图表、JSON 状态和抓包交叉核验,得 0.92。
这个 case 说明“Agent 意识到失败”与“系统从失败中恢复”是两件事。Baseline 的文字里已经出现正确诊断,但这条诊断没有作为“尚未解决的阻碍”明确交给下一轮,执行程序仍围着同一个对话框重试。
4.3 两个文档任务:操作要求和证据顺序也要满足
DOC_task_2 · 统一标题样式 · 0.00 → 0.89
- 任务要求在 LibreOffice 图形界面里统一 15 个标题,同时保证文档实际保存的是正确标题样式与大纲层级,而不只是字体看着相似。
- Baseline 先从样式下拉框发现 “Results” 实际是
FakeBoldParagraph,随后直接改文档 XML。它把目录看起来正确、导出对话框关闭当成完成,却没有遵循要求的 LibreOffice 图形操作,也没证实 PDF 已产生。论文 judge 判为 0.00。 - LongHorizon 在图形界面检查当前样式,通过样式下拉框应用 Heading 1,再逐页检查全部 15 个标题。Auditor 随后解析文档 XML,确认样式为
Heading_20_1、outline-level="1",得 0.89。Figure 8 支持的是“先 GUI 修改、再 XML 核验”,不是“先 CLI 检查、再 GUI 修改”。
DOC_task_4 · 修复 VLOOKUP 并保留前后截图 · 0.45 → 0.87
- 任务不仅要修 Calc 中的 VLOOKUP,还要保留修复前和修复后的证据。
- Baseline 已保存一部分初始错误截图,但还没收齐要求的修复前证据就直接修改 XML。重新打开文件仍显示
Err:510;最终文件和截图序列不一致。问题是前态证据未收全,不是完全没有先截图。 - LongHorizon 把修复前证据列为必须先做的待办项,先保存错误状态,再修改公式、复核结果并完成九张截图序列。
这两个 case 对应两种常见错法:把视觉外观当成文件语义,把不可逆前态当成事后可以补交的附件。本轮验收要求需要提前写明最终评分要检查的文件、屏幕状态,以及截图必须发生在哪次修改之前或之后。
4.4 WEB_task_10、SQLite gcov 和 mystery binary
WEB_task_10 要做 Lighthouse 网页性能优化并收集 DevTools 证据。Baseline 完成了核心优化,却在证据采集里耗尽预算,没有交齐产物,得 0.53。LongHorizon 把已验证的优化状态留在进度记录中,把剩余截图和元数据交给后续轮次,得 0.85。
Terminal-Bench 的两个附录 case 用程序测试结算。SQLite 任务有三项明确测试:test_sqlite_compiled、test_sqlite_in_path 和 test_gcov_enabled。gcov 是检查代码哪些部分真正运行过的覆盖率工具;编译时需加入相应选项,并产生 .gcno 文件和覆盖率符号。Baseline 通过前两项,但 gcov 检查失败,reward 0;LongHorizon 在六轮中分别检查源码来源、编译位置、覆盖率、PATH 和最终保存位置,三项全过,reward 1。
Mystery binary 要独立写出 /app/mystery.c,复刻给定程序产生的图像;最终评测器的三个 test 名称是 test_image_c_exists、test_image_compiles 和 test_image_similarity。Baseline 已交付能编译的文件,前两项通过,但图像相似度失败,reward 0。LongHorizon 把已核验的逆向结果交给后续轮次:用 gcc -static -o reversed mystery.c -lm 编译,检查源文件 gzip 后小于 2000 字节,并确认它不调用原程序。Figure 20 展示独立实现生成相同图像、临时移走原程序后图像 MD5 仍一致;九轮后 reward 1。这里证明的是公开案例中的图像、大小与独立性检查,不能扩写成未展示的“多类输入均等价”。
4.5 主结果:优先比较相同模型和执行后端
| Benchmark | Baseline | LongHorizon | 可比性 |
|---|---|---|---|
| WeaveBench PassRate | 51.8% | 80.7% | 同 Qwen 3.7-Plus、同 Claude Code 执行程序;最干净的主对比 |
| WeaveBench Overall | 0.702 | 0.835 | 同上;114 道题 |
| Terminal-Bench 2.1 | 69.7% | 77.2% | 同 Qwen 3.7-Plus、同 Claude Code;每题三次 |
| OSWorld Binary | 2.8% | 8.3% | 基线只允许单次图形操作;本文可同时用图形界面与命令行 |
| OSWorld Partial | 21.5% | 35.2% | 同上,108 道题 |
| OSWorld Opus subset | 20.6% / 55.8% | 35.3% / 66.9% | 34 道题;Binary / Partial,工具模式也不同 |
WeaveBench 官方最佳行使用普通用户权限,作者自己的 Qwen 实验在任务虚拟机中有 root 权限,因此官方 41.2% 只能作为参考。同 Qwen、同 Claude Code 的 51.8→80.7 更有比较价值,但没有控制相同总 token 成本。OSWorld 的主要限制更直接:Baseline 是 single-action GUI,LongHorizon 使用 hybrid GUI+CLI,即同时允许图形操作和命令行。它同时改变多角色编排和可用工具,不能把全部提升都归给 MEA。
额外核验也会把原本成功的任务做坏。 Appendix Table 5 中,Opus 子集的 021 和 030 都从 1 降到 0。Table 6 中,WeaveBench Desktop 的 PassRate 增加 5.56 个百分点,平均分却从 0.8671 降到 0.8465。Table 9 中,Terminal-Bench 数学类从 0.917 降到 0.750,数据科学类从 0.792 降到 0.667。不能从总体提升推出每类任务都更可靠。
还有一个论文内部不一致。Abstract 写 Claude Opus 4.7 在子集上从 20.0% 到 34.3%,Table 3 与 Appendix B.1 则是 20.6% 到 35.3%。这里保留表格和附录的 20.6→35.3,同时标明摘要不同;论文没有解释差异,不能确定是排版问题还是运行版本不同。
5. Discussion:可复用的设计与需要补做的实验
进度需要对应具体证据,额外核验也需要接受固定预算下的成本比较。
5.1 每条进度都说明依据,文件变化后重新核验
最值得复用的是进度记录规则:每条事实注明由哪轮核验,每次执行只收到相关报告,不能把 Executor 自述直接当成已完成。这样后续模型知道哪些进度能沿用、依据是什么;文件变了,旧报告也应重新检查。
对 Claude Code 或 Codex 的研究,可以把它进一步做成结构化格式,而不是完全依赖自然语言段落解析。例如给任务要求、文件产物和已确认事实分配稳定 ID,记录状态、证据位置、最后核验时间,以及什么改动会使旧结论失效。当前官方实现主要从自然语言提示中提取 Current task state 与 Task contract,可读性强,但格式修复和状态冲突处理仍会依赖模型。
5.2 Auditor 需要硬权限边界
源码里有两层约束:prompt 告诉 Auditor 只读,Claude Code 适配器在审计前后做工作区前后快照比较。这个方向是对的,因为单独写“你是 reviewer,请不要修改”并不能形成可靠边界。
下一步应把它做得更硬:只读挂载、独立容器、网络权限限制、允许执行的命令清单、文件哈希,以及只开放观察操作的 GUI 接口。还应测 Auditor 有多少误放行和误拒绝,不能把“没改文件”当成“判断正确”。当前仓库对 Codex 的角色隔离没有像 Claude Code 适配器那样完整展示工具权限与写入检测,跨执行后端的安全等价性还需要额外验证。
5.3 在固定预算下衡量核验是否划算
Auditor 占 LongHorizon 总 token 的 19.4%(WeaveBench)、24.8%(OSWorld)和 38.1%(Terminal-Bench);Manager 只占 2.8%、2.0% 和 8.1%。独立核验是主要 token 支出。
同一机制在 Terminal-Bench 反而少用 24% token,说明核验有时能砍掉无效重试;在 OSWorld 这种截图密集任务里,它也可能产生很高成本。论文的 Games 子集更能说明模型与 harness 的耦合:Qwen 从 10.7M 增至 34.3M tokens,Opus 却从 16.5M 降至 11.1M。弱模型可能需要更多恢复轮次,强模型则会因为明确的验收要求少走弯路。
6. Conclusion:已有证据与实验限制
它证明了一整套“单独保存进度、新会话执行、独立核验”的系统能显著提高长任务完成率,但没有证明其中哪一部分是必要条件。 这使它非常适合当工程与研究起点,也留下了清楚的实验缺口。
最主要的限制有五个:
- 没有组件消融。进度记录、新会话、Auditor、图形与命令行分派和额外算力没有被单独拆开。
- OSWorld 同时改变可用工具,因果解释不干净。Opus 34 题子集里还有明显退化,例如若干基线已满分的任务被 LongHorizon 做坏。
- WeaveBench 与 OSWorld 没有报告多随机种子或统计显著性。Terminal-Bench 每题三次,但主框架仍没有多次独立多角色运行的方差分析。
- 内部 Auditor 仍由模型生成自然语言判断。工作区写入检测能抓到写文件,却不能证明语义判断已经校准,也没有报告 Auditor 对每类错误的精确率 / 召回率。
- 成本高度依赖模型和任务。一个更谨慎的 harness 可能提高成功率,也可能让弱模型在恢复循环里消耗三倍 token。
如果要沿这个方向继续发论文,我会优先做四组实验:固定总 token 与运行时间的预算对比;分别去掉进度记录、新会话和独立核验;测不同模型互审时的误放行与误拒绝;比较自然语言进度表和能记录证据来源、失效条件的结构化记录。这样才能回答 LongHorizon-Harness 目前没有回答的问题:提升究竟来自更好的记忆、更干净的上下文、更严格的 judge,还是更多次尝试。
留言