长任务需要的不是更长记忆,而是可审计的状态推进
Manager 把原任务拆成有验收条件的 bounded contract。Executor 每轮以 fresh context 做一次状态变化。Auditor 只读检查环境,只有审计通过的事实才能进入下一轮。
失败往往发生在步骤之间,而不是某一步做不会
早期错误变成后续前提
Agent 把一次误判写进计划,后面的动作都围绕错误状态继续推进。
历史越长,关键状态越难取回
工具输出、截图和试错淹没当前目标;上下文长度增长不等于状态更清楚。
执行者也负责宣布完成
文件“看起来存在”、界面“看起来正确”,都可能被当作已经满足任务。
LongHorizon-Harness 不改模型,也不改 Claude Code/Codex 的内部循环
| 路线 | 主要改什么 | 何时发生 | 核心证据 |
|---|---|---|---|
| Harness-Zero | 把 teacher harness 的策略蒸馏进模型 | 训练阶段 | 可执行任务的 RL / SFT 信号 |
| Agentic Harness Engineering | 自动修改 prompt、tool、middleware、memory | 跨任务演化 | 真实 rollout 与 task flip |
| LongHorizon-Harness | 外置 task state,按轮包裹现有 backend | 单次任务运行时 | 环境中的独立只读审计 |
| 普通 Claude Code / Codex | 在一个会话中规划、执行、压缩上下文 | 单次任务运行时 | 自身工具结果与自我判断 |
先看提升,再看哪些比较真正 matched
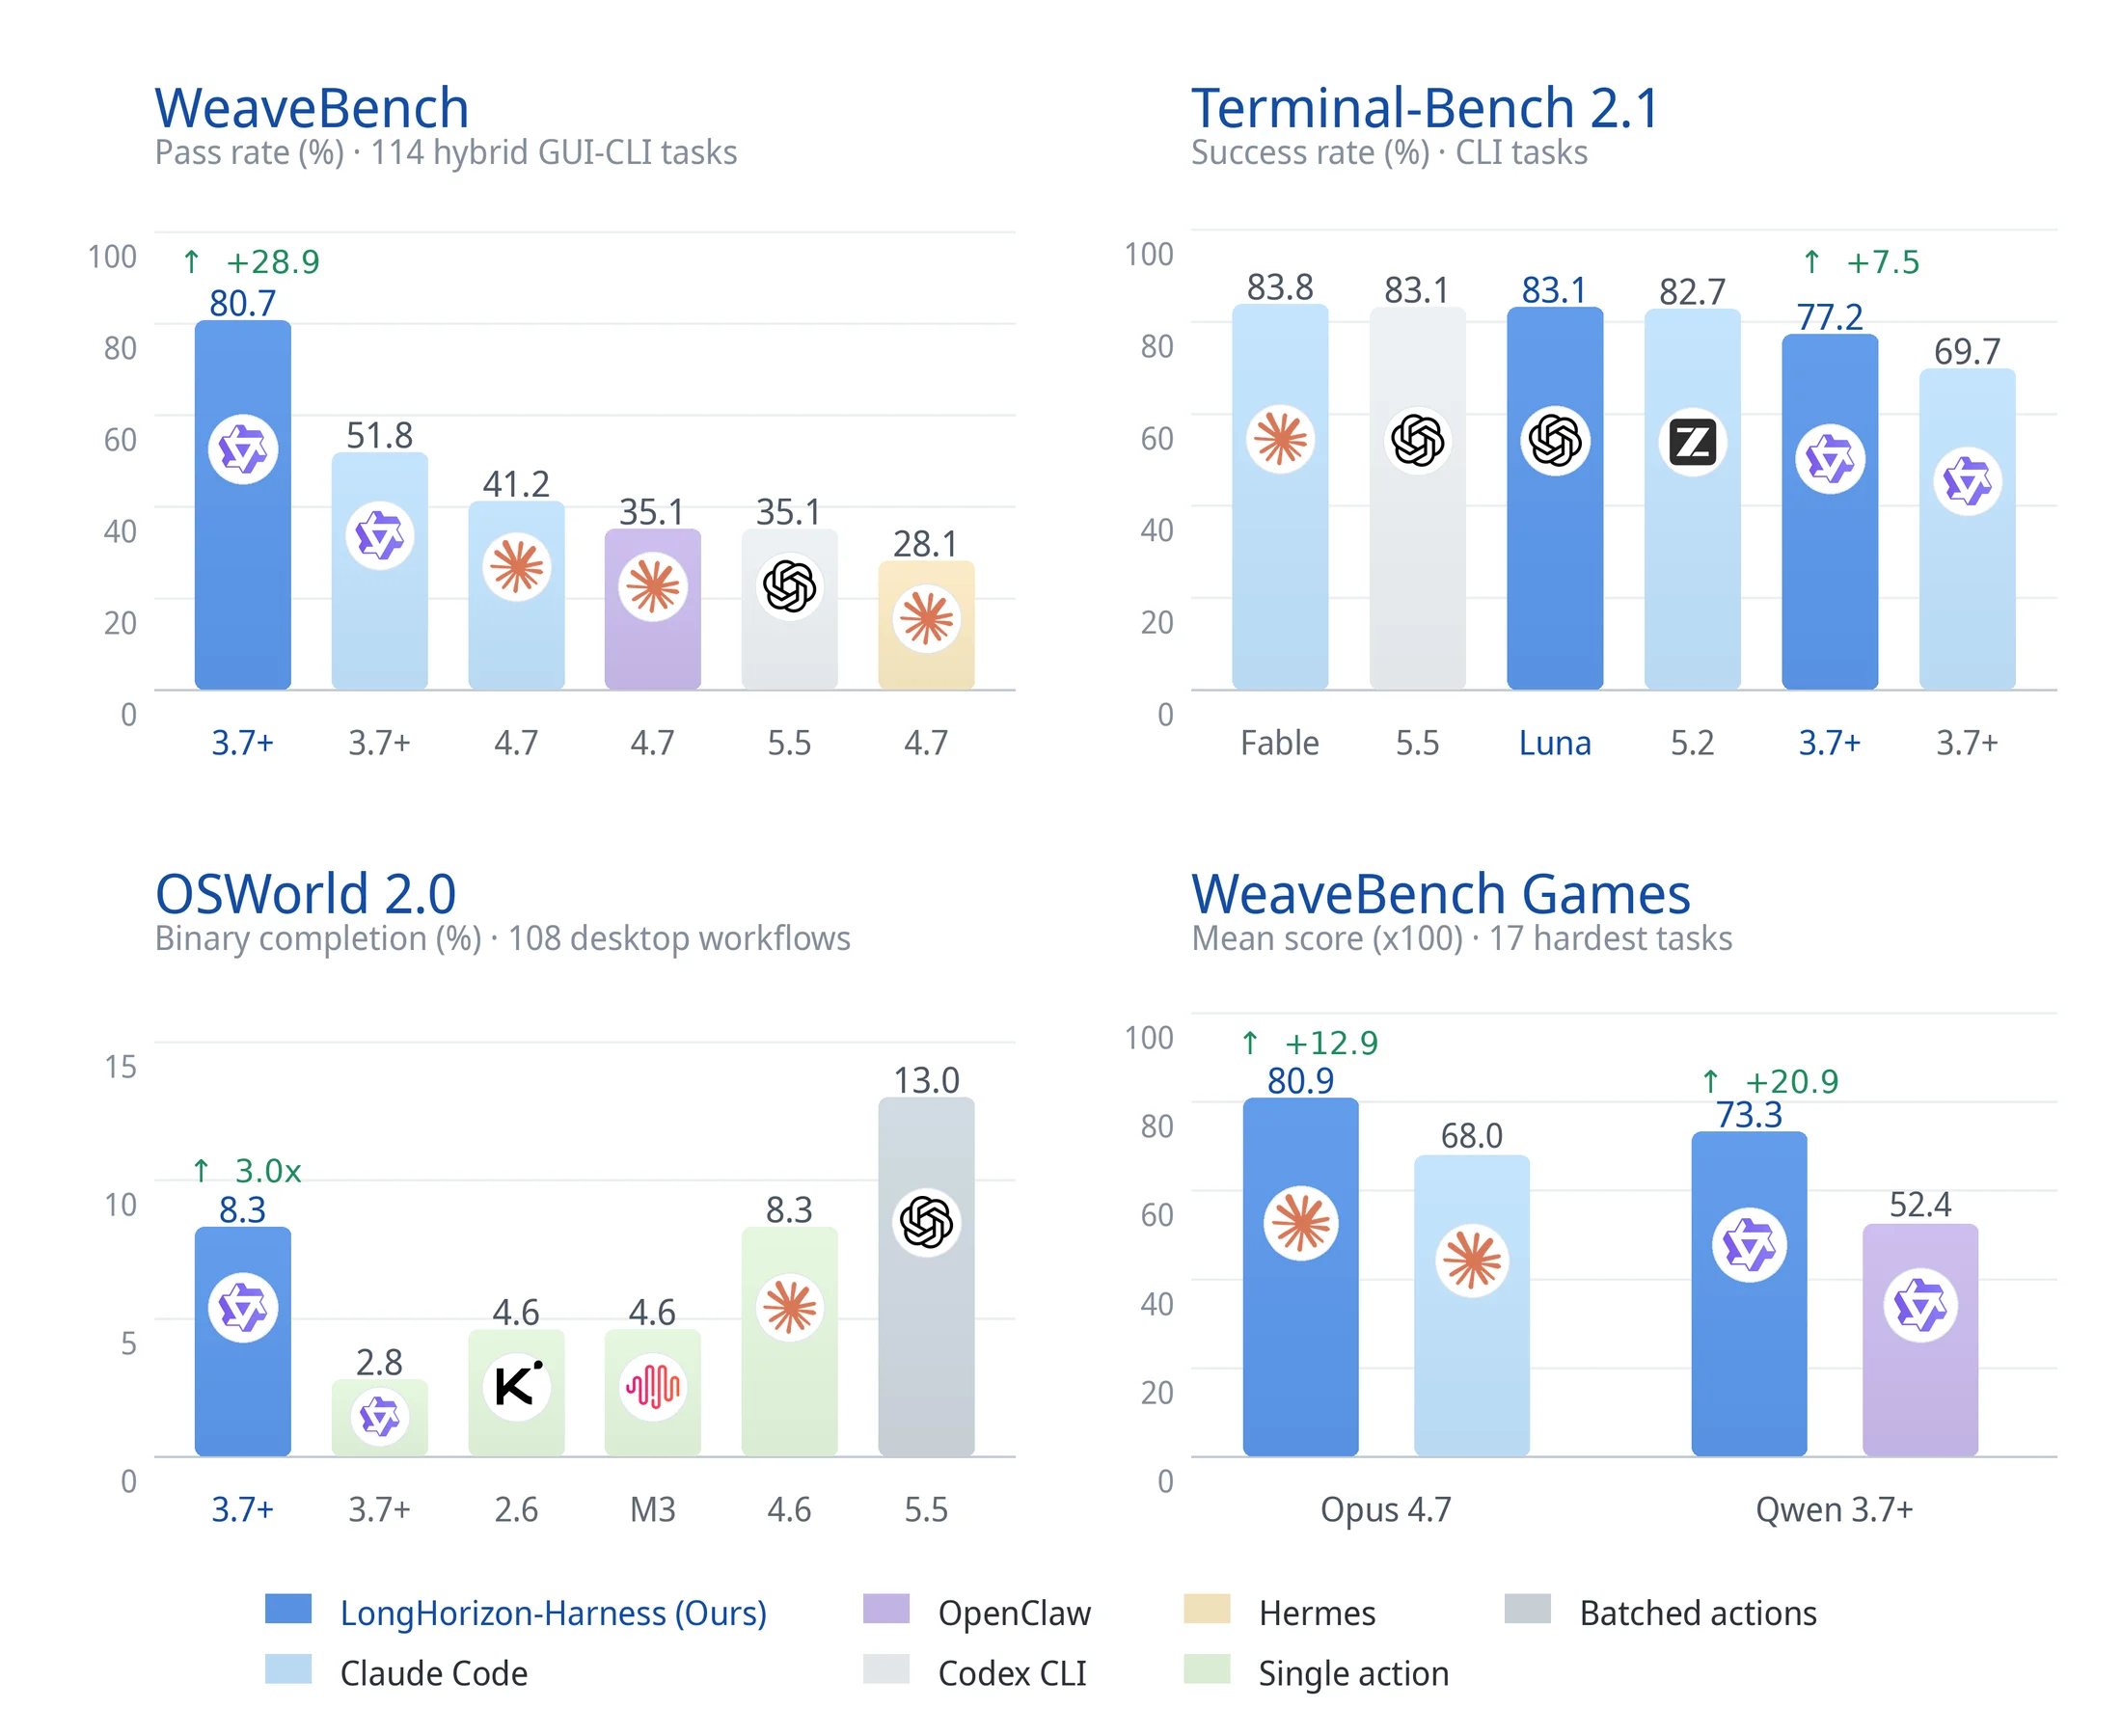
assets/harness_perf.png,MIT License。WeaveBench 的 51.8→80.7 和 Terminal-Bench 的 69.7→77.2 是同 Qwen 3.7-Plus、同 Claude Code backend 的直接对比;OSWorld 主表把 single-action baseline 与 hybrid GUI+CLI 放在一起。一轮只允许一个主要状态变化
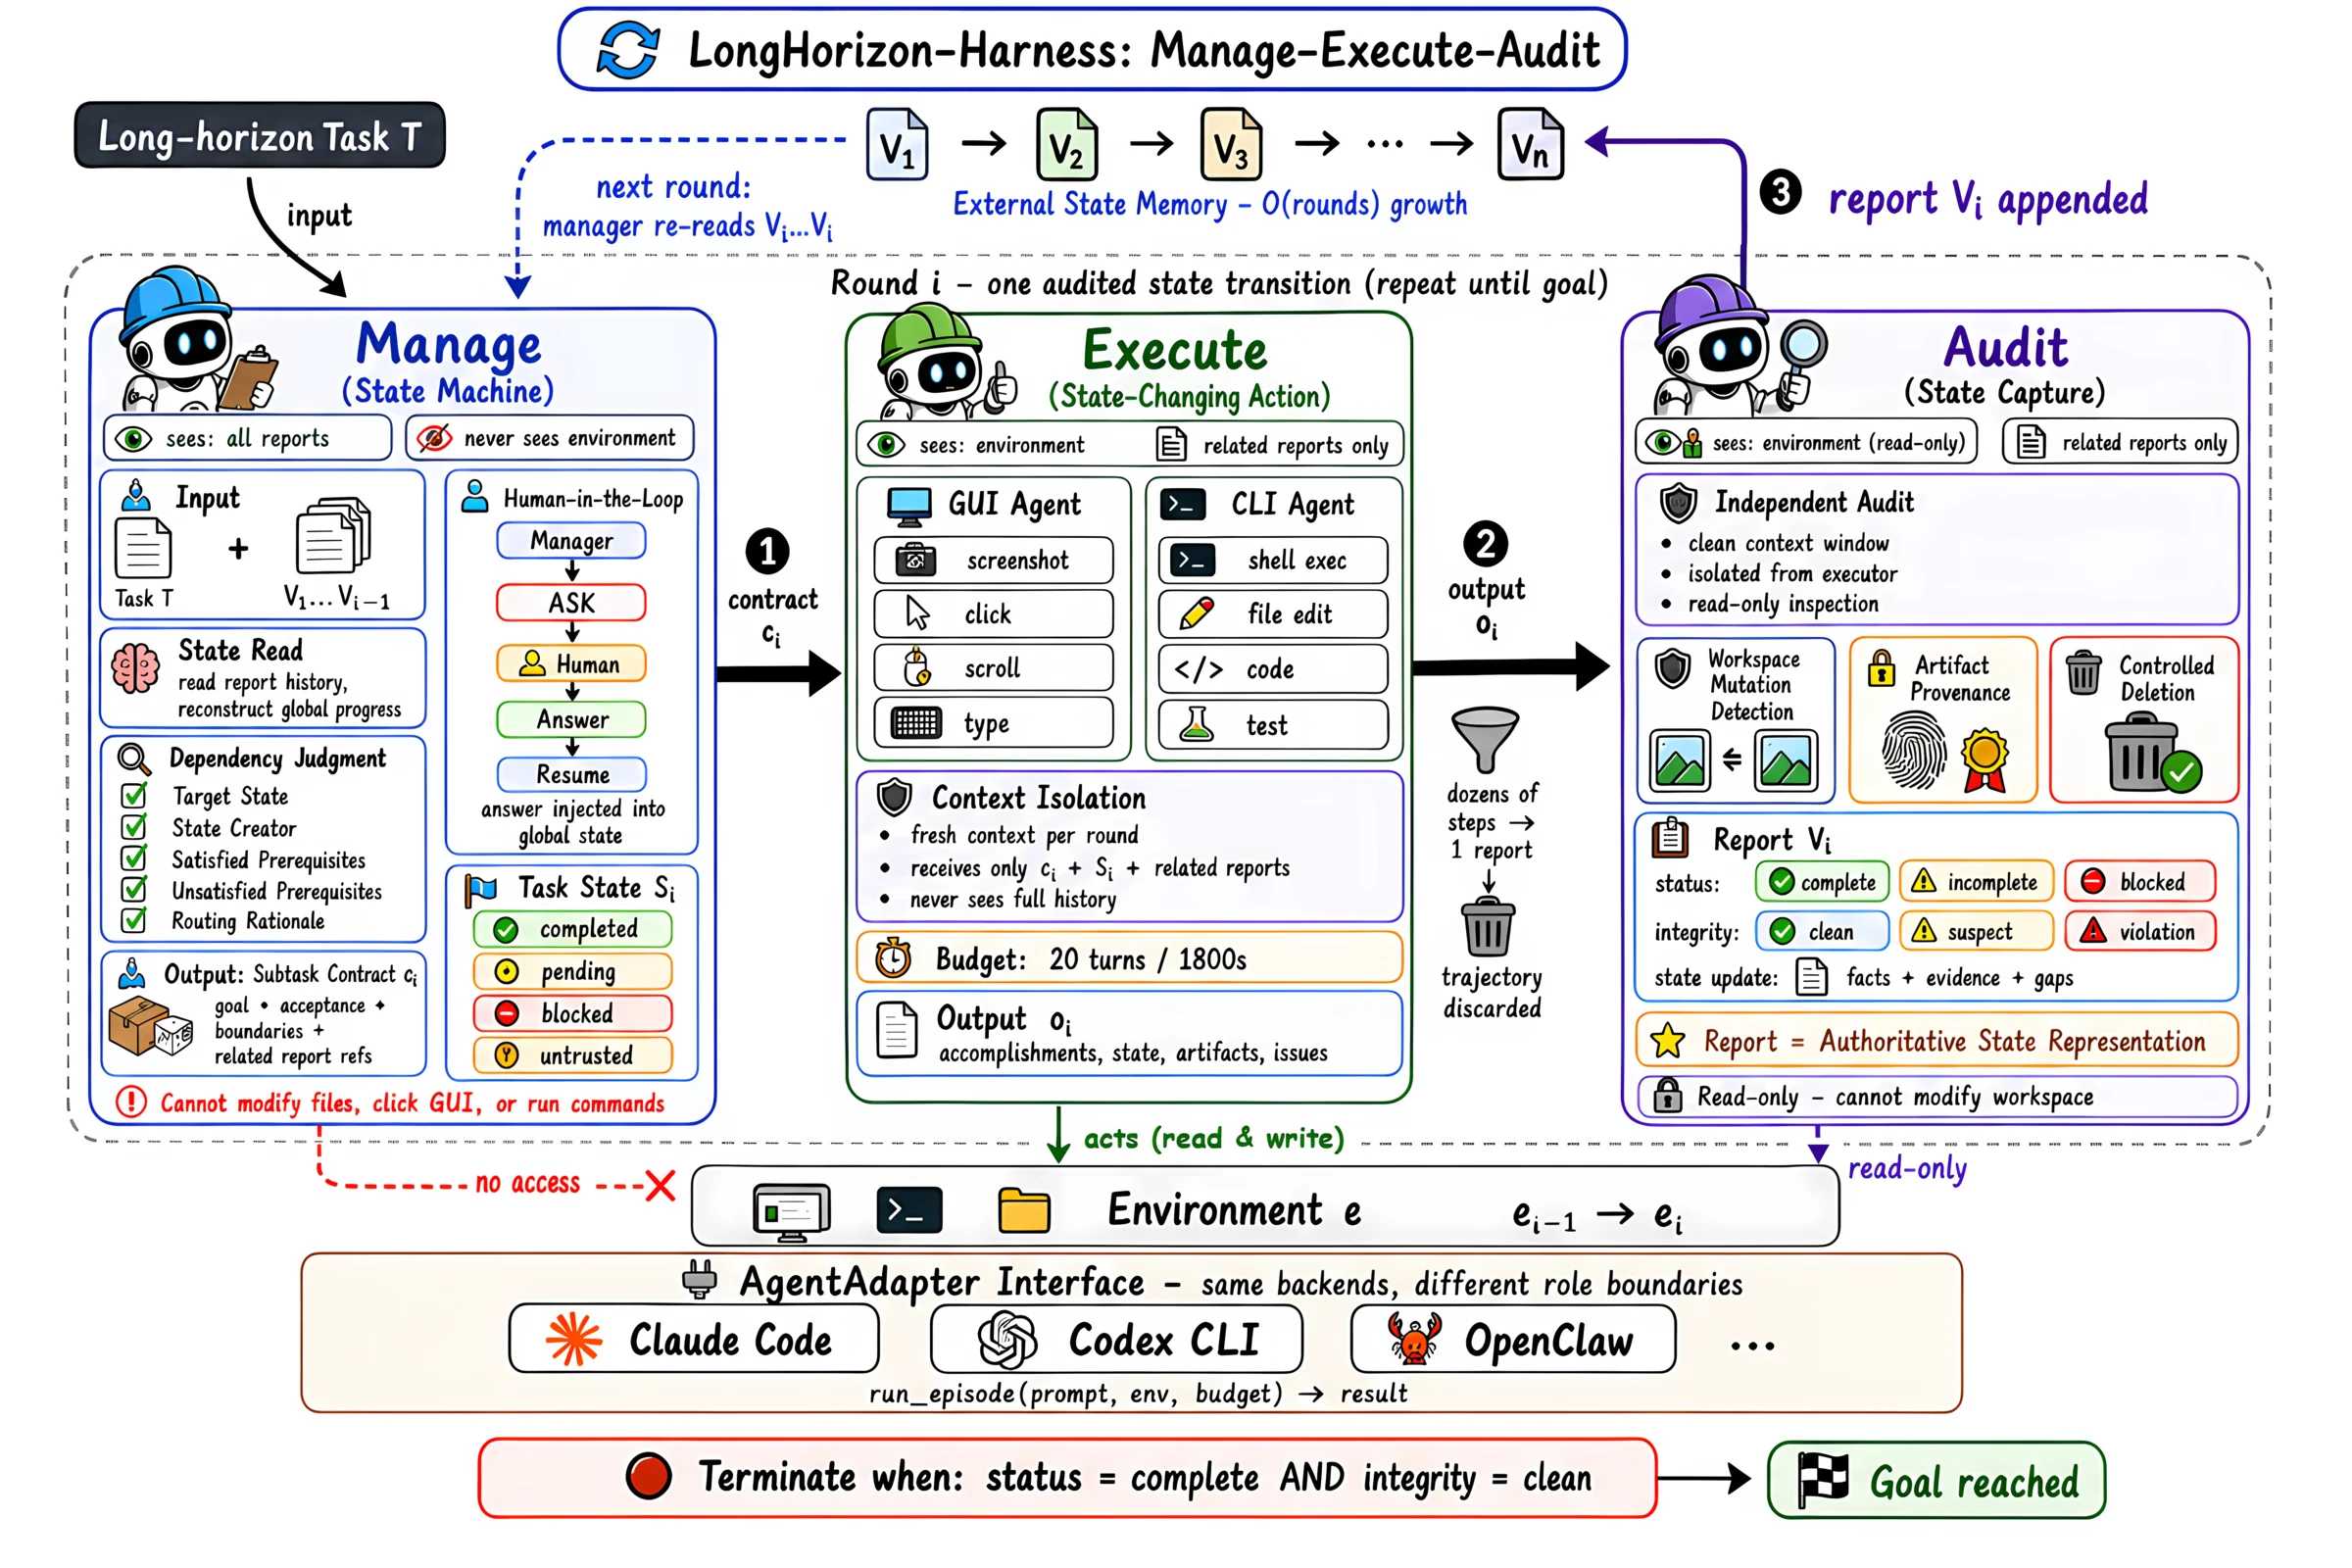
assets/mea_main.png,MIT License。图中的 report 是跨轮证据;当前源码还增加了 contract audit,最终完成需要 complete、clean、aligned 同时成立。Manager 维护两样东西:当前状态和稳定验收契约
- Requirement:原任务中的目标或限制。
- Artifact:执行中创建或修改的输出。
- Fact:后续轮次需要依赖的环境事实。
- 每条事实引用
round_003一类审计轮次。
这一轮要改变的一个主要环境状态。
哪些可观察条件同时成立才算完成。
不能碰哪些对象,允许用什么流程。
已满足与未满足的前置条件,以及路由理由。
只附上 contract 明确引用的 audit reports。
最终状态必须写入用户或下游真正消费的位置。
Executor 的“我做完了”只能触发审计,不能直接改 task state
读取状态
Manager 看到原任务、task state 和历史 audit reports,看不到环境。
选一件事
写 goal、acceptance、boundary 和相关证据引用。
fresh context
Claude Code 或 Codex 只收到本轮上下文,并可修改环境。
自述结果
输出做了什么、产物在哪里、遇到什么问题。此时仍不可信。
只读重查
从环境核验文件、应用状态、日志、截图与持久化结果。
推进状态
Manager 采用 audit 支持的事实,保留 gaps 和 untrusted 项。
下一轮
execute、ask、blocked 或 done。完成有硬条件。
Next: done 必须跨过三个独立条件
Auditor 的前三行是控制协议
随后逐项写 evidence、gaps、blocking constraints 和对 task state 的建议更新。Executor 的 claim 只能帮助定位证据。
源码层的硬 guard
- 审计期间做 workspace snapshot diff;发生 mutation 会升级为 integrity violation。
- 存在 blocking constraint 时,
complete会被降为incomplete。 - Manager 请求 done 时,最近一份有效报告必须同时是 complete、clean、aligned。
and integrity == clean
and contract_audit == aligned:
accept done
else:
inject synthetic repair feedback
fresh context 来自新的 CLI episode,不是简单清空一段聊天
--print --output-format stream-json,关闭 auto memory 与 prompt history;按角色禁用工具。codex exec --json,从 stdin 读取本轮 prompt;可注入 model、reasoning effort 与 MCP 配置。真正跨轮保留什么?
三套 benchmark 使用三种不同的最终评分路径
WeaveBench
Judge 读取 task spec、results artifacts 和完整 chat.jsonl。逐 artifact 拆 clause,再打 8 个维度。
OSWorld 2.0
使用官方 env.evaluate()。Binary 只认 final score = 1;Partial 是全部任务细粒度得分均值。
Terminal-Bench 2.1
Harbor + Docker,保留每题 CPU、memory 和环境限制;每题三次独立 trial 后取均值。
识别出 GUI 卡住还不够,必须把失败转成下一轮可执行状态
任务与 judge 看什么
Agent 要在浏览器和 Wireshark 中完成 WebRTC 分析,留下多类证据。最终 WeaveBench judge 同时读任务要求、结果目录和完整轨迹,逐 clause 核验证据。
已识别 Decode As 对话框无响应。
仍围绕同一个按钮重试 400 多步,后续端口与证据没有补齐。
Harness 把“已验证进度”和“GUI blocker”分别写入状态,避免下一轮重做前半段。
Manager 改派剩余证据子任务,最后补齐 browser charts、JSON state 和 packet evidence。
视觉完成、文件语义、修复前证据是三种不同的验收条件
DOC_task_2:heading normalization
Baseline 直接编辑 ODT,让标题看起来粗且大,却没有通过指定的 LibreOffice workflow,也没有正确写入底层 style/outline level,judge 给 0.00。
LongHorizon-Harness 用 CLI 检查 ODT 结构,再回到 GUI 完成应用内修改并复核,得分 0.89。
DOC_task_4:修复 VLOOKUP
任务同时要求证明修复前的错误和修复后的正确结果。Baseline 修完再补前态截图,重开文件后错误状态已经不可恢复,证据链自相矛盾,得分 0.45。
Harness 把 pre-repair evidence 设为 pending prerequisite,先保存前态,再修改公式和复核,得分 0.87。
CLI 任务里,file exists 往往只满足了最弱的一条条件
SQLite gcov build
任务要求编译带 gcov instrumentation 的 SQLite。验收条件包含可执行文件可运行、覆盖率符号存在、.gcno 文件生成,以及约定路径下的持久化结果。
Baseline 得到 reward 0;Harness 把多条件 build 写进 contract,逐项编译、检查与修复,reward 1。
mystery binary
Agent 需要独立复刻目标二进制行为。字符串、strace 和局部输出只能作为 hypothesis。最终 artifact 还要能编译、在多类输入上行为一致,并满足大小和独立性约束。
Harness 把探索结果保存为 audited facts,直到 C 实现跨过最终 verifier,reward 1。
稳定提升出现在 matched pairs;最大数字未必是最干净的因果证据
可靠性来自更多核验,但成本不是固定倍数
按 benchmark 看总成本
Terminal-Bench 中,分轮和审计减少了无效重试;OSWorld 则付出更多观察与恢复。
谁在花新增 token?
效果更偏向需要保留、检查、修订多个环境状态的任务。纯数学、短算法或单步感知瓶颈受益较小,部分细分类别还会回退。