专门设计的工具和检查规则能提高模型完成任务的概率,但上线时往往也得带上整套执行程序。Harness-Zero 先让另一个模型审查“下一步准备做什么”,必要时把专用流程改写成普通 Bash 命令,再实际执行。作者用这些执行记录微调 Qwen3.5-9B;部署时移除审查者,只保留微调模型、固定提示和一个 Bash 工具。
1. Motivation:专用执行程序的收益,能否保留在模型里?
论文想保留专用检查与工作流带来的收益,同时减少部署依赖。 给模型增加工具、在关键节点检查、保存跨任务经验,都是优化 harness 的常见办法;这些改动没有更新模型参数,部署时通常要继续携带原执行程序。
这会形成两个不太理想的选择。只保留一套通用 harness,模型会失去领域流程和专用工具带来的收益;为不同领域、实例和模型保留多套 harness,又需要持续维护路由、上下文、调用链和兼容性。模型升级以后,原先写死在代码里的假设还可能过时。
Harness-Zero 把目标写成一个明确的迁移问题:训练阶段有一套经过优化的 harness,部署阶段只允许使用固定的最小 harness。论文用三个符号区分它们:
execute Bash 工具和固定系统提示。h* 改写成给审查模型读取的私有参考文件;它不直接包裹待训练模型。难点是工具接口不一致。h* 可能提供部署时不存在的工具,或在模型看不到的地方检查文件、拦截提交。直接模仿这套程序下的记录,可能教会模型调用上线时不存在的工具。论文称之为 action-space mismatch,具体就是“训练时能做的动作,部署时做不了”。
2. Related Work:与优化执行程序、联合训练和上下文蒸馏的区别
最重要的比较是部署时还要保留什么。 Meta-Harness 搜索提示、工具、运行时检查与经验文件,上线时继续使用搜索出的程序。共同优化方法既改模型也改 harness,最终能力仍可能依赖二者的配合。EvoHarness-RL 和 OPHSD 则把训练时额外提供的指导蒸馏进模型;前者部署时仍保留工作区,后者没有完整的多轮工具交互。
| 方向 | 训练或推理时做什么 | 部署时还需要什么 | Harness-Zero 的边界 |
|---|---|---|---|
| 优化执行程序 | 搜索更好的提示、工具、流程和调用处理 | 优化后的专用 harness | 把已经找到的行为转成训练数据 |
| 模型与执行程序共同演化 | 交替或联合更新模型参数与 harness | 通常仍依赖共同优化后的 harness | 部署目标固定为最小 h |
| 训练专有指导蒸馏 | 蒸馏检查、规划再执行或外部状态管理 | 有的方法仍保留部分外部机制 | 处理多轮工具执行,以及训练与部署的工具差异 |
| Harness-Zero | 用审查模型把 h* 的指导逐步改写成 h 中可执行的 response | 微调模型 + 固定 h | 深领域知识和无法写成模型回复的机制仍难迁移 |
Harness-Zero 把检查移到执行之前:另一个模型先读 student 准备发出的 response,再决定保留还是替换。论文把这个审查角色称为 harnessing agent。它参考专用流程,但替换后的命令必须能由最小 h 执行;生成训练数据时就保证工具接口与部署相同。
3. Method:从执行前审查,到微调与部署
审查者只能替换下一步,不能私下替模型跑完整个任务。
3.1 先把 h* 改写成 K
每个领域都先用 Qwen3.5-9B 和最小 h 运行训练题,再让 Kimi K3 在 Kimi Code 中分析失败记录,改进一套所有训练题共享的 h*。这一步共做三轮:每轮只分析上一轮失败的题,提出可复用的工具、检查规则、技能或经验修改;主控模型合并提议,再让同一个学生模型挂载改后的 h* 重跑这些失败题。通过的题退出后续轮次,尚未通过的题进入下一轮。共享组件不能写入某道题的答案、具体单元格、文件名或只适用于该题的步骤。Appendix A 明确要求接受这类单题残留失败,而不把它们写成共享规则。
得到 h* 后,作者再把它改写成审查者读取的参考文件 K。原来的专用工具改成 action recipe,也就是用 Bash/Python 完成同类操作的脚本说明;运行时检查改为 review middleware(审查前后的处理代码),只读待执行回复和模型已经看到的结果;技能文件提供流程指导,经验文件提供重复错误的识别规则。
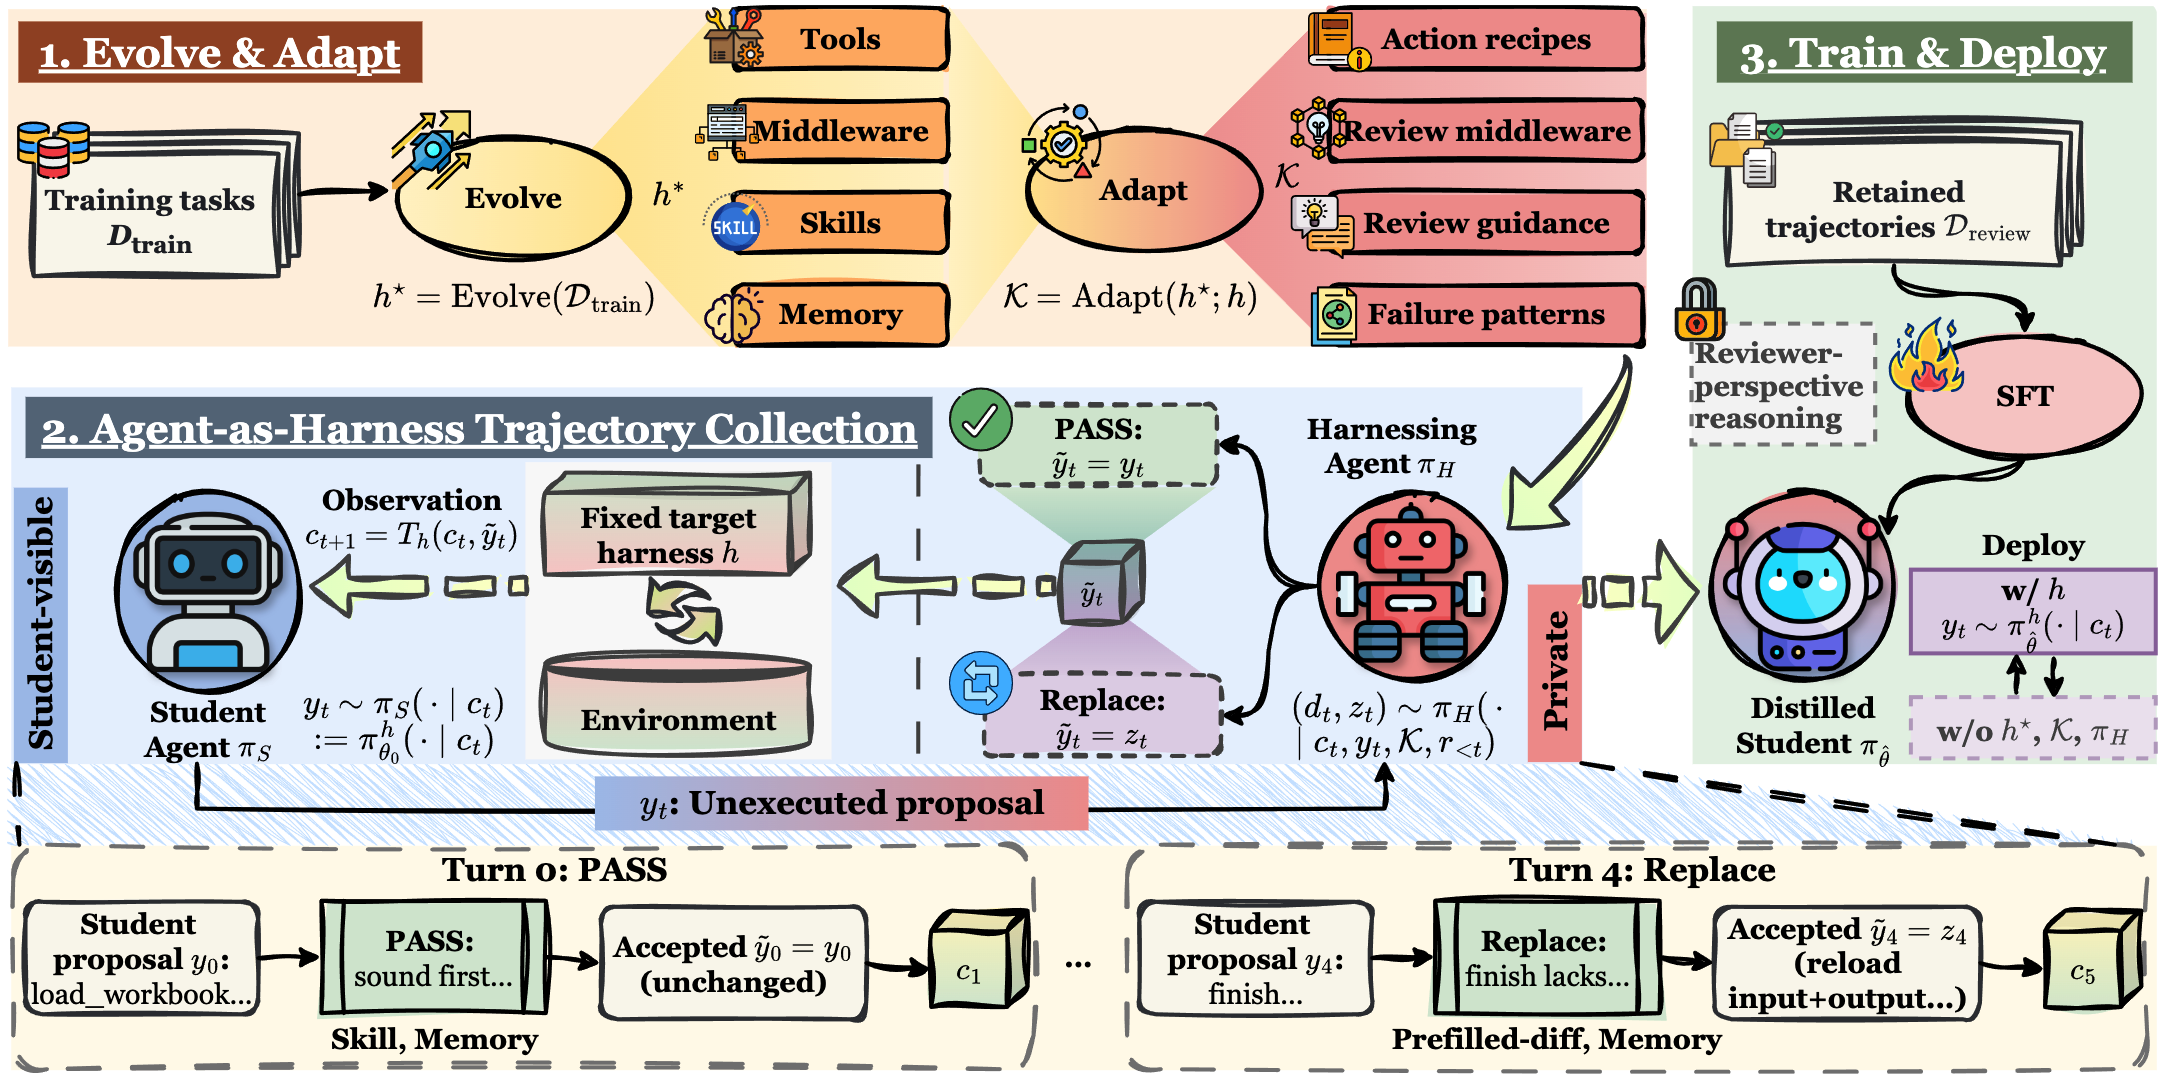
h* 到 K 的改写;中间是每一步 PASS/REPLACE;右侧表示部署时只留下微调后的学生模型与 h。图片来自作者官方仓库,Apache-2.0。3.2 每条回复都先审查,再执行
- 1 · PROPOSE学生在
h下生成尚未执行的y_t。 - 2 · REVIEW审查模型读取可见执行记录、下一步提案和私有
K。 - 3 · DECIDE选择 PASS(保留),或 REPLACE(给出完整替代回复)。
- 4 · EXECUTE获接受的回复通过目标接口
h执行。 - 5 · OBSERVE命令结果进入学生能看到的执行记录。
- 6 · TRAIN用已接受且实际执行的回复做监督微调;部署移除审查者。
PASS 保留原回复。REPLACE 必须给出一条完整的学生回复,而且只能调用 h 允许的 execute。官方格式检查拒绝三种情况:保留原回复却又附替代内容;要求替换却没有替代内容;替代回复既没有文字也没有工具调用。每次无效提交最多重试三次。
审查协议逐步作决定,但可以替换多少步另有上限。Appendix C.2 写明,SpreadsheetBench 和 AppWorld 分别用每题最多 5、3、1 次替换的设置采集轨迹,USPTO 始终最多 5 次。这个上限计算 REPLACE 的次数,不是工具调用总数,也不是最多只审查 5 轮。另有一条代码细节:固定版本 aa63a775 的 HarnessReviewMiddleware 在替换次数耗尽后直接放行后续提案,不再调用审查模型。因此“逐步审查”描述的是论文协议,不能据此假定实际仓库会在预算耗尽后继续付出审查调用成本。
保留给学生的执行记录
- 任务与固定系统提示
- 审查后实际接受的回复
execute的命令输出与退出码- 此前所有实际执行的反馈
不进入后续执行记录或 SFT
- 私有参考文件
K - PASS/REPLACE 的理由与组件名
- 被拒绝、未执行的原始提案
- 审查处理代码的内部提示
被拒绝的原始提案是学生自己生成的,审查者也会读它;上图说的是它不进入后续保留的执行记录和 SFT 目标,并非学生从未见过它。SFT 以接受后的模型回复为学习目标,任务提示与工具输出则作为上下文;不会要求模型预测工具输出。
审查者没有独立访问任务环境的接口,也看不到隐藏答案。 例如它怀疑某个 Excel 单元格被改坏,不能私下打开文件再把结论交给 student;它必须把检查脚本写进替代 response,交给 student 的 Bash 工具运行。执行结果进入下一轮上下文,student 才能据此继续。这保证训练记录包含真正需要学会的检查动作。
3.3 论文的表格示例:保留预填单元格
SpreadsheetBench 的一些任务要求填写指定区域,里面已填了少量示例。模型要从这些示例推断规则和格式,只写空白位置。脚本若对整段区域批量赋值,就可能覆盖示例。Appendix B.2 展示的是这种重复错误及检查代码,并未给出完整任务 ID 和原始模型日志;下文的 B7 用来说明检测输出,不冒充某条实测记录。
同一项保护检查,怎样迁移到学生的行为里
- 原始
h*:prefilled_guard在学生准备结束时进入隔离工作区,比较输入与输出工作簿的答题区域;原有非公式示例值改了,就拒绝结束。 - 改写成
K:审查代码不再读取工作区,只扫描学生可见的执行记录,寻找“比较过输入和输出”的证据。 - 触发 REPLACE:学生若直接结束,审查模型将结束动作替换为一条普通
execute命令。命令创建并运行工作簿比较脚本。 - 形成监督:比较结果进入学生下一轮上下文;检查通过才结束;看见被改动的坐标,就先修复。SFT 学到提交前主动比较输入与输出的动作,而非一个部署时不存在的工具名。
FAIL changed cells: ['B7'],学生恢复 B7 并重新运行验证。下面的代码根据论文 Appendix B.2 / Code 1–3 压缩改写,使用 Python 3 与 openpyxl。它逐格比较输入和输出中的非空、非公式单元格,有改动就返回退出码 1。它只验证“没有覆盖示例”,不验证所有新填值是否正确,更不是 SpreadsheetBench 的完整评分器。
# 在 accepted response 里创建并执行;目标 harness h 只看见一次 Bash execute
python3 - <<'PY' INPUT.xlsx OUTPUT.xlsx B3:B40
import sys, openpyxl
from openpyxl.utils import range_boundaries

input_path, output_path, cell_range = sys.argv[1:4]
wb_in = openpyxl.load_workbook(input_path)
wb_out = openpyxl.load_workbook(output_path)
ws_in, ws_out = wb_in.active, wb_out.active
min_c, min_r, max_c, max_r = range_boundaries(cell_range)

changed = []
for row in range(min_r, max_r + 1):
    for col in range(min_c, max_c + 1):
        before = ws_in.cell(row=row, column=col)
        after = ws_out.cell(row=row, column=col)
        if before.value is not None and before.data_type != "f":
            if after.value != before.value:
                changed.append(before.coordinate)

print("PASS" if not changed else f"FAIL changed cells: {changed}")
raise SystemExit(bool(changed))
PY
3.4 轨迹过滤与 SFT
SpreadsheetBench 和 AppWorld 只保留任务分为 1.0 且没有执行异常的尝试;USPTO 保留全部 500 条,使各消融使用同一批题。作者还扫描私有路径、提案文件名、审查提交工具名和内部处理组件名,防止审查者私有信息进入训练数据。替代回复若出现“student proposal”“review”“rewrite”等审查者视角措辞,对应推理 token 不参与训练损失。
最终每个领域单独训练:SpreadsheetBench 487 条轨迹,AppWorld 282 条,USPTO 500 条。模型是 Qwen3.5-9B,采用 LoRA,只训练少量附加参数;rank(低秩矩阵的秩)和 alpha(缩放参数)都是 32。每批 8 条、最大长度 65,536 token,训练 2 遍;峰值学习率为 2e-4,前 5% 步数预热,之后降到 1e-6,随机种子为 42。
4. Experiments:三个领域怎样评分,哪些行为真正迁移了?
主结果是三个领域各自评分后取算术平均,不是把全部测试任务混在一起。 下表先说明任务和分母,再区分采集时审查的效果与移除审查者后的效果。
4.1 三个领域与统一部署接口
化学任务是单步 retrosynthesis(逆合成预测):给定目标产物,推测生成它的上一反应步需要哪些前体。SMILES 是用字符串表示分子结构的格式;RDKit 是读取和处理这类分子结构的化学软件库。它能检查一个 SMILES 是否能解析成分子、辅助比较结构,但“能解析”并不等于“这个反应预测正确”。
| 领域 | 训练 / 测试 | 任务与指标 | 专用 harness 主要提供什么 |
|---|---|---|---|
| SpreadsheetBench Verified | 300 / 100 | 真实电子表格操作;每题一次尝试的 pass@1 | 检查、编辑、保存与验证工作簿的流程 |
| AppWorld | 147 / 168 道题 | 56 个三任务场景;SGC | API 参数、分页、修改数据后回读验证与完成条件 |
| USPTO retrosynthesis | 500 / 100 | 单步前体预测;每题一次尝试的 pass@1 | 反应先验、候选生成、RDKit / SMILES 验证 |
所有任务通过 Harbor 在 Docker 隔离环境中运行。学生部署接口始终是最小 mini-SWE-agent:一个固定系统提示、一个非空 Bash 命令参数的 execute 工具;每次调用启动新 shell,文件系统状态保留。当前目录和环境变量不跨调用保存。
SpreadsheetBench 和 USPTO 每题尝试一次,通过记 1,失败记 0;100 个测试任务的平均值就是 pass@1。AppWorld 的单题成功要求该题所有检查通过:官方评分代码先调用 evaluate_task,再把 tracker.success 转成 0/1;缺失、损坏的状态快照或评测异常记 0。
AppWorld 报告 SGC(scenario goal completion,场景目标完成率)。同一场景含三道题,评分器对三题的成功值取最小值,三题都成功才算这个场景成功。因此 SGC = 100 × 成功场景数 / 56,不是 168 道单题的平均正确率。例如三题得分 [1, 1, 0],整个场景记 0;Table 2 的 58.9% 对应 33 / 56 × 100 ≈ 58.9%。这个聚合规则已核对 Harness-Zero 的单题评分代码和其固定使用的 AppWorld v0.1.3.post1 的 Metric._compute_metrics。
三个领域的平均分是 (44.0 + 58.9 + 30.0) / 3 = 44.3。表格案例里的“预填保护 PASS”只是内部检查的一项,通过它仍不保证整个任务得 1。
官方代码的复现补充。论文 Appendix E 用“固定提示 + 单个 Bash 工具”描述最小接口;但固定版本 aa63a775 的 AppWorld README 要求使用专门的 AppWorldMinisweAgent 与环境。它在首轮加入 23 条示范、用户身份和应用说明,加上系统提示共 24 条消息。普通 agent 只有系统提示与任务说明两条消息,仓库明确说这种配置会产生无效 AppWorld 分数。两者的工具仍只有 execute,区别在初始上下文和评分前的状态导出,不能把该领域解释成完全没有额外示范。
4.2 Agent-as-harness 是否比直接挂载代码更有效?
Table 1 在 GPT-5.6 Sol 和 DeepSeek-V4-Pro 上做了三个领域 × 两个模型的六种设置。这里没有训练;同一模型分别扮演学生与审查者,因此提升不能归因于换了更强的教师。
4.3 蒸馏后,拿掉 h* 还能剩多少?
| 设置 | SpreadsheetBench | AppWorld | USPTO | 三领域平均 |
|---|---|---|---|---|
原模型 + 最小 h | 31.0 | 26.8 | 12.0 | 23.3 |
原模型 + 专用 h* | 39.0 | 48.2 | 38.0 | 41.7 |
| 原模型 + DeepAgents | 35.0 | 19.6 | 7.0 | 20.5 |
| 原模型 + Claude Code | 31.0 | 10.7 | 6.0 | 15.9 |
Harness-Zero + 最小 h | 44.0 | 58.9 | 30.0 | 44.3 |
根据论文 Table 2,三领域平均从 23.3% 升到 44.3%,比原模型继续使用 h* 的 41.7% 还高 2.6 分。分领域看则更谨慎:SpreadsheetBench 与 AppWorld 主要依赖可在轨迹中示范的程序化步骤;USPTO 的 h* 还提供反应先验、候选生成和可执行 SMILES 验证,因此微调后模型的 30.0% 仍低于 38.0%。
4.4 为什么成功率最高的轨迹,不一定最适合蒸馏?
USPTO 的数据来源消融,是全文最值得看的实验。所有条件都从同一个 Qwen3.5-9B 出发,使用相同 500 个采集任务、相同训练方案,并在 h 下测试。
| 数据来源 | 采集成功率 | 微调后在 h 下的测试 pass@1 |
|---|---|---|
| 原模型(未训练) | — | 12.0 |
| GPT-5.6 Sol 独立完成任务 | 52.0 | 12.0 |
GPT-5.6 Sol 使用 h* | 62.0 | 3.0 |
Qwen3.5-9B 使用 h* | 39.4 | 12.0 |
空 K 下审查 | 44.2 | 11.0 |
| 审查者可读标准答案 | 98.6 | 15.0 |
Harness-Zero:审查者使用 K | 59.4 | 30.0 |
直接蒸馏 h* 轨迹的失败最能说明 action-space mismatch:模型学会了部署时不存在的专用工具调用,大量尝试耗尽轮数上限。审查者直接看到标准答案,则容易提供只对当前题有效的捷径。K 没有答案,提供的是“先枚举候选、再用图结构和化学规则过滤、最后验证输出”的可复用程序。
4.5 82.3% 的行为恢复率怎么算?
作者为 h* 中的每条记忆、技能、工具或调用处理规则写了确定性的行为检测程序。对每种行为,只保留这样的测试题:原模型在 h* 下出现该行为,在 h 下不出现;能暴露该行为的题目少于 10 时,丢弃该行为。最终得到 SpreadsheetBench 18 种、USPTO 6 种、AppWorld 4 种。
28 种行为的平均恢复率为 82.3%。例如“保护预填单元格”是 24/26(92%),“读取完整分页”是 21/53(40%),“用 RDKit 验证”是 60/60(100%)。这里不能把 82.3% 当成自然任务分布上的总体行为准确率:样本筛选已使原模型 + h 为 0%、原模型 + h* 为 100%。它测的是蒸馏能否在专门挑出的“只有专用程序能触发该行为”的场景里恢复行为。
5. Discussion:训练数据必须与部署工具兼容
最值得复用的是数据生成时就检查部署可执行性。 更强教师、更高采集成功率,甚至标准答案,都不保证学生能在自己的工具接口里复现。Harness-Zero 只改下一步,再实际交给目标 harness 执行;被监督的记录因此包含它上线后也能完成的动作。
K 不给最终答案。它在模型准备犯错时加入一次文件检查、结果验证或恢复动作,保留原有轨迹的大部分状态。相比完全接管任务,这种记录更清楚地展示“遇到这种情况,下一步该怎么做”。
论文按逐步审查描述采集流程;在预算尚未耗尽时,一步要调用学生模型和审查模型,真正需要替换的却只占一部分。固定仓库在替换次数耗尽后直接放行,因此不能把整条轨迹的成本统一写成每步至少两次调用。后续可以研究只在高风险步骤审查:用较便宜的检测规则筛出可能覆盖文件、漏验证或调用错误工具的动作,再衡量省下的成本和损失的监督效果。
最后,论文也给 harness 设计提出了一个新问题:哪些组件的价值来自可学习流程,哪些必须在部署时继续作为外部能力存在?SpreadsheetBench 的检查工作流很容易写进模型回复;上下文裁剪、真正的并行调度、需要私有状态的安全隔离,就未必能靠 SFT 取代。
6. Conclusion:已证明的收益与尚未解决的依赖
程序化检查与工作流可以部分迁移进 9B 模型,深领域知识和所有外部机制尚不能一并移除。 完整路径是:先优化包裹学生的专用程序 h*,再把它改写成审查者读取的 K;审查模型用 PASS/REPLACE 把指导改写成 h 能执行的 response;监督微调只学已接受且实际执行的记录;部署时移除 h*、K 和审查者。
现有证据支持一个相对克制的结论:程序化 harness 行为可以在不保留专用 harness 的情况下,较大比例地迁移进一个 9B 模型。三领域平均分提高 21.0 个百分点,28 种仅在专用程序中触发的行为平均恢复 82.3%。但这还不是“所有 harness 都能被蒸馏掉”。
- 审查模型必须足够强。USPTO 上,agent-as-harness 相对 code-as-harness 在 GPT-5.6 Sol、DeepSeek-V4-Pro 上分别高 1 分和 4 分;在 DeepSeek-V4-Flash、Qwen3.6-35B-A3B 上则分别低 1 分和 12 分。最弱模型替换了 66.0% 的步骤,但这些改写整体有害。
- 采集成本明显增加。USPTO 上最小执行接口平均 100.1 秒,agent-as-harness 为 237.2 秒,约 2.4×;这部分成本在训练数据采集期发生,部署后消失。
- SFT 对深领域知识与真正的可执行能力吸收有限。USPTO 的蒸馏结果仍落后
h*8 分。 - 不是所有机制都能自然地写成学生回复。论文明确提到上下文管理仍是难以迁移的机制。
- 主要 pass@1 / SGC 都是单次运行结果,论文没有报告重复实验方差;强模型对比复用了在 Qwen3.5-9B 上演化的
h*,这个设计有利于考察迁移,但不等同于为每个强模型分别寻找最优 harness。
对复现而言,应同时检查执行记录有没有包含完整验证动作,以及部署工具是否支持这些动作。只确认训练答案正确,无法重现这篇论文最有信息量的对照。
留言