同一个模型,工具怎么执行、什么时候检查结果、怎样保存经验,都会影响任务能否完成。AHE 固定 GPT-5.4,让另一个负责维护的模型读取真实执行记录,修改这些执行程序,再重跑任务。每次修改记录“预计修好哪些题、可能破坏哪些题”;下一轮对照实际通过与失败的变化,检查这次判断准不准。
1. Motivation:为什么修改执行程序需要任务级证据?
同一个基础模型换一套 harness,完成率会明显变化;问题是目前这种优化主要靠人手看轨迹、找模式、改代码。 模型发布节奏越来越快,旧 harness 还可能和新模型不匹配。把所有经验继续堆进系统提示,也解决不了执行时拦截、跨步骤状态和工具语义这些问题。
AHE 把难点分成三类。第一,可修改对象不同:提示文字、工具参数格式、Python 处理代码和记忆规则,不能用同一种方法修改。第二,证据过长:一次 Terminal-Bench rollout 可以跨很多轮工具调用,真正有用的失败点埋在数百万 tokens 里。第三,因果难归属:成绩变了,并不能自动说明是哪项修改起作用,也不能说明它破坏了哪些原本能过的任务。
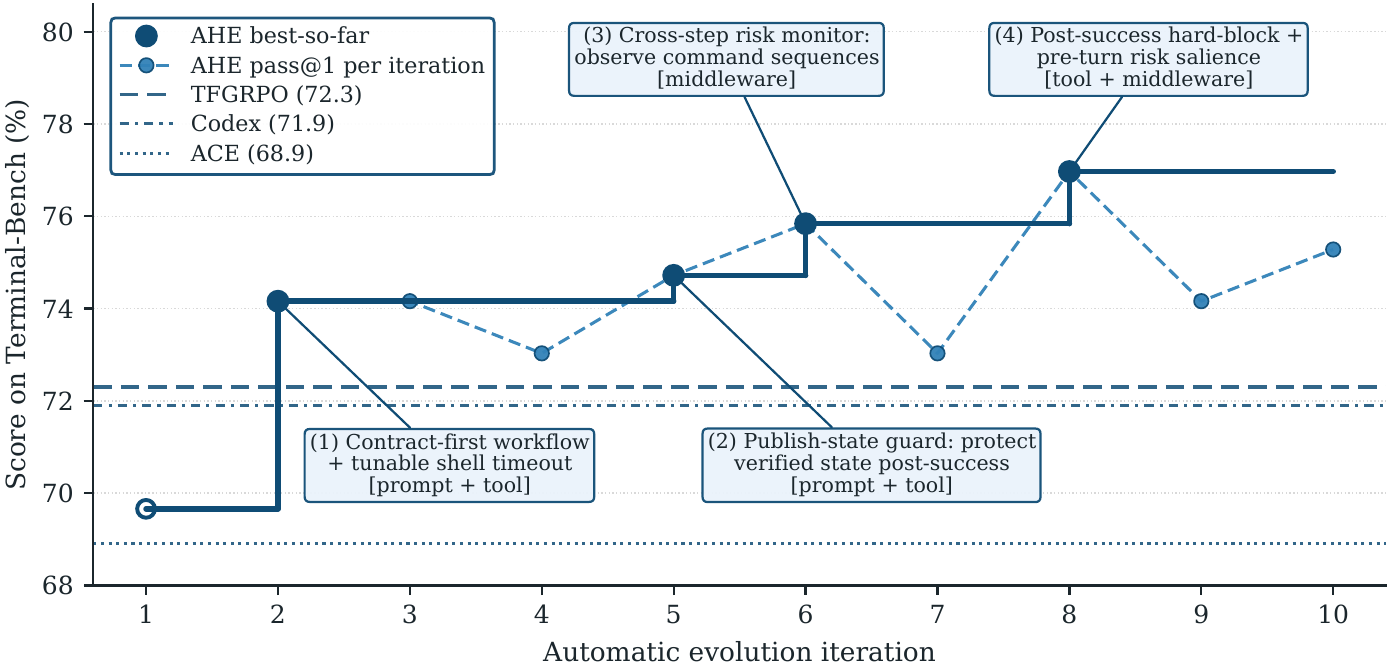
论文的判断是:维护模型需要看清可修改文件、压缩后仍能回查的执行证据,以及每次修改对应的可检验预测。具备这三项条件后,系统才能反复修改 harness,并用下一轮结果结算。验收程序、模型配置、记录器和运行记录目录始终只读;维护模型只能修改工作区内的执行程序。
2. Related Work:从提示优化到完整执行层修改
AHE 的边界在于“完整 harness + 真实执行证据 + 文件级回滚”。 相关工作里,Reflexion 一类方法改写下一次回答,ACE 将成功经验写成上下文手册,TF-GRPO 强化成功工具序列,DSPy 优化多阶段程序的指令与示例,AFlow 和 ADAS 搜索工作流或 Agent 程序。各方法开放的修改对象不同。
| 路线 | 可修改对象 | 主要反馈 | 和 AHE 的差别 |
|---|---|---|---|
| 人工 harness engineering | 提示、工具、调用处理与记忆 | 开发者读日志与评测结果 | 修改面完整,但依赖人工诊断和维护 |
| ACE / Expel / Reflexion | 手册、指令或历史经验 | 成功轨迹与文字反思 | 经验主要回到上下文,没有直接修改执行层 |
| TF-GRPO | 提示中的执行反馈 | 同组比较成功序列 | 不修改工具实现与调用处理 |
| AFlow / ADAS | 工作流图或 Agent 程序 | 执行得分 | 侧重结构搜索,不逐个文件记录组件修改效果 |
| AHE | 七类执行程序组件 | 分层执行记录与下一轮通过/失败变化 | 每项修改记录清单、Git 提交和可回滚的文件范围 |
论文也直接比较了三种自演化设置。ACE、TF-GRPO 和 AHE 都从同一个 bash-only NexAU₀ 出发,base model 都是 GPT-5.4 high。ACE 得到 68.9%,TF-GRPO 为 72.3%,AHE 为 77.0%。作者解释为修改层次不同:前两者修改自然语言经验,AHE 还能改工具实现和执行时处理代码。这个解释得到组件消融支持,但实验没有把所有相关方法在多次独立演化实验下重做,因此还不能把差距完全归因于“修改面更完整”。
3. Method:一轮修改:执行、诊断、预测与复测
每轮先重跑任务、核对上一轮预测,再提出下一轮修改。
3.1 让维护模型看到文件、执行记录和修改理由
论文把所需证据分为三层:可编辑文件告诉模型“能改哪里”,分层执行记录告诉它“哪里失败”,修改清单让下一轮能检查“预期效果是否出现”。这三层合称 observability,在这里就是能追查修改对象、错误过程和判断依据。
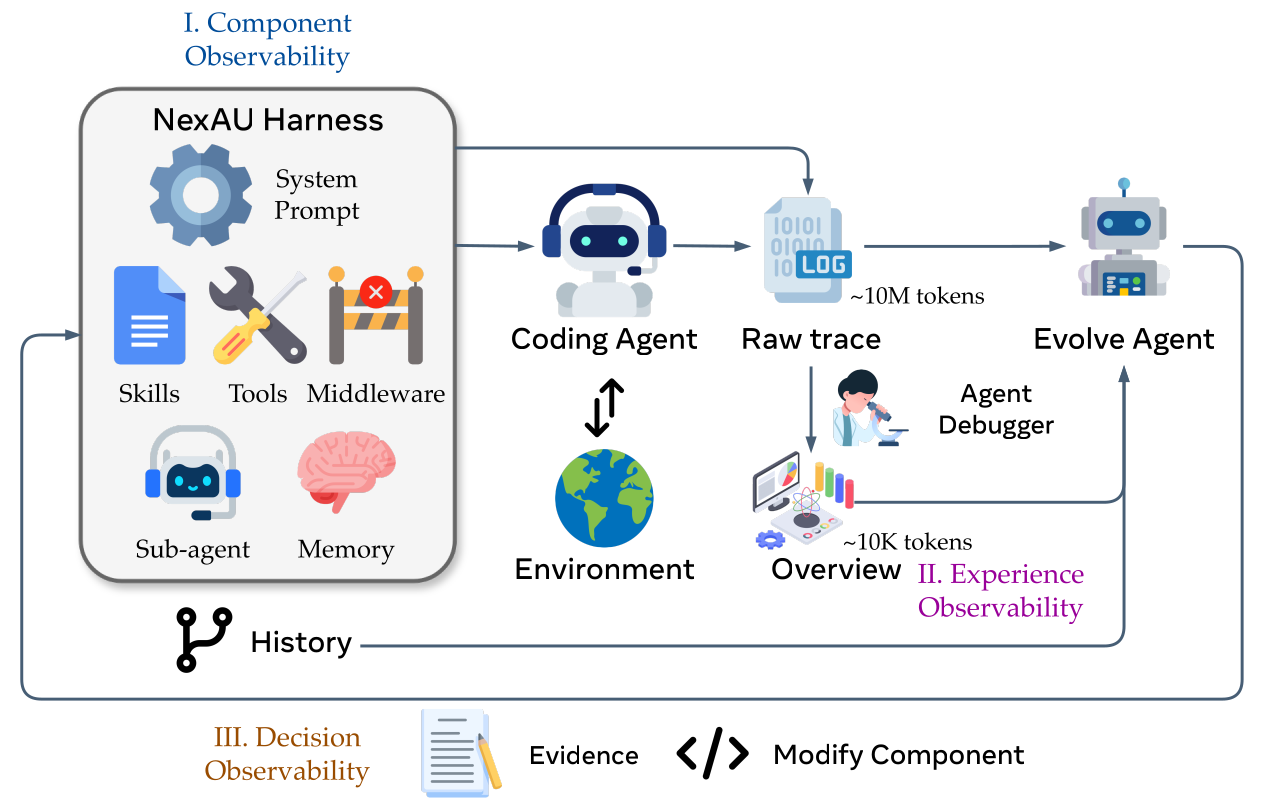
Agent Debugger 先把执行记录整理成总览和逐题报告。Evolve Agent 先读 analysis/overview.md,再按需打开 analysis/detail/{task}.md;报告不够时回查原始轨迹 nexau_in_memory_tracer.cleaned.json。论文称这种 progressive disclosure(先总览、再局部、最后原始记录)的入口约 10K tokens,原始记录约 10M。Debugger 也由模型完成,核心只部分开源,不能把这一步当成完全可复现的固定压缩算法。
3.2 修改清单怎样接受下一轮结果检验
- 1 · 执行任务当前 harness 每题执行 k 次。
- 2 · 整理记录轨迹转成统一文件结构。
- 3 · 核对旧预测用各题通过 / 失败的变化核对上一轮修改清单。
- 4 · 生成报告Debugger 生成分层证据。
- 5 · 修改组件修改工作区内组件,写新清单。
- 6 · 保存新修改每项修改独立提交,等下一轮执行后验收。
论文主实验每题 k = 2。这很重要,因为同一题一条过、一条不过时,可以对照两个 rollout 的分歧点,而不是只看到总分。每轮会把上一轮的 predicted_fixes(预计修好的任务)、risk_tasks(预计会退步的任务)与实际失败变通过、通过变失败的集合比较。这些预测写在 change manifest,也就是随修改保存的清单里。程序再标为 EFFECTIVE、PARTIALLY_EFFECTIVE、MIXED、INEFFECTIVE 或 HARMFUL;它们表示预测和实际结果的对应情况,不能消除同题两次采样带来的波动。
固定版本 8b2a55d 的执行顺序还需要说明两点。evolve.py 在收到当前版本的成绩后,先核对旧预测、更新已评测的最佳版本,再让维护模型写新修改。新文件还没有分数,要等下一轮执行;不能把当前成绩记给刚写出的修改。 论文 Algorithm 1 在这一点上混用了版本下标,本文按代码中的输入快照与评测顺序解释。
其次,evaluate_changes 只把清单声明的修复题和风险题用于单项判定。例如预计修好的题全部转为成功、声明的风险题没有退步,就标为 EFFECTIVE;没有被声明的退步另列报告。因此这个标签不代表“没有任何副作用”。代码生成核对报告后,由 Evolve Agent 决定撤销或重做哪些文件,不是程序一看到无效标签就自动撤销全部修改。
3.3 通过检查后,怎样阻止模型又删掉成果?
下面是我根据官方仓库 revision 8b2a55d 的 experiments/evolved_harness/tools/shell_tools/run_shell_command.py 压缩的等价片段。它不是任务验收程序,而是 AHE 最终演化出的终端工具行为。
# 根据官方实现压缩;Python 3.13 / NexAU runtime
def maybe_block(command, description, guard):
    override = "ALLOW_POST_SUCCESS_RESET" in (command + (description or ""))
    reasons, hard_reasons = [], []

    for path in guard["files"]:
        if destructive_rm(command, path):
            reasons.append(f"delete protected output {path}")
            if not path.startswith("/tmp/"):
                hard_reasons.append(reasons[-1])
        if writes_or_reruns(command, path):
            reasons.append(f"rewrite or rerun protected file {path}")
            hard_reasons.append(reasons[-1])

    if hard_reasons or (reasons and not override):
        return {"exit_code": 90, "type": "POST_SUCCESS_STATE_GUARD"}
    return None
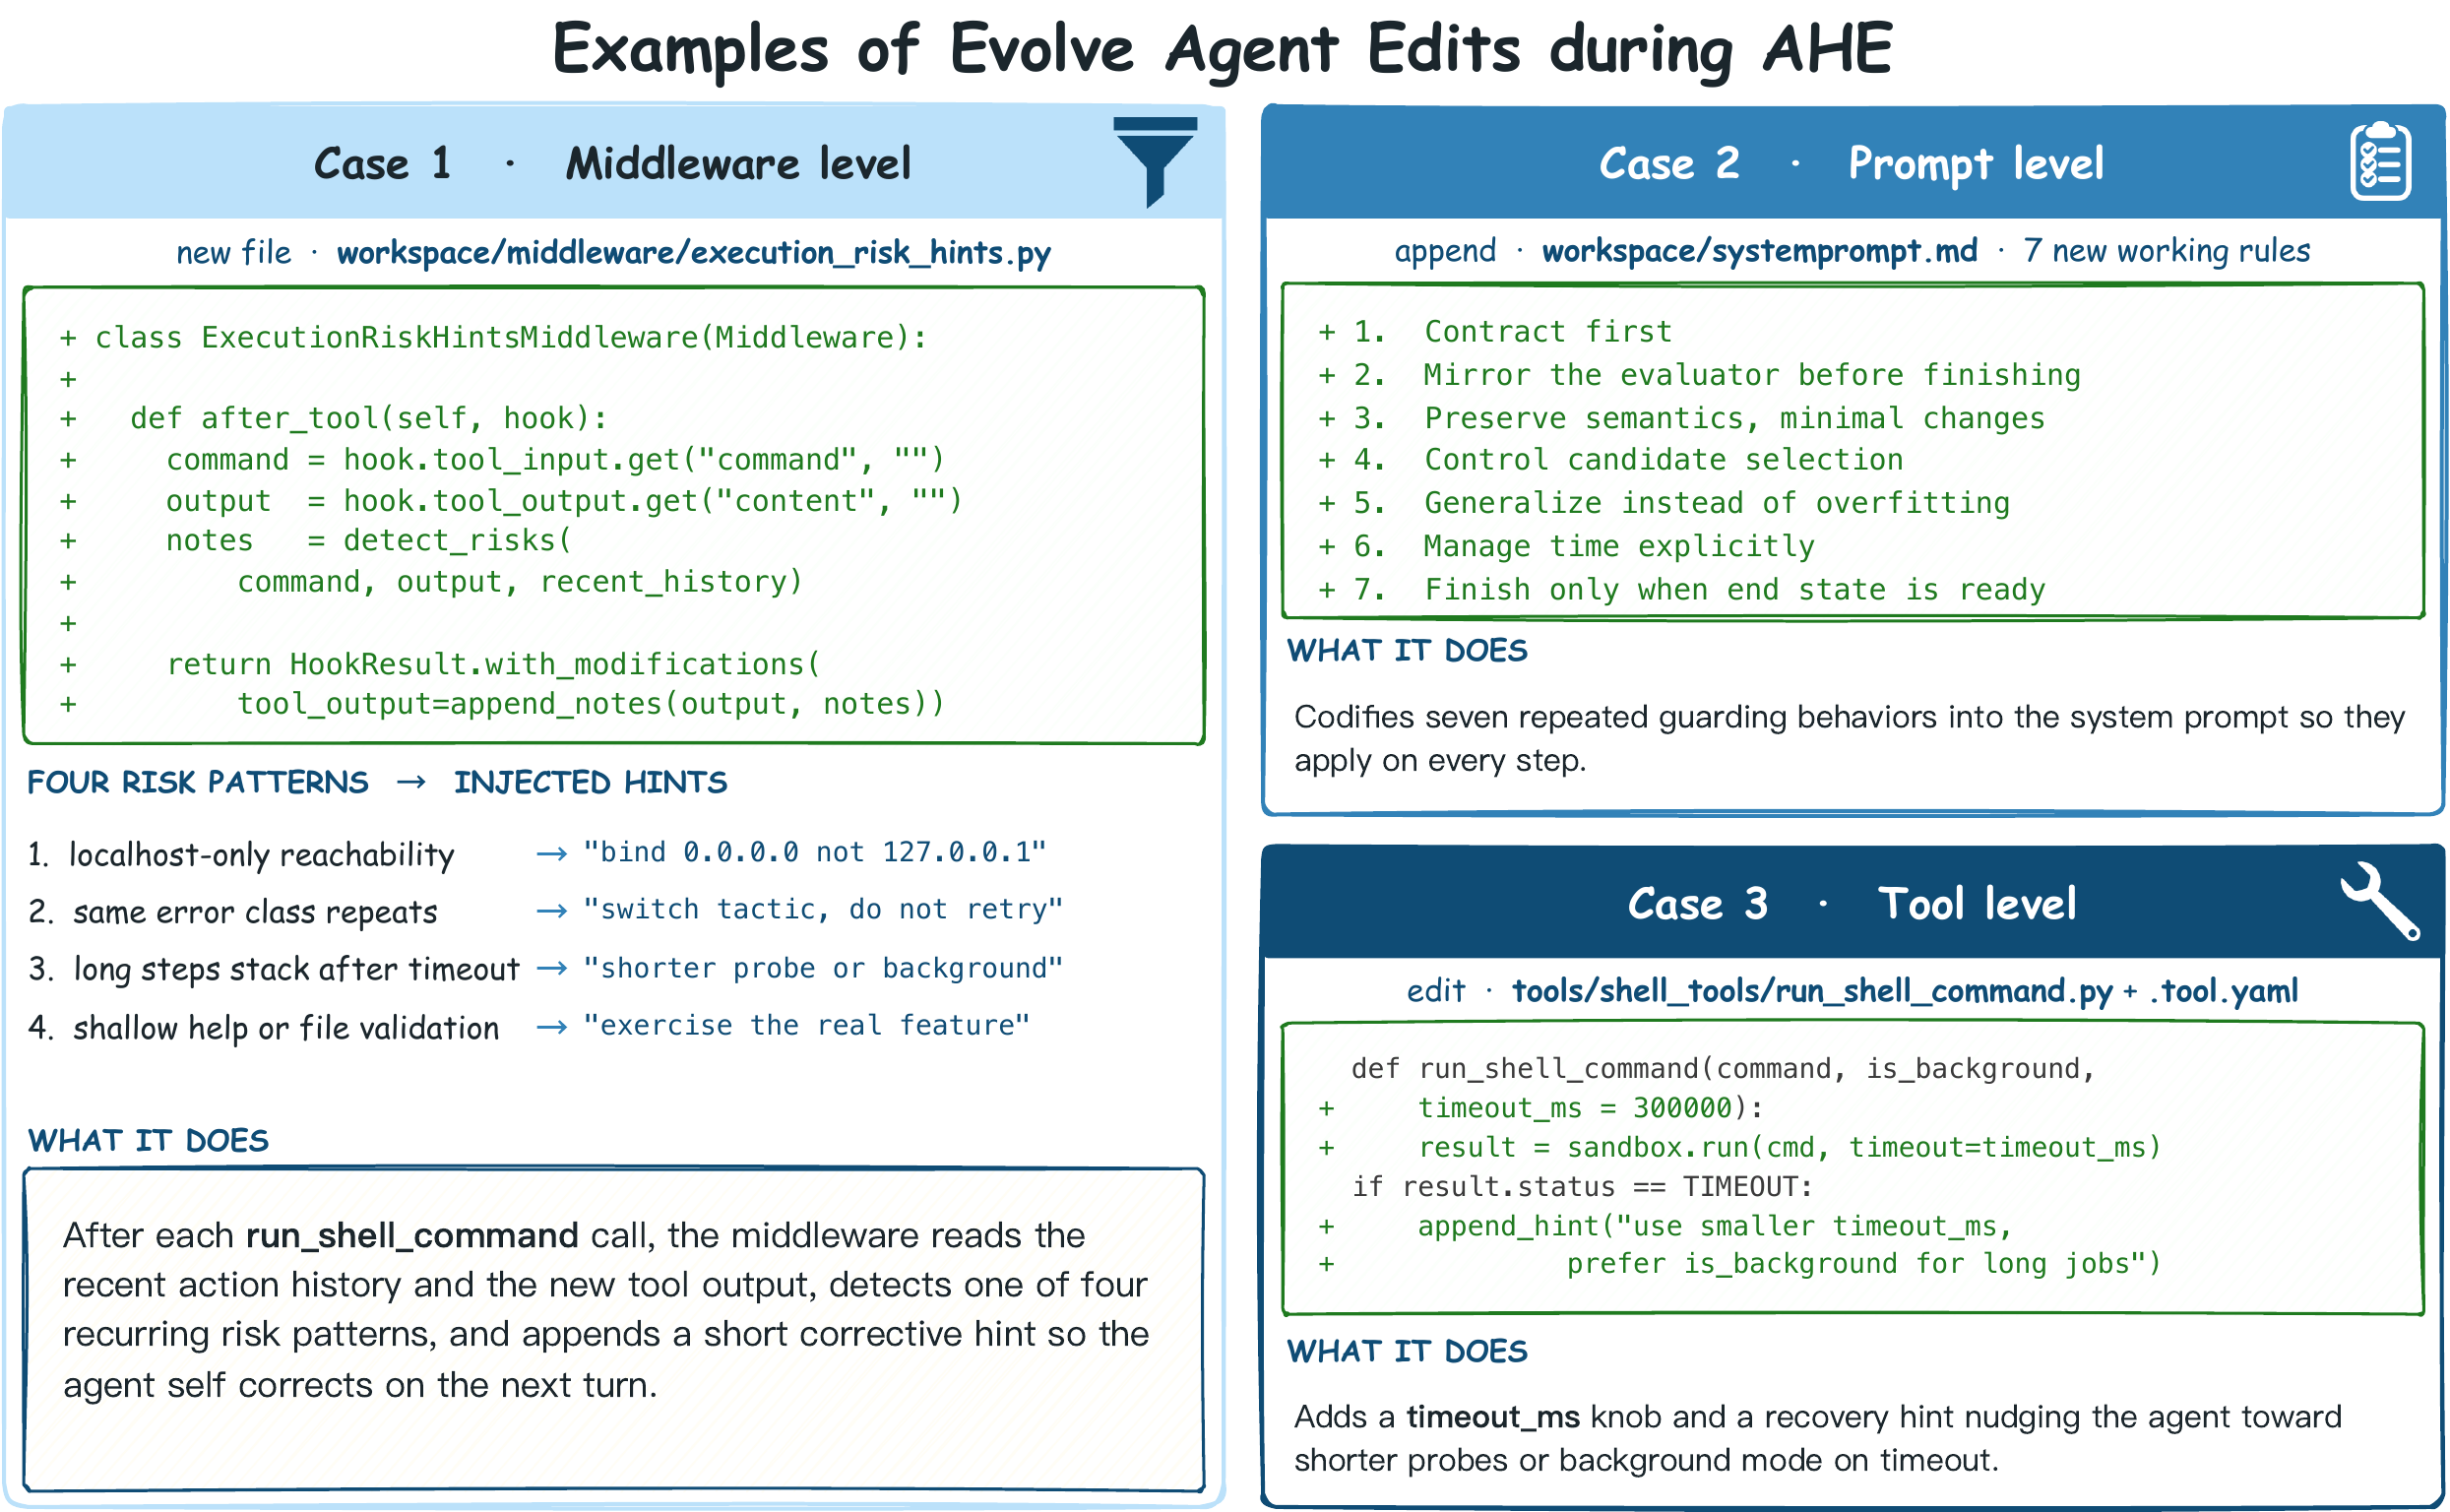
一次标为 final、evaluator-style 或 acceptance 的检查命令成功后,工具记录命令明确涉及的输出文件、待重跑脚本和项目目录。后续命令若准备删除或重写这些对象,shell 执行前就返回拦截结果。论文称它为 publish-state guard,具体是“保护已通过检查的交付状态”。第 5 轮还允许用授权标记放行部分动作;第 8 轮把删除非 /tmp 交付物和重置正在使用的项目目录改为不可绕过的拦截。
4. Experiments:从两条失败记录理解评分与修改效果
是否通过由任务自带的 verifier 决定,维护模型的自测不能代替最终验收。 主结果和两条真实案例都沿用 Terminal-Bench 2 的任务与评分器。
4.1 评测对象、可见输入与计分
主优化集是 Terminal-Bench 2 的 89 道题,其中 Easy 4、Medium 55、Hard 30。这 89 题全部用于驱动十轮修改,也用于挑选最高分版本;77.0% 不是在另留的测试集上得到的成绩。 独立任务集上的迁移证据来自后面的 SWE-bench Verified。Harbor 把每个 rollout 放进新建 E2B 隔离环境,最长 3600 秒;模型能看到任务说明、工作区与工具输出,不能修改验收、记录器、调度器或模型配置。任务验收是可执行检查;超时、隔离环境崩溃与 API 超时都计为失败,而平均 token 不含这些未完整结束的尝试。
公式中的 |D|=89 是任务数,k=2 是每题尝试数,rᵢⱼ 是某次尝试是否通过全部任务检查。分母因此为 89×2=178;某题两次全失败贡献 0/178,两次都成功贡献 2/178,一次成功贡献 1/178。这是所有尝试的平均成功率,不是“两次中成功一次就算解出该题”。
主实验只有一次十轮演化实验,大约 32 小时。三个角色都用 GPT-5.4,每题两次尝试,并行度 96。推理强度的记载有一处不一致:正文 §4.1 称三个角色均为 high,附录 Table 4 的配置表则列出 Code Agent 为 high、Evolve Agent 为 xhigh。本文保留这处差异,不把它当成同一配置。这里没有人工标注新的评测任务:任务和 verifier 来自 Terminal-Bench 2,AHE 产生的是轨迹分析和执行程序修改。
我也核查了论文仓库引用的 harbor-datasets。截至 revision 37db1088,公开目录里没有 Terminal-Bench 2 任务包;AHE 仓库本身也没有打包这四道题的验收程序。因此下文的任务说明、隐藏检查和逐步结果来自论文 Appendix C,不能当作我从公开验收源码独立复核后的结论。可以独立复核的是 AHE 的运行编排、修改效果核对,以及最终工具实现和调用处理代码。
| Harness / loop | All | Easy | Medium | Hard |
|---|---|---|---|---|
| OpenCode | 47.2 | 75.0 | 52.7 | 33.3 |
| Terminus-2 | 62.9 | 75.0 | 74.5 | 40.0 |
| Codex | 71.9 | 75.0 | 80.0 | 56.7 |
| NexAU₀ | 69.7 | 87.5 | 78.2 | 51.7 |
| ACE | 68.9 | 91.7 | 78.2 | 48.9 |
| TF-GRPO | 72.3 | 100.0 | 79.4 | 55.6 |
| AHE | 77.0 | 100.0 | 88.2 | 53.3 |
结论要分层看。AHE 的总分最高,主要来自 55 道中等难度题;Hard 上 53.3% 仍低于 Codex 的 56.7% 和 TF-GRPO 的 55.6%。优化目标按 89 题平均,Medium 数量占优势,所以 Evolve Agent 有动机接受对 Medium 有利、对 Hard 略有代价的组合。
4.2 图片生成正确,提交前却被删除
path-tracing:生成成功,清理动作删除交付物
- Terminal-Bench 2 任务要求 Agent 写出
/app/reconstructed.ppm。Verifier 只读取这个文件,与参考图像做逐像素比较。 - 第 4 轮两次尝试都已生成正确图片,并完成了自己的结构检查。
- Agent 最后执行类似
rm -rf /app/image /app/reconstructed.ppm /app/scratch的清理,然后把命令退出码 0 当成可以提交的依据。 - 任务验收运行时,唯一交付物已经不存在,因此两条都失败,得分 0/2。
- 第 5 轮提示说明“通过验收后的状态应保留”;终端工具记录受保护输出,在删除命令执行前拦截。
这个例子说明提示建议与执行拦截的差别。论文明确写到,初始提示已要求不破坏验证结果,模型仍会清理;直到工具实现禁止删除,错误才稳定消失。
4.3 两个结果文件存在,计算过程却没有完成
mcmc-sampling-stan:提前写入数字,未完成要求的采样
- 任务要求安装 rstan 2.32.7,用 30 条观测拟合 hierarchical beta-binomial model:用一组参数描述不同观测的成功概率如何分布。Agent 要写出加入观测后估计的 alpha、beta 平均值,也就是后验均值。
- Verifier 会自己安装依赖包,再从头运行 Agent 提交的
analysis.R。最终要求 alpha ∈ [2.84, 2.91],beta ∈ [16.1, 16.7]。 - 失败尝试用网格积分算出 2.876 / 16.375 并提前写进文件;任务要求的 MCMC(通过反复采样来估计参数分布)被放到后台,约 3 分钟就终止,理由是保留已有结果文件。
- Agent 的最终检查只确认两个文件存在且内容能解析。Verifier 重跑未收敛的
analysis.R,得到约 1.28e19 / 2.60e17,六项测试有两项失败。 - 第 6 轮的检查代码识别“用替代计算先写答案、只检查文件存在”的做法;保护代码同时记录
analysis.R,避免已验证的脚本被后续动作改坏。修复后的执行记录跑完iter=100000,又在/tmp独立复跑,约 2.872 / 16.43,六项测试全部通过。
这里的 judge 不是“看文件有没有”,而是复现官方计算流程并检查数值区间。AHE 的作用也不是泄漏隐藏答案,而是逼 Agent 走完任务说明要求的计算流程,并用独立执行交叉验证。
4.4 跨任务迁移、组件冲突与预测副作用
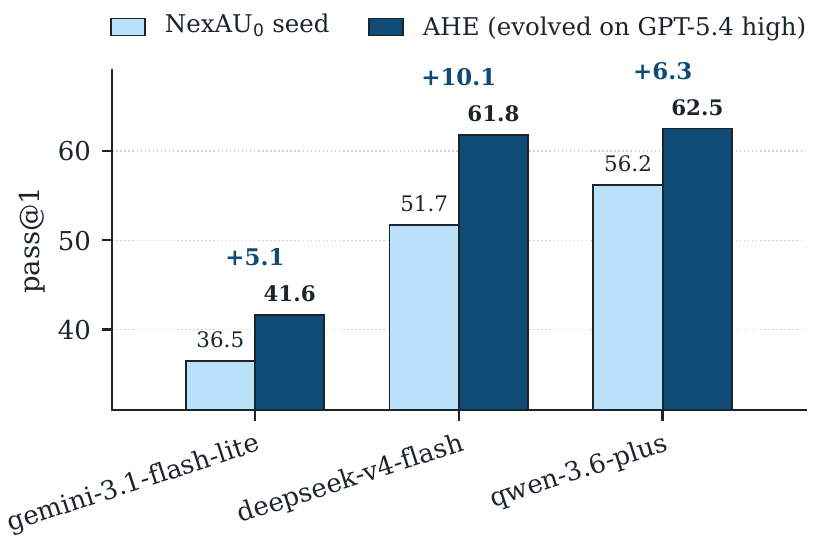
SWE-bench Verified 使用完整 500 题、七个仓库,AHE harness 不再针对该领域演化。总体成功率从 NexAU₀ 的 75.2% 到 75.6%,只高 0.4 个百分点;完整结束的尝试平均 token 从 526k 降到 461k,少约 12%。收益主要集中在 django 与 sphinx-doc,scikit-learn、pydata、astropy 三个较小仓库都退化。因而这张表更强的证据是效率迁移,不是大幅准确率迁移。
| Setting | SWE-bench Verified | Tokens / completed trial | Succ / Mtok |
|---|---|---|---|
| ACE | 74.6% | 679k | 1.10 |
| TF-GRPO | 74.2% | 582k | 1.27 |
| NexAU₀ | 75.2% | 526k | 1.43 |
| AHE | 75.6% | 461k | 1.64 |
这里的 Succ / Mtok 表示每消耗一百万 tokens,预期能完成多少次任务。附录定义为 成功率 × 10⁶ / 每次尝试的平均 tokens。以 AHE 为例,用表中的四舍五入值计算:0.756 × 10⁶ / 461000 ≈ 1.64。成功率统计包含异常退出的失败,token 均值却只统计完整结束的尝试;这个效率指标没有把异常尝试消耗的全部成本计入。
组件消融更值得注意:只加记忆为 75.3%、只加工具为 73.0%、只加调用处理为 71.9%,均高于初始 69.7%;只换系统提示则为 67.4%。Hard 的成绩只加记忆时为 63.3%,装上完整 AHE 却降到 53.3%。 三个正向组件的增益相加是 +11.1 个百分点,高于完整 AHE 的 +7.3 个百分点。作者在轨迹中看到几个组件都在重复要求提交前验证,叠加后会耗尽难题允许的交互轮数。因此不能把三个组件各自的增益相加,预测完整系统的成绩。
最后看修改效果预测。跨九轮可比较实验,修复预测的精确率 / 召回率是 33.7% / 51.4%,约为随机基线的五倍;退化预测是 11.8% / 11.1%,约为随机基线的两倍。精确率问的是“预计变化的题中,多少真的变化”,召回率问的是“实际变化的题中,多少提前预测到”。附录进一步报告累计 43 个退化预测只有 5 个命中,同时有 40 个实际退化没被预见。累计精确率是 5/43≈11.6%,与逐轮精确率取均值得到的 11.8% 不是同一种平均;累计召回率是 5/(5+40)≈11.1%。AHE 会记录修改假设,但它对副作用的判断仍然很弱。
5. Discussion:可复用的修改协议,以及还需要补的对照
执行规则要能分别修改、记录理由并做回归测试。 如果所有逻辑都写进一段大提示,维护模型很难知道某条规则是没有被读到、没有被执行,还是和另一个规则冲突。把“建议”升级成执行时提醒或工具拦截,也应当有明确条件:必须先从跨任务轨迹里看到重复错误,并验证只改提示仍不稳定。
对完整代码执行程序,我会优先复用下面四个研究设计:
- 每个组件固定路径、明确格式,使一项逻辑修改对应一个 commit。
- 同题至少两次尝试,对照同题一过一错时从哪步开始不同。
- 让维护模型先写预计修复题与风险题,下一轮按真实成败变化核对。
- 把提示建议、运行时提醒和执行前拦截当成三个不同强度的控制层,按错误的可逆性和风险选择。
论文还暴露出一个很有研究价值的问题:怎样让维护模型预测多个组件同时作用时的冲突。AHE 的清单围绕单项修改,但实际提示、记忆和调用处理可能同时推动同一种行为,导致重复检查。更完整的后续实验可以把多项修改的组合作为实验变量,逐一开关组件比较,并为 Easy、Medium、Hard 分别设预算约束,而不是只优化由 55 道中等难度题主导的总体平均分。
6. Conclusion:单次演化证明了什么,哪些稳定性仍未知?
AHE 证明模型可以按固定流程修改完整 harness,并用下一轮任务结果结算;现有实验还不足以说明这个过程稳定、低成本或能跨场景长期运行。 下面几个边界会直接影响复现和研究设计:
- 主结果来自一条十轮实验,没有不同随机种子的均值和方差。每轮又只有每题两次 rollout,单题成败变化的噪声仍然大。
- 三个角色都使用 GPT-5.4,推理强度在正文与附录配置表之间存在差异。论文保持 base model 不变,隔离了执行程序修改的作用;它没有证明较弱的维护模型也能完成同样的诊断。
- Agent Debugger 的核心只部分开源。公开仓库可检查运行循环、提示、最终组件与效果核对代码,但不能完全复现“10M tokens 如何压成 10K tokens 证据”的所有细节。
- SWE-bench Verified 的总体准确率只高初始配置 0.4 个百分点,且三个小 repo 下降;跨 benchmark 结果应主要理解为 token 效率与部分仓库上的迁移。
- 程序先针对 GPT-5.4 high 调整。medium、high、xhigh 的增益不是单调的,xhigh 可能因为更慢而超过任务超时。
- 自动修改的安全边界仍是研究原型:工作区限权、Git 回滚和验收只读能防一批明显捷径,但不能替代完整的防滥用与长期清理规则。
我的结论是:如果要研究 Claude Code、Codex 这一类完整 harness,这篇值得优先精读和复现。 它给出了可以直接实现的工程对象,也公开了具体失败轨迹。实验曲线并非一路上升,组件冲突与副作用预测不足都有可核对的负面结果。作者兴趣度因此是 10/10。
留言