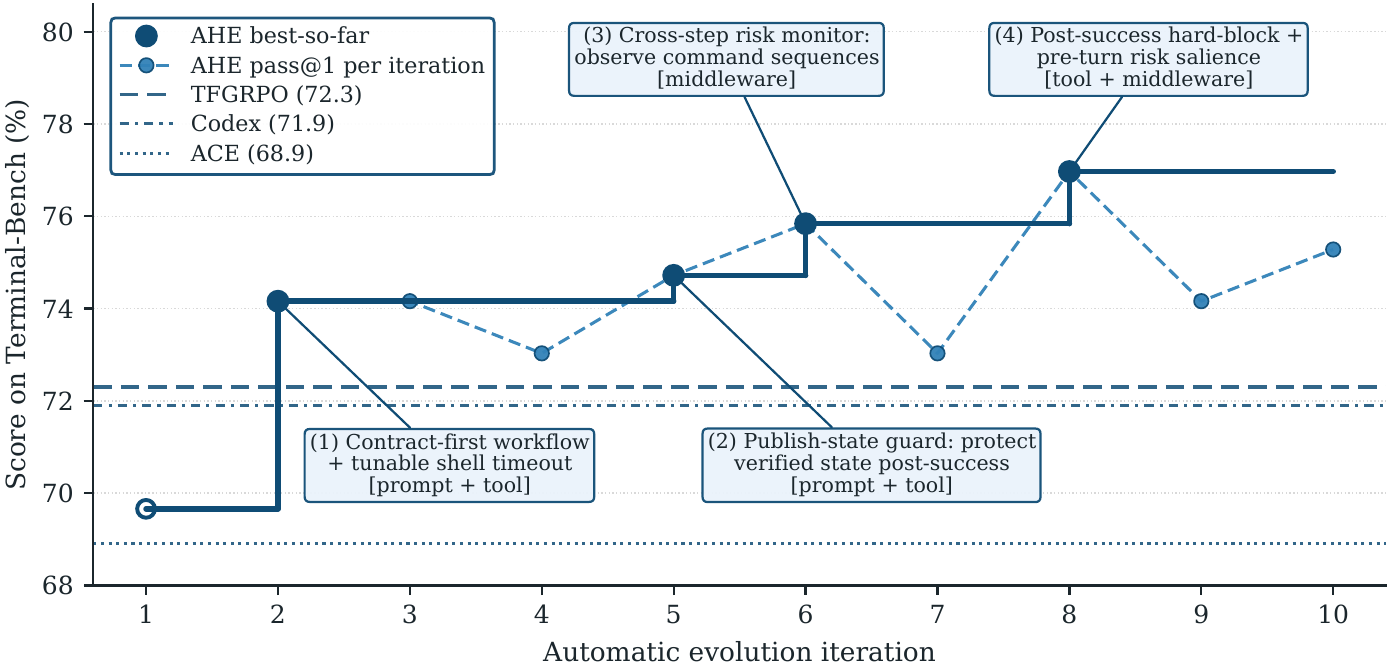
这篇论文把 coding agent 的 harness 当成一个可以自动维护的软件系统:模型本身保持不变,Evolve Agent 根据真实任务轨迹修改 prompt、tool、middleware 和 memory,再用下一轮任务的 pass/fail 变化检验修改是否有效。它最有价值的地方不是 77.0% 这个单点成绩,而是把“为什么改、改了什么、预期修谁、实际修到谁”串成了一条可以审计的链。
Q1. 为什么需要自动做 harness engineering?
同一个 base model 换一套 harness,完成率会明显变化;问题是目前这种优化主要靠人手看轨迹、找模式、改代码。 模型发布节奏越来越快,旧 harness 还可能和新模型不匹配。把所有经验继续堆进 system prompt,也解决不了执行时拦截、跨步骤状态和工具语义这些问题。
AHE 把难点分成三类。第一,修改面异构:一句 prompt、一个 tool schema、一段 middleware Python 和一条 memory 规则不是同一种动作。第二,证据过长:一次 Terminal-Bench rollout 可以跨很多轮工具调用,真正有用的失败点埋在数百万 tokens 里。第三,因果难归属:成绩变了,并不能自动说明是哪一项 edit 起作用,也不能说明它破坏了哪些原本能过的任务。
论文的核心判断是:如果 optimizer 能看到清楚的修改面、压缩过且可回钻的执行证据,并且每次修改都带可检验的预测,那么完整 harness 可以进入自动优化闭环。这里的“自动”不是无限制地让 Agent 改自己;verifier、model config、tracer、runs 目录都只读,Agent 只能修改 workspace 中的 harness 文件。
Q2. 它和 prompt evolution、agent workflow search 有什么区别?
AHE 的边界在于“完整 harness + 真实执行证据 + 文件级回滚”。 相关工作里,Reflexion 一类方法改写下一次回答,ACE 把成功经验压成 in-context playbook,TF-GRPO 强化成功 tool sequence,DSPy 优化多阶段程序里的 instructions 与 demonstrations,AFlow 和 ADAS 则搜索 workflow 或 agent program。它们各自有效,但多数只开放一个表面给 optimizer。
| 路线 | 可修改对象 | 主要反馈 | 和 AHE 的差别 |
|---|---|---|---|
| 人工 harness engineering | prompt、tools、hooks、memory 等 | 开发者读 log 与 benchmark | 修改面完整,但依赖人工诊断和维护 |
| ACE / Expel / Reflexion | playbook、instruction 或 episodic memory | 成功轨迹与文字反思 | 经验主要回到上下文,没有直接修改执行层 |
| TF-GRPO | prompt 中的 trajectory feedback | group-relative 成功序列 | 不打开 tool implementation 与 middleware |
| AFlow / ADAS | workflow graph 或 agent program | rollout score | 侧重程序结构搜索,不以 file-level harness component 为归因单位 |
| AHE | 七类 harness component | layered traces + next-round task flips | 每个 edit 有 manifest、Git commit 和 rollback 粒度 |
论文也直接比较了三种自演化设置。ACE、TF-GRPO 和 AHE 都从同一个 bash-only NexAU₀ 出发,base model 都是 GPT-5.4 high。ACE 得到 68.9%,TF-GRPO 为 72.3%,AHE 为 77.0%。作者的解释是 layer mismatch:前两者能改自然语言经验,AHE 还能把规律落实到 tool 和 middleware。这个解释得到组件消融支持,但实验没有把所有相关方法在多次独立 evolution run 下重做,因此还不能把差距完全归因于“修改面更完整”。
Q3. AHE 的闭环具体怎样运行?
3.1 三层 observability 各自产生什么 artifact?
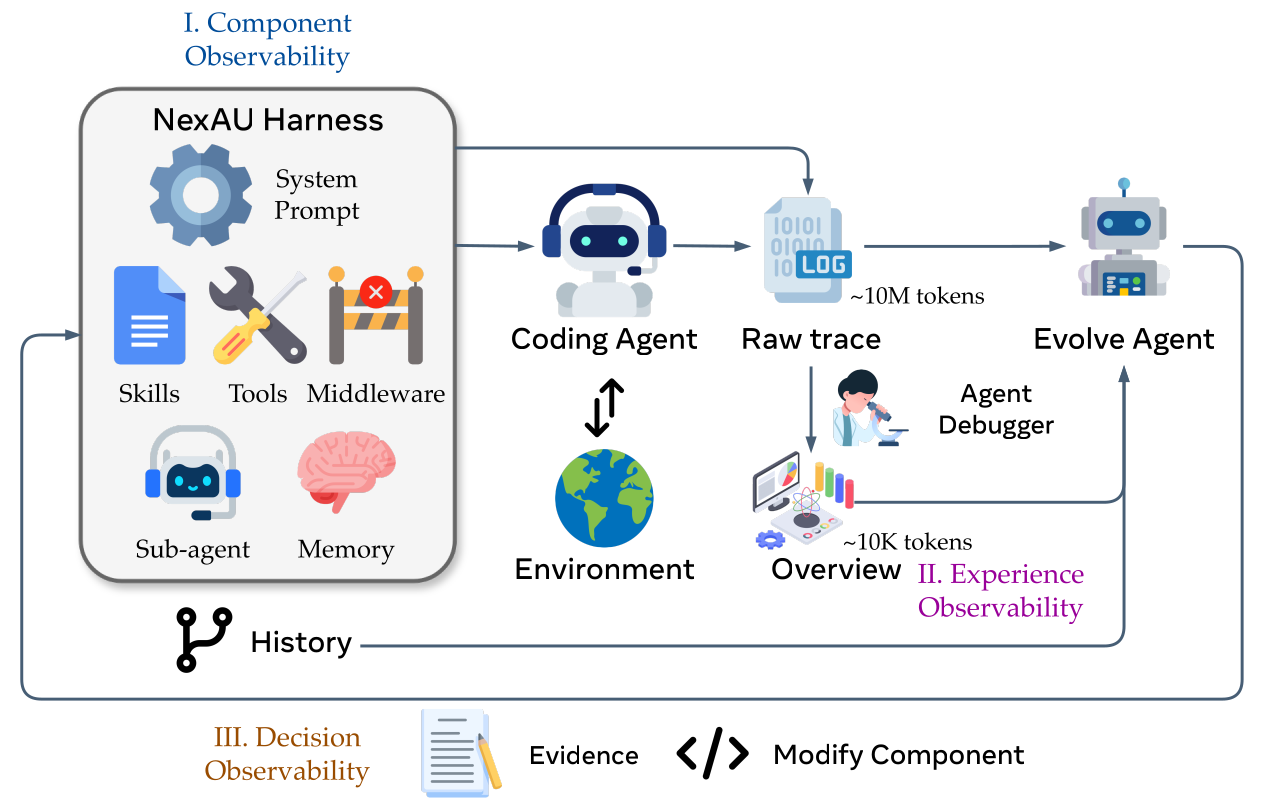
Experience observability 的关键是 progressive disclosure。Evolve Agent 先读跨任务的 analysis/overview.md,再按需打开 analysis/detail/{task}.md;只有报告证据不够时才回到 nexau_in_memory_tracer.cleaned.json。论文称原始轨迹约 10M tokens,压缩后的入口约 10K tokens。Agent Debugger 本身仍由模型完成,公开仓库也注明其核心只部分开源,所以这里的“证据蒸馏”并不是一个完全可复现的确定性程序。
3.2 一轮不是“改完再看总分”,而是先结算上一轮
- 1 · ROLLOUT当前 harness 每题执行 k 次。
- 2 · CLEAN轨迹转成统一文件结构。
- 3 · ATTRIBUTE用 task-level flip 结算上一轮 manifest。
- 4 · DISTILLDebugger 生成分层证据。
- 5 · EVOLVE修改 workspace 并写新 manifest。
- 6 · COMMITGit 记录,更新 best-so-far。
论文主实验每题 k = 2。这很重要,因为同一题一条过、一条不过时,可以对照两个 rollout 的分歧点,而不是只看到总分。每轮会把上一轮的 predicted_fixes、risk_tasks 和实际 fail→pass、pass→fail 集合求交,给出 EFFECTIVE、PARTIALLY_EFFECTIVE、MIXED、INEFFECTIVE 或 HARMFUL。
3.3 官方代码里的 publish-state guard 是怎样拦命令的?
下面是我根据官方仓库 revision 8b2a55d 的 experiments/evolved_harness/tools/shell_tools/run_shell_command.py 压缩的等价片段。它不是 benchmark checker,而是 AHE 最终学出的 shell tool 行为。
# 根据官方实现压缩;Python 3.13 / NexAU runtime
def maybe_block(command, description, guard):
    override = "ALLOW_POST_SUCCESS_RESET" in (command + (description or ""))
    reasons, hard_reasons = [], []

    for path in guard["files"]:
        if destructive_rm(command, path):
            reasons.append(f"delete protected output {path}")
            if not path.startswith("/tmp/"):
                hard_reasons.append(reasons[-1])
        if writes_or_reruns(command, path):
            reasons.append(f"rewrite or rerun protected file {path}")
            hard_reasons.append(reasons[-1])

    if hard_reasons or (reasons and not override):
        return {"exit_code": 90, "type": "POST_SUCCESS_STATE_GUARD"}
    return None
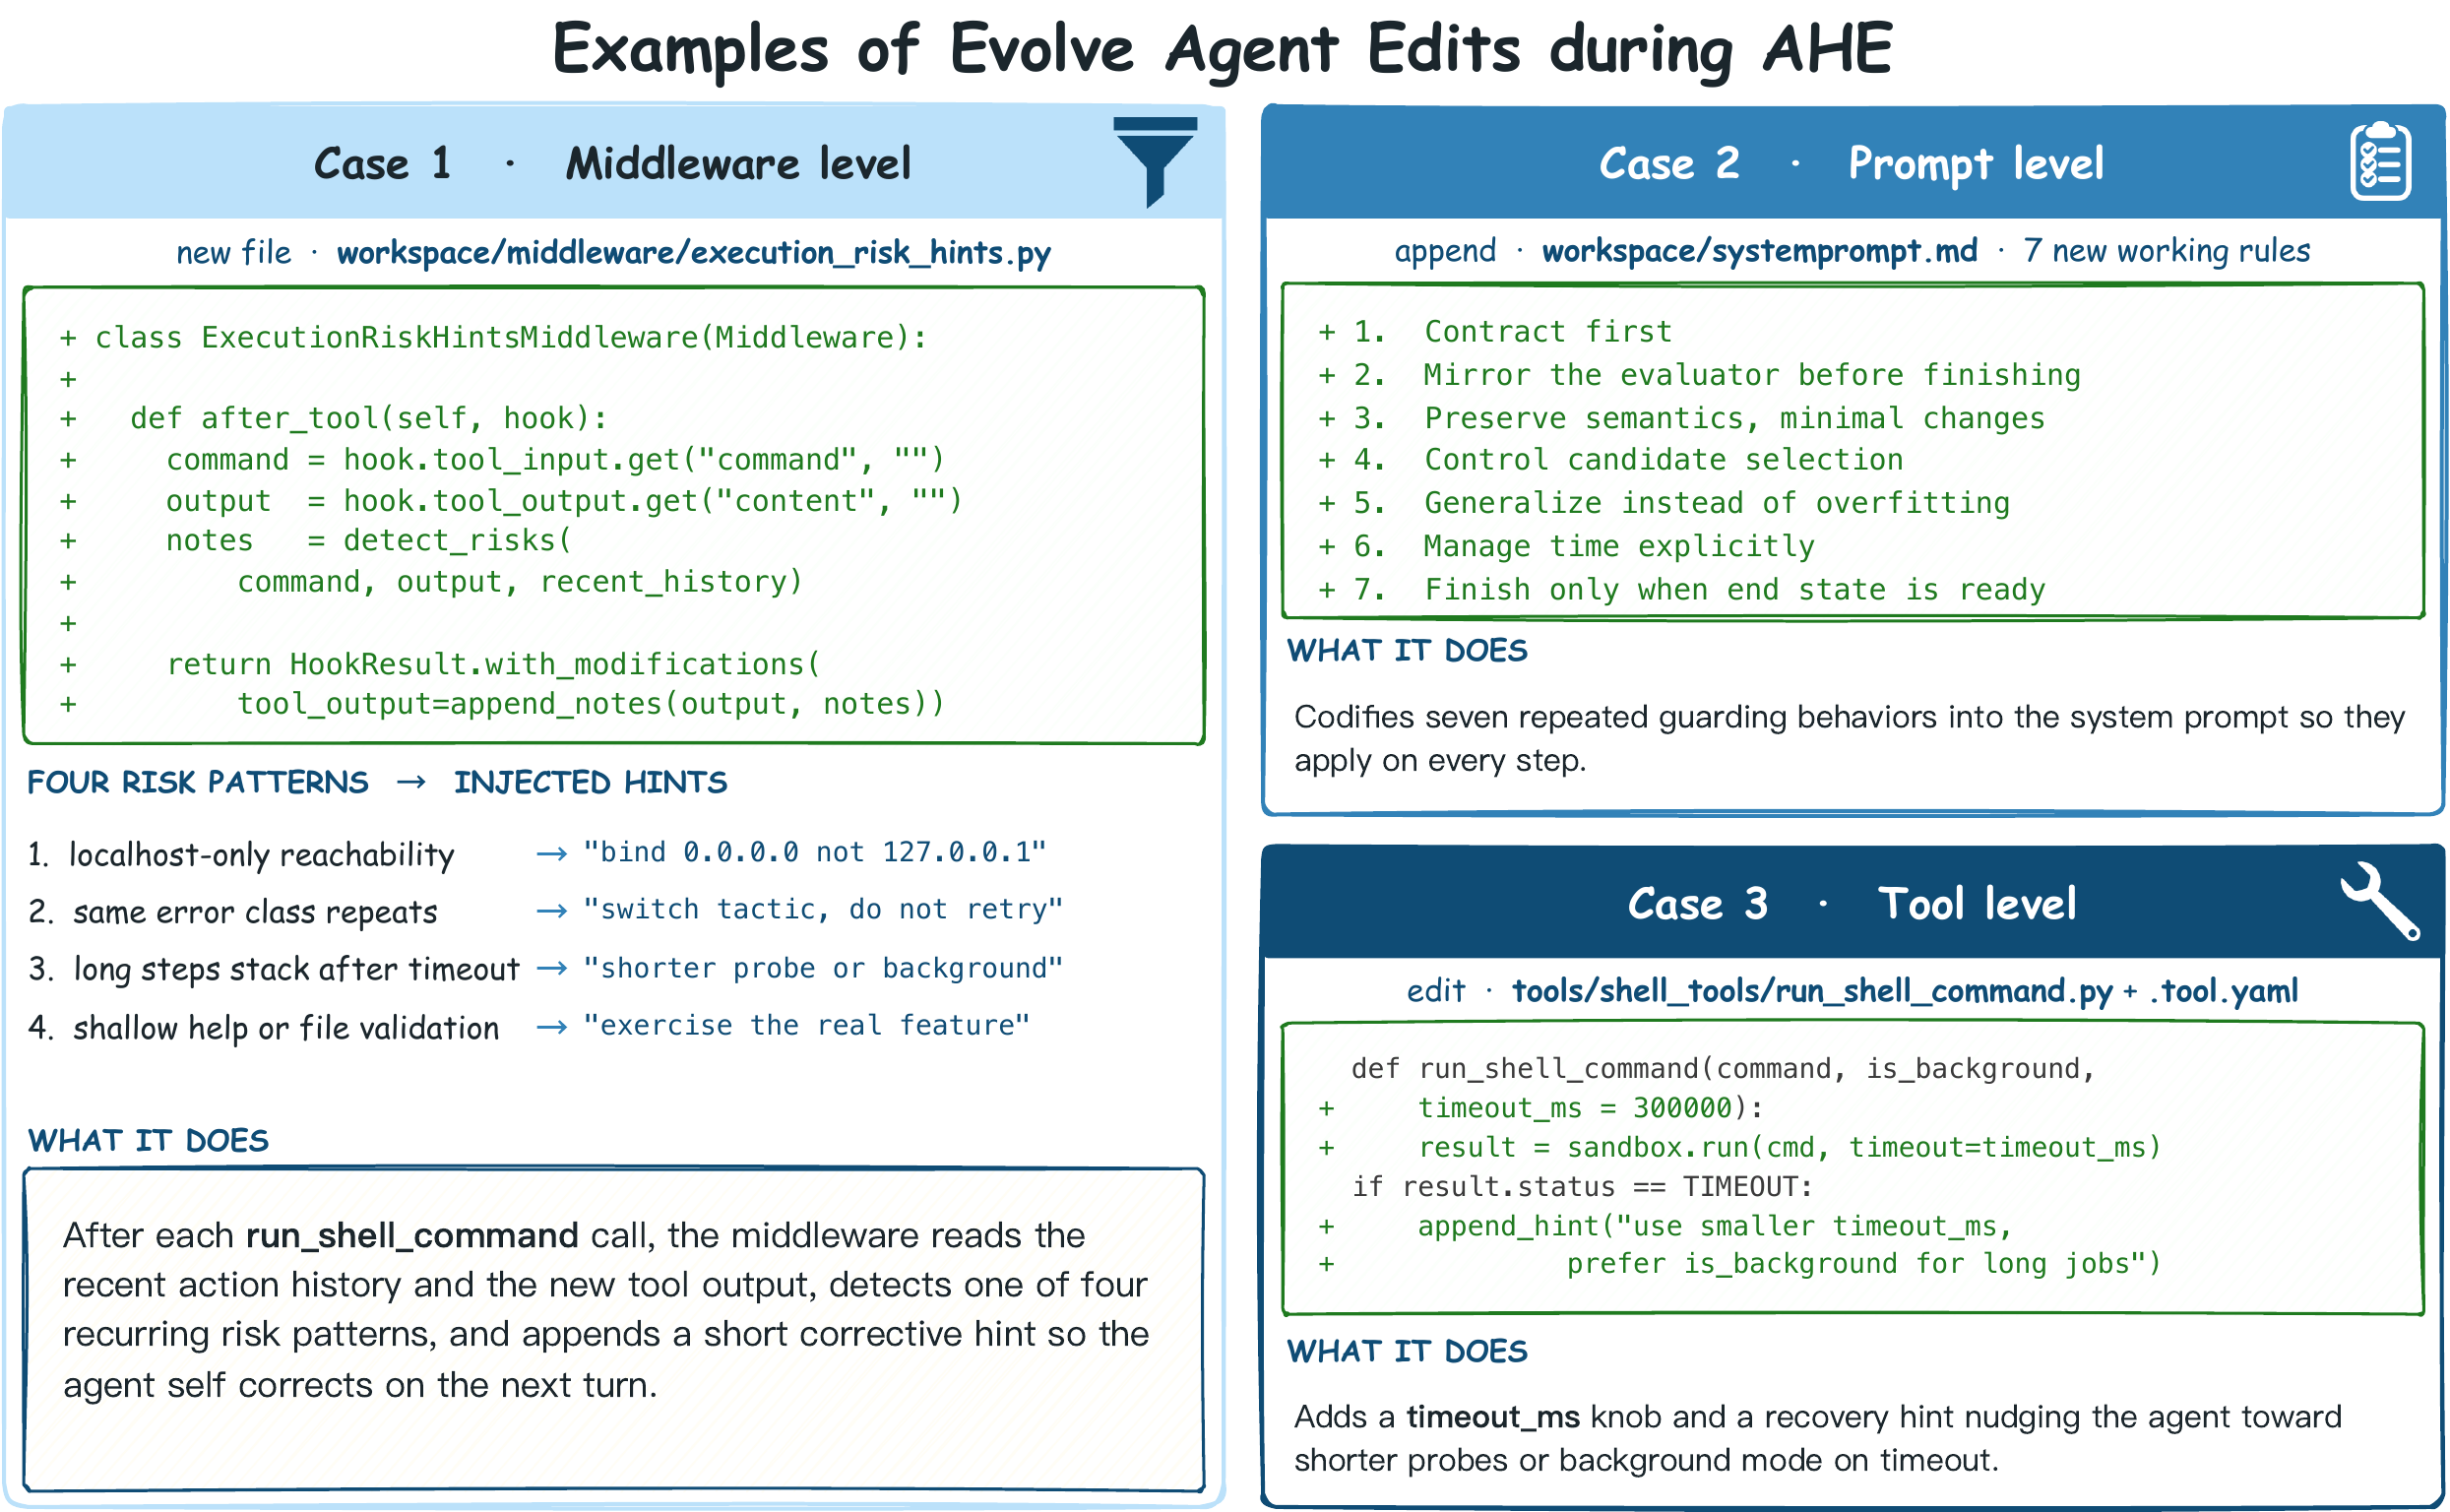
Guard 什么时候开始保护?一次带有 final、evaluator-style 或 acceptance 描述的命令成功后,tool 从命令中提取明确出现的文件、script entrypoint、Git root、web root 和当前工作目录,写入 per-agent state。后续删除、重写、重跑或破坏 Git metadata 的命令会在 shell 真正执行之前被阻止。第 5 轮的 override token 仍能放行部分动作;第 8 轮把非 /tmp 交付物删除和 live root reset 升级成 hard block,override 也不能绕过。
Q4. 实验、真实 case 和 judge 到底说明了什么?
4.1 评测对象、可见输入与计分
主优化集是 Terminal-Bench 2 的 89 个 task,其中 Easy 4、Medium 55、Hard 30。Harbor 把每个 rollout 放进 fresh E2B sandbox,最长 3600 秒;模型能看到 task brief、workspace 与工具输出,不能修改 verifier、tracer、dispatcher 或 LLM config。Verifier 是任务自带的可执行检查。timeout、sandbox crash 和 API timeout 都按失败计入 pass@1,而 token mean 会排除这些未完整结束的 trial。
主实验只有一条十轮 evolution campaign,大约 32 小时。Code Agent、Agent Debugger 和 Evolve Agent 都用 GPT-5.4;Code Agent 是 high reasoning,Evolve Agent 是 xhigh。每个 task 两次 rollout,并行度 96。这里没有人工标注新的 benchmark:任务和 verifier 来自 Terminal-Bench 2,AHE 产生的是轨迹分析和 harness edit。
我也核查了论文仓库引用的 harbor-datasets。截至 revision 37db1088,公开目录里没有 Terminal-Bench 2 task pack;AHE 仓库本身也没有打包这四个 task 的 verifier。因此下文的 task brief、隐藏检查和逐步结果来自论文 Appendix C,不能当作我从公开 checker 源码独立复核后的结论。可以独立复核的是 AHE 的 orchestration、change attribution,以及最终 evolved shell tool 和 middleware。
| Harness / loop | All | Easy | Medium | Hard |
|---|---|---|---|---|
| OpenCode | 47.2 | 75.0 | 52.7 | 33.3 |
| Terminus-2 | 62.9 | 75.0 | 74.5 | 40.0 |
| Codex | 71.9 | 75.0 | 80.0 | 56.7 |
| NexAU₀ | 69.7 | 87.5 | 78.2 | 51.7 |
| ACE | 68.9 | 91.7 | 78.2 | 48.9 |
| TF-GRPO | 72.3 | 100.0 | 79.4 | 55.6 |
| AHE | 77.0 | 100.0 | 88.2 | 53.3 |
结论要分层看。AHE 的总分最高,主要来自 55 个 Medium tasks;Hard 上 53.3% 仍低于 Codex 的 56.7% 和 TF-GRPO 的 55.6%。优化目标按 89 题平均,Medium 数量占优势,所以 Evolve Agent 有动机接受对 Medium 有利、对 Hard 略有代价的组合。
4.2 Case 1:正确图片为什么还会 FAIL?
path-tracing:生成成功,cleanup 删除交付物
- Terminal-Bench 2 task 要求 Agent 写出
/app/reconstructed.ppm。Verifier 只读取这个文件,和 reference image 做逐像素比较。 - 第 4 轮两个 rollout 都已经 render 出正确图片,并完成了自己的结构检查。
- Agent 最后执行类似
rm -rf /app/image /app/reconstructed.ppm /app/scratch的 cleanup,然后把命令 exit code 0 当成可以提交的依据。 - Verifier 执行时,唯一交付物已经不存在,因此两条都失败,得分 0/2。
- 第 5 轮的 prompt rule 说明“通过 acceptance 后的状态就是 publish state”;shell tool 同时记录 protected output,并在后续删除命令执行前返回 block。
这个例子说明 prompt 和 execution guard 的差别。论文明确写到,seed prompt 已经提醒不要破坏 verified state,但模型仍会执行 cleanup;直到 tool implementation 把删除动作变成不可执行,错误才稳定消失。
4.3 Case 2:为什么“两个数字文件都在”仍然 FAIL?
mcmc-sampling-stan:proxy answer 代替真实 pipeline
- Task 要求安装 rstan 2.32.7,用 30 条观测拟合 hierarchical beta-binomial model,并写出 posterior mean。
- Verifier 会自己安装 package,再从头运行 Agent 提交的
analysis.R。最终要求 alpha ∈ [2.84, 2.91],beta ∈ [16.1, 16.7]。 - 失败 rollout 用独立 grid integration 算出看似合理的 2.876 / 16.375,把它们先写进文件;真正的 MCMC 放到后台后,约 3 分钟就被 kill,理由是“保留已经写好的 deliverables”。
- Agent 的最终检查只确认两个文件存在且内容能 parse。Verifier 重跑未收敛的
analysis.R,得到约 1.28e19 / 2.60e17,2/6 tests fail。 - 第 6 轮的 middleware 识别 inline proxy 与 shallow validation;publish-state guard 同时把
analysis.R作为 protected entrypoint。修复后的 rollout 跑完iter=100000,又在/tmp独立复跑,约 2.872 / 16.43,6/6 tests pass。
这里的 judge 不是“看文件有没有”,而是复现官方计算流程并检查数值区间。AHE 的作用也不是泄漏隐藏答案,而是逼 Agent 走完 task brief 明确要求的 pipeline,并用独立执行交叉验证。
4.4 Transfer、消融和负结果
SWE-bench Verified 使用完整 500 题、七个 repository,AHE harness 不做 in-domain re-evolution。Aggregate success 从 NexAU₀ 的 75.2% 到 75.6%,只高 0.4 pp;tokens/trial 从 526k 降到 461k,少约 12%。收益主要集中在 django 与 sphinx-doc,scikit-learn、pydata、astropy 三个较小 repo 都退化。因而这张表更强的证据是效率迁移,不是大幅准确率迁移。
| Setting | SWE-bench Verified | Tokens / completed trial | Succ / Mtok |
|---|---|---|---|
| ACE | 74.6% | 679k | 1.10 |
| TF-GRPO | 74.2% | 582k | 1.27 |
| NexAU₀ | 75.2% | 526k | 1.43 |
| AHE | 75.6% | 461k | 1.64 |
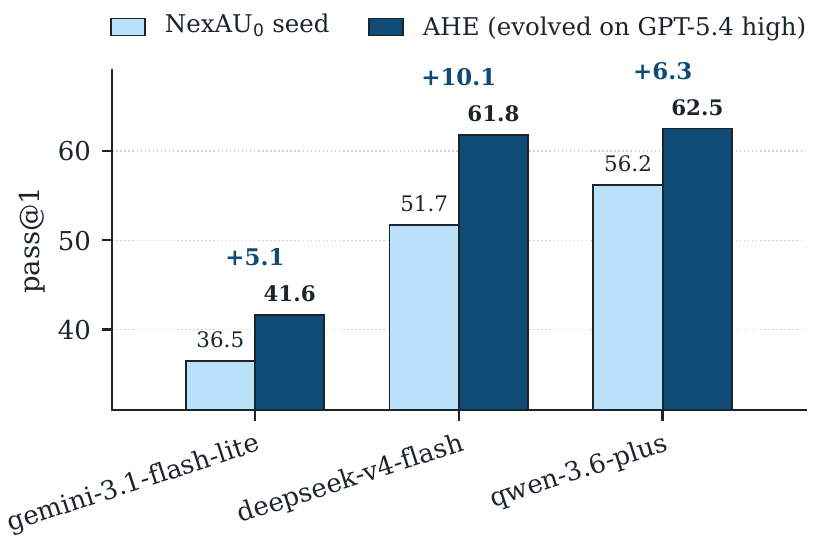
组件消融更值得注意:memory only 75.3%、tool only 73.0%、middleware only 71.9%,都高于 69.7% seed;system prompt only 为 67.4%。三个正向组件的增益相加是 +11.1 pp,高于 full AHE 的 +7.3 pp。作者在轨迹中看到几层组件都在反复做 closure verification,叠加后会耗掉 Hard task 的 turn budget。完整 harness 的组件不是可独立相加的积木。
最后看 self-attribution。跨九个可比较 round,fix prediction 的 precision / recall 是 33.7% / 51.4%,约为随机基线的五倍;regression prediction 是 11.8% / 11.1%,只比随机基线高约一倍。附录进一步报告累计 43 个 regression predictions 只有 5 个命中,同时有 40 个实际 regression 没被预见。AHE 会记录因果假设,但它对副作用的判断仍然很弱。
Q5. 对 Claude Code、Codex 这类 harness 研究有什么启发?
最直接的启发是把 harness 设计成可以实验和结算的组件系统。 如果所有逻辑都写进一段大 prompt,optimizer 很难知道某条规则是没有被读到、没有被执行,还是和另一个规则冲突。把“建议”升级成 middleware 或 tool guard,也应当有明确条件:必须先从跨任务轨迹里看到重复 failure pattern,并验证 prompt-level fix 不够稳定。
对完整 coding harness,我会优先复用下面四个研究设计:
- 每个组件固定路径、明确 schema,并让一个 logical edit 对应一个 commit。
- 同题至少两个 rollout,专门比较 partial-pass 的 divergence point。
- 让 optimizer 在修改前写 predicted fixes 与 risk tasks,下一轮按 task-level delta 结算。
- 把 soft instruction、runtime reminder 和 hard block 当成三个不同强度的控制层,按错误的可逆性和风险选择。
论文还暴露出一个很有研究价值的问题:怎样让 optimizer 预测 cross-component interference。AHE 的 manifest 以单个 edit 为中心,但实际执行中 prompt、memory、middleware 可能同时推动同一种行为,导致重复检查。更完整的后续实验可以把 edit 组合当作因果单元,加入 factorial 或 bandit-style 的组合消融,并为 Easy、Medium、Hard 分别设预算约束,而不是只优化一个由 55 个 Medium tasks 主导的 aggregate。
Q6. 这篇论文的证据边界和最终判断是什么?
AHE 已经证明完整 harness 可以进入自动优化闭环,但还没有证明这个闭环稳定、低成本、可跨场景长期自治。 下面几个边界会直接影响复现和研究设计:
- 主结果来自一条十轮 campaign,没有多 seed 的均值和方差。每轮又只有每题两次 rollout,单 task flip 的噪声仍然大。
- 三个角色都使用 GPT-5.4,且 Evolve Agent 是 xhigh reasoning。论文保持 base model 不变,隔离了 harness edit 的作用;它没有证明较弱 optimizer 也能完成同样的诊断。
- Agent Debugger 的核心只部分开源。公开仓库能看到 loop、prompt、evolved harness 与 attribution code,但不能完全复现“10M tokens 如何压成 10K tokens 证据”的所有细节。
- SWE-bench Verified 的 aggregate accuracy 只高 seed 0.4 pp,且三个小 repo 下降;跨 benchmark 结果应主要理解为 token efficiency 和部分 repository 上的迁移。
- operating point 在 GPT-5.4 high 上调过。medium、high、xhigh 的增益不是单调的,xhigh 可能因为更慢而越过 task timeout。
- self-modification 的安全边界仍是研究原型:workspace 限权、Git rollback 和 verifier 只读能防一批明显捷径,但不能替代完整的 misuse prevention 与长期 cleanup governance。
我的结论是:如果要研究 Claude Code、Codex 这一类完整 harness,这篇值得优先精读和复现。 它既给了可以直接实现的工程对象,也公开了很具体的失败轨迹;更重要的是,论文没有把 self-evolution 包装成一路单调上升,反而把 component interference 和 regression blindness 摆到了台面上。作者兴趣度因此是 10/10。
留言