EvoHarnessBench 让平台分阶段加入新工具、操作指南或专门处理某类任务的 Agent。每道旧题和它的评分规则在后续阶段保持不变,可选能力却越来越多。17 条阶段序列、802 个不重复任务,用来检查系统能否利用新能力解决新题,以及它会不会因为选择变多,把原来会做的题也做错。
1. Motivation:为什么工具变多会让原本会做的题变难
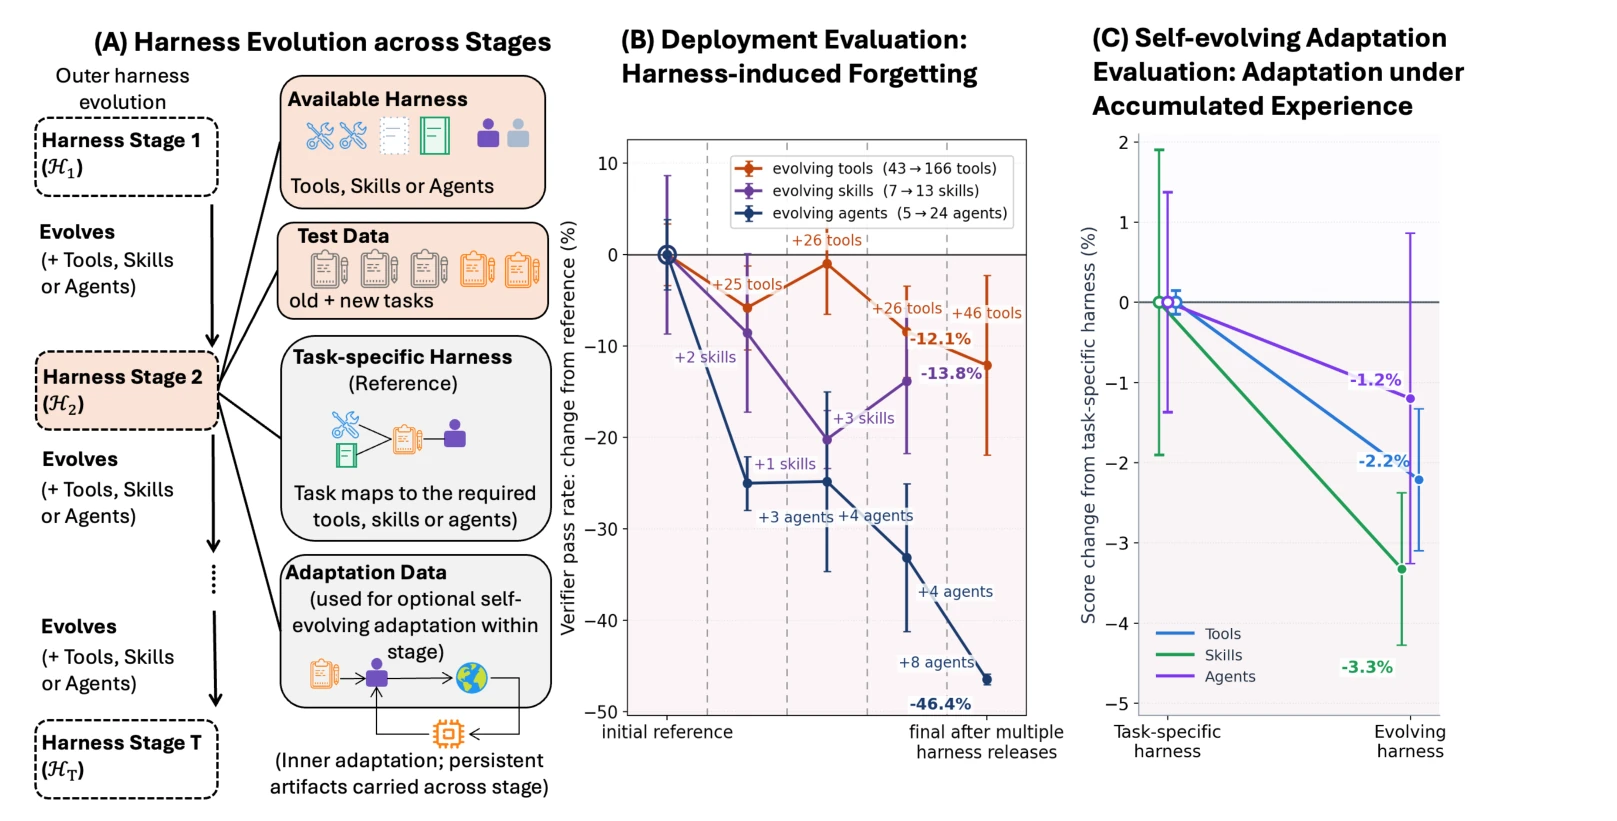
旧工具还在,不代表模型会继续选对它们。系统原本只需要在几个工具或专用 Agent 中选择,目录扩张后可能漏选必要能力、被相似名称干扰,或沿用不适合当前目录的旧记忆。论文称这种原题不变、模型不变,却因为平台变大而掉分的现象为 harness-induced forgetting。它不同于模型参数训练后遗忘:甚至每阶段全新实例、不保存记忆的系统也可能发生。
2. Related Work:与静态工具评测和持续学习的区别
被测系统要适应平台新加入的能力,benchmark 不要求它自己扩展外部平台。τ-bench、SkillsBench 等主要使用固定工具或技能;AgentCL、ContinualBench 把变化放在任务序列,通常固定 harness;CMRBench 更接近,但扩张的是可路由的模型池。EvoHarnessBench 把工具、skills 和专用 Agent 池的扩张分别控制。
它与自动 harness coding 的关系是长期部署检验:自动写出的执行系统即使今天高分,明天加入几十个工具后仍可能退化。Meta-Harness 是其中一个可以更新代码的适应方法,而不是全 benchmark 的任务定义。不同方法也可以只更新记忆或提示词。
3. Benchmark / Protocol:任务怎样进入阶段,输出怎样被检查
作者复用 EOG 和 ALE 的任务、目标状态与检查程序,重新安排能力出现的顺序。EOG(EnterpriseOps-Gym)提供企业业务工具任务;ALE(Agents' Last Exam)提供软件工具环境中的复杂任务。每条序列有 3 至 6 个阶段,共 802 个不重复任务;同一任务可能在不同能力轴上出现,因此三条轴共有 1,510 个评测样例,不能说成 1,510 道独立新题。
3.1 三条轴的标注来源不同
| 演化轴 | 任务需要哪些能力 | 评测时 Agent 得到什么 |
|---|---|---|
| tools · 工具 | 继承上游工具需求标签(oracle tool labels);ALE 把所需软件归一成软件能力 | 截至当前阶段的完整累计目录,而非只给该题需要的能力 |
| skills · 操作指南 | EOG 从共享提示词提取流程,再匹配 SQL 检查中的表、字段和值;ALE 定义一小组可复用流程,用任务文字和所需软件做规则匹配 | 主文的指南使用实验提供可检索指南库,不直接写入提示词;EOG 移除原提示中的对应流程,ALE 不删除逐题内容 |
| agents · 专用 Agent | EOG 按业务实体分工具;ALE 按软件家族分组,每种能力只分给一个 owner | 没有直接工具的主 Agent,以及当前累计的专用 Agent 名单;各专用 Agent 只拥有自己的工具包和相关流程 |
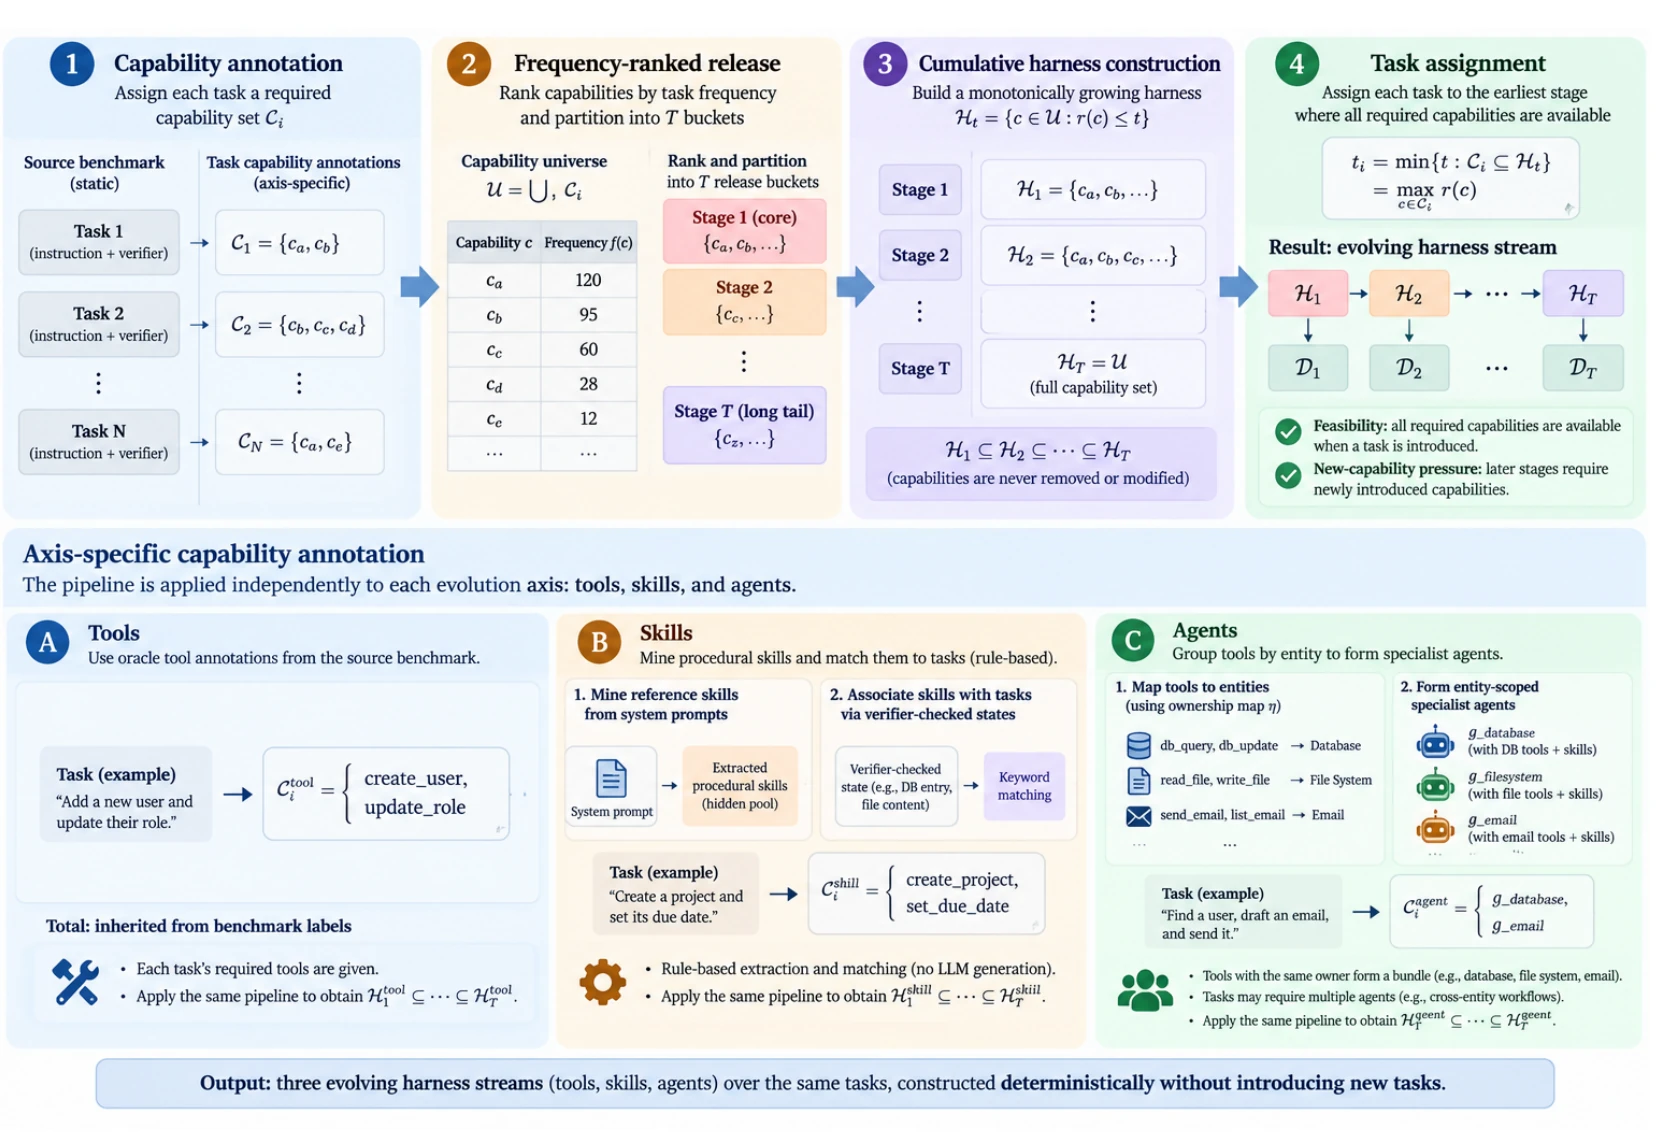
每项能力按它在任务中的出现频率分批释放,常用能力先出现,较少用的能力后出现。设任务要求的隐藏能力集合为 Cᵢ,能力 c 的首次出现阶段为 r(c),任务在 max r(c), c∈Cᵢ 进入:此时全部要求首次同时可用,且至少一项是本阶段刚加入的。任务本身、初始状态与检查程序之后不变,只有可选目录增大。每阶段还拆成适应题与不用于适应的评测题。
若一题的两项所需能力分别在阶段 1、2 出现,它便从阶段 2 开始测试。到了阶段 3,还是这道题,但目录里已有更多其他能力。这里的阶段编号是规则示意。skills 的关键词匹配也只是近似关联:论文明确说它不保证被匹配技能必需、充分或唯一。作者没有逐题增加人工技能标注或人工复核,不能把匹配结果当作因果真值。未匹配到任何指南的题会被排除;skill 轴覆盖符合条件上游题的 76.6%,因此三条轴的题集不完全一样。
另有一组 skill-learning 消融:系统从适应题轨迹和检查反馈中生成自己的指南,作者提取的 reference skills 只用于安排阶段和计算重合率,不直接交给系统。v3 Appendix C 的“隐藏 reference skills”描述与 §3.3 的“提供可检索指南库”没有把两种设置交代一致;本文分别说明主表的指南使用实验和 Appendix J.2 的指南生成实验,不把它们合成同一种输入条件。
3.2 一道题在各阶段怎样得到分数
一次评测给 Agent 公开任务与当前阶段的累计目录;任务要求的 Cᵢ 和检查目标不提供给 Agent。Agent 调工具、检索 skills 或委派专用 Agent,环境留下最终数据库、文件、邮件等状态。来源 benchmark 的 verifier(最终状态检查程序) 判定成功或失败。Pass 是成功任务数除以该批全部任务数;Score 则平均来源允许的部分分。前者是成功率,后者不一定是成功率。
deployment 模式每阶段新建系统,没有跨阶段经验,只测目录扩张本身。self-evolving adaptation 模式先用累计适应题更新记忆、提示词或代码,再测保留题;新模型实例仍使用这些持久内容。每道旧题在后续阶段重测,故结果构成一个矩阵:行是当前平台阶段,列是题目首次进入的阶段。只看最后一行的总平均,无法看出哪一批旧题退化。
BWT = Σᵢ<T nᵢ(Pₜ₌T,ᵢ − Pᵢ,ᵢ) / Σᵢ<T nᵢ
FWT = Σᵢ≥2 nᵢ(Pᵢ,ᵢ − Pᵢ,ᵢᵇᵉᶠᵒʳᵉ) / Σᵢ≥2 nᵢ
这正是 Appendix D 的公式,nᵢ 是第 i 批保留评测题数量。BWT 排除最终才加入、尚无后续可比较的最后一批;FWT 排除没有前一阶段经验的第一批。假设旧题两批分别有 10、20 题,首次成功率为 0.8、0.5,最终为 0.6、0.4,则 BWT=[10×(−0.2)+20×(−0.1)]/30=−0.1333,即降低 13.33 个百分点。这是本文示意计算,不是论文的实验读数。
论文主图和 Table 8 使用“relative BWT (%)”描述 −34.7% 等结果,而 Appendix D 上式写的是绝对成功率差,没有给出对应相对归一化的分母。本文保留主图的“相对变化”标记,不把 −34.7% 说成下降 34.7 个百分点,也不声称上述绝对公式能直接复算它。精确复算主图仍需要评测实现或各阶段原始矩阵。最终累计 ACC 则按所有批次的题数平均,成本另外报告 token、工具调用与时间。
3.3 真实任务:补上产品,关联用过的知识文章
公开 CSM 工具任务 task_20251208_035402_755_ad5a67e3_8ca9a646 来自 EOG 作者构造的企业业务环境,是合成 benchmark 任务,不是实际客户工单。用户说:Thomas Bailey 在 Initech 使用 Docker Enterprise Variant 15 时遇到了问题,之前创建的电话工单漏填产品;自己已经参考并使用过操作指南,问题仍未解决,请补上产品并关联那篇指南。
任务指定初始数据库 db_1762254390925_u5icw4thh.sql。上游公开 seed 中,Thomas Bailey 的 user_id=63,对应 contact_id=5、Initech 的 account_id=5;工单 case_id=101 的渠道为 phone、状态为 new、product_id=NULL。目标产品 ID 为 35,知识文章 ID 为 54,标题包含该产品名,状态为 published;初始没有与工单 101 的关联。另有同一客户的电话工单 108,但它已解决且属于另一产品,所以按客户名取第一条记录会选错。
执行用户是 Thomas Green(user_id=1),不是客户 Thomas Bailey。Agent 得到任务、业务政策和当前工具目录,要通过 list_users、find_contact_by_portal_user、find_account、search_cases、find_product、retrieve_knowledge 查出这些关系,再用 update_case 与 link_case_knowledge 修改状态。公开工具轴阶段 1 为它标记 8 个相关工具,但实际提供 25 个累计工具。下面的 SQL 是评测端检查代码,不是授予 Agent 的数据库直写工具。

任务有两条 database_state 检查,各自要求 COUNT(*) == 1。第一条把工单、客户、公司和产品连接起来,要求姓名、Initech、目标产品、phone 和 in_progress 同时匹配。第二条还要求知识文章与同一工单关联,产品相同、标题含产品名,并且 used_as='applied'。后者表示“用过指南但问题还没解决”;写成 resolution 会失败。任务的第二条自然语言描述误写了“as a resolution”,实际 SQL 检查的是 applied,本文以执行条件解释判分。
第二条 SQL 来自公开任务的 validation_config.query。下面保留全部条件,只整理了换行;默认折叠,便于先读判分逻辑。
展开实际 SQL:工单与知识关联的第二条检查
SELECT COUNT(*) AS cnt
FROM case_knowledge ck
JOIN knowledge k ON k.knowledge_id = ck.knowledge_id
JOIN product p ON p.product_id = k.product_id
JOIN customer_case c ON c.case_id = ck.case_id
JOIN contact ct ON ct.contact_id = c.contact_id
JOIN account a ON a.account_id = ct.account_id
JOIN "user" u ON u.user_id = ct.portal_user_id
WHERE u.first_name = 'Thomas'
  AND u.last_name  = 'Bailey'
  AND a.name       = 'Initech'
  AND c.channel    = 'phone'
  AND c.state      = 'in_progress'
  AND c.product_id = p.product_id
  AND p.name       = 'Docker Enterprise Variant 15'
  AND ck.used_as   = 'applied'
  AND k.title LIKE '%Docker Enterprise Variant 15%';
EOG 的 VerifierEngine 在 Agent 执行后通过评测端 /api/sql-runner 查询当前数据库,从单行单列结果取出数值,再按 equals 比较。这里没有让语言模型判断“回答看起来对不对”。两条检查都过才算任务成功;只过第一条为部分完成。若产品改成 35、状态改成 in_progress,但知识关联写成 resolution,则两条检查分别返回 1、0;若状态仍为 new,两条都返回 0。这些是基于公开条件的推导,本文没有运行 hosted 环境。
两条 SQL 都以业务属性查找,没有直接锁死 case_id=101,也没有覆盖政策中的每条权限、有效期和时间戳规则。通过它们只证明这些最终状态谓词成立,不能证明全过程合规。当前项目的逐题汇总中,该题在工具阶段 1 的 task-specific ReAct/Codex 为 2/3 次成功;GEPA 与 Meta-Harness 各为 0/3,后两者的调用集合都缺 list_users。汇总能说明某些工具是否出现,不能证明漏调用就是唯一失败原因,原始有序调用和每次最终数据库仍未给出。
4. Experiments:三种能力扩张分别影响什么
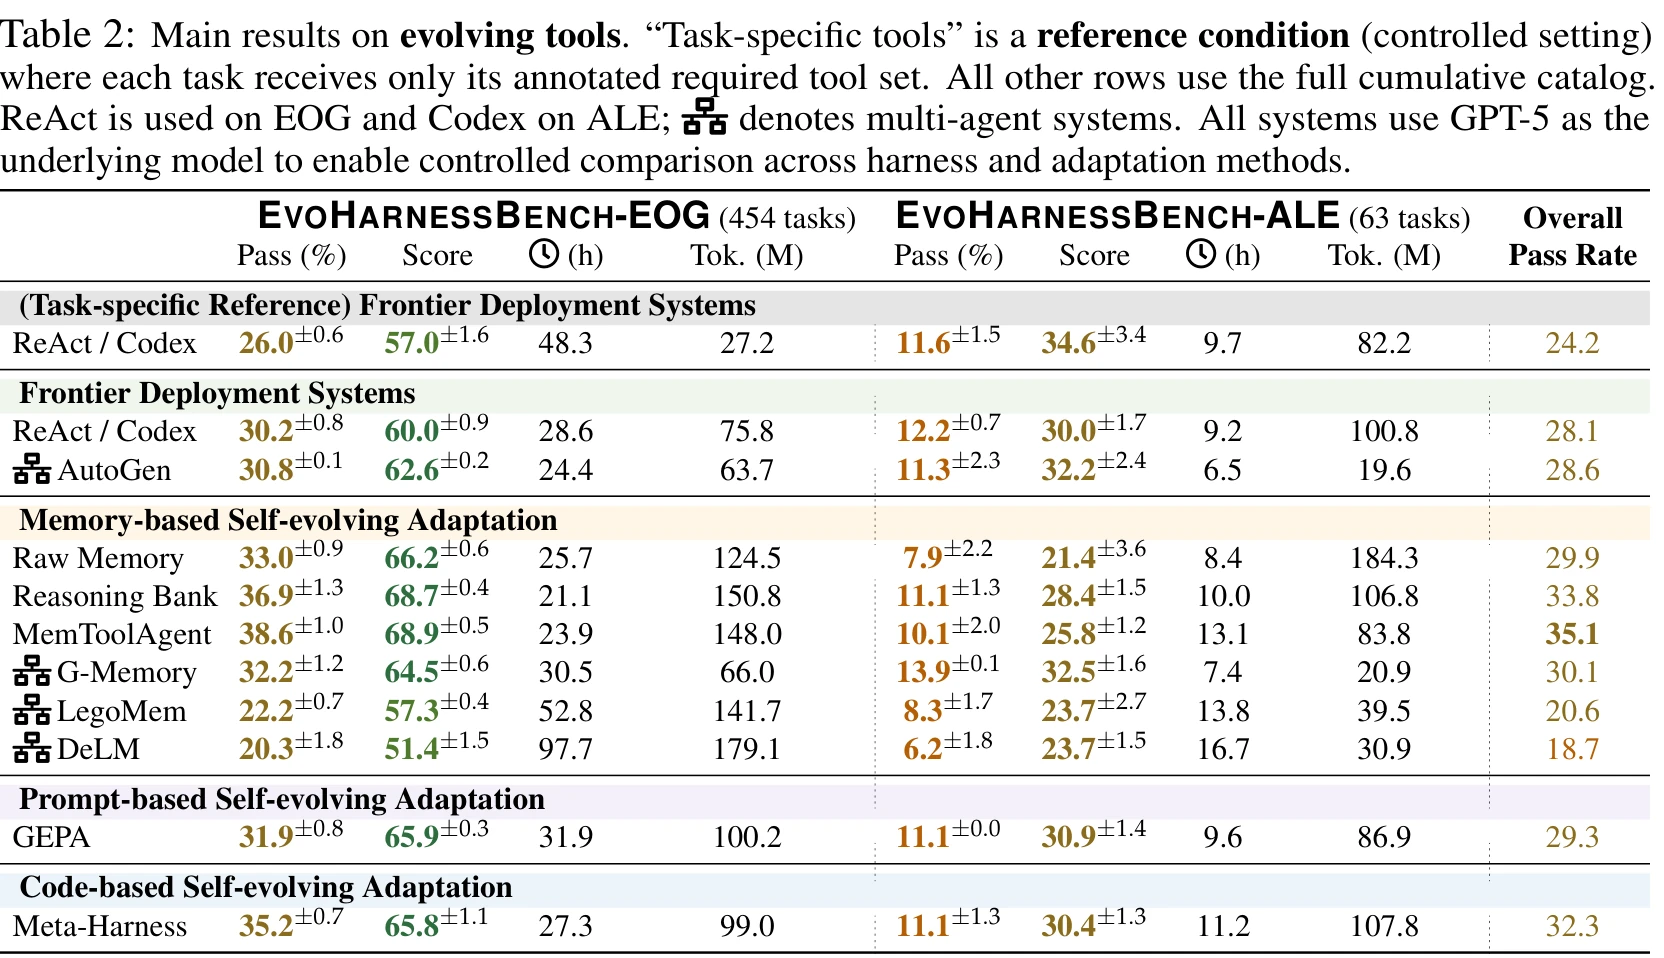
工具需要选对,skills 需要实际调用,多 Agent 需要完整委派并传递结果。tools 轴的累计目录有时提高成功率,也显著增加 token 与工具调用。EOG 上 MemToolAgent 为 38.6%、ReasoningBank 为 36.9%、Meta-Harness 为 35.2%,不适应的 deployment 为 30.2%;ALE 上多数适应方法接近或低于不保留状态的基线。这些值是对应设置的任务成功率,不能和相对 BWT 混用。
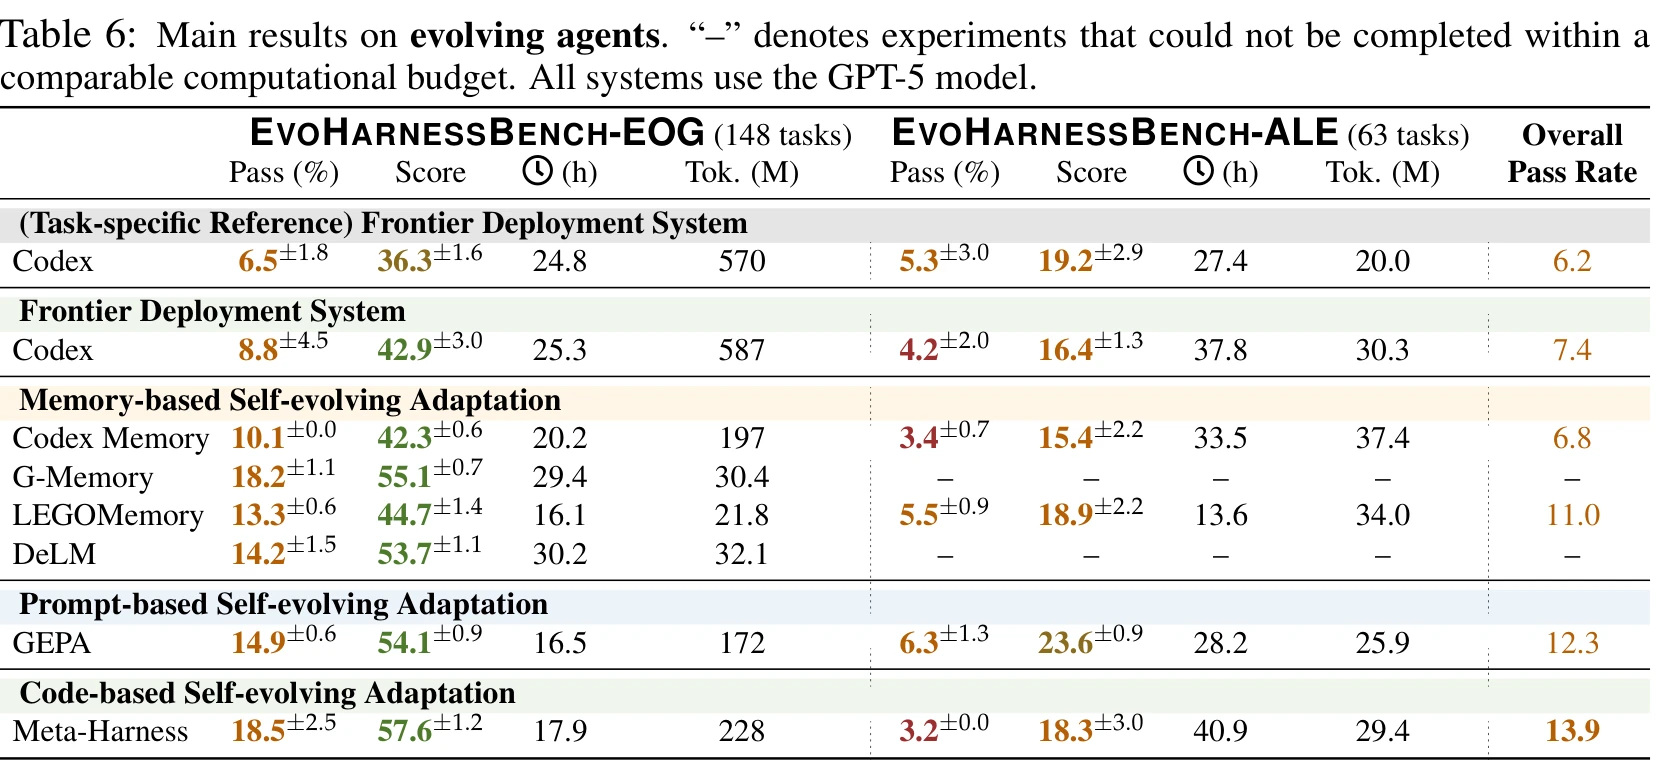
skills 轴的目录扩张本身影响较小。GEPA 在 EOG 从 18.9% 提到 24.1%,但默认 GPT-5 Agent 几乎不检索提供的 skills,说明操作指南存在不等于模型用了它。agents 轴上,Meta-Harness 在 EOG 从 8.8% 提到 18.5%,ALE 多数方法没有改善。
| 设置 | Tools EOG / ALE | Skills EOG / ALE | Agents EOG / ALE |
|---|---|---|---|
| 只给逐题所需能力的参照 | 26.0 / 11.6 | 18.9 / 7.4 | 6.5 / 5.3 |
| 累计目录,不保留经验 | 30.2 / 12.2 | 18.9 / 8.3 | 8.8 / 4.2 |
| MemToolAgent | 38.6 / 10.1 | 19.6 / 6.9 | 未列入主表 |
| GEPA | 31.9 / 11.1 | 24.1 / 7.4 | 14.9 / 6.3 |
| Meta-Harness | 35.2 / 11.1 | 19.4 / 7.8 | 18.5 / 3.2 |
上表为 v3 Tables 2、4、6 的任务成功率(%),主表控制底层模型为 GPT-5;主表的 ± 项虽已报告,正文没有完整交代统一的重复次数和统计定义,因此这里不把它擅自称为标准误或显著性。主表的题数标题也与 Appendix C 的全构造题数不同,例如 agents 主表 ALE 写 63 题,构造统计是 104 个保留测试任务;不能把两个分母直接互换。未在可比预算内完成的 G-Memory、DeLM ALE 实验标为缺失,不按 0 分算。
展开 Table 2、Table 6 原表与 Claude Code 对照
下列原表保留模型、部分分、时间、token 和未完成实验的标记。点击图片可放大;移动端可在图片详情中横向查看。
Claude Code 的结果应在它自己的两种目录之间比较。它使用 Sonnet 4.6 和原生 harness,不能用绝对分数声称比受控 GPT-5 系统更强。Appendix H 中,skills 的 EOG 成功率为 29.3%→30.2%、ALE 为 13.2%→13.2%;agents 为 EOG 11.0%→10.6%、ALE 16.9%→15.3%。这是另一套系统的内部对照。
4.1 哪些消融区分了“目录太大”和“适应方式不合适”
评测始终用完整累计目录,只在适应阶段改可见范围。MemToolAgent 在 EOG tools 中,把适应阶段缩为逐题工具,成功率 38.6%→39.1%,适应时间 23.9→17.9 小时;从一开始就给最终完整目录则为 37.9%、28.6 小时。GEPA 的 skills 消融却是成功率 24.1%→23.0%,同时部分分 61.0→63.1、时间 4.1→2.9 小时:效率和部分分提高,不等于严格成功率提高。Meta-Harness 的 agents 消融中,逐题目录为 19.4%,从开头保持最终完整目录为 20.3%,都高于逐阶段扩大目录的 18.5%。对这一轴,目录变化本身比单纯“候选多”更值得关注。
展开记忆内容与 skill 调用的次要消融
记忆的收益同样依赖它用在哪里。EOG tools 中,Reasoning Bank 的概要记忆为 36.9%,加上显式工具信息反而降到 30.3%;保留成功轨迹和只保留失败轨迹都为 34.4%。而指南学习实验中,直接一次生成指南为 11.5%,低于空指南的 16.9%;从真实执行轨迹生成为 20.0%,批量教师反馈为 22.1%。这些对照支持“经验怎样提取、怎样使用会影响成绩”,不支持“记得越多就越好”。Table J.1 的工具导向 MemToolAgent 甚至降到 4.4%,但这是额外消融,不是上表主设置的 19.6%。
Figure J.1 的调用比例也要看分母:GPT-5.5 的 task-specific Codex 打开约 82% 的逐题指南;task-specific GEPA 在完整阶段库中打开约 31%,两者库的范围不同。Claude Code 的 15% 按文件读取次数计,未记录完整 skill 名称,不能把这三个百分比当成同口径的检索召回率。
Figure 7 把“找对了谁”和“有没有找齐”分开:已调用专用 Agent 中约 90% 是相关的,论文称为 selection precision;必需专用 Agent 被调用的比例从不适应的 79% 最高升到 89%,称为 recall。在后来仍成功的旧题中,约 13% 改变了委派对象;后来失败的旧题中约 25% 改变了委派对象。论文发现更多情况是漏掉原本必要的 Agent,而非一味加入无关的新 Agent。即使找齐,整体成功率仍低,故结果传递与协调也不能省略。
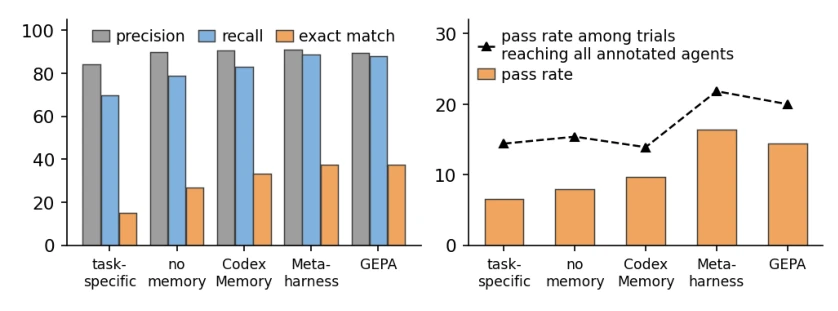
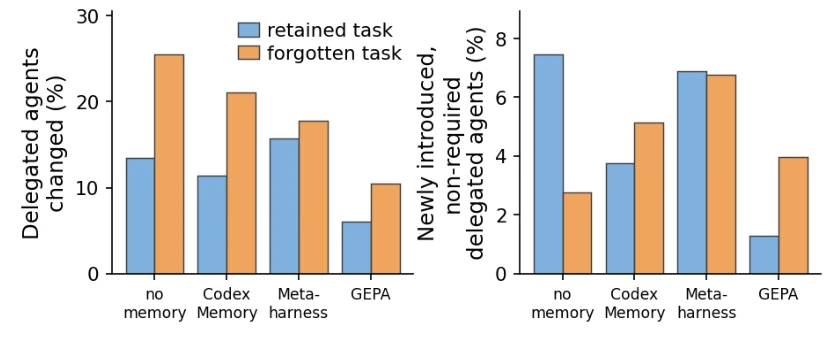
Appendix K.1 给了更直接的结果:即使所有必需专用 Agent 都叫到了,仍有 78% 至 86% 的执行失败。GEPA 适应后,新加入的必需 Agent 调用率由约 71%→81%;Meta-Harness 在适应前已约 81%,适应后几乎不变。因此两者成绩提高的路径不同,不能都归因于“更会找新 Agent”。
为什么旧题保持和新题适应必须分开报告
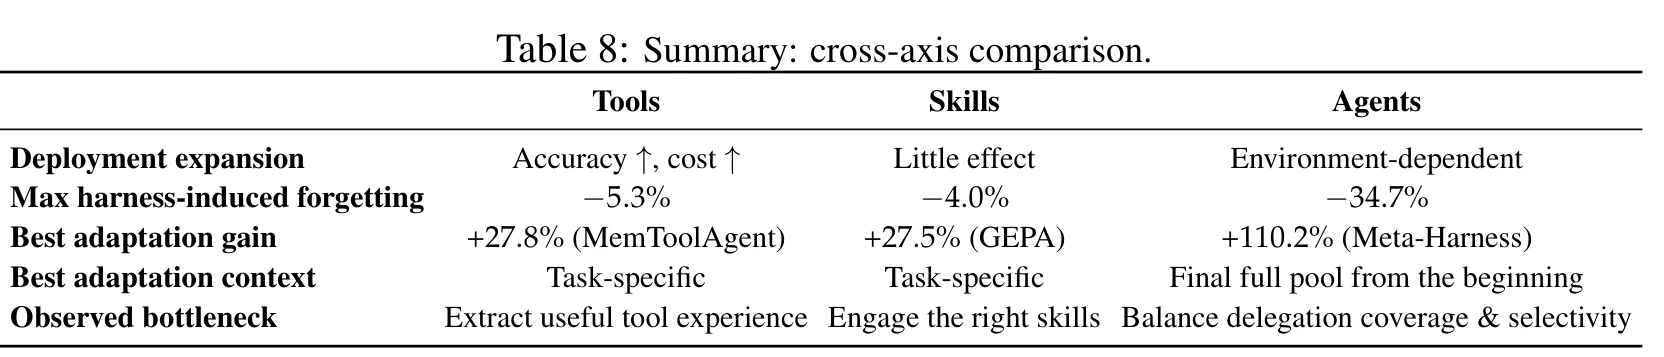
三条轴最差的相对 BWT 分别是 tools −5.3%、skills −4.0%、agents −34.7%;最好的相对适应增益分别达到 +27.8%、+27.5%、+110.2%。这些极值来自不同方法和设置,不能拼成同一个“最好系统”。它们说明一种常见情况:系统可以少忘旧题,却在适应新阶段后把新题做得更差;也可以快速学会新能力,同时严重破坏旧题中选择工具或 Agent 的策略。
v3 自身还有数值冲突:Figure 1 caption 仍写三个轴下降 12.1%、13.8%、46.4%,后面的轴内结果和 Table 8 则总结为 −5.3%、−4.0%、−34.7%。本文采用有对应轴内分析的后者,同时保留这一不一致;未经原始矩阵核查,不能宣称前者只是排版笔误。
5. Discussion:对长期部署评测的启发
新系统应同时测原题保持、新题适应与额外成本。先固定原题、工具接口与检查程序,仅逐阶段加目录;再分别比较完全不保存经验和更新记忆、提示词、代码的系统。记录每批旧题的成绩、必需能力是否调用齐、成本是否增长,可以区分目录干扰与适应策略写坏了系统。操作指南与任务的关联仍是规则近似,低匹配率不能直接解释成缺技能。
截至 2026-10-14,项目已提供任务与逐题结果汇总,三个 HF 数据集分别发布工具、指南和 Agent 任务;EOG 也公开了 seed 数据库与数据库检查代码。它们足够解释上面的真实任务。当前 release 的 1,061 个 gallery 任务、3,395 个任务×阶段记录和 17,992 条系统尝试汇总使用不同计数单位,不等同于 v3 的原实验题集。完整复现仍缺原始逐阶段矩阵、相对指标实现、EvoHarness runner 固定版本,以及每次有序调用和最终状态。
6. Conclusion:结论与尚缺的证据
能力目录增长本身就可能破坏已有表现,持续适应也不保证新旧题同时变好。论文把三种扩张拆开,并用重复测试旧题暴露这种问题,适合作为动态部署压力测试。当前边界是平台只加不删、不改接口;现实里的 API 改版、工具撤回与权限变化没有覆盖。skills 的近似关联、原文中部分输入设置与数值的不一致,以及未交代的相对指标归一化,都需要在引用结论时保留。
其余 29 项原论文图表:按 PDF 页码直达
正文选用 Figure 1、Figure E.1、Figure 7、Figure 8、Tables 2、6、8;其余图表在原论文保留完整版本,下面按 v3 PDF 页码索引。
主文图:Figure 2 · 真实与模拟的目录增长;Figure 3 · tools 轴 FWT/BWT;Figure 4 · skills 轴 FWT/BWT、Figure 5 · 指南实际调用;Figure 6 · agents 轴 FWT/BWT。
附录图:Figure D.1 · 逐阶段分数矩阵;Figure I.1 · 相对 BWT、Figure I.2 · Agent 记忆消融;Figure J.1 · 指南调用、Figure J.2 · 指南重叠与得分、Figure J.3 · 指南重叠轨迹;Figure K.1 · Agent 调用、Figure K.2 · 新 Agent 采用;Figure K.3 · 选择质量、Figure K.4 · 路由变化。
主文表:Table 1 · 相邻工作;Table 3 · 工具适应目录、Table 4 · skills 主结果;Table 5 · 指南适应目录;Table 7 · Agent 适应目录。
附录表:Table C.1 · 工具阶段统计、Table C.2 · skills 阶段统计、Table C.3 · Agent 阶段统计、Table C.4 · 独立演化序列;Table H.1 · Claude Code 对照、Table I.1 · 工具记忆、Table I.2 · 记忆内容;Table J.1 · 工具经验用于指南、Table J.2 · 指南生成。
主要来源:arXiv v3 全文与附录;公开 HF 工具任务 revision 6c2c2d9af15b12b678940ad4e23f976cdb85b150,skills revision 1ba40009f2b23cd4490ca6eaac6fb6697fe32c62,agents revision aa6f72430745d05e1082aedb06926d18e84c2b72;EOG revision 271f2c357f763376997dfd16807fcde2474ae41b 的 gym_dbs.zip 与 benchmark/verifier.py。读取了任务、seed、SQL 和逐题汇总,未运行 hosted 环境。BWT 算例与案例失败结果为规则推导。
留言