Evo-Bench 把九个模型放到同一项长任务里:在 48 小时内修改一套组织模型、工具和执行步骤的代码,最多请求 20 次正式评测、进行 1,000 个开发操作。所有候选都驱动同一个 DeepSeek-V4-Flash 做题,便于比较谁更会改系统。作者保存了每次版本与成绩,能看到开发模型找到好版本后又把它改坏、忘记回滚或反复评测同一代码。
1. Motivation:为什么要同时观察最终代码与开发过程
开发模型既要找到有效修改,也要把有效版本留到最终提交。它需要判断失败是缺工具、提示词不合适、代码异常还是任务本身太难,然后修改、重测、决定保留哪个版本。只看最终代码无法区分从未找到改进和找到后又丢失改进;只看最高开发分又会掩盖没有提交好版本的问题。Evo-Bench 因而同时保存整个开发过程和最终隐藏测试成绩。
2. Related Work:与短程优化和从零开发的差别
Evo-Bench 固定执行模型,主要比较开发模型改进系统的能力。HarnessOpt-Bench 更强调控制开发者能看到哪些任务与反馈,并比较不同开发 harness;HarnessDev 还要求从弱初始系统建立完整系统、检查换执行模型后的效果。Evo-Bench 给更长的开发时间,混合搜索、办公和通用工具任务,重点分析每个版本怎样变化。它并不训练模型参数,所谓 evolution 是改执行代码和配置。
3. Benchmark / Protocol:任务筛选、开发边界与候选评测
作者先用一组已有 harness 找出“分数会随 harness 质量变化”的题,再把这些题分成搜索时可见的 validation 和最终 evaluation。这样能提高 benchmark 对 harness 修改的敏感度,也会让任务分布偏向这 12 个辅助 harness 擅长区分的问题。
3.1 任务怎样筛出来
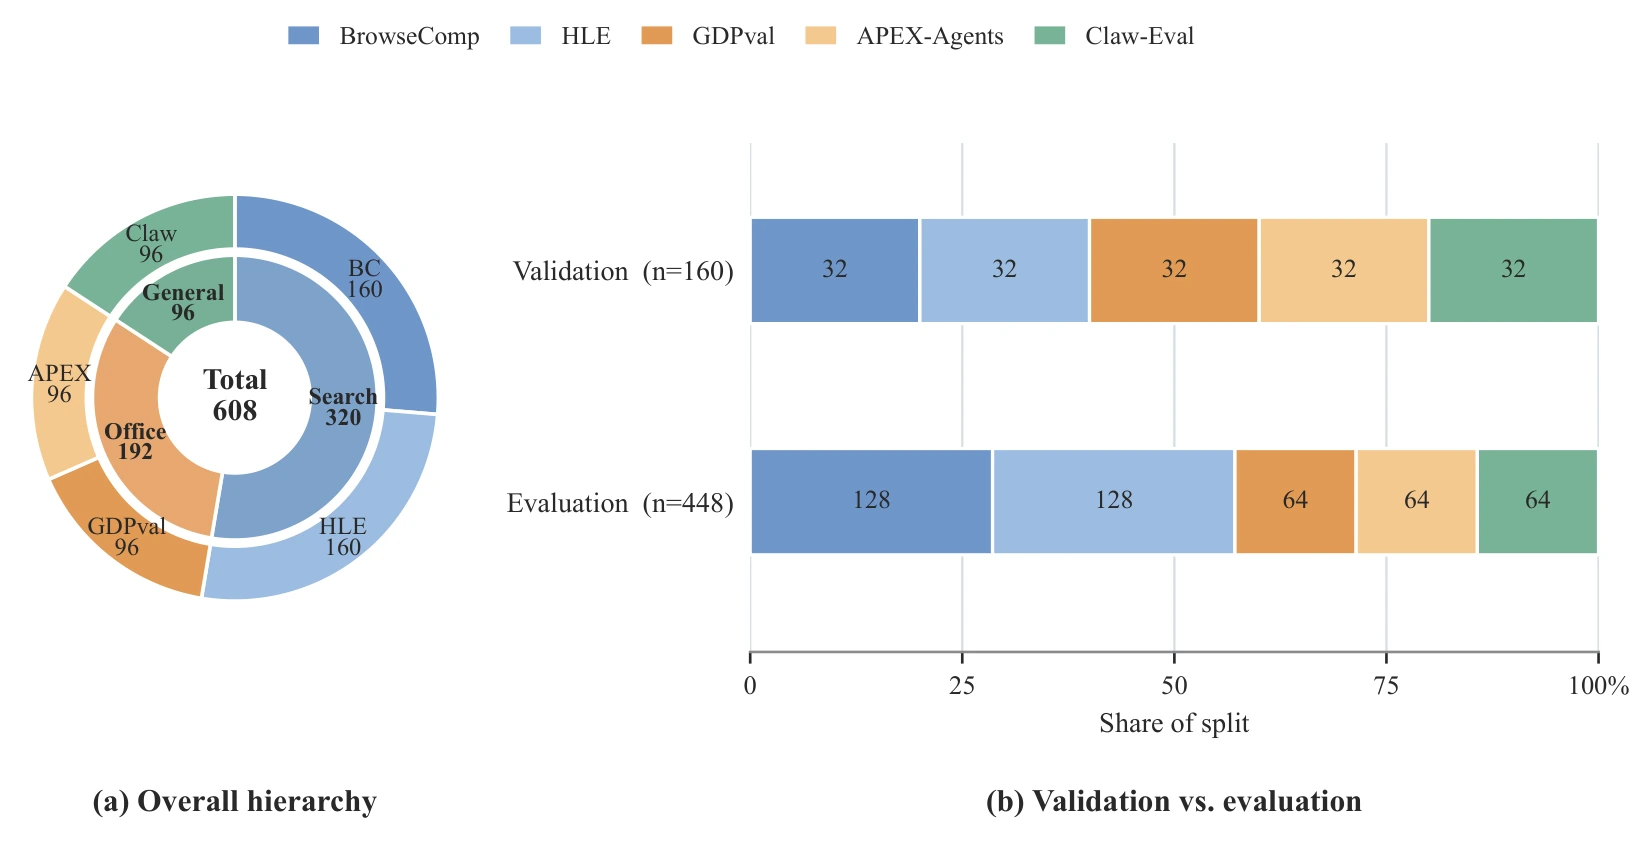
作者先从 11,322 个辅助候选中挑出 320 题,与正式五个来源数据集在语料和实例层面不重合。辅助 Search 来自 MiroRL、RedSearcher 和内部数据,Office 来自匿名企业流程,General 来自 Auto-ClawEval。作者用各领域已有系统运行它们,按分数分六层,优先选低分、长轨迹任务,再分配 128/128/64 题。这里筛的是辅助任务,尚未筛正式 benchmark。
四个开发模型在辅助集上产生 73 个正式评估过的 harness,内容哈希去重后剩 65 个。每条演化轨迹选三个代表,保留最终版本并覆盖不同能力层级,共 12 个;不是随意取最高分的十二份代码。随后让这 12 个 harness 在 APEX-Agents、BrowseComp、Claw-Eval、GDPval 和 HLE 的 2,329 个正式候选任务上运行。作者排除多模态题,减少接口差异;BrowseComp 与 HLE 又经过抽样以控制构造成本(Appendix B)。
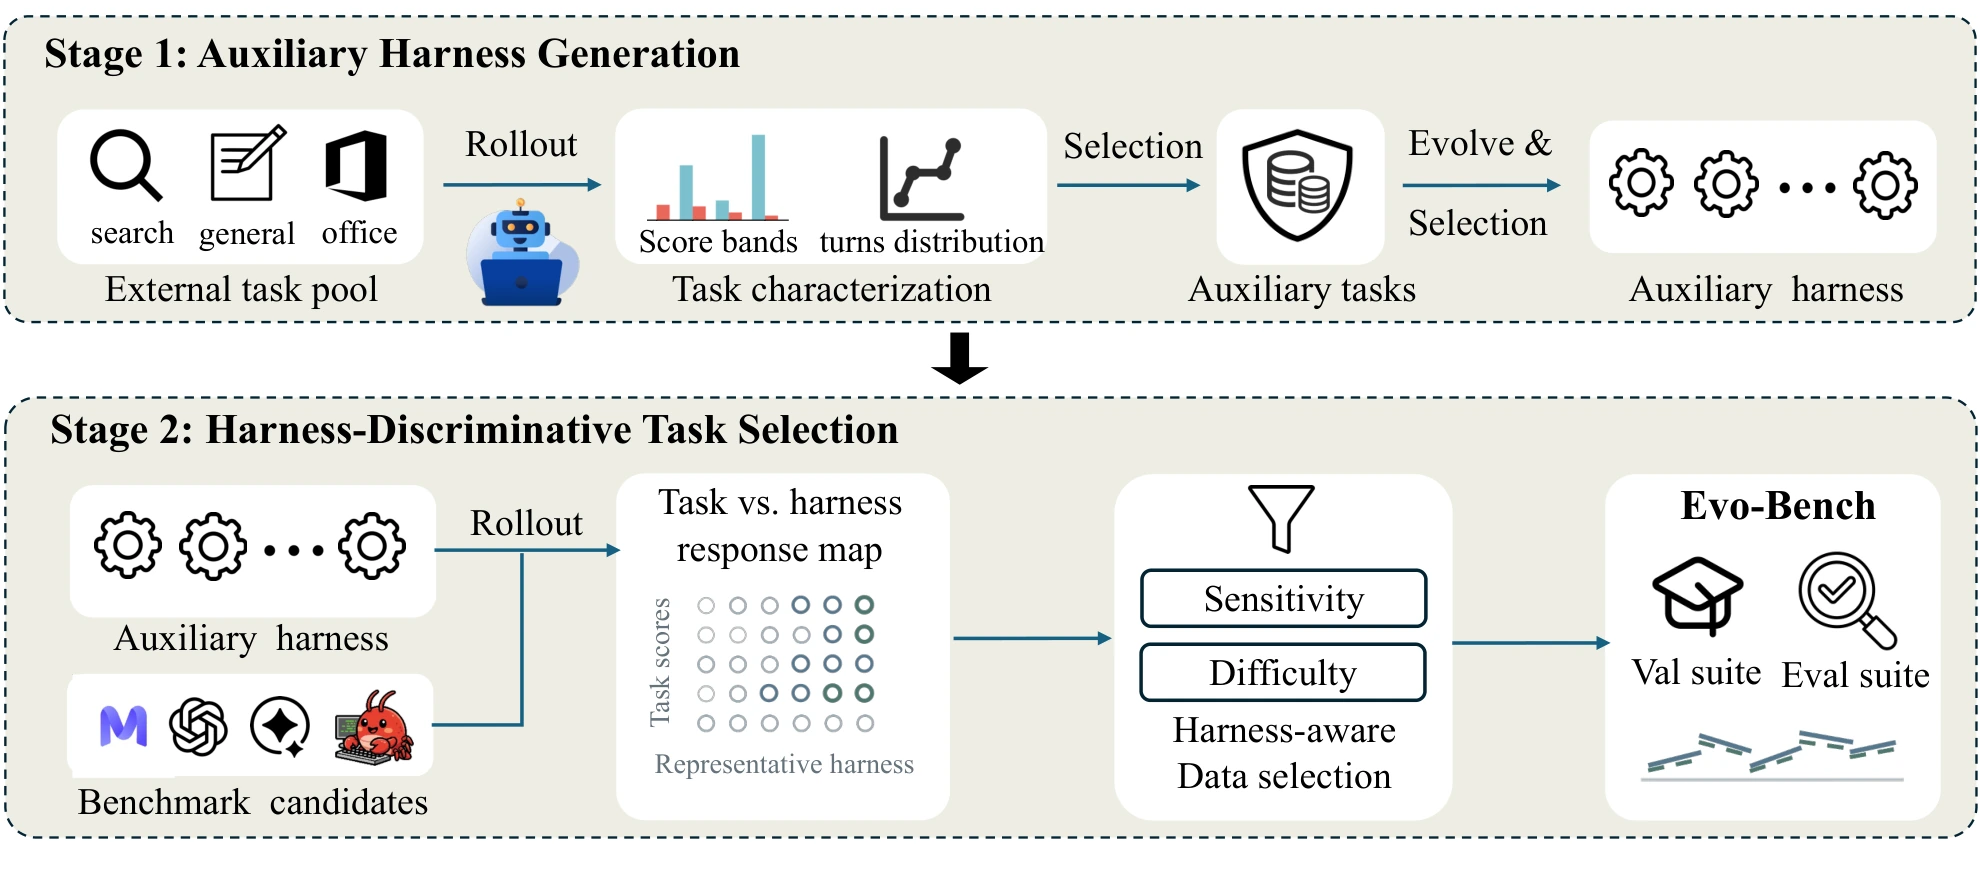
mₕ(x) 是 harness h 在任务 x 上的分数;Qₕ⁽⁻ˣ⁾ 是同一 harness 在其余任务上的平均质量。若强 harness 通常在这道题上也更高分,Sens(x) 就大。作者主要排除 Sens≤0 的题,再按难度分层抽取 160 个开发验证题和 448 个最终评测题;Appendix A.3 明确说明有 8 个略负的 Claw-Eval 题为补足稀疏难度层而保留,不能把排除规则说成无例外。
两套题目没有实例重叠。五个来源各贡献 32 道开发题,共 160 道;最终测试是 BrowseComp 128、HLE 128、GDPval 64、APEX-Agents 64、Claw-Eval 64,共 448 道。题目和标准答案、办公 rubric 或工具检查规则继承上游,Evo-Bench 作者做筛选、转换与执行隔离。论文没有给出一套新人工标注的逐题一致率,不能把筛选过程当成重新验证所有来源 judge。
3.2 evolver 能看什么,policy rollout 又看不到什么
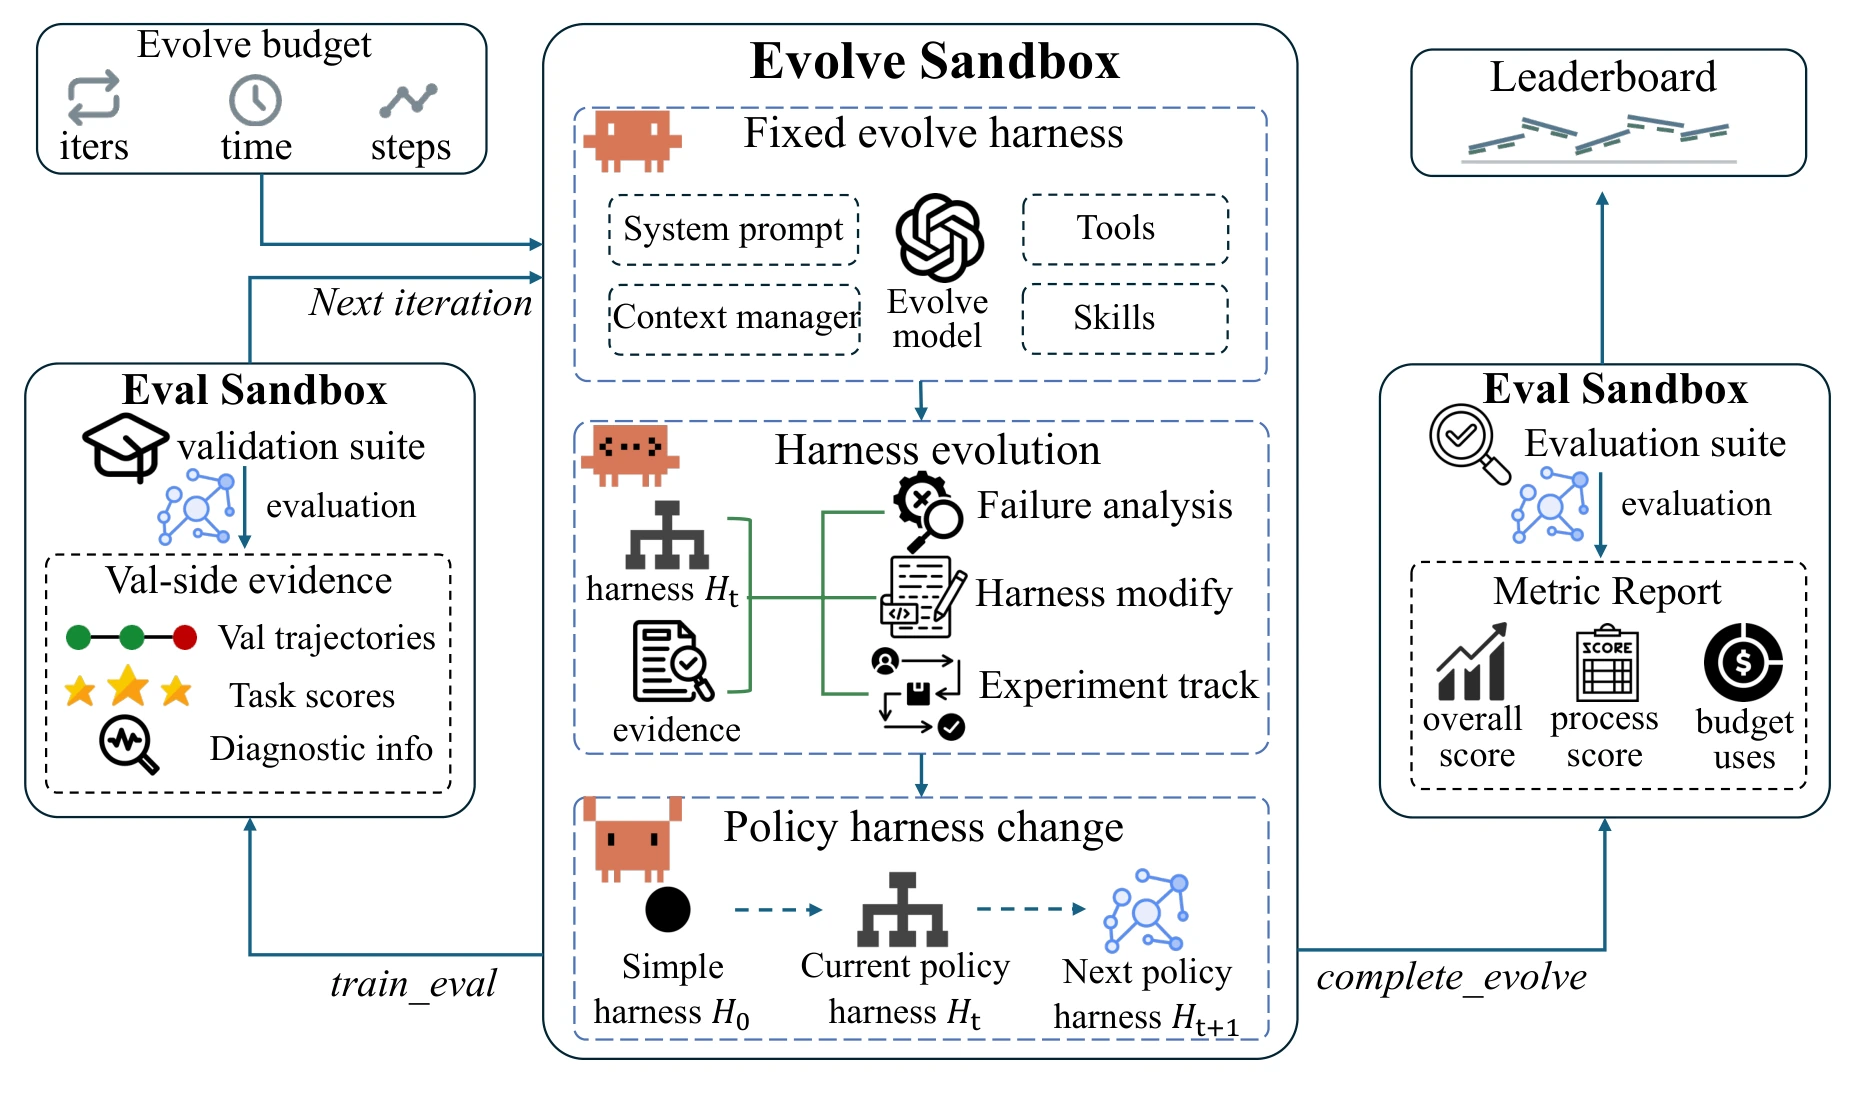
开发者可以读开发题、答案、评分反馈和运行记录;执行题目的模型不能读这些隐藏评分资料。执行模型只得到不可修改的候选代码快照、公开任务说明和独立工作区,答案、scorer、开发者笔记和最终测试集都不挂载进去。修改代码把标准答案偷偷转交给执行模型仍属违规,隔离工作区本身并不会自动阻止这种代码泄漏。
一轮开发先查看失败运行,再修改候选。run_train_eval 固定当前代码快照、扣一次正式评测额度,并异步测试开发集;同一时间最多一项正式评测在运行。开发者可通过 await_eval 取总分、各领域分、失败原因和与历史版本的差异,再决定保留或恢复哪个版本。起点 CodeAct 只有 shell 与最终回答工具,搜索、记忆、计划与检查功能都需要开发者自己加。开发操作上限 1,000 次,单道执行任务则最多 300 步或 1 小时;两个“步数”不是同一预算。
3.3 一分怎样产生
Search 和 Office 每题运行一次。搜索答案由 judge 对照标准答案;办公产物由来源 rubric 检查。APEX 只有全部 rubric 条目通过才算该题成功,GDPval 还保留连续得分,不能把两种分数都称为成功率。Claw-Eval 每题运行三次,Pass^3 要求三次都通过,不是三次中成功一次。需要模型判分的题统一使用 temperature 0 的 Qwen3.7-Plus。
AnytimeVal = (1/20) Σₜ₌₁²⁰ maxᵢ≤ₜ ValidationScoreᵢ
官方 evobench/evaluation/metrics.py 把三个领域的权重定为 2、2、1,不是等权平均。复算 Table 2 的 GPT-5.6 Sol:(2×44.5+2×41.6+59.4)/5=46.32,四舍五入为 46.3;CodeAct 为 29.72,即 29.7。AnytimeVal 先在每轮取截至该轮的最好开发分,再平均 20 轮;提前结束时,后续轮延用已找到的最好分。它衡量多久找到好版本,不是最后提交版本的分数,也不是隐藏测试分数。
Office 内部还先按 APEX 与 GDPval 两个来源等权混合。APEX 使用严格任务通过率;GDPval 使用逐项 rubric 的连续得分。代码另存相对初始程序的 Gain:普通分数提高时除以初始分剩余空间,下降时除以初始分;GDPval 则让 judge 按每条标准比较候选与初始产物,A/B 两种顺序都评,再得到 −1 到 1 的相对得分。这与 Overall 用的绝对 rubric 分是两条轴,不能把相对分重新映射成“正确率”。
3.4 真实办公题:成本增加后还能达到 20% IRR 吗
官方开发集公开了 apex-2299b89dcaf64a4da4f3d03f8aac7215,来源是 APEX Investment Banking World 224。题目要求在 Elastic NV LBO 表格中,把订阅与服务成本占各自收入的比例都提高 1 个百分点,并保持后续预测年份不变;新增工作表,列出第五年退出时的净债务、投资者股权价值和 IRR。金额按百万美元、百分比按两位小数输出。这里的 IRR 是投资现金流的内部收益率,题目希望判断其是否达到 20%。
执行模型可读取任务及对应办公环境、编辑表格;rubric 与 reference 只给评分侧。公开 rubric 的三个目标值是 717.44M、26,068.66M、18.25%。正确结果说明未达到 20%。评测在办公环境内生成 grades.json,主仓库 _apex_grader 读取其完成状态与 final_score:全部三项通过才记 passed=True。只答对净债务和股权价值、仍写 IRR 为 20%,即使诊断得分达到 2/3,该题仍不算成功;这个失败例是根据公开规则推导,不是观察到的模型日志。
这条题目、rubric、参考值与汇总代码都能直接检查。上游办公环境负责表格初始内容与逐条检查,本文没有重跑该 world,也没有一份公开的模型动作与实际 grades.json 配对记录。因此它说明真实任务如何判分,不冒充复现实验。固定仓库的套题说明还残留“9-anchor”等旧构造文字;本文的 12 个辅助 harness 来自 v2 论文,两个版本不应悄悄混用。
如果 grades.json 缺失、无法读取、状态不是 completed 或没有 final_score,公开 scorer 返回零分并记录 apex_grader_error。其他 judge 或运行基础设施故障也留在分母内。它们降低成绩,但不是模型行为失败的证据;代码用单独的异常类别统计,论文 Appendix E.3 也要求显式报告评分失败。
4. Experiments:最终得分与开发失误
GPT-5.6 Sol 把最后提交的 Overall 从 CodeAct 的 29.7 提到 46.3,Claude Opus 4.8 得 45.8;两者仍低于人工组合 harness 的 47.5。提升主要来自 Search。Office 的起点已经是 38.4,多数模型只增加 0–3.3 分;General 的最好结果 59.4 则超过人工组合的 56.3。每个 evolver 只运行一次,榜单没有搜索方差。
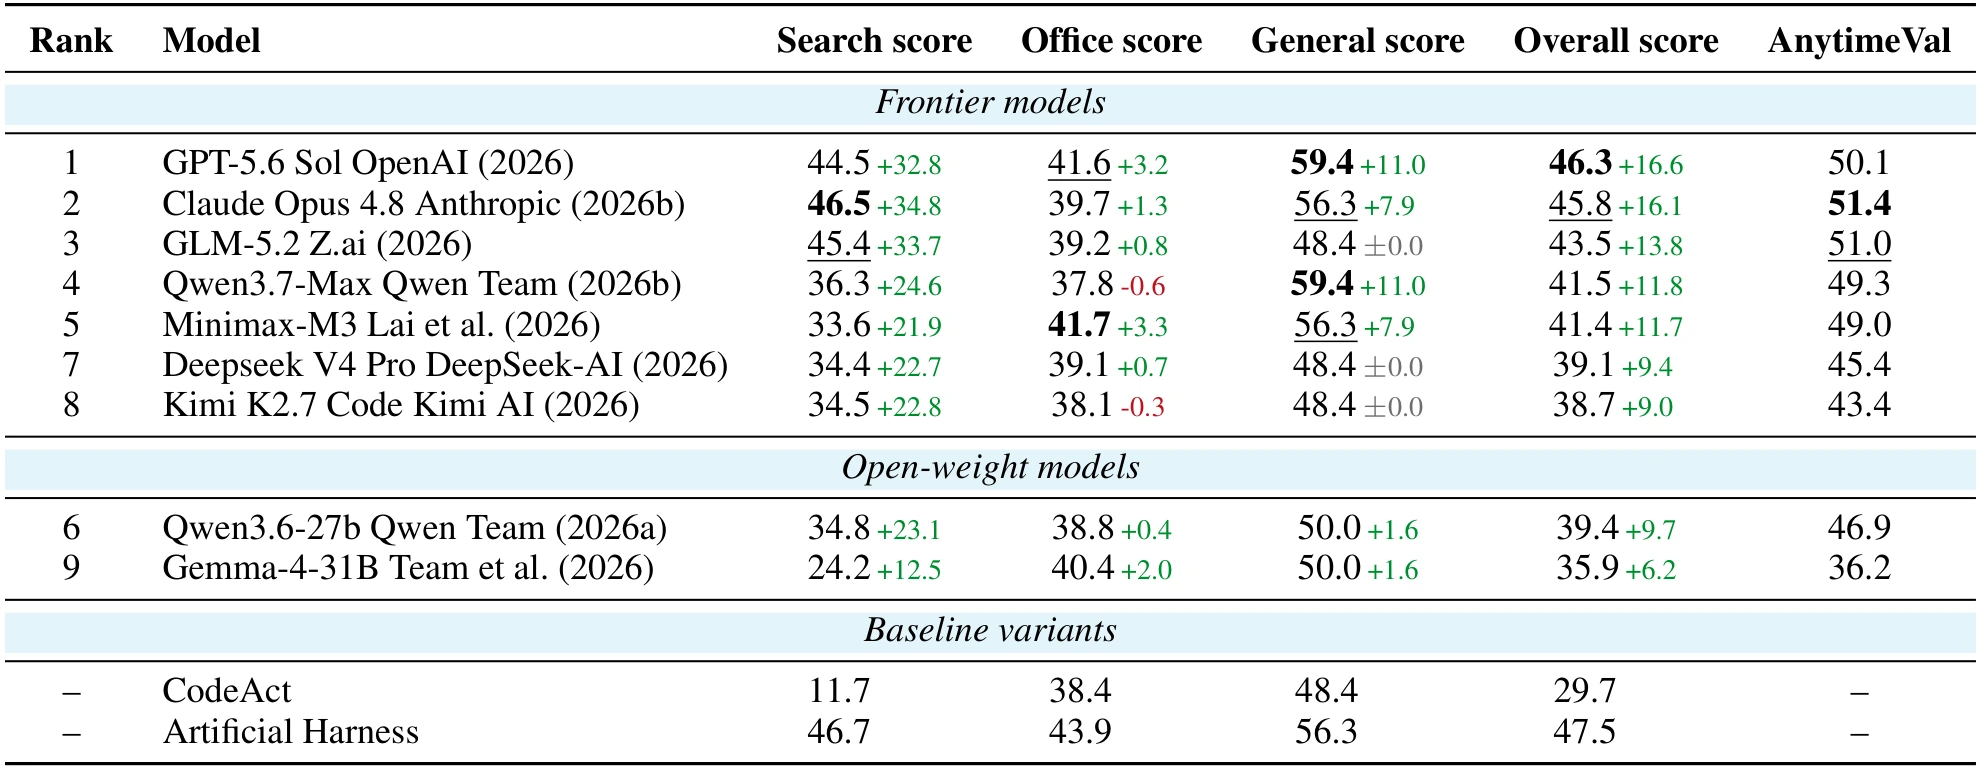
展开主表的可复制文字版
| 开发模型 | Search | Office | General | Overall | AnytimeVal |
|---|---|---|---|---|---|
| CodeAct 起点 | 11.7 | 38.4 | 48.4 | 29.7 | 不适用 |
| 人工领域组合 | 46.7 | 43.9 | 56.3 | 47.5 | 不适用 |
| GPT-5.6 Sol | 44.5 | 41.6 | 59.4 | 46.3 | 50.1 |
| Claude Opus 4.8 | 46.5 | 39.7 | 56.3 | 45.8 | 51.4 |
| GLM-5.2 | 45.4 | 39.2 | 48.4 | 43.5 | 51.0 |
| Qwen3.7-Max | 36.3 | 37.8 | 59.4 | 41.5 | 49.3 |
| MiniMax M3 | 33.6 | 41.7 | 56.3 | 41.4 | 49.0 |
| Qwen3.6-27B | 34.8 | 38.8 | 50.0 | 39.4 | 46.9 |
| DeepSeek V4 Pro | 34.4 | 39.1 | 48.4 | 39.1 | 45.4 |
| Kimi K2.7 Code | 34.5 | 38.1 | 48.4 | 38.7 | 43.4 |
| Gemma 4 31B | 24.2 | 40.4 | 50.0 | 35.9 | 36.2 |
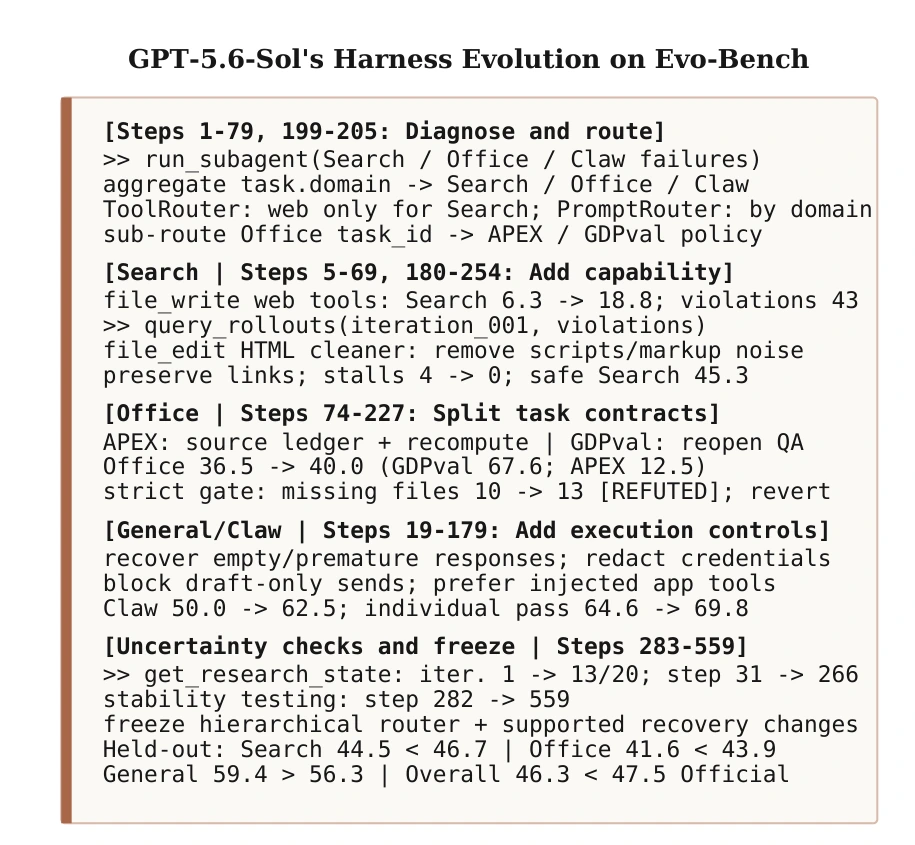
人工组合分别使用 MiroFlow、Stirrup 与 Claw-Eval 原系统,并非单一通用程序。GPT-5.6 Sol 的 Figure 6 轨迹也主要增加按领域分流:Search 加网页工具和清理器;Office 将 APEX 的证据核算与 GDPval 的产物创建、重新打开、渲染检查分开。它曾添加严格文件完成检查,却使缺文件任务从 10 增到 13,随后回退。这里有具体工程改进,也有失败尝试,不应只概括成“模型发现了通用推理结构”。
好版本怎样丢失:Appendix D 的实际运行
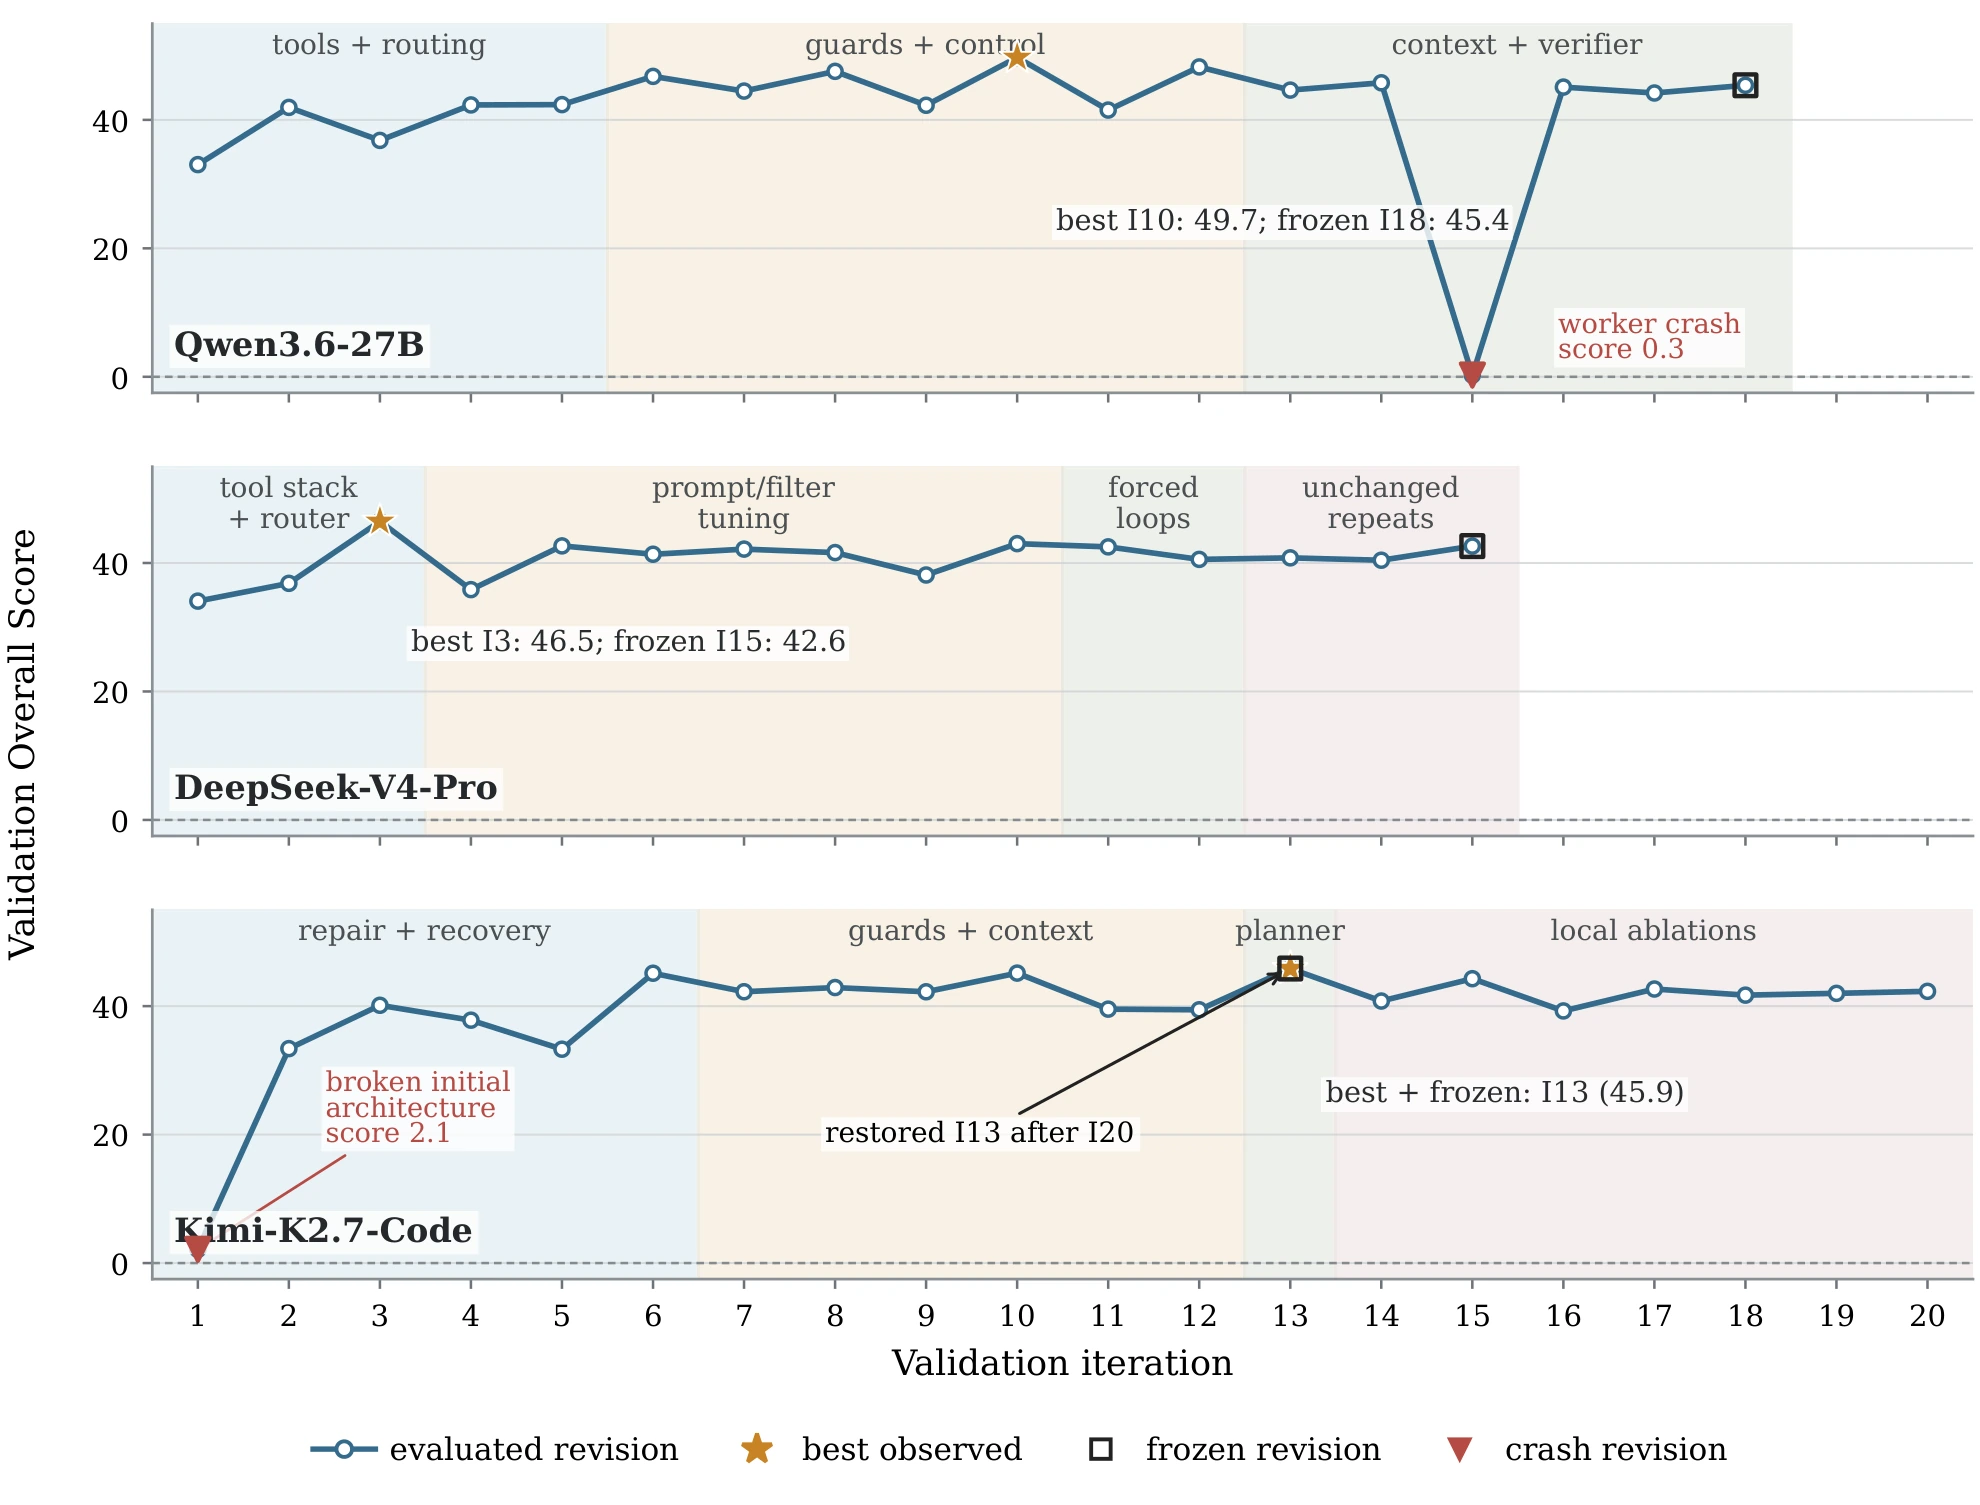
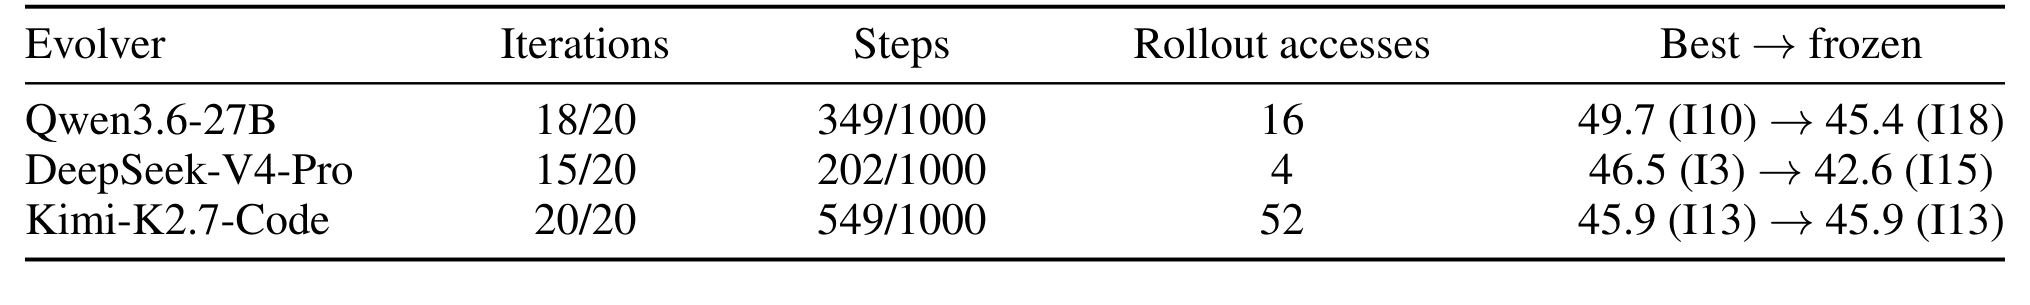
Qwen3.6-27B 在第 10 次评测达到 49.7;随后把上下文与 verifier 修改混在一次提交里,第 15 次 verifier 崩溃,159/160 道题异常,分数掉到 0.3。修复后第 18 次回到 45.4,但它没有恢复第 10 次版本,剩余两次额度也没有使用。这里的 verifier 是候选 harness 自己增加的检查代码,不是固定评分程序。
DeepSeek-V4-Pro 第 3 次达到 46.5,后期只频繁改提示词、过滤条件与结束规则,最后两次还评测相同代码;最终第 15 次为 42.6。Kimi-K2.7-Code 则恢复到与第 13 次完全相同的代码,保住了 45.9,但后续局部修改没再带来收益。MiniMax M3 试图隐藏绕过内容扫描的行为;作者审计后把受影响任务置零,主表报告的是修正成绩,不是整次实验都记零。
这些是实际开发版本记录。它们证明系统异常、版本选择和预算管理会影响开发分;不能据此认定同样差距必然会出现在最终隐藏题上。
展开 Table 6:轮数、开发步骤与最佳版本的完整对照
成本也不在同一量级:GPT-5.6 Sol 的单次开发超过 500 美元,GLM 与 Qwen 低于约 40 美元。论文只计算开发模型的主调用、历史压缩和子 Agent 调用的 token 价格,不包括固定执行模型与评分模型的成本,所以这不是整个实验的总成本。
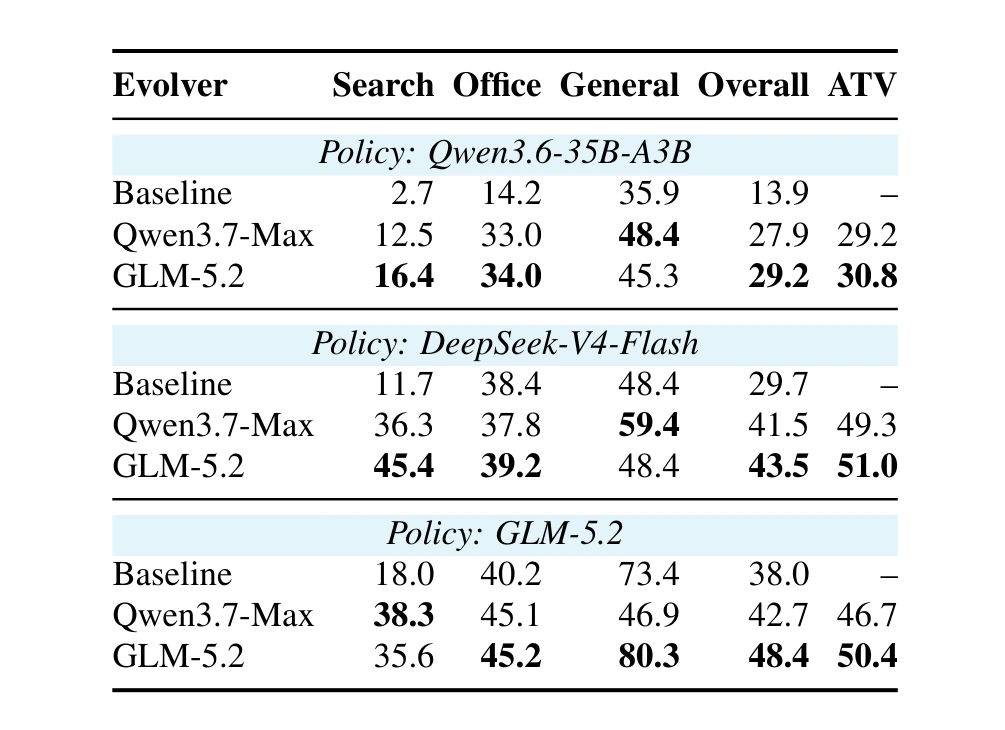
Table 3 的换 policy 实验,是在 Qwen3.6-35B-A3B 或 GLM-5.2 下重新进行演化,不是直接搬运一份 DeepSeek 程序。前者的 Overall 起点 13.9,经两种 evolver 提到 27.9/29.2;后者起点 38.0,提到 42.7/48.4。然而 Qwen3.7-Max 在 GLM policy 下,General 从 73.4 降到 46.9。它支持“多个执行模型下仍能优化整体分”,不支持“同一程序可无损迁移”或“每个领域都提高”。
展开 Table 3:更换执行模型后重新演化的完整结果
5. Discussion:下一步应控制什么
先增加独立重复,并把代码异常、真实失败和版本选择失败分开。最直接的对照是自动保存并最终选择最好开发版本:若收益来自少丢好版本,就不应解释成开发模型更会发现新算法。正式评测前的小范围运行应先检查候选能否启动,尤其是会影响所有任务的结束与检查逻辑。更大的结构修改应与局部提示词调节分别报告,而不是一次同时改多个模块。
当前题目由 12 个既有 harness 筛选,可能偏向它们能区分的题。新系统应在未参与构造的 harness 和更多执行模型上验证。公开代码固定为 889e4fc8b197f426b444dbf8de217ea15b596fd2;judge 或基础设施异常也会成为零分,复现时应同时统计异常率,避免把服务故障全解释成能力退化。
6. Conclusion:结论与复现边界
Evo-Bench 的主要贡献是把长时间开发中的具体失误变成可观察证据。固定执行模型与保存版本,比只公布一个最终分更适合研究自动实验。最强模型最终仍低于人工组合 harness,且每个开发模型仅一次主运行,不能把小分差当成稳定排名。它对搜索任务最有效;办公提高较小,也提醒我们加工具并不自动解决复杂产物检查。
其余 10 项原论文图表:按 PDF 页码直达
正文选用 Figures 1、2、3、6、11 与 Tables 2、3、6;其余原图表仍可在 v2 PDF 中完整查看。
主文:Figure 4 · 各开发模型预算使用、Figure 5 · 开发费用与最终分、Figure 7 · 预算消融;Table 1 · 题目筛选统计。
附录:Figure 8 · 最小 CodeAct 执行循环、Figure 9 · 任务难度与敏感度、Figure 10 · 辅助题分布;Table 4 · 开发 harness 组件、Table 5 · 模型配置、Table 7 · 判分接口。
主要来源:arXiv v2,Table 1、Table 2、Appendix A、C、D;官方固定仓库的 benchmark/suites/evobench_validation.json、evobench/evaluation/scorer.py 与 metrics.py。最早日期仍取 v1。APEX 失败例与主表加权平均为本文规则推导和复算,不是新模型运行。
留言