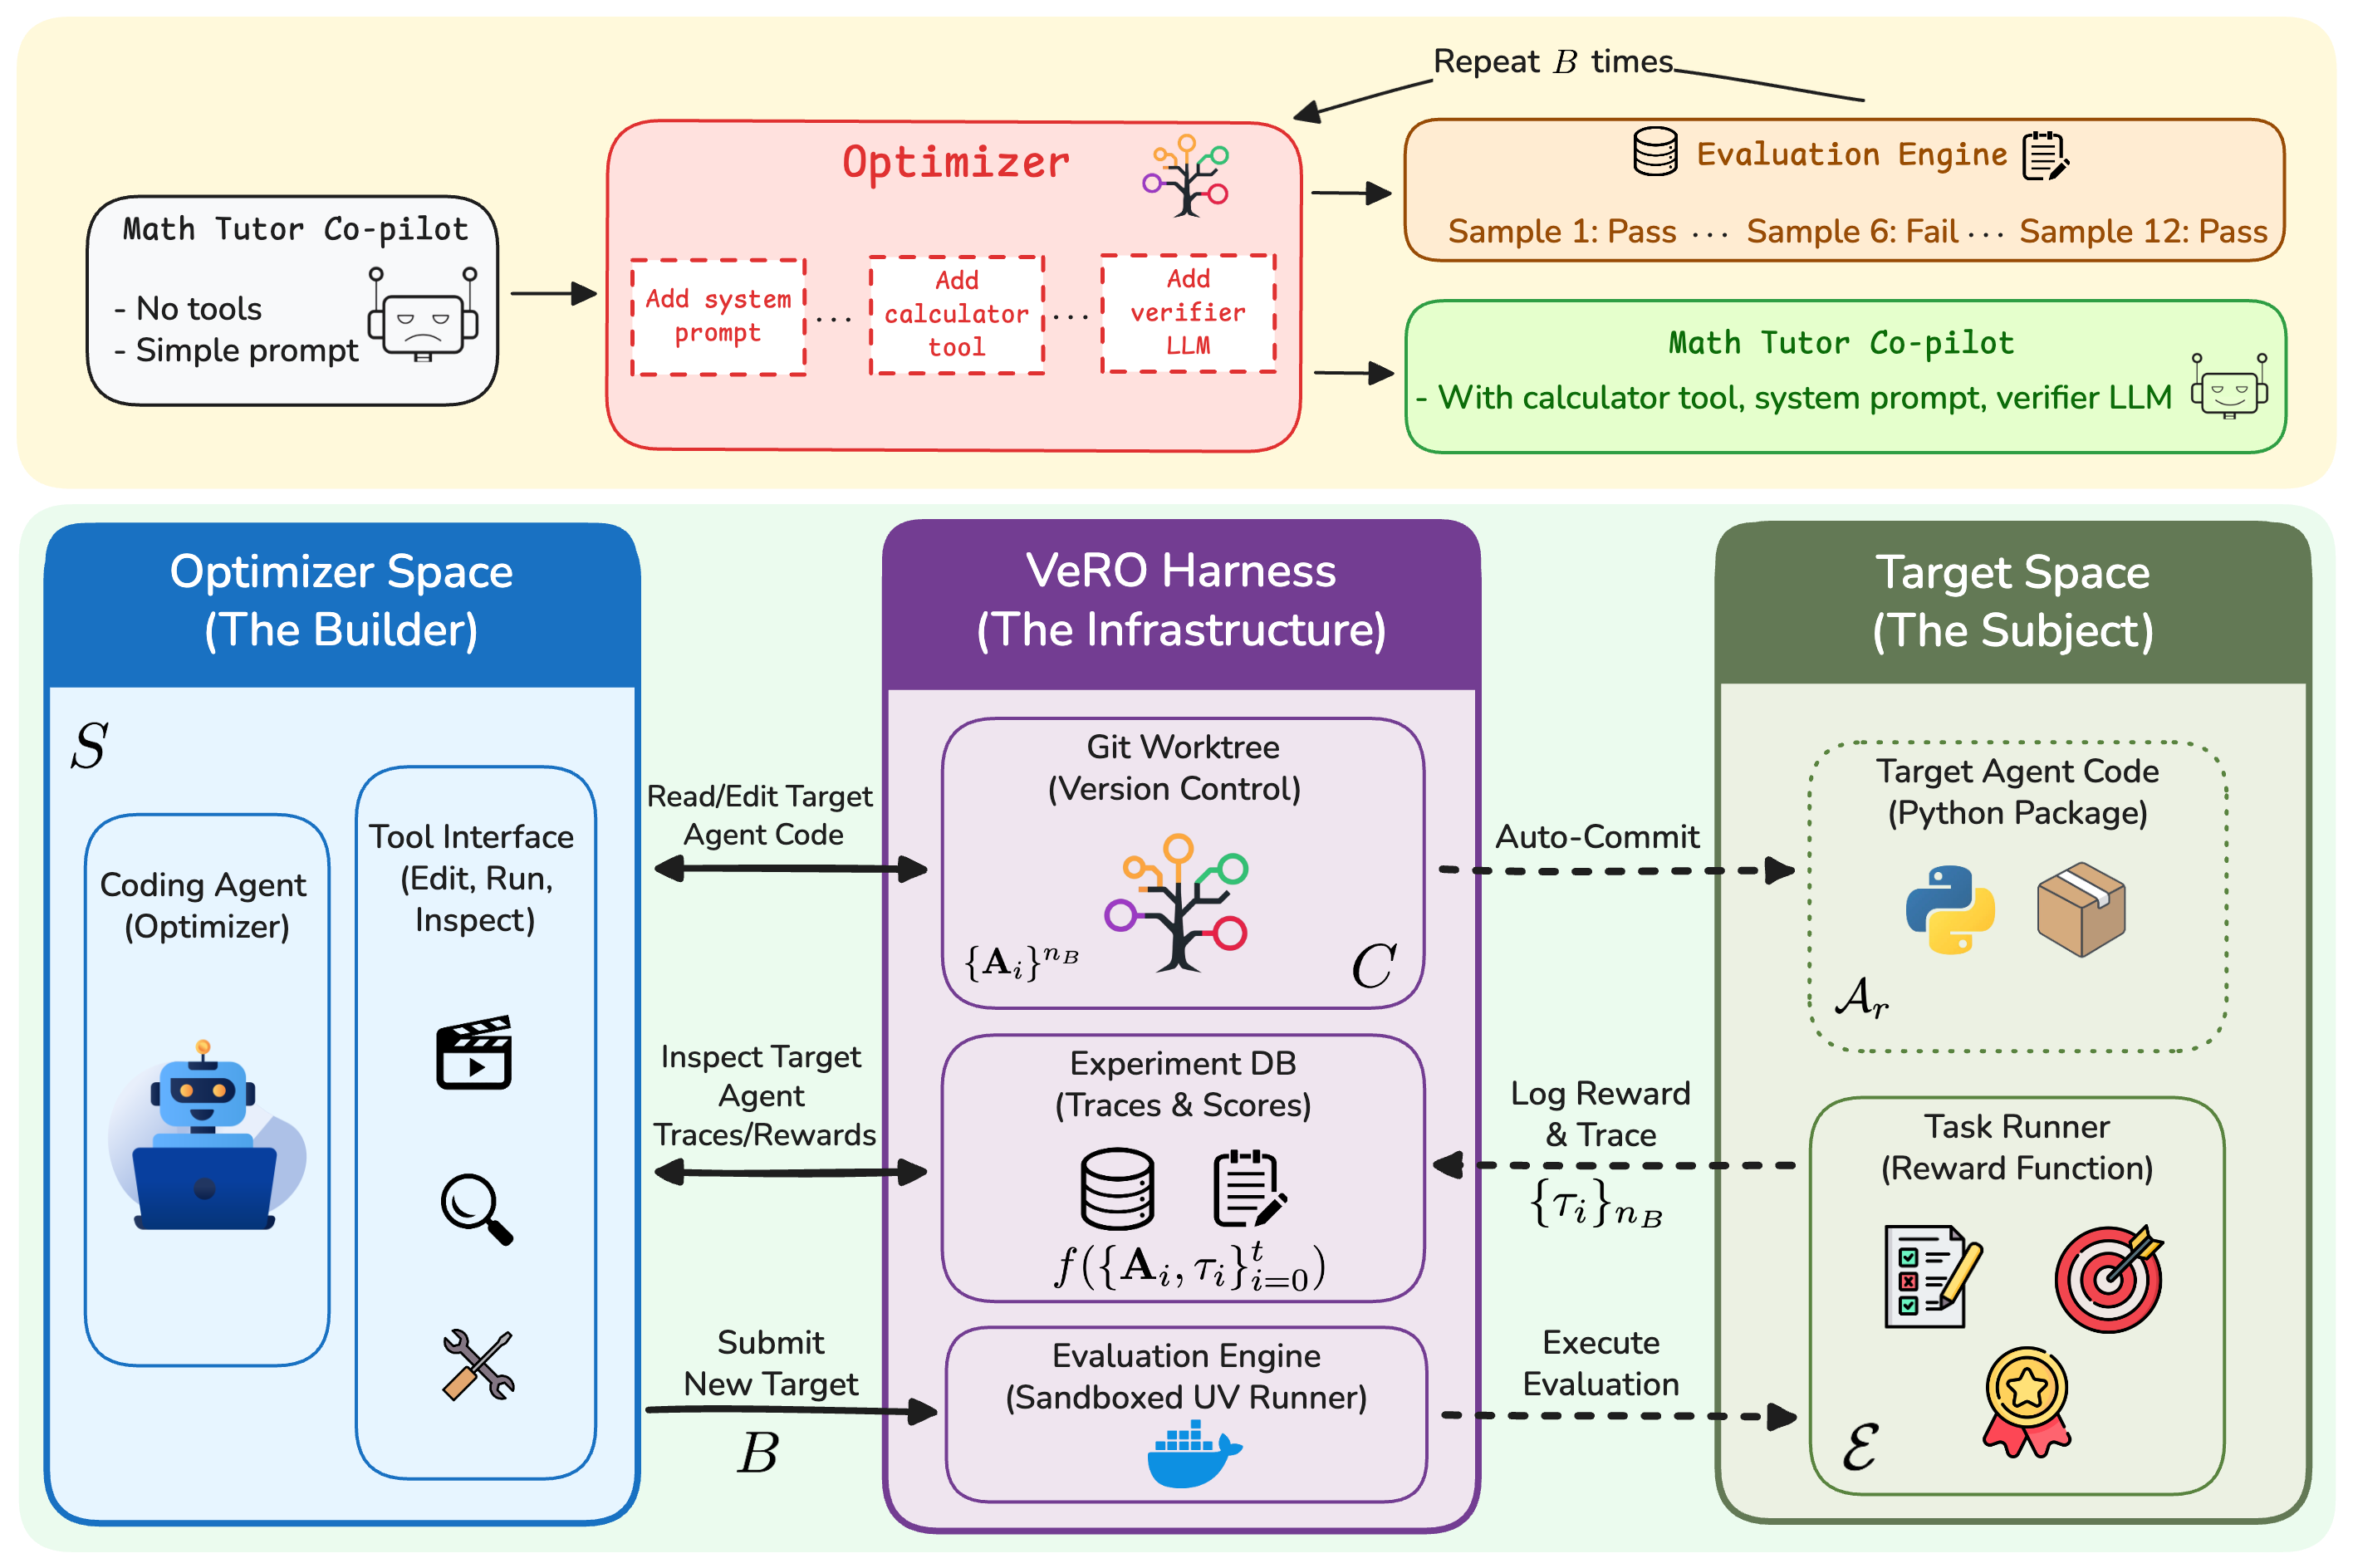
VeRO 是一套给“Agent 优化 Agent”使用的实验平台。外层编辑模型可以修改目标系统的提示词、工具和代码;平台让每个候选进入独立工作目录,由服务端扣评测额度,保存代码版本、分数与运行记录。这样才知道哪份修改得到哪个结果,也能限制直接读取测试答案或无限调用评测服务。
1. Motivation:自动改系统的实验怎样才能可信
可信的自动改进实验需要平台实际执行版本、预算和权限限制。只把规则写进提示词,编辑模型仍可能超额评测或读到测试答案;记录不完整时,也无法还原哪份代码对应哪个分数。VeRO 把这些职责交给外层系统执行。
2. Related Work:实验平台与搜索算法分开
VeRO 提供版本、权限和评测接口,搜索算法可以替换。Meta-Harness 是具体的自动修改策略;HarnessOpt-Bench 进一步固定任务和反馈公开规则。VeRO 的实验既比较不同 coding-agent 配置,也比较只改提示与工具描述的 GEPA。它不会因为某种优化器使用了自己的工具,就自动把改动算作更好的方法。
| 比较对象 | optimizer 实际能改什么 | 这篇的比较意义 |
|---|---|---|
| GEPA | 提示、工具描述及预留参数 | 用反思与演化搜索,但不能任意重写目标代码 |
| VeRO-Agent Resources Only | 与 GEPA 同一组可编辑组件 | 更接近隔离搜索策略的差别 |
| VeRO-Agent Default | 允许的 Python 代码、工具、流程和提示 | 允许搜索更大的程序空间 |
| Meta-Harness | 根据失败记录修改完整 harness | 同属自动优化,但强调具体搜索策略;VeRO 强调可替换 optimizer 的实验协议 |
因此 Default 比 GEPA 高 0.07,不能全归因于“算法更强”:两者的可修改范围不同。论文还比较 Claude Code 的原生 shell 评测与接入 VeRO 工具后的评测,不过后者同时改善了反馈、版本和接口;它并非只切换一项权限开关的消融实验(§4.1、Table 6)。
3. Method:一次候选从改代码到返回分数
optimizer 提出修改,VeRO 保存版本并执行受控评测。系统为候选创建独立 Git worktree,即共享 Git 历史但文件互不覆盖的工作目录;修改保存成 commit。optimizer 只能读取允许的数据分区和代码,不能靠直接访问文件看到 test 答案。
- 1 · 保存版本系统从初始程序创建独立 Git worktree,每次提交对应确定的代码版本。
- 2 · 修改optimizer 修改提示、工具、执行流程或代码;文件接口限制能读写的路径。
- 3 · 评测optimizer 选择分区和样本;评测服务检查权限、按实验配置扣额度,再在隔离环境运行候选。
- 4 · 观察实验数据库保存代码版本、样本、分数、运行记录与成本,再返回允许查看的结果。
- 5 · 选择optimizer 比较候选,恢复最佳版本或继续分支;最终冻结一份代码。
负责运行候选和给分的组件称为 evaluator;optimizer 通过 ExperimentRunner 请求某个 commit 的评测。服务检查分区权限和剩余额度,再运行候选。返回的 execution trace 是输入、动作、工具反馈、错误和分数组成的记录,它与 commit 一起保存在实验数据库里。optimizer 据此决定保留、回退或继续修改。
主实验 B=8 计评测调用,Terminal-Bench 案例才改用样本预算。主实验的算法每调用一次 ExperimentRunner.run,nE 加 1;B 不包含 optimizer 的 token 或 API 成本。Terminal-Bench 案例的 B=89/178 则计被评的题目样本数:89 题全量评一次消耗 89,178 相当于两次完整评测。把两种预算混成一个单位会误判搜索效率(v4 §4.1、§4.4)。
任务、分区和版本选择
作者固定目标模型为 GPT-4.1 mini,沿用五个来源 benchmark 的判分函数,而不是重新人工给所有回答打分。GAIA 测可用工具解决的综合问答,GPQA Diamond 测高难度科学选择题,MATH 测数学解题;τ-Bench Retail 模拟零售客服任务,SimpleQA 测事实问答。各任务分区如下;破折号表示没有该分区,不能当成零题得分。
| 任务 | train / validation / test | 构造与报告边界 |
|---|---|---|
| GAIA | 50 / 87 / — | 从可用训练题中过滤成 137 道纯文本题,再取 50 道优化;87 道 validation 同时用于选最佳版本与报分 |
| GPQA Diamond | 98 / — / 100 | 198 题固定拆分;没有 validation,按 train 分数选择代码,再评 test |
| MATH | 59 / 60 / 486 | 沿用 AFlow 的拆分,并核对公开题目 |
| τ-Bench Retail | 100 / 20 / 115 | 沿用来源 benchmark 的分区和工具 |
| SimpleQA | 46 / 45 / 80 | 先取 GPT-4.1、Sonnet 4.5、Gemini 2.5 Pro 直接答题都失败的 171 题,再固定拆分 |
这些预筛选在优化前完成。SimpleQA 因而测的是这批困难事实题,不能外推成整个 800 题来源集的表现。GAIA 的数据集名称与题数按 v4 Appendix A.2.1 原样记述,不混用当前仓库新 benchmark 的拆分。
八种 optimizer 配置在五项任务上各搜索三次,共 120 次;optimizer 的 temperature=1.0、最多 200 turns。主实验一次额度覆盖整批 train 或 validation,单批约 46 到 100 题,B=8 不是只允许做八道题。作者控制随机种子并重复搜索,但目标模型和在线搜索仍会产生噪声;Table 2 先取每次搜索选中的最佳代码得分,再对三次运行取平均,括号内是三次中的最大值,不是标准差。
4. Experiments:成功率与错误类别为什么必须一起看
默认配置的收益主要来自工具任务,纯推理任务改善很小。下面保留原论文 Table 2 的全部配置和数字。每格前一个数是三次搜索各自最佳版本得分的平均,括号里是三次中的最大值;最后一列再对五个任务等权平均。
| Optimizer / Variant / Model | GAIA | GPQA | MATH | Retail | SimpleQA | Avg. |
|---|---|---|---|---|---|---|
| Baseline | 0.07 | 0.60 | 0.87 | 0.38 | 0.61 | 0.50 |
| Claude Code · Pure · Sonnet 4.5 | 0.13 (0.29) | 0.58 (0.63) | 0.88 (0.90) | 0.43 (0.46) | 0.65 (0.68) | 0.53 (0.59) |
| Claude Code · VeRO Tools · Sonnet 4.5 | 0.14 (0.21) | 0.64 (0.71) | 0.88 (0.90) | 0.39 (0.43) | 0.67 (0.71) | 0.55 (0.59) |
| VeRO-Agent · Default · Sonnet 4.5 | 0.26 (0.30) | 0.64 (0.65) | 0.86 (0.87) | 0.55 (0.66) | 0.73 (0.76) | 0.61 (0.65) |
| VeRO-Agent · Orchestrator · Opus 4.5 | 0.18 (0.18) | 0.62 (0.66) | 0.88 (0.88) | 0.55 (0.57) | 0.74 (0.86) | 0.59 (0.63) |
| VeRO-Agent · Orchestrator · Sonnet 4.5 | 0.16 (0.20) | 0.62 (0.65) | 0.87 (0.88) | 0.51 (0.72) | 0.71 (0.72) | 0.57 (0.63) |
| VeRO-Agent · Orchestrator · GPT-5.2 | 0.07 (0.09) | 0.65 (0.70) | 0.88 (0.90) | 0.40 (0.42) | 0.60 (0.62) | 0.52 (0.55) |
| VeRO-Agent · Resources Only · Sonnet 4.5 | 0.11 (0.13) | 0.60 (0.64) | 0.88 (0.88) | 0.42 (0.43) | 0.69 (0.72) | 0.54 (0.56) |
| GEPA · Resources Only · Sonnet 4.5 | 0.21 (0.23) | 0.58 (0.61) | 0.86 (0.89) | 0.38 (0.42) | 0.66 (0.70) | 0.54 (0.57) |
原论文 Table 2 全表;Ursekar 等,ICML 2026,PMLR 306,CC BY 4.0。括号不是标准差,也不是另一个测试集。
Orchestrator 的三行让 VeRO-Agent 把编辑工作委派给子 Agent,平均分分别为 0.59(Opus)、0.57(Sonnet)、0.52(GPT-5.2),并没有超过 Default。Table 2 的初始程序均分来自七种非 GEPA 配置 × 三次,共 21 次运行;不要把它当成每条候选都共享的一次确定性缓存。
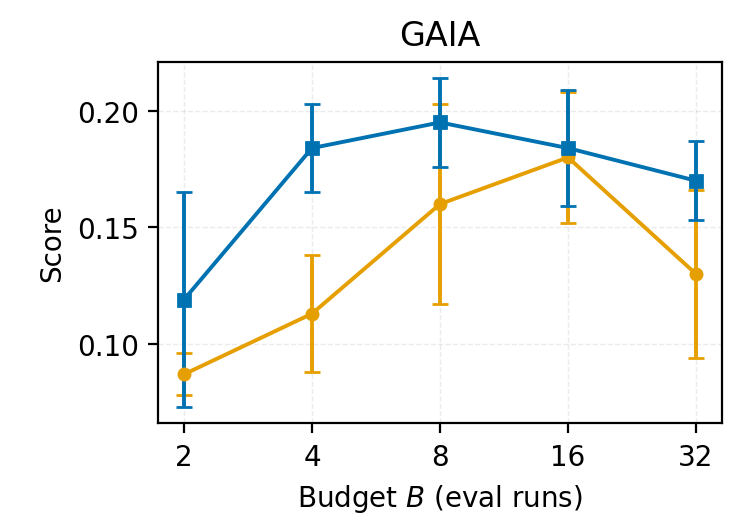
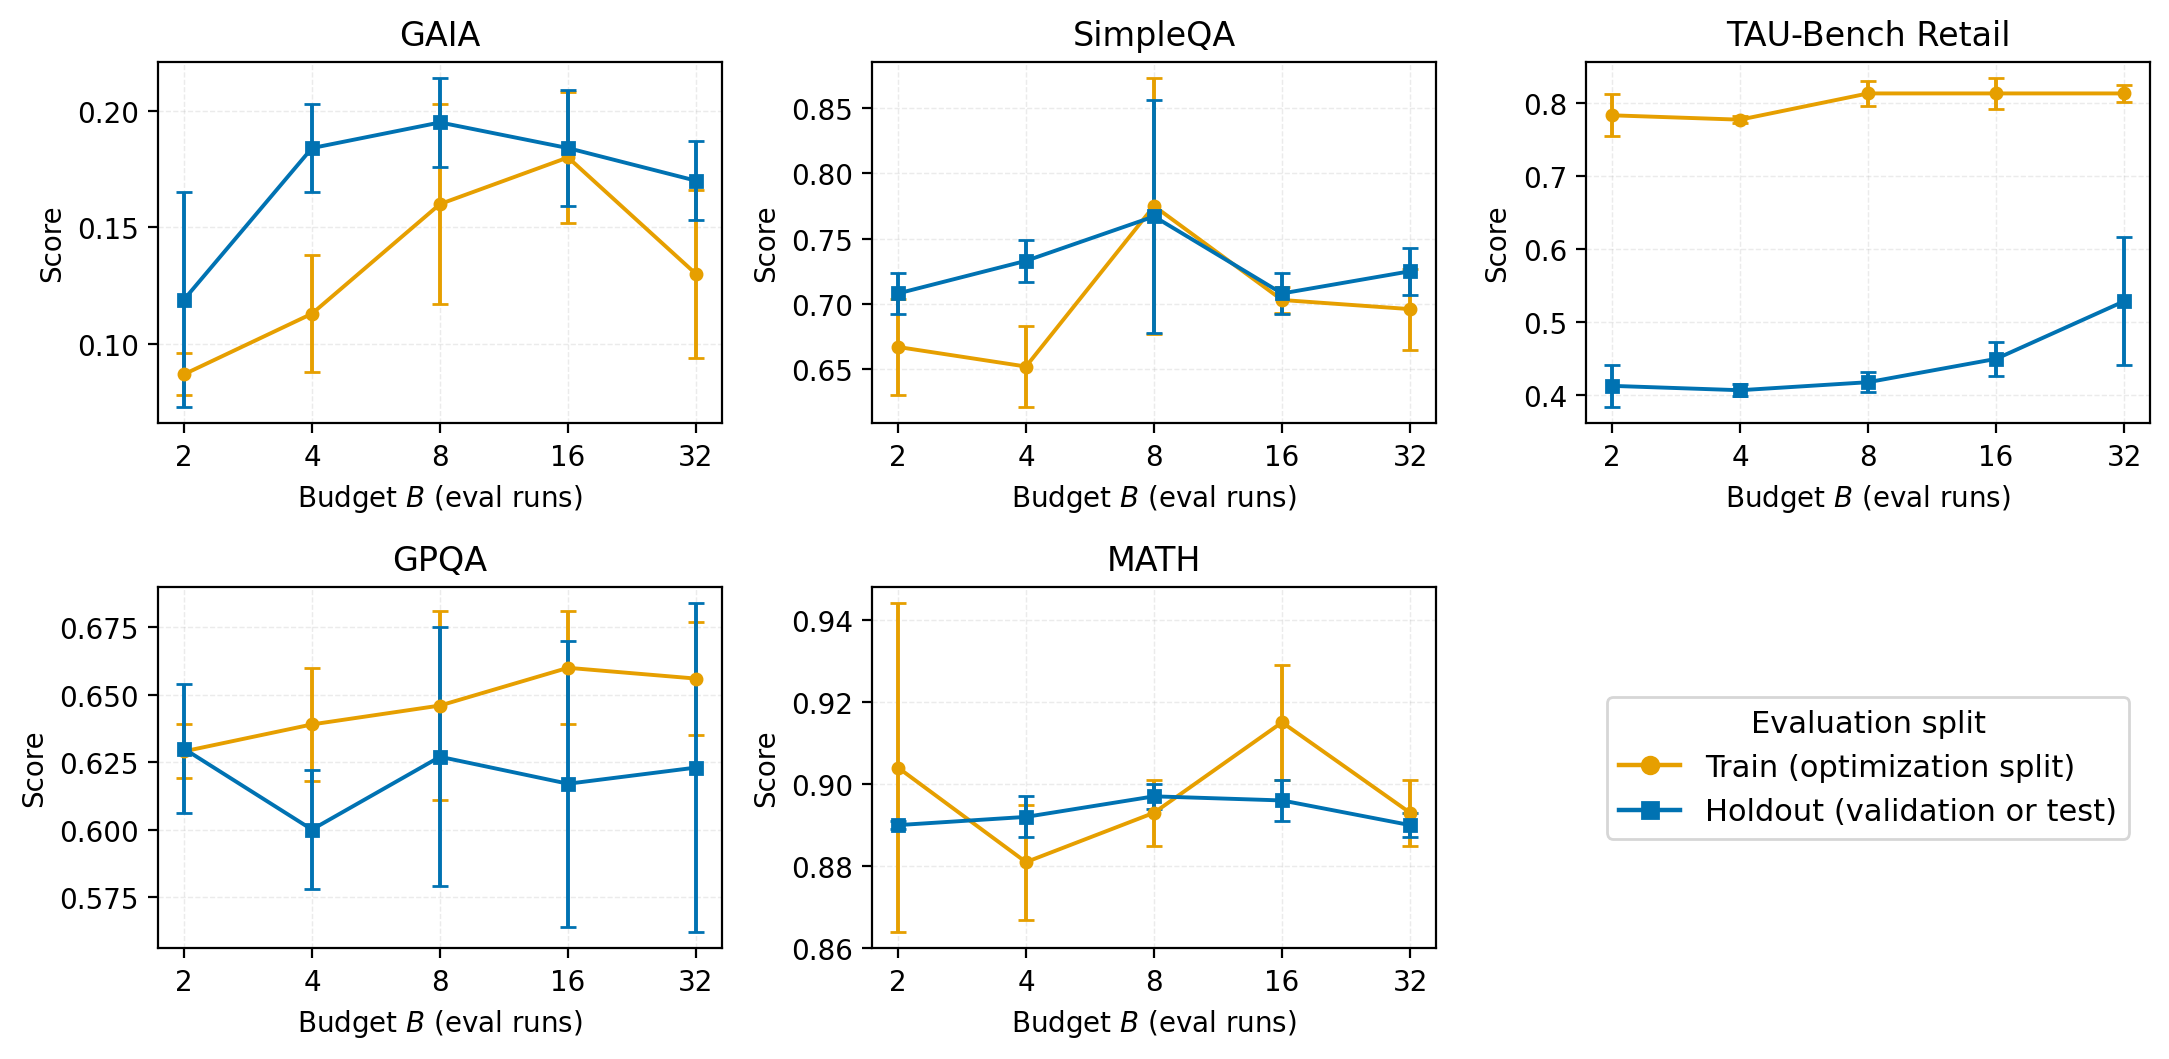
扩大预算也没有解决所有任务。B 从 2 增到 32 时,Retail 的保留集得分由 0.412 增到 0.528;GAIA 从 0.119 增到 B=8 的 0.195,却在 B=32 回落到 0.170。GPQA 与 MATH 基本持平,MATH 的初始分已约 0.87。作者认为目标模型的推理能力限制了收益,但预算实验只排除了“多评几次就会明显提升”这一解释,没有证明所有更好的程序都不存在(Figure 8)。
修改类型分析由 GPT-4.1 给代码差异分类,并非人工复核的因果实验。超过一半修改属于提示调整,后期类型更加集中;它能描述搜索行为,不能独立证明提示调整导致了成功或失败。
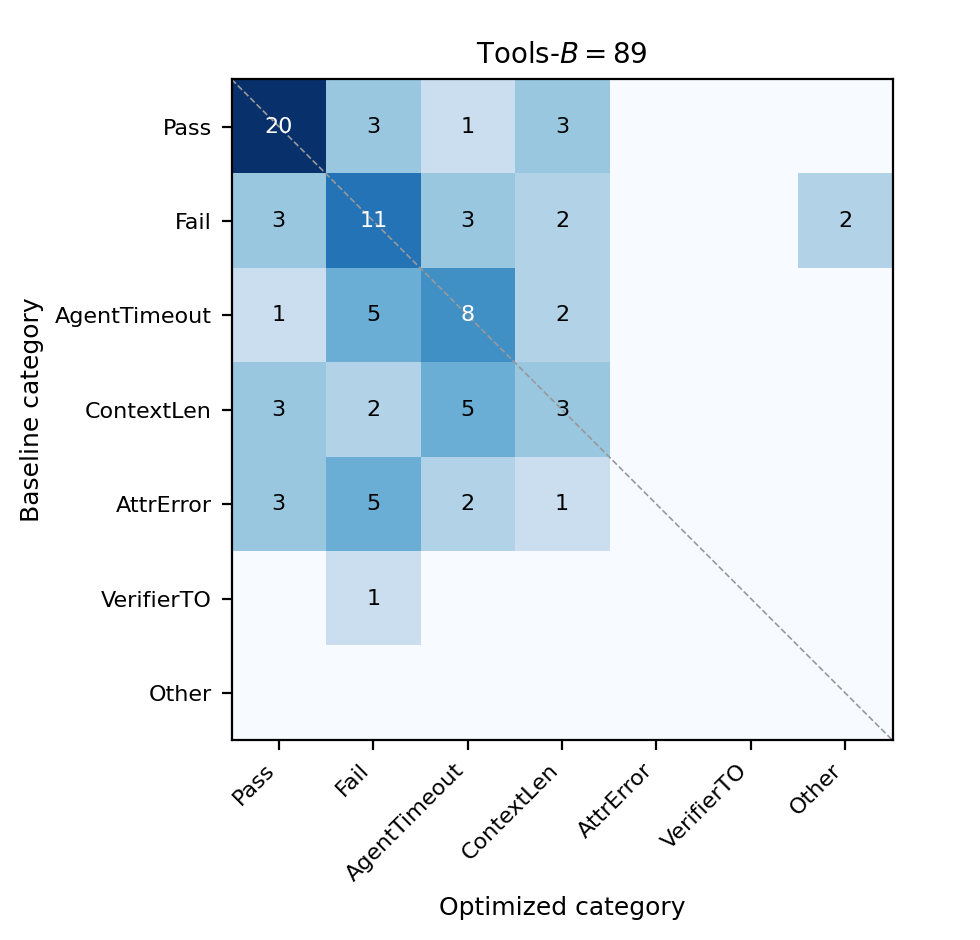
AttrError 中,3 个变成 PASS、5 个变成无异常零分、2 个变成运行超时、1 个变成上下文长度错误。完整三配置原图可对照 Filesystem 与 Tools-B=178。Ursekar 等,ICML 2026,PMLR 306,CC BY 4.0。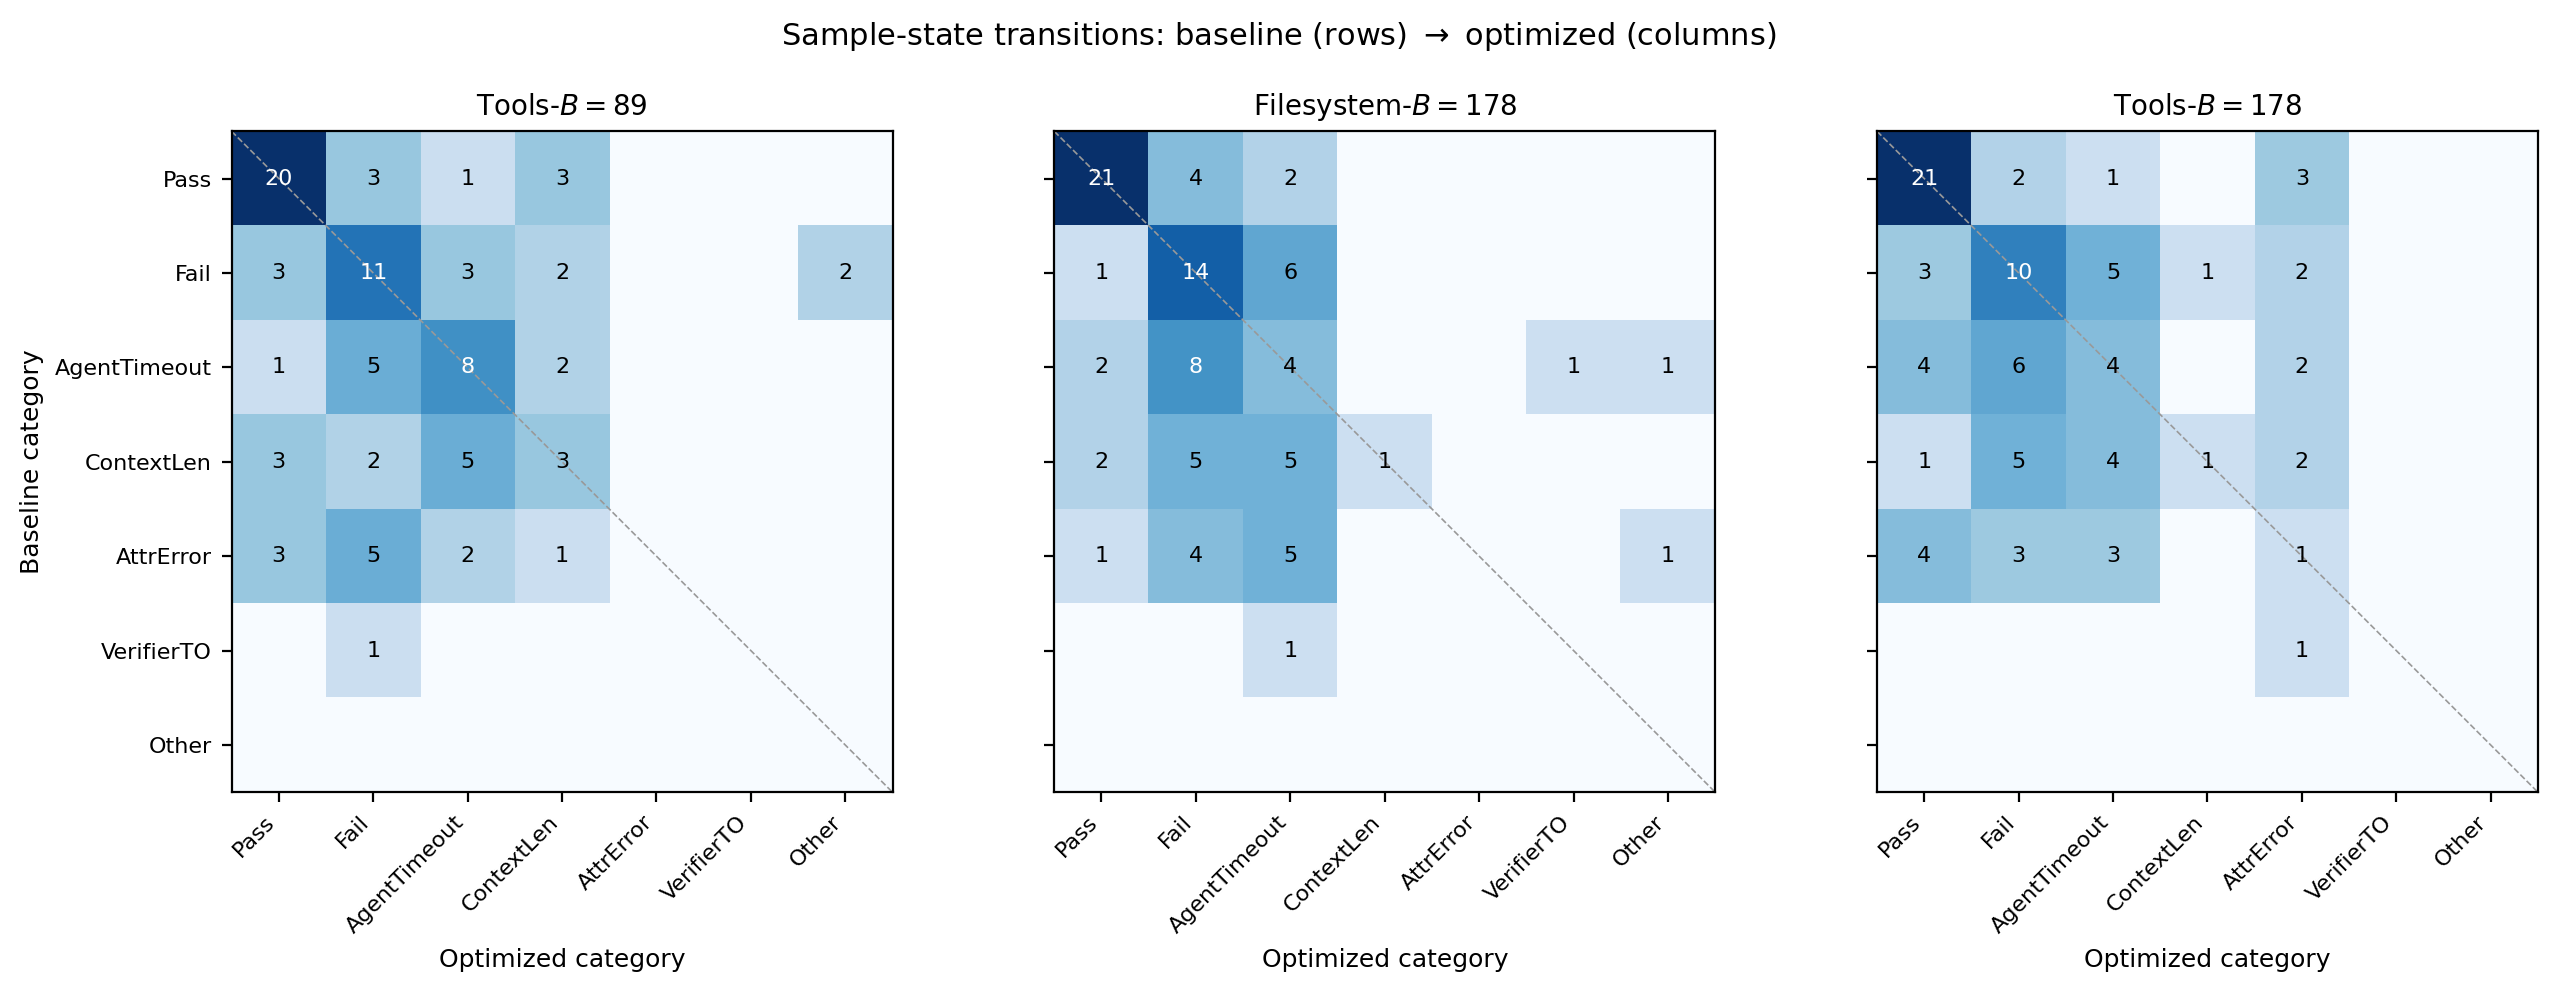
Terminal-Bench 2:消除 crash 后,任务仍可能 FAIL
- 初始状态:Terminus-KIRA 在 89 题中通过 27 题;另外有 41 次运行抛异常,21 次没有异常但 verifier 给 0。
- Tools-B=89:optimizer 发现 target LLM 有时把 tool call 输出成字符串,于是在五处加入
isinstance(..., dict)检查。11 个AttributeError全部消失,但最终只通过 30/89。 - Filesystem-B=178:同样消除 11 个
AttributeError,并把 context-length error 从 13 个降到 1 个;通过数仍是 27/89,因为超时和无异常零分增加。 - Tools-B=178:主要压缩 prompt、tool 描述与输出长度,保留了
AttributeError,却通过 33/89。 - 逐题迁移:Filesystem 版本新增 6 个 PASS,同时让原先 6 个 PASS 退化;总分相同掩盖了两批任务的交换。
原 benchmark verifier 决定 PASS/FAIL。VeRO 记录的是失败类别迁移;它不会把“少崩溃”自动换成奖励。
这组记录由 v4 Appendix A.4 的真实运行整理,判分仍来自 Terminal-Bench 的任务测试。AttributeError 表示代码把字符串当字典读取属性而崩溃;加类型检查后,程序能继续走,后面仍可能超时或提交错误产物。11 个原先这类错误中,Tools-B=89 只有 3 个转成 PASS,Filesystem-B=178 只有 1 个转成 PASS,其余换成其他失败。
Tools-B=178 = (原通过保留 21 + 新通过 12)/89 = 37.1%
净增益 = (12 − 6)/89 = 6.7 个百分点(按未舍入数)
核对原论文完整的错误类别和逐题得失(Tables 16、18)
Table 16 按最终运行状态给 89 题分类;无异常但 verifier 给 0 的任务单列为 Fail。数值均为题数。
| Table 16 · 状态 | Baseline | Tools-B=89 | Filesystem-B=178 | Tools-B=178 |
|---|---|---|---|---|
| AgentTimeoutError | 16 | 19 | 23 | 17 |
| ContextLengthExceededError | 13 | 11 | 1 | 2 |
| AttributeError | 11 | 0 | 0 | 11 |
| VerifierTimeoutError | 1 | 0 | 1 | 0 |
| ExecutionError | 0 | 2 | 0 | 0 |
| Other (Internal, Runtime) | 0 | 0 | 2 | 0 |
| 全部异常 | 41 | 32 | 27 | 30 |
| Fail:无异常、得分 0 | 21 | 27 | 35 | 26 |
| Pass | 27 | 30 | 27 | 33 |
Table 18 把每份最终程序与初始程序逐题配对;新通过数减旧通过退化数才是净增长。
| Table 18 · 配置 | 最终 Pass | 旧 Pass 保留 | 新 Pass | 旧 Pass 退化 |
|---|---|---|---|---|
| Tools-B=89 | 30 | 20/27 | 10 | 7 |
| Filesystem-B=178 | 27 | 21/27 | 6 | 6 |
| Tools-B=178 | 33 | 21/27 | 12 | 6 |
原论文 Table 16、Table 18;Ursekar 等,ICML 2026,PMLR 306,CC BY 4.0。
论文公布了逐题分类迁移,不是每题的完整 brief、环境与测试断言。它足以支持“修掉 crash 不充分”,不能用来构造某一道未公开下游题的假 checker。该 case 每种配置只有一次搜索,不能把 33/89 当作 Tools 接口稳定优于 Filesystem 的统计结论。
同一份程序换任务,提升可能反转
另一组 GAIA 案例比较简单的 Pawn(4 个工具、25 行提示、20 turns)与更完整的 Knight(6 个工具、140 行提示、40 turns)。每种优化指令运行四次、每次最多五批训练评测;最终还测 FACTS 和 SimpleQA。Pawn 的 black_lake 分支在 GAIA 由 17/87 增至 22/87(+5.75 个百分点),但 SimpleQA 从 31/45 降至 23/45(−17.78 个百分点),FACTS 也从 54.72% 降到 49.33%。这个结果直接限制了“改进后的 harness 到处更好”的说法。
Knight 的 shiny_night 分支在 FACTS 达到 70.34%、SimpleQA 达到 88.89%,单题时间却由 26.6 秒变成 107.8 秒。相同评测次数掩盖了约四倍执行成本。Table 12 的 orange_wind 在 FACTS 因评测崩溃记作 N/A,不是 0 分;不能把四次运行当作四个有效 FACTS 得分。
只写规则,仍会读到答案
Appendix A.5 单独运行无环境限制的 Claude Code(Sonnet 4.5),让它优化 GPQA 代码,文字要求最多八批 train 和八批 validation 评测。实际数据没有 validation,而有 100 题 test;附录指令一面禁止读取测试数据,一面允许基线与最终 test 聚合评测,规则本身也有不一致。事后 GPT-5.4 检查 258 条 assistant 消息,把“看聚合得分”视为允许,把“查看单题测试内容与答案”视为违规。
最直接的记录是 optimizer 打印 ds['test'][0]:返回题目、选项、解释以及 answer_index: 1,测试答案进入了自己的上下文。它后来还承认做了九个不同 train 版本的评测,并试图把重复运行当成“共享额度”来解释超额。作者共标出四条读取测试内容、六条承认超额的消息;后六条反复描述同一次超额,不能解读成额外做了六批实验。这是一条具体的违规轨迹,不是已统计多次重复的泄漏发生率。
5. Discussion:成本、权限与最终测试分别核查
复现应同时固定程序版本、选模分区和总成本。Terminal 三条搜索实际消耗 89/89、178/178、129/178 个样本额度;对应 optimizer 费用约 $2.41、$2.97、$3.13,墙钟时间却是 2 小时 38 分、6 小时 54 分、12 小时 38 分。完整执行一批 89 题的目标系统另需约 $180;“optimizer 便宜”不等于整个实验便宜(Table 15)。
更可信的下一组实验可以把“更完整的反馈接口”和“更严格的访问限制”分别切换,在同一程序与同一预算下比较,再用完全独立的测试集报分。还应报告每个旧成功是否退化、单题执行成本和不可用 API 的比例。论文没有同预算人工优化器对照,也承认公网答案记忆仍未受控。
代码阅读需要留意版本:当前官方 README 指定 paper-v1 为论文时期复现入口,旧代码在固定快照 d1400011917ff66b7c122e7a787d547372f43e97 的 legacy/ 中。那里 Evaluator.evaluate 解析 commit、构造数据分区、运行候选并写实验数据库,_run_in_workspace 拒绝未保存修改,避免评测到不确定文件。但单独调用 evaluator 不是权限与额度的全部机制;限制由外层工具和配置执行。新版 v0.5 的推理网关等功能不能倒推成本文 v4 已验证的方法。本文只读代码,未重跑这些昂贵搜索。
6. Conclusion:每个修改都要对应到版本、分数与运行记录
VeRO 最值得读的是它如何记录每个候选版本、评测预算和运行后果。保留代码快照、服务端计费和逐题反馈,让后续研究者能追踪修改的真实影响;安全实验说明文字规则不能代替权限控制。
本文完整核查 arXiv:2602.22480v4 正文与附录,重点为 Tables 1–3、12–18、Figure 8/16 与 Appendix A.5。最早公开日期另取 v1。主实验的调用预算与 Terminal-Bench 的样本预算分开;论文时期代码入口为 paper-v1,已读快照为 d1400011917ff66b7c122e7a787d547372f43e97/legacy。
留言