同一个模型先做任务,再阅读自己失败的记录,修改负责给它提供提示、工具和执行检查的程序。模型参数保持不变。系统把候选放到两组任务上重跑,只保留两组平均成绩都不下降、至少一组提高的版本。论文称为 held-out 的那组任务每轮都参与筛选,需要按验证集来理解。
1. Motivation:运行程序能否按模型自己的失败改进
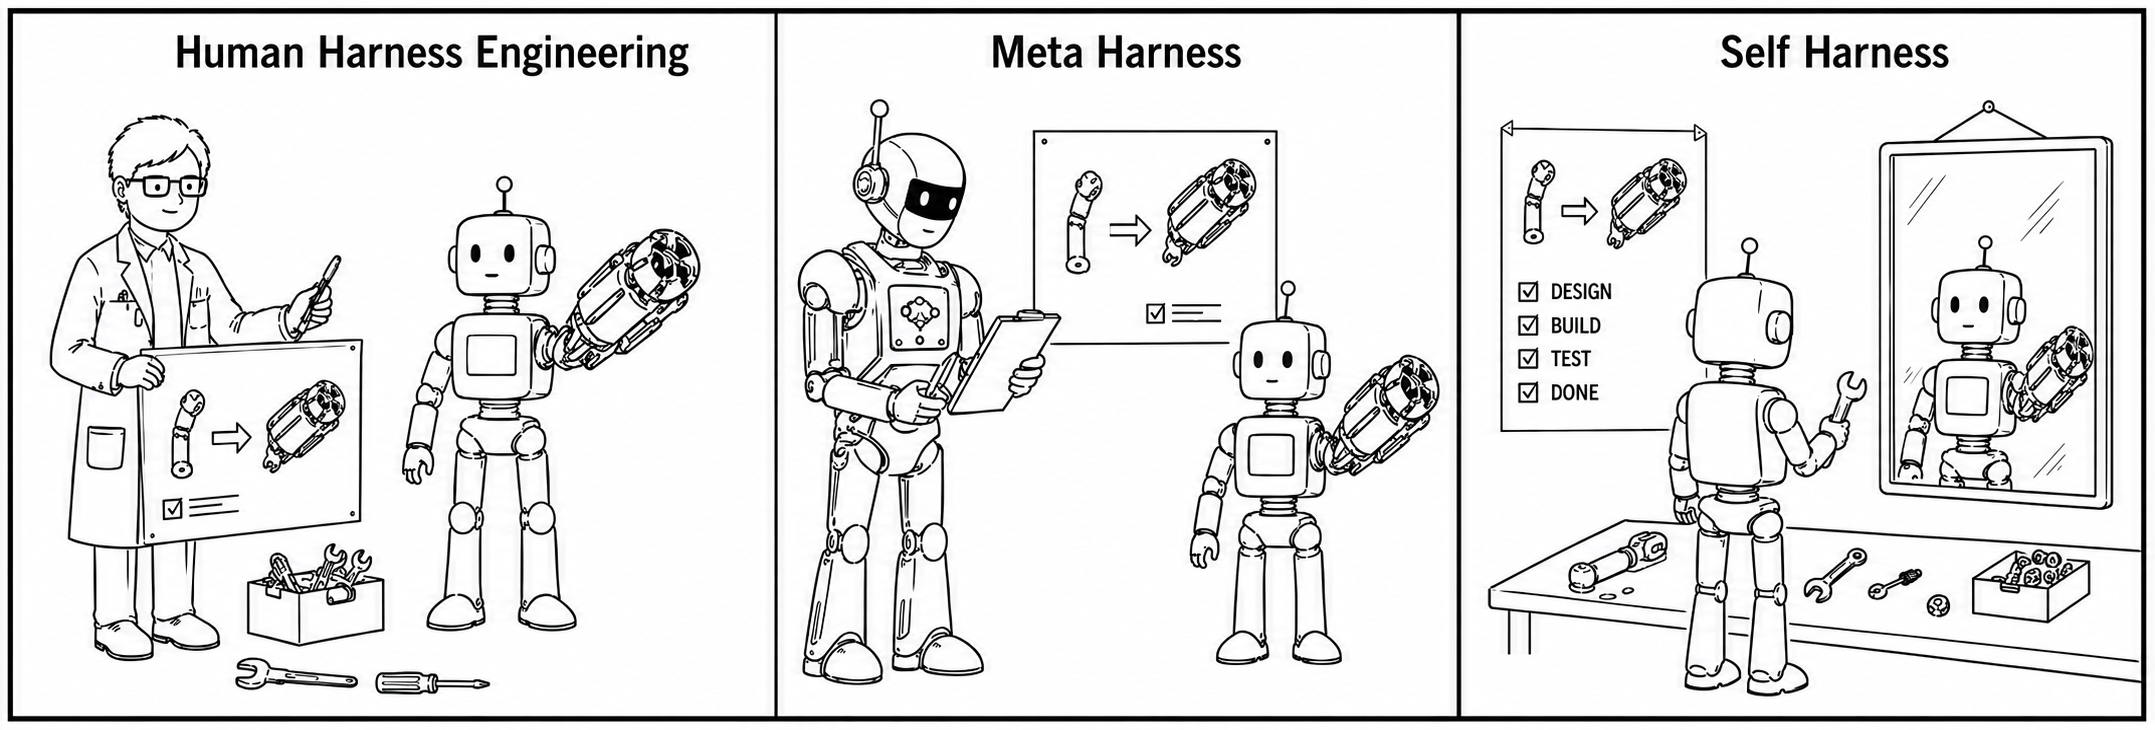
不同模型会犯不同错误,为每个新模型手工调整运行程序很费时。Self-Harness 让当前模型读自己的失败轨迹、概括反复出现的原因,再提交最小修改;两个数据分区都不退化、至少一个提高时,系统才采用新版本。
2. Related Work:固定模型下的保守补丁搜索
Self-Harness 只改预先声明的运行配置,并逐个验证候选。普通 prompt search 主要改输入文字;Harness-R1 训练另一个写补丁的模型;HarnessFix 先把运行记录对应到具体代码位置。Self-Harness 不训练模型,也不引入更强编辑器。正式实验从最小 DeepAgent 配置出发,编辑它的定义文件;这比在整个任意代码库里自由改架构更窄(v3 §4.1)。
| 路线 | 谁提出修改 | 输入与可改对象 | 差别 |
|---|---|---|---|
| Meta-Harness | 外部优化 Agent | 程序、得分和轨迹;搜索可执行 harness | 不要求编辑者与做题模型相同 |
| Agentic Harness Engineering | 执行诊断与修改的外部 Agent | 详细运行记录和仓库配置 | 重点是可观察的执行证据与验收流程 |
| Self-Harness | 当前做题模型换一个提案输入 | 归类后的失败、历史修改、声明的配置入口 | 同模型、参数固定;两个分区的平均成绩决定保留 |
3. Method:失败归类、提出小修改、双分区重跑
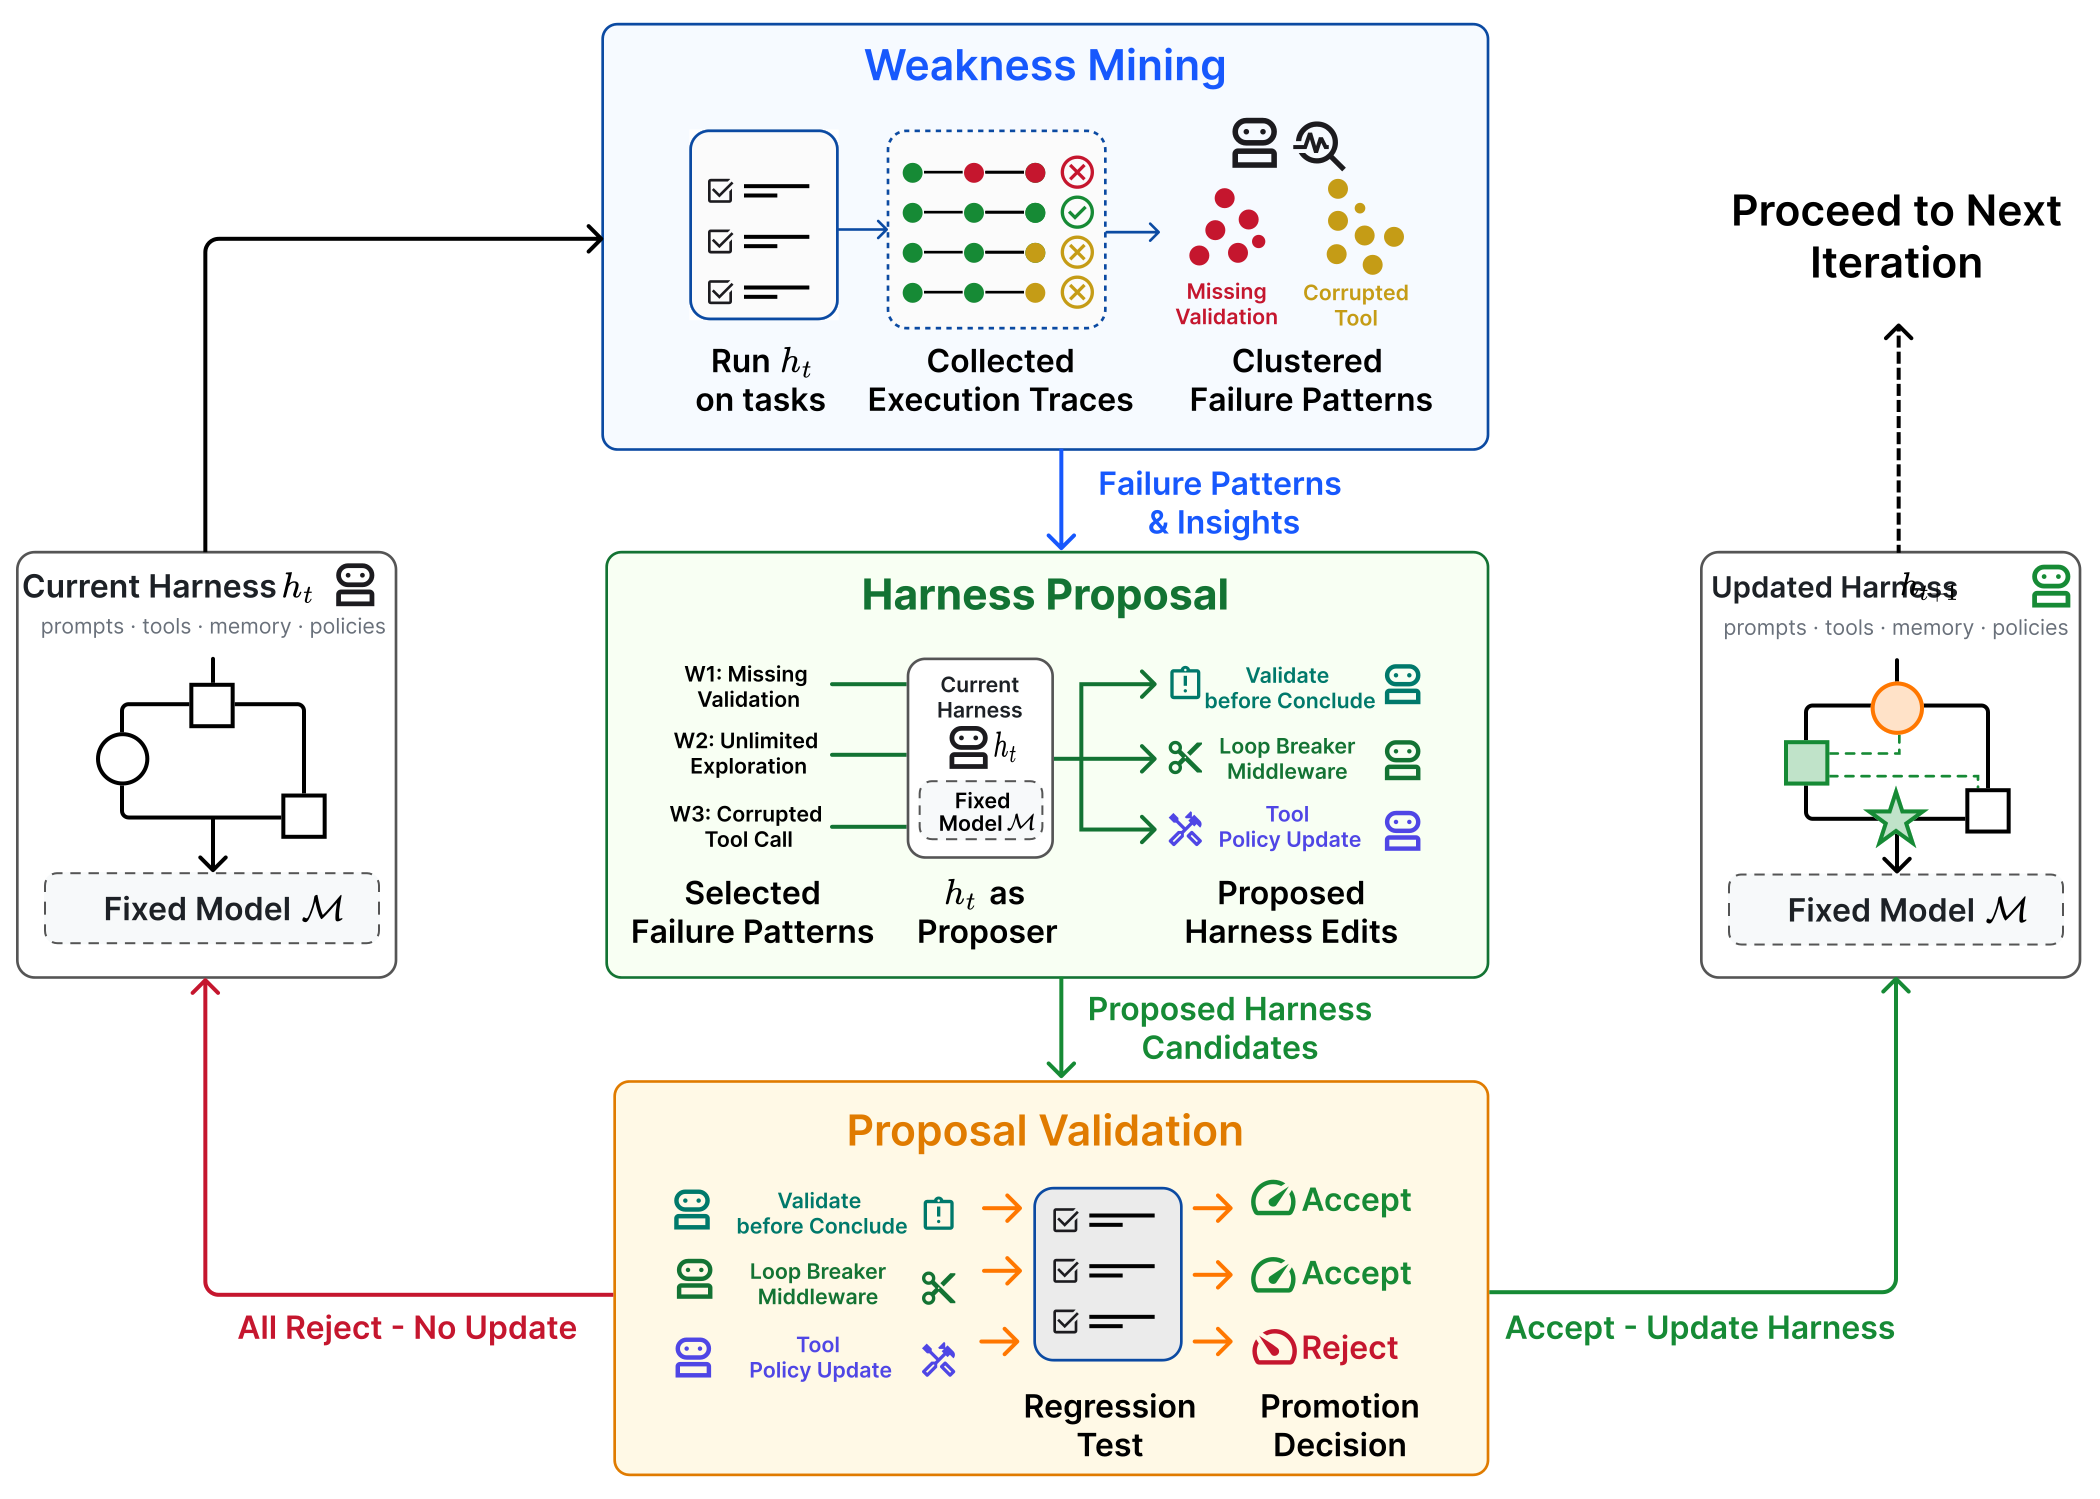
一轮先收集失败证据,再提修改,最后决定是否替换当前版本。模型用旧 harness 跑提供失败证据的 held-in 分区。原 benchmark 的测试程序,也就是 verifier,先给每次运行判成功或失败;外层系统随后记录“测试拒绝什么、Agent 的哪种行为造成它、这些行为有什么共同机制”。这组三项描述称为 failure signature。只有三项一致的失败才归到同一类;不是看两条长日志语义相似就合并。
- 系统把每类失败的数量、代表题、关键记录和测试结果整理成一包证据(evidence bundle),交给同一个模型的“提案者”角色。
- 提案者还看到当前可改配置、需要保住的成功行为、以前试过的改动。它为不同失败提出互相区分的小修改,并说明预计改变什么行为和可能的回归。
- 每个候选在两个固定分区上各重跑通常两次。held-out 分区的轨迹不交给提案者,但通过数会用于筛选版本。无实际编辑或运行失败的候选直接拒绝。
- 两个分区都不退化、至少一个严格提高时,外层程序保留候选;兼容的已通过修改可以合并,拒绝的候选只留在日志里。
Δ 是候选与旧版本的平均单次通过率之差。这个接受规则称为 promotion gate,即“哪些候选获准成为下一版本”。仅作计算示例:若一个候选两分区分别多通过 2 次与少通过 1 次,合计虽然提高 1 次,仍会拒绝;分别多通过 2 次与保持不变则可接受。这不是论文的一条实测候选日志。
“不退化”只检查分区平均值。一个分区里,原来成功的一题可以被改坏,只要新增成功补回来。下面是根据官方 run_acceptance_gate.py 写的 Python 3 简化算例,不是论文原始运行:每组 5 题跑两次,第一组每次从 3 题成功变成 4 题成功,第二组维持 2 题成功,候选获准保留。即使第一组丢失旧成功、再新增两题成功,这个只看数量的规则也区分不出来。
1 | def mean_pass(repeats): |
真实脚本还要求重复次数正确、重复编号不冲突,并核对候选与基线每次的题数一致;随后比较每次通过率的平均。本文直接调用固定版本的官方函数,用上述数量得到 accepted;把第二组改成每次只成功 1 题则得到 rejected。这验证的是筛选计算,不是重现模型做题。
Figure 3 展示起点为什么称为“最小配置”:DeepAgent 默认提供读写文件和 shell 工具,初始额外子 Agent 与 skills 列表为空,运行控制关闭。可改入口包括启动提示、执行提示、提交前验证、工具报错后的恢复,以及子 Agent 定义等。Figure 5 的 MiniMax 修改例如把“先找最小编辑位置”改为“尽早写出所需输出文件”,并在累计 50 条工具消息后加入停止重复操作的提示。50 是这项修改的触发阈值,不能当成全套实验统一的硬性工具预算。
这里的 held-out 每轮都影响选择,因此是搜索期验证和回归集,不是最终只看一次的盲测。参数冻结也不等于没有过拟合:程序版本仍在这两个分区的反馈上反复选择。
4. Experiments:分母、可执行测试与九组提升
Pass 是平均单次通过率,不是“两次任意一次通过就算成功”。论文 v3 用固定的 Terminal-Bench 64 题子集、SWE-bench Verified 100 题和 AppWorld 180 题;每题跑两次且题数相同,因此可写成 成功尝试数/(题数×2)。公开 Terminal 分区是 43/21,SWE 是按仓库比例抽样的 67/33,AppWorld 是 90/90:前者包含官方全部训练题,后者按比例取自 test_normal 与 test_challenge。Terminal 排除不稳定外部资源和初始 harness 不支持的多模态题,外网限速 2 MB/s,并镜像一部分稳定但下载慢的资源。这是受控子集,不是完整排行榜设置。
每道 SWE 题在独立 Docker 仓库环境执行,官方实例镜像给最终代码差异判分;单题超时 3,600 秒,工具超时 120 秒。AppWorld 每题重置应用状态,最多 50 个 Agent 回合,由官方状态测试判分。MiniMax、GLM 通过托管服务调用,Qwen 部署在 4 张 H200 上。做题模型与提案模型相同,各候选比较中的模型、评测程序、任务分区与不可改配置固定。论文没有报告整个搜索的统一 token 成本,不能把“不训练模型”直接等同于“低成本”。
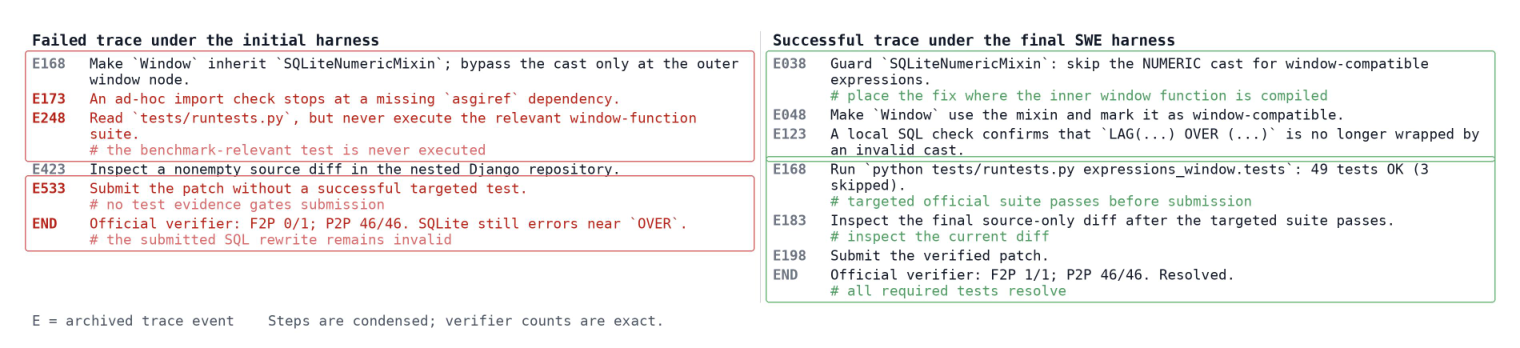
expressions_window 的 49 项本地测试,再由官方评测得到 F2P 1/1、P2P 46/46。两套测试不是同一个分母。真实 Django 案例:提交前的本地测试与官方判分
v3 Appendix B.2 与 Figure 14 给出 Qwen3.5 的 Django 案例。Agent 读仓库、修数据库窗口函数表达式(window expression),提交代码差异。原运行把针对 SQLite 数据类型转换的条件检查(casting guard)放在整个窗口表达式外层,没有成功执行目标测试就结束,唯一应被修好的测试仍失败。
Self-Harness 修改的是做题程序的提交前检查:检查代码差异、调用测试验证,并在测试仍失败时继续修。改用新程序后,仍由做题 Agent 调整源码,把 casting guard 放到可用于窗口函数的内部表达式,再运行包含 49 个测试的 expressions_window 测试组。提案者没有替官方评测器直接判成功。
最终官方评测程序报告 1/1 FAIL-TO-PASS 和 46/46 PASS-TO-PASS 通过,任务才算解决。前者是原来失败、修后应通过的测试,后者检查原来通过的行为仍正常;若唯一 FAIL-TO-PASS 失败,其他全部通过也不能算解决。49 个本地测试与 47 个官方计分测试是不同集合,不能混成“47/49 分”。论文摘录没有给出完整任务 ID、测试列表和成对运行文件;这不意味着 SWE-bench 上游的测试都未公开。本文没有复现这条模型轨迹,也不把一题的 47 项检查推广到所有 SWE 题。
AppWorld 的 Figure 18 提供另一种错误:MiniMax 原运行向聚餐的 7 位参与者都发出收款请求,忽略已经支付的交易。新程序要求读完分页、检查时间范围,再由 Agent 查询出 4 位已经付款的人,只向余下 3 人请求付款。GLM 的 Figure 22 则在分页读全后修改全部 12 条目标记录,并为只要求执行动作的任务传入 answer=None。这些是论文公开的前后轨迹;题目完整初始化数据和逐项状态测试没有在该摘录展开,不能伪造交易金额或声称已经重放 checker。
MiniMax M2.5、Qwen3.5-35B-A3B、GLM-5 在 Terminal-Bench 2.0、SWE-bench Verified、AppWorld 的九种组合都在两个候选筛选分区上提高。原论文 Table 1 同时列出 held-in、held-out 和 overall;overall 是两组全部尝试合并后的通过率,不能将 43/21 或 67/33 的两组百分比直接各取一半。
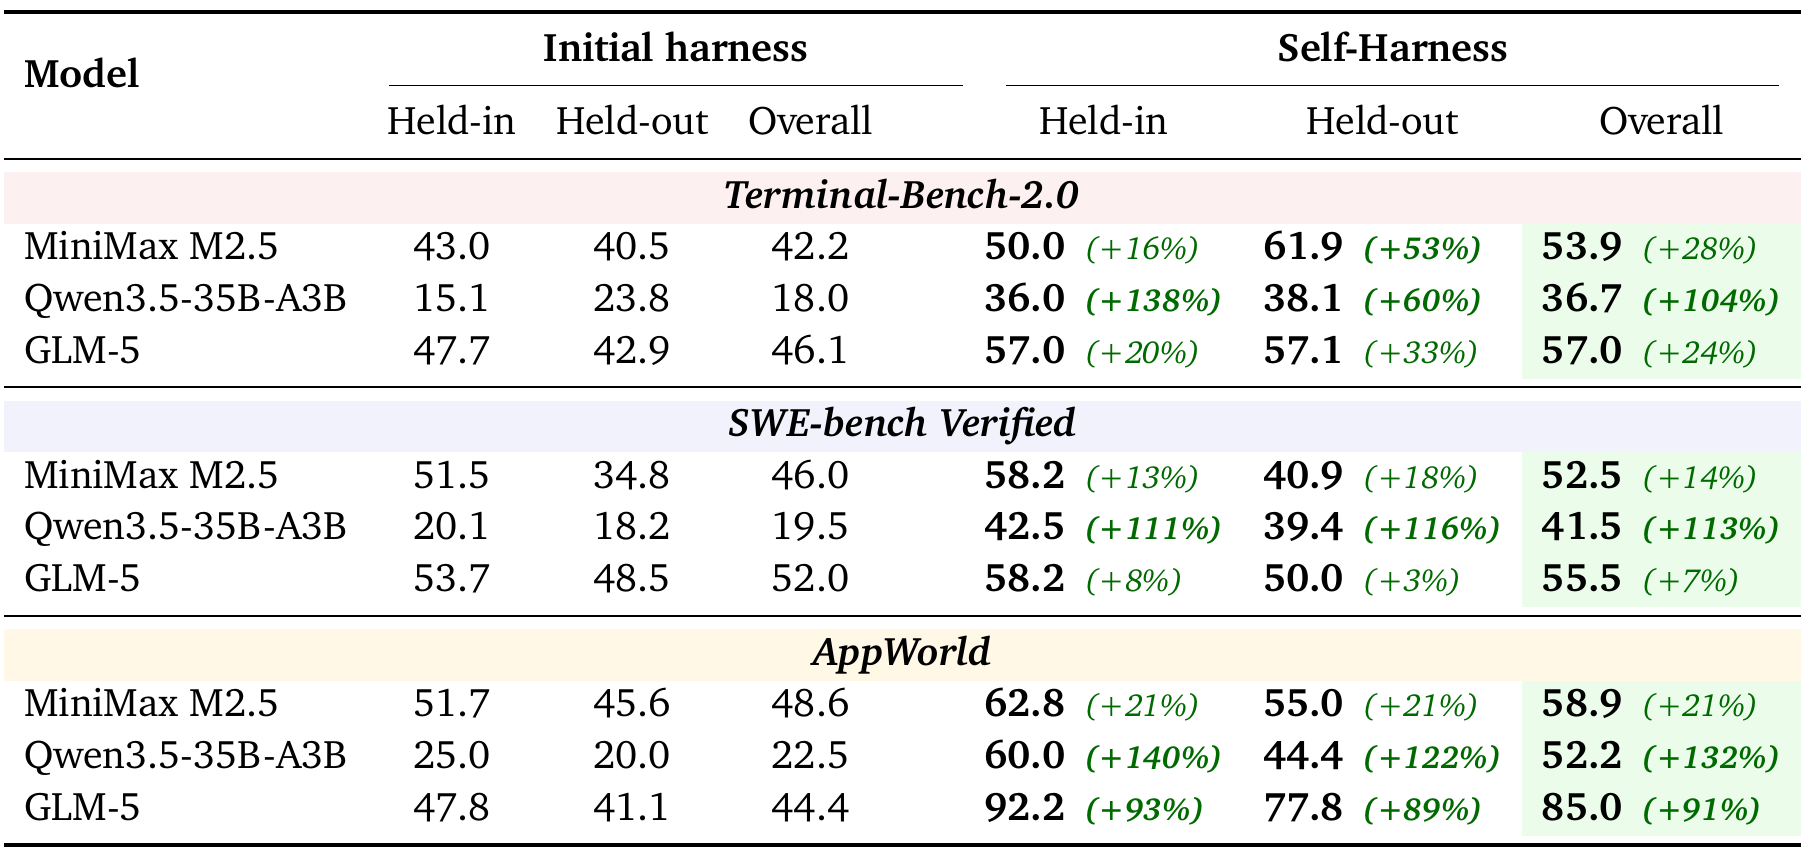
例如 Qwen 在 Terminal 的初始 18.0% 对应约 23/128,新版本 36.7% 对应约 47/128;这些是按表中保留一位小数反算的数量,不是额外运行日志。最大绝对提升是 GLM 的 AppWorld 增加 40.6 个百分点;Qwen 在 AppWorld 的相对增幅约 132%,与“增加 132 个百分点”不同。两个分区都参与过每轮筛选,仍不能当成独立最终测试。
其他保留修改也很具体。Terminal-Bench harness 会更早创建题目要求的输出文件,检测重复调用工具却没有进展的循环,并在执行前检查所需软件依赖;AppWorld harness 补齐多页查询结果,要求确认真实外部状态发生变化后才能宣布完成。每个候选通常只重跑两次,随机波动仍可能让筛选规则接受偶然提升。九组实验都来自三个工程任务基准,尚未证明这些修改会跨域迁移。
5. Discussion:再留一套从未参与版本选择的题
应另留一套完全不参与版本筛选的最终测试题,并增加独立重复。每个候选通常只重跑两次,偶然波动也可能过关;可以增加随机种子,或按累计证据决定是否保留。还应检查延迟、token、权限和安全:通过率不下降并不能排除数据泄漏、过度工具调用或偷偷改变任务要求。
官方仓库固定版本 2720dbb3f52283684f4b85a1065d642df1779dd8 可访问。README 的结果只列 Terminal-Bench,并写着 More results are coming soon。因此能核对公开筛选脚本与 Terminal 分区,但不能宣称全部九组实验、全部拒绝候选及 AppWorld/SWE 成对轨迹都已发布。复现时还需保存完整搜索历史与随机种子,才能计算找到好版本付出的代价。
6. Conclusion:最小编辑有效,但筛选分区不是独立测试
同一个冻结模型能从失败证据提出有效的运行程序修改。小范围编辑和双分区筛选值得借鉴;但论文里的 held-out 已参与搜索,只能说“未用于失败归类的回归题也提高了”,还不是完全独立的最终泛化证明。
主要来源:arXiv:2606.09498v3 的 §3–4、Table 1、Appendix B.2 及 Figure 12;最早日期另取 v1 元数据。v1 只有 Terminal-Bench,本文的三 benchmark / 九组合结果来自 v3,不能归到初版。代码固定版本为 2720dbb3f52283684f4b85a1065d642df1779dd8。
留言