让模型修改 Agent 程序,不能只看它改了多少行代码。HarnessOpt-Bench 固定初始程序、做题模型、运行环境和评分规则,让不同模型在有限试验额度内修改同一个起点。开发题可以查失败记录,验证题只返回总分,最终测试完全隐藏。要比较的是谁更会改程序,而不是谁换了更强的做题模型。
1. Motivation:为什么修改 Agent 程序需要单独评测
harness 修改是否有用,要通过昂贵、带随机性的任务执行来估计。软件补丁可以用测试检查;Agent 的提示词、历史压缩或退出逻辑改变后,往往要用固定模型跑许多题,才知道它是稳定进步还是一次幸运运行。
因此 optimizer 不只需要写代码,还需要决定查哪些失败、测试哪些候选、花多少预算,以及最终选哪一版。若不同研究各用不同的初始程序、模型、信息接口和预算,成绩混在一起,无法判断方法差别来自哪里。
本 benchmark 固定四项:初始 harness、target model、环境,以及来源 benchmark 的评分器(verifier)。这样,程序优化造成的变化才不会与换模型或更换判分规则混淆。作者研究三个问题:前沿模型是否能区分开,当前优化者在哪里失败,以及外层开发工具对结果影响多大。
2. Related Work:优化方法与统一赛道的区别
VeRO 提供实验设施,Meta-Harness 提出搜索方式,本论文规定一组统一的优化任务。它不提出新的训练算法或固定搜索算法;只要系统能在同样的信息与预算边界内编辑程序、选定版本,就可以参加。
| 工作 | 修改范围 / 模型角色 | 反馈与交付 | 此处的区别 |
|---|---|---|---|
| DSPy / GEPA | 优化声明式 LM 程序或可用文字表示的组件,模型参与提出候选 | 任务分数、反思反馈 → 更新后的组件 | 这里把整个可执行 harness 作为交付物,另外固定代码版本、预算与隐藏测试接口;不能把这些方法一概称为“只能改 prompt” |
| ADAS / AFlow | 搜索代码表示的 Agent 或工作流 | 由外部搜索程序管理候选、评测、选择 | 模型常是搜索过程中的一环,不一定自己分配完整优化预算 |
| VeRO | 允许 coding agent 修改目标程序 | 版本、预算控制、结构化执行记录 | 为受控优化提供设施,本 benchmark 在其上固定任务集 |
| Meta-Harness | 开发者读取历史代码、分数与轨迹,提出下一候选 | 完整优化算法 → 最终 harness | 这里比较算法或模型时,起点、预算和测试接口统一 |
| SWE-bench 等软件修复评测 | 改任务仓库里的软件补丁 | 原生软件测试 → PASS/FAIL | 这里改的是做题的系统,效果由多次随机执行的平均成绩衡量 |
四项任务为 OfficeQA、BrowseComp-Plus、Terminal-Bench 2.0 和 GAIA。前三项从能运行但未经优化的程序开始;GAIA 从不会做任务的代码占位开始。后者测“造出可用 Agent”的成分更大,不能无条件并入前三项的优化排名。
3. Benchmark / Protocol:一次优化实验:可见信息、预算和最终得分
optimizer 可以反复测试开发与验证题,却只能在最终选定版本后接受隐藏测试。先看起点与任务来源,再沿着一次代码提交走到分数。
3.1 固定任务与初始程序
作者沿用四个 benchmark 的任务和判断方式,再固定分区、初始 harness、target model 与评测服务。它没有重新标注一套独立题库,也没有报告新一轮标注者一致性。公开 release 在 VeRO 仓库内:各任务的初始程序、分区清单、构建配置和公共评测服务可核对;较大的原始任务数据需要另行下载。下面的成绩来自论文 v1,代码说明固定在 d140001…,不能把当前 release 当作论文原始实验的完整运行档案。
| 任务 | 固定 target model | dev / val / test | 初始 test 分数 |
|---|---|---|---|
| OfficeQA | DeepSeek V4 Flash | 49 / 98 / 99 | 0.341 ± 0.023 |
| BrowseComp-Plus | DeepSeek V4 Flash | 33 / 66 / 66 | 0.462 ± 0.020 |
| Terminal-Bench 2.0 | Grok Build | 17 / 36 / 36 | 0.241 ± 0.009 |
| GAIA | GPT-5.4 mini | 33 / 66 / 66 | 0,只写空答案的占位程序 |
数值来自 Appendix Table 3。这里的 ± 是三轮测试平均分的标准误:每轮先在整个测试区计算均分,再取这三个均分的样本标准差,除以 √3。它描述重复运行造成的波动,不是题目之间的得分差异,也不是下文用于判断胜负的 resolution band,更不是置信区间。当前配置则记录三轮均分的标准差;OfficeQA 还重新测定过初始分为 0.3412,三个均分为 0.354/0.296/0.374、SD 约 0.033。两份材料的数值和统计单位都不同,不宜直接替换或靠乘除 √3 强行对齐。
OfficeQA 当前初始程序给内层模型三个工具:run_shell 在 /app 运行命令,read_image 读取环境内图片,submit_answer 把最终字符串写入 /app/answer.txt 并结束。模型最多执行 24 轮决策;过长工具输出只保留头尾各 10,000 个字符。这些是可直接修改的程序部件,而做题模型 DeepSeek V4 Flash 不可替换。
GAIA 尤其容易用错起点。论文的 target-shell 能启动和结束,但不调用模型,只写空答案,所以得零分。当前仓库另有完整工具版 target,其初始成绩约 0.621 ± 0.052(SD);它不是论文的零起点。论文使用 Terminal-Bench 2.0,当前 release 标为 2.1,也需要分别注明。
3.2 开发区能查什么,验证区和测试区藏什么
| 分区 | 返回给 optimizer | 不返回什么 |
|---|---|---|
| dev | 题目、逐题得分、执行轨迹 | 不能修改 task data、模型、环境或评分器 |
| validation | 所选题目的汇总分;当前代码要求一次至少选 5 题 | 逐题输出与完整轨迹 |
| test | 搜索期间没有任何结果 | 测试题、答案和测试分数,均在可信服务侧隔离 |
optimizer 只能写目标 harness。所有模型调用经网关限制可用模型和额度;目标 Agent 在临时、非特权沙箱中执行。测试数据、凭证与预算管理不在 optimizer 的文件系统里,所以“不能偷看 test”由环境强制,不只是一句提示。
公开仓库能列出分区文件,不代表参加实验的 optimizer 被允许读 test。研究者下载 release,与 optimizer 在受限文件系统中搜索,是两种不同的信息权限。
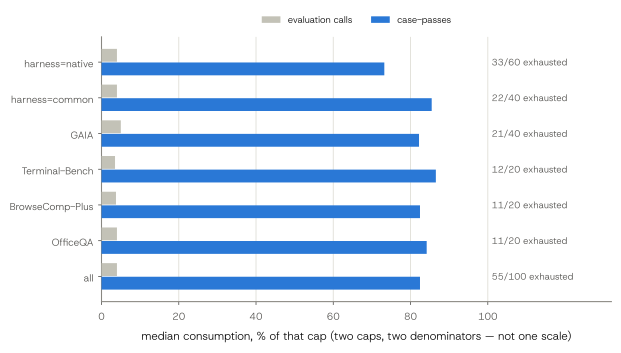
预算要区分两层。目标模型执行 token(模型处理的文本单位)有上限;optimizer 自己的推理 token 被记录但没有封顶。开发、验证分别最多四次 full case pass;选子集时按实际题数扣额度。API 调用次数的上限在 §3.1 写为每分区 100 次,在 §5.3 写为 200 次,§5.3 所写“8 次等于 4%”与 200 一致;Figure 15 展示的是预算比例中位数。当前 release 使用开发 100 次、验证 100 次,但这不能反推原始实验究竟按哪个数执行。当前 optimizer 还有 20 小时运行上限,沙箱最多 24 小时、空闲最多 1 小时;“optimizer token 不封顶”也不等于所有资源无限或各配置总算力相同。
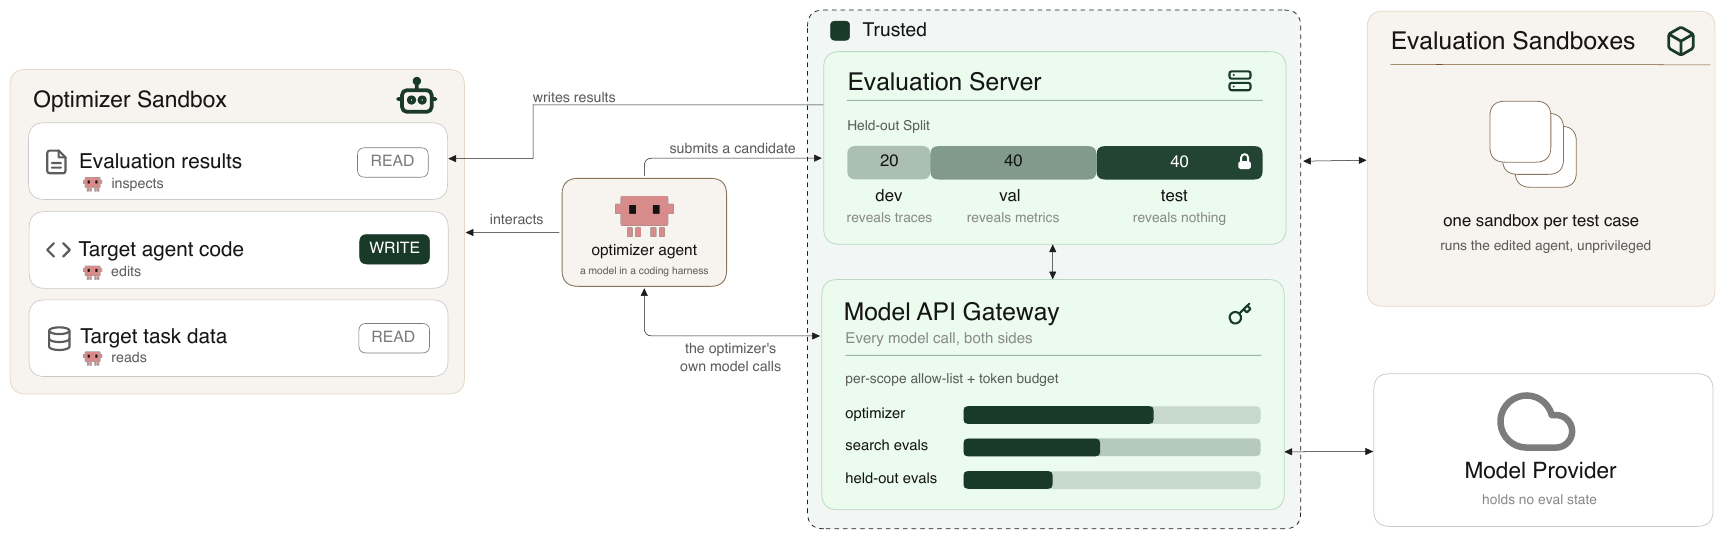
3.3 提交代码后,如何得到一个增益
- 选择版本optimizer 从自己保存的候选 commit 中指定一个最终 harness。
- 独立做题可信服务使用固定 target model,在隔离环境中对每道测试题运行这份冻结代码。
- 原生判分来源 benchmark 的 verifier 将实际执行与交付物变成 0–1 分,不能用目标 Agent 自报成功替代。
- 重复并汇总初始程序与最终候选分别对每道 test 题跑三次,平均得到测试成绩 E(H₀) 与 E(H⁺)。
搜索时每题只做一次;最终 test 每题做三次取均值。当前服务优先采用显式提交的版本;若没有提交,重测验证成绩最好的前三个合格候选再选;仍无法选择时,退回最近一次实际测过的候选,不是当前目录里尚未评测的最后修改。候选代码自身失败记零;基础设施错误按重试与排除规则处理。错误比例达到 0.1 时当前实现会把评测标为 INVALID,即 ≥10%,配置说明的“超过 10%”不够精确。
各任务也不是统一做字符串精确匹配。OfficeQA 使用数值/文本规则;BrowseComp-Plus 当前用 gpt-4.1 判断提交答案和隐藏标准答案是否语义一致。后者会把问题、答案前 100,000 字符及标准答案交给 judge,解析 correct: yes/no;缺答案、空答案、judge 请求失败或无法解析均给零。评测模型不参与优化,但它的误判仍可能影响最终分数。
g 是“拿回了初始程序剩余提升空间的多少”,论文称为 normalized gain。初始 0.4、改后 0.55,则 g=(0.55−0.4)/0.6=0.25。负数就是改差了。GAIA 初始为零,分母为一,因此它的 gain 就是最终测试原分,和另外三项不同。
每种 optimizer 配置独立优化两轮,表里报告两轮均值和 min–max。这两次优化重复,与每道测试题的三次做题重复不是一回事;两轮范围不是误差置信区间。
3.4 真实记录:一次 API 请求究竟花了多少额度
OfficeQA 的完整分区执行与论文预算统计
预算记录来自论文 Table 3、§5.3 与 Figure 15。
- OfficeQA 开发区 49 题,验证区 98 题。每区四次全量额度,分别允许累计执行
49×4=196和98×4=392题次。 - optimizer 若一次请求跑完 98 道验证题,API 只扣一次调用,验证题次却扣 98,即四分之一额度。连续请求四遍,只有四次 API 调用,却耗尽验证题次。
- 论文观察到 API 调用中位数仅为 8,但题目额度消耗中位数是 82%;预算统计覆盖的 100 个实验单元中,55 个耗尽至少一个分区的题次。
55/100 的预算统计与 111 次总有分数实验不是相同分母。以下单题例子再说明每个题次里究竟判什么。
3.5 真实任务 UID0185:查表、回归、写答案,最后检查什么
这是 release 开发分区实际列出的 officeqa-uid0185。题面和标准答案由 OfficeQA/Harbor 任务包提供,不是被测 Agent 生成;但这些文件没有逐题标注者或复核人员名单,不能据此声称经过几轮人工标注。本文核对的是 Harbor 数据仓库固定版本 37db108…;没有把它和论文原始打包任务的整体哈希对齐,所以它是当前可核对的同 ID 公开任务,不是论文某次模型成功日志。
- Agent 看到题面和
/app/corpus/中 697 份财政公报解析文本。题面要求找 1989 年 7 月至 1993 年 6 月的 48 个“月末联邦证券总额”,按四个年度各加 12 个月,再对年度与年度总和做线性回归,预测 1995 年总和,除以 12、四舍五入为整数。这里按题面指定的 July–June 分组,不应把它解释成美国实际财政年度的一般定义。 - 公开标准答案配置列出四份依据文件:
treasury_bulletin_1990_09.txt至1993_09.txt;Agent 要自己检索与取数,题面没有直接送出这些定位或答案。它可以写分析程序,但最终交付必须是/app/answer.txt,例如调用submit_answer({"answer":"4990256"})。这条调用用于说明接口,不是已观测的模型动作。 - 检查阶段读取隐藏的
/tests/config.json:标准答案为4990256,容许相对误差为0.01。evaluate.py先查答案文件存在且非空,再调用score_answer;对本题的无单位纯数字答案,PASS 条件就是|预测−4990256| / 4990256 ≤ 0.01。 - 直接运行该版本的官方
reward.py,4990256和5040158得 1;5040159得 0,因为它相差 49,903,略超过容许的 49,902.56。若忘记除以 12,写成59883072,也得 0。这些是本文构造的输入与检查结果,不是原论文模型失败轨迹。
这个 verifier 不查看 48 个数有没有找对,也不审计回归代码。更完整的数值解析还允许从带说明的回答中找到接近标准答案的数字,因此“按题面要求输出”和“被规则判为正确”也不完全等价。原始逐月取数、回归系数和实际模型执行日志未随这个任务文件提供,本文不编造中间表格。
officeqa-uid0185 的 instruction.md、config.json、evaluate.py、reward.py 整理。纯数字 PASS/FAIL 已用官方函数检查;不代表复现论文模型成绩。4. Experiments:谁更会改,以及哪些结论不能排名
优化模型的差别比外层工具的平均差别大,但没有一套工具对所有模型都更好。主实验为五个模型:Claude Opus 5、Sonnet 5、GPT-5.6 Sol、GPT-5.6 Terra、Kimi K3。每个都在公共 OpenCode 和自己的原生工具下运行;另有 GAIA 扩展工具以及 OfficeQA 的旧模型版本系列,总计 111 次有正式得分的优化实验。
4.1 先看噪声尺度,再看胜负
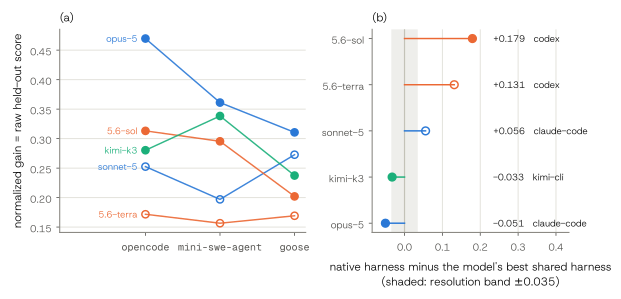
作者将同一候选在相同题上评分两遍,取两遍差异的中位数,并换算到三次测试重复的 gain 尺度,得到 resolution band:小于它的差别视为无法区分。四项分别是 OfficeQA ±0.045、BrowseComp ±0.066、Terminal ±0.054、GAIA ±0.035。它是描述性的分辨阈值,不是统计显著性检验或置信区间。
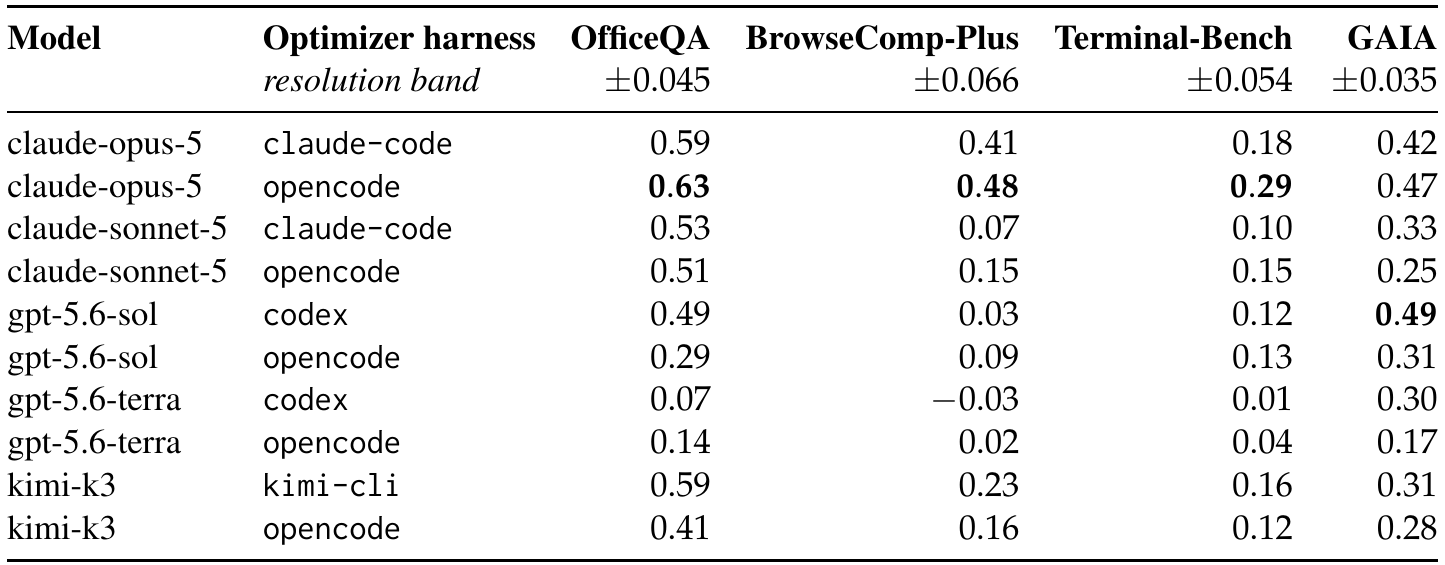
原表保留了全部十个“模型 × 外层工具”配置。Opus 的 OfficeQA 0.63−0.59=0.04 小于 0.045 的阈值,不能说 OpenCode 在这项已可靠胜过 Claude Code。Sol 的 OfficeQA 0.49−0.29=0.20 与 GAIA 0.49−0.31=0.18 则明显超过各自阈值,但仍只来自两轮优化,不等于跨任务普遍优势。
把一个真实报告数换回原分,更容易理解:OfficeQA 初始为 0.341,Opus/OpenCode gain 约 0.63,所以改后的两轮平均测试分约为 0.341+0.63×(1−0.341)=0.756。这是根据四舍五入的报告值计算的约数,不是论文另报的一次测试准确率,更不是 63% 的题通过。
4.2 模型、工具与失败诊断
在固定任务与外层工具的配对比较里,更换 optimizer model 导致 gain 平均变化 0.142;固定模型而更换工具,平均变化 0.079,约小 1.8 倍。这是配对差异的描述统计,不是“模型解释了 14.2% 方差”。
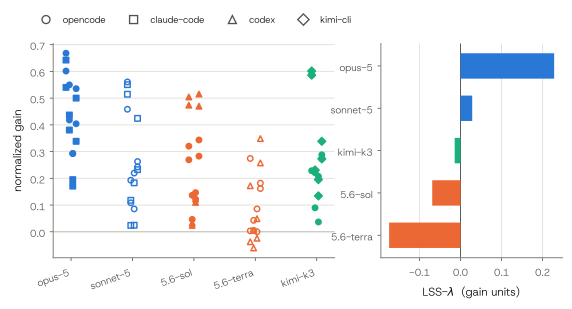
20 个“模型 × 任务”配对中,公共 OpenCode 赢 11 个、原生工具赢 9 个;其中只有 11 个配对的差异超过任务专用阈值。GAIA 加入 Goose 与 mini-swe-agent 后,工具排名随模型改变。相对于各自最好的公共工具,GPT-5.6 Sol 与 Terra 在 Codex 下分别高 0.179、0.131,均超过 GAIA 的 ±0.035 分辨阈值;Claude 与 Kimi 的原生工具差值在一到两个分辨带内。报告模型能力时,需要同时写明所用的外层工具。
论文另外计算一个跨任务平均值 λ:每个模型先取三项有完整初始程序任务的平均 gain,再减去所有模型的总均值。只用共同 OpenCode 条件,排除零起点 GAIA 和原生工具,才让这项“模型相对水平”保持一致比较对象;不能拿它代替包含全部配置的总榜。
作者还记录搜索过程。修改覆盖的八类部件越广,与 gain 的相关性通常越高,但覆盖面和总修改量混在一起;有配置改了七次、触及四分之三部件,最终仍提交初始程序。不能把这个相关性读成“改得越多越好”。
111 个有分数实验中,只有 7 个主动请求过详细轨迹,共 16 次;轨迹读取没有显示正向收益。这说明当前优化者很少有效使用这类反馈,或逐题分数已经足够定位部分问题,不能证明轨迹无用。可见验证最高分通常还高于最后测试分;论文不能区分这是反复选择造成的过拟合,还是验证与测试分布不同。
5. Discussion:更可靠的优化评测应补什么
最需要补的是原始执行记录、更多重复,以及初始程序强度的控制。程序、分区和公共服务已经公开,下一步应把论文各次实验对应的任务哈希、最终 commit、轨迹和配置关联起来,并解释 100/200 次上限冲突。尤其是当前 Terminal 版本、GAIA 起点与初始分重新测定,不能悄悄代替论文 v1 的条件。
其次,把外层推理成本也纳入同条件比较,增加 optimizer 独立重复,才知道收益是否值得其试验成本。每题三次运行能缓解目标 Agent 的随机性,却不能消除两轮优化选择的方差。
第三,系统改变初始程序的完整度:空占位、能运行但朴素、成熟 Agent 应分别报告,避免把构建能力与精修能力合成一个名次。最后,在不同 target model、工具行为和评分器实现上重放最终修改,检查它是否只适应固定评测的细节。这些是可信的下一步,不是本文已有验证结果。
6. Conclusion:借鉴控制设计,保留复现与统计边界
这篇适合学习如何把“改 Agent 程序”变成受控实验。它固定内层模型和任务环境,分开开发诊断、验证选择和隐藏测试,也把 API 次数与实际题次拆开,避免不同实验因反馈更多或模型更强而不可比。
前沿模型已经能改善弱起点,但收益随任务、模型和外层工具而变;微小差异不能细排名。最强限制是每配置只有两轮优化、GAIA 与其他三项起点不同、外层推理 token 未封顶、预算上限存在文本冲突,以及当前 release 与论文原始运行条件并不完全相同。
主要来源:arXiv:2608.06301v1 全文与附录,§§3–5、Algorithm 1、Tables 1–3、Figures 1/2/5/15;VeRO d1400011917ff66b7c122e7a787d547372f43e97 的 HarnessOpt-Bench release;Harbor 数据 37db108843a49bb31a592e37a75e2c40dc3f9749 的 UID0185。2026-10-20 复读全部 27 页,公开文件固定版本此前已核对;本文只复核了案例的判分函数,没有独立跑 111 次优化实验。
留言