一个支付工具返回“执行成功”,数据库却没有新增付款请求,Agent 随即宣布完成。该修提示、错误处理,还是结束条件?HarnessFix 把失败记录连到负责这些行为的代码,再让修复模型只改有证据指向的位置。论文的重点是把“任务没做成”变成可以验证的代码诊断。
1. Motivation:失败发生在哪一步,对应哪段代码
最终失败分数没有标明出错步骤,也没有指明可修改代码。运行记录混着模型调用、工具返回、文件变化和是否重试的决策。直接把长日志交给编辑模型,可能得到大范围修改,却说不清它为什么能解决这类失败。
作者分析 30 个开源 Agent 的约 57,780 条 issue、PR、commit 和 release 记录,经模型分类与人工抽查保留 26,174 条运行程序相关记录,占 45.3%。ETCLOVG 是七类运行职责的简称:执行环境与隔离、工具接口、上下文与记忆、生命周期与调度、日志与可观察性、验证与评测、权限与安全。它用来组织可修范围,不是七个新模型(Table I)。
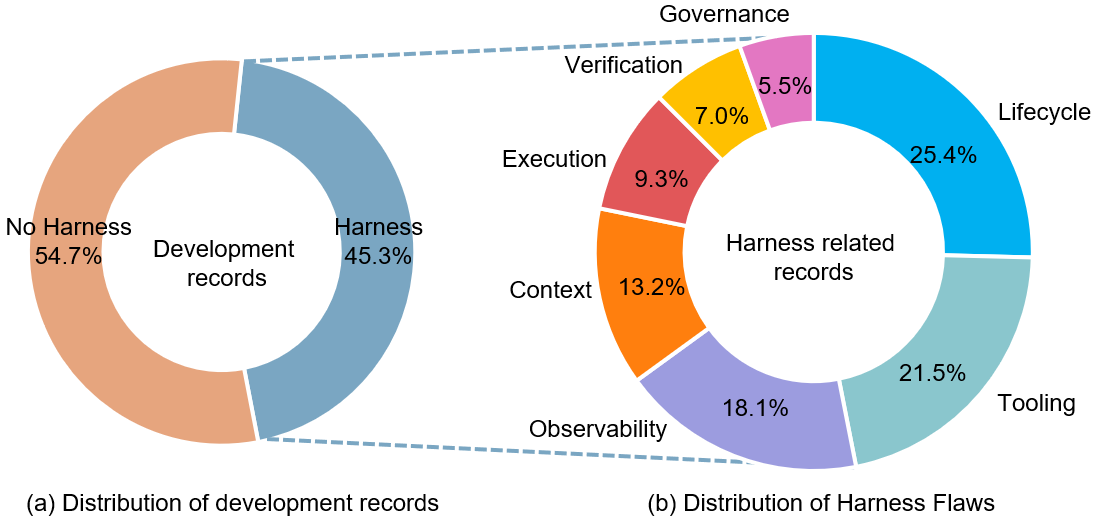
这个调查怎样变成可用的修复操作?固定仓库的 docs/motivation_study.md 给出过程:从四类任务中按 GitHub stars 选有可执行代码、公开历史的仓库,去重后得到 30 个系统。两名作者先看 100 条随机开发记录、形成判断标准;模型逐条分类并给证据,作者抽查后迭代提示。最后两人独立审计 300 条记录、第三人裁决分歧,报告 precision 97%、recall 94%:前者衡量判为相关的记录有多少真相关,后者衡量真实相关记录找回多少。作者再从 13,238 条关联了修复 commit/PR 的 issue 中归纳常见修改,形成 Table II 的修复操作。完整逐条数据和审计混淆矩阵未发布,这些百分比仍是作者报告。
2. Related Work:在补丁搜索前增加有证据的诊断
HarnessFix 在写补丁前,要求先指出失败步骤、对应代码和允许的修复。GEPA 主要改提示词;Meta-Harness 搜索候选程序。HarnessFix 增加一份可对应到实现的运行记录,让诊断模型回答:哪一步负责、哪个文件和函数实现它、违反哪类职责、允许怎样修。下一节的支付请求说明这份记录怎样构成,而不是只列出模块名。
| 对照 | 输入与产物 | HarnessFix 增加的约束 |
|---|---|---|
| GEPA / SCOPE | 任务得分、执行反思;修改提示 | 还能修改工具处理、程序控制与日志;具体到文件和行为 |
| Meta-Harness | 既有程序、得分、轨迹;搜索新程序 | 编辑前先形成责任步骤、代码定位和限定修复规范 |
| 失败归因 / AgentFixer | 失败轨迹;定位原因或推荐修复 | 继续生成实现修改,并在独立验证题中检查后果 |
3. Method:从支付失败记录到限定范围的补丁
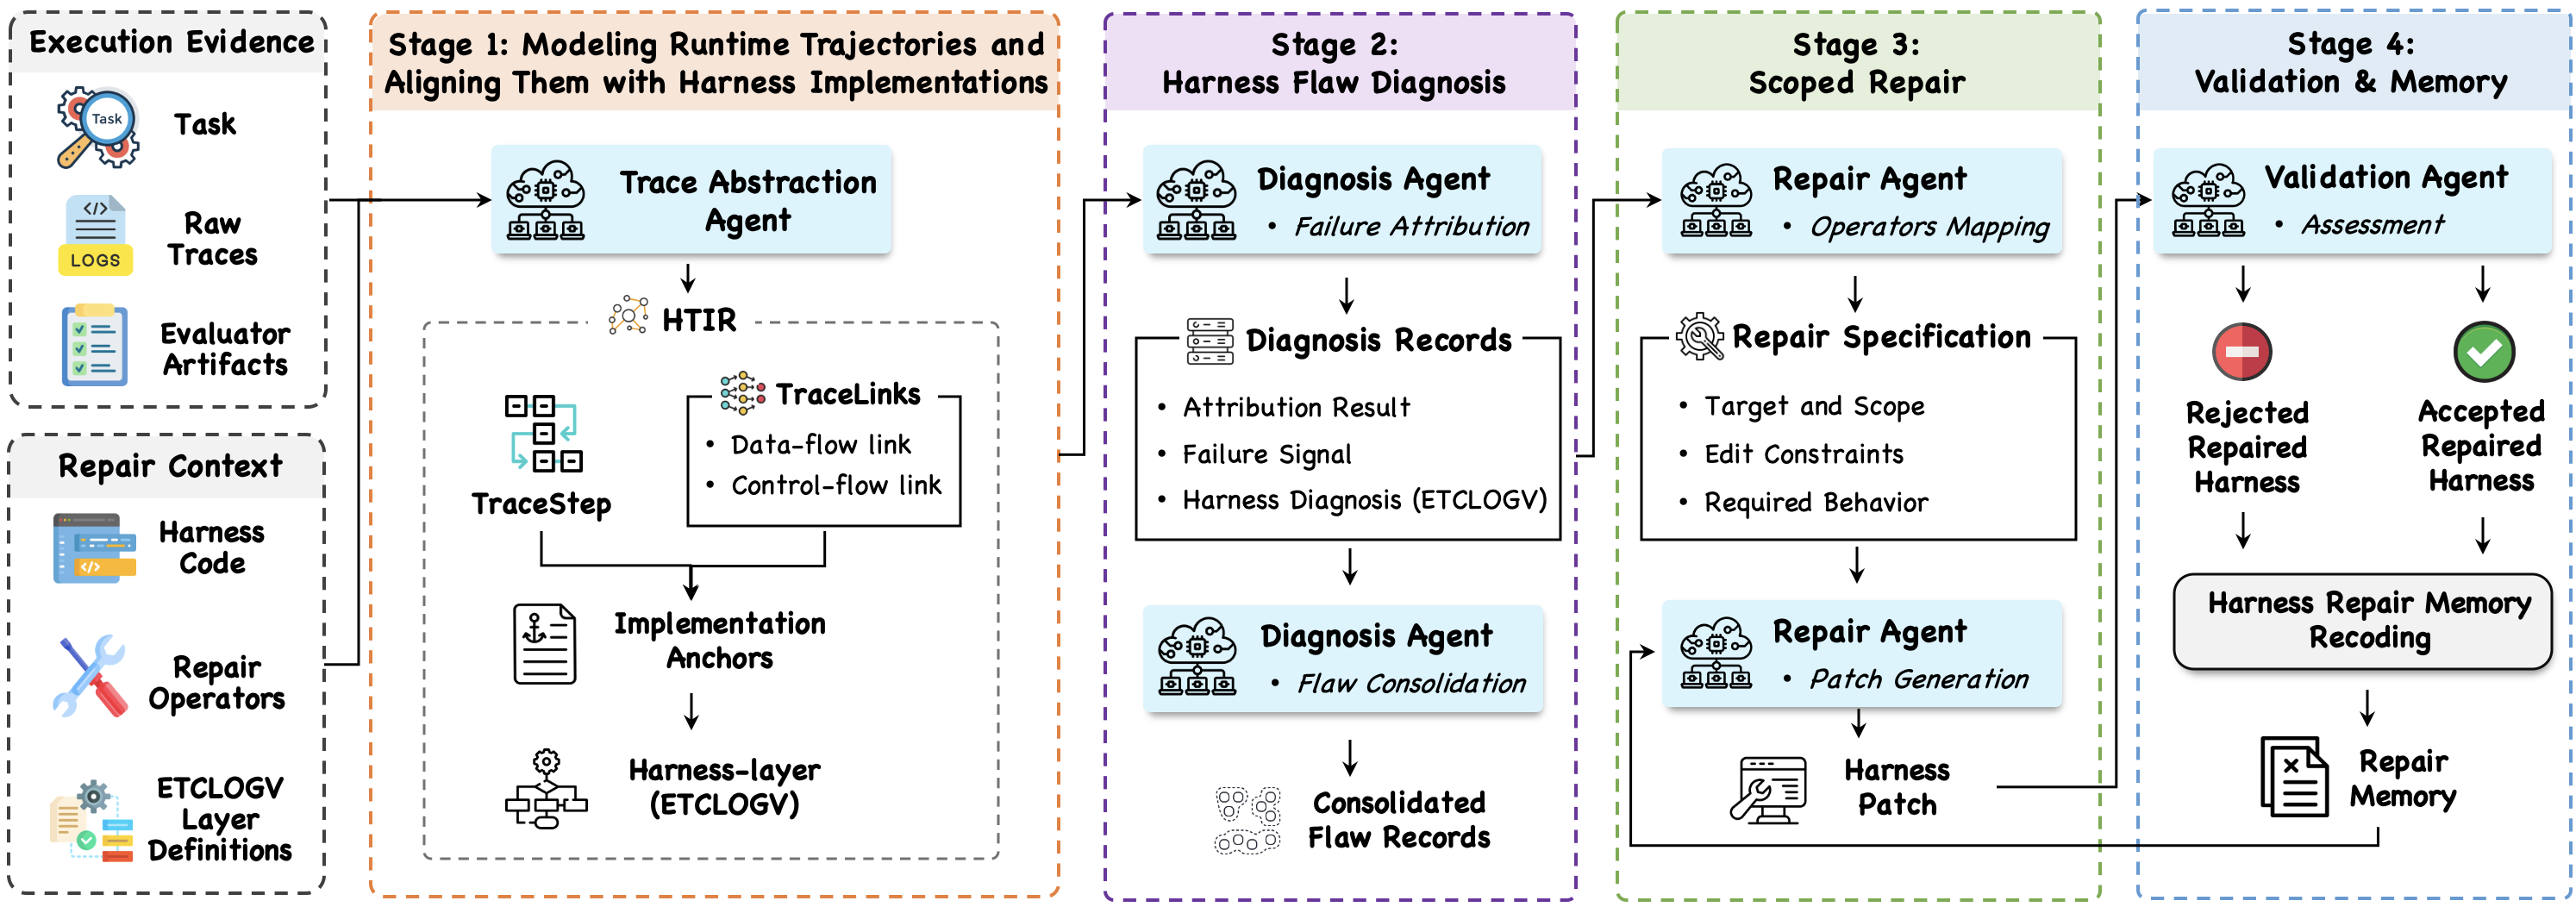
四个角色依次整理记录、诊断、写补丁和验证;前一个角色要给后一个留下可核对证据。整理角色把一次模型调用、工具动作或结束决策写成 TraceStep,记录输入、返回和真实外部变化。所有步骤加上跨步骤关系、代码位置后,形成 HTIR(Harness-aware Trace Intermediate Representation),即“能把这次运行对应到 harness 实现的记录”。
论文 Figure 3:请求分摊最近三笔 Amazon 订单费用
- Agent 先读
create_payment_request的文档,知道请求必须包含收款人的user_email。这是步骤 S3。 - Figure 3 的 S4 支付请求包含
amount=117.6和说明,却没有user_email。工具错误被运行程序捕获,外层仍返回成功状态;付款请求记录没有增加。 - S5 没有暴露真实状态变化,S6 的结束检查只看成功状态,允许调用
complete_task()。任务因此未完成。 - 整理角色连起 S3 的必填字段与 S4 的缺失请求。这种说明信息如何进入下一次输入的关系叫 data-flow link。它还连起 S5 的返回状态与 S6 的提前结束,这种说明代码为何继续或终止的关系叫 control-flow link。
- 整理角色指出运行程序里负责允许结束的函数与文件。这个附带证据的代码定位叫 implementation anchor,不是凭任务失败猜一个文件名。
- 诊断角色回溯这些关系,确认请求构造遗漏、错误被吞掉和没有效果检查共同造成失败;相同原因的记录合并为一类问题。
- 修复角色只能改结束检查及执行结果记录,不能改任务数据、标签和 API。要求是暴露支付错误,并在完成前看到实际
PaymentRequest变化。
这是论文贯穿方法的说明案例。v2 公开了步骤、请求金额、缺失字段与修复要求,没有完整 task ID、所有收款人记录或修补后的逐条运行日志;不能写成“这道题已实测拿到 1 分”。
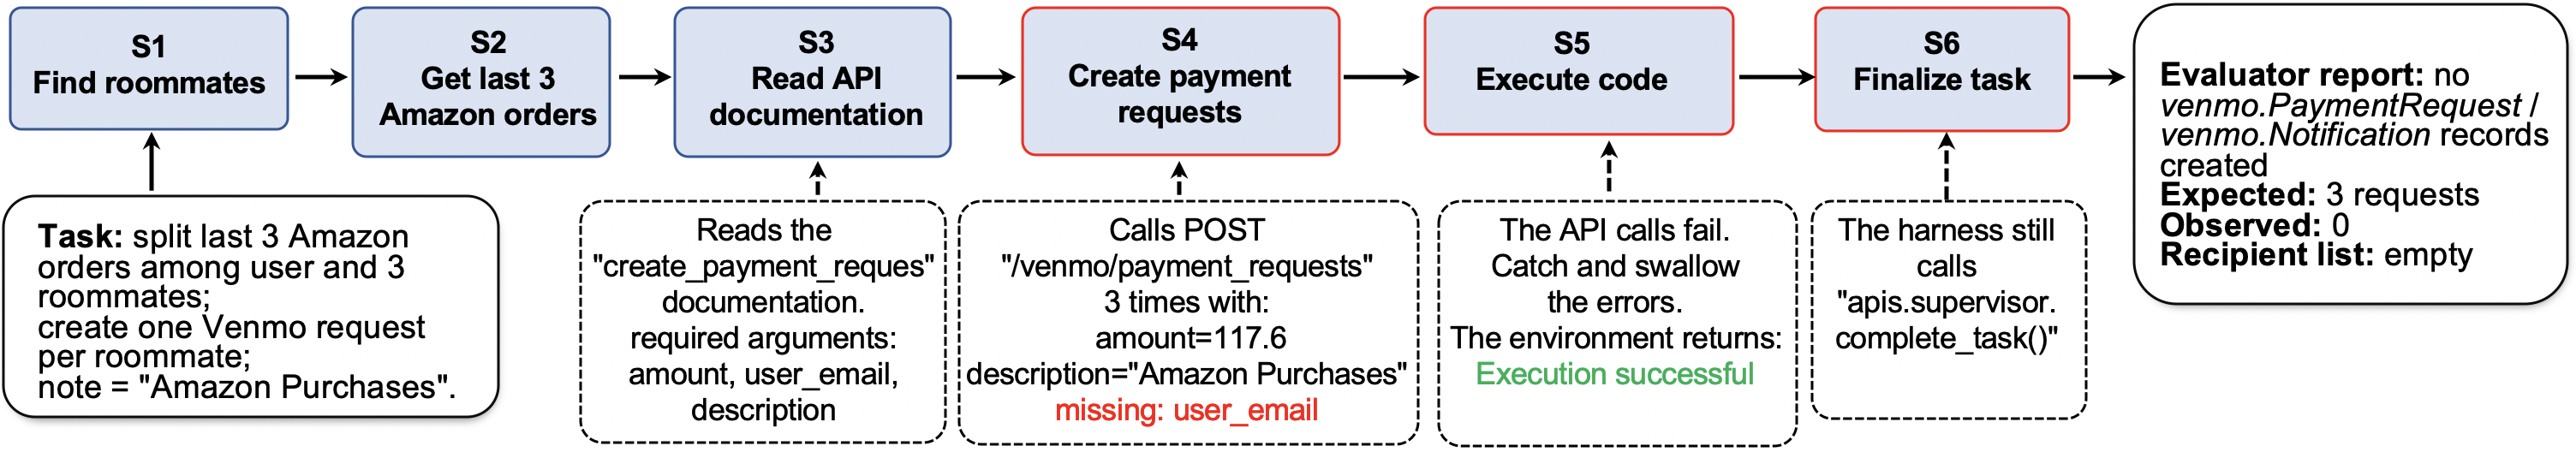
user_email,请求却遗漏;图中的金额为 117.6。来源:Mengzhuo Chen 等,arXiv v2,CC BY 4.0;裁切并遮去左上角相邻 S2 的残边,S3–S5 内容未改。点击查看完整原图。论文自身的金额有一处不一致:§III-A 的结构化请求摘录写 54.0,Figure 3 原图写 117.6。上面的原图按 Figure 3 展示;两处共同的诊断证据是漏传 user_email、API 错误被吞掉,以及预期 3 条付款请求而实际为 0。论文没有给出可核对这一金额差异的完整执行日志。
系统把允许文件、禁止文件、目标问题和修改后必须满足的行为写进 repair specification,即当前补丁的范围和验收条件。验证角色先查代码改动是否越界、语法和静态检查能否通过,再在验证集上重跑:目标问题是否减少,原有成功是否被破坏。有效补丁及其证据保存在修复记录库(harness memory)中,供后续修复避免重复尝试(v2 §III-C/D)。
公开验收脚本允许有限回归。固定版本 check_val_gate.py 默认要求净解决任务数至少增加 1,同时退化的旧成功任务最多 2 个;提供前后轨迹时,还要求目标行为指标至少一项改善、总变化不小于 0。比如旧成功集合是 {A,B,C,D},新集合为 {C,D,E,F,G},丢失 A/B 两题但净增一题,这层默认任务数量检查仍通过。这是假设算例,不是论文的实际候选。代码虽然有 --max-cost-ratio 参数,却明确将成本只作报告,不参与接受;这些是当前代码默认值,不能反推每个论文实验都用了同一命令。
4. Experiments:任务成功率、诊断标注与关键消融
任务分数由上游 benchmark 的最终验收决定,诊断准确率另有人工标签。GAIA 的题目来自公开开发集;SWE 来自真实仓库修复题;AppWorld 用应用状态测试;Terminal-Bench 在容器中执行终端任务。作者分别从 166/500/750/89 题中抽取 150/250/225/85 题,再按 train/validation/test 拆成 60/30/60、100/50/100、90/45/90、34/17/34。搜索用训练与验证数据,主结果在固定 test split 统计任务完成率 TCR;表中分数是三次独立运行的算术平均,不是一次最好结果。
诊断没有由任务测试自动生成的标准答案。作者在最终 harness 冻结后,从四基准各取 20 条初始程序失败轨迹,共 80 条;三名标注者独立读原轨迹、代码/提示、任务元数据和评测反馈,不看 HarnessFix 的预测诊断,标出责任步骤、原因、实现位置、职责层和修复范围,再裁决分歧。裁决后的标签称为 gold,只用于诊断评测,不用于修补或选版本。
仓库公开了标注流程与 Fleiss' kappa,即扣除偶然一致后的人际一致性:步骤 .76、原因 .74、代码位置 .73、职责层 .80、修复范围 .75。它们不是模型准确率。评测四种输入表示时,诊断模型相同,只有输入表示改变;原日志的责任步骤准确率 55.0%,加数据关系 70.0%,再加控制关系 77.5%,完整 HTIR 为 85.0%。尚缺 80 条轨迹 ID、逐人标签、裁决后的每行 gold 和预测,不能独立重算这些结果,但不能说人数和一致性没有公开。
固定 GPT-5 mini 时,HarnessFix 在 GAIA、SWE、AppWorld、Terminal-Bench 2.0 分别把初始 harness 从 43.3→61.7、45.3→57.3、36.7→43.0、17.6→26.5。对应提升 18.4/12.0/6.3/8.9 个百分点。论文摘要的 6.3–18.4 是这个默认模型范围;Table III 的五模型结果还包含 DeepSeek/AppWorld 的 5.9。相对 Meta-Harness,四基准分别高 5.0/2.6/2.6/3.0 个百分点。
| GPT-5 mini · Table IV | GAIA | SWE | AppWorld | Terminal |
|---|---|---|---|---|
| 原程序 | 43.3 | 45.3 | 36.7 | 17.6 |
| Meta-Harness | 56.7 | 54.7 | 40.4 | 23.5 |
| HarnessFix | 61.7 | 57.3 | 43.0 | 26.5 |
| Meta-Harness 开发 token · 百万 | 94.2 | 82.9 | 74.6 | 66.8 |
| HarnessFix 开发 token · 百万 | 57.6 | 48.9 | 37.2 | 33.5 |
Meta-Harness 在这套统计下多用 63.5%–100.5% 的 token;仅统计离线演化/修复,排除收集轨迹的做题 token,不等于总体部署或研究成本减少相同比例。默认 task/repair 模型均为 GPT-5 mini,temperature=1、medium reasoning。最大回合、工具、总搜索成本不能只从这张表推断。
对照人工标签,完整 HTIR 的原因准确率为 83.8%、代码定位为 81.3%、操作选择为 82.5%。职责层 macro-F1 为 86.2%:先算各类 F1 再等权平均。GAIA 迁移实验直接复用 GPT-5 mini 修好的同一个 harness,不对目标模型重新诊断;四模型提升 5.5–9.5 个百分点,明显低于为它们专门修程序的 Table III,不能混成同一结果。
论文报告单侧配对符号检验 p 值为 2.4×10⁻⁴ 到 4.9×10⁻⁴。逐题重复输出未完整公开,因此本文未重算该检验,也不将跨论文的步骤定位分数当成同一测试集的直接比较。
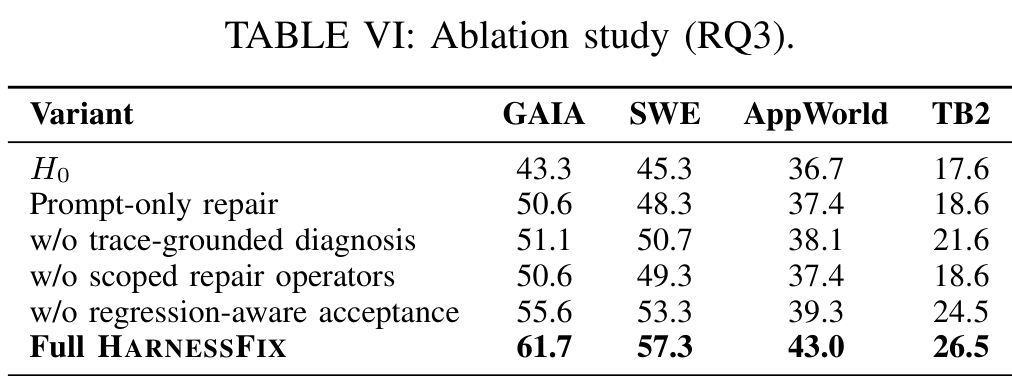
只改提示词达不到完整方法的收益。Table VI 中,GAIA 只修提示词的成功率为 50.6%,完整系统为 61.7%;去掉有运行证据的诊断后为 51.1%,去掉限定修复操作后为 50.6%,去掉回归验收后为 55.6%。这些都是在原起点 43.3% 上比较,说明结构化诊断和候选筛选都参与增益;没有证据支持某一个模块独占全部效果。
5. Discussion:公开诊断标注和失败补丁
下一步应公开逐条数据,使已经公布的标注流程可复算。固定仓库 9167a0b9a58748c73b56c3ee04fdc3437ba0c56e 有分类、审计与诊断标注说明,但没有足够的记录 ID、模型判断、逐人标签和裁决数据。还需要原始/候选程序、失败补丁、依赖与运行输出,分别复跑“定位对了”与“任务提高了”。比较诊断方法时还应保持同模型、同 token 和同检索内容预算,区分显式关系结构的作用与额外输入信息的作用。
6. Conclusion:把运行事实连到可改代码
HarnessFix 最值得复用的要求是:补丁必须说明哪个运行事实对应哪段可改代码。四个 benchmark 都有提升,单独修改提示又明显弱于完整方法。官方已经公开开发记录的筛选与人工标注流程;尚缺逐条记录 ID、标注标签和预测行,外部读者仍无法重算全部诊断指标。
本文方法和结果按 arXiv:2606.06324v2 的 Figure 3、§III–V、Tables III–VI 核查;最早日期另取 v1 元数据。代码固定版本为 9167a0b9a58748c73b56c3ee04fdc3437ba0c56e。论文中的案例是方法说明,不是公开的完整逐题 checker 记录。
留言