同一个 coding model,换一套 harness,成绩可能相差四倍。那把多种 harness 的 rollout 混在一起做 RL,学到的是可迁移的 coding 能力,还是对训练配置的适应?这篇论文固定模型起点、训练记录、reward、token、loss mask 和更新次数,只改变 GRPO 的分组边界,再把 checkpoint 放进训练时从未出现的 weak-ReAct 接口测试。
Q1. 为什么要把 multi-harness RL 拆成“见过多种接口”和“跨接口比较 reward”?
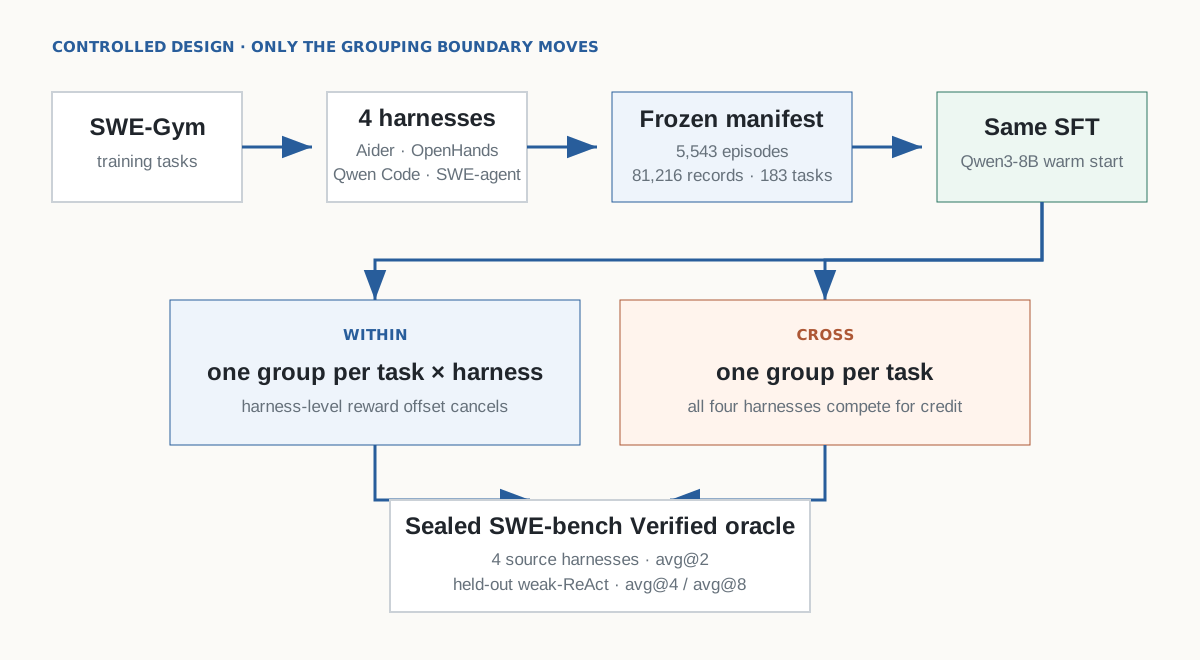
因为这两个干预在已有工作里经常同时发生,最终涨分时很难知道是哪一个起作用。 ClawGym II 按 task-harness pair 分组,HarnessX 则让同题在不同 harness 或模型版本下的轨迹直接竞争。两类系统还同时改变数据量、rollout 方式、训练阶段和评测接口,端到端成绩不能回答分组边界本身的作用。
Harness 不是薄薄的一层 prompt。它决定模型收到什么 observation、能调用哪些 tools、怎样重试、何时截断上下文,以及最终怎样提交 patch。论文先用六个 checkpoint × 四套评测 harness × 500 题 × 两次尝试构造 24,000 次评测。列均值从 2.14% 到 9.27%,相差 4.3 倍;训练 recipe 的行均值只有 5.55% 到 6.46%,相差 1.16 倍。
这意味着同一 checkpoint 在一套界面里不会做,并不等于模型没有对应能力;反过来,训练后只在原生 harness 上涨分,也不能自动解释成模型把能力内化了。论文把“换到 unseen harness 后是否还涨”作为 portability 的操作性定义。
Q2. 它和 HarnessX、ClawGym II、POLAR、OpenForgeRL 的边界在哪里?
这篇论文做的是一组把 credit-assignment boundary 单独隔离出来的因果对照。 它不训练更大的系统,也不追求比同期工作更高的绝对分数;证据价值主要来自控制变量和负结果。
| 工作 | 多 harness 怎样进入训练 | 怎样评测 | 本文关心的证据边界 |
|---|---|---|---|
| ClawGym II | 一个 policy 接收多种 harness rollout;advantage 在 task-harness pair 内标准化 | 原生 harness 与跨 harness transfer | 对应本文的 Within 思路,但它还改变了数据和训练系统。 |
| HarnessX | 同题在连续演化的 harness / model 版本间共享 GRPO group | 整体 recipe 的 end-to-end 结果 | 对应 Cross 思路;版本演化与 credit rule 没有被拆开。 |
| POLAR | 通过 production harness 做原生 GRPO | 各 checkpoint 在自己的训练 harness 上测 | 报告 +0.6 到 +22.6 pp 的 harness-indexed gain,不能单独识别 portability。 |
| OpenForgeRL | SFT distillation 与 RL rollout 都使用三种 harness | ClawEval held-out gain +9.5 / +20.3 pp | 同时改变 exposure 与训练阶段,不能把收益只归给 cross-harness credit。 |
| Orchard | 完整 harness 产生 SFT 数据 | 2×2 matched / mismatched harness | matched 53.5–57.9%,mismatched 19.0–28.0%,直接暴露接口锁定。 |
| 本文 | 四 harness exposure 完全相同,只移动 GRPO group 边界 | 四个 source harness + unseen weak-ReAct | 能回答“跨 harness 比较 reward 是否额外带来 portability”。 |
论文因此适合作为其他大系统论文的 negative control,也就是用严格控制的负结果检验宽泛解释。它排除了一个较窄的说法:只要把不同 harness 的二值结果放进同一个 GRPO group,模型就会自然学到 interface-invariant policy。 Multi-harness exposure、更多任务和更长训练是否有效,不在这组实验的否定范围内。
Q3. 数据、分组、sealed oracle 和一条真实 case 到底怎样串起来?
3.1 训练集从哪里来,谁产生什么
训练 trajectory 来自 SWE-Gym,评测使用与它按 benchmark family 分离的 SWE-bench Verified。作者先让四套 harness 在同一训练池上运行,再从 1,008 个已评分任务中选择 183 个“不同 harness 结果不一致”的任务。只有这些任务的 pooled group 有非零 reward 方差,能给 Cross 提供梯度。
SFT warm start 使用 186 个任务、8,841 条成功轨迹 records。这里的 record 是从 trajectory 中拆出的训练记录。四个 RL arms 都重放同一份冻结 manifest:183 个任务、5,543 个 episodes、81,216 条 records,并都完成 81,200 个 optimizer steps。Task 与测试来自 SWE-Gym / SWE-bench;本文作者没有重新人工编写问题或测试。作者负责采集、筛选、分组、训练和统计分析。
论文也把运行环境锁到了具体版本,避免“同名 harness”掩盖实现差异:Aider 0.86.2,OpenHands SDK 1.0.0a6 与 openhands-ai 0.62.0,Qwen Code 0.19.3,SWE-agent / SWE-ReX 1.1.0 / 1.4.0;训练栈是 torch 2.6.0、transformers 4.51.3、verl 0.4.1,评测使用 swebench 4.1.0 与 udocker 1.3.17。
3.2 Within 与 Cross 的差别只有分母里的同伴
对 task x、harness h、第 i 条 rollout,reward r(x,h,i) 只有 0 或 1:
Within 只和同一 harness 的其他尝试比较,所以 harness 整体更强或更弱的 offset 会被消掉。Cross 把四种 harness 混在一起;如果 OpenHands 在训练任务上的成功率是 27.0%,Aider 只有 6.9%,模型经由 OpenHands 得到的 rollout 会系统性拿到更高 advantage。论文后面的 classifier 正是在测这部分 harness identity。
# 解释性伪代码;不是论文公开仓库中的实现
for task in frozen_manifest:
    if recipe == "Within":
        groups = group_by(task, harness)
    elif recipe == "Cross":
        groups = group_by(task)  # pool all four harnesses
    advantage = zscore(binary_oracle_reward, within=groups)
    update_same_policy(records, advantage, masked_observation_tokens=True)
3.3 一个 episode 怎样得到 0 或 1
每道题都有一个 sealed per-instance oracle,也就是只服务于该实例的隐藏测试。评测 Agent 能看到 GitHub issue、固定在 base_commit 的 repository、harness 提供的 prompt / tools,以及命令输出。它提交 patch 后,评测器才在隔离容器中应用 patch、运行隐藏的 test_patch,再把日志解析成测试状态。任务要记作 resolved,FAIL_TO_PASS 必须全部从失败变成通过,PASS_TO_PASS 也必须全部继续通过。空 patch、patch 无法应用、缺少测试输出或必要测试失败都不会得到 1;基础设施错误被单列并排除,不冒充模型失败。
Source matrix 用 avg@2。held-out weak-ReAct 先用 avg@4,三条主要 checkpoint 又加密到 avg@8。每个 cell 只纳入达到至少 95% graded coverage 的数据;对比在 task 层配对,bootstrap 也按 task cluster 重采样 10,000 次。
3.4 真实 case:astropy__astropy-12907
这条 case 是 SWE-bench Verified 官方 500 题中的第一条,也在本文声明的完整评测 roster 内。问题是 separability_matrix 在嵌套 CompoundModel 中错误地把两个独立 Linear1D 分支判断成互相依赖。
从 issue 到 verdict
- 来源:Astropy 的真实 issue–PR 对;Verified 数据维护者对原始 SWE-bench 样本做人工质量验证。本文直接使用这套任务,没有重新标注。
- Agent 可见:issue 正文、Astropy repository 的 `d16bfe05…` 基线版本,以及当前 harness 暴露的工具和输出。金标准 patch 与隐藏 test patch 不提供给 Agent。
- Agent 要做:定位组合模型构造 separability matrix 的逻辑,提交 repository patch。
- 隐藏检查:两条 `FAIL_TO_PASS` 覆盖嵌套组合形式,13 条 `PASS_TO_PASS` 覆盖原有坐标矩阵、stack、算术组合与其他 separability case。
- PASS:候选 patch 能应用,2/2 新回归测试与 13/13 原有测试全部通过,episode reward 为 1。
- FAIL:如果 patch 只修正 `rot & (sh1 & sh2)`,却让另一种嵌套组合仍得到耦合矩阵,至少一条 `FAIL_TO_PASS` 失败,整个 episode reward 为 0。这是按公开 test list 推导的解释性轨迹,不是论文发布的模型日志。
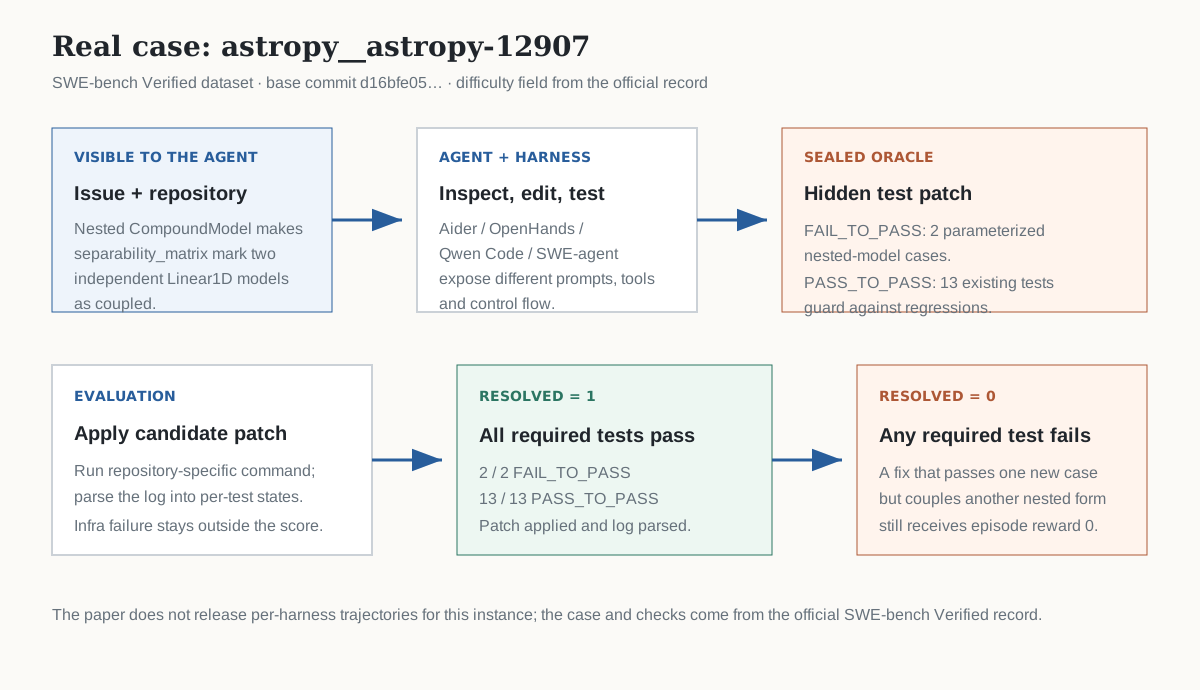
论文说所有数字都由 results/postfreeze_2026q3/ 下的 JSON 和脚本生成,也说 weak-ReAct 与 grader 随 artifact 发布。但 arXiv 页面、PDF 和 source archive 没有给出 artifact URL;截至 2026-09-29,我无法独立检查这些文件。上面的真实 case 与 judge 来自官方 SWE-bench Verified 数据和论文锁定的 swebench==4.1.0,并不等价于本文缺失的 per-harness episode logs。
Q4. 结果支持“学会了什么”,又排除了什么?
4.1 Source harness 上有小幅 gain,但最大变量是评测接口
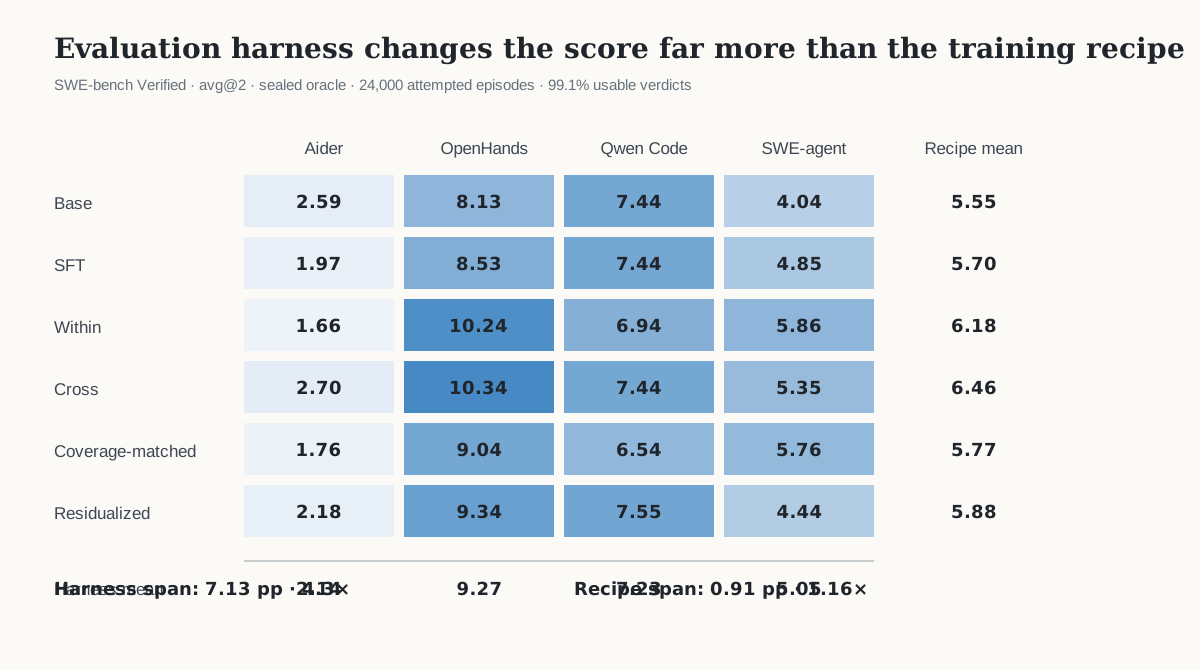
Cross 在四个 source harness 上的平均成绩是 6.46%,SFT 是 5.70%,差值为 +0.77 pp,95% CI [+0.03,+1.52]。论文预先对五个 recipe 对比做 Bonferroni 修正后,99% CI 变成 [−0.21,+1.75]。四列里的最大增益是 OpenHands 上的 +1.81 pp;Within 也把最大增益放在 OpenHands,幅度 +1.71 pp。两条 RL 线都把最大收益留在训练时见过的配置上。
第二个 model family 也说明“harness 强弱”不能当成固定常数。Seed-Coder-8B 在 weak-ReAct 上是 5.00%,与 Qwen3-8B 的 4.07% 接近;换成 Aider 或 SWE-agent 后,它相对自己的 weak-ReAct 分别下降 4.41 与 4.40 pp。OpenHands 和 Qwen Code 的 2,000 次尝试全部没产出 patch,因此记为 not measurable,没有被硬算成 0。
4.2 Held-out 上没有检测到 Cross 的额外 portability
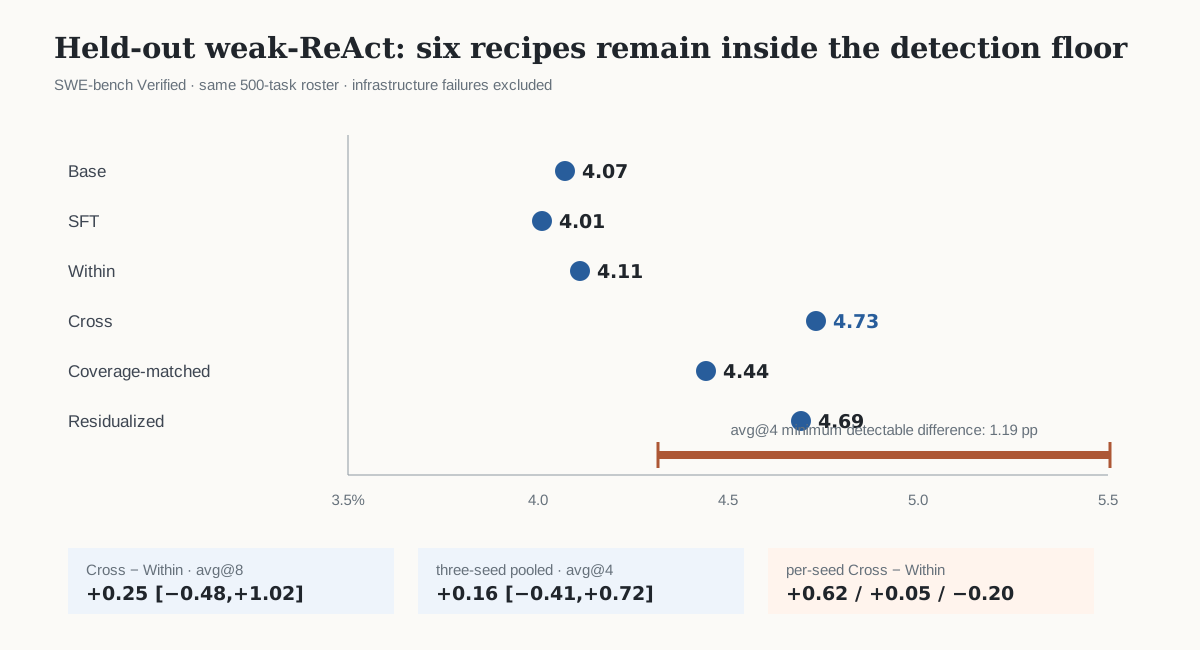
把尝试数从 4 加到 8 后,Cross − Within 从 +0.58 pp 缩到 +0.25 pp,95% CI [−0.48,+1.02];Cross − SFT 是 +0.13 pp [−0.65,+0.92]。三 seed 合并时,Cross − Within 为 +0.16 pp [−0.41,+0.72],而三个 seed 的单点差值是 +0.62、+0.05、−0.20 pp,符号会翻转。
这组结果支持“没有检测到大于约 1 pp 的稳定收益”,不支持数学意义上的完全等价。avg@8 的 80% power 最小可检差异仍为 0.88–1.14 pp。比它更小的真实收益,实验没有足够精度排除。
4.3 Cross 确实污染了 advantage,但污染没有变成可见行为差异
作者训练一个 out-of-fold classifier,只看 advantage 就猜它来自哪套 harness。Within 比各自 shuffled-label null 高 +0.02 pp,区间跨 0;Cross 高 +4.48 pp [+3.22,+5.83]。Coverage matching 还剩 +1.17 pp;Residualized 反而是 +4.54 pp,因为它从 1,008 个多数全失败的任务估计 baseline,实际只消掉 183 个 disagreement tasks 中 9% 的 offset。
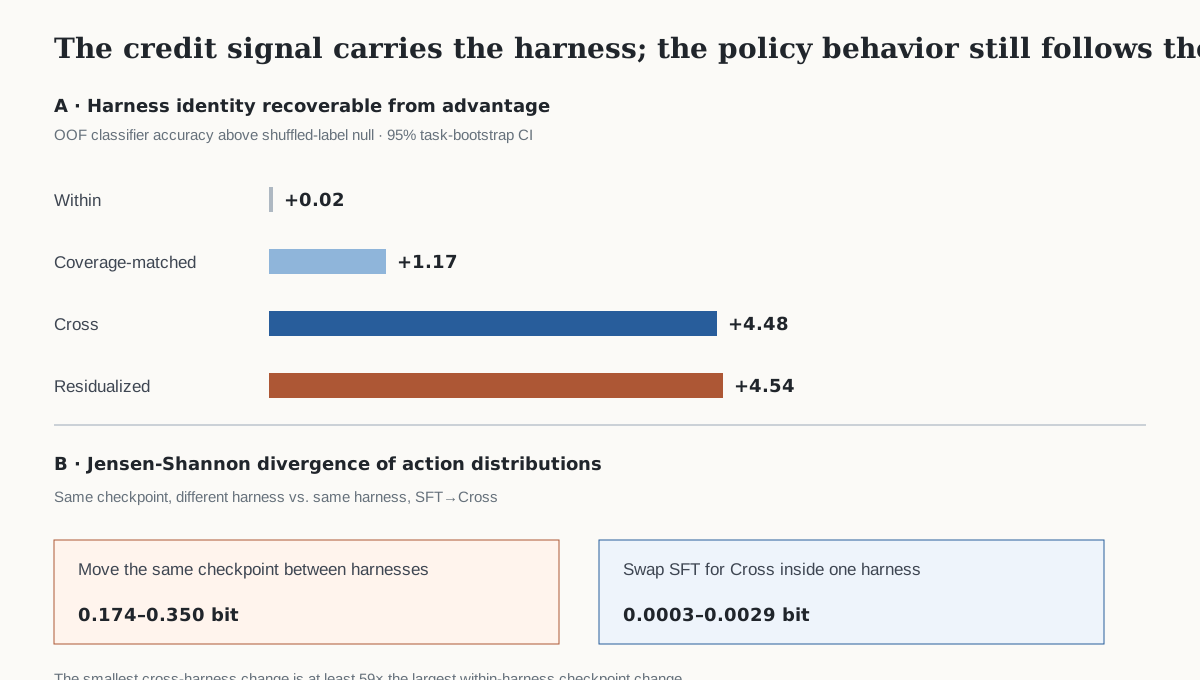
行为侧的结果更直接。同一个 checkpoint 换 harness,action composition 的 Jensen–Shannon divergence 是 0.174–0.350 bit;同一 harness 内把 SFT 换成 Cross,只有 0.0003–0.0029 bit。160 个 turn 的人工抽查里,rule-based labeler 错了 11 个,其中 8 个来自 SWE-agent。即便考虑这项噪声,两个量级仍相差很远。
4.4 冻结 replay 和基础设施是否把结果做平了?
论文额外训练了一条 re-collected Cross:前半程重放冻结数据,后半程让半训练 policy 重新跑四种 harness。它相对 offline Cross 为 +0.13 pp [−0.85,+1.10],相对 Within 为 +0.75 pp [−0.10,+1.65],仍没有显著差异。
Appendix H 披露了五类会悄悄改结果的系统故障:跨条件 container 污染、model registration race 导致约 20% episode 丢失、UTF-8 grader crash 压低可用分母、container Git 损坏,以及 hollow image cache 把每轮截断在 25 题。作者修复后重新验证。这份清单说明一次 harness 实验要在哪些位置设置 fail-closed 检查。
Q5. 对 Claude Code、Codex 这类完整 harness,下一步最值得做什么?
训练报告至少要把 exposure、credit grouping、source gain 和 held-out gain 分开写。 只报一个多 harness 总分,读者无法知道模型看过哪些接口,也不知道正负梯度是在什么比较组里产生的。
如果要继续做这个方向,我会优先补四组实验:
- 用 Claude Code、Codex CLI、OpenHands 等真实 interface 做完整 train-harness × eval-harness 矩阵,同时固定 model、task、budget 与 grader。
- 除二值 episode reward 外,引入 tool-level 或 phase-level credit,检查更细的归因能否带来 portability。
- 把 residual baseline 只估计在真正产生梯度的 disagreement population 上,并和 learned baseline、per-step value、hindsight credit 对照。
- 把 held-out harness 从一个简化 weak-ReAct 扩展到多种未见 prompt schema、tool vocabulary、context policy 与 recovery strategy,分别测哪一层能迁移。
对产品系统也有一个直接提醒:同一个 model 在不同 harness 上可能呈现完全不同的成功率和动作结构。模型评测、上线配置与安全评估都应把 harness 名称、版本、tool schema、rollout 数和 grader 一起记录。
Q6. 最后怎样评价这篇论文?
论文的证据强度主要来自控制变量。作者把 exposure 固定,只移动 credit-assignment boundary,再用 held-out interface、三 seed、avg@8、re-collected rollout、minimum detectable difference 和 action JSD 从不同角度检查同一个结论。
我的结论是:它是一篇很扎实的负结果,也给出了 multi-harness RL 应有的最低对照标准。 对 Claude Code、Codex harness 研究而言,训练和评测都要把接口当成一等变量。若要声称模型学到了可迁移能力,证据必须来自未见过的 harness。
留言