[2026-10-04] Self-Evaluating Recursive Agents
Agent 拆出的子任务没有现成答案,怎样训练它评价这些任务?SERA 让同一模型写评分条件、执行与评分。本文用公开两菜任务的实际程序重放,讲清三种训练奖励、最终验收和关键负结果。
Agent 拆出的子任务没有现成答案,怎样训练它评价这些任务?SERA 让同一模型写评分条件、执行与评分。本文用公开两菜任务的实际程序重放,讲清三种训练奖励、最终验收和关键负结果。
强模型只留下成功做过哪些操作,也能帮助训练吗?本文通过取消订单的真实记录,解释 π-Distill 如何让同一模型在带参考记录和不带记录的两种输入下共同学习,并核对奖励、概率约束和评测选择。
答对选项也可能看错图。V-Rubrics 把视觉事实、推理和输出要求分开判分,再将每项训练信号分配给回答的相应前缀。本文用公开潮汐题复算奖励,核对原论文图表与代码边界。
GAGAR 如何比较多次通过测试的代码修改质量,再重新分配训练权重;拆解判分 Agent、计算公式、训练结果、带上限的实现与未公开证据。
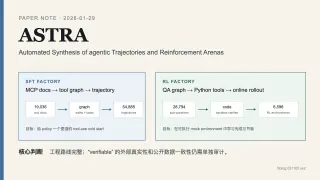
ASTRA 先生成工具调用示范,再把多步问答写成可执行的模拟工具,用模型自己的执行结果继续训练。本文分开解释数据构造、环境检查、训练奖励、行李加购真实样本及公开代码与论文的差异。
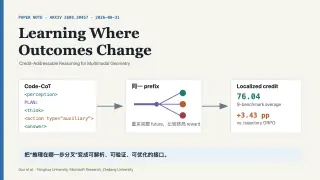
把几何解题过程写成带标签的步骤,固定某一步以前的内容,再从这里生成不同完整解法,用最终分数差训练后半段。结合等腰三角形真实案例,说明数据来源、评分、更新范围与实验限制。
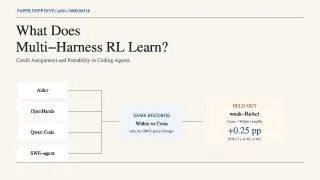
同一批编程执行记录,按接口分别比较成绩,或把同题不同接口的成绩合起来比较:两种训练都只有小幅提升,评测接口带来的差异更大;换到未见接口后,谁更好仍没有稳定证据。
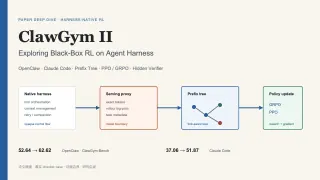
ClawGym II 保留 Claude Code 和 OpenClaw 的工具执行流程,通过模型调用记录和任务评分训练模型。本文解释分支怎样恢复、哪些生成不参与训练,并实际运行公开周报任务的检查程序,核对评分与实…
RIVER 先检查任务说明、容器和测试程序是否一致,再让强模型各试两次,从原训练集筛出约 3.5K 个环境。两条真实误判记录说明答案泄漏和脆弱测试怎样带偏训练,以及重复操作的扣分加在何处。
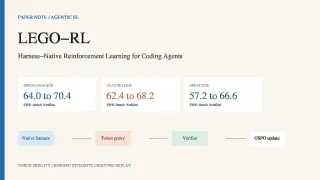
LEGO-RL 保留 Claude Code 等编码助手原有的执行流程,记录模型实际生成的内容,再按隐藏测试结果训练模型。用真实进度条修复任务讲清生成记录、任务筛选、评分和训练更新,并区分验证集最高分与最后一次验证。