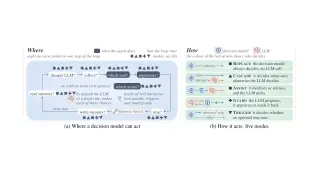
[2026-10-15] JevAgentHarness: Benchmarking, Deploying and Training Decision Models That Share Control with LLMs
把选工具、填有限选项交给小模型,不确定时仍调用大模型。沿真实发货日志和可运行的订单检查器,解释三层评测、阈值与训练,并核对新规则失败和 coding harness 的实际验证范围。
把选工具、填有限选项交给小模型,不确定时仍调用大模型。沿真实发货日志和可运行的订单检查器,解释三层评测、阈值与训练,并核对新规则失败和 coding harness 的实际验证范围。
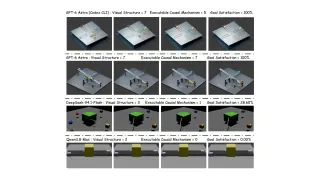
让模型用 Blender 搭出靠机械作用运行的三维装置。沿一道路口放行的真实任务,介绍题目怎么构建、模型看到什么、动画怎么评分,以及运行成功为何不等于机械正确。
41 个可运行 Godot 参考游戏派生出 247 道开发、补全、修复与移植题。SWE-Game 用预定动作试玩,再检查状态变化和无输入对照;本文沿 Beacon Relay 的拾取、计时、送达过程解释判分。
给一张图片,让模型写 Blender 代码搭出整间房间或室外场景,再检查隐藏几何与重新渲染后的画面。LEGO-Anything 区分了文件能用、场景恢复正确,以及后续修改是否真的变好。
平台逐阶段加入新工具、操作指南或专门处理某类任务的 Agent,旧题和评分规则不变。EvoHarnessBench 检查系统能否用好新增能力,以及选择越来越多时会不会连原来会做的题也做错。
让九个模型修改同一套调用模型、工具与执行步骤的代码,最多评测 20 次、工作 48 小时。Evo-Bench 不只测最终得分,还检查模型是否保住好版本、是否把系统改坏,以及怎样使用开发预算。
给模型 12 至 24 小时,让它写出一个会答题、会修代码或会操作终端的程序,再用未见过的任务测试这份程序。Meta-Agent Challenge 比较了 39 组开发配置,也记录了开发接口泄露答案的真实案例。
VeRO 管理 Agent 自动改进 Agent 时的代码版本、评测额度、可见文件和运行记录。本文解释一次修改怎样被评测,并用 Terminal-Bench 的逐题结果说明:消除程序异常,未必让任务成功率提高。
HarnessFix 先把失败记录对应到具体代码:哪些信息没传下去,程序为什么过早结束,再限制补丁可改的范围。本文用 AppWorld 支付请求解释完整诊断与验证过程,并核对四个 benchmark 的评分和证据缺…
Self-Harness 让同一个模型做任务、阅读失败原因,再修改自己的运行程序。重点是候选如何生成和保留、真实测试怎样判补丁成功,以及反复用于筛选的验证题为什么不等于最终盲测。