MULTI-HARNESS RL · 论文图解初次公开 2026-09-03 · 解读 v2(2026-10-09)

跨接口分组只有小幅增益,执行接口本身的影响更大

从同一个监督微调(SFT)模型出发,使用相同执行记录和预算;训练只改变成功与失败互相比较的分组方式。

同一道修复题 · 四套执行程序Aider、OpenHands、Qwen Code、SWE-agent 产生固定的成功与失败记录,之后不重新采集。
Within

同题、同接口互比

每个接口分别计算组均值和标准差。

Cross

同题、跨接口互比

四个接口的记录合成一个比较组。

两种模型都用独立隐藏测试复测分别检查四个原接口和未参与训练的 weak-ReAct 接口,避免把原接口提升当成迁移成功。
原接口 · 相对 SFT
+0.48 / +0.77 pp

Within / Cross 的估计增益;同一结果表中,执行接口的列均值差异为 7.13 pp。

未见 weak-ReAct · 每题八次取平均Cross − Within = +0.25 pp,95% 置信区间 [−0.48,+1.02]。两种规则都未显著超过 SFT;pp 表示百分点。

博客作者兴趣度 9.7 / 10:受控实验检验多接口训练的收益与迁移。

Multi-Harness Reinforcement Learning for Coding Agents: Training Gains and Harness Dependence
02 · 研究问题先区分接口接触与分数分组

见过四套执行程序,与合并它们的成绩,是两个训练选择

哪些接口产生数据

Harness 是模型外的执行程序

它提供提示、工具、命令输出、重试和历史管理。本文两组都使用 Aider、OpenHands、Qwen Code、SWE-agent。

没有匹配的单接口训练对照,不能单独判断接口数量的作用。

哪些成绩放在一起比较

Within 与 Cross 的主变量

GRPO 用同组成功与失败的分数,决定鼓励或压低哪些生成。

Within 比同题同接口;Cross 合并同题四接口。本文只改变这个分组边界。

来源:论文 §1、§3。
03 · 动机六种模型分别交给四种接口评测

评测接口的列均值差异,远大于模型的行均值差异

Aider
2.14%

六种模型在此接口的列均值。

OpenHands
9.27%

同样六种模型在此接口的列均值。

接口列均值
7.13 pp

最大值 − 最小值。

模型行均值
0.91 pp

Base 5.55% → Cross 6.46%。

v2 Figure 2、Table 4;共尝试 24,000 次。这是均值规模比较,不是每个模型都相差同一倍数。
04 · 相关工作不同工作改变的变量并不相同

系统论文训练完整方案;本文只控制分数分组

工作训练方式评测边界不能直接归因于什么
ClawGym II同题同接口内标准化原接口 + 换接口完整训练设置变化;不能只归因于 Within。
HarnessX同题跨接口及模型版本分组完整系统结果版本演化与分组规则同时变化。
Polar分别在真实部署程序内做 GRPO每个模型在原训练接口测试没有单独测迁移到新接口。
OpenForgeRL单接口或三接口 SFT+RL三接口模型的 OpenClaw / Codex 都是已见接口+9.5 / +20.3 pp 不能叫未见接口收益。
Orchard分别用两接口记录做 SFT训练评测匹配 / 不匹配 2×2检验的是 SFT 接口匹配,不是 RL 分组。
v2 §2、Appendix D;跨论文数据、模型、预算不同,不组成统一榜单。
05 · 受控实验同数据、同预算,不同分组

先固定执行记录,再改变相对分的比较组

采集四套 harness 在 SWE-Gym 上留下 183 题、5,543 次完整执行。
训练Within 和 Cross 从同一 SFT 起点出发,重放同一批记录,各做 81,200 次日志更新;只改变相对分的分组。
复测四个原接口和一个未见的 weak-ReAct 均由相同隐藏测试判分。
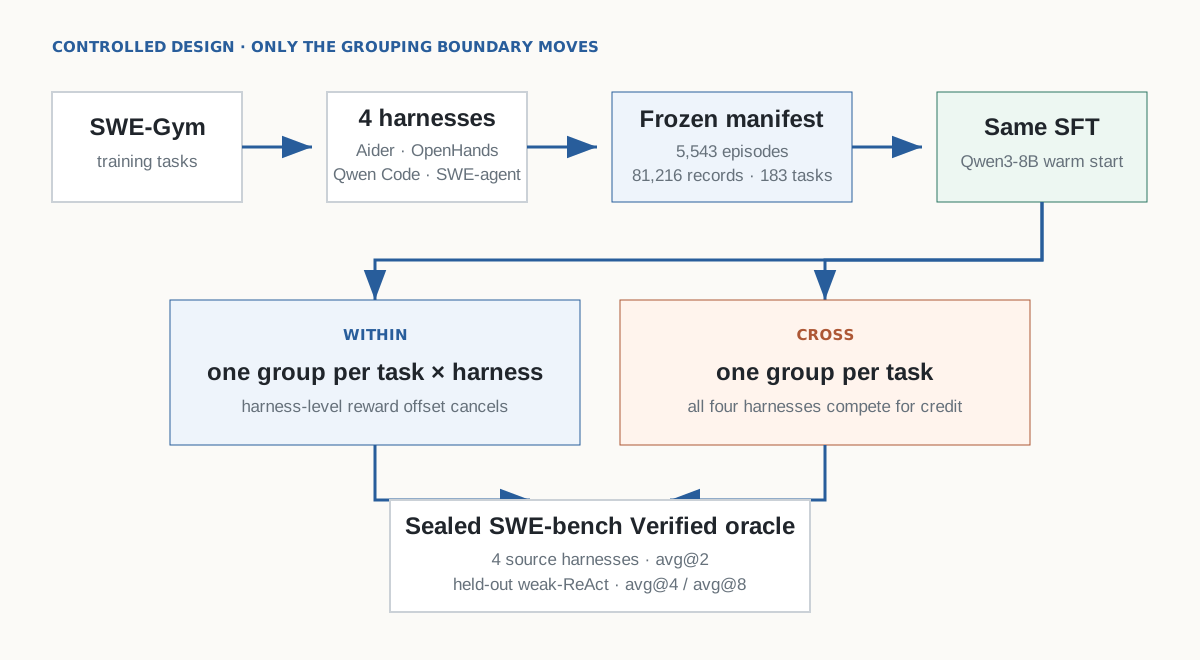
Controlled multi-harness experiment
根据论文 Figure 1 重绘。原论文为 arXiv non-exclusive distribution license,未复用原图像素。
06 · 分组公式advantage:比组均值好或差多少

同一条 0/1 分,比较对象不同,相对得分就不同

AWithin(x,h,i) = [r(x,h,i) − μ(x,h)] / [σ(x,h)+ε]同题同接口的尝试互比,接口本身整体强弱造成的偏移被消掉。
ACross(x,h,i) = [r(x,h,i) − μ(x)] / [σ(x)+ε]同题四接口一起比较,强接口本身更容易成功的影响也进入相对得分。
v2 Equation 2;μ 为组均值、σ 为组标准差、ε 防止除零。相对分用于加权生成 token 的更新。
07 · 算一个小组两接口简化例子,不是论文模型日志

同题 A 四次全对、B 四次全错:Within 全为 0,Cross 约为 ±1

Within

A 与 B 分别减各自均值

A:分数都是 1,均值 1;B:分数都是 0,均值 0。两组的分子都为 0,advantage 全为 0。

真实数据:698 个组中 44.8% 有混合结果;全对或全错的组对应 55.1% 的执行。两个百分比的分母不同。

Cross

八次执行合成一组

组均值 0.5,总体标准差 0.5;忽略很小的 ε,成功约 +1,失败约 −1。

183 个入选任务都同时有成功和失败,因此执行的非零 advantage 占比为 100%;它依赖任务筛选。

v2 §3、§5.1、Appendix A.1、Table 1。零 advantage 只关闭奖励项,KL 约束仍可能更新模型。
08 · 数据与训练SWE-Gym 训练;Verified 评测,任务不重叠

任务、完整执行、处理后记录、优化器更新,必须分开计数

SFT 起点
186

任务;8,841 条成功执行处理后的记录。

RL 任务
183

任务;5,543 次完整执行。同题合并后既有成功又有失败。

训练记录
81,216

四种方案相同;具体切分规则未公开。

日志更新次数
81,200

各方案一次重放;与记录数不能直接等同。

v2 Appendix A.1–A.2,Tables 1–2。lr=3e-7、KL=0.01;保留原生成 token,环境输出不计生成损失。
09 · 判定流程逐题隔离复测:sealed per-instance oracle

模型交代码补丁,独立隐藏测试判定成功 1 或失败 0

VISIBLE
GitHub 问题说明基线代码仓库执行程序的工具工具输出
HIDDEN
VERDICT
应用代码与测试补丁运行测试解析日志成功 1 / 失败 0
v2 §3.3、Appendix B.2;通用规则见 swebench 4.1.0 grading.py。执行中测试曾有 2.58% 乐观误判。
10 · 真实任务astropy__astropy-12907

一行修复怎样过真实测试,标准评分器又有什么边界?

输入与错误Astropy 的 rot & (sh1 & sh2) 本应让后两个输出各依赖一个输入;旧代码把右下角矩阵错误地全置为 1。
参考修复与判分上游 PR 保留右侧原矩阵;正常完整运行时,2 项修复测试和 13 项保留测试全部通过,标准评分器才返回 resolved=True。
证据边界这是真实公开任务,不是论文模型日志。标准包的 SKIPPED 处理可核查,论文专用复测器仍未公开。
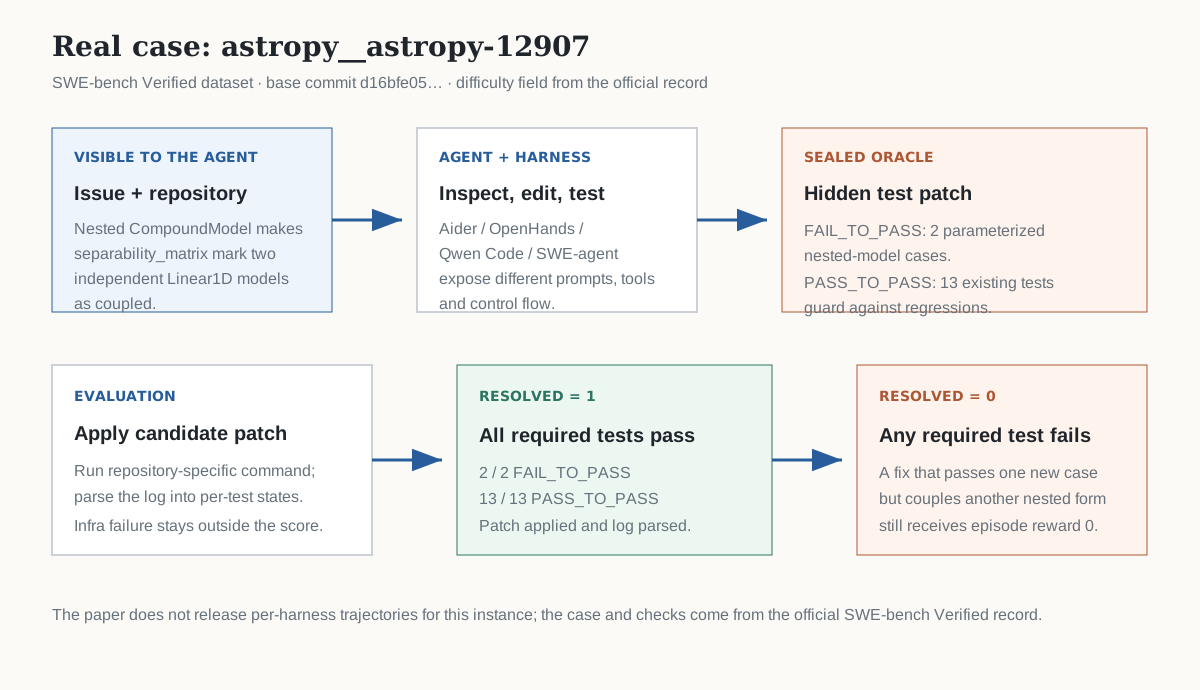
SWE-bench Verified real case
来源:固定 SWE-bench Verified 数据、Astropy PR #12907、swebench 4.1.0。论文专用复测与模型日志未公开。
11 · 原接口成绩六种模型 × 四种评测接口

原接口增益 +0.48 / +0.77 pp,接口列均值差异 7.13 pp

同一批模型,换评测接口Aider 2.14%、SWE-agent 5.05%、Qwen Code 7.23%、OpenHands 9.27% 是六种模型的列均值;最大差 7.13 pp。
同一批接口,换训练方案SFT 5.70%、Within 6.18%、Cross 6.46% 是四接口行均值。Cross − SFT 的五重比较校正 99% 区间 [−0.21,+1.75] pp 含 0。
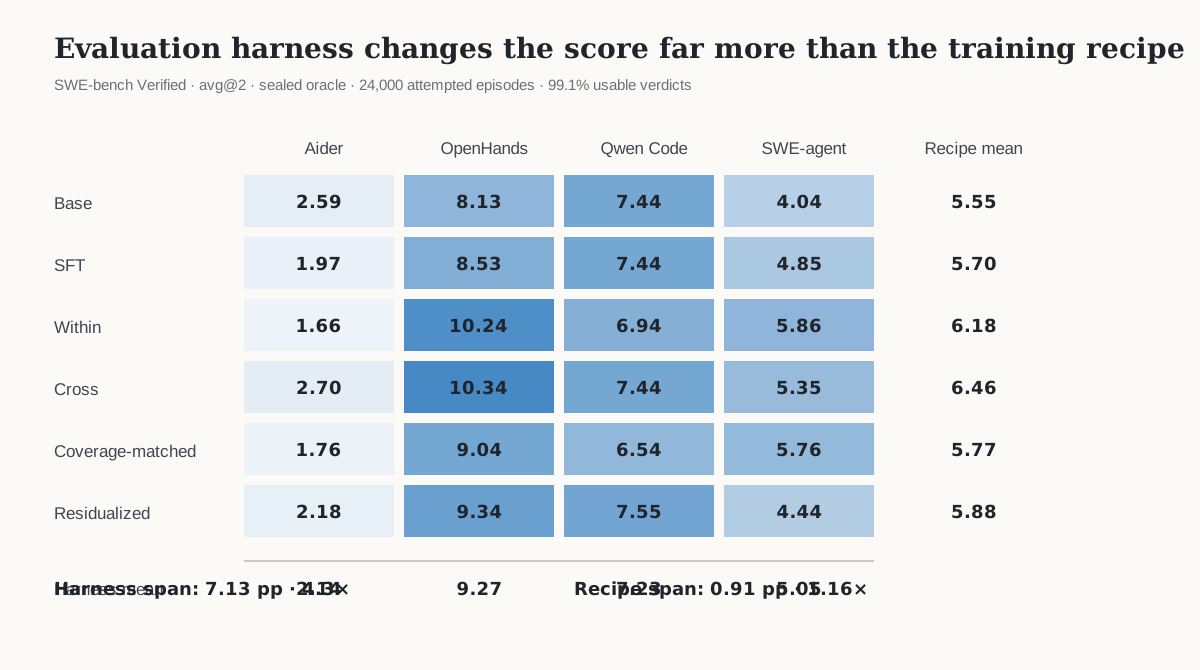
Source harness result matrix
v2 Figure 2 / Table 4 重绘。Cross − SFT 的 99% 多重比较校正区间 [−0.21,+1.75] 含 0。
12 · 未见接口weak-ReAct 未参与训练

未见接口上,Within 与 Cross 都没有显著超过 SFT

四次尝试的绝对分在 499 道共同题上,SFT 4.01%、Within 4.11%、Cross 4.73%;这些均值与配对差值使用的题目集合不总相同。
八次尝试的配对结果Cross − Within 为 +0.25 pp,95% CI [−0.48,+1.02];两种规则相对 SFT 的区间也包含 0。
三种训练 seedCross − Within 合并为 +0.16 pp,95% CI [−0.41,+0.72];单个 seed 的差值有正有负。
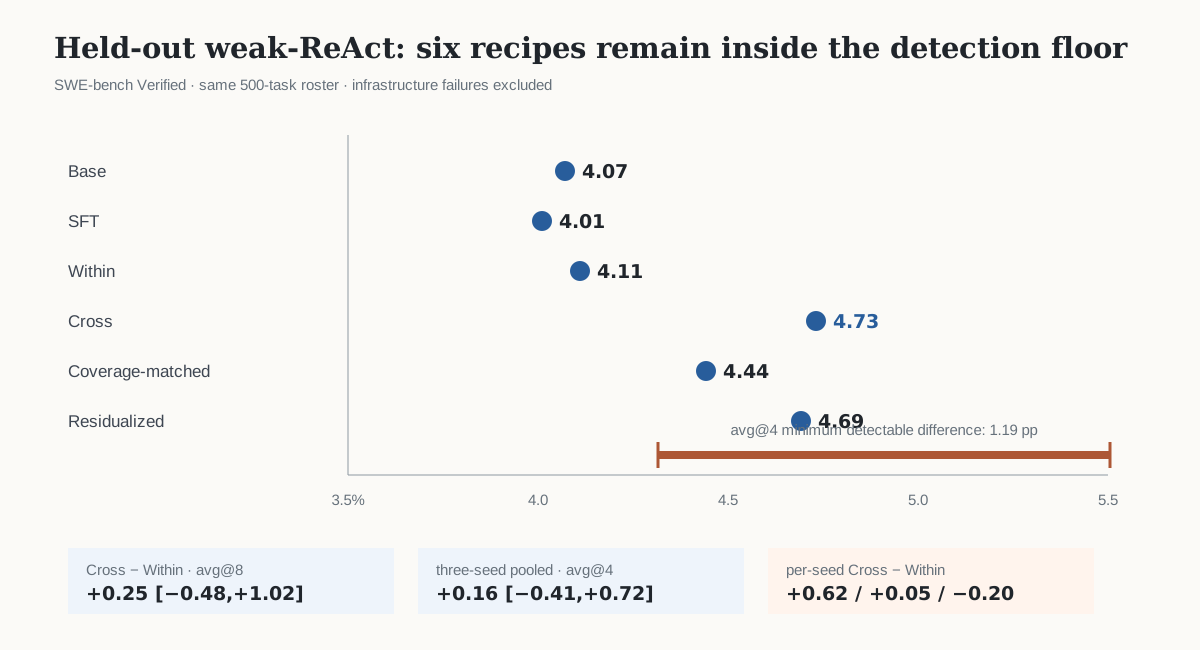
Held-out weak-ReAct results
v2 Figure 3a、Tables 5–7 重绘。avg@8 配对差值用各自完整题目集合,不等于绝对均值直接相减。
13 · 统计解释不显著,不能推出等价

最小可检出效应描述实验精度,不是已排除差异的上限

每题四次尝试
1.19–1.42 pp

估计达到 80% 检出概率所需的真实差异。

每题八次尝试
0.88–1.14 pp

区间更窄;Cross − Within 为 +0.25 pp,区间仍含 0。

题目集合也不同

绝对分不能直接相减

绝对均值用 500 题及有效尝试;八次配对先筛 486 题,再选双方八次完整的题。三项差值不必可加。

v2 Appendix B.2、Tables 5–7;最小可检出效应由区间宽度近似估计,不能证明零效应。
14 · 稳定性三种训练随机种子;Cross 一次中途重采

训练随机种子的差值有正有负,一次重采也没有显著改善

三种 seed · avg@4

+0.62 / +0.05 / −0.20 pp

合并差值 +0.16 pp,95% CI [−0.41,+0.72];对题目重采样,固定三种已观察的 seed。

Within / Cross 的跨 seed 最大分差为 0.45 / 0.42 pp。

一次重采的 Cross

重跑原 183 题,131 题仍有混合结果

中途模型采新记录供后半程训练;首次更新概率比与 ESS 均为 1.000。

较离线 Cross:+0.13 pp [−0.85,+1.10]。只检验一次重采,不是持续在线对照。

v2 §4.2、Appendix B.1–B.2、Tables 5–6。
15 · 训练信号诊断只用一个相对分,能否猜出来源接口?

Cross 的相对分包含接口信息;两个对照都未单独隔离其影响

按任务五折验证

同题不能跨训练与测试折

分类器输入 advantage,预测 harness;减去同题内标签随机打乱的基准准确率。

Cross:30.63% − 26.15% = +4.48 pp;Within:+0.02 pp,区间含 0。关联不证明模型记住了接口。

辅助对照

信号数量与接口可预测性未分开

Coverage-matched 置零部分相对分,也降低接口可预测性。Residualized 减去其他任务的接口均分,但估计分布与训练分布不同,接口仍可预测。

两项较 Cross 的未见接口差值都不显著。

v2 §5、Appendix A.2 / C.1、Table 9;对照联合改变或未充分改变目标属性,不能确定因果贡献。
16 · 行为诊断这里比较 SFT 与 Cross,没有比较 Within 与 Cross

换接口的动作频率差异,远大于同接口内 SFT 与 Cross 的差异

相对分能透露接口来源只用 advantage 预测来源 harness,Cross 比打乱标签的基准高 +4.48 pp;Within 高 +0.02 pp。
动作组成更依赖接口同一模型换接口的 JSD 为 0.174–0.350 bit;同接口比较 SFT 和 Cross 只有 0.0003–0.0029 bit。频率不评价每一步是否正确。
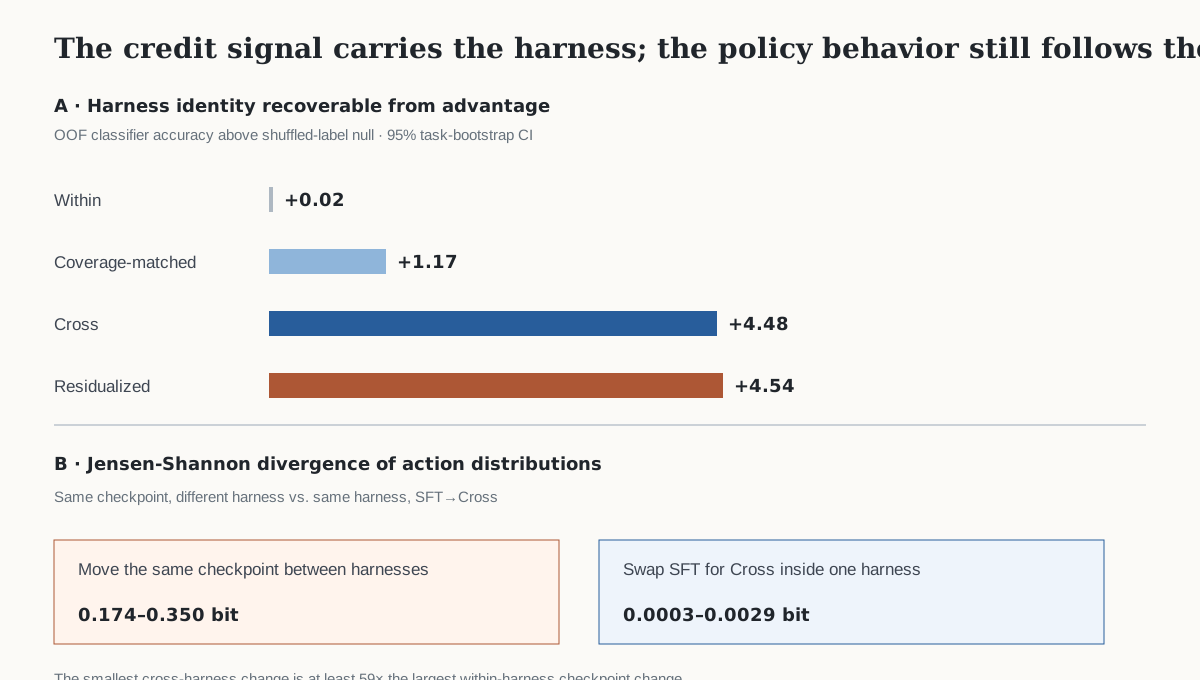
Harness identity and action distribution diagnostics
v2 Figures 3b–4、Tables 9–10 重绘。编辑后测试只标编辑;频率不评价动作是否正确。
17 · 限制结论依赖当前数据、模型、接口和统计精度

低成功率、弱 SFT 起点和未公开材料,都限制结论范围

模型范围训练只有 Qwen3-8BPython 修复,成功率多为 1%–10%;没有高能力模型验证。
统计精度小差异仍与区间相容未见接口仅一个 weak-ReAct;不显著不等价。
实验材料v2 明确尚未公开执行程序、专用评分器、结果与分析计划拟以后发布。
筛选条件183 题都有混合结果非零信号全覆盖依赖筛选;没有单接口训练对照。
SFT 起点未独立调优超参数与 RL 同用 3e-7 学习率及预算;不代表最优 SFT 配方。
执行故障哪些排除,哪些算 0基础设施无判定排除;Seed-Coder 的 32 次上下文超限算失败。
v2 Limitations、Appendix A.2 / B.1 / E.1;论文与 source archive 核对于 2026-10-14。
18 · 结论对 Claude Code / Codex 相关训练研究的启发

原流程中变好、换流程仍变好、分组改变带来收益,要分别证明

本研究的证据

小幅训练增益,大幅接口差异

原接口的 Within / Cross 估计增益为 +0.48 / +0.77 pp;接口列均值差异 7.13 pp。

未见接口两种规则都未显著超过 SFT,Cross 未稳定超过 Within;没有证明多接口 RL 无用。

下一步对照

增加接口与持续在线训练

固定任务、预算、评分器,轮流留出不同接口;再比较持续采集下两种分组规则。

对照应验证非零信号数量与接口可预测性是否真的被单独改变。

核心结论1 / 18