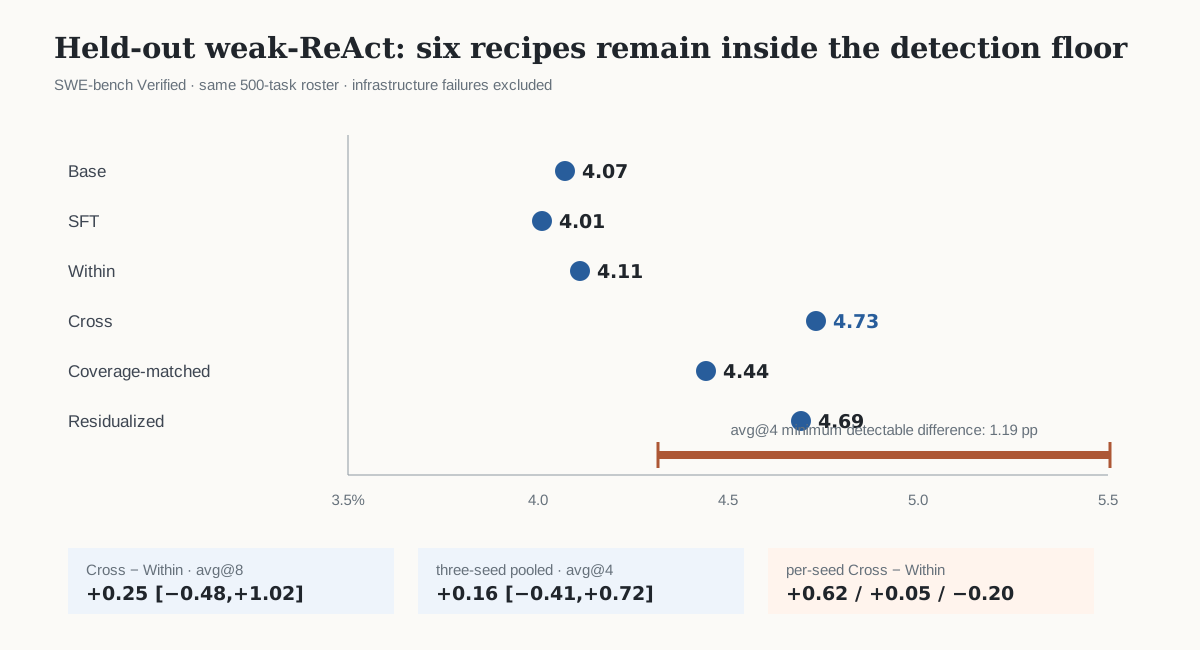
同一批 records、同一 SFT 起点、同一更新预算,只把 GRPO group 从 task × harness 改成 task。换到 unseen weak-ReAct 后,Cross 没有测出稳定优势。
“多 harness 训练”至少混着两个不同干预
模型见过多种交互接口
Prompt、tool schema、observation、retry 与 context policy 都不同。
本文两条主线都固定为四种 harness exposure。
不同接口的 reward 是否直接比较
Within 在 task-harness pair 内标准化;Cross 把同一 task 的四种 harness 放进一个 GRPO group。
这才是本文唯一改变的主变量。
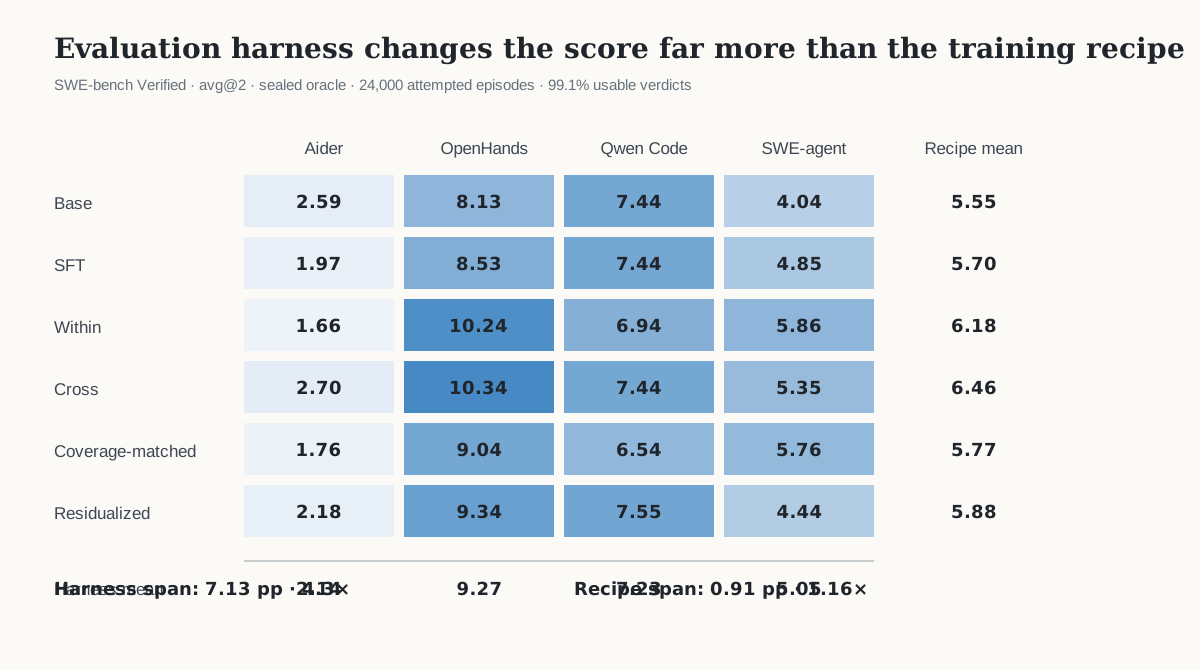
同一模型换评测 harness,平均 solve rate 相差 4.3 倍
六种 recipe 的列均值。
同一批 checkpoint 的列均值。
2.14% → 9.27%,4.3×。
5.55% → 6.46%,1.16×。
ClawGym II 做 Within,HarnessX 更接近 Cross;其他系统把多个变量一起改变
| 工作 | 多 harness 信号 | 评测边界 | 本文的判断 |
|---|---|---|---|
| ClawGym II | task-harness pair 内归一化 | native + transfer | 对应 Within;完整训练 recipe 同时变化。 |
| HarnessX | 跨 harness / model version pooling | end-to-end | 对应 Cross;演化过程与 credit rule 混在一起。 |
| POLAR | production harness 内 GRPO | 各自 native harness | 不能区分 source adaptation 与 portability。 |
| OpenForgeRL | 三 harness SFT + RL | ClawEval held-out | 报告正向 transfer,但 exposure 与训练阶段同时改变。 |
| Orchard | full-harness SFT | matched / mismatched 2×2 | 显示很强的 interface lock-in。 |
训练记录被冻结后,Within 与 Cross 只在 advantage 分组处岔开
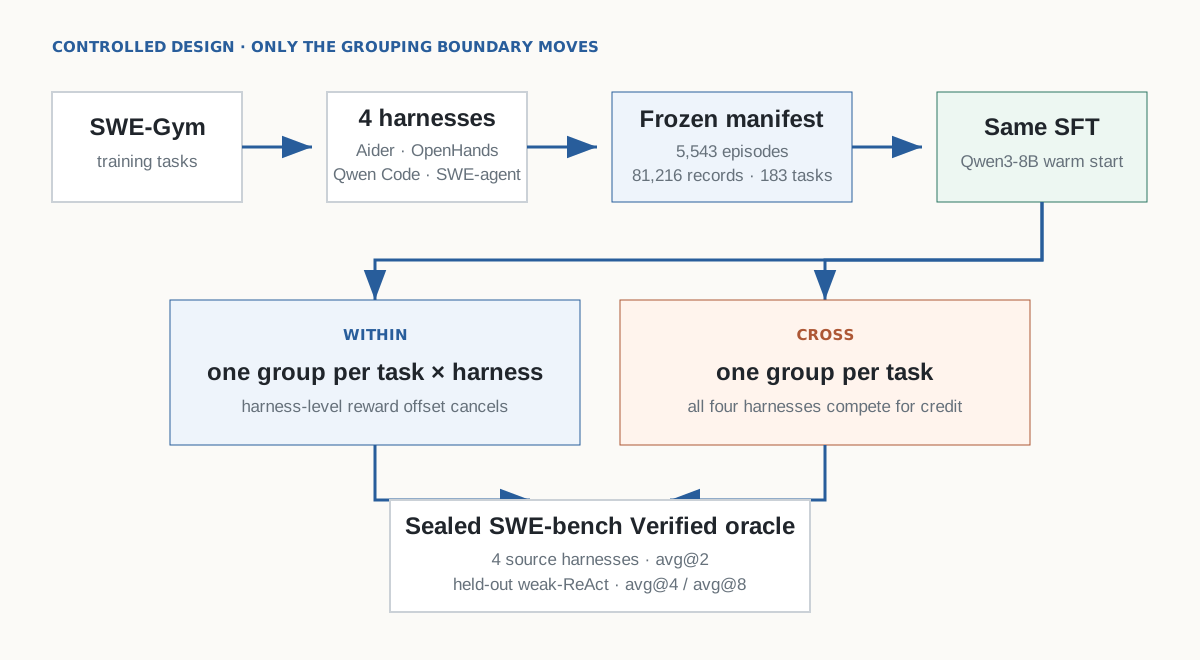
同一条 binary reward,因为比较对象不同,会得到不同 advantage
假设同题四种 harness 的 reward 是 0、0、1、1
先按 harness 分开
每套 harness 只和自己的重复 rollout 比。某套 harness 若全成功或全失败,该组方差为 0,所有 trace 的 advantage 也为 0。
实际 manifest 中 55.1% 的 Within groups 是这种 all-pass / all-fail group。
四套 harness 直接竞争
同题里成功的 harness 得正 advantage,失败的得负 advantage。183 个入选任务的 pooled group 全都有非零方差。
这会扩大 gradient coverage,也把 harness 成功率写进 credit。
梯度只来自 183 个“harness 会产生分歧”的任务
tasks,8,841 records。
tasks,5,543 episodes。
四条 RL arms 完全一致。
每条 arm 实际完成数相同。
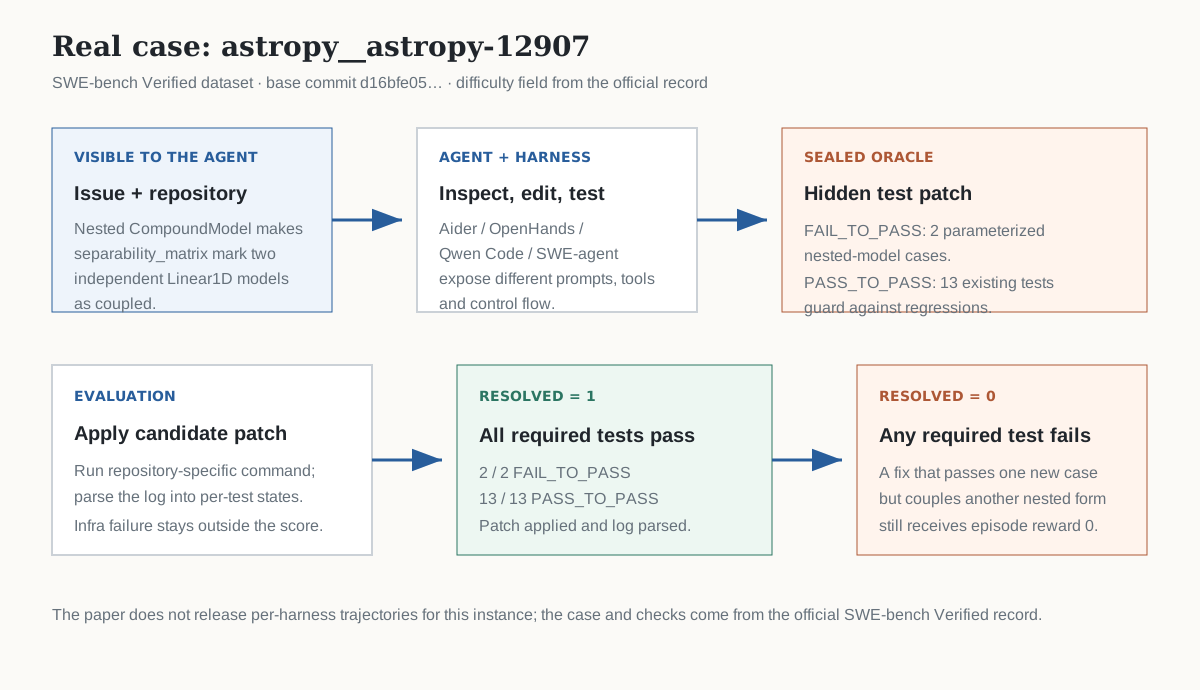
Agent 交 patch;隐藏测试决定 binary reward;基础设施故障不算模型失败
嵌套 CompoundModel:两条新测试要修好,13 条原有测试不能退化
列从左到右明显变深,行与行之间只小幅移动
六条 recipe 的 spread 比实验最小可检测差异还小
实验排除了大效应,没有证明 Cross 与 Within 数学等价
六个 held-out contrast 的 80% power 最小可检差异。
尝试数翻倍,precision 提高,点估计也朝 0 收缩。
no detectable portability
小于约 1 pp 的真实差异仍可能存在,论文不能把它排除。
Cross − Within 的 seed 波动比两者平均差异更大
+0.62 / +0.05 / −0.20 pp
合并差值 +0.16 pp,95% CI [−0.41,+0.72]。Within 与 Cross 自己的 seed range 分别为 0.45 与 0.42 pp。
后半程改为 on-policy
相对 offline Cross 为 +0.13 [−0.85,+1.10];相对 Within 为 +0.75 [−0.10,+1.65]。区间仍跨 0。
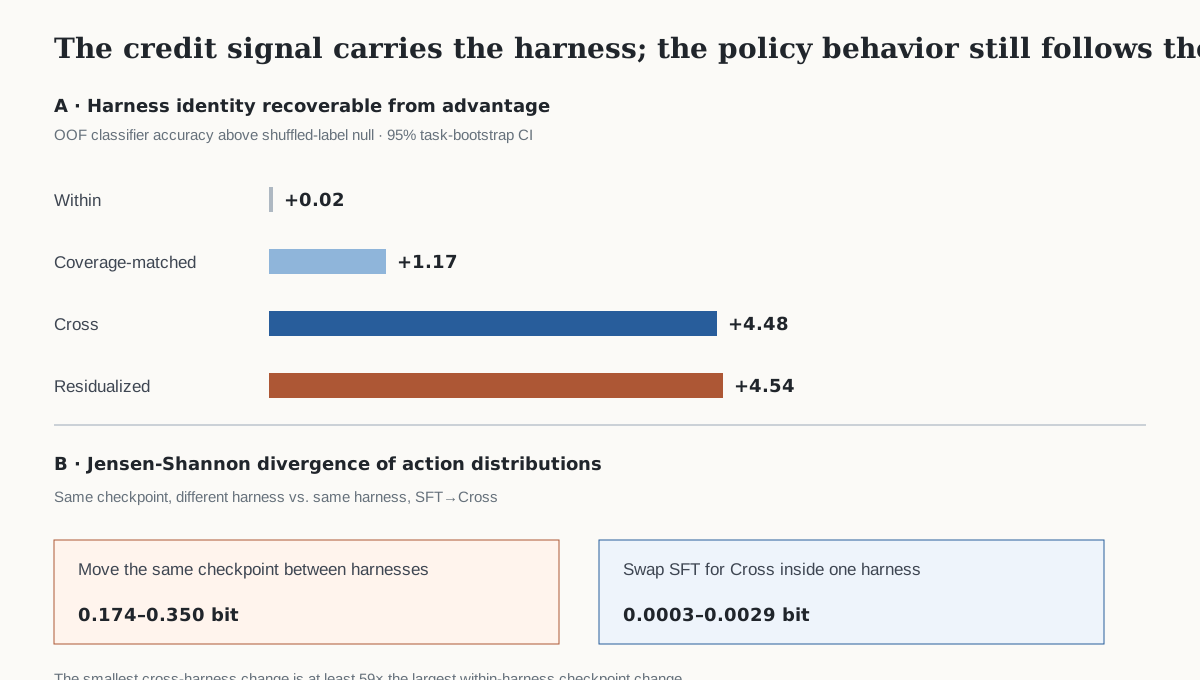
Cross 确实把 harness 成功先验写进 advantage
只看 advantage 猜 harness
183 tasks hashed into five folds;每条 arm 和自己的 within-task shuffled-label null 比。
Within:+0.02 pp [−0.38,+0.46];Cross:+4.48 pp [+3.22,+5.83]。
Baseline population 选错了
Baseline 从 1,008 个多数全失败的任务估计,训练却只用 183 个 disagreement tasks。它只去掉 9% offset,残留 identity +4.54 pp。
换 harness 会重排行为;换 credit rule 几乎不动
结论窄而可信;复现材料和外部有效性仍有缺口
想证明模型学到了可迁移能力,必须把接口换掉再测
Cross credit changes the signal
Harness identity 可从 advantage 恢复;source harness 上有小幅收益。
但 held-out score、seed 复核与 action composition 都没有显示额外 portability。
把 harness 当成一等实验变量
报告训练 exposure、grouping boundary、source delta、unseen-harness delta、grader 与版本。
下一步应做多种 held-out interface 和更细粒度 credit assignment。