LongHorizon-Harness 解决的是一个很具体的问题:Claude Code 或 Codex 做几个小时的任务时,执行历史会越来越长,“已经完成了什么、哪些结果真的验证过、下一步应改哪一处”逐渐混在聊天记录里。论文把这些状态移到执行上下文之外,再用 Manager、fresh-context Executor 和只读 Auditor 把一次长任务拆成一系列可核验的状态变化。
Q1. 为什么长上下文还不能解决长任务?
长上下文保存了历史,却没有把“可信的当前状态”单独维护出来。 同一个会话同时负责执行、记住进度和判断自己是否完成时,三个问题会互相放大。
第一是 compounding errors。某一步把“文件已经保存”误判为真的,后面几百步都会把这个误判当作前提。第二是 context rot。截图、shell 输出、试错和解释越积越多,Agent 很难从几十万 tokens 里稳定恢复当前约束。第三是 task-state loss。任务往往要求保留多个相互依赖的状态,例如先截图错误,再修复公式,再截图修复结果;只记住“公式已修好”会直接破坏证据链。
论文的结构性判断是:执行轨迹和任务状态不应该放在同一个不断增长的 context 里,执行者也不应该给自己的结果盖章。LongHorizon-Harness 因此把任务状态放到 Executor 外面,并让独立 Auditor 只读检查环境。
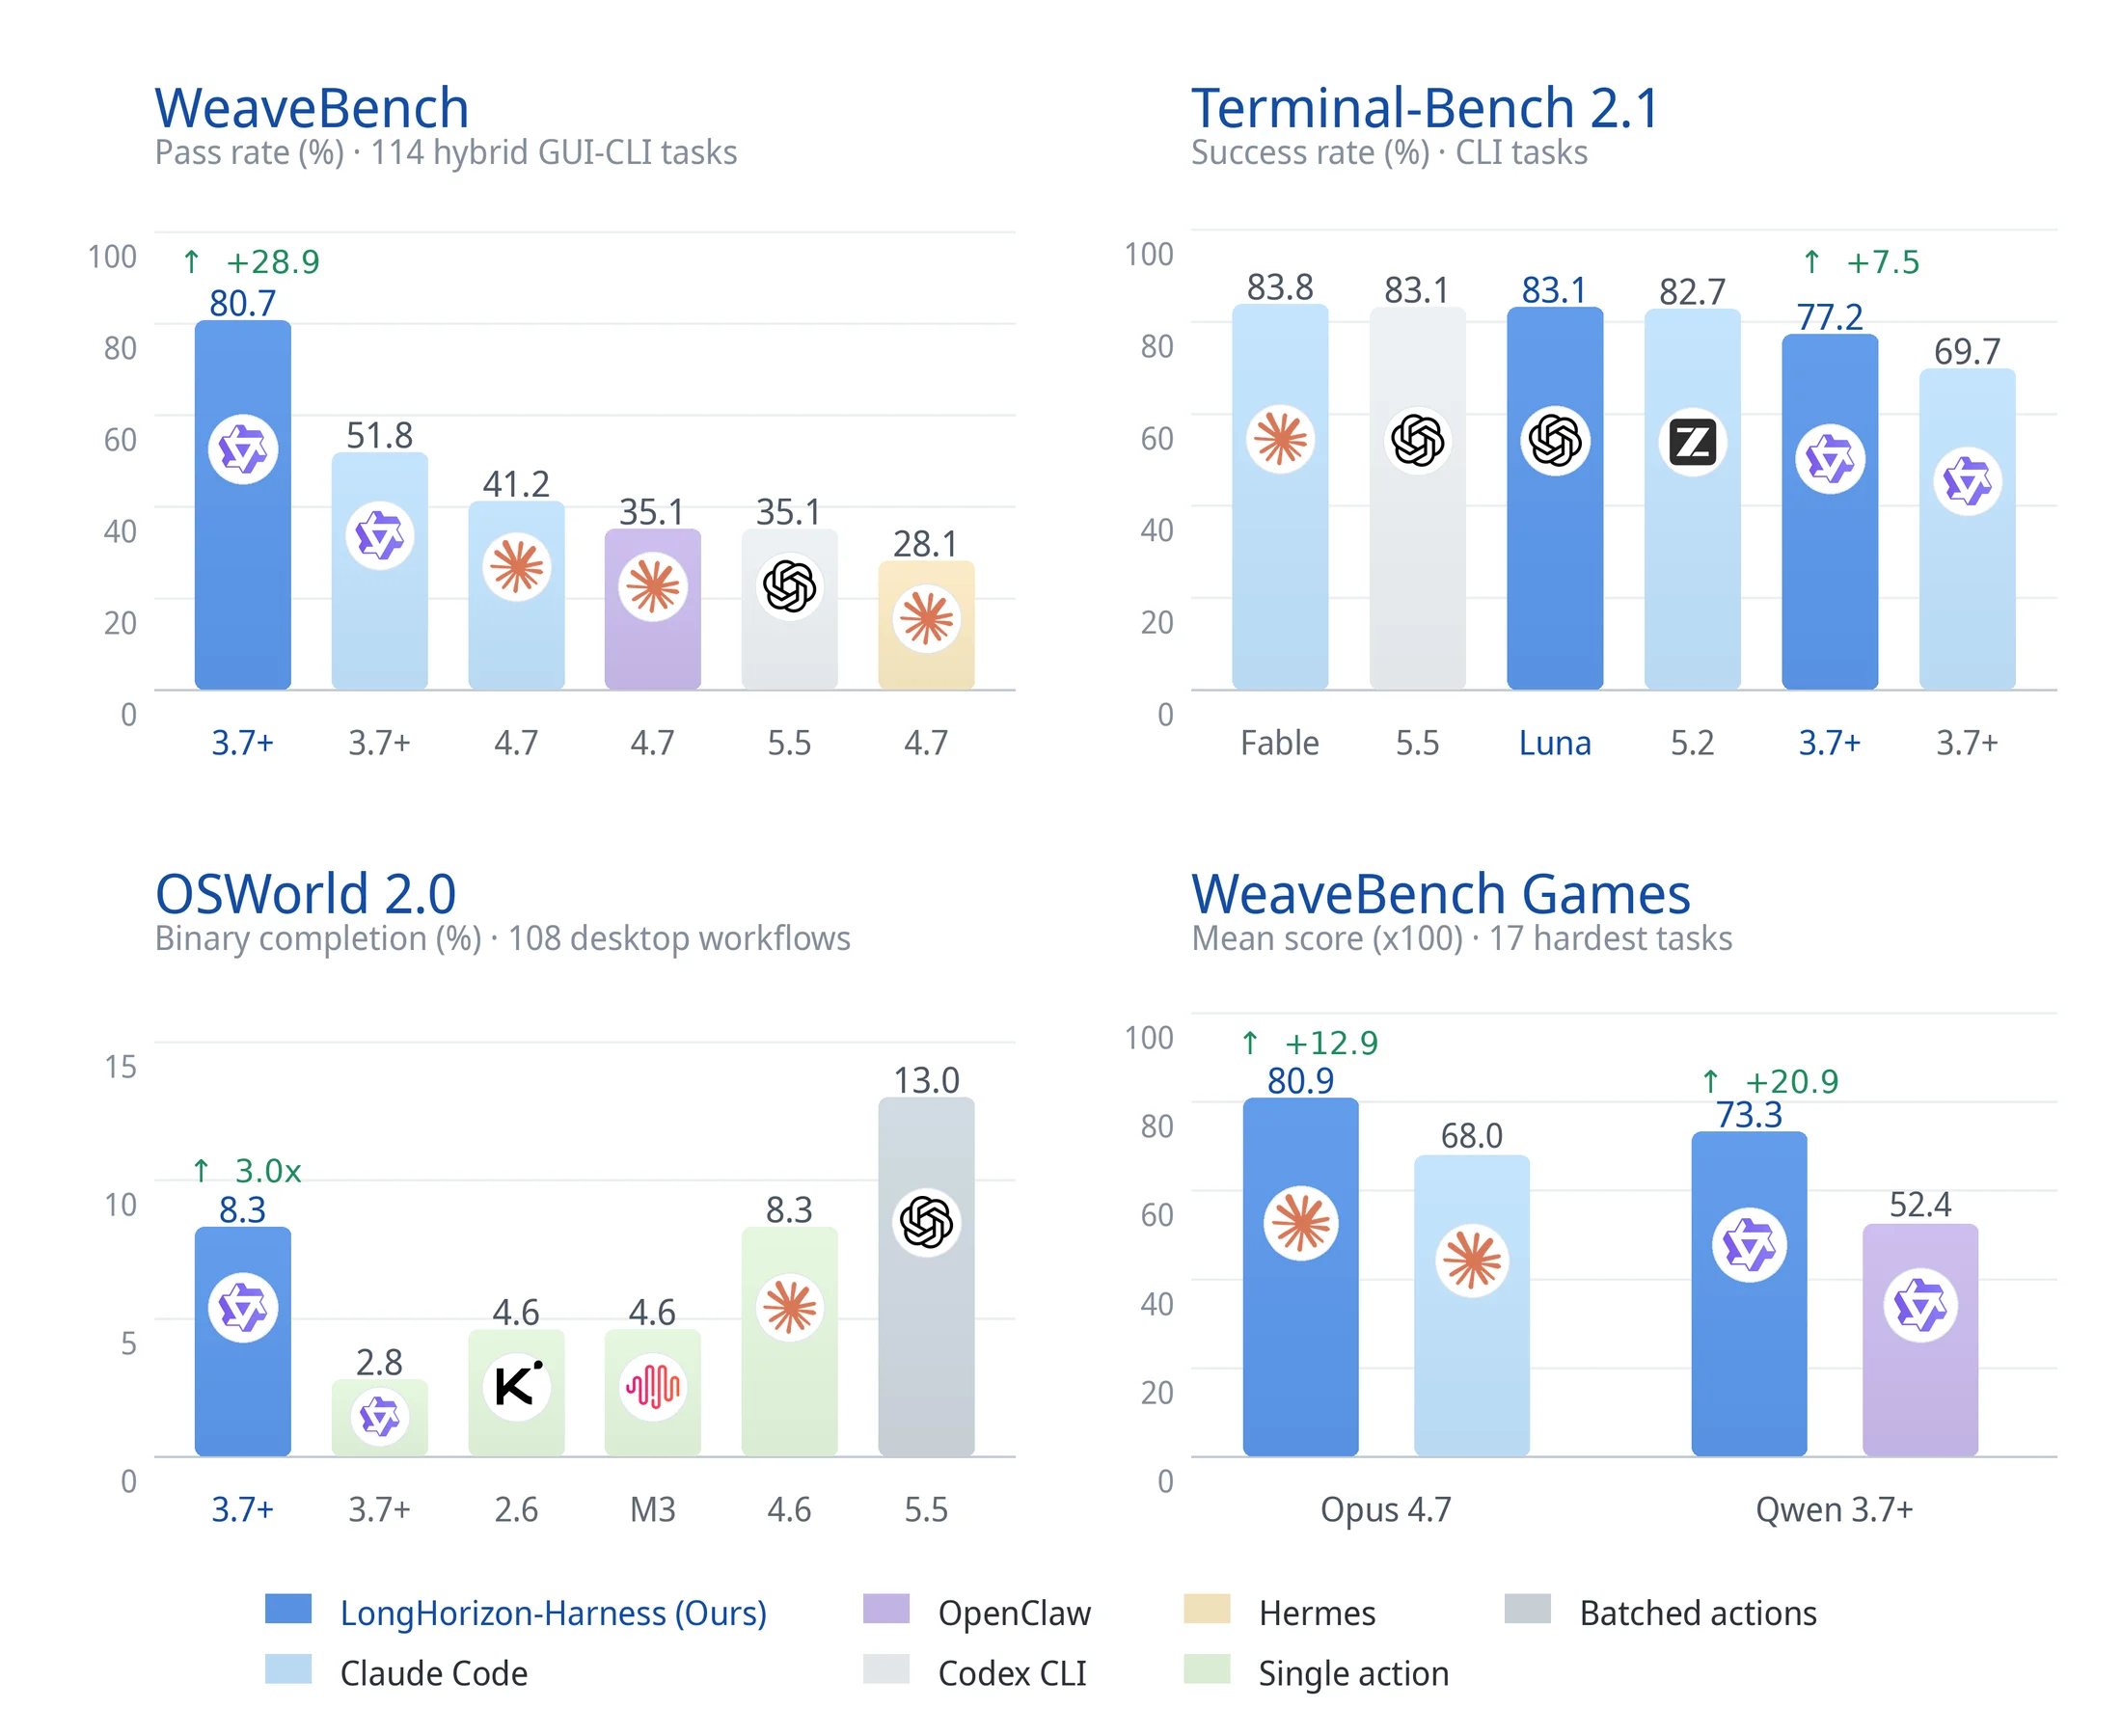
assets/harness_perf.png。图把本文结果和部分官方榜单放在一起;因果解释应以同模型、同 executor backend 的 paired rows 为主。官方仓库 MIT License。方法依赖明确的职责和权限边界:Manager 不接触环境,Executor 可以改变环境,Auditor 能观察环境但不能修复它。三个角色可以使用同一个模型,但每次调用必须拿到不同的上下文、工具和写权限。
Q2. 它和 Harness-Zero、AHE 以及普通多 Agent 有什么区别?
LongHorizon-Harness 优化的是一次任务运行中的状态推进,不训练模型,也不自动修改底层 harness。 它把 Claude Code、Codex CLI 等系统当作可替换 backend,在外面增加 orchestration 与审计。
| 路线 | 可变化的对象 | 发生阶段 | 本文与它的边界 |
|---|---|---|---|
| Harness-Zero | 从 teacher harness 生成并筛选训练轨迹,更新 base model | 训练阶段 | 目标是让模型学会 harness 提供的行为;LongHorizon 不更新模型 |
| Agentic Harness Engineering | prompt、tool、middleware、skill、memory 等 harness component | 跨任务演化 | 目标是自动改进 harness;LongHorizon 固定 backend,在单个任务内控制状态 |
| Claude Code / Codex 原生 loop | 会话中的 plan、tool call、context compression | 单次运行 | 执行和自我判断通常共享历史;LongHorizon 把持久状态与审计拆出来 |
| Planner / worker / reviewer 多 Agent | 角色和消息拓扑 | 单次运行 | 角色名相似不够;本文明确规定谁可写环境、哪些证据可跨轮、何时允许 done |
论文没有单列 Related Work,也没有系统性地把所有 orchestration 方法放进同一张实验表。它引用了 planning、subagent、computer-use 和长上下文相关工作,但实证问题收得更窄:外置已审计 task state,能否让现成 harness 在长任务中少丢进度、少相信错误的自我判断。
Q3. Manage-Execute-Audit 具体怎样运行?
3.1 Manager 保存什么?
Manager 每轮读原始任务、当前 task state 和历史 audit reports,但它没有 GUI、shell 或文件权限。它维护两份自然语言状态:Current task state 和 Task contract。
Task state 至少分四栏:Completed、Incomplete、Blockers/Risks、Untrusted/Do not reuse。Task contract 则保持原任务中的精确对象、文件名、路径、字段、格式、应用位置和禁止项,并写清 final-state carrier、authoritative input、state-production process、commit/persistence boundary 和 acceptance constraints。Contract 写的是这轮可检查的验收边界,不负责列出完整执行计划。
官方源码在 ManagedRound 中保留这些字段。下面是基于 revision a1dd930 的原始结构摘录,运行时为 Python 3.11+:
@dataclass
class ManagedRound:
    round_index: int
    next_step: RoleNextStep
    plan_text: str
    executor_output: str = ""
    auditor_report: str = ""
    harness_feedback: str = ""
    task_state: str = ""
    task_contract: str = ""
    related_report_refs: list[str] = field(default_factory=list)
3.2 一轮只执行一个 bounded contract
- 1 · READManager 读取原任务、task state、audits。
- 2 · CONTRACT挑一个未完成目标,写 acceptance 与 boundaries。
- 3 · ROUTE按主要状态变化选择 GUI 或 CLI。
- 4 · EXECUTE新 episode 只拿本轮 context,修改环境。
- 5 · REPORTExecutor 报告动作和产物,此时仍未验证。
- 6 · AUDIT新 context 只读检查环境,写 evidence 与 gaps。
- 7 · UPDATEManager 采用审计事实,决定下一轮或结束。
Executor 收到原任务、task state、当前 contract,以及 contract 明确引用的 audit reports。它看不到以前的 raw trajectory。官方通用 adapter 每轮创建唯一 prompt 文件,再在同一 workspace 启动一个新的 CLI 进程。Claude Code adapter 额外设置 CLAUDE_CODE_DISABLE_AUTO_MEMORY=1 和 CLAUDE_CODE_SKIP_PROMPT_HISTORY=1;Codex adapter 通过 codex exec --json 从 stdin 读取本轮 prompt。
这里有一个安全细节:Codex adapter 默认在隔离环境中使用 --dangerously-bypass-approvals-and-sandbox,因为外层环境已经负责隔离。论文的角色边界不能替代部署隔离;如果把它放进真实项目,workspace、凭据和 network 权限仍要单独设计。
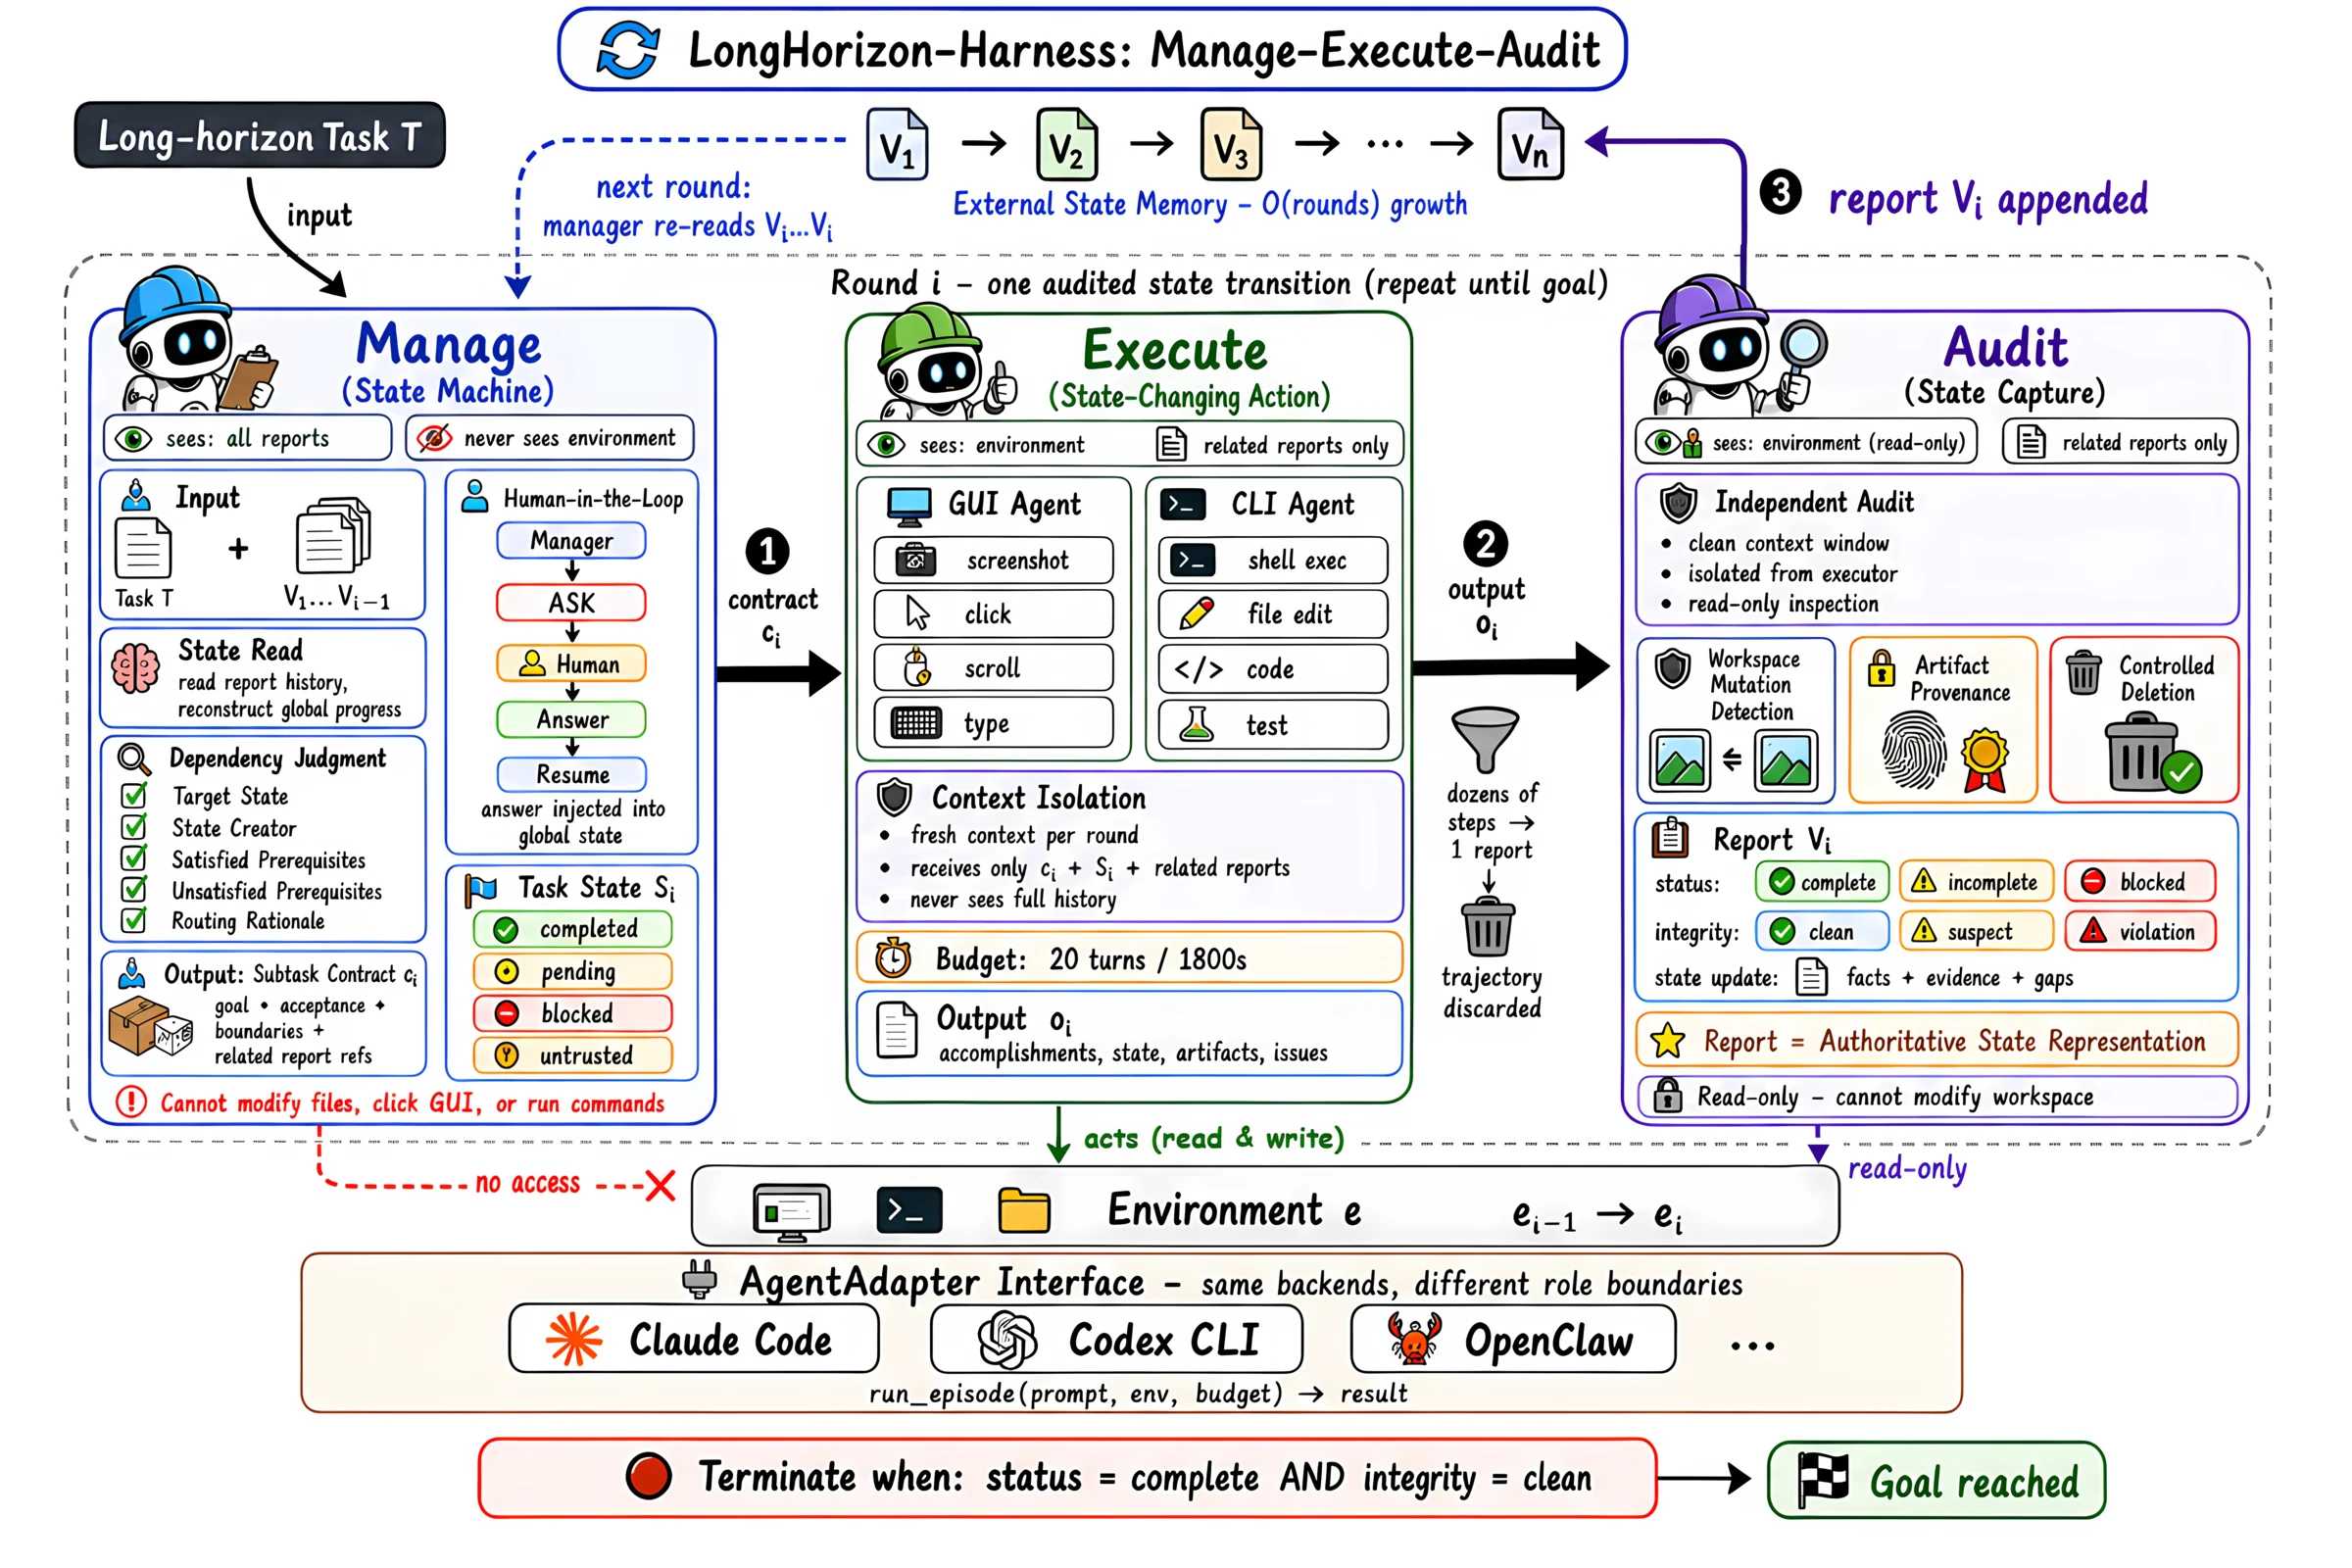
assets/mea_main.png。Manager 无环境访问;Executor 可读写;Auditor 只读。论文 Figure 2 与当前仓库流程一致,但当前源码还要求 contract audit 为 aligned。官方仓库 MIT License。3.3 Auditor 怎样把“看起来完成”变成可用状态?
Auditor 看到原任务、task state、contract、相关历史审计和 Executor 的简短报告。它不看 Executor 的内部 reasoning 或完整历史。GUI Auditor 只能观察屏幕与已有截图;CLI Auditor 只能用 Read/Glob/Grep 和受控只读命令。Claude Code adapter 还会在审计前后做 workspace snapshot diff。若 Auditor 改了 task 文件,报告会被标为 integrity violation。
Auditor 的前三行是机器会解析的控制头:
Status: complete | incomplete | blocked
Integrity: clean | suspect | violation
Contract audit: aligned | unknown | needs_revision | invalid
源码用 guard 强制执行完成条件:
return (
    report.status == "complete"
    and report.integrity_status == "clean"
    and report.contract_audit_status == "aligned"
)
如果 Manager 仍输出 Next: done,主循环不会结束。它会生成 synthetic repair feedback,把“没有 complete/clean/aligned 证据”送回下一轮 Manager。若 Auditor 报告存在 blocking constraints,解析器也会把 complete 降成 incomplete。
Q4. 实验怎样评分,真实 case 到底说明什么?
4.1 内部 Auditor 不负责论文表格里的分数
chat.jsonl,逐 artifact 拆 clause,再打 8 个维度。env.evaluate()。Binary 只把 final score = 1 计为完成;Partial 是 108 题的平均细粒度分数。WeaveBench judge 的公开 prompt 规定:先逐项检查 deliverable 与 clause,再给 task completion、deliverable correctness、quality、evidence authenticity、tool use、final state、efficiency 和 instruction following 八个维度。若发现 hack,最终分数直接为 0;否则:
论文附录把 WeaveBench PassRate 定义为 score ≥ 0.8 的任务比例,Overall 是 114 题平均分。Judge 没找到 artifact 时还必须查完整轨迹;如果轨迹能证明文件确实创建过但没有被收进结果目录,可以记录 unstaged_evidence=true,同时降低分数。这个 judge 不是纯 file checker,也不是简单看最终截图。
4.2 WEB_task_16:卡在 Wireshark 后怎样恢复?
WebRTC simulcast-layer audit · 0.59 → 0.92
- 任务来源与可见输入:WeaveBench 官方任务。Agent 要在浏览器与 Wireshark 中检查 simulcast layer,留下 chart、JSON 和 packet-level evidence。
- Baseline 的真实轨迹:Claude Code 已经判断
Decode As对话框无响应,随后仍围绕同一个 GUI 交互重试 400 多步。它只解码了一个 stream,后续证据没有补完。 - LongHorizon 的处理:Auditor 把已验证的浏览器结果与未解决的 Wireshark blocker 分开写进 task state。Manager 后续只派缺失证据,不重新做已经确认的部分。
- 最终 judge:WeaveBench judge 对照任务 clause、结果目录和完整轨迹。Baseline 因缺证据得 0.59;LongHorizon 补齐 browser charts、JSON state 和 packet cross-validation,得 0.92。
这个 case 说明“Agent 意识到失败”与“系统从失败中恢复”是两件事。Baseline 的文字里已经出现正确诊断,但这个诊断没有被提升成跨轮 blocker,所以执行 loop 继续消耗预算。
4.3 DOC_task_2 与 DOC_task_4:最终状态正确还不够
DOC_task_2 · heading-style normalization · 0.00 → 0.89
- 任务要求通过指定 LibreOffice GUI workflow 统一 15 个 heading,并保留正确的底层 style 与 outline level。
- Baseline 直接改 document XML,视觉上像正确标题,但没有按要求走 LibreOffice workflow。论文的 judge 将该结果判为 0.00。
- LongHorizon 先用 CLI 检查底层 ODT 结构,再通过 GUI 应用正确 heading style,最后重查 XML 中 15 个 heading 的语义状态,得 0.89。
DOC_task_4 · VLOOKUP repair · 0.45 → 0.87
- 任务不仅要修 Calc 中的 VLOOKUP,还要保留修复前和修复后的证据。
- Baseline 先修公式,再回头补 pre-repair screenshot。文件已经被改变,重开后看到的错误与原始前态对不上,证据序列自相矛盾。
- LongHorizon 把 pre-repair evidence 作为 pending prerequisite,先保存错误状态,再修改公式、复核结果并完成九张截图序列。
这两个 case 对应两种常见错法:把视觉外观当成文件语义,把不可逆前态当成事后可以补交的附件。Task contract 提前标出最终 judge 依赖的状态载体和证据时间顺序。
4.4 WEB_task_10、SQLite gcov 和 mystery binary
WEB_task_10 要做 Lighthouse performance optimization 并收集 DevTools 证据。Baseline 完成了核心优化,却在证据采集里耗尽预算,没有交齐 deliverables,得 0.53。LongHorizon 把已验证的优化状态留在 task state,把剩余 screenshot 和 metadata 交给后续轮次,得 0.85。
Terminal-Bench 的两个附录 case 更像传统 coding judge。SQLite 任务有三个明确 tests:test_sqlite_compiled、test_sqlite_in_path 和 test_gcov_enabled。Baseline 通过前两项,但 gcov 检查失败,reward 0;LongHorizon 把 .gcno 产物和覆盖率符号写成 acceptance criteria,三项全过,reward 1。
Mystery binary 要独立写出 /app/mystery.c;官方 verifier 的三个 test 名称是 test_image_c_exists、test_image_compiles 和 test_image_similarity。Baseline 做了大量逆向探索,却没有交付通过相似度检查的独立实现。LongHorizon 把 strings、strace、输入输出和图像观察保存为 audited facts,再让后续轮次收敛到可编译、行为一致的 C 程序,reward 1。
4.5 主结果先看 matched pairs
| Benchmark | Baseline | LongHorizon | 可比性 |
|---|---|---|---|
| WeaveBench PassRate | 51.8% | 80.7% | 同 Qwen 3.7-Plus、同 Claude Code executor;最干净的主对比 |
| WeaveBench Overall | 0.702 | 0.835 | 同上;114 tasks |
| Terminal-Bench 2.1 | 69.7% | 77.2% | 同 Qwen 3.7-Plus、同 Claude Code;每题三次 |
| OSWorld Binary | 2.8% | 8.3% | baseline 为 single-action GUI,本文为 hybrid GUI+CLI |
| OSWorld Partial | 21.5% | 35.2% | 同上,108 tasks |
| OSWorld Opus subset | 20.6% / 55.8% | 35.3% / 66.9% | 34 tasks;Binary / Partial,工具模式也不同 |
WeaveBench 官方最佳行使用普通用户权限,作者自己的 Qwen runs 在 task VM 中有 root,因此官方 41.2% 只能作为参考。OSWorld 的主要 limitation 更直接:Baseline 是 single-action GUI,LongHorizon 使用 hybrid GUI+CLI。它同时改变了 orchestration 和 action space,不能把全部提升都归给 MEA。
还有一个论文内部不一致。Abstract 写 Claude Opus 4.7 在子集上从 20.0% 到 34.3%,Table 3 与 Appendix B.1 则是 20.6% 到 35.3%。这里采用表格和附录的 20.6→35.3,并把摘要数字视为排版或版本同步错误。
Q5. 这篇论文对 harness 研究最有用的启发是什么?
5.1 把“状态”设计成可引用的证据图
最值得复用的是 state transition 的数据契约。每条事实有来源轮次,每个 contract 只携带相关 reports,下一步依赖项必须来自已审计事实。这样可以把“上下文压缩”从文本摘要问题改成 provenance 问题:哪些事实能进入下一轮,为什么能信,谁验证过。
对 Claude Code 或 Codex 的研究,可以把它进一步做成结构化 schema,而不是完全依赖自然语言 section parser。例如 requirement、artifact、fact 各自拥有稳定 ID、status、evidence locator、freshness 和 invalidation rule。当前官方实现主要从自然语言 prompt 中提取 Current task state 与 Task contract,可读性强,但格式修复和状态冲突处理仍会依赖模型。
5.2 Auditor 需要硬权限边界
源码里有两层约束:prompt 告诉 Auditor 只读,Claude adapter 在审计前后做 workspace snapshot diff。这个方向是对的,因为单独写“你是 reviewer,请不要修改”并不能形成可靠边界。
下一步应把它做得更硬:只读 mount、单独容器、network policy、命令 allowlist、artifact content hash、GUI observation proxy,以及对 Auditor 本身的 false positive / false negative 校准。当前仓库对 Codex 的角色隔离没有像 Claude Code adapter 那样完整展示 tool-policy 与 mutation guard,跨 backend 的安全等价性还需要额外验证。
5.3 把 budget 分给执行、核验和恢复
Auditor 占 LongHorizon 总 token 的 19.4%(WeaveBench)、24.8%(OSWorld)和 38.1%(Terminal-Bench);Manager 只占 2.8%、2.0% 和 8.1%。独立核验是主要 token 支出。
同一机制在 Terminal-Bench 反而少用 24% token,说明核验有时能砍掉无效重试;在 OSWorld 这种截图密集任务里,它也可能产生很高成本。论文的 Games 子集更能说明模型与 harness 的耦合:Qwen 从 10.7M 增至 34.3M tokens,Opus 却从 16.5M 降至 11.1M。弱模型可能需要更多恢复轮次,强模型则会因为明确 contract 少走弯路。
Q6. 最后该怎样评价这篇工作?
它证明了一整套“外置状态、fresh episode、独立审计”的系统能显著提高长任务完成率,但没有证明其中哪一部分是必要条件。 这使它非常适合当工程与研究起点,也留下了清楚的实验缺口。
最主要的限制有五个:
- 没有组件消融。Task state、fresh context、Auditor、GUI/CLI routing 和额外 compute 没有被单独拆开。
- OSWorld 同时改变 action space,因果解释不干净。Opus 34-task subset 里还有明显 regression,例如若干 baseline 已满分的任务被 LongHorizon 做坏。
- WeaveBench 与 OSWorld 没有报告多 seed 或统计显著性。Terminal-Bench 每题三次,但主框架仍没有多次独立 orchestration run 的方差分析。
- 内部 Auditor 仍由模型生成自然语言判断。Workspace mutation guard 能抓到写文件,却不能证明语义判断已经校准,也没有报告 Auditor 对每类错误的 precision / recall。
- 成本高度依赖模型和任务。一个更谨慎的 harness 可能提高成功率,也可能让弱模型在恢复循环里消耗三倍 token。
如果要沿这个方向继续发论文,我会优先做四组实验:固定总 token / wall-clock 的预算对比;对 task state、fresh context、Auditor 的完整因子消融;跨模型互审和 auditor calibration;把 task state 从自然语言升级为带 provenance、invalidation 和 confidence 的结构化状态图。这样才能回答 LongHorizon-Harness 目前没有回答的问题:提升究竟来自更好的记忆、更干净的上下文、更严格的 judge,还是更多次尝试。
留言