INTERACTIVE PAPER DECK26 页交互图解:从 Godot 的物理更新到错误实现校准 展开阅读
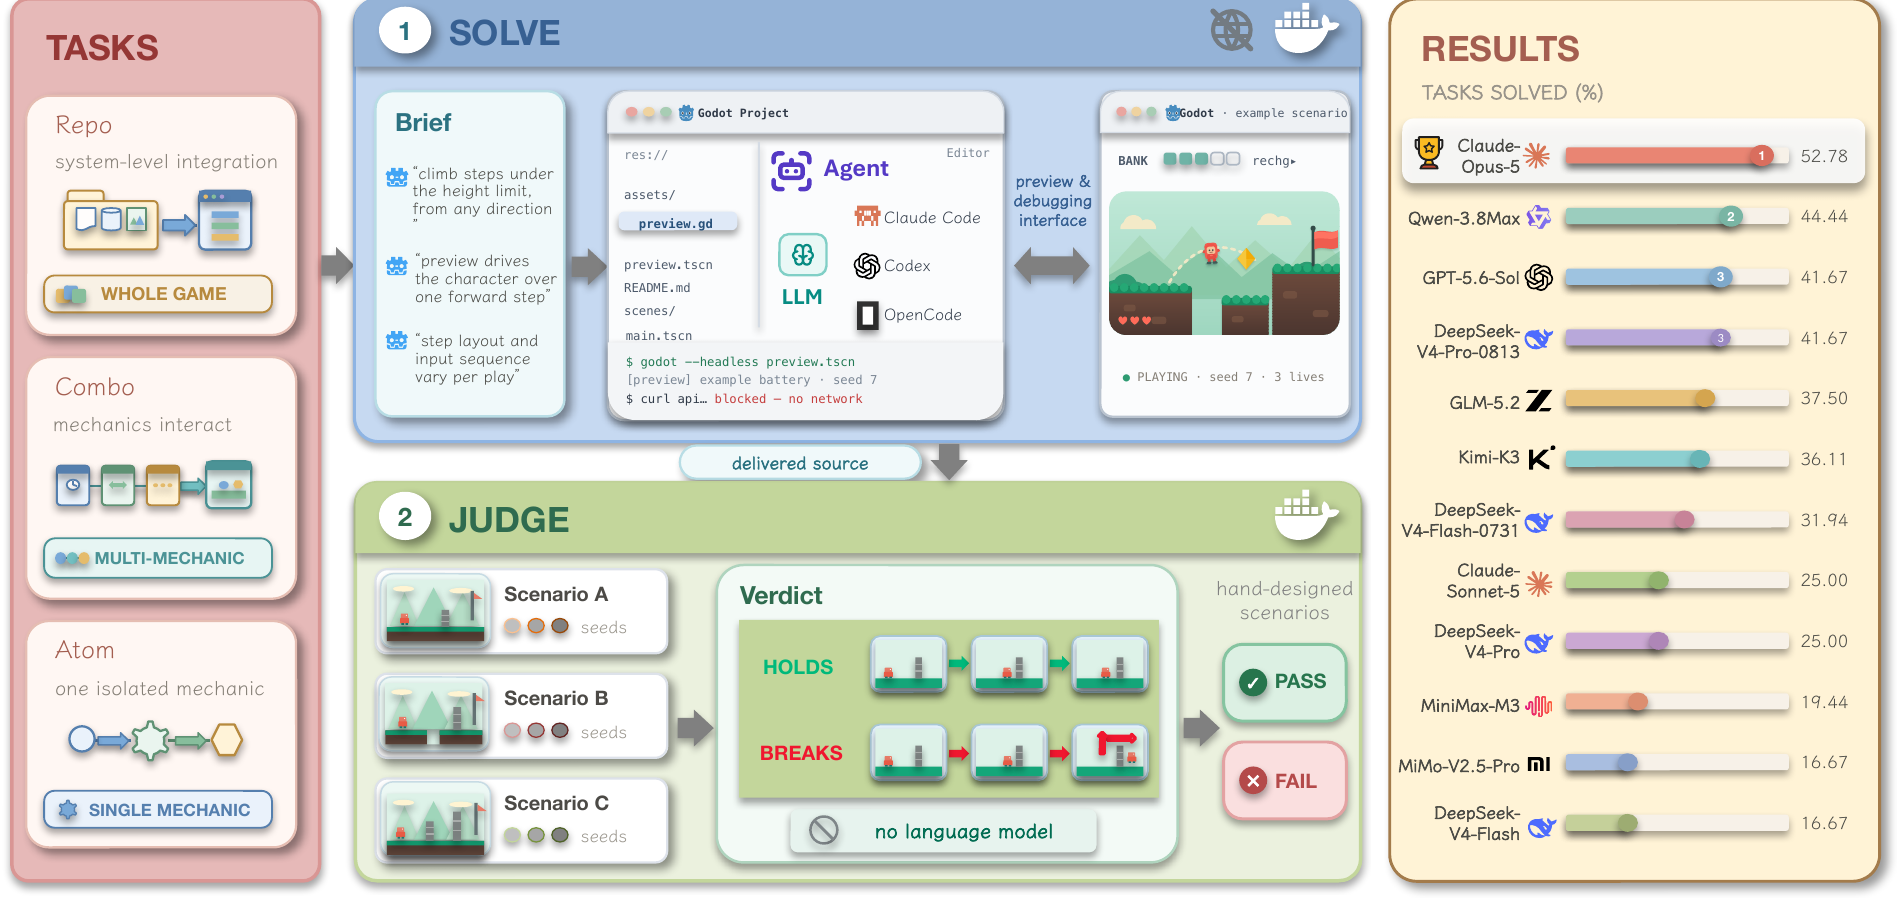
GameLogicBench 要测的是:模型能否在现有 Godot 游戏项目中补好指定玩法,并在不同地图、输入和时序下始终遵守规则。作者用程序检查整个运行过程,而不只看最终画面或结果。最佳配置一次解出 38/72 题;多数失败项目可以运行,问题出在玩法行为。
Godot 怎样运行一段游戏代码
Godot 是游戏引擎,负责绘制画面、读取输入、模拟碰撞和调用游戏脚本。它用节点(node)分担这些工作,再把节点组织成可保存、可重复使用的场景(scene)。例如一个角色节点 CharacterBody2D 下面可以挂碰撞体、贴图和相机;关卡场景再放入这个角色。
游戏脚本通常写在 Godot 自带的语言 GDScript 中,并附着在节点上。引擎每做一次物理更新,就调用脚本的 _physics_process(delta);delta 是这一步经过的仿真时间。这种离散更新步称为 simulation tick。本文说“逐 tick 检查”,就是在运行的每一步检查状态和事件,不等游戏结束后才验收。它与画面刷新不是同一个概念。
节点还可以发出事件通知,Godot 称为 signal。例如角色受伤后发出 health_changed,界面收到后更新血条,不必让角色脚本直接操纵界面。
player.gd · 为本文写的 Godot 4.4 背景示例,不是 benchmark 任务
1 | extends CharacterBody2D |
这段脚本需要挂到有碰撞体的 CharacterBody2D;在项目的 Input Map 中配置 left/right/up/down 四个动作后,才有对应按键输入。它每个物理步读取方向,让引擎处理移动和碰撞。调用 take_damage 时,生命值变化并通知订阅者;snapshot 是本文加的公开读取示例,不是 Godot 自动生成的评测接口。
背景依据 Godot 4.4 的 Nodes and Scenes 与 Using signals。论文实际只评测 Godot 4.4 + GDScript,不覆盖其他引擎和语言。
1. Motivation:为什么游戏逻辑需要检查整个运行过程
同一个最终结果,可能来自正确过程,也可能掩盖中途违规。 资源系统如果先错误地扣掉 10 单位、下一步又补回 10,最后余额仍正确;角色也可能先擦过墙体,再到达终点。冷却时间、跳跃落地、状态切换和同一帧的多个请求,都有这类过程约束。
已有评测可以看视频、检查最终状态,或让另一个模型操作游戏并打分。GameLogicBench 聚焦能由程序明确判断的玩法规则:运行期间是否一直满足约束、换了合法输入是否仍然正确、同一提交重跑是否得到同一判定。
作者把被测系统称为 coding agent,本文简称 Agent:模型通过框架提供的读文件、改代码和执行工具,在已有游戏项目中补全指定脚本。判分程序称为 judge,它在 Godot 内运行提交并检查状态、事件和时间。这里评价的是指定玩法逻辑,不包括美术、趣味、关卡内容或整款游戏的体验。
2. Related Work:与已有游戏开发评测相比,它改变了什么
最近的对照是同样在 Godot 项目中补代码的 GameDevBench;差别主要在测试证据与场景覆盖。 GameDevBench 使用测试脚本,部分任务会在多个运行时刻读取状态,但每题只有一个手工场景。GameLogicBench 把多时刻状态检查用于全部任务,并由 judge 为每题选择 2–12 个手工场景,再通过随机种子改变数值参数。
论文 Table 1 还比较了从零生成游戏、模型打分和真实工程补代码等设置。表中“确定性”表示决定区分成绩的判分部分不依赖模型判断;“Tick-level”表示至少在两个仿真步读取游戏状态,不一定意味着每一步都查。论文对自身协议的描述更强:固定时间步运行并逐 tick 检查。
| Benchmark | 给 Agent 的任务 / 产物 | 判分依据 | 不依赖模型判断 | 多 tick 状态检查 | 每题手工场景 |
|---|---|---|---|---|---|
| SWE-bench | 真实软件仓库;提交补丁(patch) | 单元测试 | 全部任务 | 不适用 | 不适用 |
| Terminal-Bench 2.0 | 终端任务;生成或修改文件 | 单元测试 | 全部任务 | 不适用 | 不适用 |
| WebCompass | 交互网页;从零生成或修改 | Agent 操作并判断 | 否 | 不适用 | 1 |
| WebGameBench | 从零生成浏览器游戏 | Agent 操作并判断 | 否 | 否 | 1 |
| GameDevBench | 真实 Godot 项目;提交 patch | 测试脚本 | 全部任务 | 部分任务 | 1 |
| JAMER | Godot 项目;从零生成或修改 | 引擎内验证 | 全部任务 | 否 | 1 |
| GameCraft-Bench | 从零生成完整 Godot 游戏 | 视觉语言模型(VLM)判断 | 否 | 否 | 1 |
| GameEngineBench | 真实 UE5 / C++ 项目;提交 patch | 测试与语言模型判断 | 否 | 部分任务 | 1 |
| AutoUE | 从零生成 UE5 / C++ 项目 | 语言模型判断 | 否 | 否 | 1 |
| GameLogicBench | 专门构建或真实 Godot 项目;全部提交 patch | 引擎内状态、事件断言 | 全部任务 | 全部任务 | 2–12 |
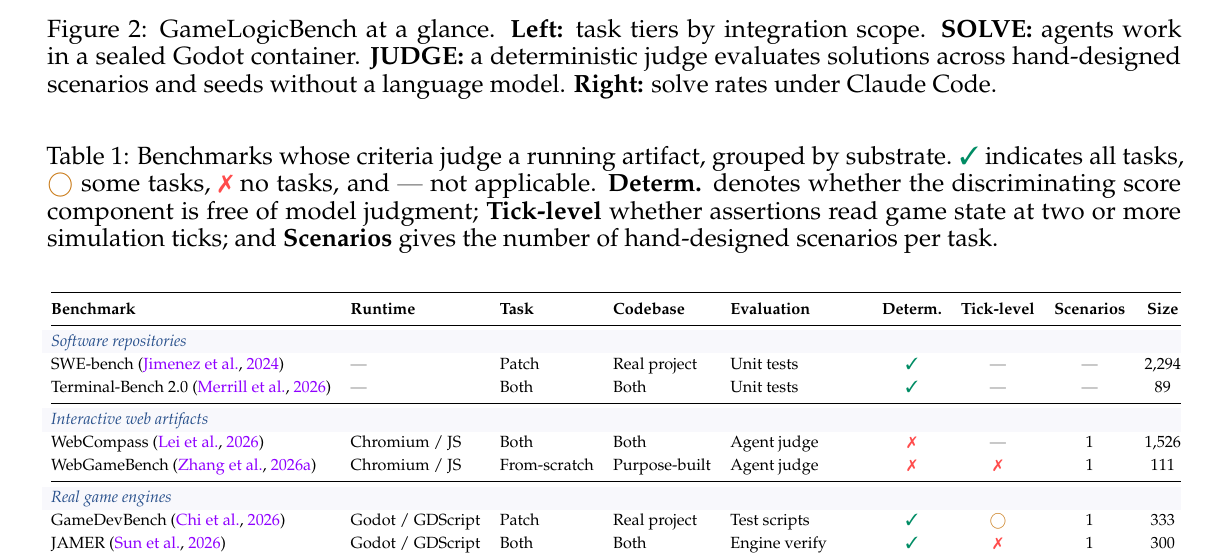
这是作者选取的运行中产物评测集合,不能据此宣称所有代码 benchmark 都缺少这些性质。它也没有证明程序判分能够替代体验评价;这里先把研究对象收窄到能写成明确运行规则的机制,再增加检查深度。
3. Benchmark / Protocol:任务怎样构建,一份提交怎样得到判定
先把规则、可修改接口与隐藏测试固定,再用同一套 judge 检查每份提交。 理解这条链,要分开任务构建和提交评测:前者决定测什么、测试是否可信,后者决定某份代码是否通过。
3.1 任务包与数据来源
一道任务(task)包含说明文档 brief、给定 Godot 项目、公开可运行示例 preview、可提交的文件范围,以及 Agent 看不到的计分场景和 judge。brief 写行为与接口要求,Agent 要补指定 GDScript 或组件,不需要生成整个项目。
三种层级(tier)描述需要接入多少现有系统:
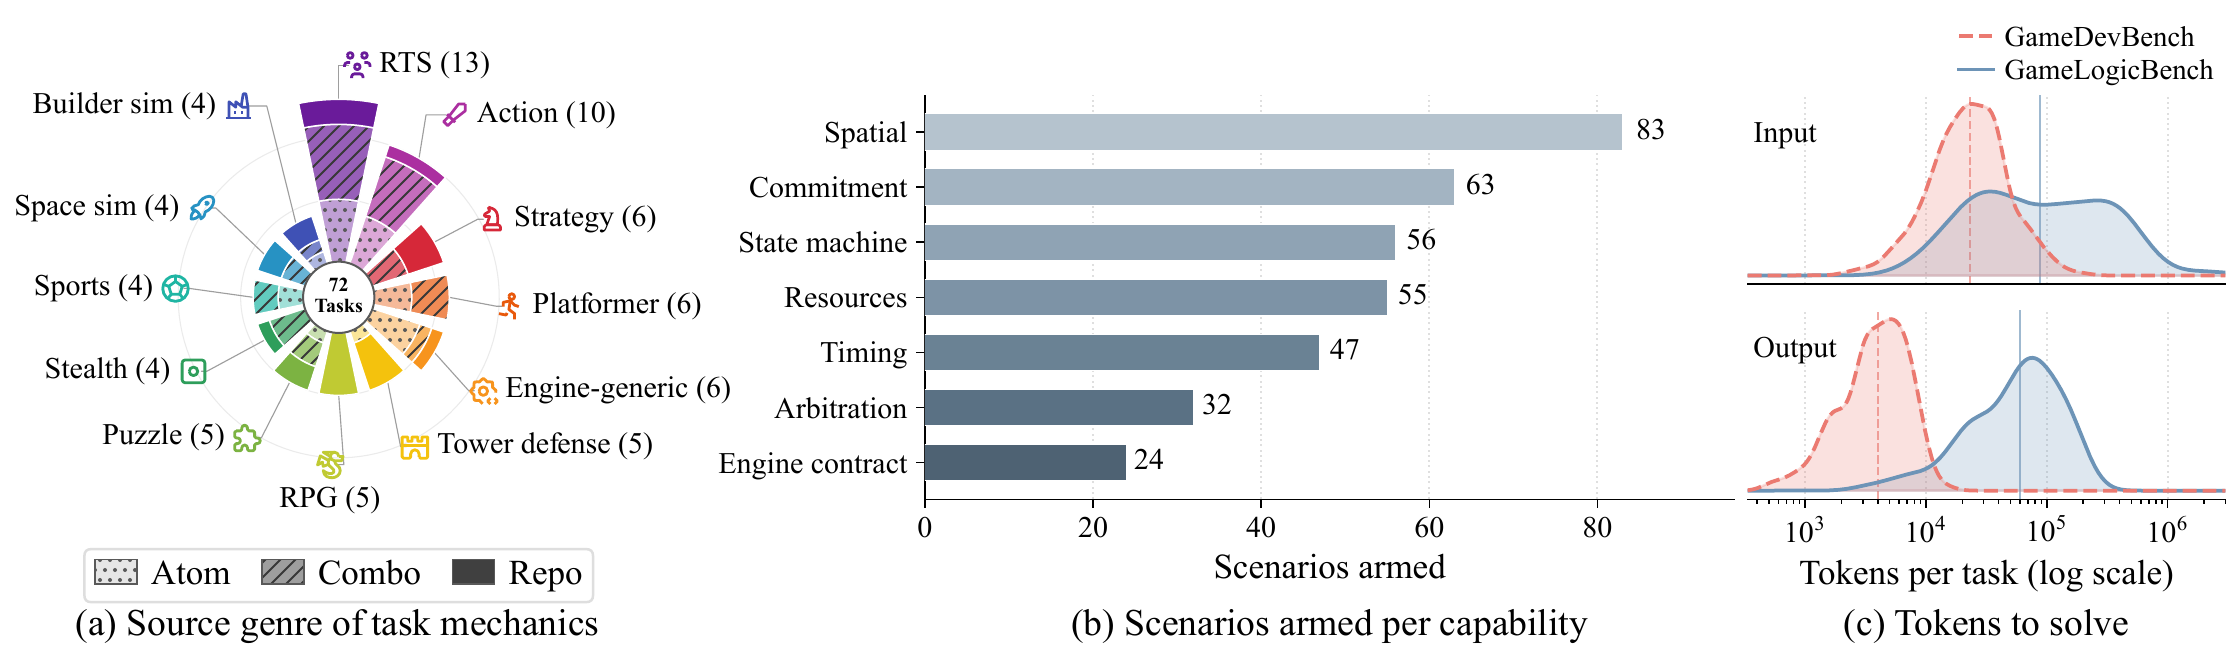
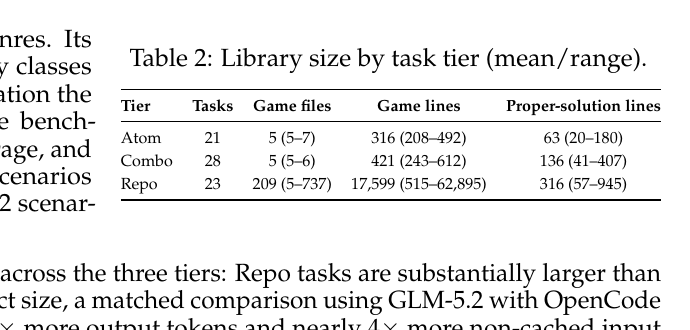
- Atom:为 benchmark 专门做的最小游戏,隔离一个机制,例如敌人寻路;21 题。
- Combo:仍是专门构建的小游戏,但同时要求几个机制在时间、空间或并发调用下兼容;28 题。
- Repo:在真实项目规模的系统中补充指定机制,同时保持动画、相机、资源和其他组件依赖的接口与共享状态;23 题。Appendix G 给出三种构造方式:补完项目原本缺失或未完成的系统;移去已有子系统后重新实现(carve out and reimplement);在现有系统相互约束下新增机制。它们都补缺失功能,不是按报错修已有缺陷。
Repo 在数据中更难,但 tier 的定义是集成范围,不是预先给题目贴难度标签。Repo 平均含 209 个游戏文件、17,599 行代码;Atom / Combo 都平均只有 5 个文件,分别为 316 / 421 行。Agent 要在较大的项目里找到行为控制位置、读懂调用方,并避免修好一处却破坏另一处。
候选机制来自开源 Godot 仓库、已发布游戏和按功能能力整理的分类。仓库代码只有许可证允许才复用;不能复用时,作者重做机制。借鉴已发布游戏的机制时,作者新写游戏,不复制原游戏代码或素材。§Ethical Considerations 只明确说其中 20 道 Repo 题源自公开开源 Godot 项目,未解释与 Repo 总数 23 的差别,不能把全部 23 题都写成直接移除上游代码的任务。
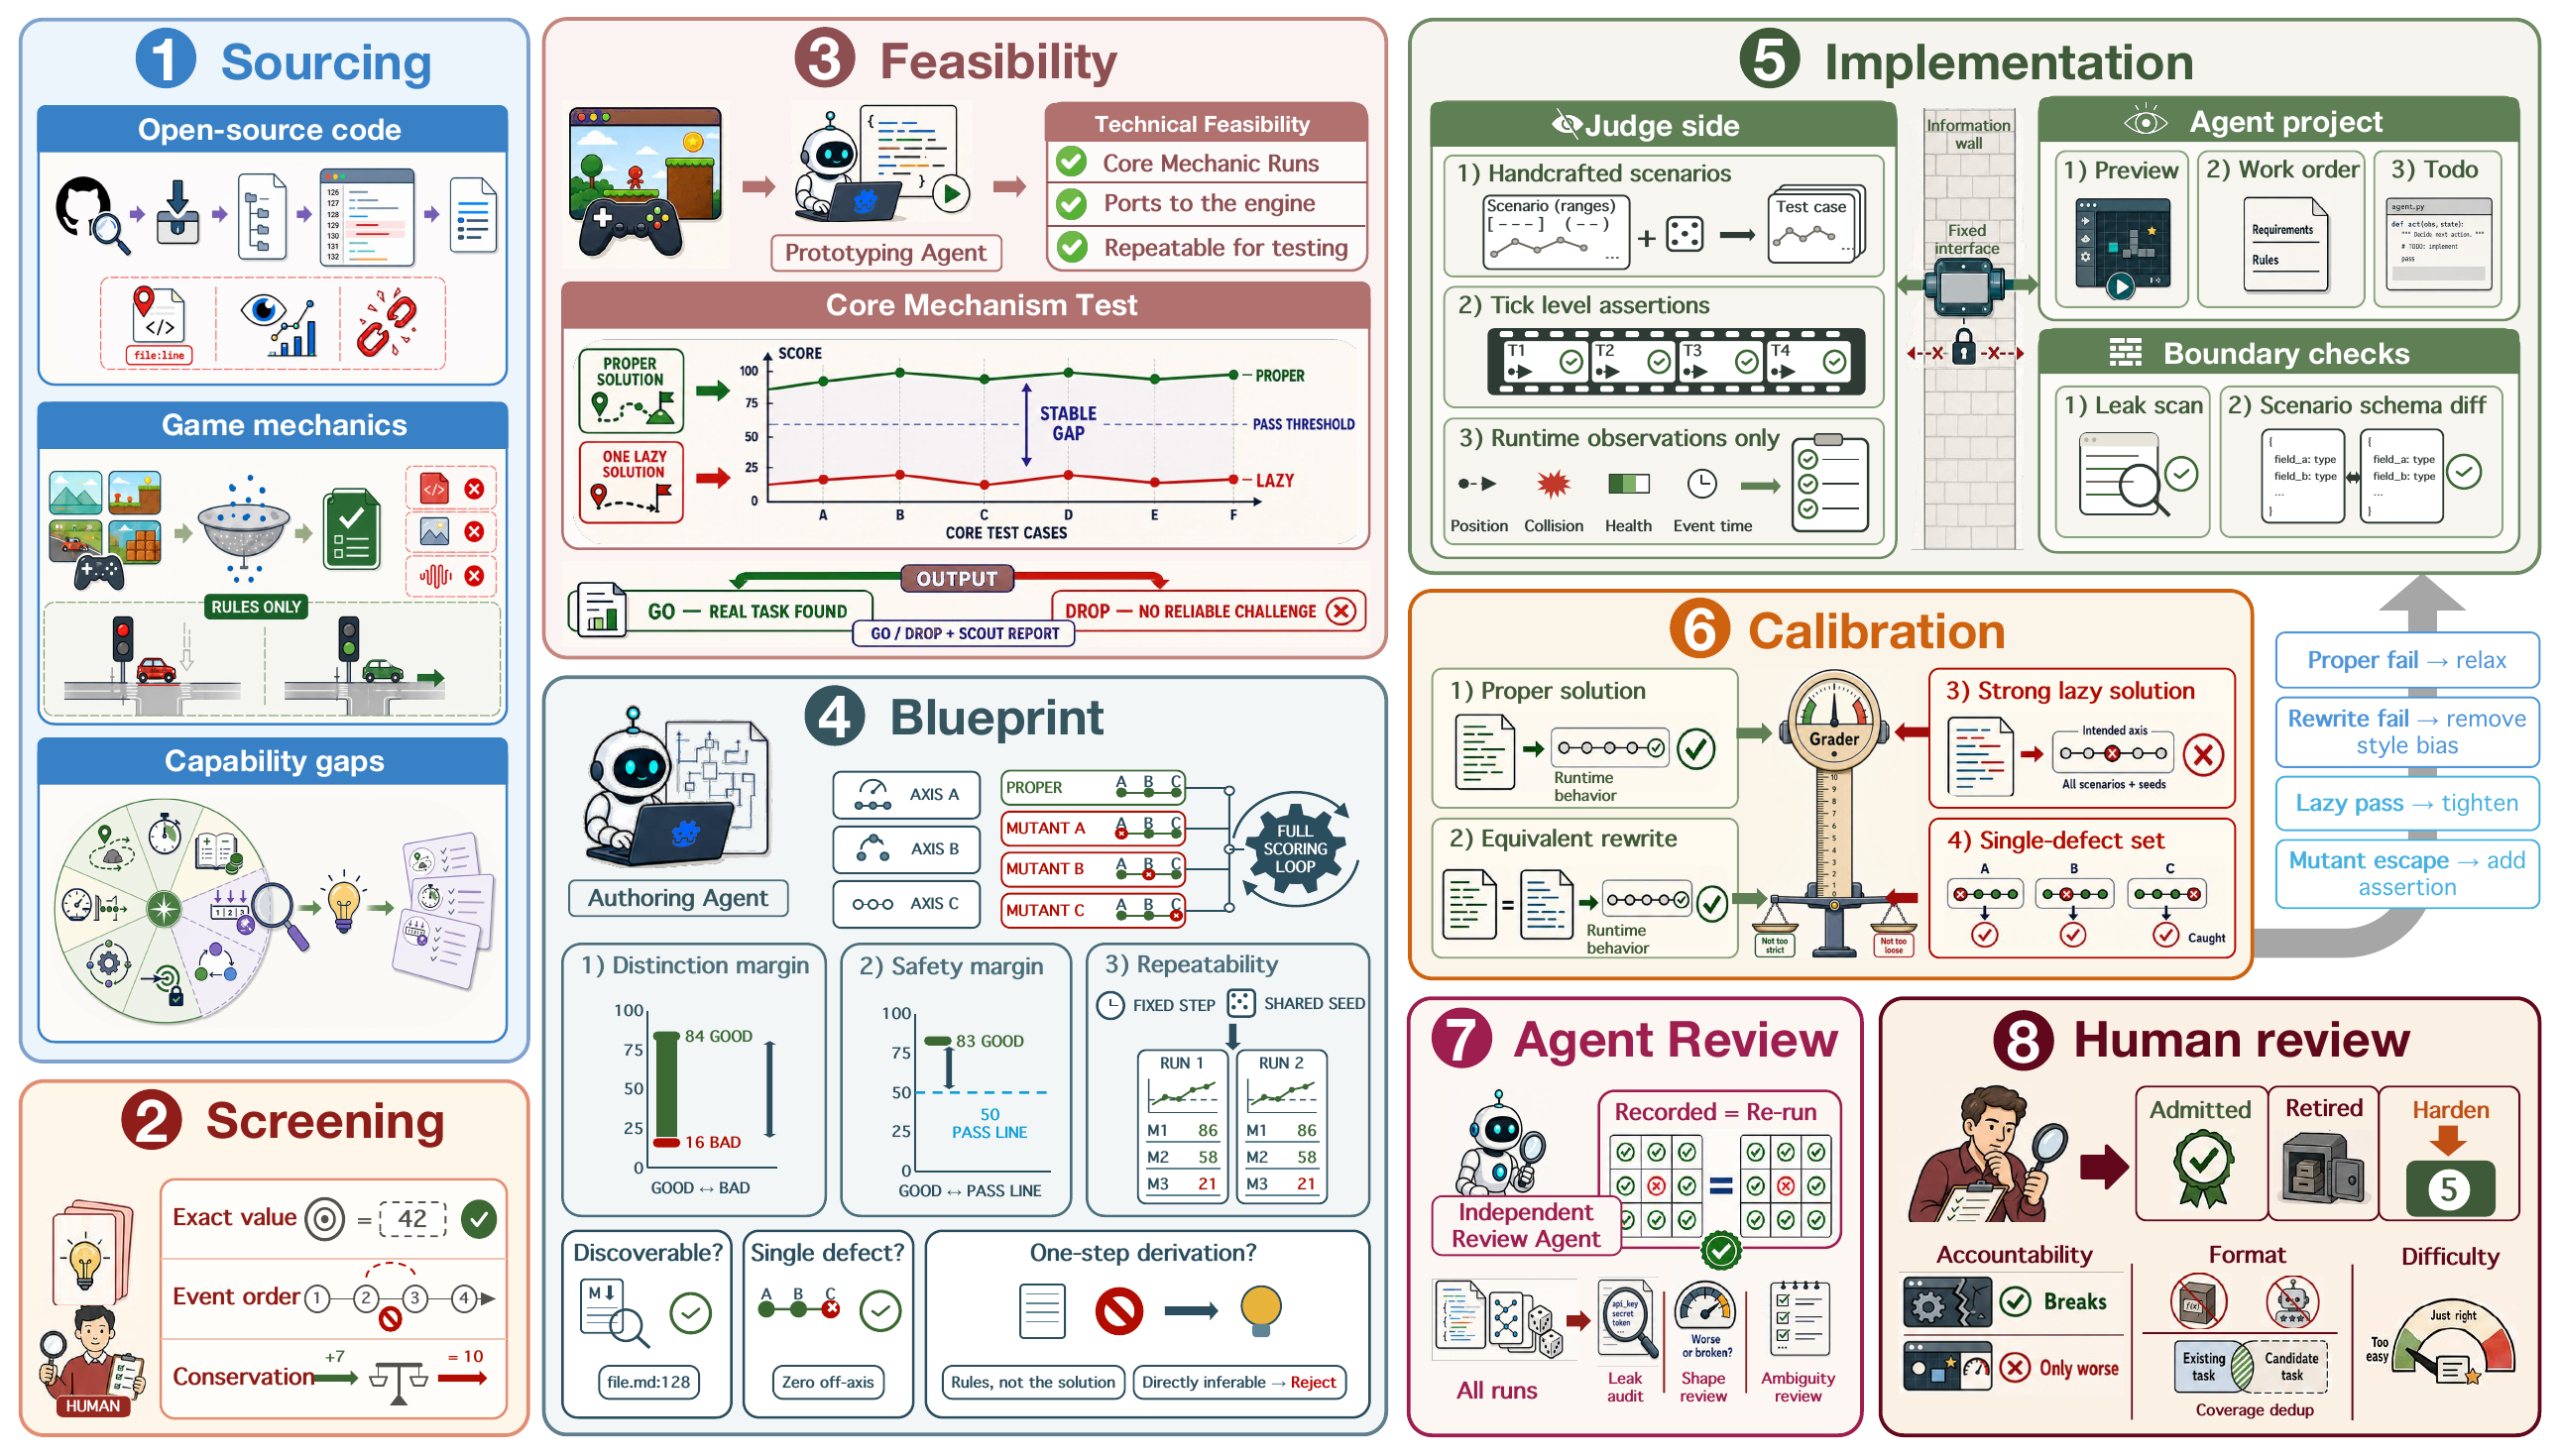
三名人工标注者先筛掉依赖审美或体验判断的机制。保留项的正确性必须能够写成唯一值、合法事件顺序,或运行中应守恒的量;还要有实现挑战并支持完整运行。辅助构建的 Agent 先比较正确与常见错误实现,再形成任务设计,最后生成给被测 Agent 的项目、judge 和校准样例。能直接照 brief 写出而无需处理运行交互的候选会被淘汰。
约 200 个想法中,122 个完成构建、校准和独立 Agent 复跑;三名标注者最终录取 72 个,其他候选退修或淘汰。论文没有给出标注者一致率,也没有说明最终录取采用多数票还是一致同意,不能据“三人复核”推断这些统计。
3.2 公开材料与隐藏测试的边界
Agent 看得到规则、接口、可修改文件、公开 preview 和调试输出。每题只展示一个场景结构,但 Agent 可以换随机种子(seed)运行这个示例。judge 使用同一行为规则和接口,另外选择地图、输入序列和调用时序。隐藏的是具体计分实例和 judge 实现,不是另外一套玩法规则。
作者手工设计测试结构,称为 scenario;例如从哪个方向接近台阶、后面是否有高墙。seed 再给高度、距离或时间等数值参数取值,一个 scenario × seed 构成一个测试用例(test case)。全库有 403 个 scenario、1,451 个 test case;每题 2–12 个 scenario、10–38 个 test case。
3.3 一次提交的执行顺序
承载模型并提供读写、命令工具的框架,论文称为 scaffold,例如 Claude Code、Codex 或 OpenCode。负责复制工作区、隔离容器和启动测试的外层评测程序是 harness;它不等同于被测模型的 scaffold。
- harness 在求解容器中交给 Agent brief、项目和公开 preview。Agent 可以运行与调试游戏;模型 API 可访问,其他出网访问被封。
- 求解结束后,harness 把 Agent 工作区复制到另一个完全断网的 judge 容器。
- 官方 README 说明项目按
game → solution → judge顺序组装。冻结 judge 最后覆盖,因此 Agent 调试时改了同名文件,也不会替换最终检查程序。 - judge 遍历每个计分 scenario 及其 seeds,启动一个固定 timestep 的运行。它可以采用接口允许的同时调用、重复进入同一方法(re-entry),或改变时间参数;改变的是合法执行条件,不是规则。
- 每个 tick 检查运行状态和事件记录,结束时再检查终局条件。所有相关条件成立才给该 case 输出 PASS,否则 FAIL。
- 固定运行环境、judge、提交、scenario 和 seed 后,重跑判定相同。评分过程不调用语言模型。
统一协议来自论文和公开 harness 的 README;不能把 README 当成 72 道题的断言代码。独立任务库 NJU-LINK/GameLogicBench-Tasks 在 2026-09-22 的历史核查中返回 404。本文没有据此宣称它今天仍不可用。以下三个 case 依据论文公开的完整 brief 与场景例子;没有取得每题隐藏 checker,因而不能逐行复跑其断言与容差。
下面的 GDScript 风格伪代码仅表示论文协议,不是官方 judge,也不是可运行 Godot 程序:
1 | for scenario in hidden_scenarios: |
3.4 Case 1:Enemy Navigation,路径到达却擦到墙角
Atom / Enemy Navigation
- Agent 得到公开 preview,并每个物理帧接收
self_pos、goal_pos、角色radius、world、nav_map、时间步dt与累计时间t。 - Agent 提交
res://logic/controller.gd及允许的 helper。decide(state) → Vector2返回移动方向;非零向量由游戏归一化,角色前进固定距离;Vector2.ZERO表示停留。 - judge 换地图场景与 seed,使墙、门洞、起点和终点不同。角色必须在任务时间预算内到达,并且整个身体从不接触墙,擦到墙角也算违规。公开 brief 未给具体时限,不应补成某个秒数。
- 按规则展开的失败:控制器只为中心点规划路径,没给半径留空间。在门洞某一帧,中心没进墙但身体擦过墙角;后来抵达终点也无法消除这次违规。
这类错误解释了只查终局的盲点:最终的“已到达”没有记录到达之前的触墙。
3.5 Case 2:Platform Guard,坐标名单不等于可见目标
Combo / Platform Guard
- 每帧输入含守卫位置、速度、是否着地,全部平台与塔(tower),家所在的平台(home platform)以及
intruders。最后一个字段始终列出所有访客的真实坐标,不替控制器筛选可见目标。 - 控制器返回
{"move": float, "jump": bool, "chasing": int}。move限在 [-1,1],jump只在着地时接受;chasing为正在追的目标 ID,没追时为 -1。 - 目标必须同时在
vision_range距离内、视线没有被塔或平台挡住,才算可见。控制器要自己计算这个条件;光看名单或距离都不够。 - 公开要求还包括安静期巡逻覆盖至少 34% 的家平台可行走范围;看到访客后及时在地面上接近至 130 世界单位;安静后离家不超过 6 秒,再恢复巡逻。空中掠过 130 单位范围,不算完成接近。
- 测试改变平台宽度、间隙、出生点和来访时序,并可放遮挡视线的塔。每次 watch 是 1,800 帧,即 30 秒、60 Hz;公开物理常量为速度 200、跳跃初速度 -400、重力 980、角色胶囊半径 12。
chasing=id。目标实际不可见,违反“只追看得见的目标”,即 brief 的 ghost chase(声称追逐不可见目标)。
3.6 Case 3:AMSG Character Movement,接口正确还要行为兼容
Repo / AMSG Character Movement
- 这个案例采用移去已有实现再补回的方式(carve-out):Agent 接手真实第三人称角色项目中的
CharacterMovementComponent.gd,补回被移去的方法体。类名、导出属性、状态字段和签名不能改,因为动画、相机、PlayerController 和其他组件都在使用它们。 - 它要实现行走(walking)、跑步(running)、冲刺(sprinting)三种步态,以及松开输入后的减速、蹲伏、头顶阻挡、全方向上台阶和跳跃。调用方按住方向时每步调用
add_movement_input(...),松开后停止调用;其他组件可在移动途中改变gait(步态等级)、stance(站立或蹲伏姿态)与rotation_mode(朝向控制模式),运动必须立即使用当前配置。 - 离地后有 0.1 秒确认窗口,之后才进入 airborne(空中状态);确认前不能标为空中状态,也不能提前施加重力。头顶被挡住时不能站起或靠跳跃增加高度。
- 公开 preview 沿 +X 方向上合法台阶。论文披露的计分场景沿 -X 接近,后方再放超过最大台阶高度的墙。角色要爬合法台阶,但不能把高墙也当成台阶。
- 本文按规则写的 FAIL:探测方向固定为 +X,公开示例能通过;换成 -X 后仍向另一侧探测,角色卡在合法台阶。这个错误不代表论文公开了相应模型日志。
3.7 分数怎样从运行步汇总到整题
每个 case 的逐 tick 与终局断言都要成立;每个 scenario 的全部 seed 通过,才是该场景严格通过(strict scenario pass);一道 task 的所有计分 case 通过,才是 solved。
Solve rate = solved tasks / 72。 无可判定提交或求解过程不可用的结果仍计失败,不从分母删除。因此最佳 38/72 = 52.777…%,四舍五入为 52.78%。1,451 个 case 没有被直接平均成这个标题分数。
能力分析用的是不同单位:先对每个 scenario 的所有 seed 严格合取,再在有某能力标签的 scenario 中计算通过率。场景可能带多个标签,所以能力分组的分母不能相加,也不能拿它与整题 solve rate 直接比较。
3.8 如何验证 judge 没有误杀与漏判
作者在录取任务之前准备四类校准实现。正确实现(proper solution)要跨全部 scenario 和 seed 通过,且不贴着容差边界;内部写法不同但行为相同的正确实现(behavior-preserving control)也要通过。包含常见错误的 naive solution 必须失败;每次只删掉一项目标能力的 single-capability mutant,至少要被专门暴露这项缺失的一个场景抓住。
独立 Agent 再复跑全部场景和 seed,检查校准结果与公开/隐藏边界,最后三名人工标注者决定录取。具体容差不是统一给定值;没有取得各题 checker,不应在案例里补一个假定阈值。
这步有实际证据:36 题审计集的修补前检查放过 127/666 个 mutant,暴露 19 道任务中的 24 个缺失检查。修补后,9 个模型 × 2 个框架的历史提交有三份由 PASS 变 FAIL,涉及两题、三个模型;正确实现和等价正确实现仍通过。只验证“好实现能过”,不能证明“坏实现过不了”。
4. Experiments:实验测到了哪些失败,哪些比较最有说服力
最强证据来自固定提交重判:删掉过程检查或隐藏场景,都会让本来失败的代码过关。 主表则显示模型和框架共同决定成绩;它只有一次运行,不足以给模型排稳定能力名次。
4.1 实验设置与主结果
论文测试 20 个模型与执行框架配对,使用 Claude Code 2.1.177、Codex 0.144.1、OpenCode 1.17.18,求解与判分都是 Godot 4.4。全部求解设置 effort=high,每题最多 3,600 秒。主表每个配置只做一次完整运行。
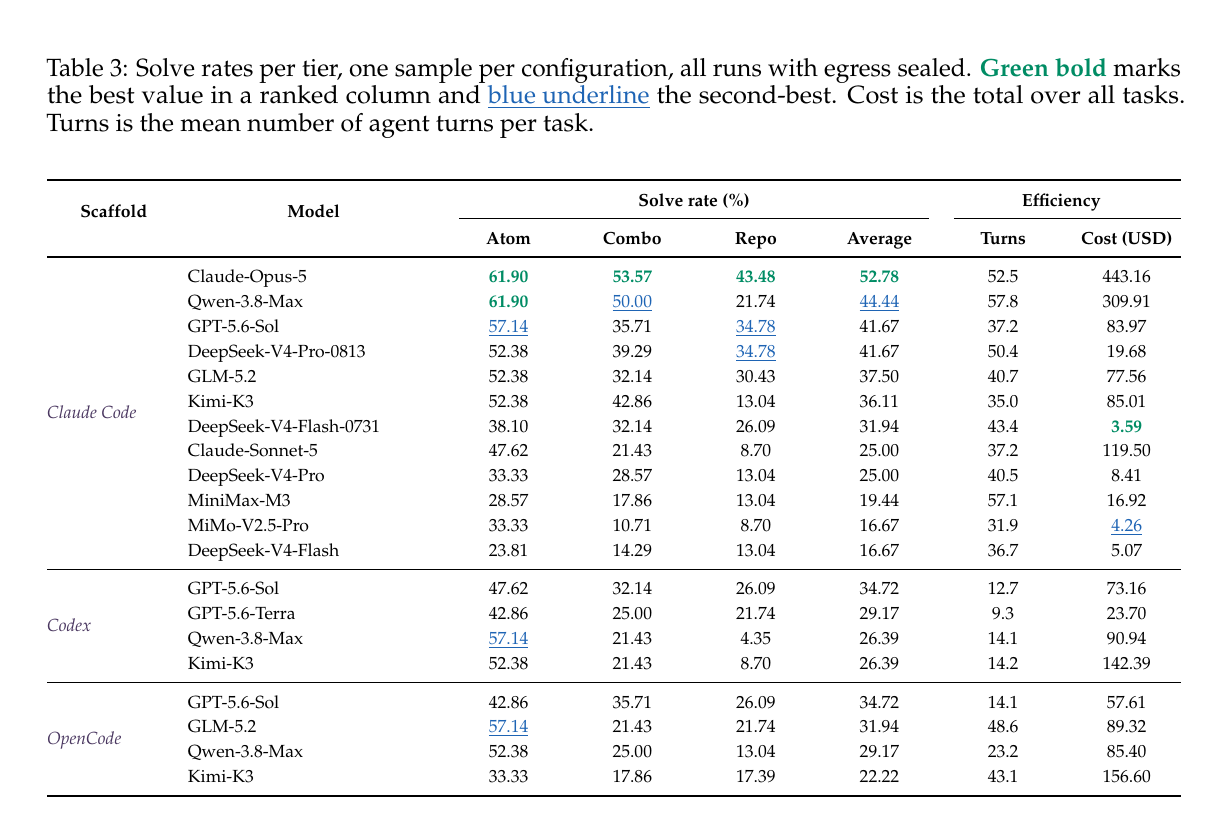
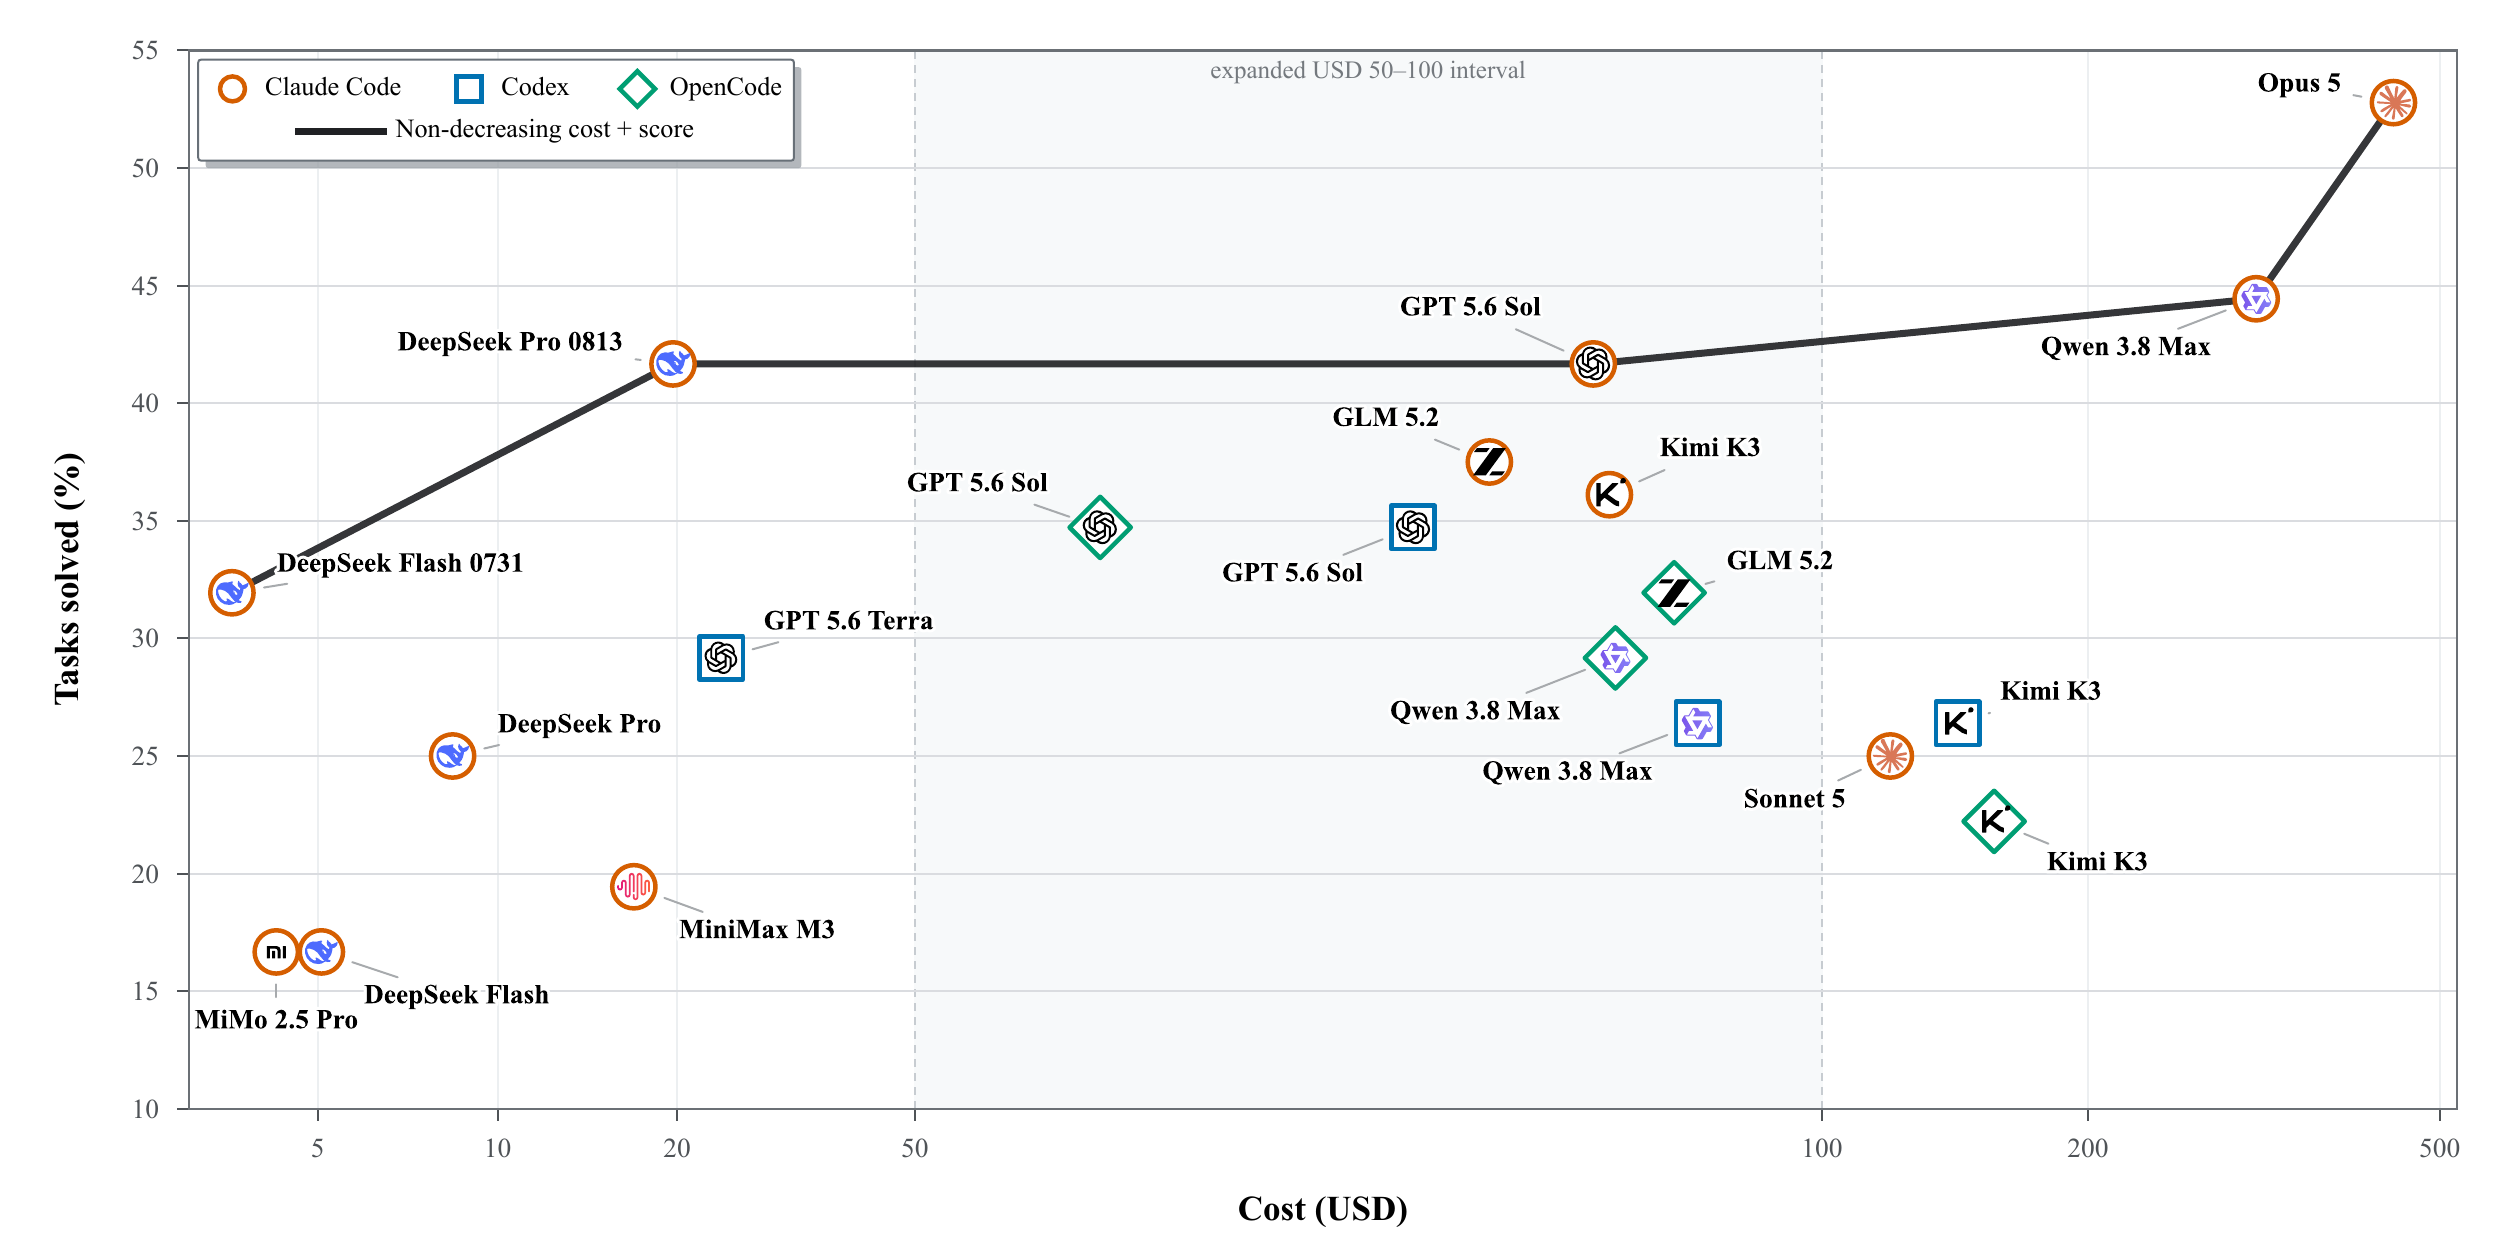
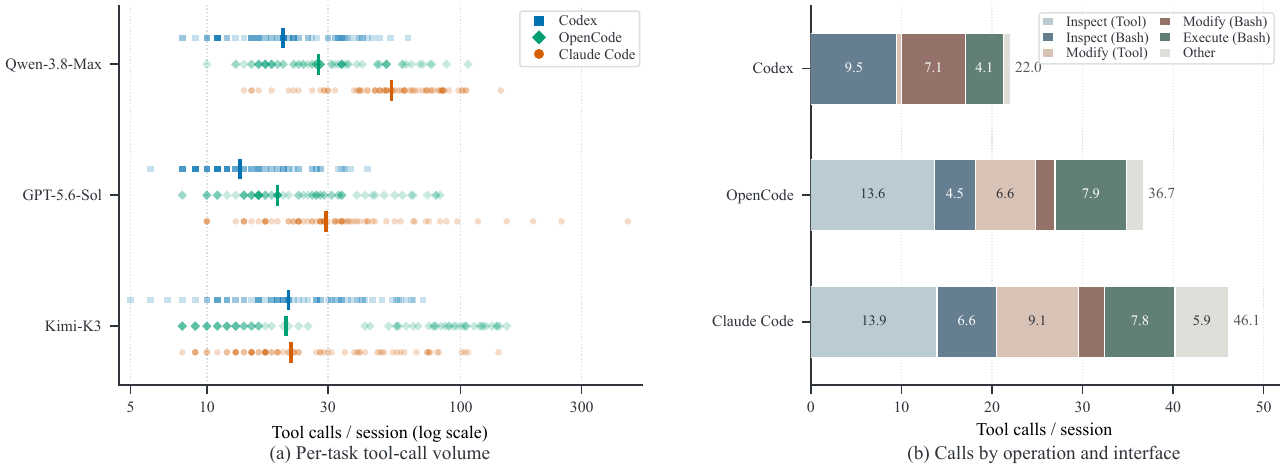
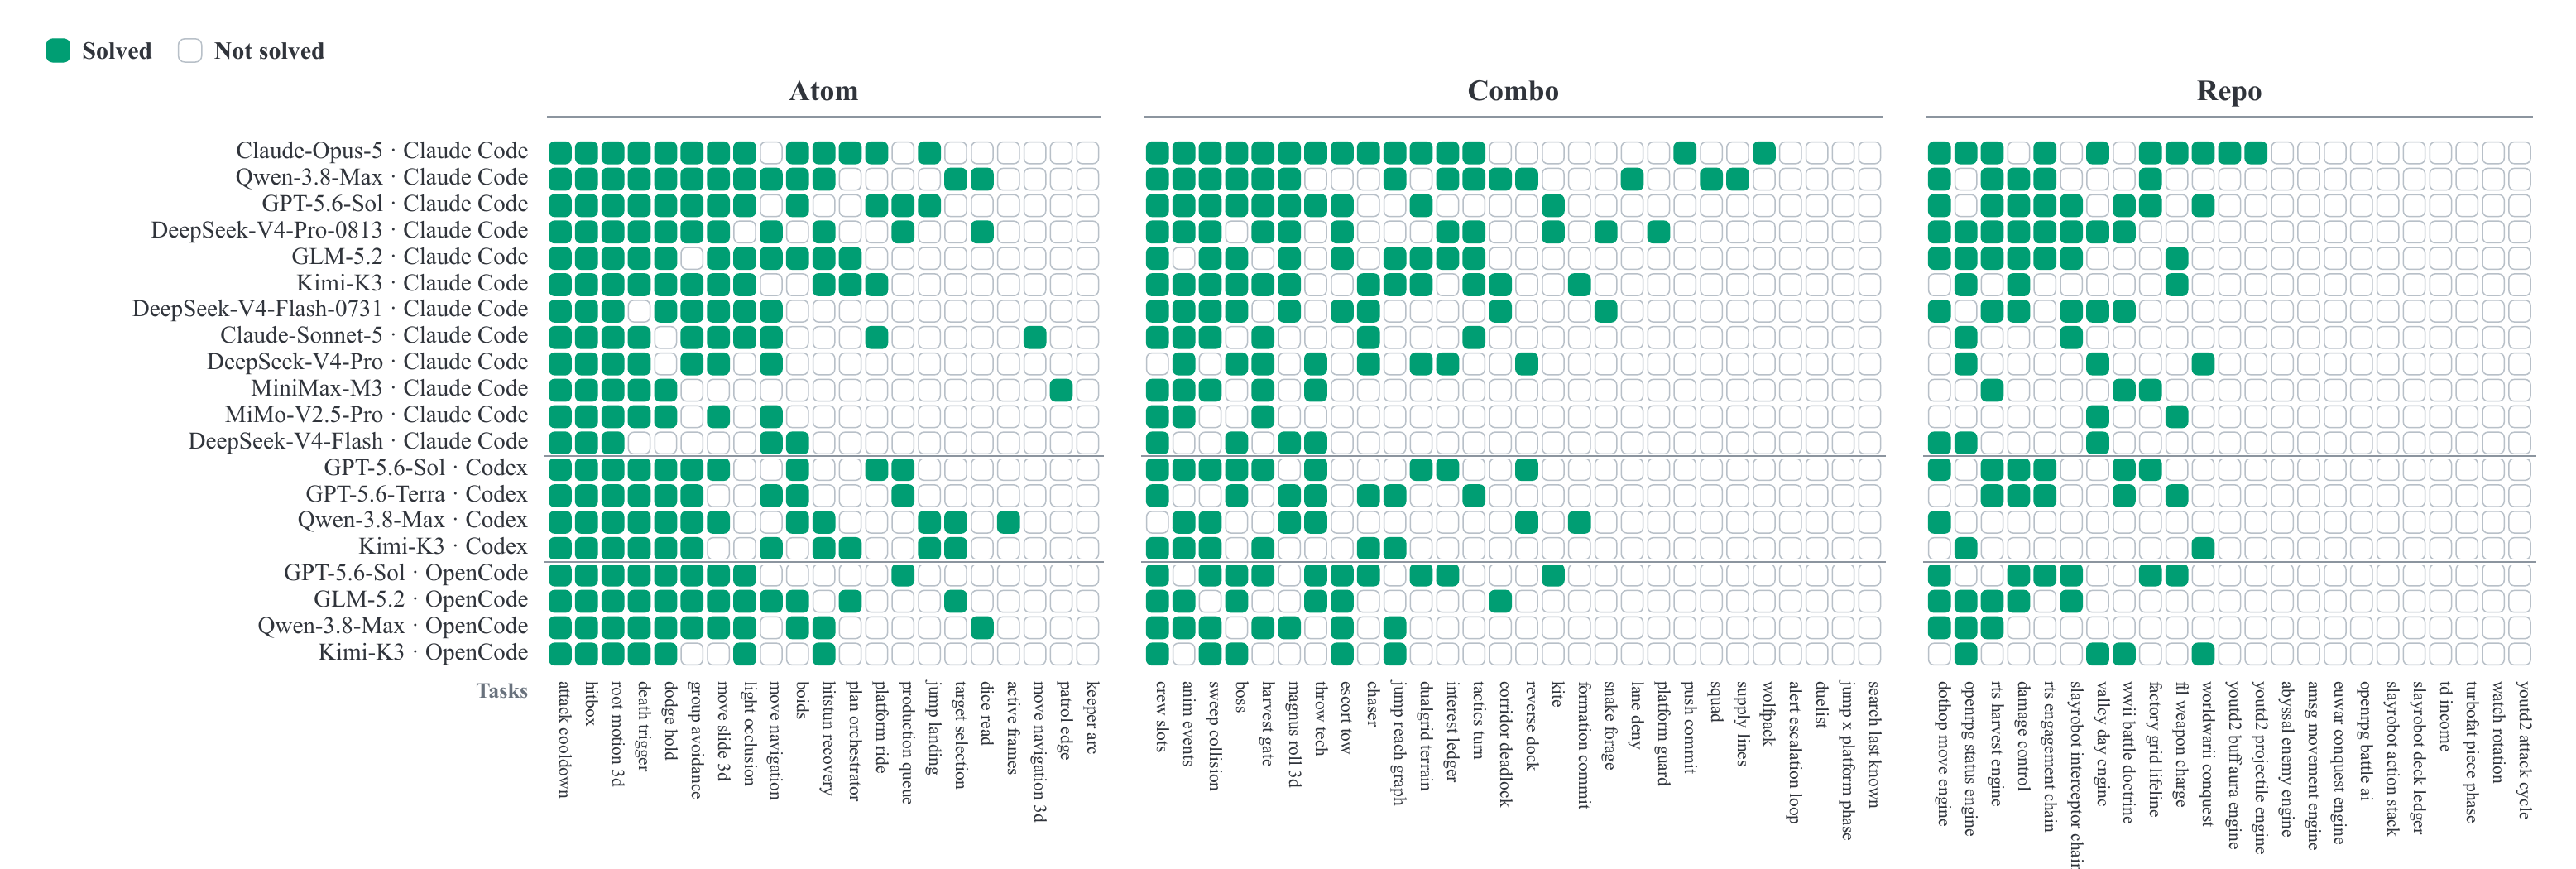
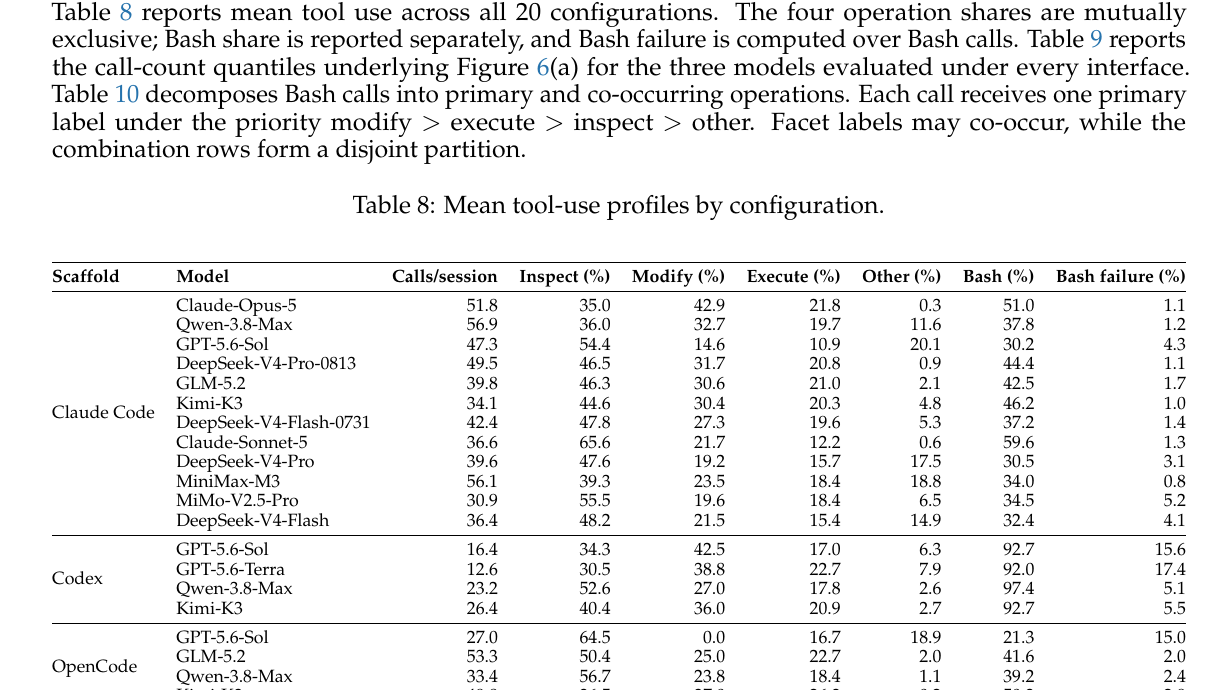
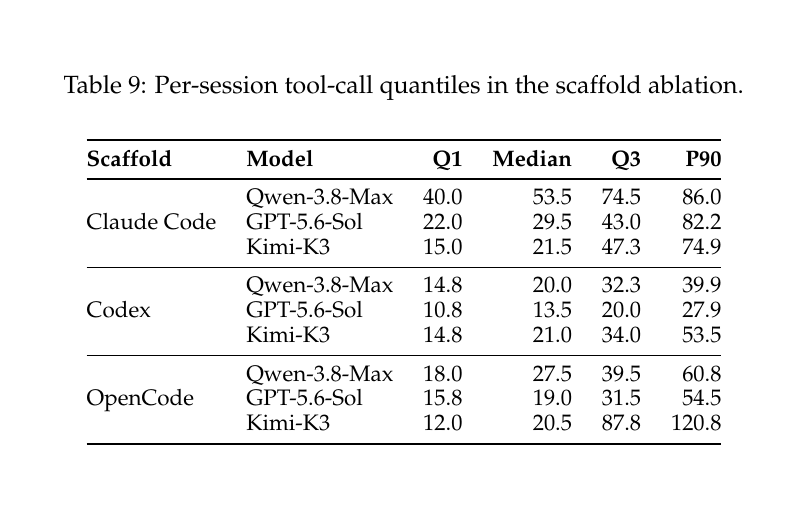
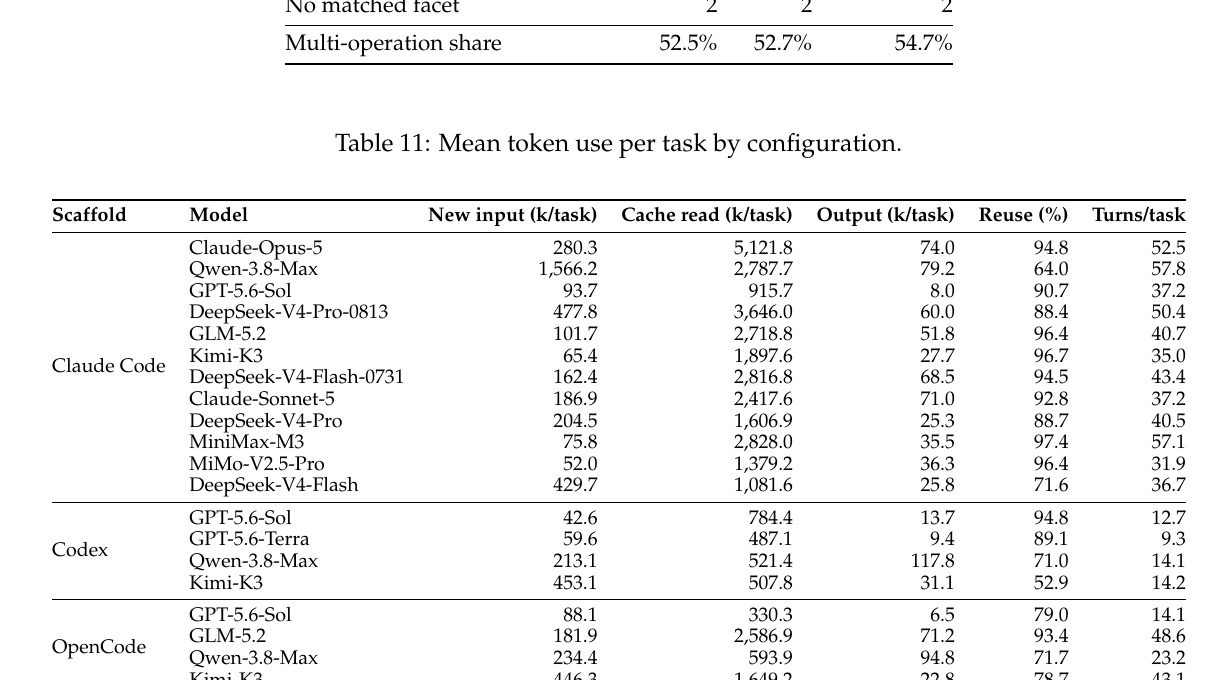
Qwen-3.8-Max 在 Claude Code / Codex / OpenCode 分别为 44.44% / 26.39% / 29.17%;GPT-5.6-Sol 为 41.67% / 34.72% / 34.72%。Codex 平均模型交互轮数最少,并且 Qwen、GPT 在其下的各报告分位工具调用也较少。但工具调用少不稳定对应更好或更差的成绩,论文没有把它作为单独原因。
4.2 集成范围扩大,运行尝试增加仍然掉分
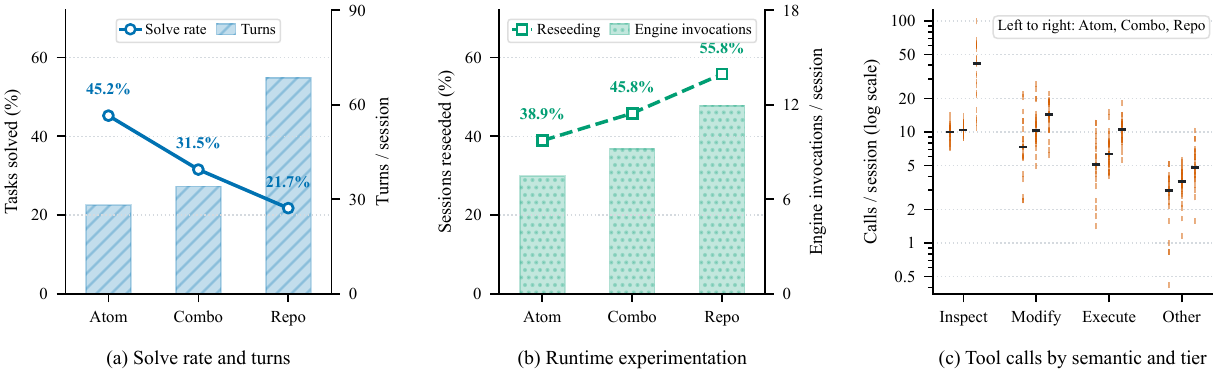
固定 Claude Code,12 个模型都从 Atom 到 Combo 再到 Repo 下降;汇总解题率为 45.2% → 31.5% → 21.7%。Agent 在 Repo 花更多交互轮、启动引擎更多,也更常改公开示例的随机种子:相关会话比例从 Atom 的 38.9% 到 Repo 的 55.8%。
4.3 能启动引擎,仍维持不好具体规则
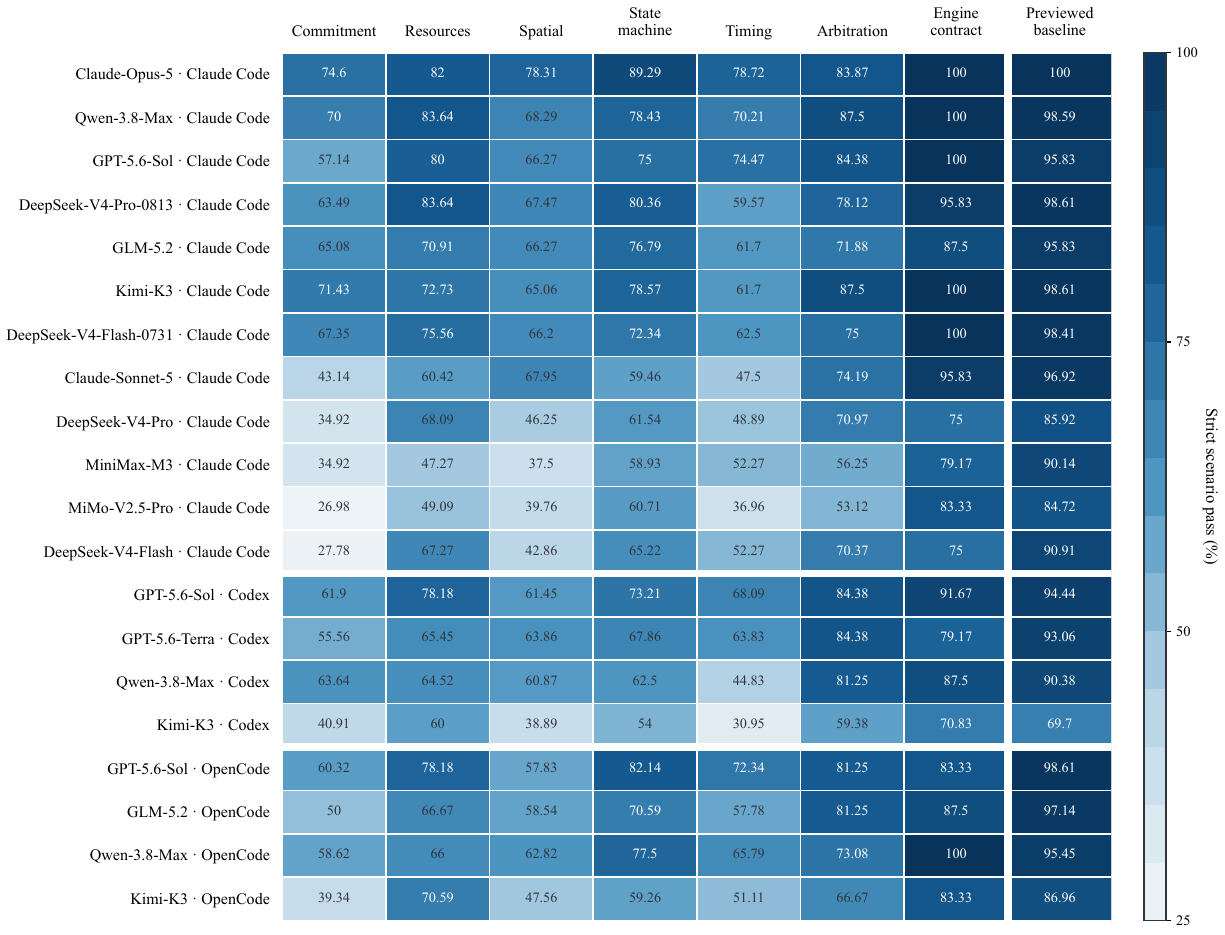
在合并统计的失败 scenario 中,74.3% 的提交可以运行且可判分,但违反玩法规则;17.2% 没有可判定提交,8.5% 求解过程不可用。这三个比例的分母是失败场景,不是 72 道题,也不是所有运行。
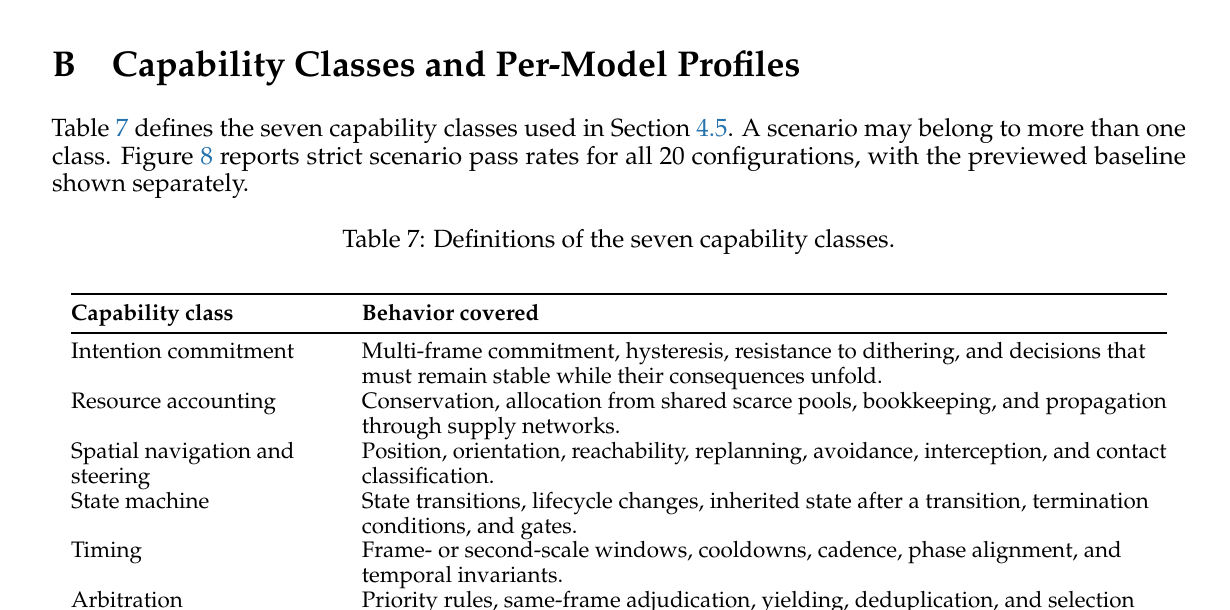
七类能力包括跨多个帧保持一个决定的 Intention commitment,资源守恒与共享分配的 Resource accounting,空间寻路与避障的 Spatial navigation and steering,状态转移的 State machine,冷却与时间窗口的 Timing,同帧竞争请求的优先级与去重的 Arbitration,以及正确使用 Godot 时钟、求解器和子系统的 Engine contract。
4.4 固定测试与提交,删哪一层会漏什么
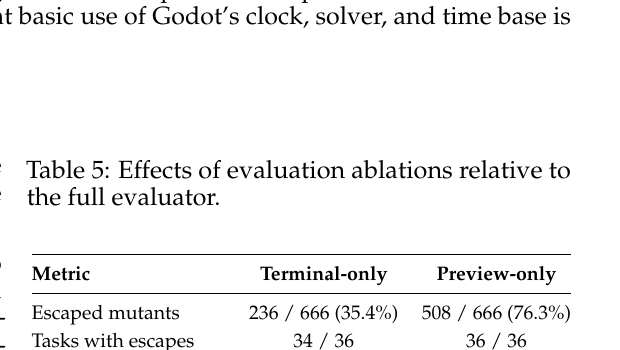
36 题审计集含 666 个 mutant 和 20 配置 × 36 题 = 720 份模型提交;其中 488 份在完整 judge 下失败。作者不重新生成代码,而是给同一批产物换判分方式。
只查终局(Terminal-only)保留全部 scenario 与 seed,删掉中途断言:236/666 个 mutant 逃过,34/36 题至少漏一个;64/488 份原失败提交变成通过。平均解题率增加的分母是全部 720 份提交,因此 64/720 × 100 = 8.89 个百分点,不是 64/488。
只查公开示例(Preview-only)保留逐 tick 断言,却仅跑公开 scenario:508/666 个 mutant 逃过,全部 36 题都漏掉错误;418/488 份原失败提交变成通过。因此 418/720 × 100 = 58.06 个百分点。
4.5 开放网络改变了评测问题
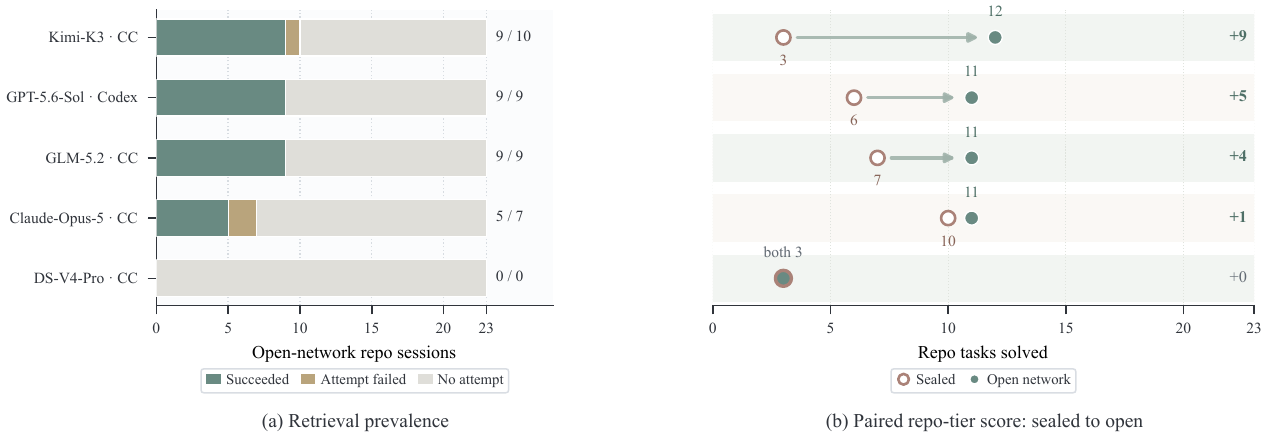
在 Repo 上,作者给五个配置开放网络,并与各自封闭运行对照。四个配置检索到了上游源码,人工检查轨迹发现直接复用;这四个配置解出题数都上升。Kimi-K3 + Claude Code 从 3 题增至 12 题,增加九题。第五个配置没尝试检索,成绩也没变。
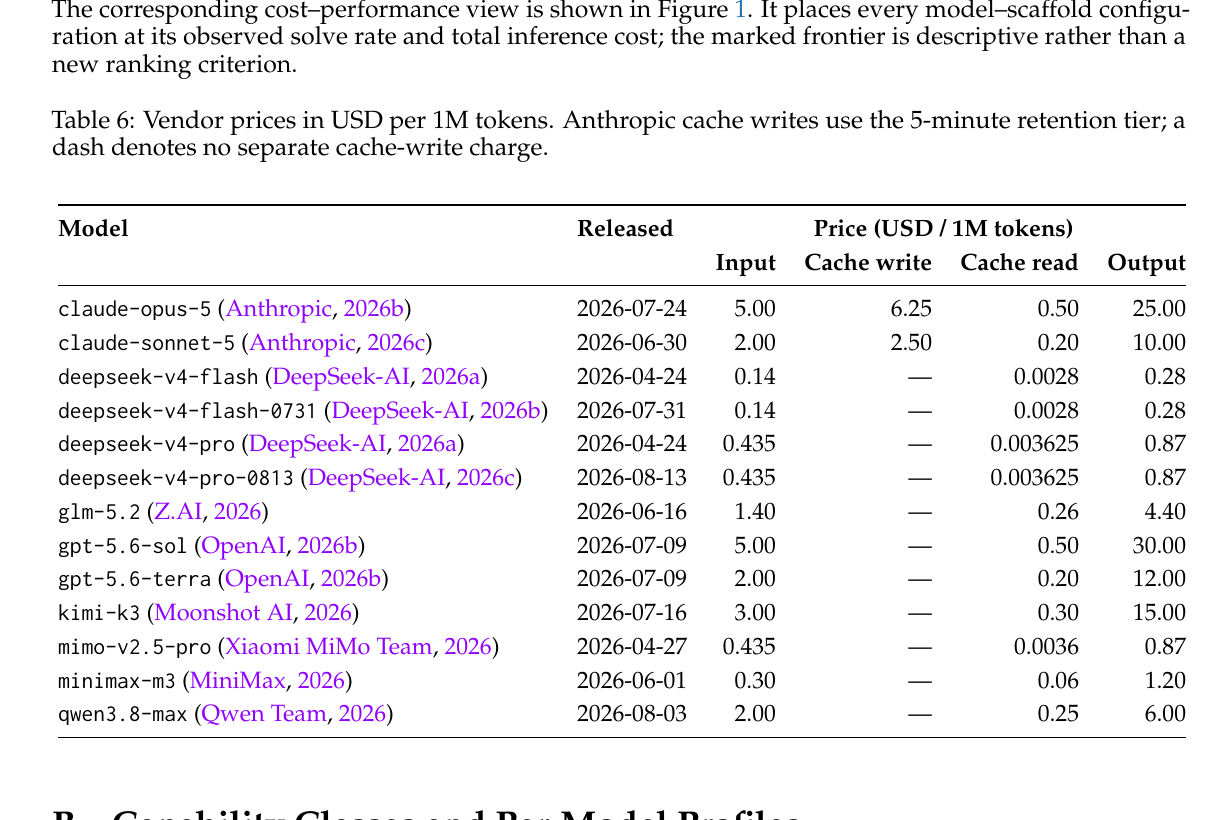
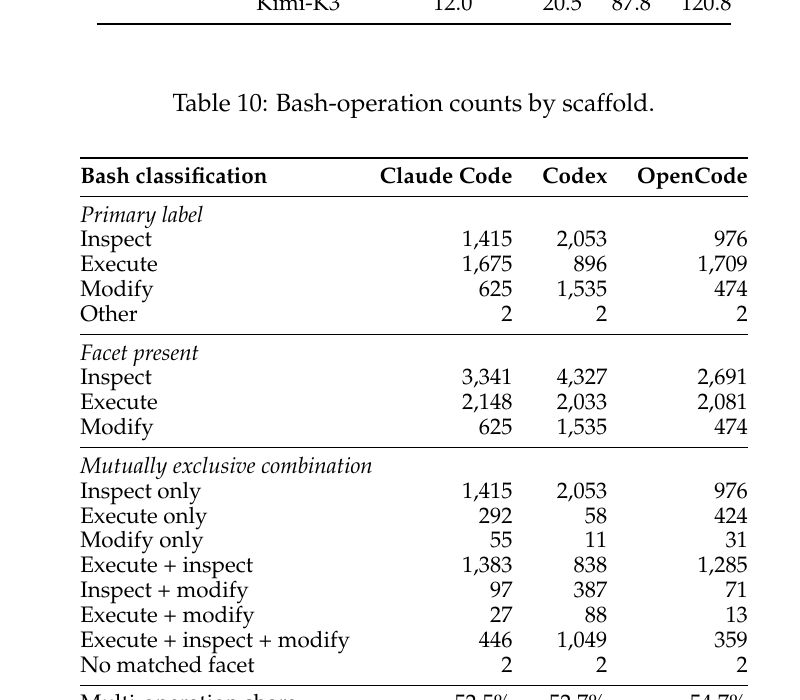
完整原始图表索引论文的 9 张 Figure 与 12 张编号 Table 均有记录
5. Discussion:后续研究最该隔离哪些因素
优先分开“真正实现规则”和“碰巧适应示例”,再谈更大任务或更多工具。 这不是论文已经验证的新方法,而是据现有失败证据提出的下一步实验。
可以固定模型、工具与时间预算,比较三种求解反馈:只给公开 preview;给更多合法输入变体;给首次违规的时间、状态和事件。需要另留未见过的计分场景,否则增加反馈只是帮助模型适应测试。观察整题 solved、过程违规类别和总工具/token 成本,比只报公开示例通过更能回答反馈有没有用。
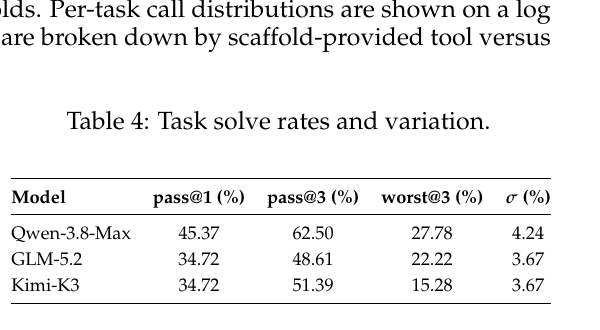
还要增加重复运行。论文在 Claude Code 下为 Qwen-3.8-Max、GLM-5.2、Kimi-K3 各跑三次:pass@1 是三次题级解题率均值,pass@3 是至少一次解出的题目比例,worst@3 是三次都解出的比例。单次分数标准差为 3.67%–4.24%,约两三题;pass@3 与 worst@3 差 26.39–36.11 个百分点。因此一次 38/72 不等于稳定可解那 38 题。
方法迁移到 Unity、Unreal 或多人游戏还需新证据。现在只覆盖 Godot 4.4、GDScript 和单容器游戏;网络同步、异步任务及多客户端事件顺序会增加控制难度。美术、节奏与玩家体验也不能自动写成同类确定性断言,需另用体验评价补充。
最后,应把公开复现与防直接检索一起设计:明确任务、judge、参考解和校准错误实现的版本,保证别人可以复跑,同时另留计分新变体。本文保留任务库的历史可用性缺口;没有取得的隐藏代码,不用“合理猜测”补成官方实现。
6. Conclusion:最值得保留的结论与边界
它的贡献是同时检验运行过程、输入变化和检查程序本身。 多场景避免只适应公开示例,逐 tick 检查避免最终结果掩盖违规,正确与错误实现校准则避免 judge 接受错误或误杀另一种正确写法。
这三部分的证据力度不同:固定提交重判的消融直接显示简化测试会漏错;666 个 mutant 的反查实际修补了 judge;20 配置主表则是单次结果,不能当成稳定模型排名。最佳 52.78% 和 Claude Code 下 Repo 汇总 21.7% 也都要放回严格整题分母理解。
读这篇最有用的收获,是如何把一句“这个玩法实现对了”拆成可以重复检查的条件。它没有评价完整游戏体验;封闭出网不是无训练污染的证明;三个公开 brief 也不等于完整隐藏任务库。这些边界与主结果一样,应当留在解读中。
留言