一个专门设计的 agent harness 可以让模型更会用工具、更少犯流程错误,但这些收益通常和那套 harness 绑在一起。Harness-Zero 的目标,是把专用 harness 诱导出的做事方式写回模型参数:训练时让一个 harnessing agent 在每次执行前审查 student 的下一步,必要时把它改写成 student 原本就能执行的动作;SFT 结束后,部署只留下微调后的模型和一个最小 harness。
Q1. 为什么要把 harness 蒸馏掉?
Harness engineering 已经是一条有效的 agent 优化路线:给模型增加工具、在关键节点做检查、把长期任务拆开、保存跨任务经验,都能提高完成率。问题在于,提升发生在模型外面,部署时就必须继续携带那套系统。
这会形成两个不太理想的选择。只保留一套通用 harness,模型会失去领域流程和专用工具带来的收益;为不同领域、实例和模型保留多套 harness,又需要持续维护路由、上下文、调用链和兼容性。模型升级以后,原先写死在代码里的假设还可能过时。
Harness-Zero 把目标写成一个明确的迁移问题:训练阶段有一套经过优化的 harness,部署阶段只允许使用固定的最小 harness。论文用三个符号区分它们:
execute Bash 工具和固定 system prompt。h* 改写成给 harnessing agent 读取的私有参考 harness。它不直接挂在 student 上。要解决的难点并非普通的 teacher–student distillation。h* 可能提供部署时不存在的工具,也可能在 student 看不到的地方直接读 sandbox、阻止动作或改写状态。直接模仿 h* 下的轨迹,会把这些不存在的 tool calls 一起教给模型。论文把这个问题称为 action-space mismatch。
Q2. 它和已有工作差在哪?
相关工作大致有三条线。第一条优化 harness 本身,例如 Meta-Harness 自动搜索工具、middleware、skills 和 memory;收益很好,但上线仍要带着优化后的 harness。第二条共同优化模型和 harness;模型更新会利用新 harness 采集的数据,不过最终能力仍可能依赖训练时的外部系统。第三条蒸馏 privileged guidance:EvoHarness-RL 和 OPHSD 都说明模型能吸收一部分外部流程,但前者部署时仍保留 workspace,后者没有完整的交互式工具循环。
| 方向 | 训练或推理时做什么 | 部署时还需要什么 | Harness-Zero 的边界 |
|---|---|---|---|
| Harness optimization | 搜索更好的 prompt、tools、workflow、middleware | 优化后的专用 harness | 把已经找到的行为转成训练数据 |
| Model–harness co-evolution | 交替或联合更新模型参数与 harness | 通常仍依赖共同优化后的 harness | 部署目标固定为最小 h |
| Privileged-guidance distillation | 蒸馏 verifier、plan–solve 或外部状态管理 | 有的方法仍保留部分外部机制 | 处理完整 tool-using harness 与 action-space mismatch |
| Harness-Zero | 用 agent 把 h* 的指导逐步改写成 h 中可执行的 response | 微调模型 + 固定 h | 当前仍不擅长深领域知识和无法写成 response 的机制 |
论文的关键区别是 enforcement point(干预位置)变了。h* 原来直接包住 student;Harness-Zero 让 harnessing agent 在 response 进入执行器之前做审查。这样既能参考专用 harness,又能保证被接受的动作从一开始就属于 h。
Q3. Harness-Zero 具体怎么做?
3.1 先把 h* 改写成 K
作者先在训练任务上演化 h*,再根据目标 harness h 改写每类组件。工具变成 action recipe,告诉 reviewer 如何用普通 Bash/Python 构造等价操作;middleware 变成 review middleware,只根据 candidate response 和 student 可见轨迹判断是否要干预;skills 变成 review guidance;memory 中积累的失败则变成 failure patterns。
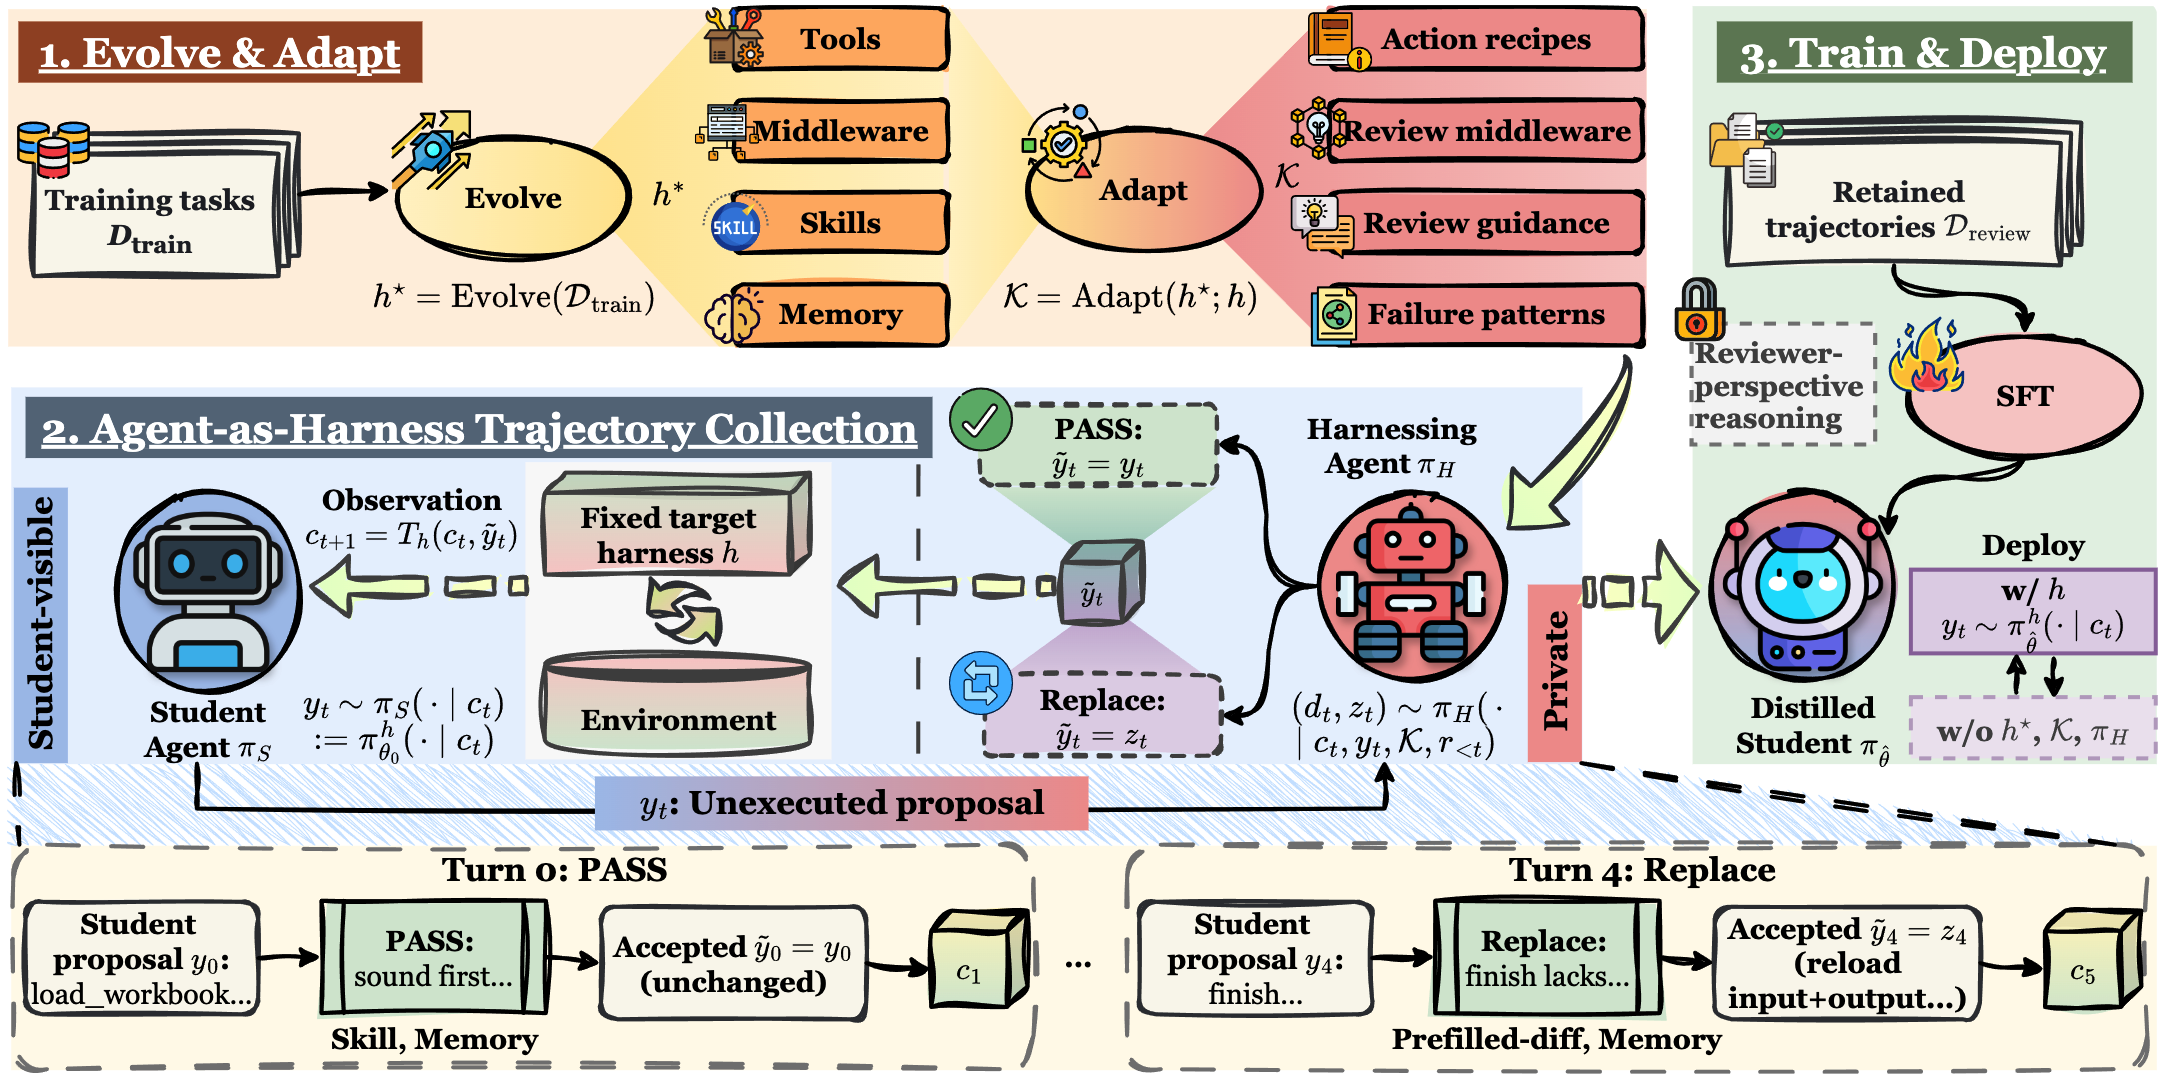
h* 到 K 的改写;中间是每一步 PASS/REPLACE;右侧表示部署时只留下 distilled student 与 h。图片来自作者官方仓库,Apache-2.0。3.2 每个 response 都先审查,再执行
- 1 · PROPOSEstudent 在
h下生成尚未执行的y_t。 - 2 · REVIEWharnessing agent 读取可见轨迹、candidate 和私有
K。 - 3 · DECIDE选择 PASS,或给出完整 REPLACE response。
- 4 · EXECUTEaccepted response 通过目标 harness
h执行。 - 5 · OBSERVE命令结果进入 student-visible trajectory。
- 6 · TRAIN对 accepted responses 做 SFT;部署移除 reviewer。
PASS 保留原 response。REPLACE 必须给出一条完整的 student response,而且只能调用 h 允许的 execute。官方实现的 schema 会拒绝三种情况:PASS 却带 replacement、REPLACE 没有 replacement、replacement 既无可见文字也无 tool call。每次无效提交最多重试三次。
student 能看到并用于训练
- 任务与固定 system prompt
- 已接受的 response
execute的 stdout / stderr 与 exit code- 之前所有 accepted observations
只属于 harnessing agent
- 私有参考 harness
K - PASS/REPLACE 的理由与组件名
- 未执行的原始 proposal
- review middleware 的内部提示
这个可见性边界很重要。harnessing agent 没有 student sandbox 的私有挂载,也不能读取隐藏答案。它只能根据 student 已经看到的 observation 判断下一步,并把 correction 写成 student 自己能执行的动作。
3.3 真实 case:预填示例单元格不能被覆盖
SpreadsheetBench 的一些任务要求填写一段 answer range,其中已经放了少量 worked examples。这些单元格本身就是规格:student 要从中推断规则和格式,只填写空白位置。常见错误是脚本对整段区域批量写值,把示例一起覆盖。
同一个 guard,如何从 h* 迁移到 student 的行为里
- 原始
h*:prefilled_guard在 student 准备 finish 时,直接进入 sandbox,比较输入、输出 workbook 的 answer range;只要预填 literal 被改动,就拒绝结束。 - 改写成
K:review middleware 不再读取 sandbox,只扫描 student-visible trajectory,寻找“比较过输入和输出”的证据。 - 触发 REPLACE:student 若直接 finish,harnessing agent 把 finish 换成一条普通
execute命令。命令创建并运行 workbook diff 脚本。 - 形成监督:diff 输出进入 student 的下一轮上下文。student 看见 PASS 才结束;看见被改动的坐标,就先修复。SFT 学到的是“提交前主动比较”,不是某个隐藏 middleware 的调用名。
FAIL changed cells: ['B7'],student 恢复 B7 并重新运行验证。下面的代码根据论文 Appendix B.2 / Code 1–3 压缩改写。它展示 action recipe 最终如何变成 h 可执行的 student action;不是新的 benchmark checker。
# 在 accepted response 里创建并执行;目标 harness h 只看见一次 Bash execute
python3 - <<'PY' INPUT.xlsx OUTPUT.xlsx B3:B40
import sys, openpyxl
from openpyxl.utils import range_boundaries

input_path, output_path, cell_range = sys.argv[1:4]
wb_in = openpyxl.load_workbook(input_path)
wb_out = openpyxl.load_workbook(output_path)
ws_in, ws_out = wb_in.active, wb_out.active
min_c, min_r, max_c, max_r = range_boundaries(cell_range)
changed = []
for row in range(min_r, max_r + 1):
    for col in range(min_c, max_c + 1):
        before = ws_in.cell(row=row, column=col)
        after = ws_out.cell(row=row, column=col)
        if before.value is not None and before.data_type != “f”:
            if after.value != before.value:
                changed.append(before.coordinate)
print(“PASS” if not changed else f”FAIL changed cells: {changed}”)
raise SystemExit(bool(changed))
PY
3.4 轨迹过滤与 SFT
SpreadsheetBench 和 AppWorld 只保留 verifier reward 为 1.0 且没有执行异常的 trial;USPTO 保留全部 500 条,保证各 ablation 使用相同任务。作者还扫描私有路径、candidate 文件名、review submission tool 名和内部 middleware 名,防止 reviewer 私有信息进入训练数据。若 replacement 的 reasoning 出现“student proposal”“review”“rewrite”等 reviewer 视角表达,该 reasoning token span 会从 loss 中 mask 掉。
最终每个领域单独训练:SpreadsheetBench 487 条轨迹,AppWorld 282 条,USPTO 500 条。模型是 Qwen3.5-9B,LoRA rank / alpha 都是 32,batch size 8,sequence length 65,536,训练 2 epochs;peak learning rate 为 2e-4,5% warmup 后降到 1e-6,seed 42。
Q4. 实验到底说明了什么?
4.1 三个领域与统一部署接口
| Domain | 训练 / 测试 | 任务与指标 | 专用 harness 主要提供什么 |
|---|---|---|---|
| SpreadsheetBench Verified | 300 / 100 | 真实 spreadsheet manipulation;single-run pass@1 | 检查、编辑、保存和验证 workbook 的流程 |
| AppWorld | 147 / 168 tasks | 56 个三任务 scenario;SGC | API 参数、分页、mutation 后回读、完成条件 |
| USPTO retrosynthesis | 500 / 100 | 单步前体预测;single-run pass@1 | 反应先验、候选生成、RDKit / SMILES 验证 |
所有任务通过 Harbor 在 Docker sandbox 中运行。student 部署接口始终是最小 mini-SWE-agent:一个固定 system prompt、一个非空 Bash 命令参数的 execute 工具;每次调用启动新 shell,文件系统状态保留。
4.2 Agent-as-harness 是否比直接挂载代码更有效?
Table 1 在 GPT-5.6 Sol 和 DeepSeek-V4-Pro 上做了六个 benchmark–model 设置。这里没有训练;同一个模型同时扮演 student 和 harnessing agent,所以提升不能归因于更强 teacher。
4.3 蒸馏后,拿掉 h* 还能剩多少?
| Setting | SpreadsheetBench | AppWorld | USPTO | Macro avg. |
|---|---|---|---|---|
Base + minimal h | 31.0 | 26.8 | 12.0 | 23.3 |
Base + evolved h* | 39.0 | 48.2 | 38.0 | 41.7 |
| Base + DeepAgents | 35.0 | 19.6 | 7.0 | 20.5 |
| Base + Claude Code | 31.0 | 10.7 | 6.0 | 15.9 |
Harness-Zero + minimal h | 44.0 | 58.9 | 30.0 | 44.3 |
根据论文 Table 2,macro average 从 23.3% 升到 44.3%,比 base model 继续挂着 h* 的 41.7% 还高 2.6 分。分领域看则更谨慎:SpreadsheetBench 与 AppWorld 主要依赖可在轨迹中示范的程序化步骤;USPTO 的 h* 还提供反应先验、候选生成和可执行 SMILES 验证,因此 distilled model 的 30.0% 仍低于 38.0%。
4.4 为什么成功率最高的轨迹,不一定最适合蒸馏?
USPTO ablation 是全文最值得看的实验。所有条件都从同一个 Qwen3.5-9B 出发,使用相同 500 个采集任务、相同训练 recipe,并在 h 下测试。
| Trajectory source | Collection success | 微调后 test pass@1 under h |
|---|---|---|
| Base(未训练) | — | 12.0 |
| GPT-5.6 teacher rollout | 52.0 | 12.0 |
Teacher under h* | 62.0 | 3.0 |
Student under h* | 39.4 | 12.0 |
Review with empty K | 44.2 | 11.0 |
| Review with oracle answer | 98.6 | 15.0 |
Harness-Zero with K | 59.4 | 30.0 |
直接蒸馏 h* 轨迹的失败最能说明 action-space mismatch:模型学会了部署时不存在的 harness-tool call,大量 trial 因此耗尽 turn limit。Oracle answer 则容易产生只对当前题有效的捷径。K 没有答案,提供的是“先枚举候选、再用图结构和化学规则过滤、最后验证输出”的可复用程序。
4.5 82.3% 的 behavior recovery 怎么算?
作者为 h* 中的每条 memory、skill、tool 和 middleware 规则写了确定性 trajectory detector。对每个 pattern,只保留这样的 test task:base model 在 h* 下出现该行为,在 h 下不出现;support tasks 少于 10 的 pattern 被丢弃。最终得到 SpreadsheetBench 18 种、USPTO 6 种、AppWorld 4 种。
28 个 pattern 的平均恢复率为 82.3%。例如“保护预填单元格”是 24/26(92%),“读取完整分页”是 21/53(40%),“用 RDKit 验证”是 60/60(100%)。这里不能把 82.3% 当成自然任务分布上的总体行为准确率:support set 的定义已经让 base + h 为 0%、base + h* 为 100%。它测的是蒸馏能否在专门挑出的 harness-exclusive 场景里恢复行为。
Q5. 这项工作给 agent 训练带来什么启发?
第一,训练数据的价值取决于 deployment compatibility。更强 teacher、更高采集成功率、甚至 oracle answer,都不保证 student 能在自己的工具接口里复现。Harness-Zero 让 teacher 只改“下一步”,每次 correction 都经过目标 harness 执行,把可执行性直接写进数据生成过程。
第二,harness 可以被看成一种程序化课程。K 不给最终答案,而是在 student 正要犯错的时刻加入一次 inspection、verification 或 recovery。它保留 student 原有轨迹的大部分状态,只对关键 decision 做小改动。相比完整接管任务,这种数据更接近 student 的能力范围,也更明确地示范一个可复用行为。
第三,未来更值得研究 selective review。当前方法审查每个 proposal,训练时每一步至少两次模型调用;但真正需要 replacement 的步骤只占一部分。若能用便宜的 detector 或 uncertainty signal 筛选高风险节点,可能保留主要监督价值,同时显著降低采集成本。
最后,论文也给 harness 设计提出了一个新问题:哪些组件的价值来自可学习流程,哪些必须在部署时继续作为外部能力存在?SpreadsheetBench 的检查工作流很容易写进 response;上下文裁剪、真正的并行调度、需要私有状态的安全隔离,就未必能靠 SFT 取代。
Q6. 结论与限制
Harness-Zero 提供了一条完整路径:先优化 student-side harness h*,再把它改写成 reviewer 读取的 K;harnessing agent 用 PASS/REPLACE 把指导翻译成目标 action space h 中的 response;SFT 只学习 accepted trajectory;部署时移除 h*、K 和 reviewer。
现有证据支持一个相对克制的结论:程序化 harness 行为可以在不保留专用 harness 的情况下,较大比例地迁移进一个 9B 模型。三领域 macro average 提高 21.0 个百分点,28 个 harness-exclusive patterns 平均恢复 82.3%。但这还不是“所有 harness 都能被蒸馏掉”。
- reviewer 必须足够强。USPTO 上,agent-as-harness 相对 code-as-harness 在 GPT-5.6 Sol、DeepSeek-V4-Pro 上分别高 1 分和 4 分;在 DeepSeek-V4-Flash、Qwen3.6-35B-A3B 上则分别低 1 分和 12 分。最弱模型替换了 66.0% 的步骤,但这些改写整体有害。
- 采集成本明显增加。USPTO 上 minimal harness 平均 100.1 秒,agent-as-harness 为 237.2 秒,约 2.4×;这部分成本在训练数据采集期发生,部署后消失。
- SFT 对深领域知识与真正的可执行能力吸收有限。USPTO 的蒸馏结果仍落后
h*8 分。 - 不是所有机制都能自然地写成 student response。论文明确提到 context management 仍是困难项。
- 主要 pass@1 / SGC 都是 single-run,论文没有报告重复实验方差;frontier model 对比复用了在 Qwen3.5-9B 上演化的
h*,这个设计有利于考察迁移,但不等同于为每个强模型分别寻找最优 harness。
Harness-Zero 不让 reviewer 替 student 完成整道题。它把外部 harness 的检查与工作流,翻译成 student 在部署接口下也能亲自执行、并能通过 SFT 留下来的行为。
留言