LEGO-RL 研究的是一个很具体的系统问题:Claude Code、OpenHands 或 OpenCode 会读仓库、改文件、跑命令、压缩历史,policy-gradient trainer 怎样从这类长轨迹中拿到可信的 token 和 reward?论文把 model-API proxy、Harbor sandbox、隐藏 verifier、MoE routing replay、任务筛选和 Live UI 接成一条链,让“一次修复得到 1 分”可以对应到“这批 token 应该被上调”。
Q1. 为什么完整 coding harness 很难直接拿来做 RL?
训练框架通常希望自己控制 token 序列,完整 harness 却会主动管理上下文和工具交互。 一次 Claude Code trajectory 可能包含多轮模型调用、shell 输出、文件 diff、tool schema、history compaction 和 SDK 重序列化。Trainer 如果只在结束后读取 transcript,再把文字 tokenize 一遍,拿到的 token IDs、response mask 或上下文边界可能已经和 rollout 时不同。
这个差异会直接破坏 policy gradient 的概率比。分母如果对应另一串 token,或者 MoE expert routing 已经变化,优化目标就失去原来的统计含义。论文的要求很直接:在相同权重上,trainer 对 policy-generated tokens 重算的 log-prob 应当接近 serving boundary 记录的 rollout log-prob。
第二个问题来自 reward。Coding Agent 最终只得到一个 sparse verifier reward。论文在系统开发期间看到过六类污染:
| 失败方式 | 部署防护前出现比例 | LEGO-RL 的处理 |
|---|---|---|
| 读取 git history | 4.6% 至 20.5% | Agent 阶段把 history rebase 成单一 commit,grading 前恢复 |
| 下载 reference fix | 1.9% | 分阶段 egress firewall |
| 修改 tests | 2.4% 至 19.4% | tests 到 grading 才注入,并回滚 test-path edits |
| grader 自己套用 reference patch | 2.5% | 审计并剔除受影响任务,线上检测 degenerate reward |
| grader 依赖网络 | 未单独量化 | 把 grade-time dependency 打包进环境 |
| 仓库构建不完整 | 未单独量化 | hermetic fail-fast build,报告 setup failure 而不是 reward 0 |
LEGO-RL 的 motivation 可以压缩成一句话:训练系统必须同时守住 trajectory fidelity 和 reward integrity。 前者回答“梯度是不是对着 rollout 时的 policy 行为算的”,后者回答“1 分是不是 Agent 真的修好了任务”。
Q2. 它和现有 agentic RL 框架的边界在哪里?
与 LEGO-RL 最接近的路线选择在 model API 边界接入现成 harness。 论文把相关工作分成几类。
| 路线 | rollout 由谁控制 | 强项 | 与 LEGO-RL 的区别 |
|---|---|---|---|
| verl、slime、MOLT、SkyRL、AReaL | RL framework 内部 loop 或其 abstraction | 生成和 optimizer 靠得近,容易做异步与大规模训练 | 完整 coding harness 往往要适配成框架规定的 interaction loop |
| ALE:ROLL + ROCK + iFlow | trainer、sandbox、CLI agent 协同设计 | 整栈一致性 | 通过共同控制 full stack 获得一致性,目标并非兼容任意现成 harness |
| Agent Lightning | 现有 Agent 加 SDK callback | 能接多种 agent system | 论文 Table 1 没有报告 history alignment、R3 或 reward-hack defense |
| Polar、rLLM、OpenForgeRL | model API 边界观察原生 harness | 保留既有 Agent control flow | 与 LEGO-RL 最接近;各自对 routing replay、sandbox、operations 和 observability 的覆盖不同 |
| LEGO-RL | Claude Code、OpenHands、OpenCode 原生 loop | token capture、R3、Harbor verifier、Live UI 和运维闭环 | 贡献在完整系统组合;论文没有声称每项组件都是第一次提出 |
论文也和 SWE-RL、DeepSWE、LongContext 一类工作区分开来。SWE-RL 没有 executable interaction;其他工作常在框架自有 loop 中训练。LEGO-RL 关注的是部署时会真实使用的 harness 是否也能原样参与训练。
这里要保留一个证据边界:Table 1 的功能勾选由 LEGO-RL 作者整理,本文没有逐个复现十个框架。它适合说明设计空间,不能当成独立 benchmark 排名。
Q3. LEGO-RL 的训练闭环、数据和 judge 到底怎样工作?
3.1 一条 trajectory 的数据流
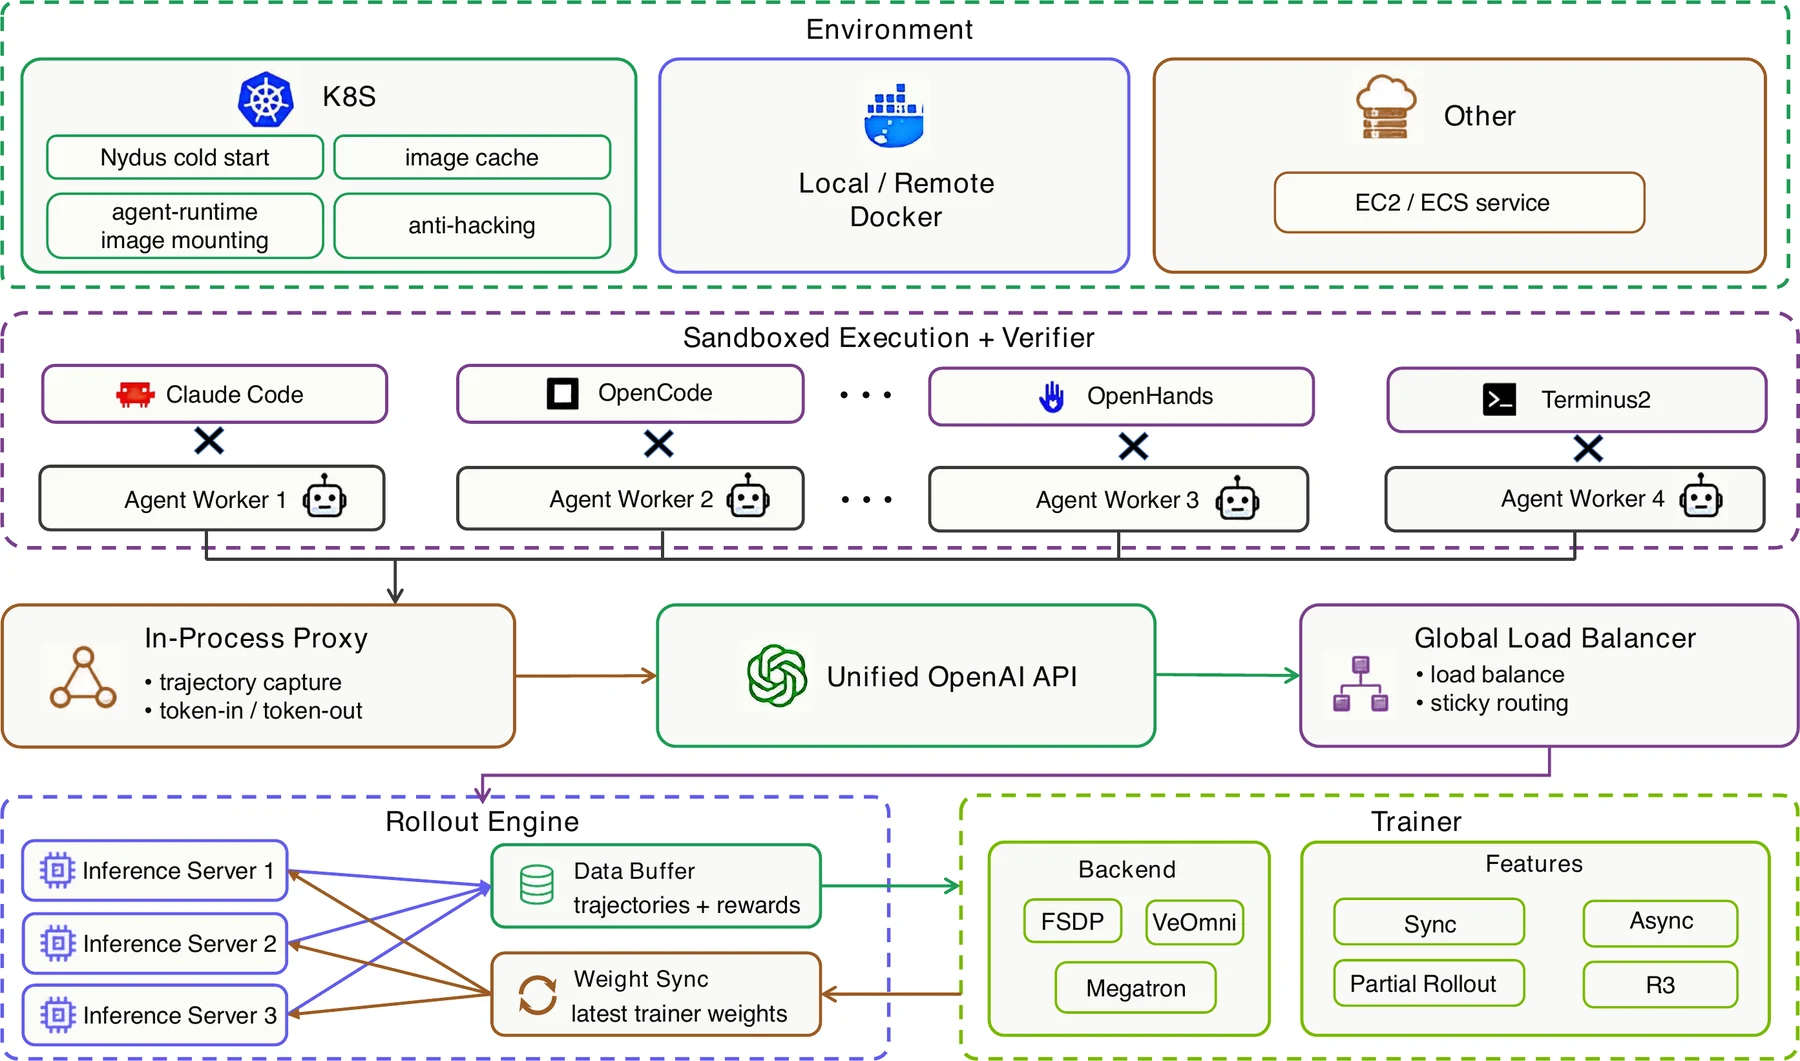
每个 task 是 x = (q_x, R_x, V_x):问题描述、初始化仓库和 task-specific verifier。Harness 根据当前交互状态构造 context,policy 生成 assistant tokens,harness 执行工具并改变仓库。LEGO-RL 只训练 assistant response tokens,不把 tool output 或 user message 当成 policy action。
Proxy 需要处理一个麻烦细节:harness 可能在下一轮请求里重新序列化旧消息。官方实现 revision a3e28f171be165b5e8cda45030f336ec103690a7 直接把 proxy 捕获的 token、mask、log-prob 和 routing 放进 AgentLoopOutput:
prompt_ids = traj_acc[:prompt_token_len]
response_ids = traj_acc[prompt_token_len:]
response_mask = tail_mask
response_logprobs = tail_lp
response_routing = (
    tail_routing if len(tail_routing) == len(tail_mask) else []
)

output = AgentLoopOutput(
    prompt_ids=prompt_ids,
    response_ids=response_ids[:self.response_length],
    response_mask=response_mask[:self.response_length],
    response_logprobs=response_logprobs[:self.response_length],
    routed_experts=self._build_routed_experts(
        prompt_ids, response_routing[:self.response_length]
    ),
    reward_score=reward_score,
)
这段代码来自官方仓库,不是文章重构的伪代码。实现还会把 timeout、environment setup failure、max turns 和 context overflow 分开标记;trajectory filter 再决定是否进入 loss。
3.2 训练任务从 36,884 条缩到 2,699 条
任务来自 OpenSWE candidate pools。作者先做规则过滤:
- 36,884OpenSWE-derived candidates
- 22,806通过基本有效性、repo diversity、coarse complexity
- 21,681build 与 verifier 可运行
- 4 rolloutsQwen3.6-27B + OpenHands SDK
- 1-3 / 4保留既不全错也不全对的任务
- 2,699最终训练 index
训练集与 SWE-bench Verified 在 repository 和 instance 两层都不重叠。难度筛选只使用一个 model-harness 组合,这是潜在 bias。作者随后在 Claude Code 和 OpenCode 上也获得提升,说明这批任务可以迁移;现有实验没有证明三种 harness 共享同一个最优 curriculum。
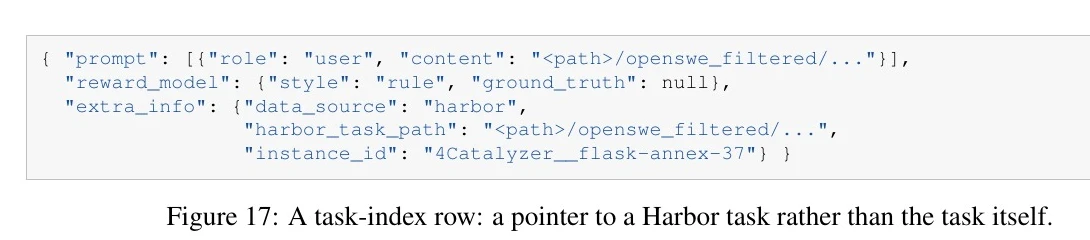
官方 utils/create_task_index.py 也说明了 index 的性质。Parquet 行里的 prompt 只是路径占位符,真实 issue 在 Harbor task 的 instruction.md 中:
return {
    "prompt": [{"role": "user", "content": str(path)}],
    "reward_model": {"style": "rule", "ground_truth": None},
    "extra_info": {
        "harbor_task_path": str(path.resolve()),
        "instance_id": path.name,
        "data_source": "harbor",
    },
}
3.3 真实 case:12rambau__sepal_ui-814
这个 instance 来自 openforis/pysepal 的 issue #813 和 PR #814。原始需求由项目维护者提出:第一次调用 alert.update_progress(0, total=10) 后,循环内应该只写 alert.update_progress(i),不必每次重复传 total。
从公开 issue 到 verifier verdict
- 上游来源:issue #813 给出可运行示例;PR #814 的公开 patch 修改
alert.py,并把test_update_progress改为先以 0/100 初始化,再调用update_progress(50)。 - OpenSWE record:作者保存 base commit
6d825ae167f96ad2e7b76b96ca07de562f74dcf0、问题描述、gold patch、test patch、FAIL_TO_PASS和PASS_TO_PASS。 - Agent 可见状态:Harbor 初始化仓库,只把 issue text 交给 Agent。Agent 可以读写源代码、运行公开命令,但看不到 gold patch、test patch、测试清单或 grader;egress firewall 阻止它下载公开 PR。
- Agent 输出:Agent 修改工作树。论文没有公开这条 instance 的实际训练 transcript,因此本文不编造它具体读过哪些文件或用了哪条 shell 命令。
- Verifier setup:Agent 结束后,host 才把
tests/test.patch、parser.py和含 raw record 的config.json注入 sandbox。test.sh重置测试、应用 test patch、运行 pytest 并解析结果。 - PASS:
tests/test_sepalwidgets/test_Alert.py::test_update_progress必须从 fail 变 pass,所有PASS_TO_PASS也必须继续通过。否则 reward 为 0;全部满足才是 1。
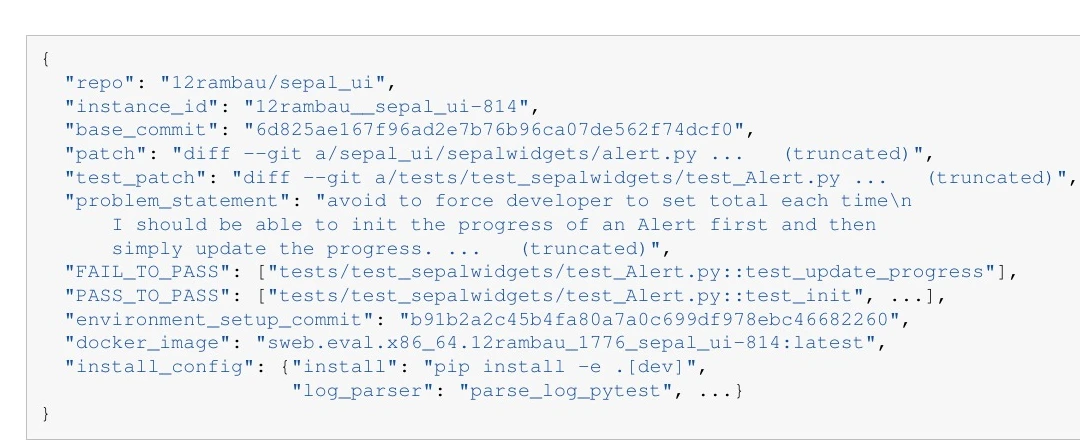
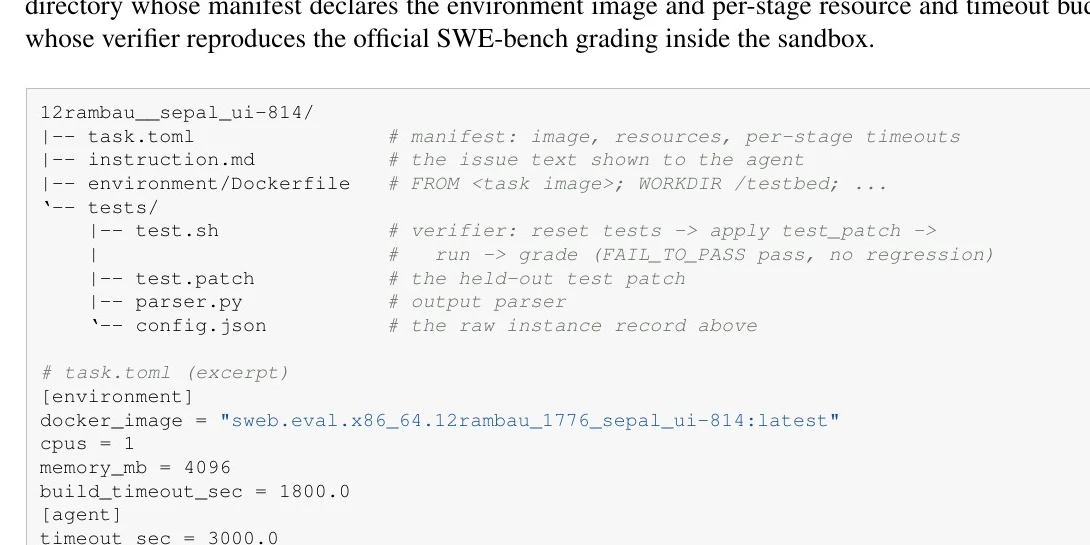
论文和官方 GitHub 仓库 revision a3e28f1 没有公开这条 instance 的完整 Harbor directory;Figures 15-16 也明确标注 long fields truncated。本文可以核验上游 issue、公开 reference patch 和总体 grading protocol,无法逐行审计作者实际使用的 test.sh 与完整 PASS_TO_PASS 清单。
Q4. 实验怎样设置,结果到底说明了什么?
4.1 主实验控制
三次 production run 都从 Qwen3.5-35B-A3B 开始,使用 GSPO、64 prompts/batch、8 rollouts/prompt、3 epochs。Prompt budget 是 30k tokens,response budget 是 170k;rollout temperature 1.0,validation temperature 0.7。每个 harness 单独训练一次,验证集固定为 SWE-bench Verified 500 tasks。
| Harness | 初始 Qwen3.5 | LEGO-RL | 绝对增益 | 同协议 KAT-Coder |
|---|---|---|---|---|
| OpenHands SDK | 64.0% | 70.4% | +6.4 | 67.0% |
| Claude Code | 62.4% | 68.2% | +5.8 | 66.8% |
| OpenCode | 57.2% | 66.6% | +9.4 | 64.8% |
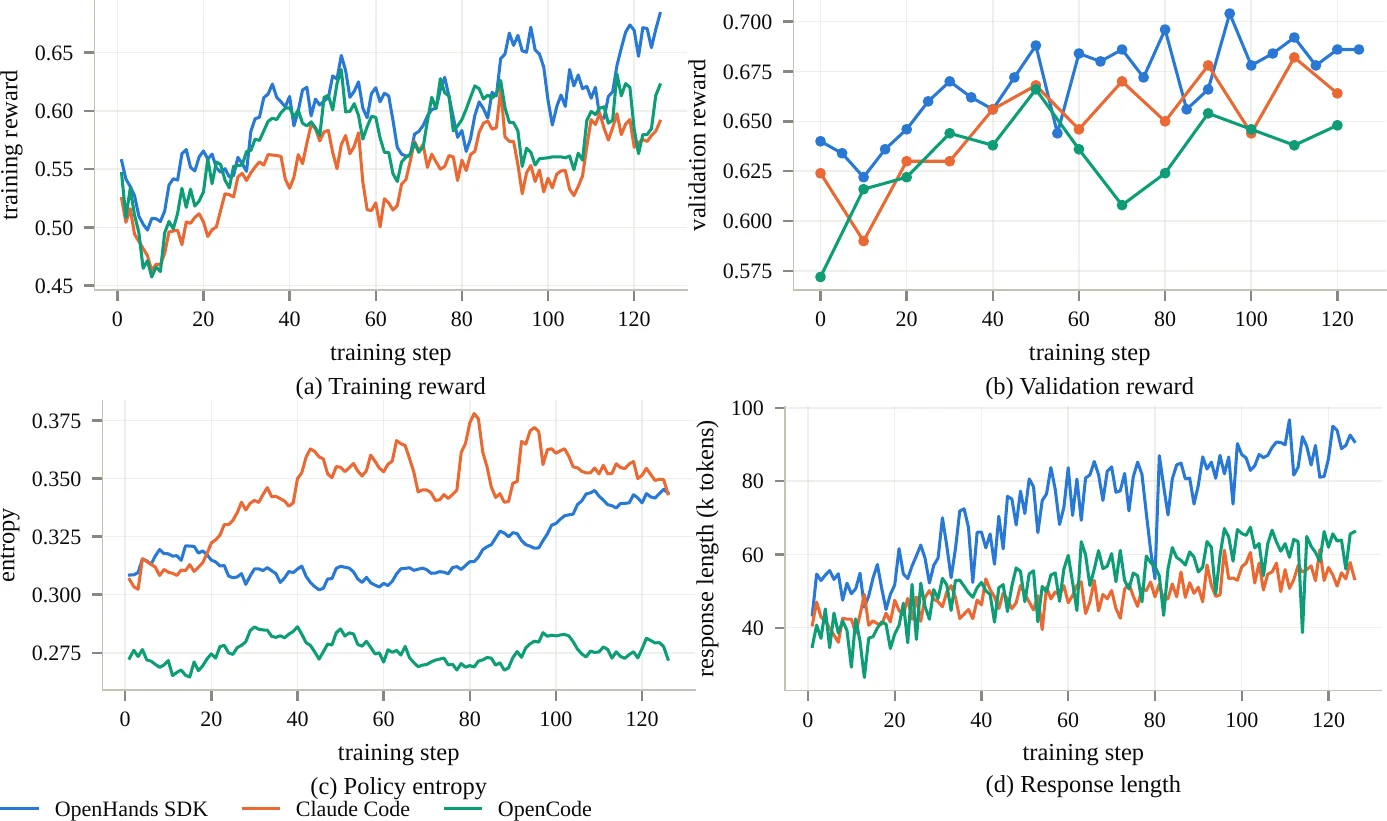
每个主要配置只有一次 run。表格证明三次训练都沿同一方向改善,也超过作者在同协议下重测的 Qwen3.6-35B-A3B 和 KAT-Coder-V2.5-Dev;它不能给出优化方差或复现成功概率。
4.2 Alignment:训练的真是 rollout 时那批 token 吗?
| Harness | Median Pearson r | KL ×10^-3 | p99 |Δ mean log p| ×10^-3 |
|---|---|---|---|
| OpenHands SDK | 0.9993 | 0.75 | 2.1 |
| Claude Code | 0.9980 | 1.35 | 2.7 |
| OpenCode | 0.9993 | 0.60 | 2.0 |
每个 training step 的 Pearson 都不低于 0.989。Routing replay 的 negative control 更有说服力:关闭 replay 时 Pearson 为 0.9946;正确对齐后是 0.9993;把每个 token 的 route 故意错一位后跌到 0.7503。机制“在运行”不够,token 与 route 必须逐位置匹配。
4.3 Task admission 与 curriculum
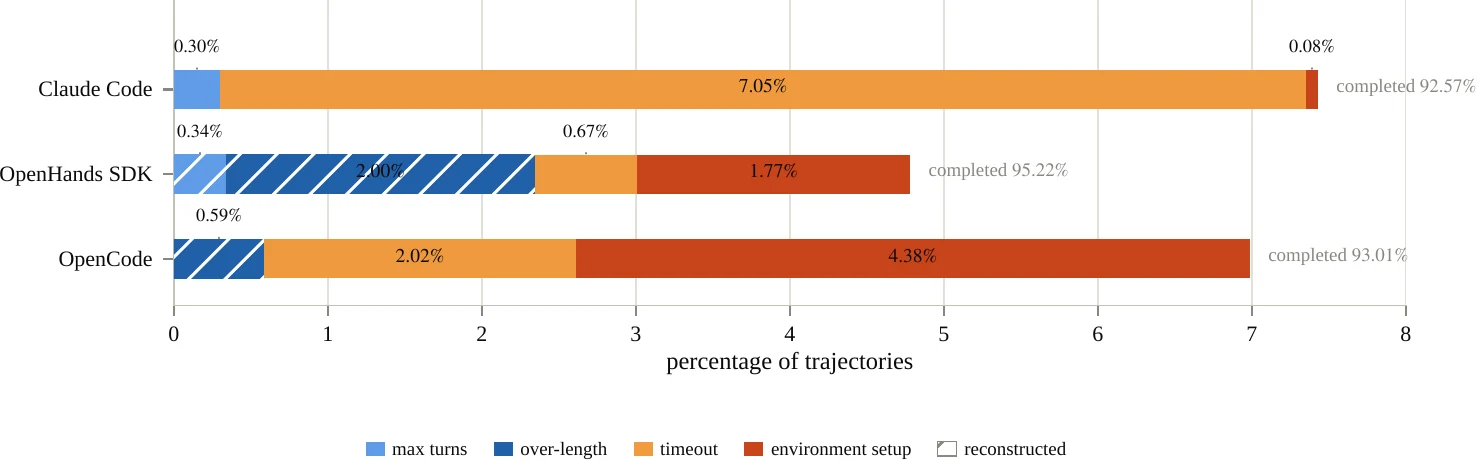
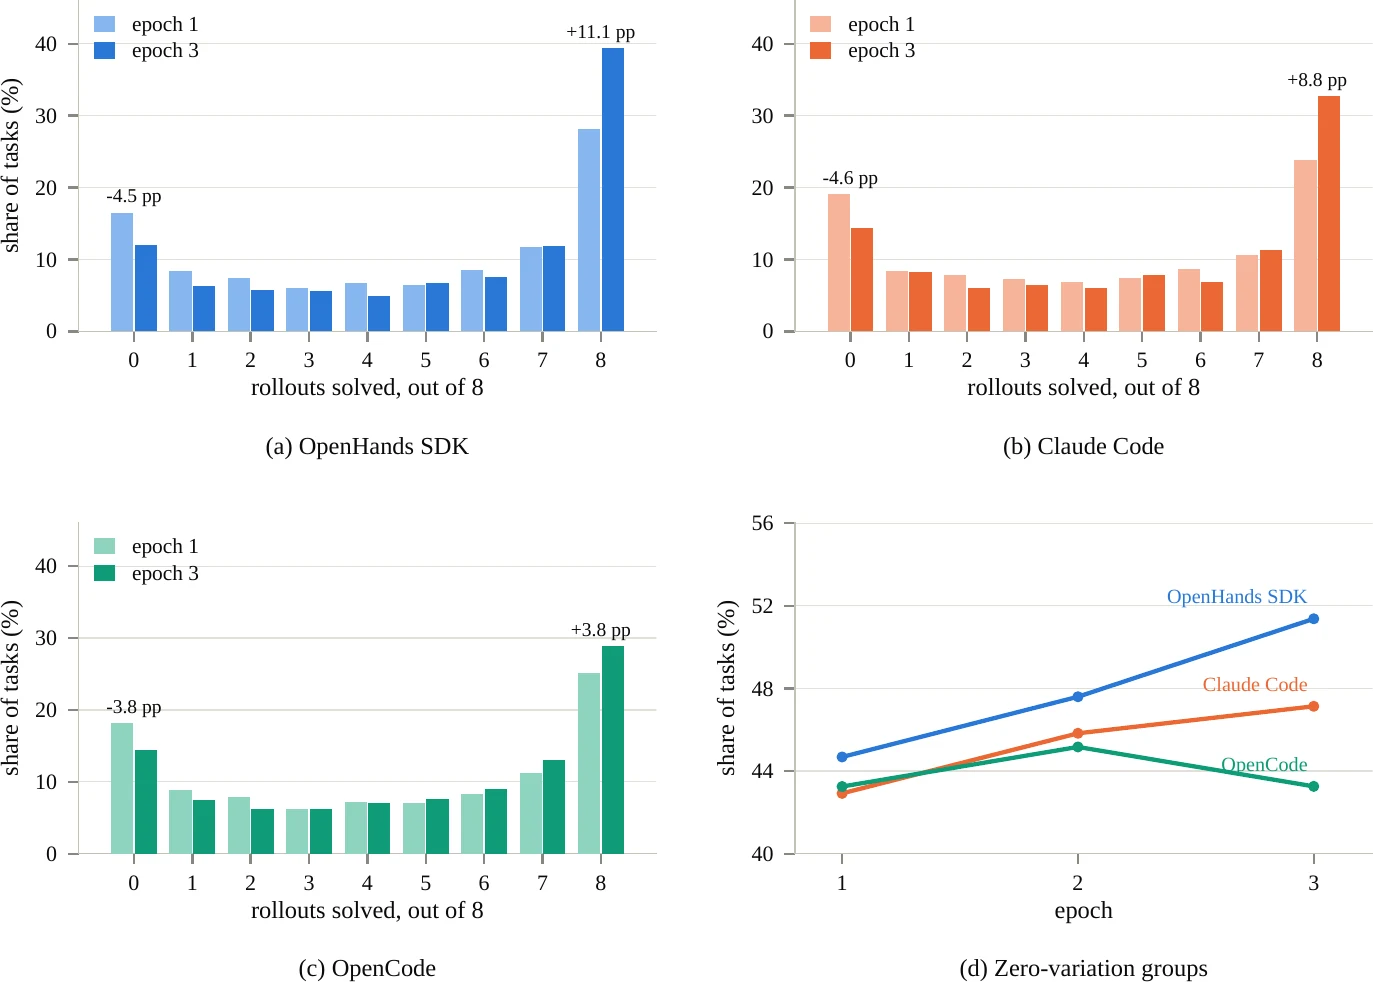
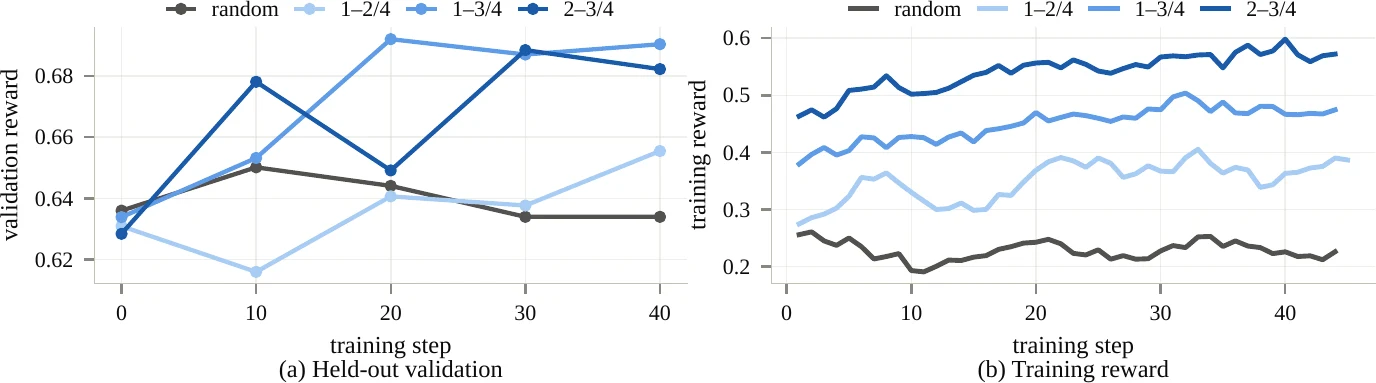
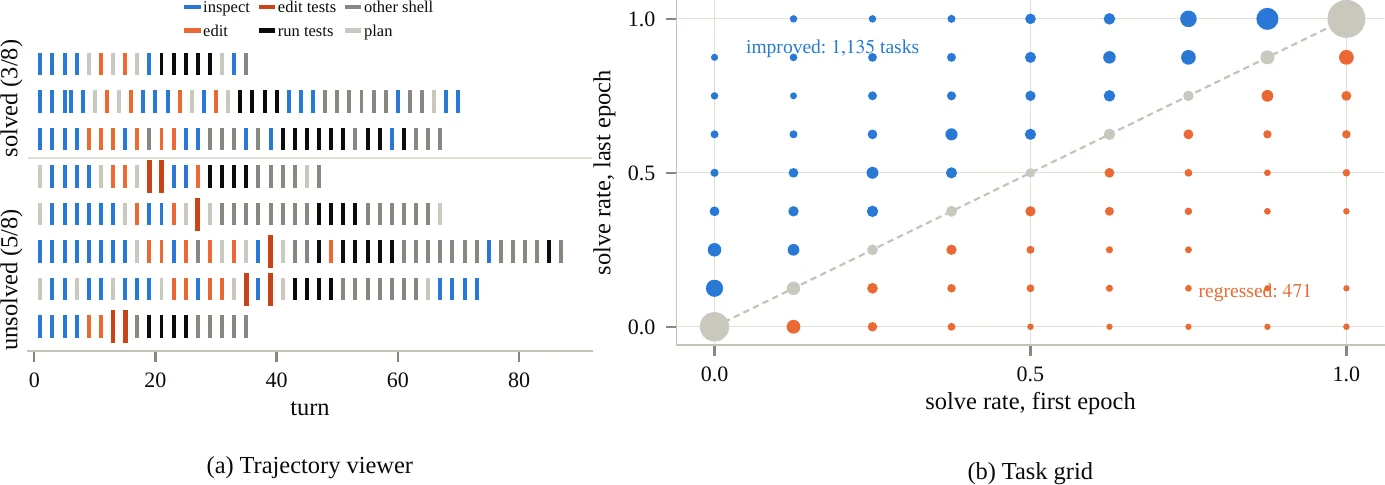
Unscreened pool 在四次 screening rollout 中有 72.7% 的任务从未解出,13.4% 总能解出。能产生组内 reward variation 的任务只占很小一部分。
4.4 Live UI 发现了什么真实 failure?
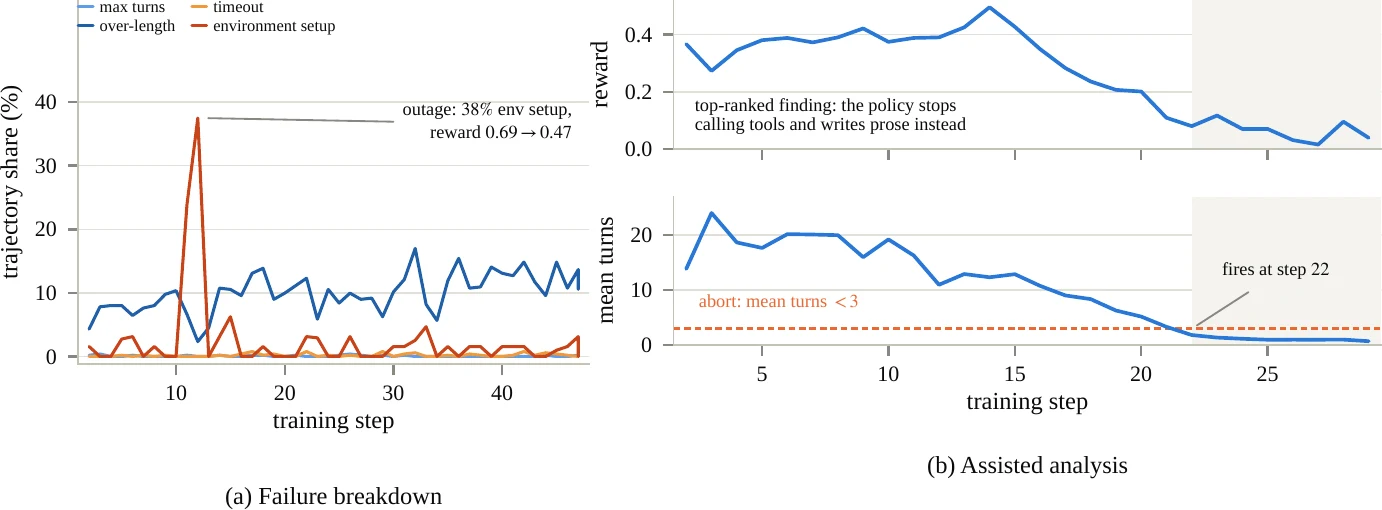
论文附录给出一个 collapsed run。模型是 Qwen3-30B-A3B,harness 是 OpenHands SDK,task pool 有 449 条。29 个 logged steps 内,training reward 从 0.351 降到 0.050,validation 从 0.230 降到 0.014,mean turns 从 18.9 降到 0.96。Agent 后期几乎不再发 tool call,而是把 shell command 写进 fenced prose。
作者据此构造 early-stop 条件 mean turns < 3,它会在 step 22 触发,比人工终止早 8 步。这个阈值只在一个 case study 上得到验证,能否跨任务工作仍未知。
4.5 训练后的行为和系统代价
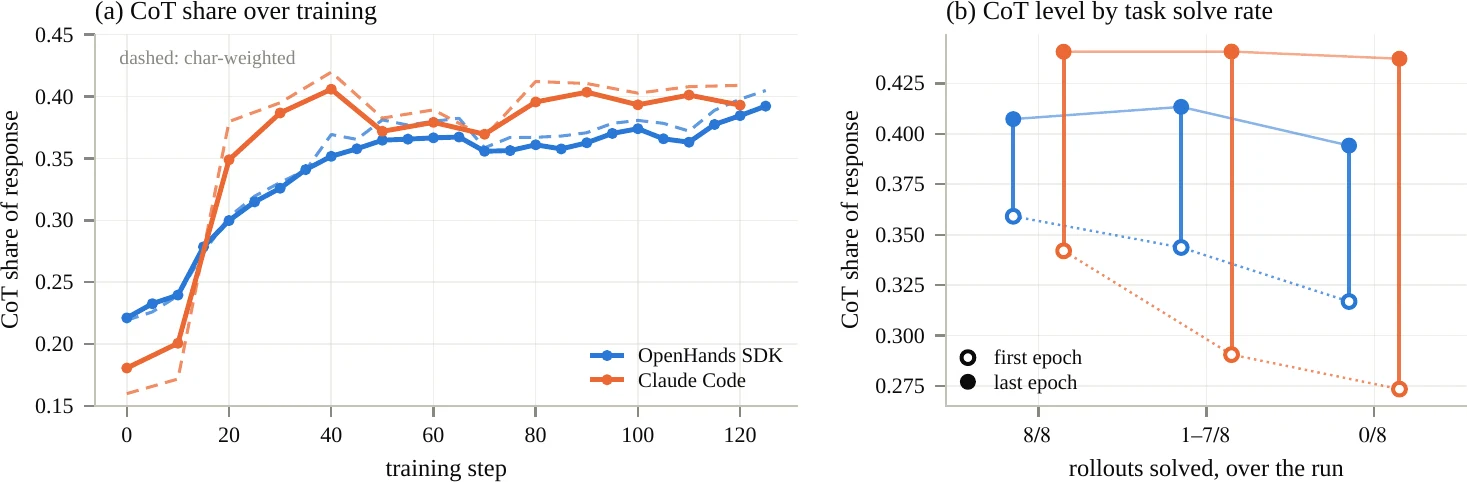
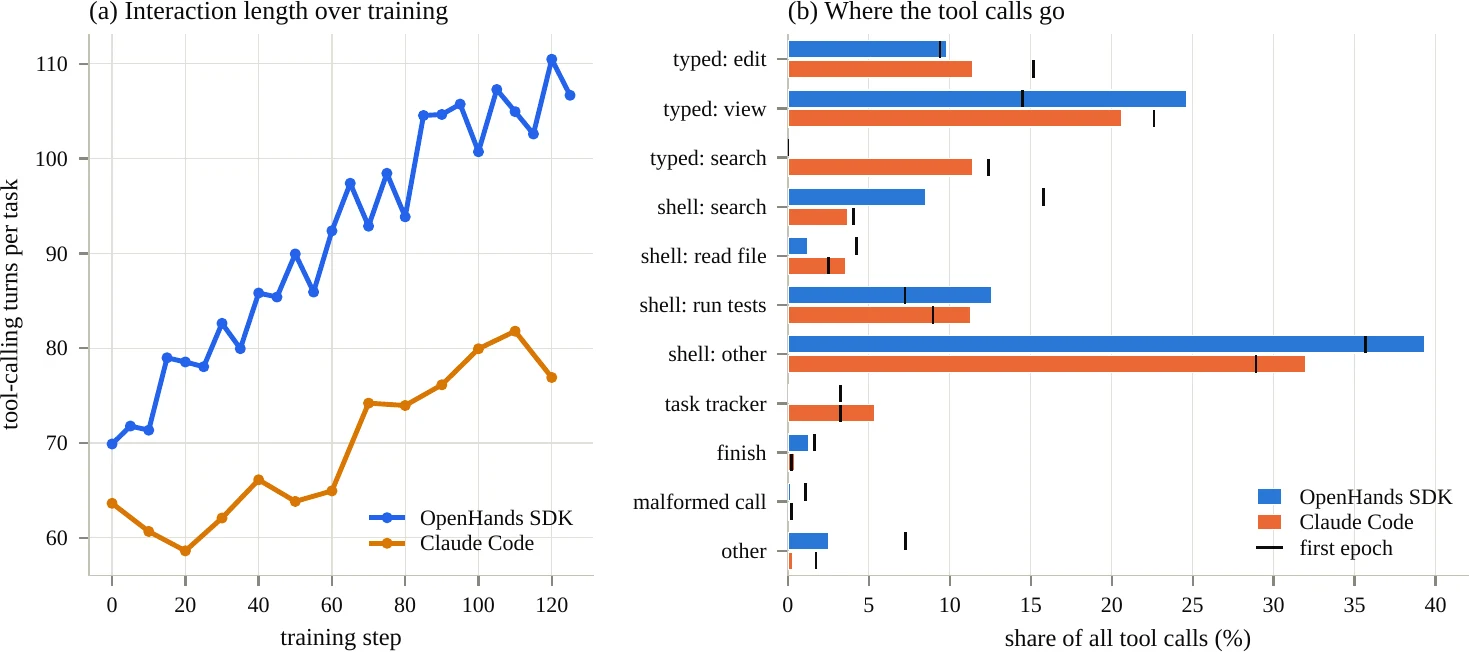
在 OpenHands SDK production run 的首尾各 420 条 trajectory 上,修改后重新读文件从 73.6% 增到 98.1%,运行 tests 从 85.0% 增到 93.6%,首次修改前检查的文件数从 3.45 增到 6.92,malformed tool calls 从 1.07% 降到 0.15%。出错后仍解决任务的比例只从 63.9% 增到 66.8%,变化较小。
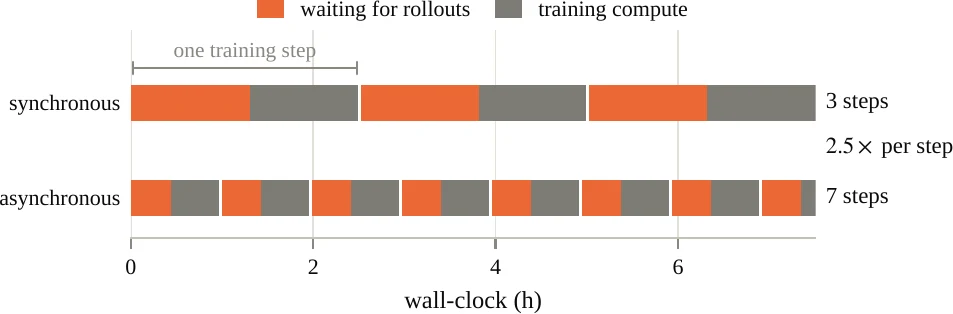
3,699 条 OpenHands SDK trials 中,Agent execution 平均占 840.5 / 920.4 秒,也就是 91.3%。相同 7.5 小时内,synchronous training 完成 3 steps,asynchronous 完成 7 steps;实测 step time 改善 2.5×。两组 optimizer throughput 不匹配,校正后估计约 1.9×。
Deck 还完整收录了论文 Figures 13-14 的 task grid 与 diagnostic panels,以及 Figures 15-17 的三种 data representation。原论文 17 幅 Figure 均未遗漏;10 张 Table 已在正文、Deck 或 source manifest 中逐项登记。
Q5. 对 Claude Code、Codex harness 研究有什么直接启发?
最值得复用的是三份明确的契约。
第一份是 trajectory contract。Harness 可以自由压缩和重写上下文,训练系统必须在 model-serving boundary 保存真实 token IDs、response mask、log-probs 和必要的 routing metadata。只保存最终 transcript 不够。
第二份是 reward contract。Agent 看得到 issue 和 repo,看不到 gold patch、hidden tests、测试列表或 grader;外网也不能成为下载 reference fix 的旁路。Verifier 在 Agent 结束后运行,基础设施错误单独分类。这样 reward 才能代表“修复是否通过验收”。
第三份是 curriculum contract。Task validity、trajectory validity 和 reward informativeness 要分开检查。一个能构建、能判分的任务,仍可能因为当前 policy 0/8 或 8/8 而没有训练价值。
如果沿着这篇论文继续做,我会优先补五个实验:
- 训练一个同时经历 Claude Code、OpenHands、OpenCode 的 shared policy,再与三个单-harness policies 做等 token、等 wall time 对照,测 harness-general behavior。
- 让 sampler 按最近的组内 reward variance 动态重加权,替代三轮训练都使用固定 2,699-task pool 的做法。
- 对 reward-integrity defense 做逐项消融,分别量化 hidden tests、egress firewall、history rebasing 和 test-path rollback 的价值。
- 在同一配置上做至少 3 个 training seeds,并报告 final、best、area under validation curve 与每题转移矩阵。
- 把 alignment 变成 fail-closed invariant。Token coverage、route coverage 或 log-prob discrepancy 一旦越界,trainer 立即停止更新。
Q6. 这篇论文能证明什么,还缺什么?
它证明了三套完整 coding harness 可以在不修改内部 control flow 的前提下进行有效 policy-gradient training。 三次 production run 都提高 SWE-bench Verified。Token-level alignment、routing negative control、reward-integrity audit、task selection ablation 和系统 profiling 同时检查了训练链本身。
我的结论是:LEGO-RL 的主要贡献是一条可审计的训练数据链。 Native harness 生成什么 token、这些 token 走了哪些 experts、Agent 在什么仓库状态上行动、grader 为什么给 1 分,都能回到明确的系统边界。对 Claude Code、Codex 方向的研究,先把这套训练协议做扎实,再讨论 optimizer 的差异。
留言