01 · PAPER MAParXiv:2608.17393v1 · 2026-08-18 · CC0
HARNESS-NATIVE RL FOR CODING AGENTS
把 Claude Code、OpenHands、OpenCode 原样接进 RL
LEGO-RL 不接管 Agent 的内部 control flow。它在模型 API 边界捕获真实 token,在隔离仓库里执行任务,再把 verifier 的 0/1 结果送回 GSPO。
论文解决的是训练闭环的可信度:rollout 时发生了什么,trainer 是否在同一批 token 和同一条 MoE routing 上算梯度,reward 又是否来自真实修复。
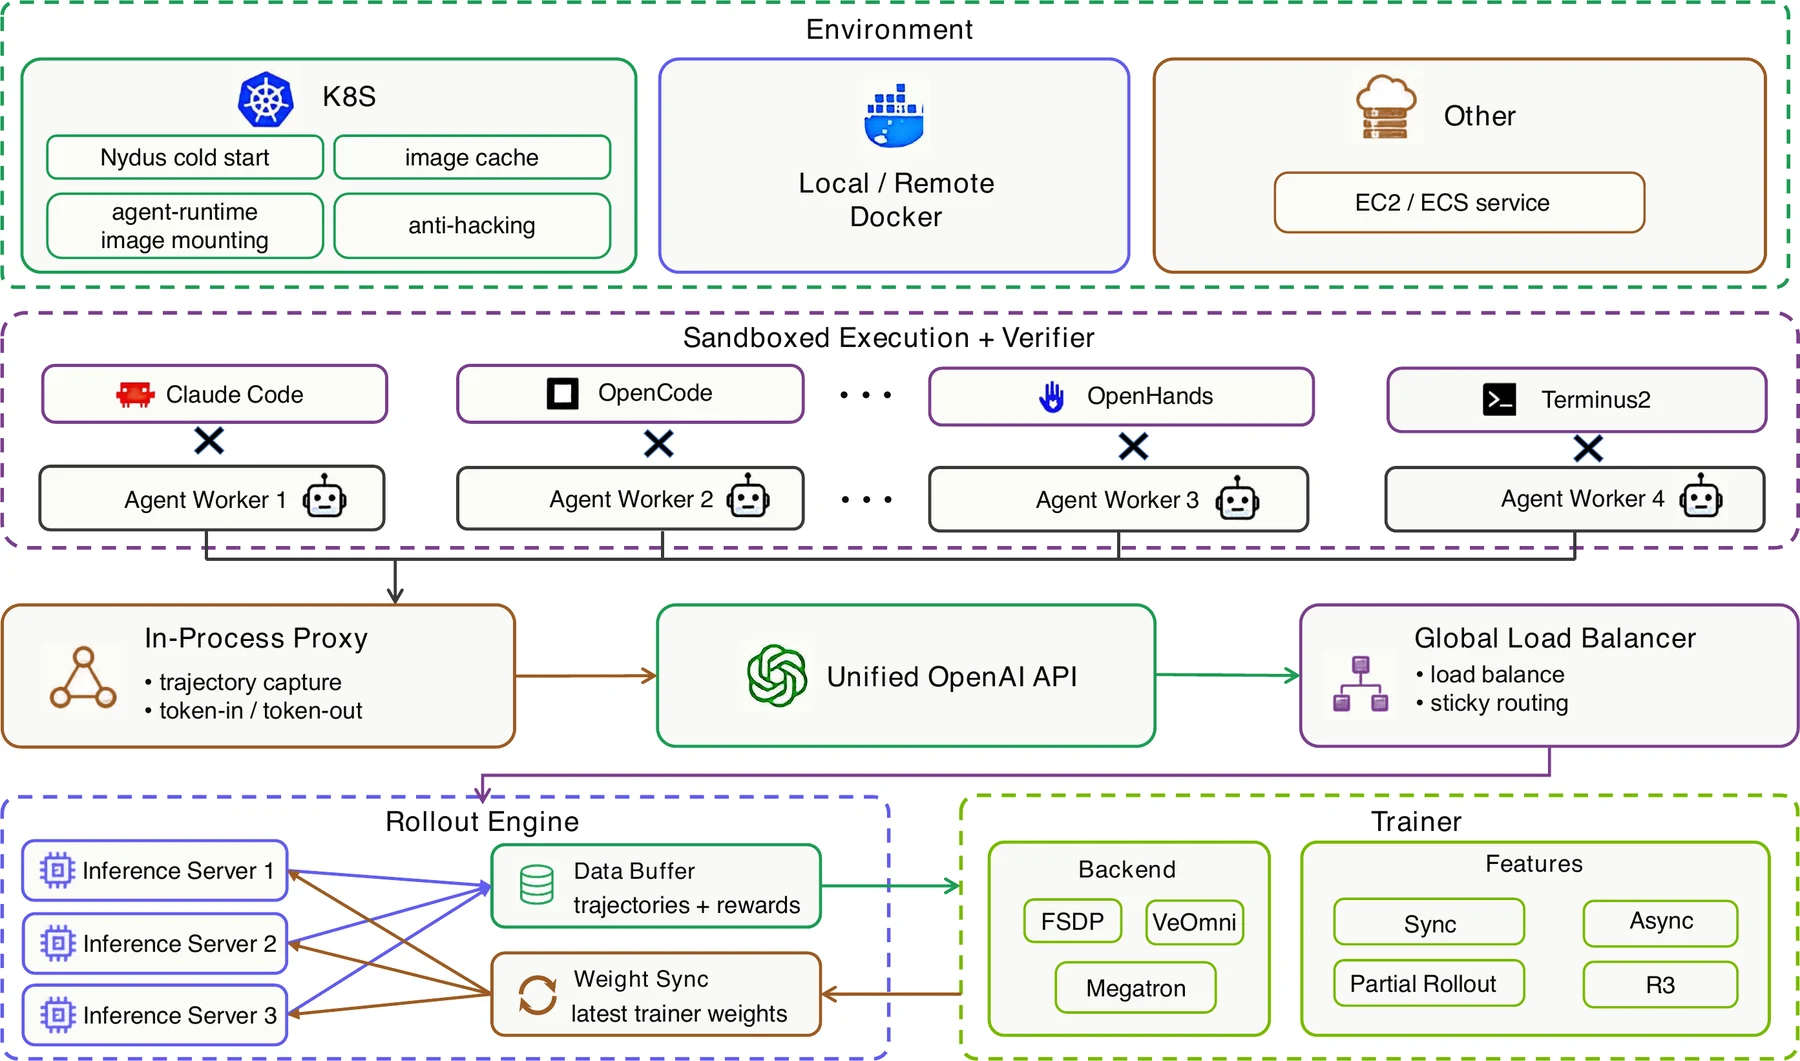
原论文 Figure 1:native harness、proxy、sandbox、verifier 与 trainer。
64.0 → 70.4OpenHands SDK
62.4 → 68.2Claude Code
57.2 → 66.6OpenCode
> 0.99rollout-training correlation
论文 Abstract、Figure 1、Table 2。每个主要配置一次 training run。
06 · ARCHITECTUREFigure 1
一次 rollout 怎样从 native harness 走到 policy update
原论文 Figure 1(CC0)。Sandbox 内运行 harness;proxy 连到 inference;verifier reward 与 trajectory 进入 trainer。
07 · OPERATIONSFigure 2
训练不是一条命令,而是五阶段可检查流程
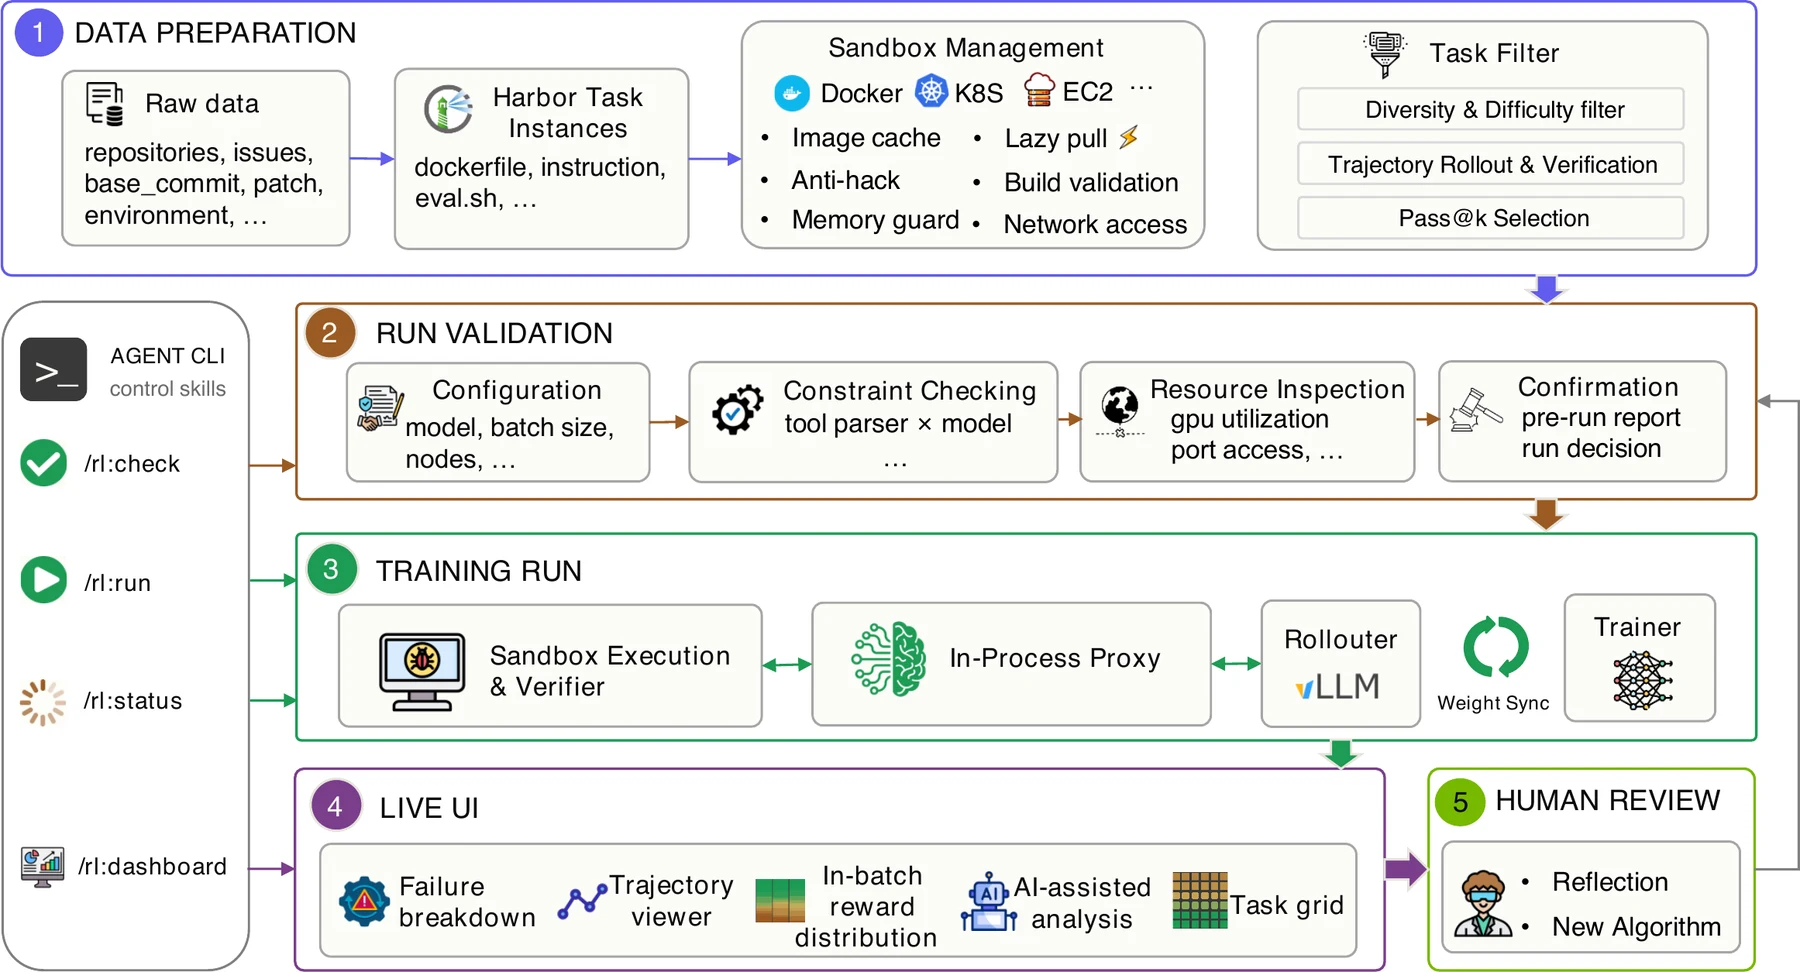
原论文 Figure 2(CC0):Data Preparation → Run Validation → Training → Live UI → Human Review。
准备与验证检查 task index、image、verifier、模型、sandbox 与依赖。
训练Figure 1 的 proxy、rollout buffer 与 trainer 真正运行。
观察与复核Live UI 下钻到 task、trajectory、tool use 和 termination reason。
论文 §3.3、Figure 2。官方仓库提供 /rl:check、/rl:run、/rl:status、/rl:dashboard。
09 · REAL CASE12rambau__sepal_ui-814 · issue #813 / PR #814
首次设置 total,后续只更新 progress
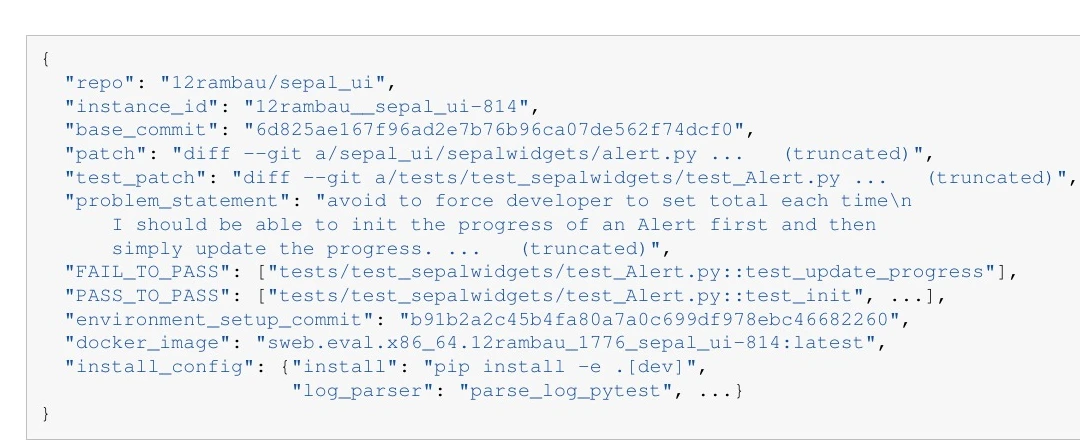
原论文 Figure 15(CC0):raw instance 长字段已截断。
alert = sw.Alert()

# 第一次初始化总量
alert.update_progress(0, "toto", total=10)

# 后续不再重复传 total
for i in range(10):
    alert.update_progress(i)
任务来源openforis/pysepal issue #813;PR #814 是公开参考修复。
目标 test
test_update_progress 从 FAIL 变 PASS;PASS_TO_PASS 不能回归。Agent 看不到gold patch、test patch、test lists、grader 与外网。
论文 Appendix J / Figure 15;公开 issue #813 与 PR #814 用于核验来源。
10 · JUDGE TRACEAgent phase 与 verifier phase 分权
同一任务经过 raw record、Harbor package、thin index 三种表示
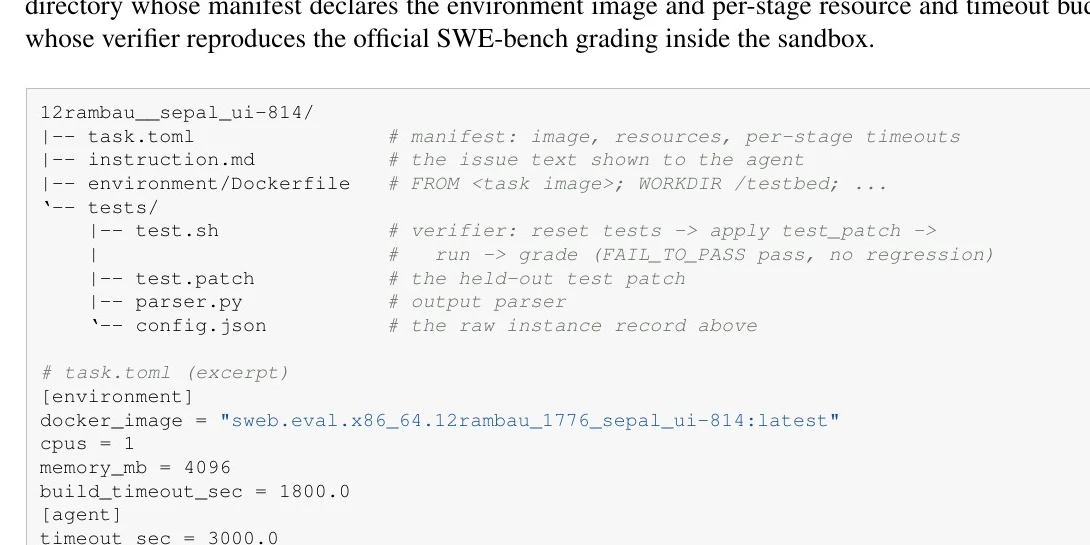
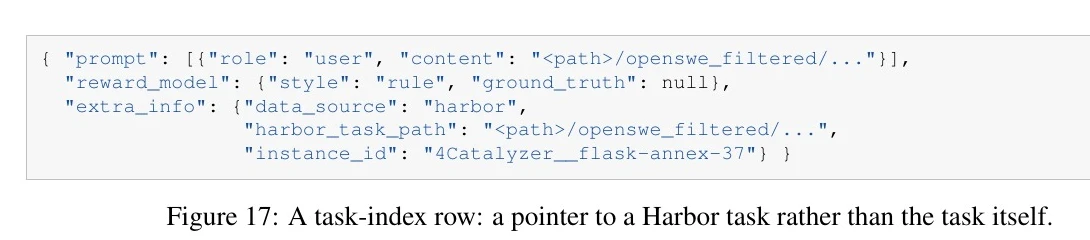
原论文 Figures 15-17(CC0)。PASS:FAIL_TO_PASS 全过且 PASS_TO_PASS 无回归;官方 GitHub 未含此 instance 完整 checker。
11 · TRAINING BEHAVIORFigure 3 · 126 steps / 3 epochs
同一初始 policy 在三种 harness 下形成不同 trajectory distribution
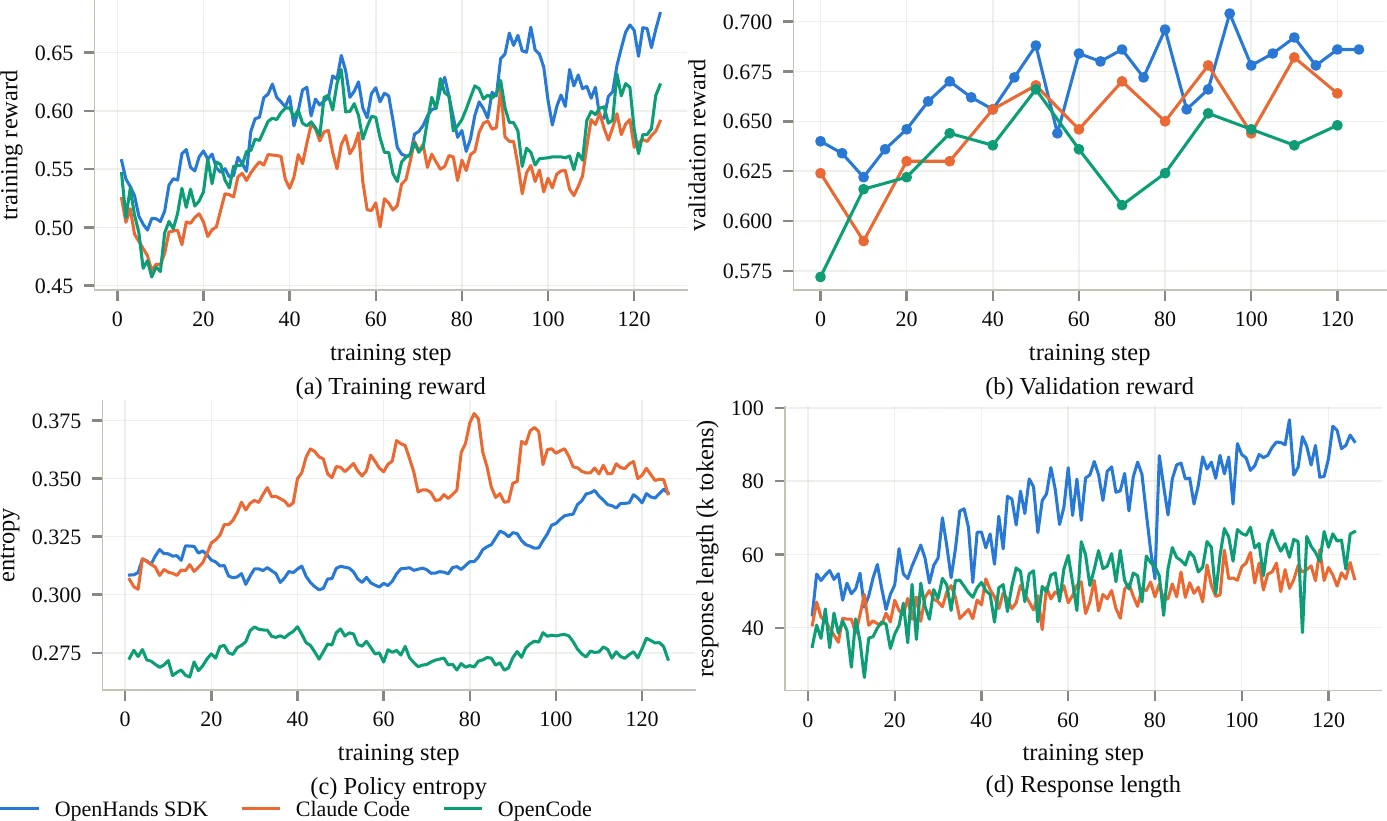
原论文 Figure 3(CC0):reward、validation、entropy、response length。
OpenHands SDK64.0% → 70.4%。
Claude Code62.4% → 68.2%。
OpenCode57.2% → 66.6%。
不能横向排名 harnessstep-0 已不同;论文比较各自训练前后。
论文 Figure 3、Table 2。Validation temperature 0.7,1 sample/instance。
12 · ADMISSION & REWARDFigures 4-5
基础设施失败要丢弃;合法超时仍保留 verifier 结果
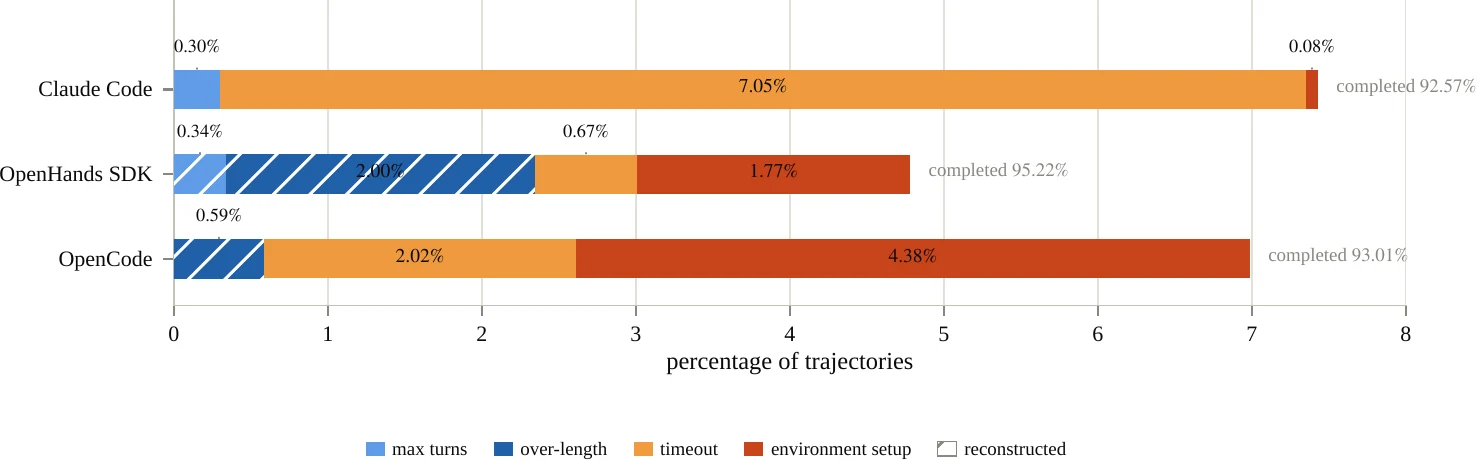
原论文 Figures 4-5(CC0)。environment setup failure 与 wall-clock timeout 被排除。
13 · TASK SELECTIONFigure 6 · four 951-task pools
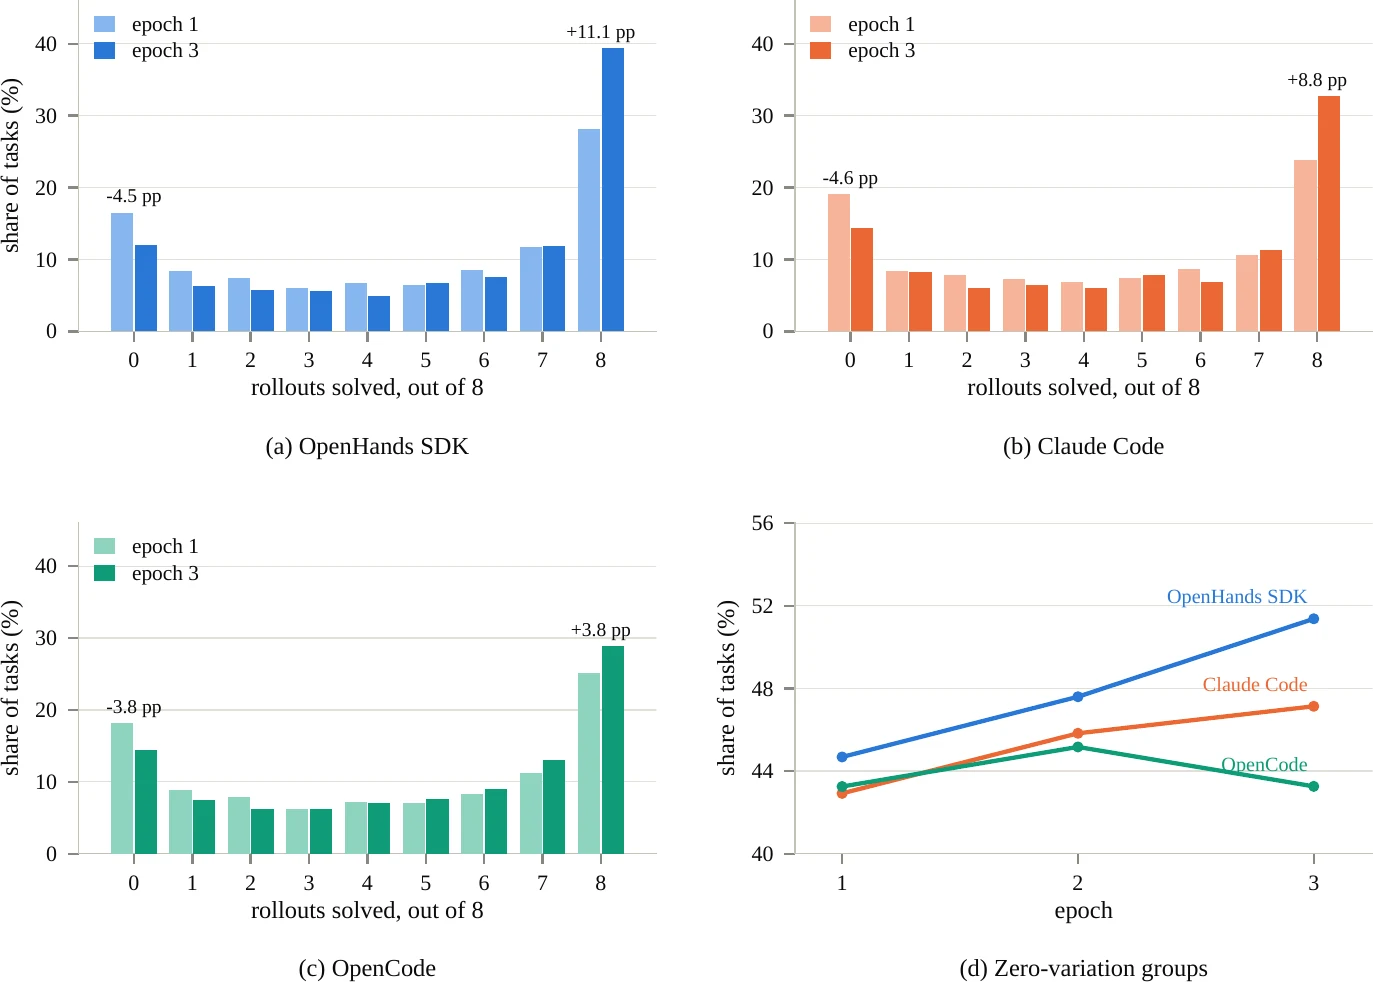
随机未筛选任务几乎不给 GSPO 可用的组内差异
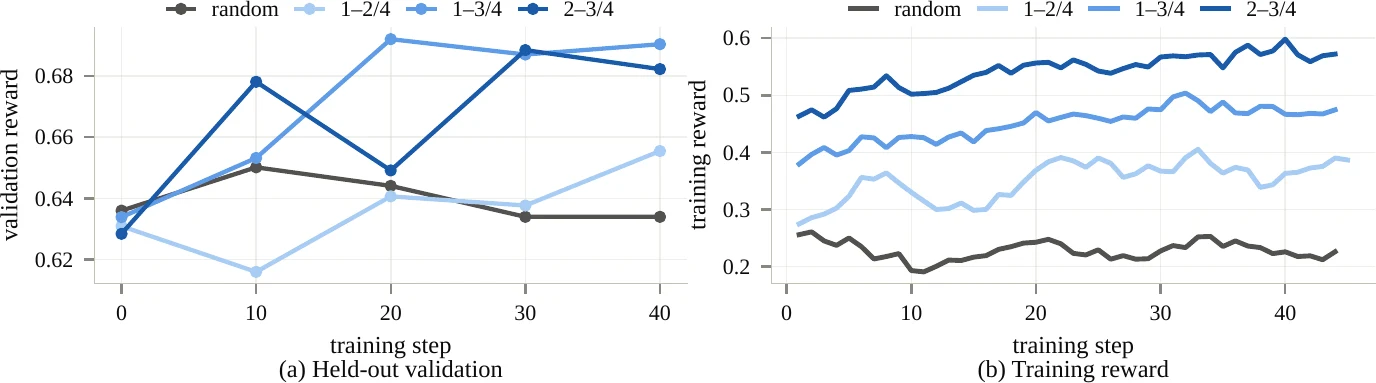
原论文 Figure 6(CC0)。Validation 只在实际执行的任务上计算。
Full bandpost-warmup validation average 0.671。
Upper half0.670。
Lower half0.640。
Unscreened72.7% 从未解出,13.4% 总能解出;训练前后没有净改善。
论文 §4.3、Figure 6。四组 inference concurrency 不同,作者比较 post-warmup average。
14 · OBSERVABILITYFigures 7-8
均值下降以后,必须下钻到 termination、task 和 transcript
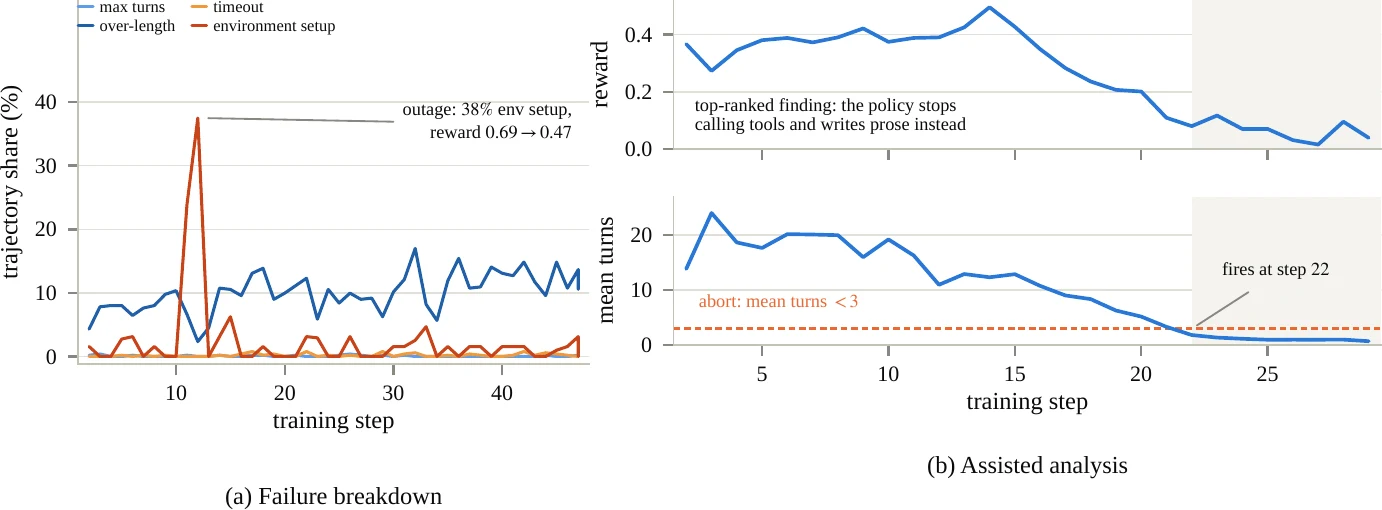
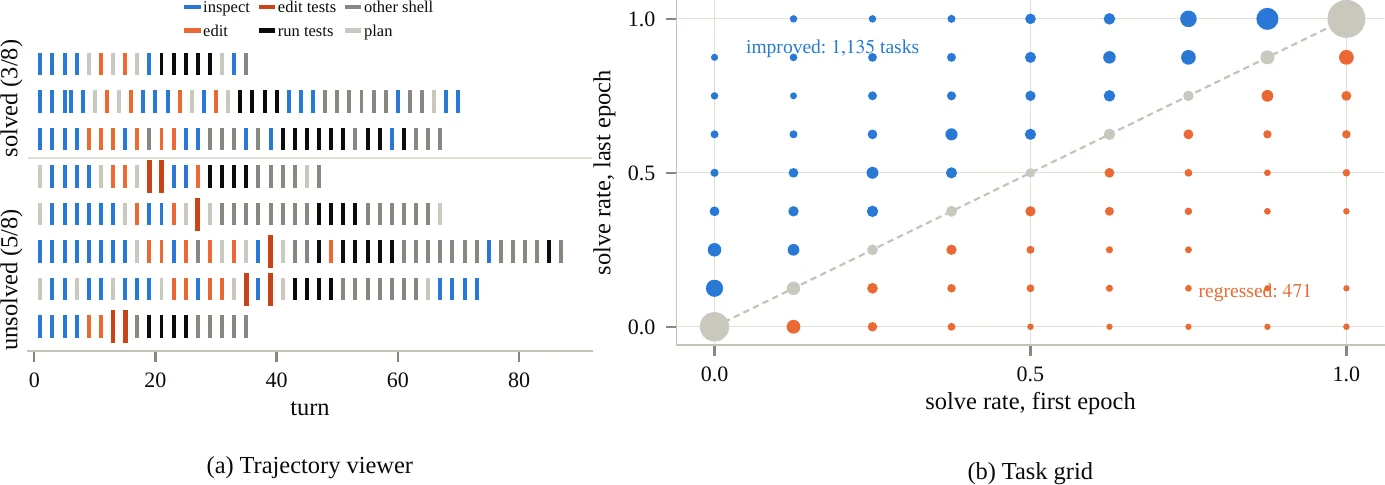
原论文 Figures 7-8(CC0)。Figure 7 两个 panel 来自不同 diagnostic runs。
15 · BEHAVIORFigures 11-12
模型更常检查、重读和运行测试,malformed tool call 变少
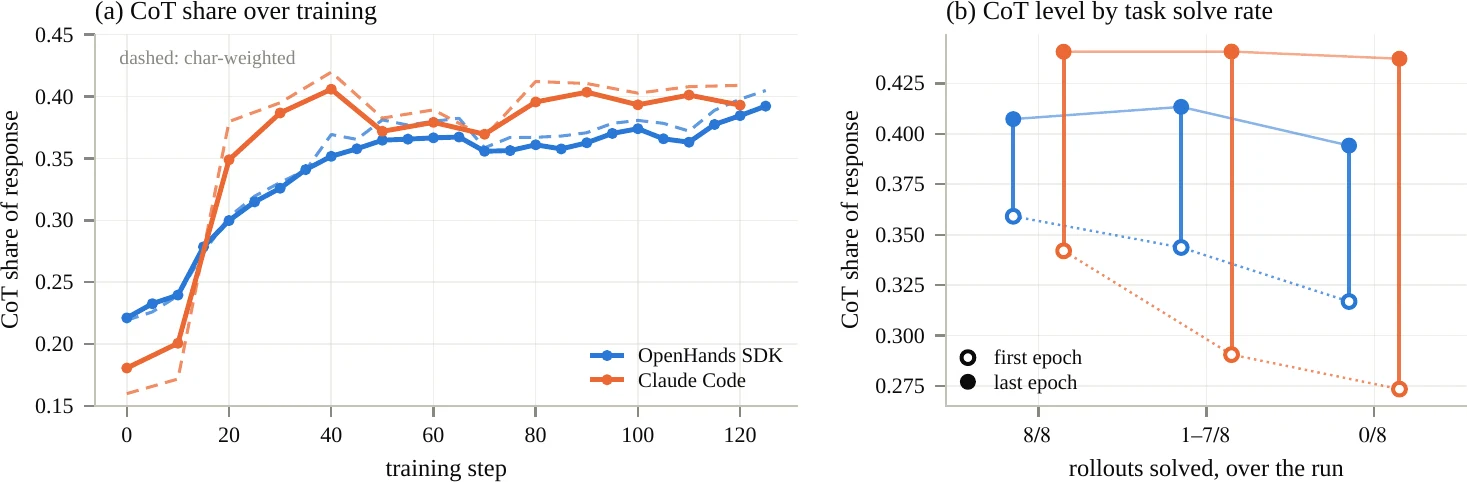
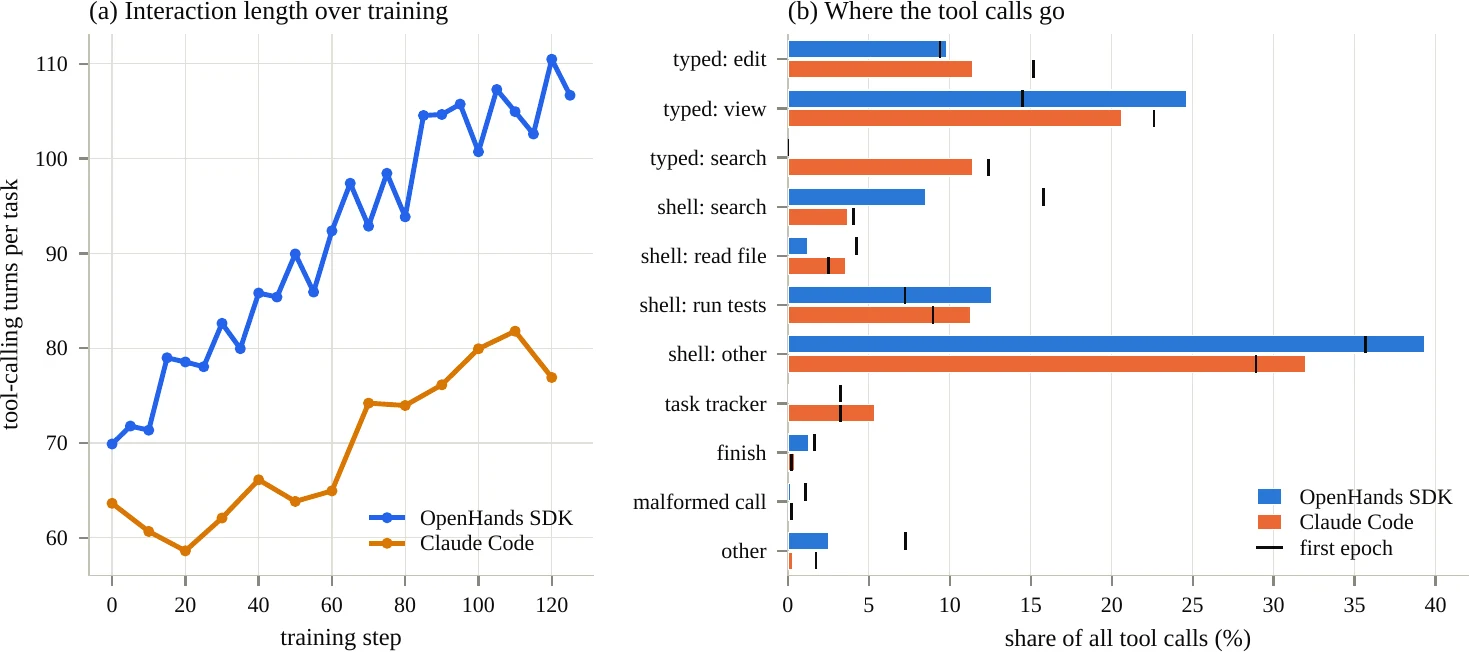
原论文 Figures 11-12、Table 9(CC0)。行为标签由确定性 transcript detector 计算。
16 · SYSTEMSFigures 9-10
异步调度消掉慢 rollout 的批次等待,Nydus 减少镜像搬运
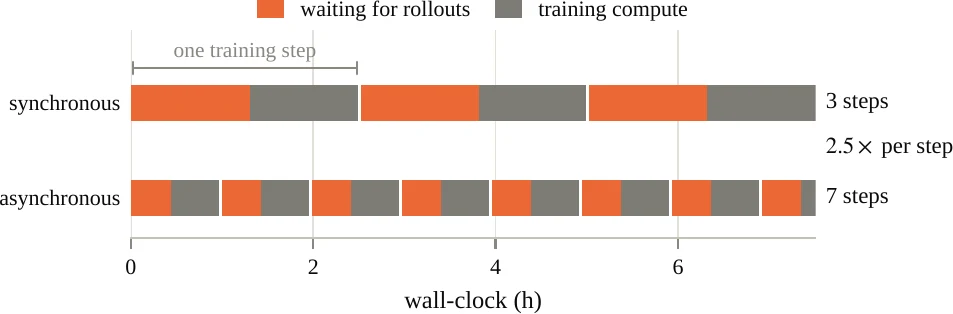
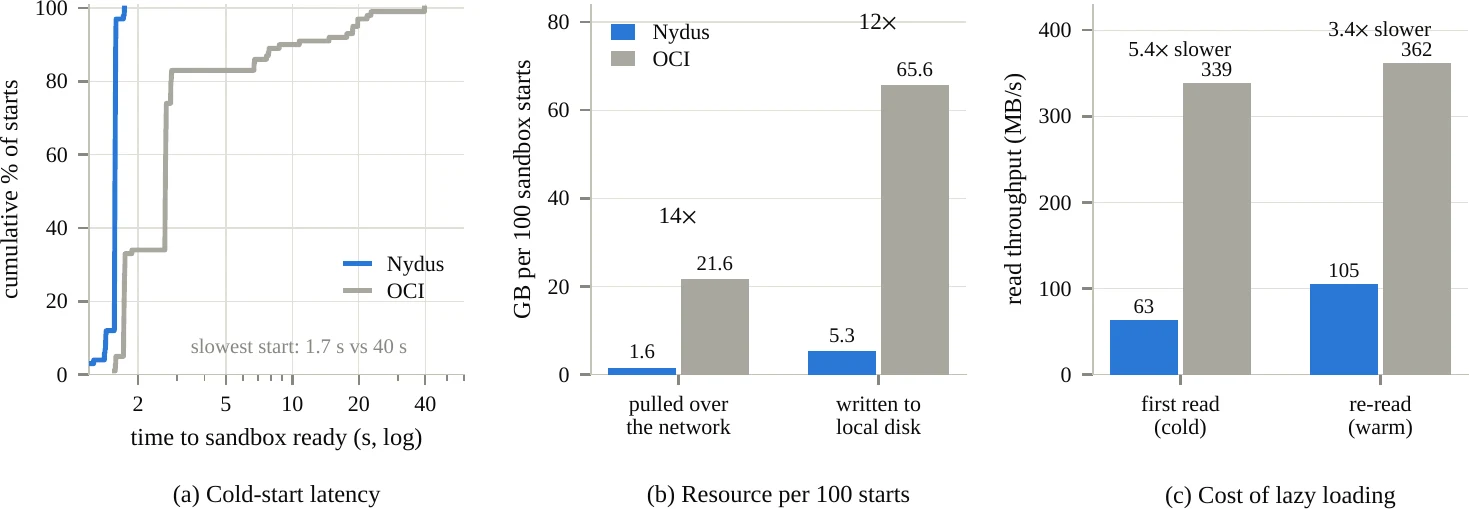
原论文 Figures 9-10、Tables 4-5(CC0)。Sync/async 的 optimizer throughput 不完全匹配。
17 · UI EVIDENCEFigures 13-14
从 task grid 进入 termination 与 train-inference alignment
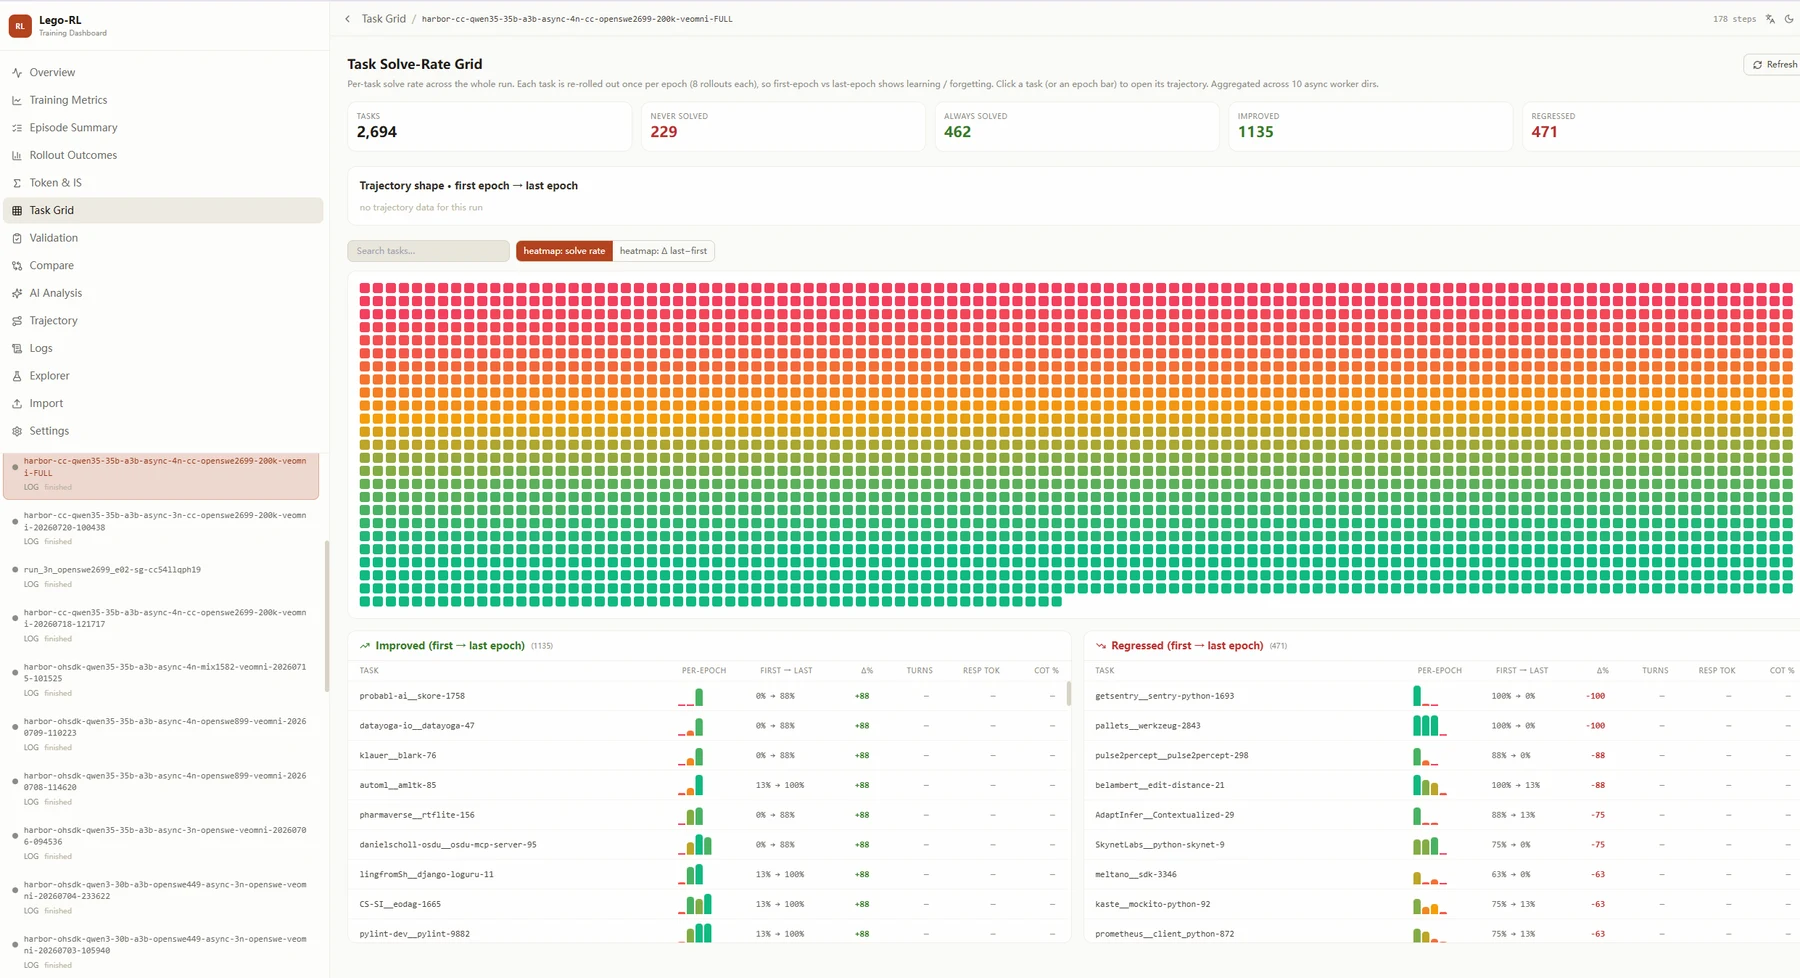
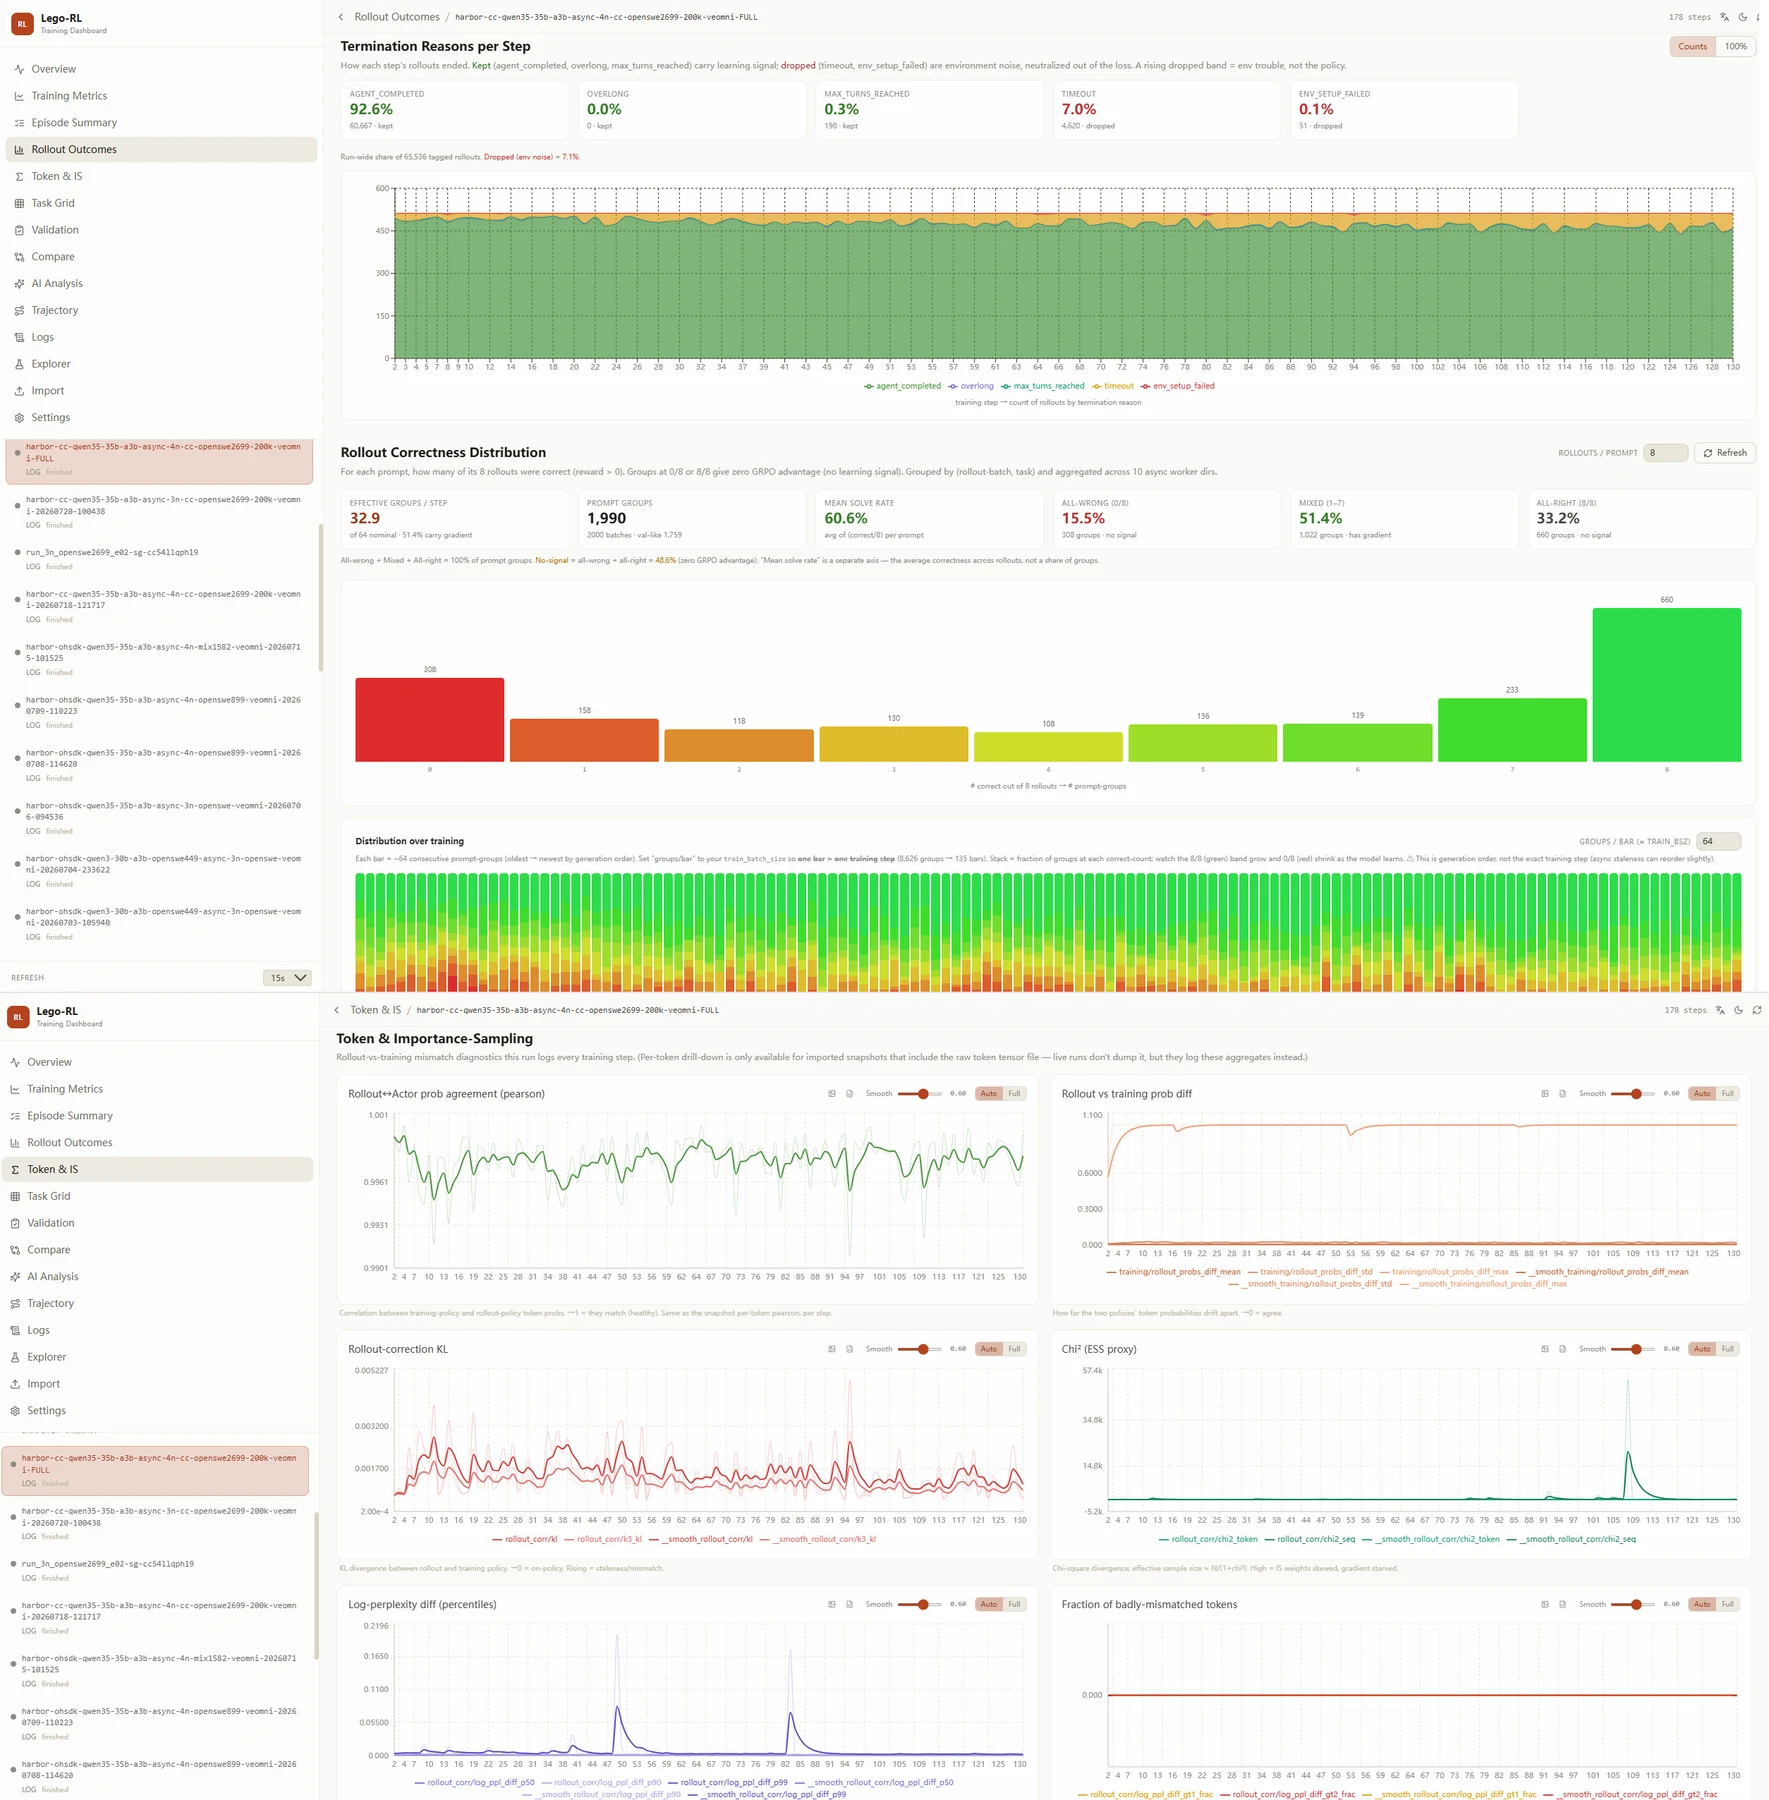
原论文 Figures 13-14(CC0)。UI 是诊断工具,不自动把相关性解释成原因。