01 · PAPER MAParXiv:2608.17393v1 · 2026-08-18 · CC0
HARNESS-NATIVE RL FOR CODING AGENTS保留 Claude Code 等
保留 Claude Code 等
原有执行流程,
用真实修复结果训练模型
LEGO-RL 不改写 Agent 怎样管理上下文和工具。它在模型服务处记录实际生成的 token,在隔离仓库里执行修复,最后用隐藏测试给出 0/1 分。
训练需要对上同一条记录:模型当时读了什么、生成了哪些 token、使用了哪些 MoE 专家。训练程序根据这些记录重算概率,更新模型权重,编码助手的执行流程不变。
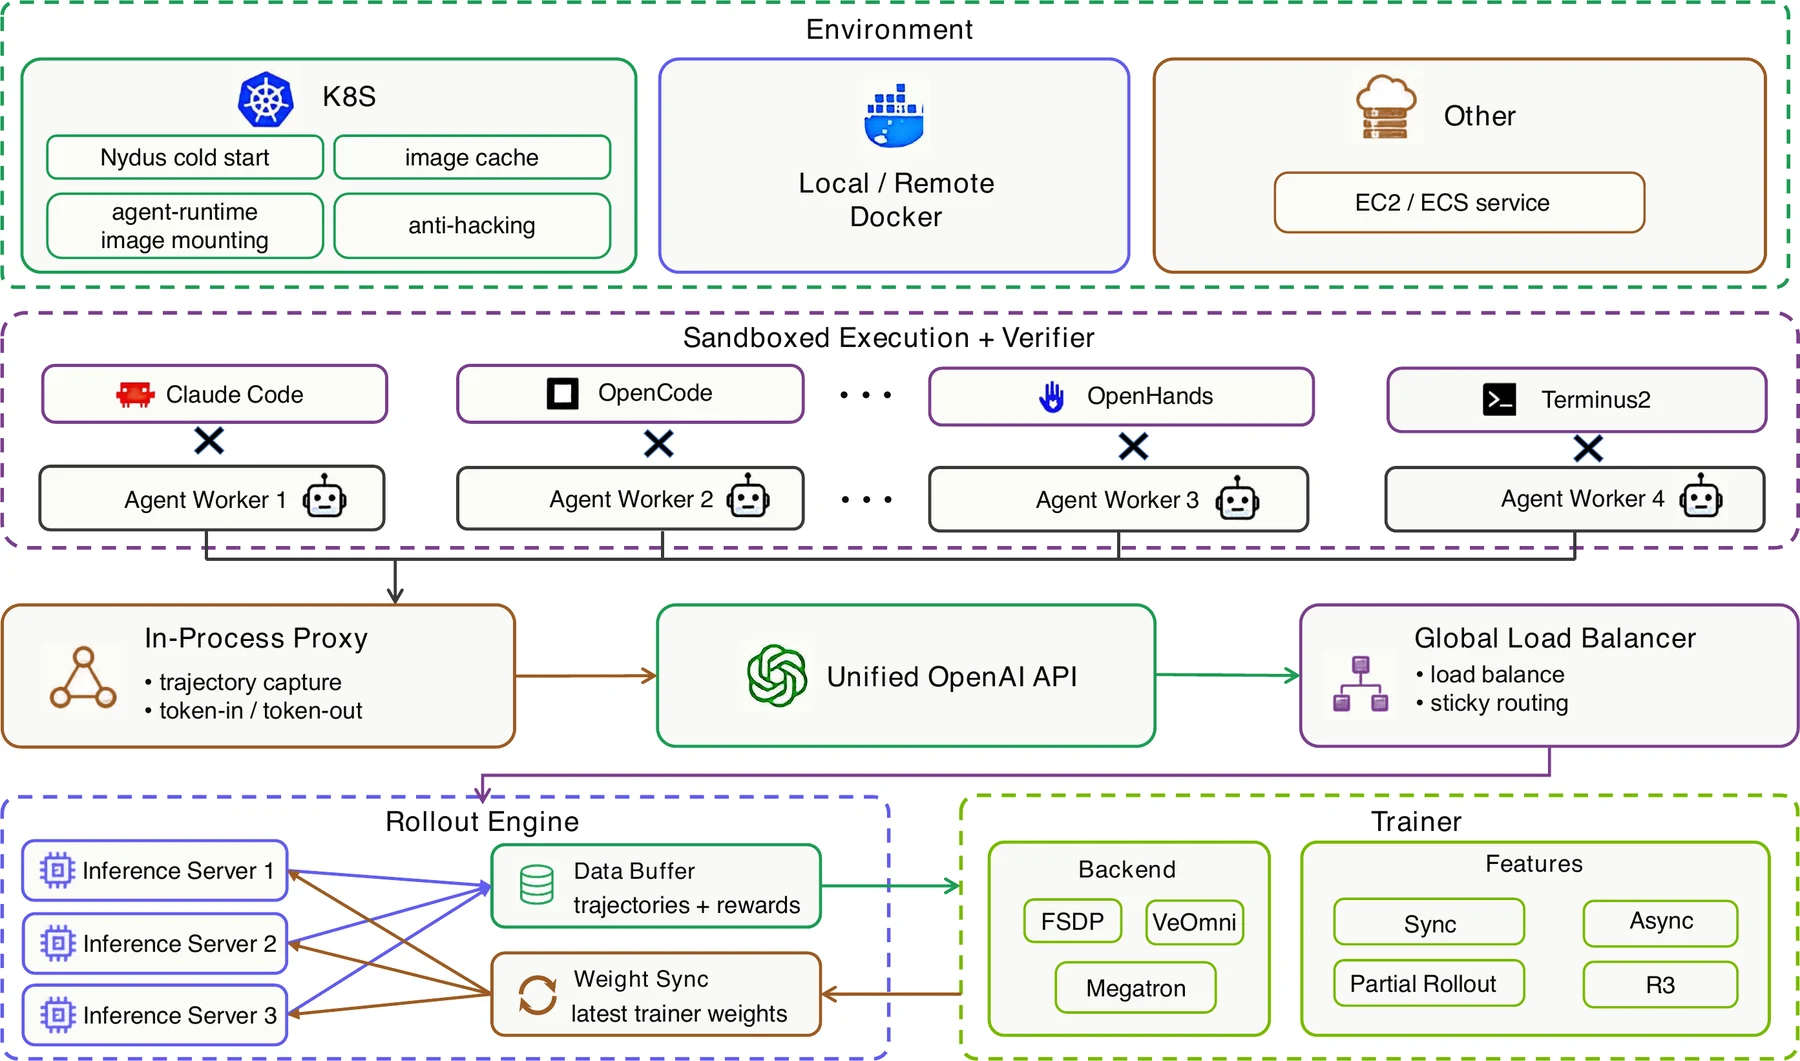
原论文 Figure 1:编码助手、代理程序、隔离环境、测试程序与训练程序。
64.0 → 70.4OpenHands · 验证最高分 %
62.4 → 68.2Claude Code · 验证最高分 %
57.2 → 66.6OpenCode · 验证最高分 %
> 0.99生成与训练概率的相关系数
论文 Abstract、Figure 1、Table 2。每种 harness 单独训练一次;数值为各自初始/验证最高分。
06 · ARCHITECTUREFigure 1
一次任务执行怎样进入模型训练
原论文 Figure 1(CC0)。隔离环境内运行编码助手;代理连接生成模型;执行记录和测试分进入训练程序。
07 · OPERATIONSFigure 2
数据准备、配置检查、运行、监控与人工复核各有职责
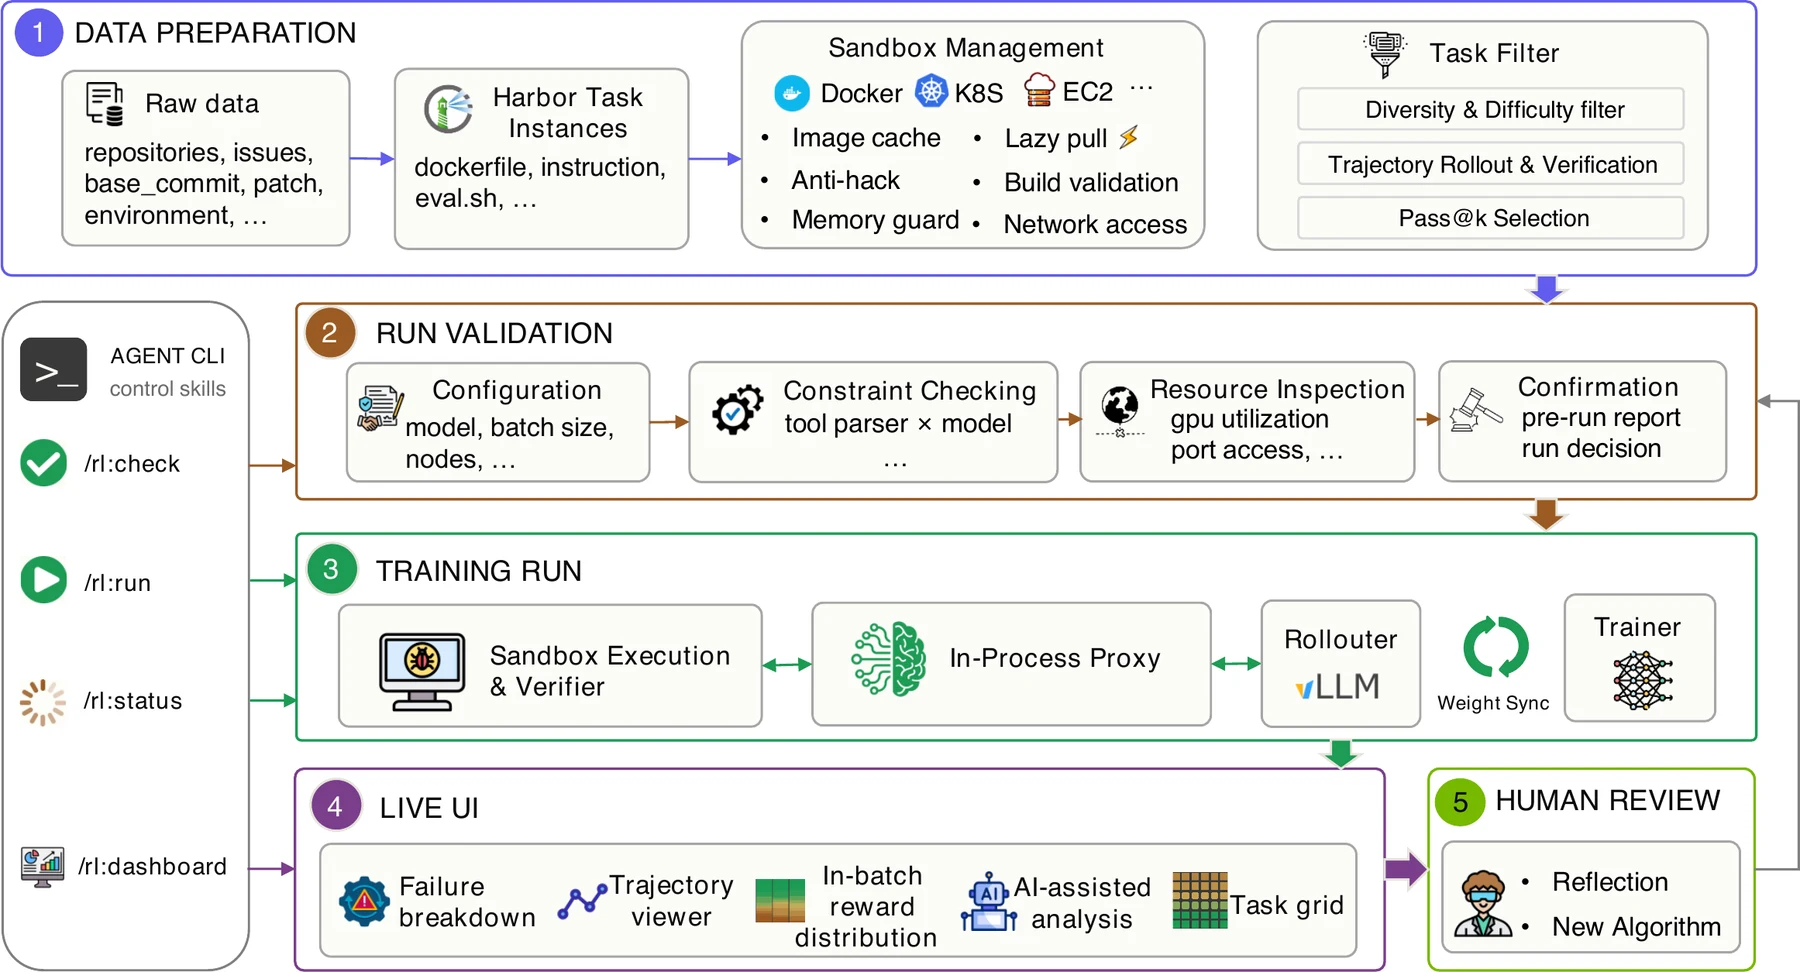
原论文 Figure 2(CC0):Data Preparation → Run Validation → Training → Live UI → Human Review。
准备与验证检查训练索引、容器镜像、测试程序、模型和依赖。
训练运行 Figure 1 的模型代理、记录缓冲区和训练程序。
观察与复核监控界面(Live UI)查看具体任务、执行记录、工具使用和结束原因。
论文 §3.3、Figure 2。官方仓库提供 /rl:check、/rl:run、/rl:status、/rl:dashboard。
10 · JUDGE TRACEAgent 执行阶段和 verifier 评分阶段分开
同一任务从原始记录变成验收包;训练索引只保存包的路径
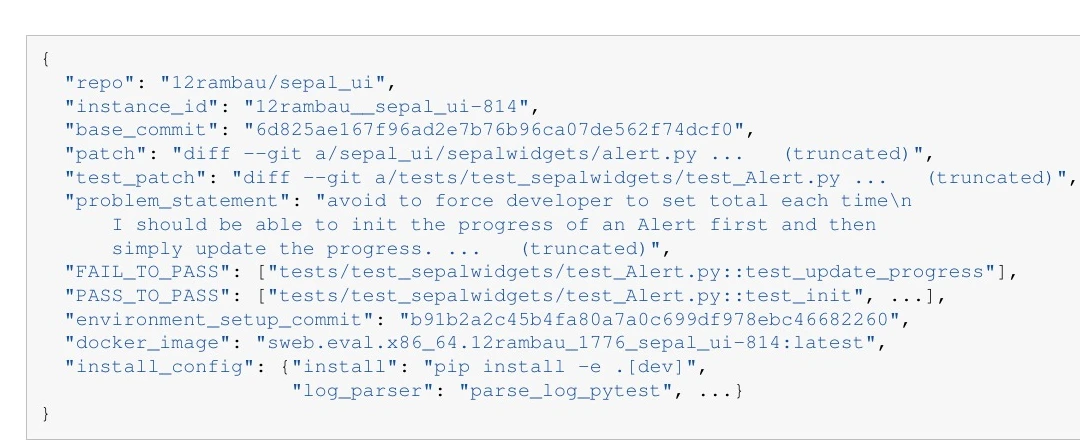
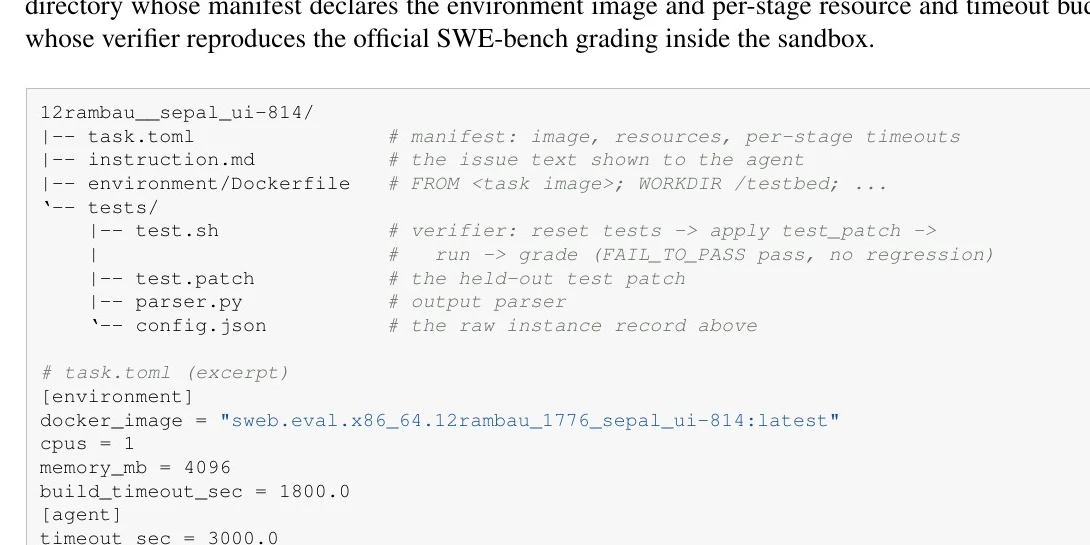
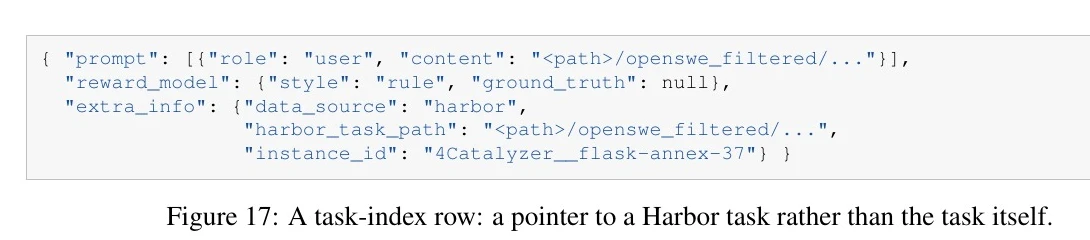
结束以后,verifier 才获得 tests/恢复测试文件 → 应用隐藏 test patch → 跑测试 → 解析结果。FAIL_TO_PASS 全过且 PASS_TO_PASS 无回归才给 1,否则 0。官方 GitHub 未含此任务完整测试包;这里只核对上游测试和论文协议,没有复现作者评分。
原论文 Figures 15-17(CC0);文件目录在宿主侧,不能当成 Agent 可见的文件系统。
11 · TRAINING BEHAVIORFigure 3 · 126 steps / 3 epochs
同一初始模型在三种 harness 下,成绩与执行长度都不同
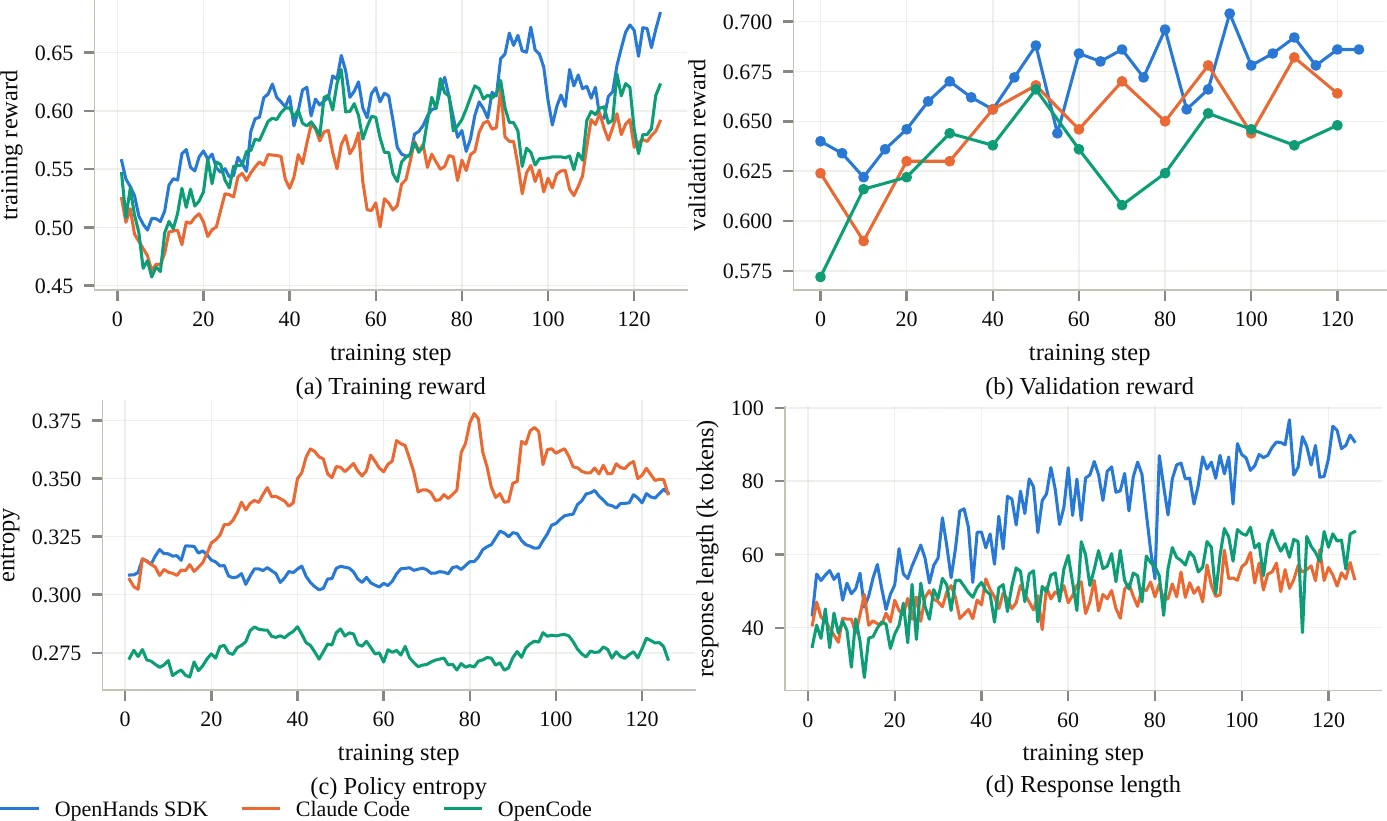
原论文 Figure 3(CC0):训练分、验证分、生成分布的熵、回复长度。
OpenHands SDK初始 64.0%,验证最高 70.4%。
Claude Code初始 62.4%,验证最高 68.2%。
OpenCode初始 57.2%,验证最高 66.6%。
不能横向排名 harnessstep-0 已不同;论文比较各自训练前后。
论文 Figure 3、Table 2。Validation temperature 0.7,1 sample/instance。
12 · ADMISSION & REWARDFigures 4-5
按结束原因给训练权重;不能把所有未完成任务都当成模型答错
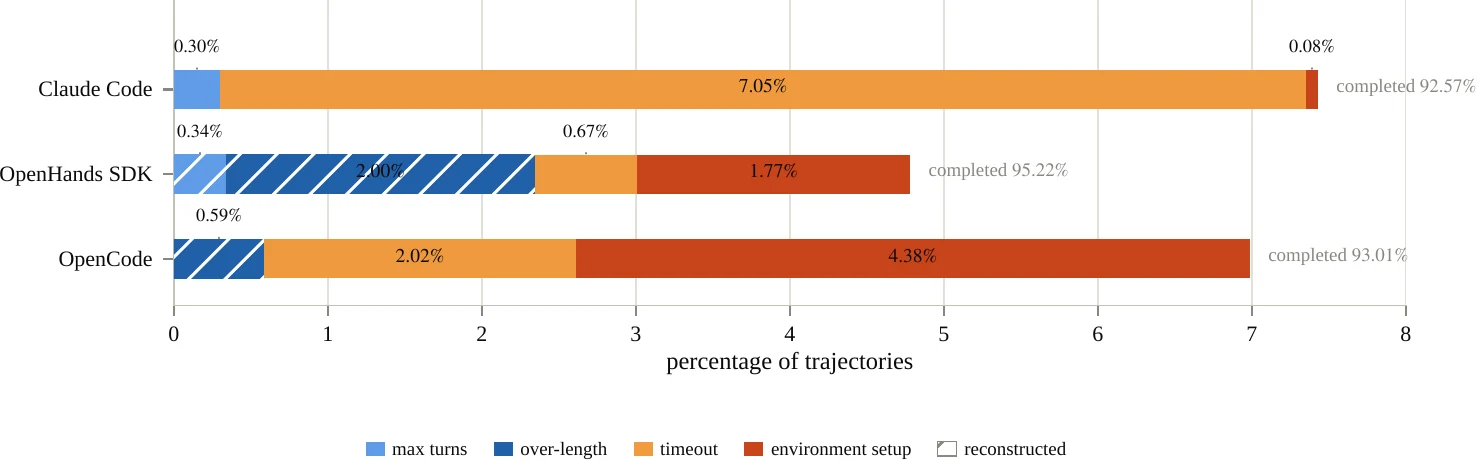
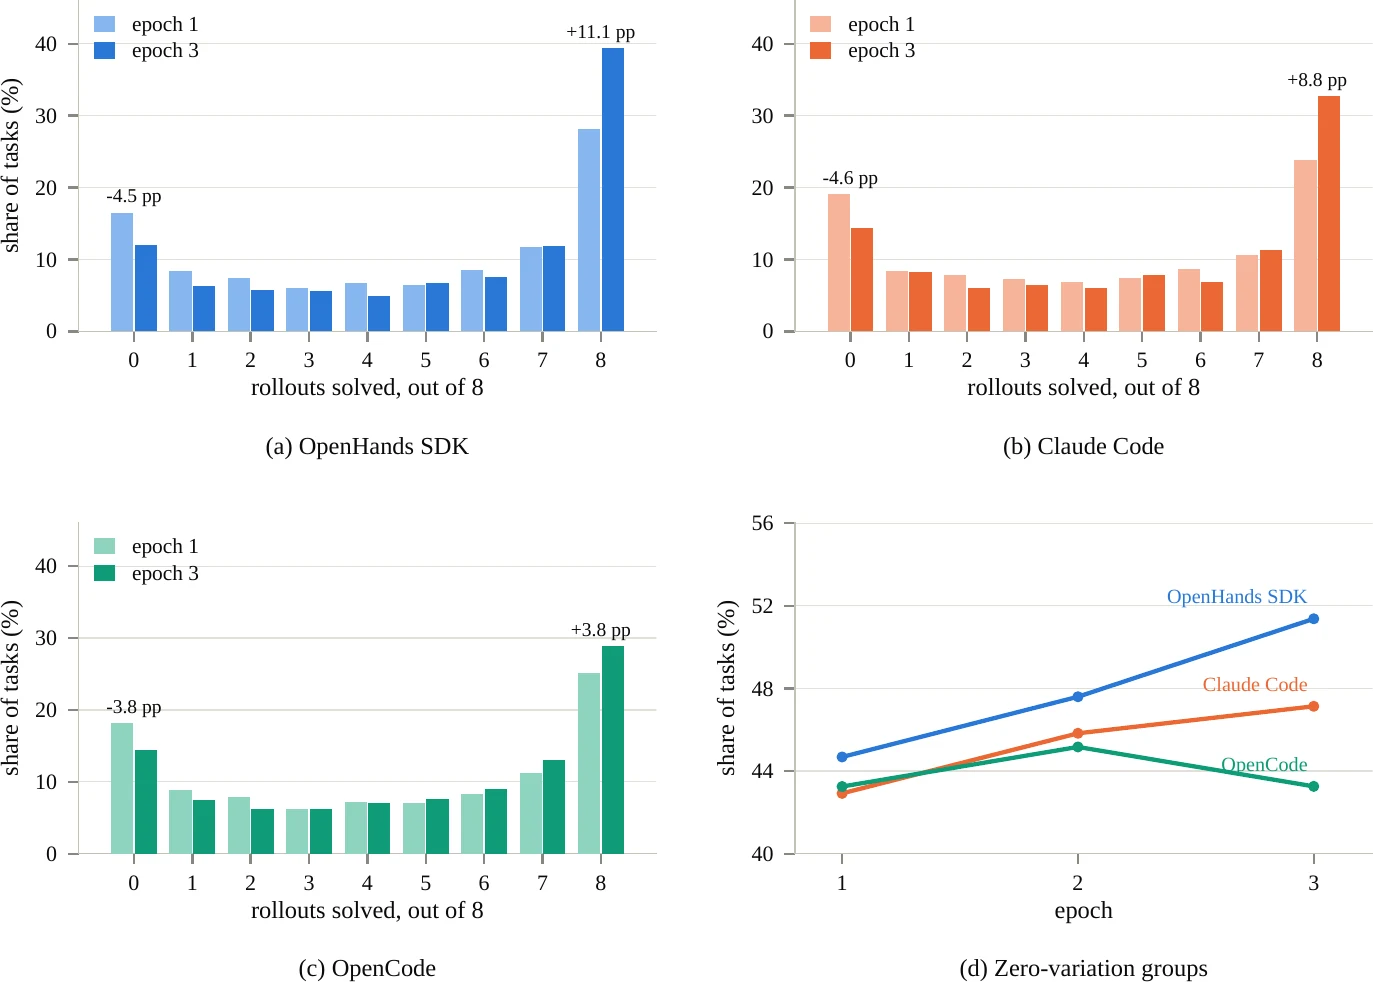
Figures 4-5;代码 patches/verl_sao_7aed6b23.patch。设施故障记录先脱离组统计,再清零训练贡献;有效但达轮数上限的记录仍保留测试结果。
13 · TASK SELECTIONFigure 6 · four 951-task pools
四组同样各 951 题,偏难任务和随机题池更难提供组内差异
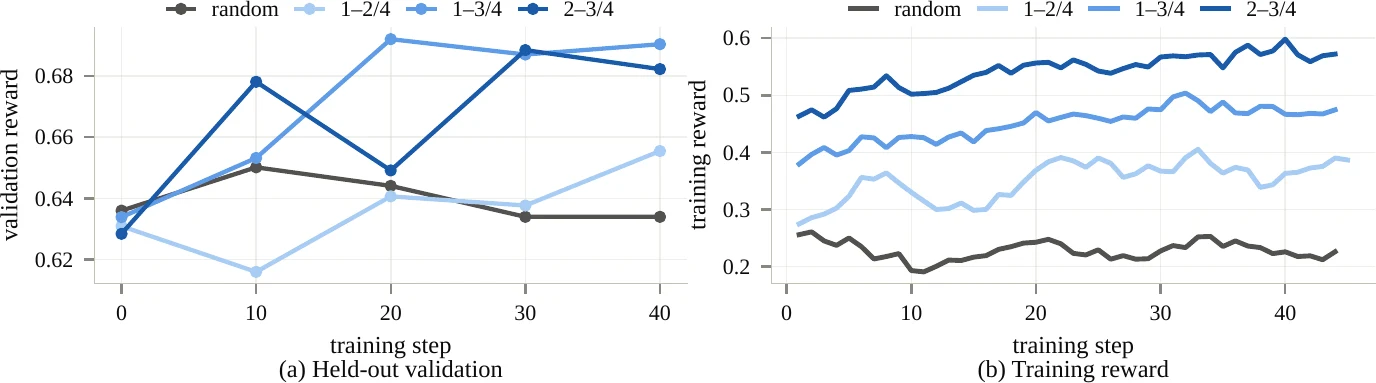
原论文 Figure 6(CC0)。Validation 只在实际执行的任务上计算。
完整段:1–3/4预热后平均验证分 0.671。
偏易半段:2–3/4预热后平均验证分 0.670。
偏难半段:1–2/4预热后平均验证分 0.640。
未做难度筛选72.7% 从未解出,13.4% 总能解出;训练前后没有净改善。
论文 §4.3、Figure 6。四组生成并发不同,验证分母仅含实际执行题目;不是主实验固定 500 题的口径。
14 · OBSERVABILITYFigures 7-8
训练分下降时,要查结束原因、具体任务和执行记录
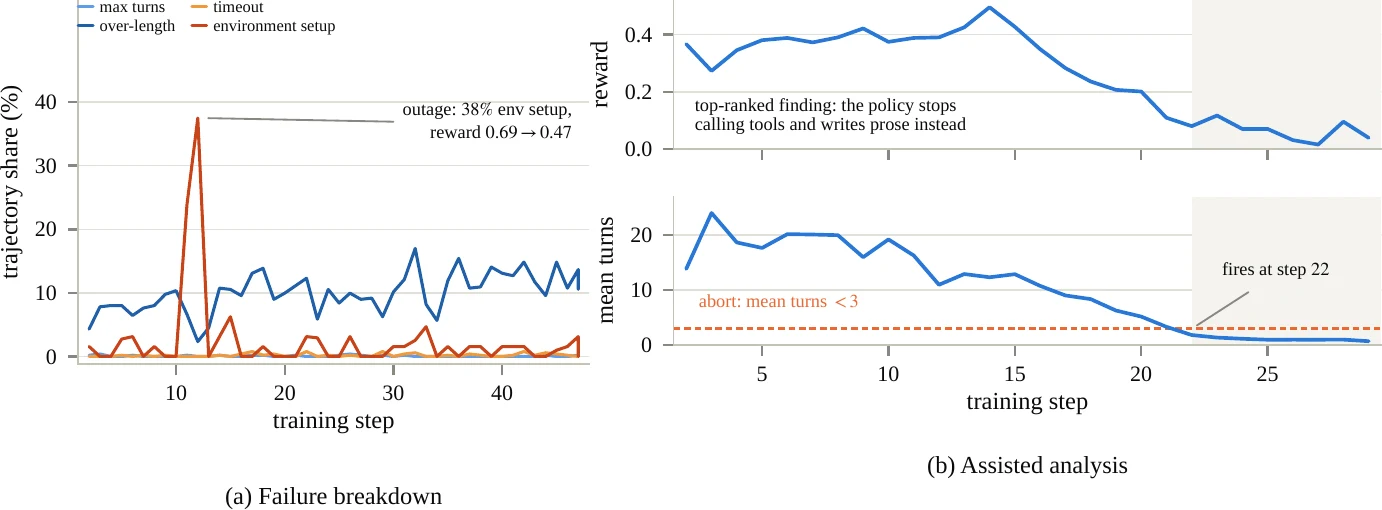
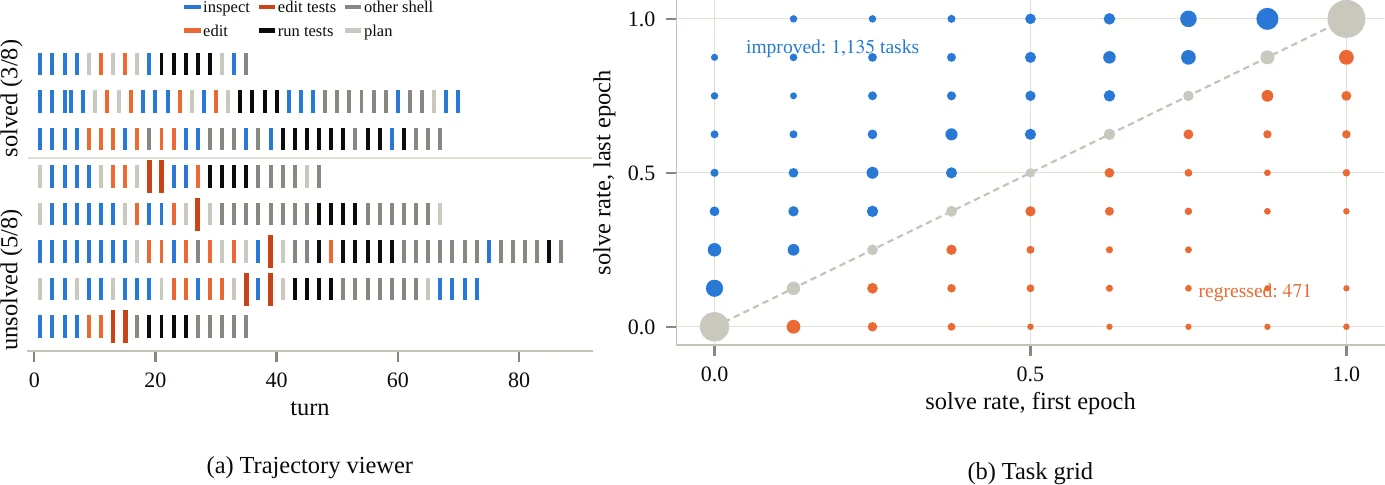
原论文 Figures 7-8(CC0)。Figure 7 两个子图来自不同诊断运行,都不是前面的主实验曲线。
15 · BEHAVIORFigures 11-12
模型更常重读和测试代码,格式错误的工具调用变少
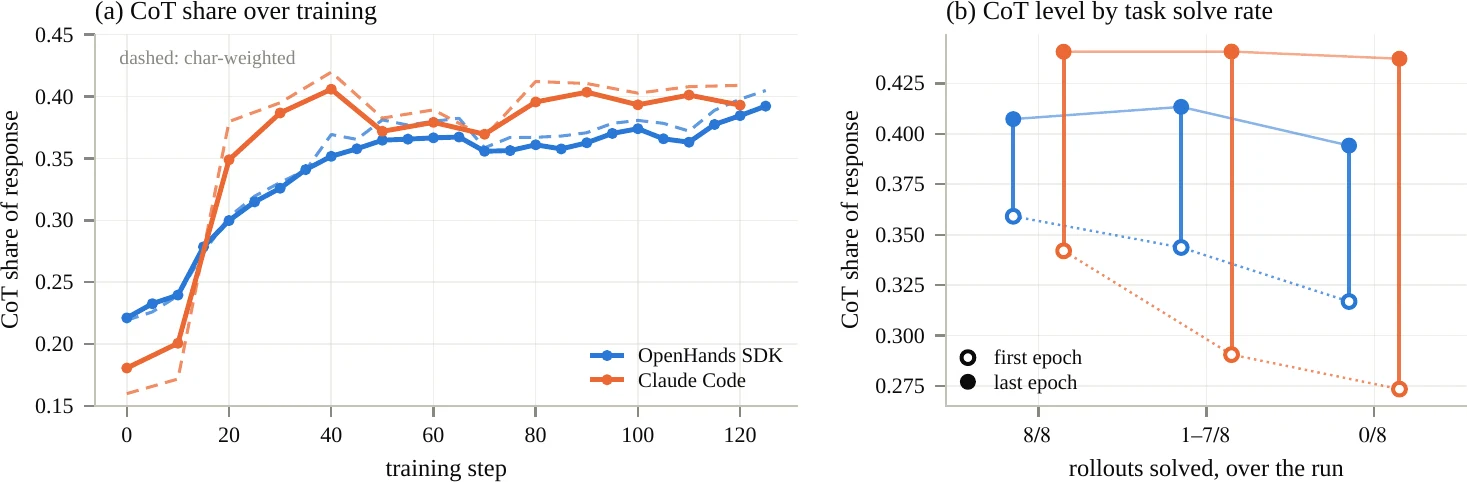
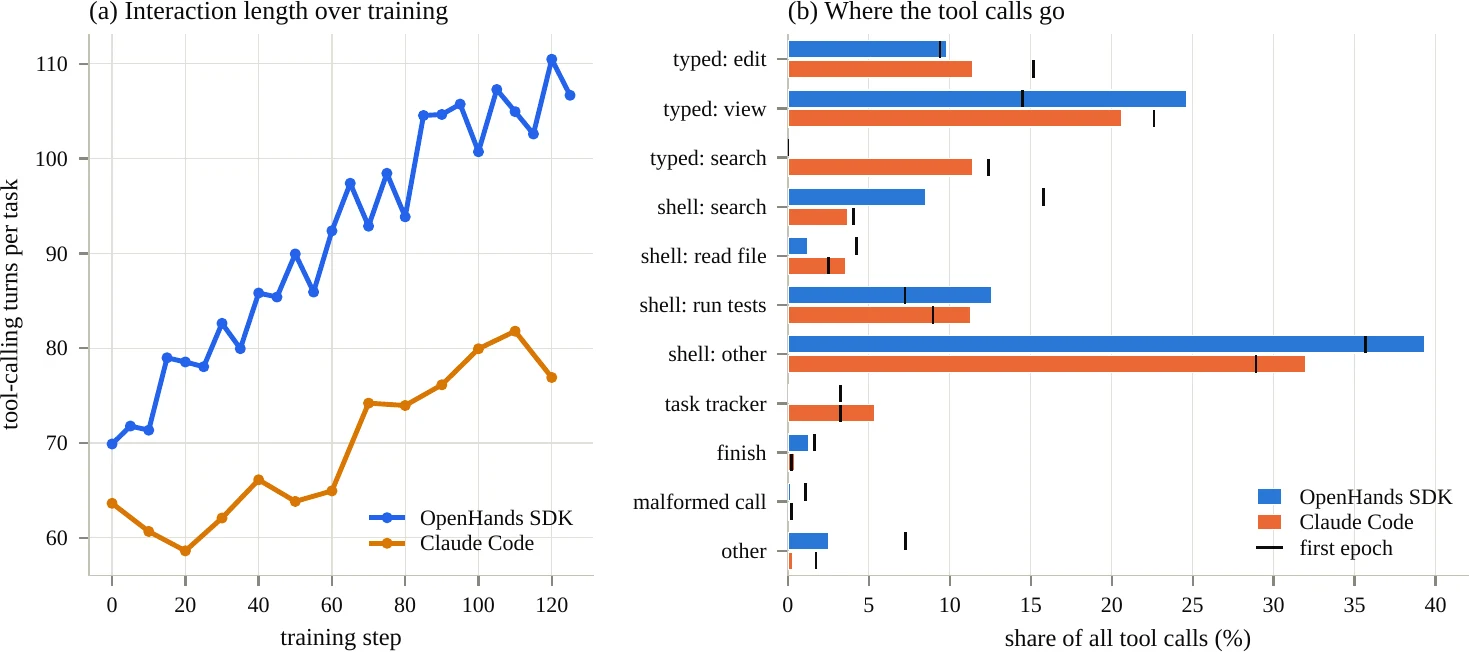
原论文 Figures 11-12、Table 9(CC0)。行为标签由程序扫描执行记录得到,不是模型评分。
16 · SYSTEMSFigures 9-10
异步不必等待整批最慢任务;按需下载镜像减少启动传输
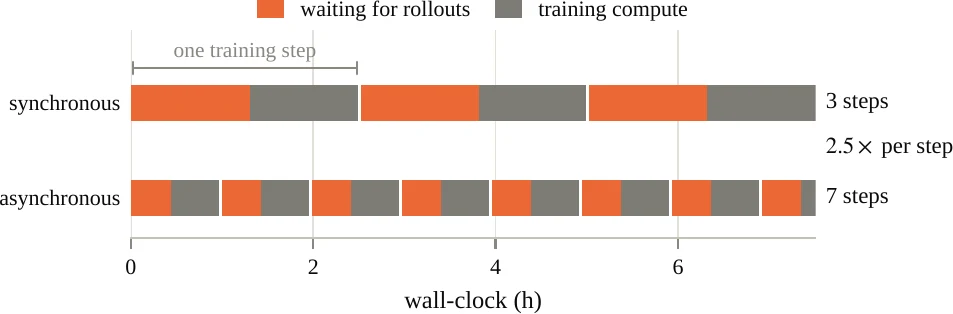
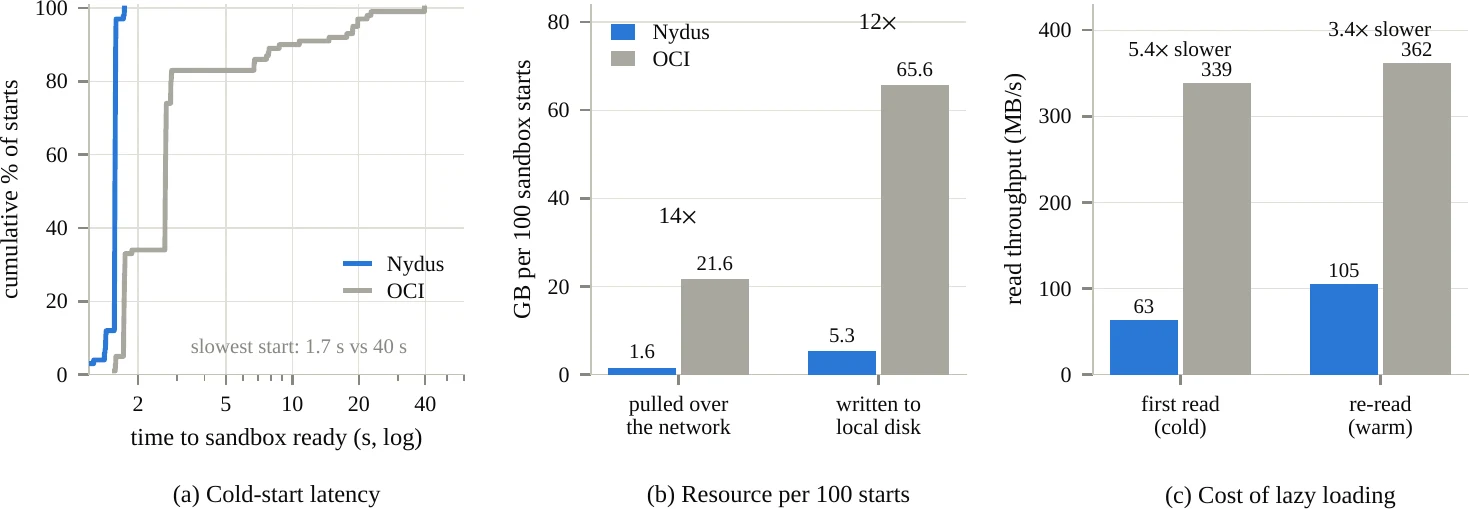
原论文 Figures 9-10、Tables 4-5(CC0)。同步与异步组的参数更新吞吐不同;1.9× 是估计,不是匹配硬件重跑结果。
17 · UI EVIDENCEFigures 13-14
从任务网格查看结束原因,以及生成和训练概率是否一致
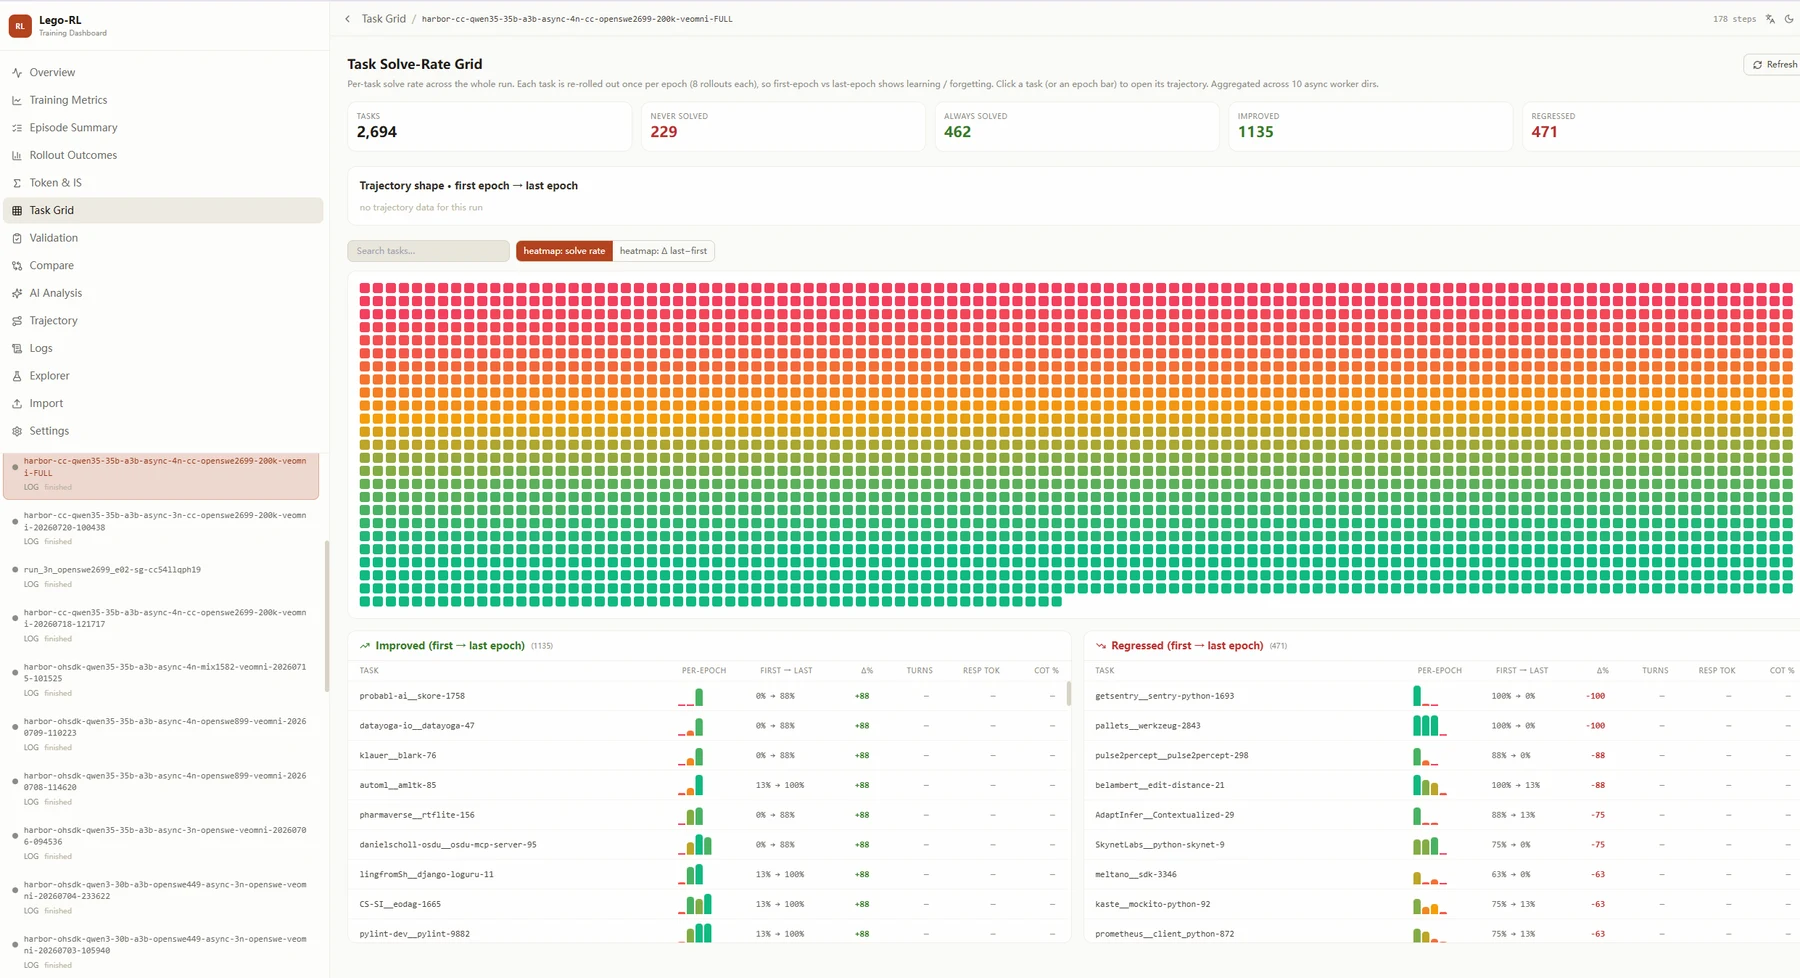
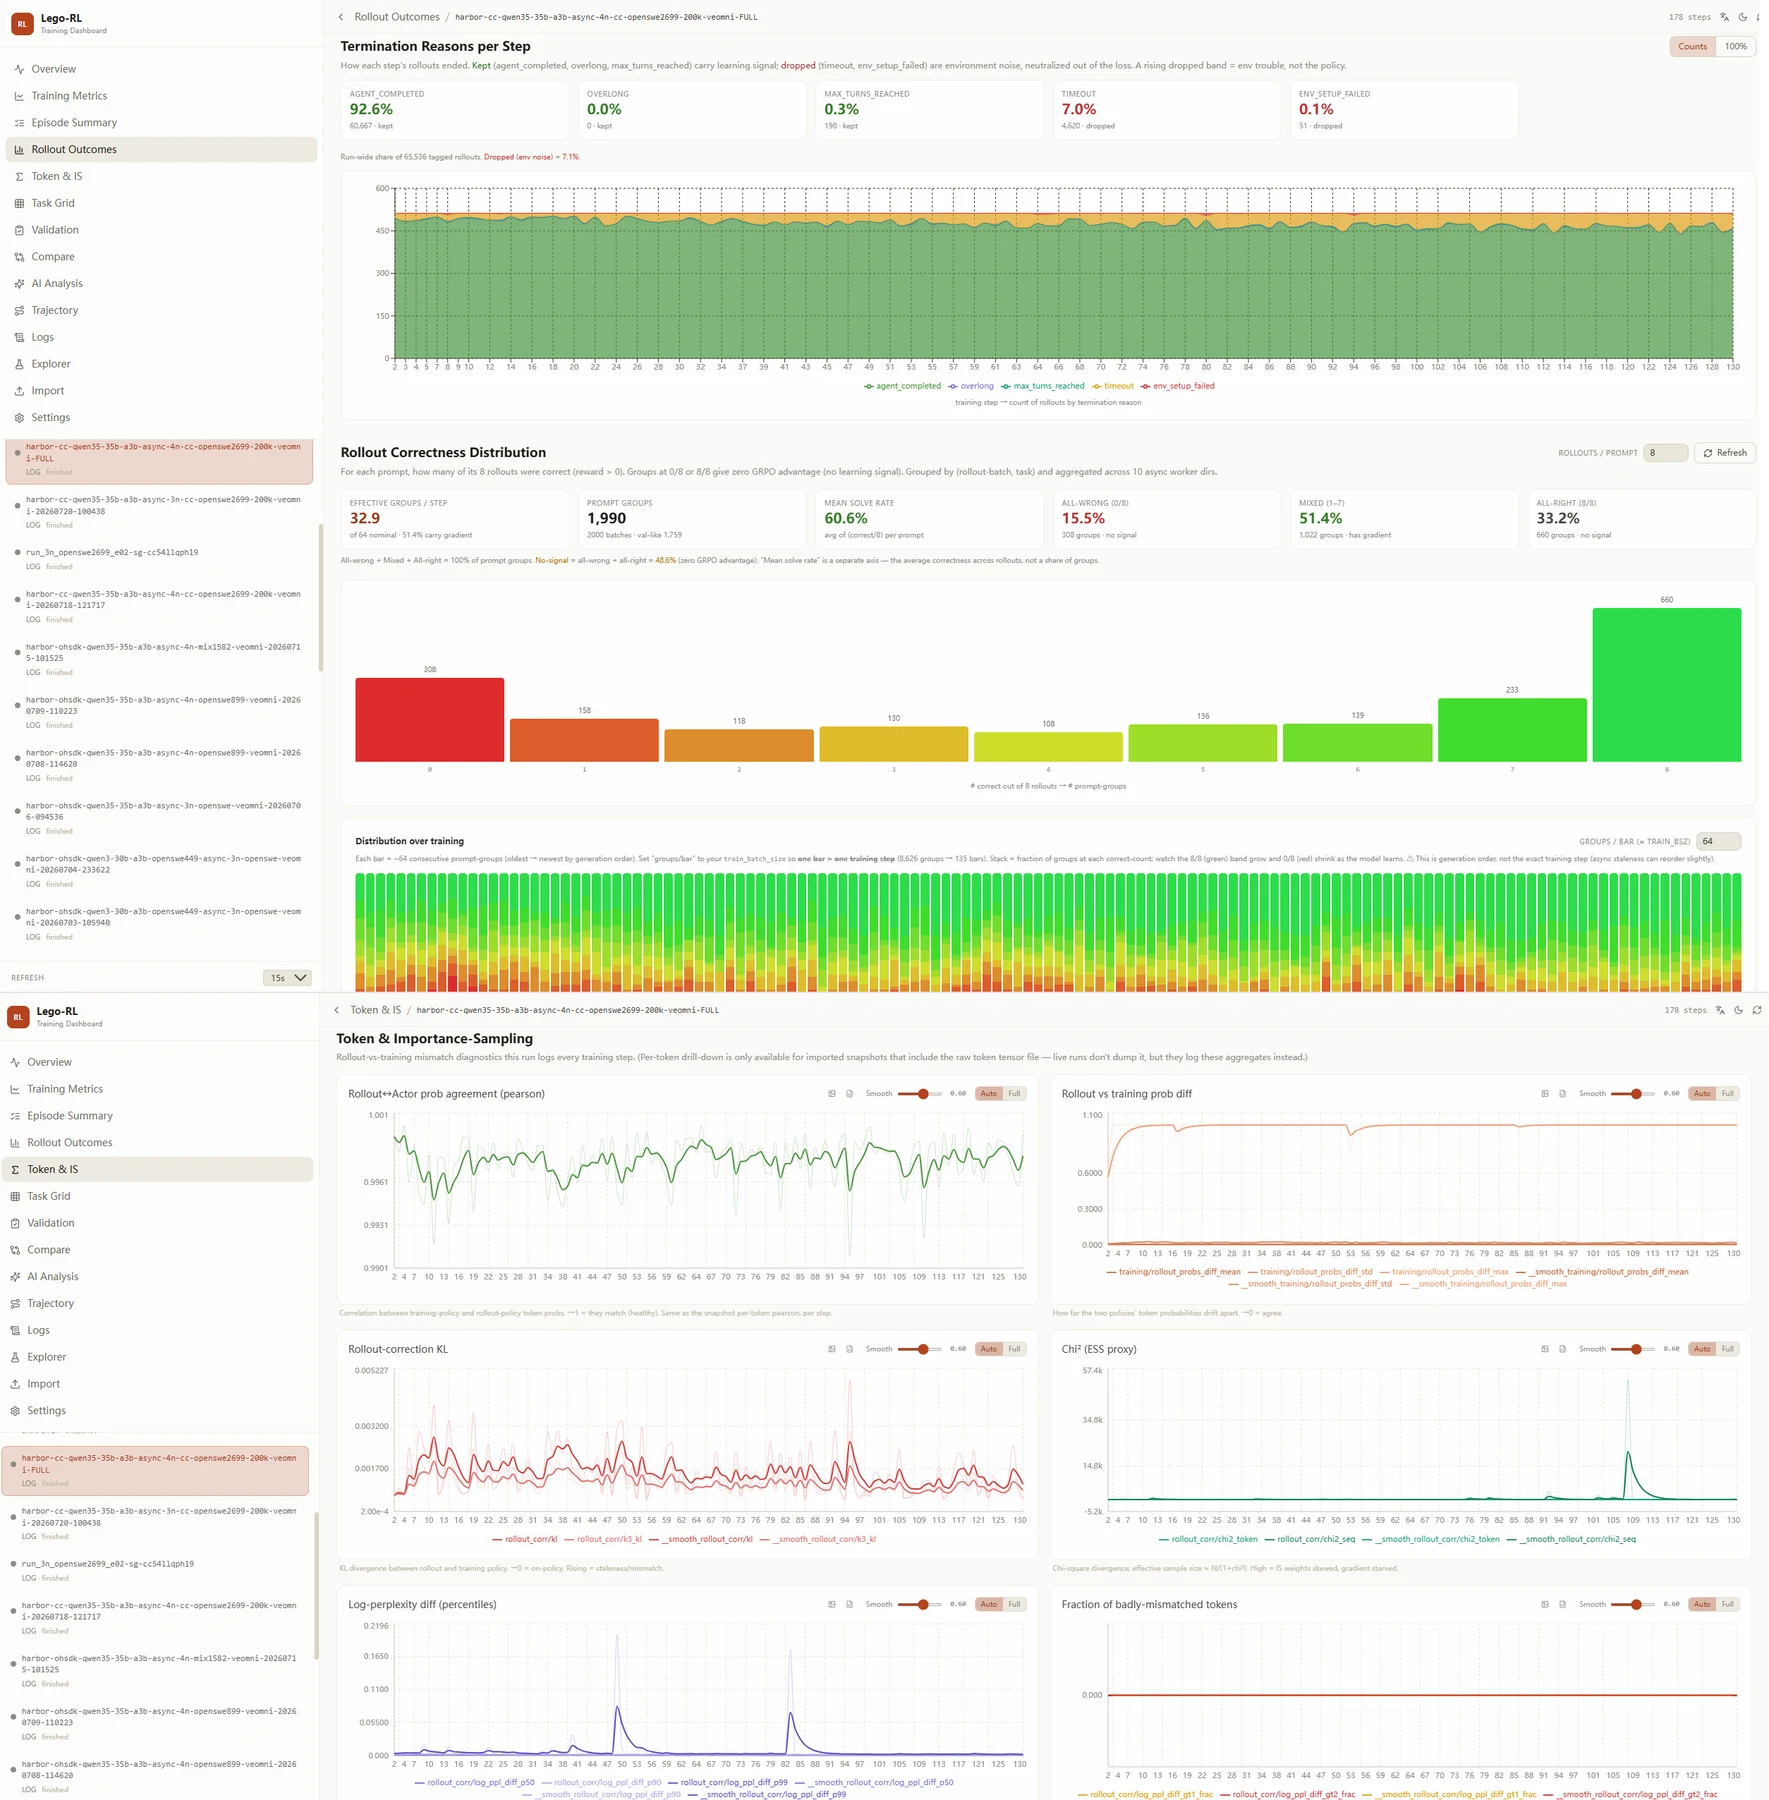
原论文 Figures 13-14(CC0)。UI 是诊断工具,不自动把相关性解释成原因。