01 · HARNESS-ZEROHarness Distillation via Agent-as-Harness
专用 harness 可以下线,
它教会模型的流程留下来
训练时,审查模型把 h* 的指导改成学生在 h 中能执行的回复;部署只保留微调后的学生模型与最小接口 h。
23.3 → 44.3Qwen3.5-9B 三领域无权平均
82.3%28 种专用程序才触发的行为,平均恢复率
Ye et al., arXiv:2609.24974v1
02 · MOTIVATION优化的是外部系统,收益也会留在外部系统
每个领域维护一套最优 harness,部署复杂度会一直增长
SHARED HARNESS
只保留一套通用接口
部署简单,但丢掉领域流程、专用检查和工具带来的收益。
↔
SPECIALIZED HARNESSES每个领域都带一套
每个领域都带一套 h*
效果更好,却要继续维护路由、上下文、模型调用和版本兼容。
论文 §1。
03 · NOTATION先分清谁在训练,谁在部署
h、h*、K 不是三套同类 harness
h部署用的固定接口
学生模型实际使用的固定接口:Bash execute 工具和固定系统提示。
训练与部署都保留
h*训练题上演化的专用程序
工具、调用前后处理、技能和记忆。直接包住学生时,可以读状态、拦动作或加工具。
仅用于产生指导
K审查者私有参考文件
把 h* 改成操作指南、审查规则、提示和常见错误,供审查模型读取。
仅供审查模型读取
论文 §3.1。
04 · ORIGINAL FIGURE 1Evolve → Review → SFT → Deploy
所有训练示范都先改成学生实际能执行的动作
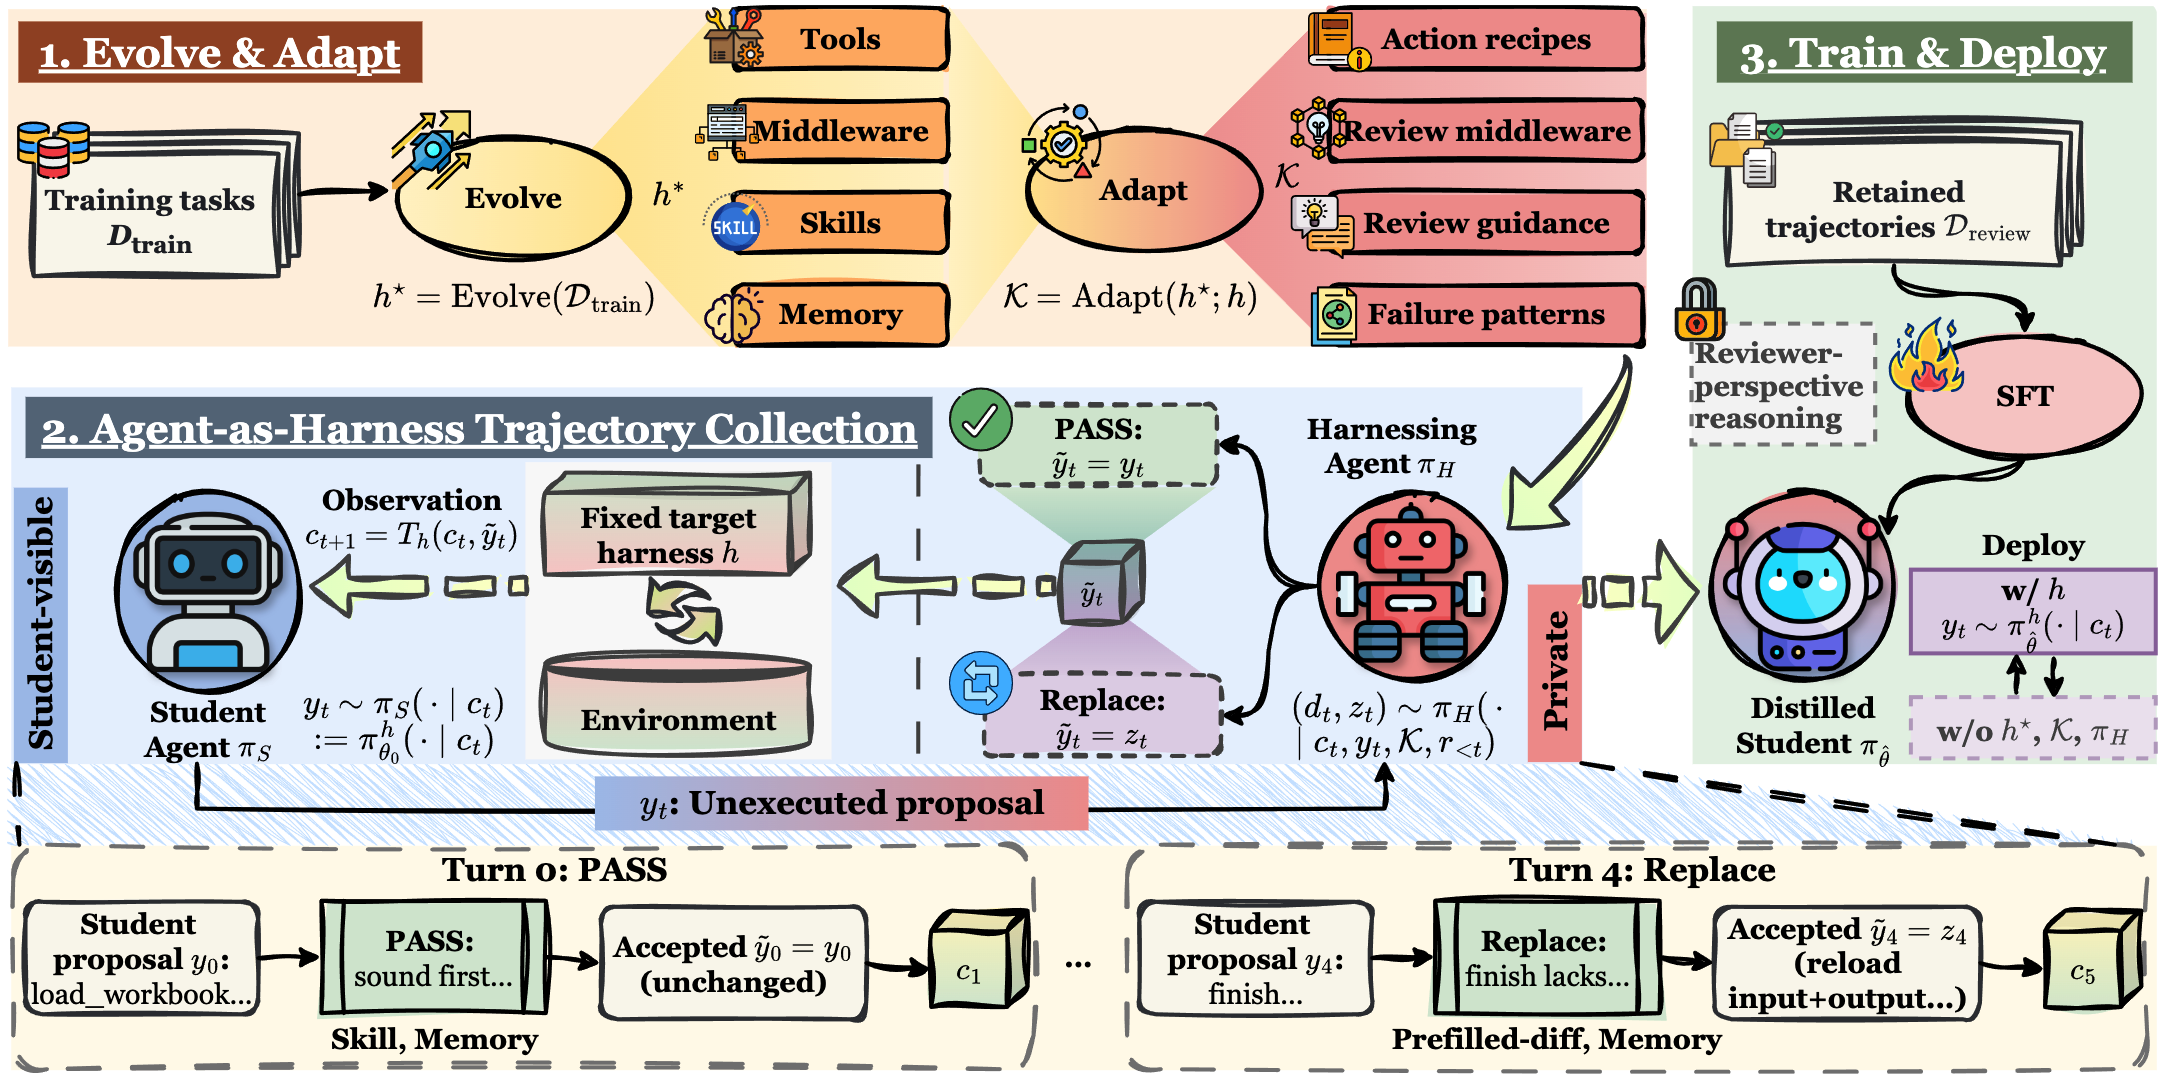
作者官方 Figure 1。先做三轮共享程序演化,只分析上一轮失败题;SFT(监督微调)学习接受后的回复。右下角是部署:保留
h,移除专用程序与审查者。官方仓库 assets/harness-zero.png,Apache-2.0。
05 · RESPONSE BOUNDARY模型提出的下一步,先审查再执行
审查模型只改下一步,然后让学生继续
1 · PROPOSE学生生成下一条回复
学生生成下一条回复 y_t
回复中的动作还没有执行。
2 · REVIEW读取轨迹与
读取轨迹与 K
只能依赖学生也能看到的证据。
3 · DECIDE
PASS / REPLACE
替换内容必须是一条完整回复。
4 · EXECUTE通过
通过 h 运行
最多一个合法 execute。
5 · OBSERVE
结果写回轨迹
学生根据新工具输出继续。
PASS原回复合理,不为风格或轻微低效改写。
REPLACE用尽量小、连贯且可执行的改动修正关键步骤。
C.2:表格/AppWorld 替换上限 5、3、1,USPTO 5;代码预算耗尽后直接放行、不再审查。
06 · EVIDENCE BOUNDARY审查者私有信息不进入训练记录
学生学自己执行过的检查,不学审查者批语
进入学生可见记录
- 任务与固定系统提示
- 审查后实际执行的回复
execute的输出和 exit code- 学生可以据此修复
不进入后续执行记录与 SFT
K与组件私有路径- 被拒绝的提案由学生生成,只是不执行、不监督
- PASS/REPLACE 的理由
- 调用前后处理规则的触发提示
§3.2–3.3、Appendix C–D;SFT 预测接受后的模型回复,工具输出只作上下文。
07 · WORKED EXAMPLE保留答题区域中预先填写的示例
答案区域里的示例单元格,本身就是不能改写的规格
B
C
D
3
18
?
?
4
24
?
?
5
20 ✕
?
?
蓝色是预填示例,红色表示被覆盖。坐标与数值仅为示意,非原始任务日志。
h* / 原检查代码
提交前直接读隔离工作区,比较输入与输出表格。
K / 改写后审查规则
不直接读工作区,只检查记录中是否有输入输出比较的证据。
REPLACE
若学生直接提交,替换成 Bash/Python 验证命令。
SFT 监督目标
命令输出进入可见轨迹,模型学会“验证后再提交”。
论文 Appendix B.2,Code 1–3。
08 · STUDENT-NATIVE ACTION根据 Code 1–3 压缩改写
K 不直接读文件,而让学生执行同样的检查
# 审查后实际执行回复中的 execute
wb_in  = openpyxl.load_workbook(INPUT)
wb_out = openpyxl.load_workbook(OUTPUT)

changed = []
for cell in answer_range:
    if input[cell].value is not None \
       and input[cell].data_type != "f" \
       and output[cell].value != input[cell].value:
        changed.append(cell)

print("PASS" if not changed else changed)
raise SystemExit(bool(changed))
为什么能学命令在学生自己的接口执行,输出和修复过程也都进入学生上下文。
为什么不是答案泄漏审查者不知道正确表格,只要求比较输入输出,检查示例是否被覆盖。
最终学到什么提交前比较输入输出,保护预填示例。
按 Appendix B.2 压缩的示意代码,只检查示例保护,不是完整任务验收器。
09 · DATA & TRAINING三个领域分别微调
同一个最小 h,三套领域轨迹
SpreadsheetBench
300 / 100训练 / 独立测试;最终 487 条成功轨迹。
AppWorld
147 / 168训练 / 测试题;56 个场景各 3 题,全对才算成功;最终 282 条轨迹。
USPTO
500 / 100训练 / 独立测试;覆盖 10 类反应,预测前体;保留全部 500 条轨迹。
Qwen3.5-9BLoRA r=32, α=32每批 8 条最大 65,536 token训练 2 遍随机种子 42
§4.1、D–E;代码复现补充:AppWorld 首轮另有 23 条示范/应用说明,工具仍只有 execute。
10 · TABLE 1 REDRAWN强模型实验,不更新权重
同一个专用程序,经审查模型改成动作后平均更强
最小
h68.6
h + 无指导审查69.2
直接挂载程序
h*78.1
按
K 逐步审查81.1
空
K 只比 最小 h 高 0.6 分。增益来自演化得到的指导,不是“多一次模型调用”本身。根据论文 Table 1 重绘;三个领域 × 两个模型,共六种设置的平均百分比。
11 · TABLE 2 REDRAWN部署时移除 h*、K、harnessing agent
蒸馏后的 9B 模型,在 最小 h 下达到 44.3%
| 设置 | 表格任务 | AppWorld | USPTO | 三领域平均 |
|---|---|---|---|---|
原模型 + h | 31.0 | 26.8 | 12.0 | 23.3 |
原模型 + h* | 39.0 | 48.2 | 38.0 | 41.7 |
| 原模型 + DeepAgents | 35.0 | 19.6 | 7.0 | 20.5 |
| 原模型 + Claude Code | 31.0 | 10.7 | 6.0 | 15.9 |
| Harness-Zero + h | 44.0 | 58.9 | 30.0 | 44.3 |
根据论文 Table 2 重绘;pass@1 / SGC,单次运行;AppWorld 58.9% = 33 / 56 场景。
12 · TABLE 3 REDRAWN采集成功不等于适合蒸馏
审查者读取标准答案,采集 98.6% 成功;蒸馏测试 15.0%
| USPTO 轨迹来源 | 采集成功率 | h 下测试 |
|---|---|---|
| GPT-5.6 Sol 独立做题 | 52.0 | 12.0 |
GPT-5.6 Sol 使用 h* | 62.0 | 3.0 |
Qwen3.5-9B 使用 h* | 39.4 | 12.0 |
空 K 下审查 | 44.2 | 11.0 |
| 审查者可读标准答案 | 98.6 | 15.0 |
Harness-Zero K | 59.4 | 30.0 |
根据论文 Table 3 重绘;同一批 500 道采集题与训练方案。
13 · TABLE 4 REDRAWN28 类专用程序触发的行为
82.3% 是在专门挑选的任务上恢复行为
82.3%28 类行为的平均恢复率
保护预填单元格24/26 · 92%
读取完整分页21/53 · 40%
用 RDKit 检查分子格式60/60 · 100%
区分执行动作与作答24/33 · 73%
解读边界样本按行为差异筛选:原模型 +
h 不做、+ h* 会做。恢复率不是自然任务上的总体行为准确率。根据论文 Table 4、Appendix G 重绘。
14 · TAKEAWAYS什么可以留下,什么暂时留不下
示范动作必须能在部署接口执行;代价是逐步审查与采集成本
较容易迁移程序化流程检查文件、验证结果和恢复动作,能通过实际回复示范并由 SFT 学习。
尚未充分迁移深领域知识USPTO:蒸馏后 30.0%,仍低于
h* 的 38.0%。审查者能力弱审查模型也会改坏Qwen3.6-35B-A3B 上逐步审查比直接挂载程序低 12 分。
采集成本100.1s → 237.2sUSPTO 平均延迟约 2.4×;部署阶段不再支付。