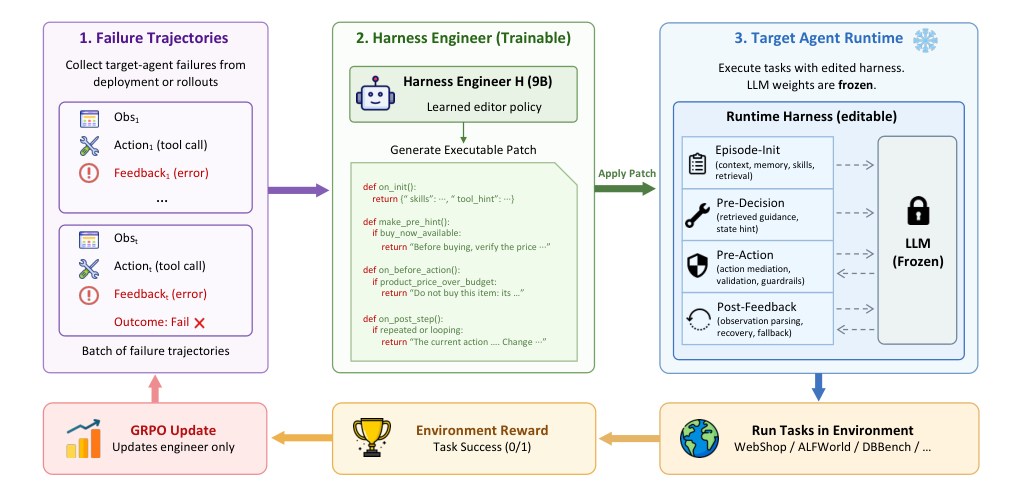
Harness-R1 训练一个 9B 模型专门修 Agent 的运行程序。它读取失败记录,修改组装提示、转发动作和处理环境反馈的代码,再让原 Agent 重做任务。训练奖励来自重跑前后的环境得分差;负责做任务的模型不更新,更新的是负责写补丁的模型。
1. Motivation:怎样从失败中学会修补运行程序
论文训练模型完成“读失败记录、改运行代码、重跑验证”这件事。直接请一个强模型写补丁,有时能修好,也会把原来能完成的题改坏;固定规则又很难处理新出现的失败。Harness-R1 用单独的 Qwen3.5-9B 学习:当前失败是否可以靠外部代码修正,以及应在动作发出前还是环境反馈后介入。
例如购物模型已经找对商品,却漏选颜色就点击购买。再次让模型思考整道题未必比在购买前检查“必需选项是否选好”更有效。反过来,把所有动作都按一个粗糙的任务阶段重写,也会破坏原本正确的决策。论文要训练工程师学会何时干预、干预到什么程度;补丁是否可执行只是最低要求,真正的训练信号来自安装后的任务结果。
2. Related Work:搜索补丁、诊断补丁与训练工程师
它训练专门的补丁模型,用安装补丁后真实重跑的环境奖励差更新模型。Self-Harness 用同一个冻结模型提出并筛选自己的修改;HarnessFix 先把失败步骤对应到代码,再限定修复范围;直接监督微调(SFT)任务模型则更新做题模型本身。Harness-R1 保持做题模型不变,只训练另一个模型编辑四个预留调用位置。
所以主结果衡量的是“工程师修改运行程序后,冻结的任务模型提高多少”。任务模型先经过 SFT 后,另行训练的工程师还能继续提高分数,说明任务模型训练与外部程序修补可以叠加。WebShop 的训练奖励是连续匹配分,不能把它等同于最终完整任务成功率。
| 相邻方法 | 谁提出修改 | 反馈实际更新什么 | 与本文的差别 |
|---|---|---|---|
| Meta-Harness / AHE | 固定的 coding agent | 候选程序、选择结果与历史记录 | 不靠补丁收益更新提出者的模型权重 |
| Self-Harness / HarnessFix | 固定模型提出或诊断局部修复 | 通过测试筛选、接受补丁 | 学到的产物主要是运行程序,编辑策略本身没有在线训练 |
| HarnessX | 符号化修改与组合组件 | 用 GRPO(组内相对策略优化)更新做任务的模型 | 训练对象不同 |
| Harness-R1 | 独立 9B engineer | 同批任务重跑的奖励差更新 engineer | 但编辑空间是四类预留 hooks,不是任意代码库维护 |
3. Method:一包失败记录怎样变成一次训练更新
工程师只读失败题,但补丁必须在原来整批题上重跑,包括原本成功的题。系统先缓存 target agent 的原始运行和得分,用确定性提取程序留下失败题的要求、关键动作、反馈、结果及必要环境状态。这包证据称为 failure packet;提示词另外说明 hook 接口、可读取字段与限制。它没有人工逐步标注的正确解,也不是工程师自己玩出的新轨迹;公开构造程序拼接的是接口说明与失败记录,不能据此说它附上了完整 Agent 仓库源码。
| 可修改位置 | 何时调用 | 允许改变什么 |
|---|---|---|
on_init | 原 Agent 第一次决策前 | 加入可复用的任务指导或工具提示 |
make_pre_hint | 每次模型决策前 | 根据当前状态补一条提示,不执行环境动作 |
on_before_action | 模型提出动作之后、环境执行之前 | 拦截并要求重选;接口支持时可改写动作 |
on_post_step | 环境反馈回来之后 | 更新运行记录、加入恢复提示;接口支持时安排下一动作 |
这些由运行程序预留的调用位置称为 hooks。工程师一次性输出补丁后就退出,不参加后续购物或 SQL 操作;宿主程序解释补丁的返回值。DBBench v1 只接受提示与拦截,不允许补丁直接改写 SQL 或强制提交数据库操作(论文 Appendix C)。动作发出前检查条件、必要时拦截的这段代码称为 guard,例如必须选好颜色后才允许购买。
补丁是 <patch> 内的 JSON,含 benchmark、description 和 actions。每个 action 指定 add_code_hook、调用位置和定义 hook(ctx, nb) 的 Python 代码:ctx 是宿主提供的当前动作、状态与任务要求,nb 用来保存本次任务的阶段记录。一个补丁可以在这批任务内复用,但论文没有跨批次持续累积补丁,也不在同一 editing instance 里反复修改到通过为止。
训练的“在线”指当前 engineer 会采样新的候选,再真实执行它们;原始基线轨迹、奖励和 failure packet 在训练前已缓存。不能把 Algorithm 1 读成每次更新都重新收集一批未经修补的基线轨迹。
- 冷启动先用 877 个经过安装和重跑筛选的示范补丁做 SFT:WebShop 381、ALFWorld 248、DBBench 248。示范由强模型提出,筛选要求补丁可执行、评测完整且不退化。
- 采样在线训练对同一个 failure packet 生成 8 个候选补丁,分别安装到隔离的重跑中。
- 重跑原 Agent 在每个候选下重新执行完整 batch;无效、没有实际干预或评测不完整的候选记 0。
- 更新比较 8 个候选的得分差,将组内相对好坏交给 GRPO,只更新写补丁的 engineer。
r(B,P) = ΔB(P),若补丁有效且评测完整;否则为 0
n 是整批任务数,R⁰ 与 Rᴾ 是同一道题修补前后的环境奖励。WebShop 使用连续的商品匹配分,ALFWorld 与 DBBench 使用二元成功分。有效补丁若造成退化,可以得到负奖励;“格式正确”本身没有奖金。GRPO 再用 (r−组内均值)/组内标准差 得到候选优势,同一补丁的输出 token 共用该优势。
实现对 token 的新旧策略概率比使用非对称裁剪:ε_lower=0.20、ε_upper=0.28,对应裁剪区间 [1−0.20, 1+0.28]=[0.80, 1.28],不是把概率比裁到 0.20 与 0.28 之间。训练引擎与采样引擎的旧策略概率可能不同,所以另有截断重要性权重,最大为 2。没有显式 KL 或熵奖励。冷启动用 GPT-5.5 生成并筛选的 877 例训练两轮;在线训练用约 1,500 个 failure packets。工程师 SFT、工程师 GRPO 与另行比较的任务模型 SFT 各使用一节点 8 张 H800;前两项才是 Harness-R1 的两阶段训练。
| 任务 | SFT 任务池 | RL 任务池 | 验证 / 测试 | 需要注意 |
|---|---|---|---|---|
| WebShop | 5,290 | 5,190 | 100 / 500 | 测试索引 0–499;前后重跑固定 goal seed 233 |
| ALFWorld | 1,380 | 1,280 | 99 / 500 | 测试由 109 个 new_std 加 391 个 train_valid 分层样本组成 |
| DBBench | 2,401 | 2,302 | 100 / 300 | 300 个单独标准测试任务 |
这些是 Appendix D 的独立任务数,分区先于轨迹与补丁生成;SFT/RL 任务不重叠。过滤与组装以后才得到 877 个示范补丁和约 1,500 个 failure packets,不能把记录数量当作任务池大小。
这个奖励直接针对产生 failure packet 的同一 batch 优化,论文称为 transductive objective:模型可以利用这一批已发生的失败,训练目标没有单独要求另一批题也提高,也没有惩罚额外推理成本。
4. Experiments:购物案例、评分分母与未见任务迁移
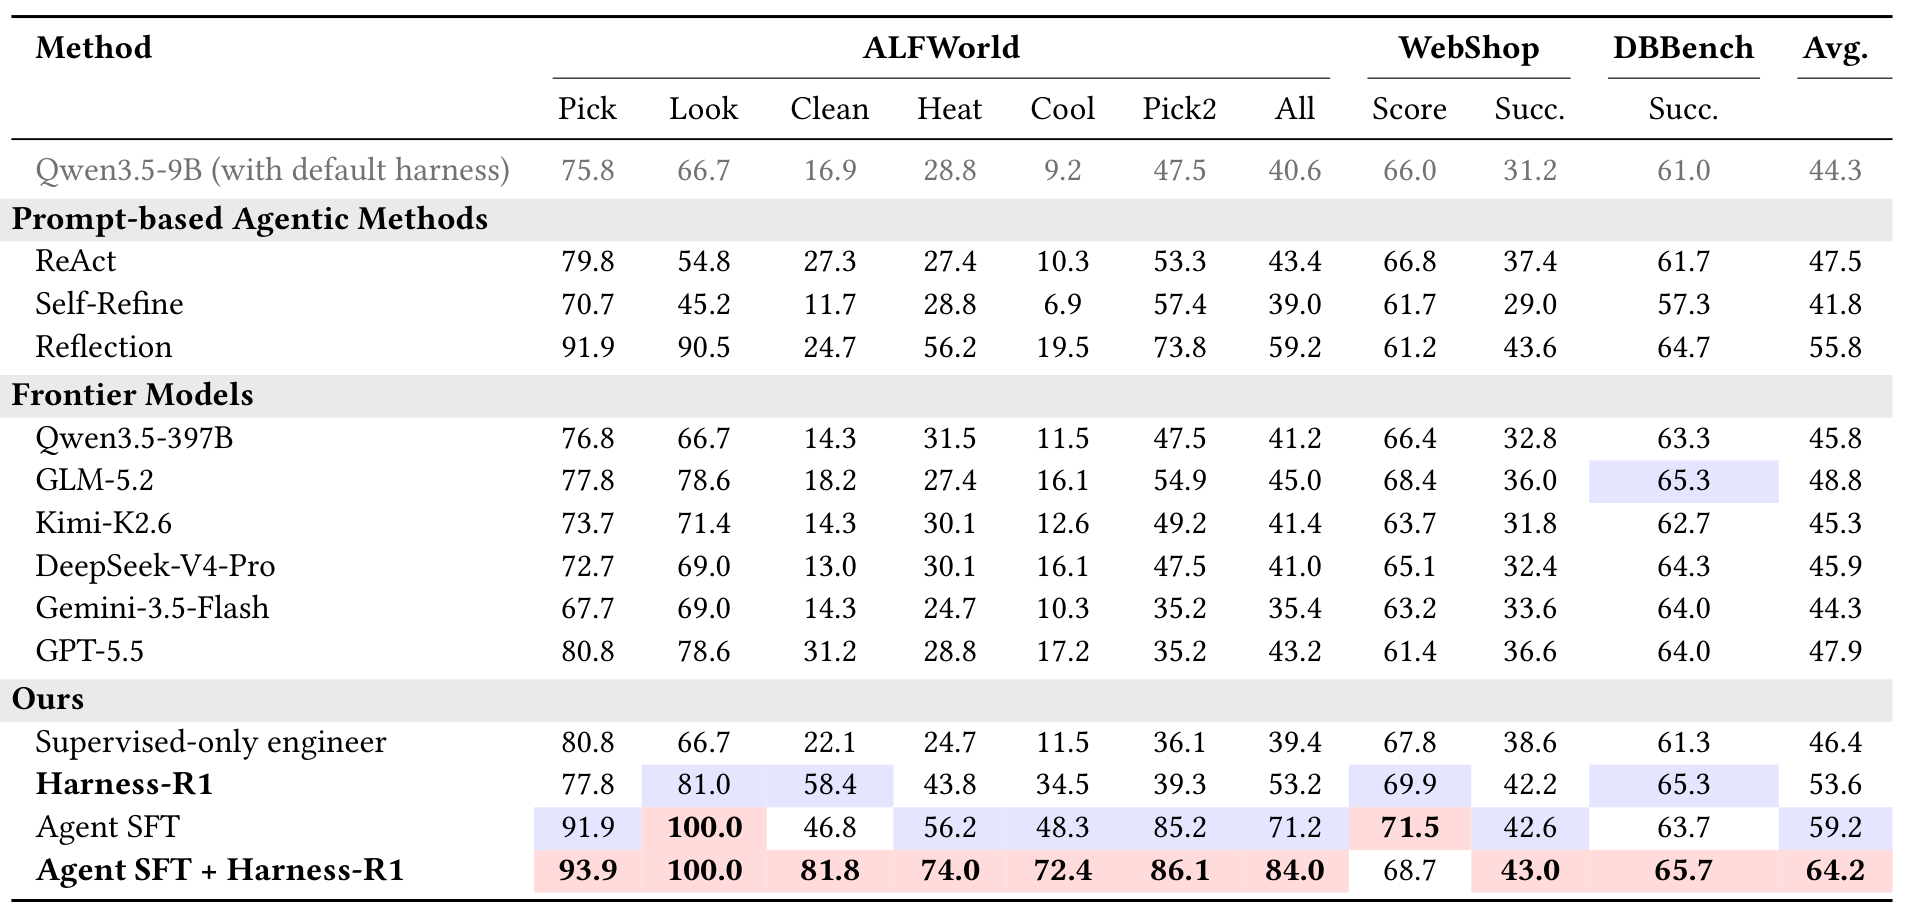
训练奖励与主榜成功率不是同一个指标。主榜分别在 WebShop 500 题、ALFWorld 500 题、DBBench 300 题上算任务成功率,再对三项成功率等权平均;不是把 1,300 题混成一个平均值。WebShop 另外报告连续 Score。以原系统为例,(31.2+40.6+61.0)/3≈44.3%(Table 1)。Reflection 行允许两次尝试,其他行是单次成功率,不能直接按同预算排名。
真实 WebShop 案例:先选颜色,再允许购买
- 初始任务:购买价格低于 40 美元的 synthetic hairpiece(人造发片),颜色必须选择页面上的
black brown(黑棕色)选项。 - 原始轨迹:target agent 找到合适商品,却没有选择颜色就执行
Buy Now(立即购买);环境只给 0.667 的部分奖励。 - 补丁:harness engineer 在
on_before_action安装前述 guard。只要价格超预算,或任务要求的商品选项尚未选择,它就拦截购买动作。 - 重跑:target agent 再次尝试提前购买,guard 返回提示;Agent 随后选择 black brown,再购买。
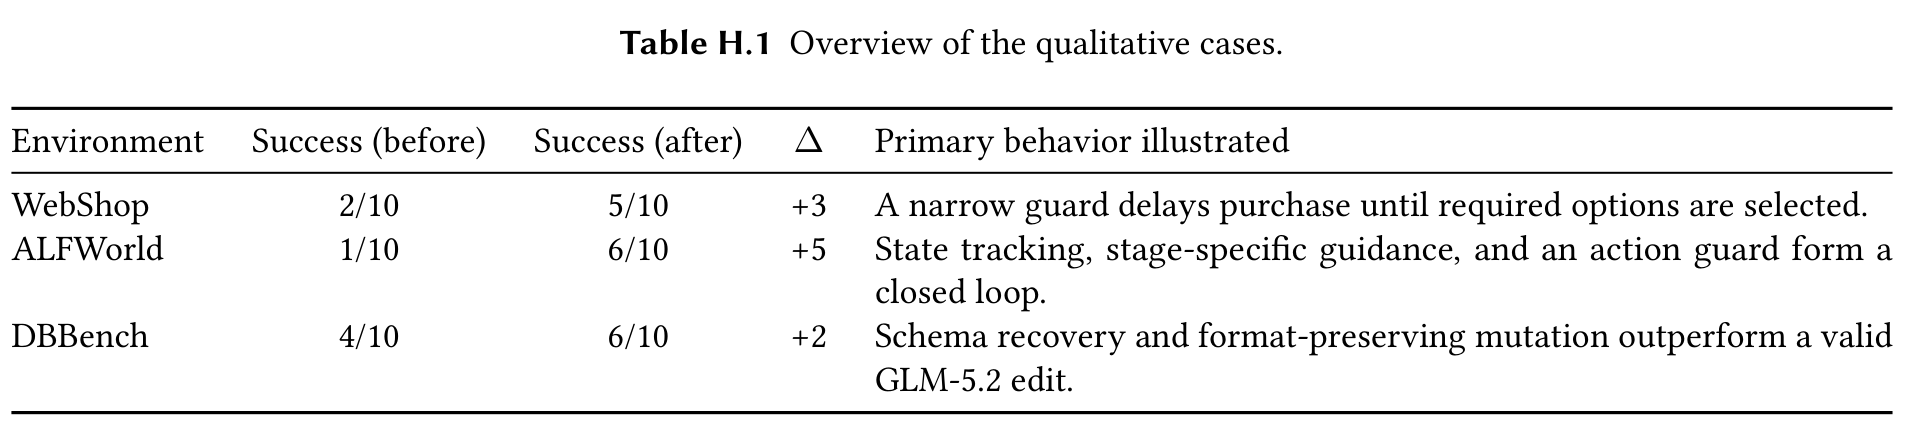
- 结果:同一道题从 0.667 变成 1.0;同一十题批次的完整成功数从 2/10 增至 5/10,原先已成功的两题没有退化。
这是论文 Appendix H.1 的 WebShop batch 008。连续奖励的批均值实际由 0.682 到 0.768,因此该补丁的训练奖励是 0.768−0.682=0.086,不是完整成功率差 5/10−2/10=0.3。公开记录足以复核这一计算,但没有给出十题所有商品属性和 WebShop scorer 的逐属性分解,不能把 0.667 擅自解释成“恰好通过三条要求中的两条”。
ALFWorld 的补丁记录任务进行到哪一步、给出下一步提示,并阻止把物体放到错误位置。十题批次从 1/10 提到 6/10:它修好六条失败,同时让唯一一条原本成功的任务退化,净增加五条成功。Gemini 的另一组补丁则把 ALFWorld 从 41.6% 降到 35.4%;最差批次 7/10→0/10,原因是过早强制放置第一个物体,破坏了需要收集两个物体的正确行为。
DBBench batch 022 更能说明谁在执行。任务要求修改 Race Schedule 表中 Moosehead Grand Prix 的长度。原 Agent 已看到旧值 3 Hours,却写 4 hours;GLM-5.2 的有效补丁也没有避免这个错误。Harness-R1 的 hook 先提醒恢复表结构、检查当前行,再由冻结的 target agent 生成 SQL,写成大小写一致的 4 Hours,核对后提交。论文的精确格式判分把前两者记失败、后者记成功;批次分别是 4/10、5/10、6/10。这里没有发布这条完整 SQL checker 的逐步重放,不能补写成 hook 直接修改数据库。
下面是本文写的 Python 3 简化示意,说明宿主如何使用购买前 hook 的返回值;不是 batch 008 原补丁。真实公开的购买拦截见 held-out seed 20260720 的补丁,它属于另一组实验,只检查未选选项,不含 batch 008 所述的超预算条件。
def hook(ctx, nb):
    action = ctx["action"]
    if action["tool"] != "click_action":
        return None
    if action["value_normalized"] != "buy now":
        return None
    if not ctx["predicates"]["required_options_unselected"]:
        return None
    return {
        "kind": "block_and_prompt",
        "message": "Select the requested visible option before buying."
    }
required_options_unselected 是宿主对当前页面和任务要求检查后的布尔值;为真时,宿主取消这次购买,把 message 交给 target 重新决策。工程师不直接选择某个商品,也不直接完成购买。这个示意只展示返回效果,没有运行整个 WebShop 环境或证明某条新轨迹会成功。
4.1 主结果与稀疏失败迁移:用的是两种平均方式
在三个训练环境上,未经任务微调的 Qwen3.5-9B 从 44.3% 提到 53.6%,增加 9.3 个百分点;target 先 SFT 后再修 harness,则从 59.2% 到 64.2%。监督训练工程师为 46.4%,最强一次性编辑器 GLM-5.2 为 48.8%。但 target 先 SFT 后,WebShop 连续 Score 从 71.5 降到 68.7,说明“平均成功率提高”不等于所有指标都提高。
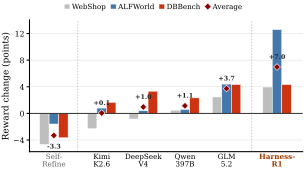
20 个未参与训练的 target 配置各提供自己的失败记录,工程师重新生成补丁,不是迁移一个固定补丁。各模型的三环境平均增益都为正,平均提升 7.06 个百分点;包含训练 target 的 21×3 个配对中有 56 个改善、4 个不变、3 个下降。
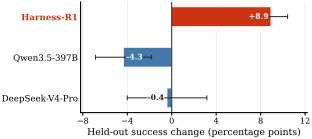
未见任务实验采用另一种平均:每个环境只给相同的 10 条失败,生成一份环境专用补丁,评测其余 490+490+290=1270 题,按题数合并计算增益,不再三环境等权。三个证据种子的成功数分别为 550→656、550→685、549→648,所以 (106+135+99)/3/1270×100≈8.92 个百分点;±1.50 是三个种子增益的样本标准差,不是逐题标准误。
公开 seed 20260720 中,ALFWorld 修好 102 条失败、改坏 59 条旧成功,净增加 43/490。这个结果支持平均迁移收益,不能说补丁保住了每一条旧能力。相同协议的 Qwen3.5-397B 与 DeepSeek-V4-Pro 平均变化分别为 −4.3±2.5、−0.4±3.6 个百分点。
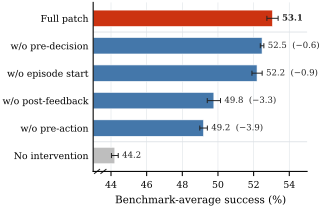
固定补丁、分别关闭某个调用位置的消融中,移除动作前检查的平均成功率下降 3.9 个百分点,移除环境反馈后的状态记录与恢复提示下降 3.3 个百分点;不同环境的下降幅度并不一致,不能把它们相加成固定的组件排名。
5. Discussion:补丁能否保住未见任务和运行成本
最需要补的对照,是同一补丁在另一批任务上的得分与代价。现在的在线奖励可以发现局部有效的修改,却没有区分“修好了通用行为”与“适配了眼前十题”。可在奖励里加入未参与失败提取的回归集,并报告额外模型调用、动作数和运行时间;这样才知道工程师是否靠反复提示换分。已有迁移测试仍沿用相同 hook 接口,不能代表能维护任意 Agent 代码库。
官方仓库固定到 94f2e087f573e1b82fc9568bb634d4ae9a887e28,模型权重也已公开。复现时还要固定上游环境、任务 split 与补丁接口,不能只复用一个模型文件。
6. Conclusion:学到的是外部干预,不是任务模型的新权重
Harness-R1 把可执行补丁的实际后果变成工程师模型的训练信号。证据表明专门化工程师比通用模型一次性编辑更稳定;但同批奖励仍可能鼓励局部修补,尚不能证明它学会了普遍的软件维护能力。
主要来源:arXiv:2608.02276v1 全文与附录;2026-10-20 复读 22 页并核对原图、表格。官方代码固定版本:94f2e087f573e1b82fc9568bb634d4ae9a887e28。原图裁切范围见站内来源说明。
留言