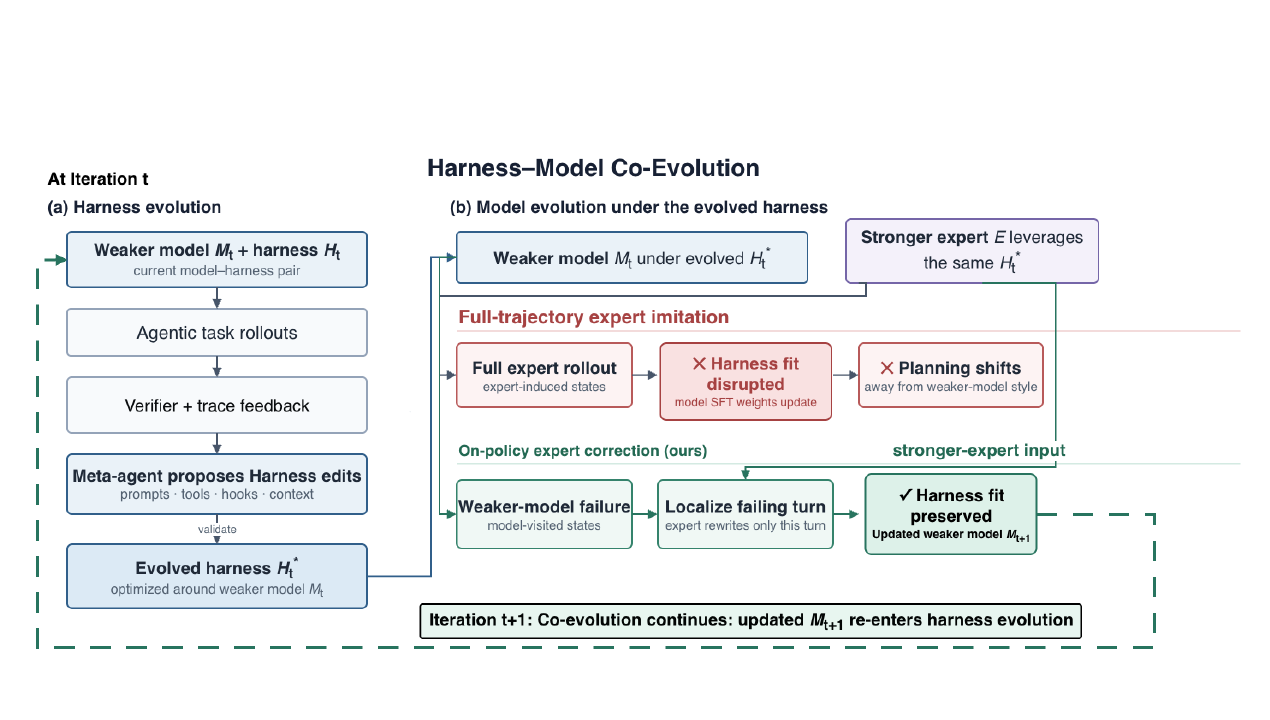
这篇论文抓住了一个很容易被忽略的顺序问题:团队先围绕弱模型演化出一套好用的 harness,再用强模型的成功轨迹微调弱模型,结果可能更差。Qwen3-Coder 在 evolved harness 下原本达到 78.0%,完整模仿 Gemini 后降到 63.1%。作者改为保留 Qwen 自己的 rollout,只让 expert 重写其中第一个错误 turn,最终得到 79.7%。
Q1. 为什么强模型的成功轨迹会把弱模型教坏?
因为 evolved harness 已经适配了弱模型原有的 planning cadence,而完整 imitation 同时改了知识和规划风格。 强模型能在更少的中间检查下直接执行,也更早提交答案。弱模型会模仿这种 terse(少解释、少检查)、answer-early(更早提交答案)的轨迹,但未必同时获得支撑这套节奏的执行能力。
这和普通 SFT 的直觉正面冲突。Gemini 在 Qwen 的 h* 下能达到 93.6%,显著高于 Qwen 的 78.0%,看起来是一位合适的 teacher。但 h* 的 prompt、tool、hook 与执行顺序,是根据 Qwen 的失败记录逐步改出来的。完整 imitation 改变了 Qwen 的 planning distribution,也就是它通常会访问哪些 states、何时检查、何时提交。结果是脚手架还在,模型的动作节奏却变了。
论文用一个必要的 control 支持这个解释:同样的 expert-imitation recipe 放回未演化的 h0 后,Qwen 从 29.2% 升到 35.5%。Expert trajectory 在普通 harness 下有正收益;它与已经适配 Qwen 的 h* 组合时,才出现明显退化。
Q2. 它和联合优化、Harness-Zero、普通 on-policy imitation 有什么区别?
这篇论文研究的是“先演化 harness、再更新模型”时,模型与 harness 能否继续配合。 它不移除 evolved harness,也不证明 correction 能跨到另一个 action space。部署产物仍是 corrected Qwen 加上原来的 h*。
| 路线 | 训练时改变什么 | 部署时保留什么 | 与本文的边界 |
|---|---|---|---|
| Meta-Harness / Better Harnesses | 搜索 prompt、tool、hook 与 control flow | 固定模型 + evolved harness | 提供上游 harness evolution;不更新模型权重。 |
| Co-Harness / WHALE / HarnessForge | 交替或联合优化 harness 与 weights | 最终 model-harness pair | 证明两者可协同;本文专门隔离 full imitation 引起的负迁移。 |
| 普通 on-policy expert correction | 在 student 访问到的 state 上请 teacher 接管或续写 | 模型 + 固定 interface | 本文把同一思想放进 model-specific evolved harness,目标是保住 pair fit。 |
| Harness-Zero | 把 source-harness 行为转成 target-harness 有效动作后训练模型 | 模型 + 更小的 target harness | Harness-Zero 要移除 specialized source harness;本文始终保留 `h*`。 |
| Grow the Harness | 把重复控制写进可执行代码 | 固定模型 + specialist harness | 与本文部署立场接近,但它主要优化可复用代码,不做 model correction。 |
论文给出的关键反例是:teacher 更强、trajectory 全部成功、格式已经转换正确,student 仍然可能因为 planning shift 而退化。 这比笼统地说“on-policy 比 off-policy 好”更有信息量。
Q3. Harness 怎样演化,correction 数据又是怎样造出来的?
3.1 七类任务和 harness evolution
作者沿用 Yang et al. (2026) 的七类 enterprise tasks:payroll attendance audit、budget approval、stock alert、IoT anomaly detection、Playwright browser automation、website management 和 code refactoring。论文称这些任务有客观 verifier,但没有在本文重新列出每个 split 的任务数、逐任务 checker 或原始 task package。
作者对上游环境做了两处修改:在涉及 MCP tool 的任务中,Agent 必须通过工具访问数据,不能直接修改 task database;tool-call errors 也会交给 harness optimizer。论文因此提醒,本文绝对分数不能直接与 Yang et al. 的原结果比较。
每个任务单独演化 harness,过程如下:
- 1 · ROLLOUTQwen 在当前 harness 下执行 task minibatch。
- 2 · FEEDBACKVerifier verdict、trace 与 tool errors 交给 optimizer。
- 3 · EDITGemini meta-agent 修改 prompt,也可增删 tool 或 hook。
- 4 · VALIDATE只有 minibatch performance 提升的 edit 才进入 Pareto pool。
- 5 · SELECT三 seed、每 task $20、单 rollout 600 秒;按 validation score 选 `h*`,同分取较早 iteration。
Training 和 validation split 用于 harness 与 model optimization,test split 保持 held out。主表报告 test success 的三次运行均值与 SEM。
3.2 Full imitation 数据怎样构造?
作者先收集 Gemini 在 h* 下 reward=1.0 的完整成功轨迹,再加入 Qwen 自己的成功轨迹,转换成 Qwen 的 chat/tool-call 格式后做 LoRA-SFT。主实验对三次独立 LoRA seed(0、101、202)取平均。
训练配置是 rank 16 或 64 取较好结果、2 epochs、learning rate 1e-4、bf16、effective batch size 8。默认 sequence length 为 49,152 tokens;当超过 5% 训练样本被截断时,作者再训练一个 98,304-token 版本。Adapter 合并为约 57 到 61 GB 的 dense checkpoint,在两张 H200 上推理;论文称一次训练少于一小时。
3.3 On-policy correction 数据怎样构造?
作者改从 Qwen 在 h* 下的失败 rollout 出发。自动化的 failure localization 先找到第一个错误 turn;Gemini 看到 task instruction、截至该 turn 的 trajectory 和失败 checkpoint,然后只输出“一句修正策略 + 修正后的 tool call”。每个 turn 采样 N=3 个候选,再由另一个 quality judge 留下一个。
# Article reconstruction from Appendix B, not official code.
def make_training_example(student_rollout, failed_checkpoint):
    turn = failure_localizer.first_wrong_turn(
        rollout=student_rollout,
        checkpoint=failed_checkpoint,
    )
    candidates = [
        expert.rewrite_only_this_turn(
            task=student_rollout.task,
            prefix=student_rollout.before(turn),
            failed_checkpoint=failed_checkpoint,
        )
        for _ in range(3)
    ]
    correction = quality_judge.select_best(candidates)
    return student_rollout.replace(turn, correction)
最终训练集约 500 rows:约 400 条 single-turn correction,加上约 50 条 Qwen 自己的 passing rollout;后者优先挑能力边界附近的样本,也就是同一任务有时成功、有时失败的 capability-boundary examples。论文没有解释这些约数之间剩余的差额,也没有公开 localizer prompt、quality judge 身份、筛选 rubric 或 corrected trajectory 的重新执行率。
3.4 两条 case 具体发生了什么?
Case 1:Payroll audit,算对了却没提交
- 上游 task 要求完成 payroll aggregation。`h*` 明确写出 employee-level aggregation、department mean-of-means、ceiling-then-multiply payroll 和 rounding。
- 原始 Qwen 按“compute → verify once → finish”执行,同一 example 的三条 rollout 都在 14 到 20 steps 内得到 1.0。
- SFT-imitation 后的 Qwen 仍写出了正确 department aggregates,说明 domain recipe 已学会。
- 它随后把一次 verify 变成循环:同一 view 发出 29 次、prompt 约重读 20 次,78 steps 内始终没有调用 finish,因此 task verifier 给 0。
Case 2:WebArena,351 不是 346
- 问题询问 Magento Admin 中 Approved reviews 的总数,ground truth 是 346。
- `h*` 给出明确过程:找到 status column,筛选 Approved,读取 filtered total,再通过 structured finish 返回。
- 原始 Gemma 会执行 filter-then-count,并返回 346。
- SFT-imitation 后的 Gemma 进入 review grid 后直接读取未筛选的 “351 records found”,跳过筛选并提前提交 351。
这两条是作者挑选的解释性 rollout,不是随机 error sample。论文没有公开原始日志和 checker code,本文只能核对 Appendix D 的叙述,不能独立重放。
Q4. 实验结果到底证明了什么?
4.1 主结果:harness 很强,完整 imitation 七项全退
Qwen 从 h0 的 29.2±0.61 升到 h* 的 78.0±0.97,说明 harness evolution 是主要增益来源。Gemini 也能使用这套为 Qwen 演化的 harness,从 84.4±0.85 升到 93.6±0.46,证明 h* 不只是 Qwen 能触发的一组脆弱提示。
问题出现在权重更新。Qwen 在 h* 下做 full imitation 后降到 63.1±0.81,七项任务全部下降,范围是 −4.2 到 −29.9 个百分点。On-policy correction 则达到 79.7±0.67:五项上升,Attendance 与 Budget 分别 −0.4、−0.6,作者将其视为接近饱和条件下的噪声范围。
4.2 机制证据:knowledge 上升,planning fit 下降
Full imitation 后,domain-computation recipe 的使用率从 30.8% 升到 76.1%,implicit-knowledge failures 从 46.2% 降到 44.5%。但 planning failures 从 1.1% 跳到 14.6%。On-policy correction 把 planning failures 保持在 1.8%,同时把 knowledge failures 降到 43.2%,总体 failure rate 也从 28.9% 降到 26.8%。
这组证据与“planning-style drift 破坏 model-harness fit”一致,但仍属于行为归因。Failure category 由 LLM classifier 判定,论文没有人工 agreement、judge model、prompt 或 confusion matrix,因此不能把 14.6% 当成无争议的人工诊断。
4.3 Gemma replication 排除了什么?
作者在 WebArena task 上把 weak model 换成 Gemma-4-26B-A4B。Harness evolution 让它从 46.7% 升到 55.6%;Gemini 使用同一 harness 时从 71.1% 升到 81.1%;Gemma 做 full imitation 后降到 41.1%。这说明退化不只出现在 Qwen-Gemini 组合里,也难以只用表面输出 style 不同来解释。
它没有排除更多因素:Gemma 只测了一个 task,仍使用同一个 expert 和同一套 LoRA recipe,也没有比较 DAgger、RL、KL regularization 或不同 correction 粒度。
Q5. 对 Claude Code、Codex 这类完整 harness 有什么启发?
最直接的结论是:升级模型权重后,旧 harness 需要重新做 compatibility regression。 一个为 Claude Code 某个版本调出来的 tool policy、sub-agent 分工、retry hook 或 context compaction 规则,不一定能原样适配下一版模型。模型更强也不保证它会按旧 scaffold 预期的节奏走完任务。
第二,收集训练数据时应优先保留 learner state distribution。对真实 coding agent,可以先运行当前模型,定位第一处导致后续失败的 decision,再让更强模型只修这一步。这样产生的数据更接近学生部署时会遇到的 repository state、tool output 和 context history。
第三,“用了 harness 组件”不等于“与 harness 配合正确”。 本文的 imitation model 更频繁使用 domain recipe,却更容易在规划上失败。监控系统至少要同时看 task success、tool/hook adoption、planning loops、finish behavior 和未完成原因。
如果把这篇论文扩展到 Claude Code / Codex,我会补四个实验:用同一组 repo-level sealed tasks 比较 base、full imitation、single-turn correction 和 short-window correction;在模型版本升级前后交叉测试旧 harness;由人工复核 first-failure localization;最后把 corrected turn 重新放回真实环境执行,确认后续 trajectory 仍然成立。
Q6. 最后怎样评价这篇论文?
它给出了一个很有价值的负结果:成功 expert trajectory 也可能是错误的训练单位。 围绕 78.0→63.1 的异常,作者补了 baseline-harness control、第二模型家族、模型是否采用新增 harness 规则的统计、failure composition 和两条可读的 rollout case。证据链比单纯提出一种新 SFT recipe 完整得多。
需要保留的限制也很明确:
我的判断是:这篇论文应该和 Harness-Zero、Multi-Harness RL 一起读。 Harness-Zero 问怎样把行为带离 source harness,Multi-Harness RL 说明混合多个 harness 不会自动产生 portability,而本文指出即使继续使用同一个 evolved harness,粗暴的完整轨迹模仿也会破坏兼容性。三篇合起来,把“训练数据来自哪个 runtime、保留了谁的 state distribution、部署时还剩哪个 harness”这三个问题分开了。
来源与授权说明:论文为 arXiv:2609.09134v1,arXiv 页面标注 CC0 1.0。本文直接引用 Figure 1 并注明来源,其余图表均根据 Tables 1-3 与 Appendix D 数据重绘。论文 PDF、arXiv metadata 与公开代码链接于 2026-09-29 核查;未找到本工作的官方代码或数据发布。
留言