01 · PAPER IN ONE PAGEYu et al. · arXiv:2609.09134v1

为弱模型调好执行程序后,模仿强模型的完整记录反而可能变差

Harness 是调用工具、管理上下文和检查提交的外层程序。为 Qwen 调好的版本记为 h*;Qwen 在它上面达到 78.0%,完整模仿 Gemini 后降到 63.1%。

作者改用 on-policy correction:从 Qwen 自己的失败记录出发,只替换定位到的一个错误回复及工具调用,其余记录保留。微调后仍用原 h*,平均成功率达到 79.7%。

29.2→78.0演化执行程序
78.0→63.1完整模仿专家
78.0→79.7局部修正学生记录
9.7/10博客作者个人兴趣程度
来源:论文 Abstract、Table 1、Appendix B-D。
02 · PART 0学生 · 专家 · 演化程序 · 验收程序

谁执行任务、谁改程序、谁造训练记录、谁验收?

STUDENT

Qwen3-Coder

主实验是 Qwen3-Coder-30B-A3B。它执行任务,产生 rollout(一次任务的完整记录),也是 LoRA-SFT 的训练对象。

EXPERT

Gemini

Gemini-3.1-Pro-Preview 提出程序改动,也生成完整专家记录或单次回复的 correction(修正)。

H*

演化后的 harness

根据 Qwen 失败改提示、工具、hooks(调用前后的处理逻辑)和上下文;验证集选出的最佳版本叫 h*。

VERIFIER

任务验收程序

任务执行成功给 1,否则给 0。训练和验证可用于优化,测试集不参与;具体 checker 未公开。

来源:论文 §3.1、Appendix A-B。LoRA-SFT 只训练少量附加参数,再合并回模型。
03 · MOTIVATION强专家的成功记录未必适合直接教学生

Gemini 在同一个 h* 上更强;Qwen 模仿它后,七项任务却全部下降

改外层程序29.2→78.0根据 Qwen 的失败改提示、工具和调用规则。
换强专家93.6Gemini 用同一个 h*,平均成功率还更高。
完整模仿63.1Qwen 学专家完整执行步骤,七项全部回退。
失败分析14.6%失败记录中,规划缺陷从 1.1% 升至 14.6%。
局部修正79.7改学生错误回复,保留其余执行记录。
来源:论文 Table 1、Table 3;规划占比的分母是各条件下的失败 rollout。
04 · CONCEPT模型更新后,原程序预期的检查和提交顺序可能改变

作者把模型执行习惯与外层规则的配合,称为 model-harness fit(模型与执行程序的适配)

原始学生执行方式

h* 围绕这种行为调过

  • 把问题拆成具体子任务
  • 在要求的位置调用工具和检查
  • 完成一次验证后明确提交
  • 按学生常见错误调整恢复规则
⇄
完整模仿后的变化

学到规则,也可能改坏执行习惯

  • 说明更短,可能更早作答
  • 跳过原程序依赖的中间检查
  • 或反复验证,始终不提交
  • 计算规则使用增加,成功率仍下降
来源:论文 §3.3.3、Appendix D。以上是作者的机制解释,非独立因果证明。
05 · RELATED WORKwhat remains at deployment?

部署仍保留演化后的执行程序;实验不涉及跨接口迁移

路线优化对象部署产物与本文的区别
Meta-Harness / Better Harnesses执行程序代码模型 + 已演化程序不更新模型权重。
Co-Harness / WHALE / HarnessForge程序与模型权重配合使用的模型与程序联合优化;本文单独检查完整模仿的退化。
On-policy correction学生实际访问的状态模型 + 固定接口本文检查更新后是否仍与原 h* 配合。
Harness-Zero跨接口迁移执行行为模型 + 最小目标接口移除原专用程序;本文仍保留 h*。
Grow the Harness可执行控制代码模型 + 专用程序把重复策略写进代码,不修正模型回复。
来源:论文 §2;Harness-Zero 与 Grow the Harness 的边界由本文按部署产物整理。
06 · ORIGINAL FIGUREFigure 1 · CC0 1.0

共同演化分两步:先改执行程序,再更新模型且保留原有配合
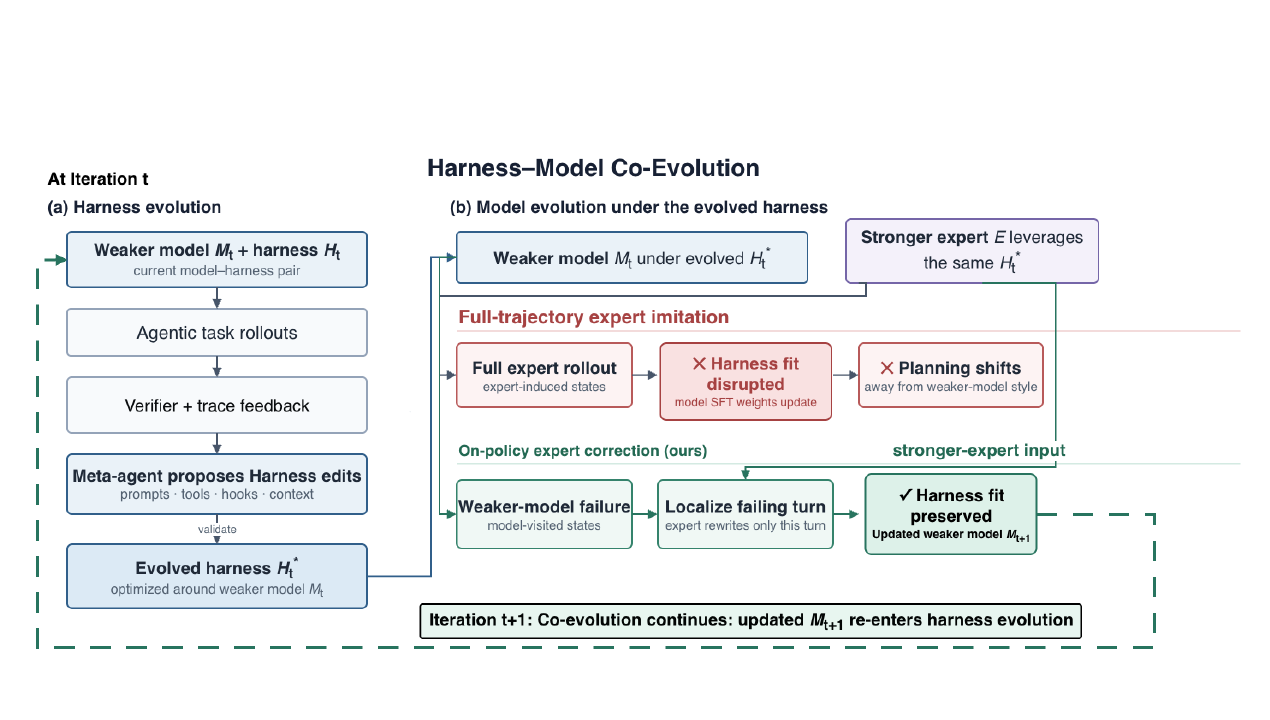
Harness-model co-evolution
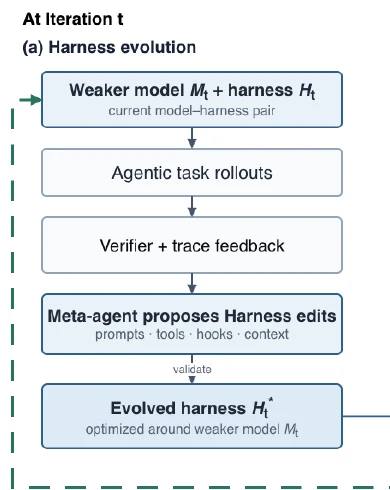
1. 围绕弱模型演化执行程序 · 原论文局部裁切
Figure 1 左侧:任务执行、验收反馈与程序修改
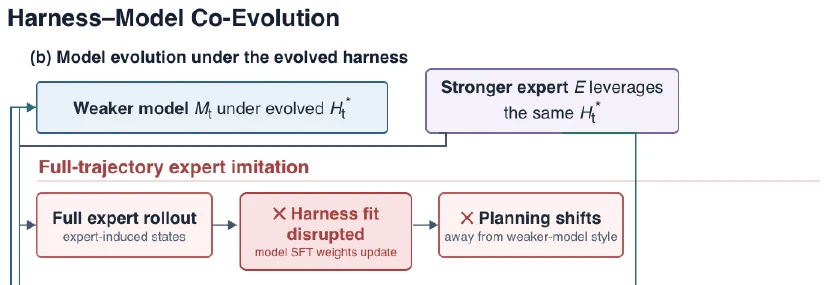
2. 完整模仿打乱原有配合 · 原论文局部裁切
Figure 1 右上:专家完整记录改变模型规划方式
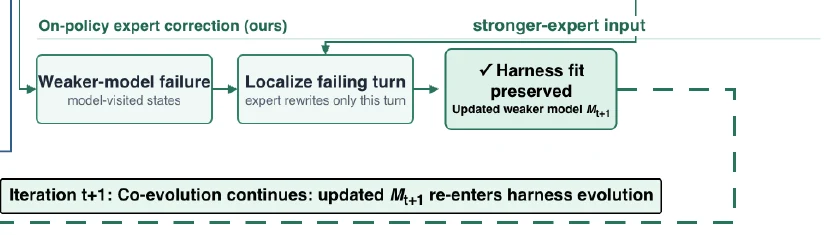
3. 局部修正保留学生状态 · 原论文局部裁切
Figure 1 右下:学生失败记录上的单轮修正
原论文 Figure 1,CC0 1.0;手机端展示标注的原图局部。查看完整原图
07 · TASK PROVENANCEinherited from Yang et al. (2026)

七类企业任务用程序验收;本文没有重新发布任务包

DATA

Attendance + Budget

工资核算与审批协议,依赖聚合规则和受控数据访问。

MONITORING

Stock + Anomaly

枚举低库存项;完成 查询、检测、报告与上传流程。

BROWSER

Playwright + Website

浏览器自动化与 Magento Admin;需要按规定格式提交结果。

CODE

Refactor

代码重构;演化后的程序增加了全局搜索工具。

来源:论文 §3.1、Appendix A。本文未披露各划分的任务数与验收代码。
08 · HARNESS EVOLUTION3 seeds · 每类任务 $20 · 每次执行 600 秒

每类任务单独演化;验证分变好才保留修改

01 · EXECUTEQwen rollout在当前程序下执行一小批任务。
02 · OBSERVETrace + error可读取验收反馈与工具调用错误。
03 · PROPOSEGemini edit改系统提示,也可增删工具和调用前后处理。
04 · VALIDATEPareto pool小批任务的表现上升才保留。
05 · SELECTBest h*选择验证分最高的版本;同分取较早版本。
来源:论文 Appendix A。测试题不参与选择。
09 · SFT-IMITATIONexpert states + student successes

完整模仿同时复制专家的知识与执行计划

COLLECTreward=1先收集 Gemini 在 h* 下的成功执行记录。
MIXself-pass加入 Qwen 自己在 h* 下的 成功记录。
CONVERTchat/tools转成 Qwen 的输入与工具调用格式。
LORA-SFT2 epochsrank 16/64,lr 1e-4,bf16,batch 8。
TEST63.1三个 LoRA 随机种子的平均;七项任务全部下降。
来源:论文 §3.3、Appendix B。Sequence length 49,152 或 98,304。
10 · SFT-CORRECTION学生访问到的状态 + 一个专家重写

只替换学生记录中的错误回复;后续学生内容没有重新生成

01 · 执行学生失败记录Qwen 在 h* 下执行任务,保存模型回复和工具反馈。
02 · 定位定位到的出错 turn定位与失败有关的一次回复;turn 是一次模型回复及工具调用。论文未说明如何保证它是最早出错的位置。
03 · 重写专家生成 3 个候选输入题目、此前记录和失败检查点;输出一句修正策略与工具调用。
04 · 选择质量评分者选 1 个只替换这个 turn,前后学生步骤保持原样。
05 · 微调约 500 条约 400 条修正与约 50 条学生成功记录,最终 79.7%。
质量评分不是环境重跑验收。更改工具调用可能改变后续环境状态;论文未披露修正记录的重新执行比例,不能把约 400 条称为“验证通过的成功轨迹”。
来源:论文 §3.4、Appendix B;约 400 + 约 50 未完全相加到约 500,差额未解释。
11 · PSEUDOCODE本文重建公开协议,不是官方代码

训练样本保留整段学生记录,只把一个回复换掉

# Appendix B 的说明性重建;函数名非官方 API。
def make_example(student_rollout, failed_checkpoint):
    turn = localizer.locate_failing_turn(
        rollout=student_rollout, checkpoint=failed_checkpoint,
    )
    candidates = [
        expert.rewrite_only_this_turn(
            task=student_rollout.task,
            prefix=student_rollout.before(turn),
            failed_checkpoint=failed_checkpoint,
        )
        for _ in range(3)
    ]
    patch = quality_judge.select_best(candidates)
    # 只替换 turn;其余内容保留。此处没有环境重跑。
    return student_rollout.replace(turn, patch)
论文未公开训练仓库、提示、质量评分者或 correction 数据;没有披露修正后重跑比例。
12 · REAL FAILUREAppendix D · Qwen payroll audit

部门汇总算对了,却反复检查,78 步仍没有提交

H* 规则算 → 验 → 交按员工汇总、计算部门均值、按规定舍入,再验证一次并提交。
原始 QWEN14-20 步同一例子的三次执行均得到 1.0。
完整模仿后仍算对了作者描述评分器记录了正确部门汇总。
反复检查29 + ≈20同一视图查看 29 次,任务提示约重读 20 次。
未提交78 步 → 0没有结束任务、提交结果;二元成功分为 0。
来源:论文 Appendix D, Case 1。作者提供叙述,没有公开原始逐步日志。
13 · REAL FAILUREAppendix D · Gemma review count

应先筛选 Approved 再数:346 条;跳过筛选,看到的是全部 351 条
完整模仿造成的两种执行失败Payroll 和 WebArena 两条真实失败记录的手机阅读图
Harness 要求定位 status 列 → 筛选 Approved → 读取筛选后的总数 → 按规定格式提交。
原始 Gemma先筛选再计数,返回正确答案 346。
完整模仿后的 Gemma进入表格后直接读 “351 records found”,跳过筛选并提前提交。
来源:论文 Appendix D, Case 2。图为两条叙述性失败例的重绘,不是原始逐步日志。
14 · MAIN RESULTS7 tasks · 3 runs · mean ± SEM

最大提升来自 h*;局部修正主要保住这项提升,尚未追平专家
Main task success resultsQwen 在原始、演化、完整模仿与局部修正条件下的主结果,手机阅读图
根据论文 Table 1 重绘。Avg 为七项算术平均。
15 · TASK-LEVEL DELTASrelative to Qwen + h*

完整模仿七项全退;局部修正五项上升、两项接近持平
Task-level deltas
任务完整模仿局部修正
Attendance−29.9−0.4
Budget−10.6−0.6
Stock−14.1+2.2
Anomaly−4.2+1.7
Playwright−16.0+1.2
Website−20.3+5.6
Refactor−9.1+2.2

单位:百分点。相对于同一 Qwen + h*,按论文 Table 1 重排;打开完整横向图。

根据论文 Table 1 重绘。论文没有逐任务显著性检验。
16 · MECHANISM EVIDENCE由模型分类的失败记录,非人工 gold label

完整模仿增加计算规则的使用,也增加了规划失败
失败记录中的知识与规划缺陷占比
失败记录的分类占比 · 根据 Table 3 重排
类型原 Qwen完整模仿局部修正
规划失败1.1%14.6%1.8%
知识不足46.2%44.5%43.2%
分母是各条件下的失败记录,非全部任务。查看完整图
计算规则更常使用使用部门计算规则的记录从 30.8% 增至 76.1%;失败记录中知识不足占比从 46.2% 降至 44.5%。
规划失败增加失败记录中的规划缺陷从 1.1% 升至 14.6%;局部修正后为 1.8%。
评分模型根据失败检查点和工具错误分类。论文未公开评分模型、提示、人工一致率或混淆矩阵,不能当作人工确认的因果标签。
来源:论文 Tables 2-3、Appendix C;规则使用率与失败类型占比的分母不同。
17 · EVIDENCE BOUNDARY论文内已测结果与未公开细节

完整模仿回退有多项对照;局部修正数据的有效性仍有未披露处

未发布

训练与任务材料

没有官方训练仓库、任务包、约 500 条修正记录、权重或原始日志。

未披露

选择与重新执行

质量评分者身份、候选选择标准和修正后重跑比例未知;保留的学生后续未重新生成。

净提升有限

+1.7 个百分点

强证据是避免完整模仿的 −14.9 回退,尚未追平 Gemini 的 93.6%。

一次更新

Co-evolution

总图画多轮循环,实验主要验证一次程序演化后的监督微调;不能据此宣称多轮稳定。

来源:全文、Appendices B-C;2026-10-20 核查 arXiv 条目与原文,未见官方发布链接;不排除作者在其他位置发布未链接材料。
18 · TAKEAWAYSfor Claude Code / Codex harness research

权重更新会改变执行习惯;训练后要重新检查与原 harness 的配合

已有证据

完整专家轨迹未必是安全训练单位

在学生自己访问到的失败状态上局部修正,可以保留更多原有执行步骤。本实验仍部署同一个 h*,平均从 78.0% 到 79.7%;不是移除工具或 harness。

下一步如何验证

在完整 coding harness 中做同条件比较

同一批隔离仓库任务上,比完整模仿、单次回复修正和短区间修正;人工检查错误定位,再把修正放回环境重跑。更新模型后,复测工具调用、验证和提交是否仍符合原规则。

个人兴趣度 9.7/10,仅表示博客作者兴趣程度。
核心结论1 / 18