Video2World 给 Agent 一段人或机器人操作的视频,要求它写出一个能在物理模拟器中完成同一任务的程序包。Agent 要恢复场景、物体尺寸、机器人位置,再生成控制动作。机器人必须真的拿起、放下、开合或装配物体,任务完成和画面相似分开评分。
1. Motivation:视频没有自动给出能交互的模拟世界
视频容易采集,但变成能执行的世界仍需要大量补充工作。 场景资源、机器人配置、物体状态与控制程序不会自动从画面里出现。
真实机器人数据集和第一视角人类视频越来越多,里面有完整的抓取、移动、装配和工具使用过程。但一段 RGB 视频不会直接告诉我们桌面坐标、相机内外参、物体 mesh、碰撞体、质量、关节位置,更不会自动给出能让另一台机器人复现动作的控制序列。传统真实场景转模拟器的 real-to-sim 流程要把这些部分逐项补齐,成本高,也很难扩展到大量新场景。
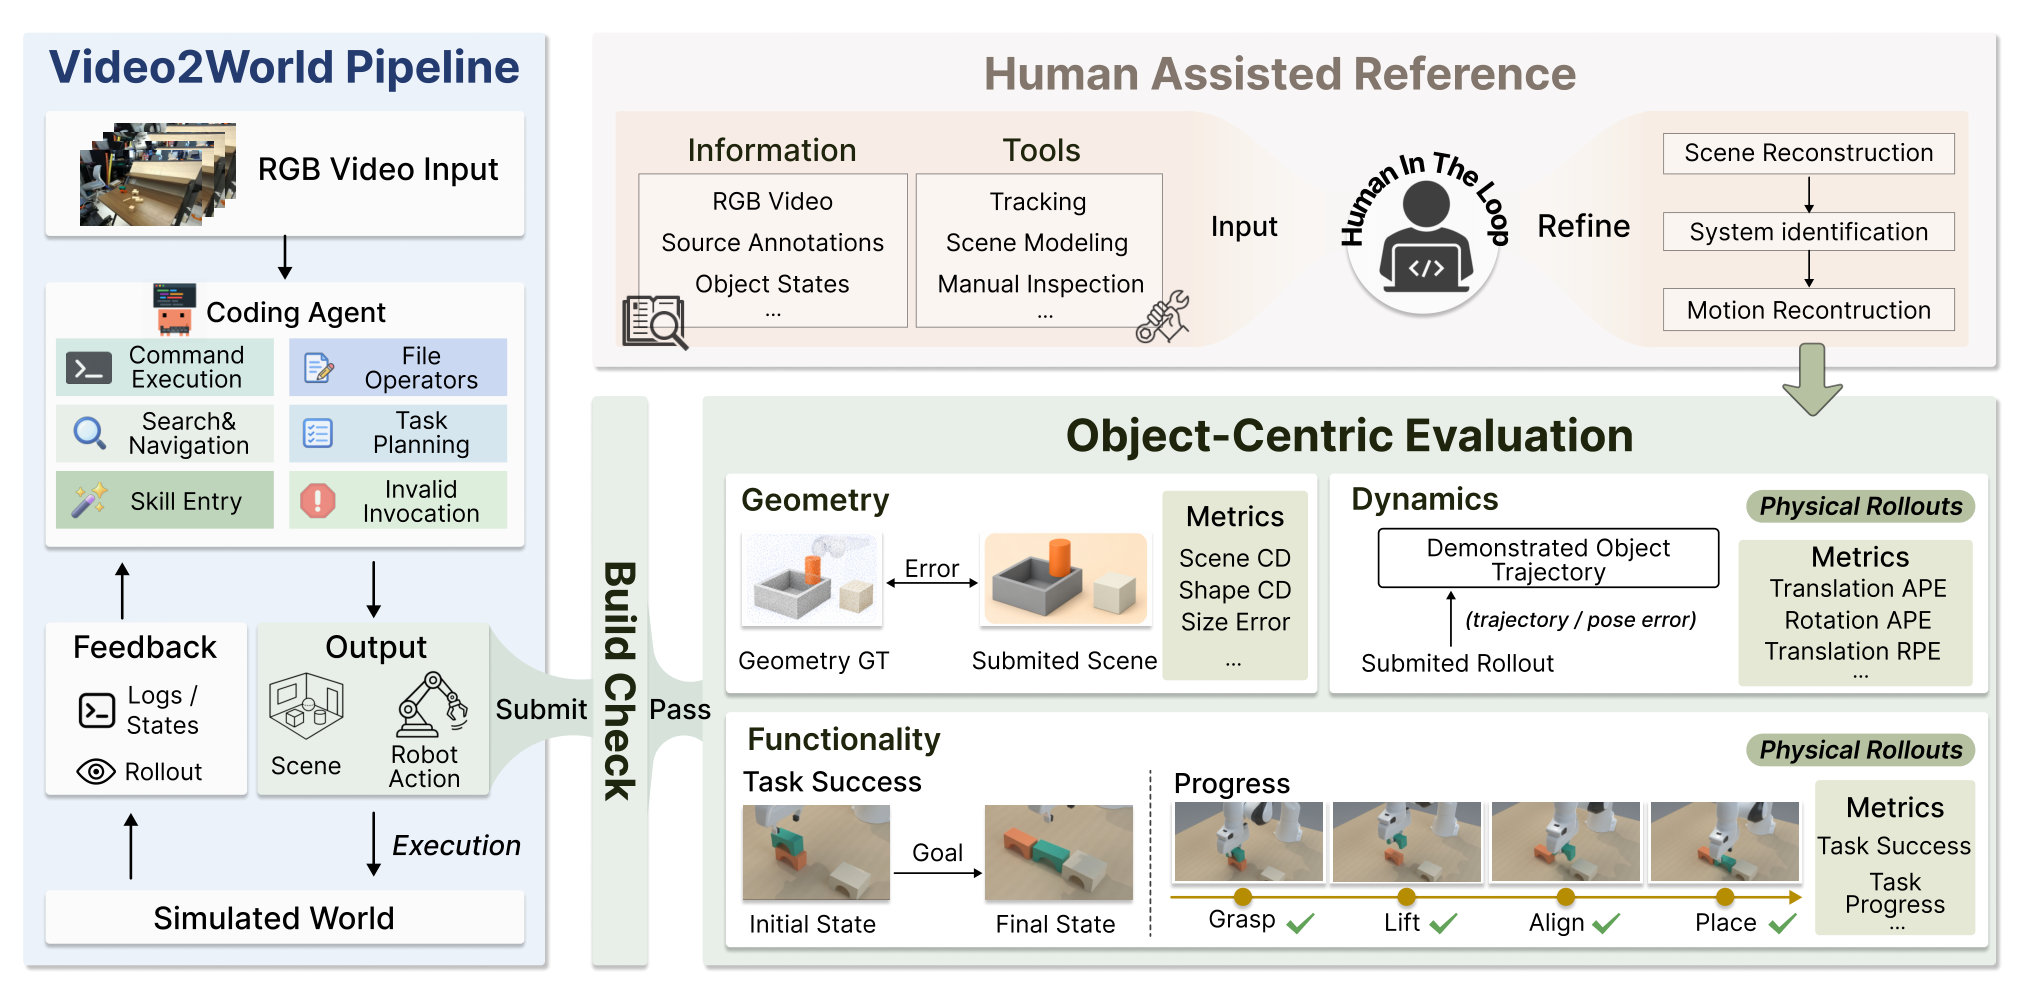
Video2World 的研究问题因此很具体:给 coding agent 一段视频,以及目标模拟器和机器人的公共接口说明,它能不能通过读图、写文件、执行自己的候选重建、观察报错和反复修改,最终交出一个可运行的环境?这同时考查视觉理解、几何估计、3D 资源制作、机器人控制、物理调试和长程工具使用。
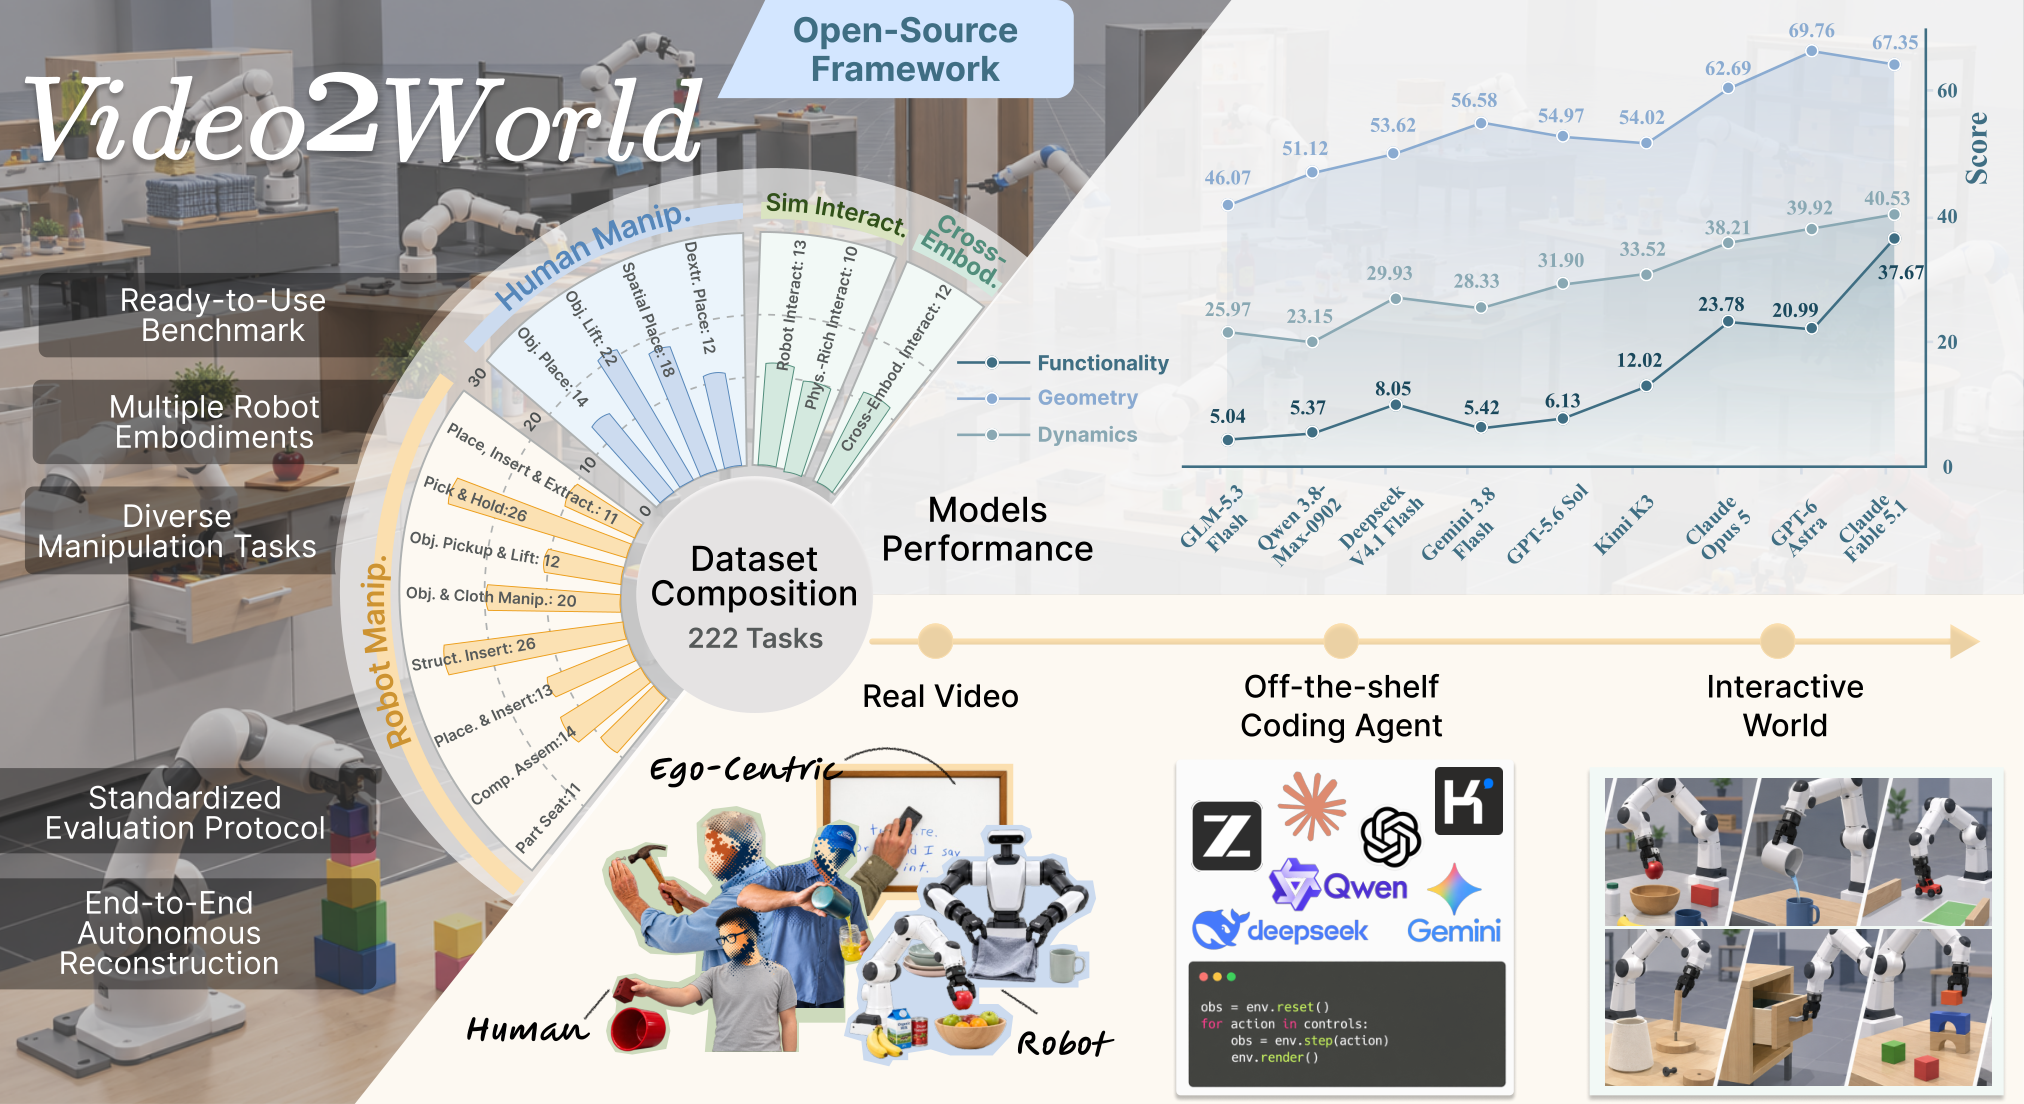
这个 benchmark 同时测“看起来像”和“真的能做”。只测任务成功,Agent 可以用极简几何体甚至取巧完成目标;只测几何,又无法判断世界是否可以交互。Video2World 用功能、静态几何和动态轨迹三组指标区分这些失败。
2. Related Work:视频策略、场景重建与可执行程序
它要求把理解视频、恢复场景和控制目标机器人一起交付。 目标机器人或手的类型叫 embodiment;同一视频换一种 embodiment,会形成不同任务实例。
| 工作 | 输入与输出 | 主要检查 | 与 Video2World 的差别 |
|---|---|---|---|
| Video2Policy | 人类视频 → 机器人动作策略 | 机器人能否模仿任务 | 重点是训练动作策略,不要求代码 Agent 交付完整模拟场景与资源。 |
| Agentic Real2Sim | 真实观察 → 可执行模拟 | 自动把真实场景还原到模拟器 | 问题最接近;Video2World 更强调统一 benchmark、隐藏参考与九套代码 Agent 的系统比较。 |
| BVB | 视频 → Blender 场景 / 构建过程 | 视觉与场景重建 | 主要在 Blender 与视觉结果上评测,不把机器人控制和任务评分作为中心。 |
| SceneActBench | 已有三维场景的视觉观察与操作任务 → 场景操作 | Agent 能否在看到的三维场景里执行指定操作 | 不要求从一段操作视频恢复整个模拟场景和机器人控制程序。 |
| CaP-X | 多模态观察 → 控制机器人的代码 | 代码能否控制机器人 | 侧重控制程序;Video2World 还要求恢复环境几何、相机与对象属性。 |
| EmbodiedSWE | 具身任务与机器人接口 → 可执行控制代码 | 代码在具身环境中能否完成物理任务 | 主要检查控制行为;Video2World 还把场景重建本身作为交付物和评分对象。 |
论文提供了一条完整的 coding-agent 评测链:统一的公开说明、提交格式、simulator runner(负责加载和执行提交的程序)、隐藏参考答案和按任务编写的 judge。结果表同时包含 OpenCode、Codex CLI 和 Claude Code 的原生 harness(给模型提供工具并管理执行的框架)。这些 harness 并不完全相同,因此 Table 2 是 system-level comparison(模型与执行框架整体比较),不能当作只更换模型的排行榜。
3. Benchmark / Protocol:视频、人工参考与隐藏物理判定
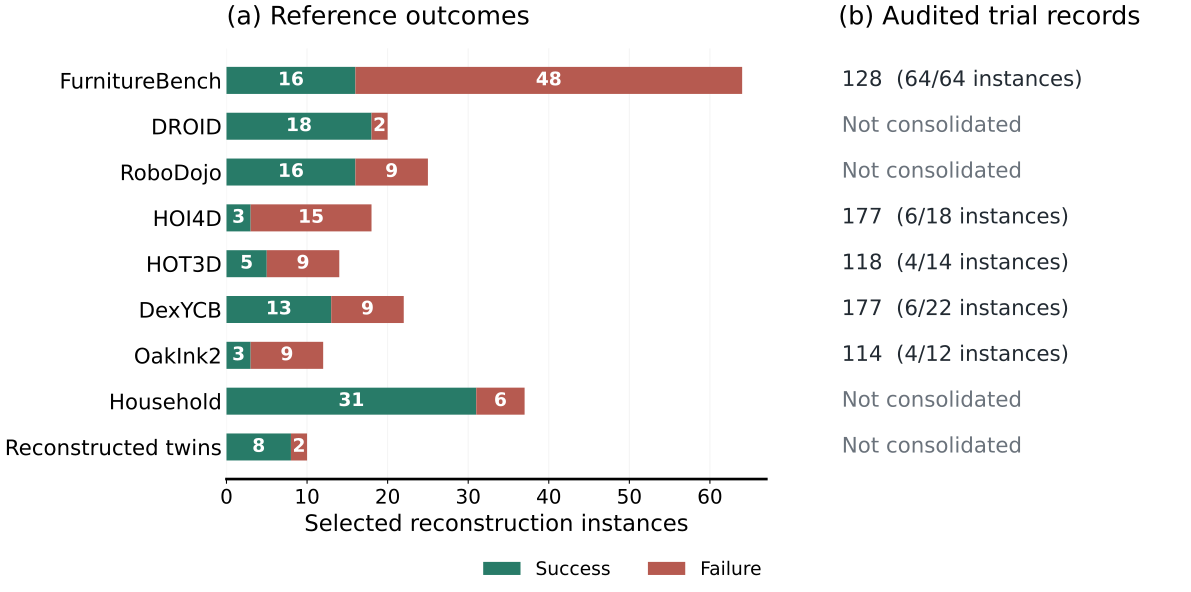
作者把 189 段视频配到目标模拟器、机器人与 end-effector(末端工具),形成 222 个重建实例。 其中 33 段人类视频各配机械臂和 paired-hand(成对机械手)两个版本。附录 Table A8 的来源清单如下,共九组。
| 来源 | 视频 / 实例 | 它补充的任务类型 |
|---|---|---|
| FurnitureBench | 64 个实例 | 家具零件操作与装配 |
| DROID | 20 | 真实机械臂日常物体操作 |
| RoboDojo | 25 | 跨任务机器人示范 |
| HOI4D | 9 段视频 / 18 个实例 | 第一视角的人与物体交互 |
| HOT3D | 7 / 14 | 手部与物体交互 |
| DexYCB | 11 / 22 | 手-物体抓取 |
| OakInk2 | 6 / 12 | 双手物体操作 |
| In-house household | 37 / 37 | 家居操作,目标为 G1 与 Omnipicker 夹爪 |
| Reconstructed twins | 10 / 10 | 真实视频配人工重建的物理目标:平面推动 3、绳索穿槽 5、软玩具装入容器 2 |
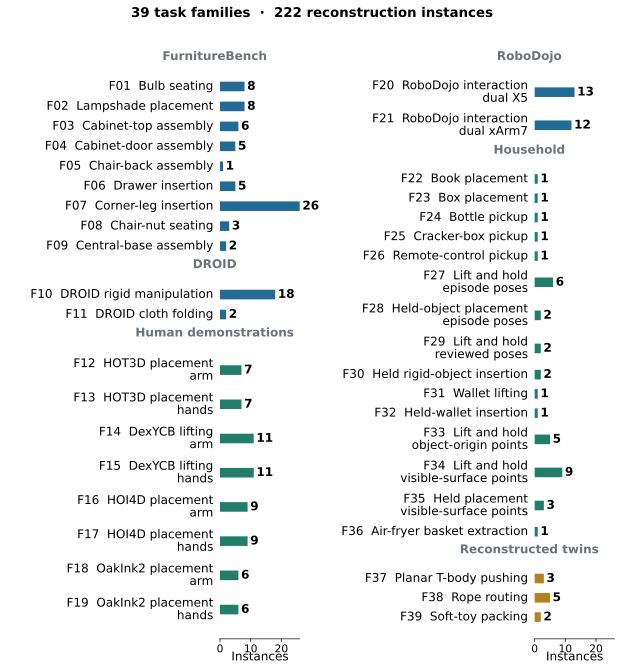
这些视频窗口不是 189 次彼此独立的采集:64 个家具片段来自 46 个原始 episode(一次完整录制),一些人类片段也共享较长的源录制。家具窗口按装配步骤设数量上限,排序时会使用参考执行结果和终态一致性;这是偏向可重建片段的筛选,不是随机抽样。失败的已选参考仍保留。
作者先用源数据构造隐藏标注,再另做人类辅助重建(HAR)。标注记录对象身份、尺寸、初始位置、随时间变化的位姿、目标关系、拿起/松手事件及观测有效区间。FurnitureBench 可用 CAD、相机标定和机器人日志;DROID 需要拟合对象与支撑面;人类视频依赖各源数据已有的对象和相机信息;重建对照组则使用明确注明来源的建模目标。这些额外信息不给被测 Agent,HAR 执行也不是隐藏标注本身。
作者把任务规则与源视频、对象轨迹及物理执行一起复核,检查规则是否接受合理替代动作、拒绝未完成的交互。参考执行失败不会自动使一个标注作废,参考成功也不是样本入选的统一条件。论文没有报告独立多标注者的一致率或完整人工工时;不能把“作者复核”写成已经完成了这些验证。
3.1 Agent 得到什么?
- RGB 视频、分辨率、帧数和播放信息;
- 目标模拟器与机器人的公共说明、资源文件、关节范围和控制格式;
- 终端、文件、图片查看和代码编辑工具;
- 自己候选重建的格式检查结果、执行视频(rendered rollout)和报错。
3.2 Agent 明确看不到什么?
- 参考场景/网格、测量得到的示范轨迹和原始机器人日志;
- 隐藏相机标定、参考控制序列与参考提交;
- 按任务制定的成功条件与评测分数。
3.3 最终交付的 package 有什么?
核心文件是 protocol.json、actions.npy 和 scene.json 或 scene.xml,另加本地 3D meshes、textures(纹理)、source/ 与 report.md。某些机器人/模拟器配置还允许 expected/obj_poses.npy,但它只是 Agent 声明的预期物体轨迹,不能直接驱动物体。物体必须由 robot actuation(机器人控制)与 simulator physics 产生运动;否则任务 judge 和实际执行都不会认可。
评测对象是九套完整代码 Agent 配置。七个模型运行在 OpenCode 1.18.29,GPT-6 Astra 使用 Codex CLI 0.154.0-alpha.6.2,Fable-5.1 使用 Claude Code 2.1.276。每个实例只有一次独立构建 session(可在其中多次修改),没有统一的总工具调用次数上限。
附录 E 给出共同的名义预算:180 分钟、60 美元和最多三次提交,但附录 A.5 区分了落实方式。OpenCode 由 benchmark executor 管理,接受有效提交后立即结束;未显式交付时,按阶段期限保留有效 checkpoint(中途保存的可用程序包),最终生成期限为 165 分钟。两个原生 harness 由外部进程监督,保留各自的终止与候选保存方式,不能说成同一套提交状态机。OpenCode 的 60 美元也是已观测账单阈值,延迟上报曾使一次 Opus 任务达到 61.07 美元。隐藏评分均不给 Agent,最终版本不按隐藏分数挑选。
3.4 程序包如何变成一次物理判定
评测器先检查文件格式并构建场景,再执行控制动作,记录机器人与物体状态。任务规则根据这些真实状态判断成功和进度,几何与轨迹指标另与隐藏参考比较;不是从最后一张截图猜是否完成。
- 1 · 格式检查检查文件结构、资源路径与控制数组是否合法。
- 2 · 构建在 SAPIEN、Isaac Sim 或 MuJoCo 中加载场景与机器人。
- 3 · 执行按
protocol.json的时间步执行actions.npy。 - 4 · 判定按任务规则检查接触、支撑、释放、姿态与静止状态。
- 5 · 比较在参考时间戳上计算几何误差与绝对/相对位姿误差。
3.5 真实案例:把横放的小瓶立起来
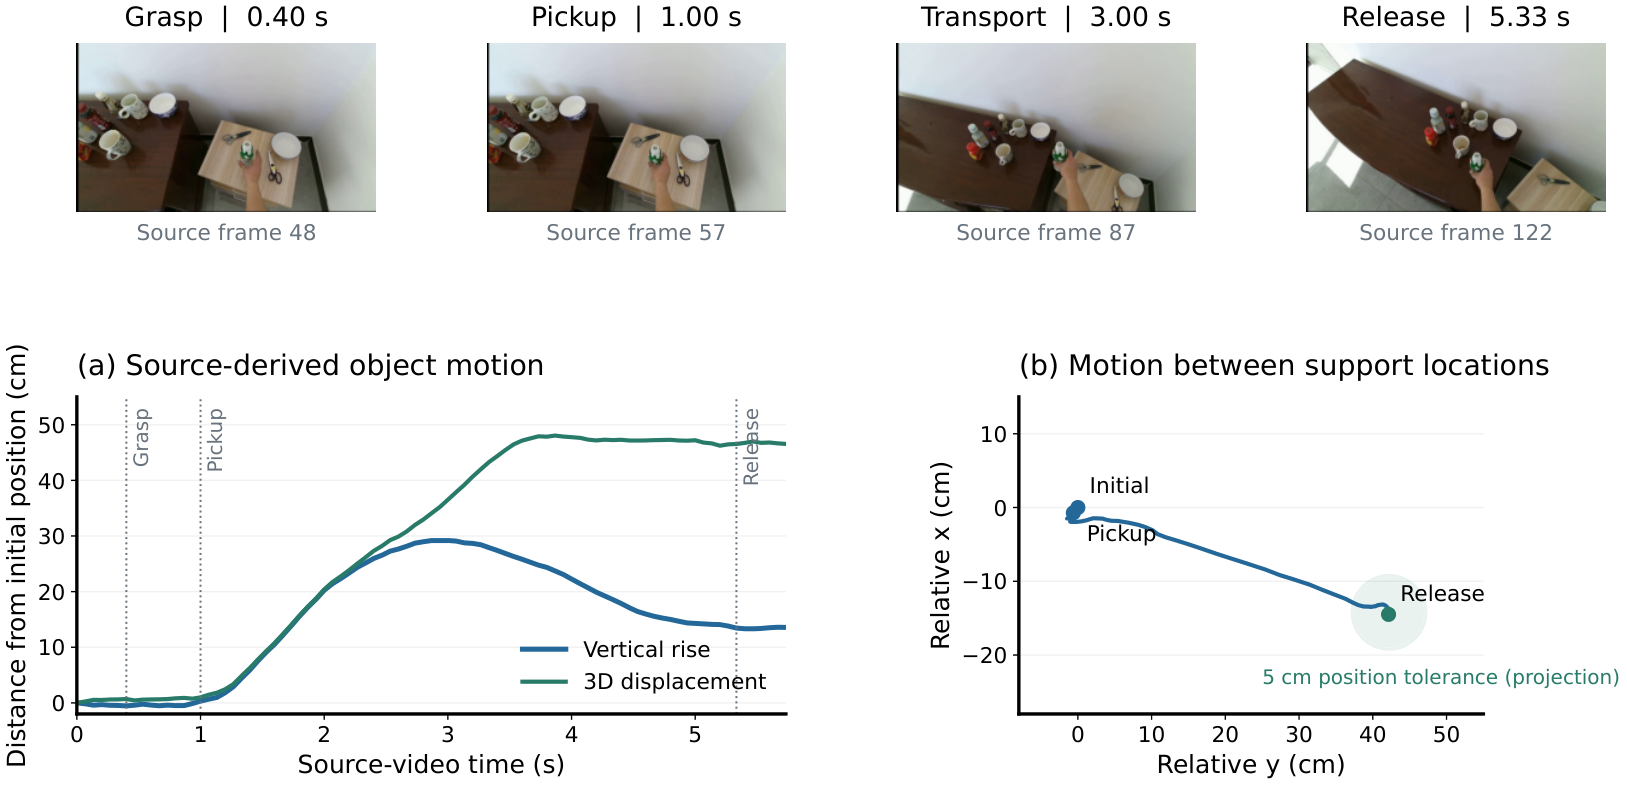
论文 Appendix 8.4 完整公开了一次 GPT-6 Astra 在视觉反馈下反复修改后的提交(visual-refinement submission)。输入来自 DROID:83 帧、640×640、7.5 Hz;原视频取第 64–228 帧,每隔一帧抽取一次,因此可见示范约 10.93 秒。任务是抓起横放在桌上的小瓶,把它转成直立姿态,重新放到桌面并松手;目标配置是 SAPIEN + Panda + Robotiq 2F-85。
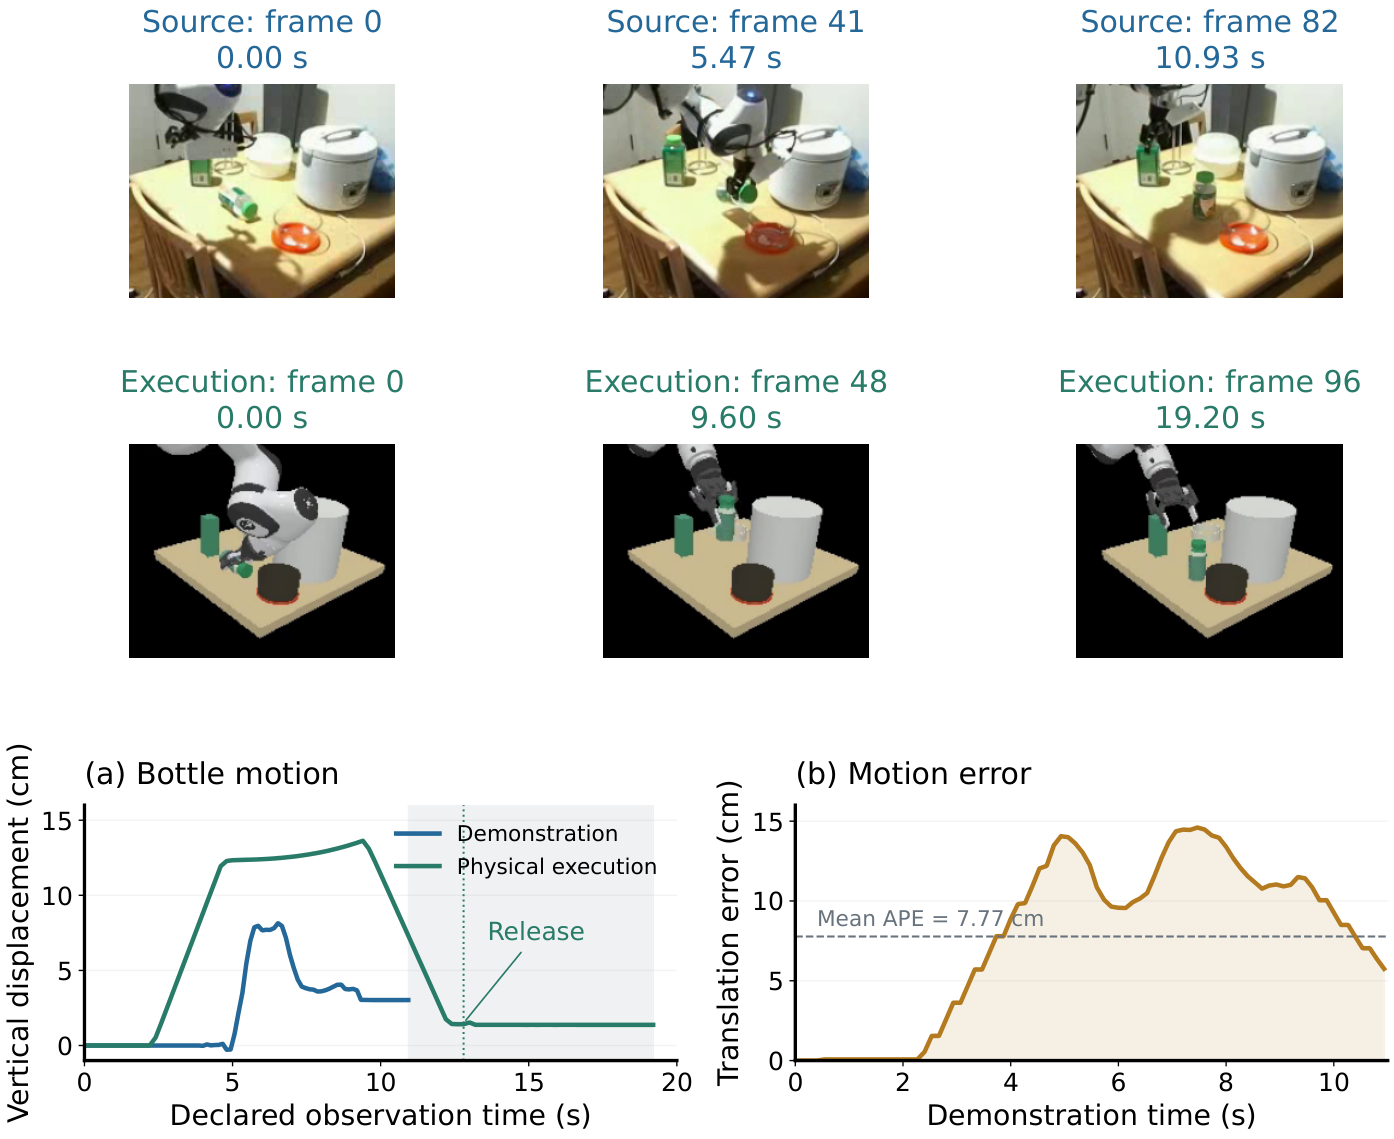
Agent 看到了视频帧拼图(contact sheet)、机器人与 TCP(tool center point,末端工具中心点)规范和提交格式。此处来自独立的 visual-refinement 实验:外部 controller(负责执行的控制程序)在两轮之间运行候选,将初始渲染、动作视频拼图、逆运动学误差和静止诊断交给 Agent;这个案例没有赋予 Agent 直接运行 simulator 的工具。相机标定、物体几何、参考轨迹、任务标注和分数仍隐藏,不能拿它冒充主榜所有系统完全相同的执行权限。最终程序包包含瓶子网格、桌面与背景几何、估计的相机和机器人位置,另有 97×7 的控制数组(dt=0.2 s)和 83×7 的预期物体位姿。预期位姿仍然只是声明;评测器从实际物理执行记录(physics rollout)中采集了 97 个物体状态。
执行时间线说明了为什么不能只比较视频帧:0.4 秒抓住瓶子,2.6 秒开始移动,12.8 秒松手,19.2 秒才完成终态判定。运动轨迹误差只在 83 个示范时间戳上比较;示范结束后的 41 个执行状态不进入运动误差评分,但任务评分程序仍会用它们确认物体最后是否稳定。
3.6 立瓶子:成功判据与一个具体失败分支
官方 v2w/metrics/task.py 中,这个 upright-bottle family 的最终逻辑可简化为:
# 根据官方 task.py:652-675 简化,不是完整可运行 checker
geometry_ok = supported and angle_deg <= 30
success = geometry_ok and released and quiescent
还要先通过 gate_initial_goal:如果瓶子一开始已经直立,Agent 什么都不做不能得分。这个实例要求瓶子最后由提交中声明的 tabletop(桌面支撑体)托住,实测支撑间隙 support gap 小于 0.01 mm,瓶轴和桌面法线约差 0.009°,机械手已经松开,且处于 quiescent/rest(物体运动足够小的静止状态)。公开门槛还包括 30° 的直立容差、1 cm 的支撑间隙和 5 mm 的桌面边界余量。
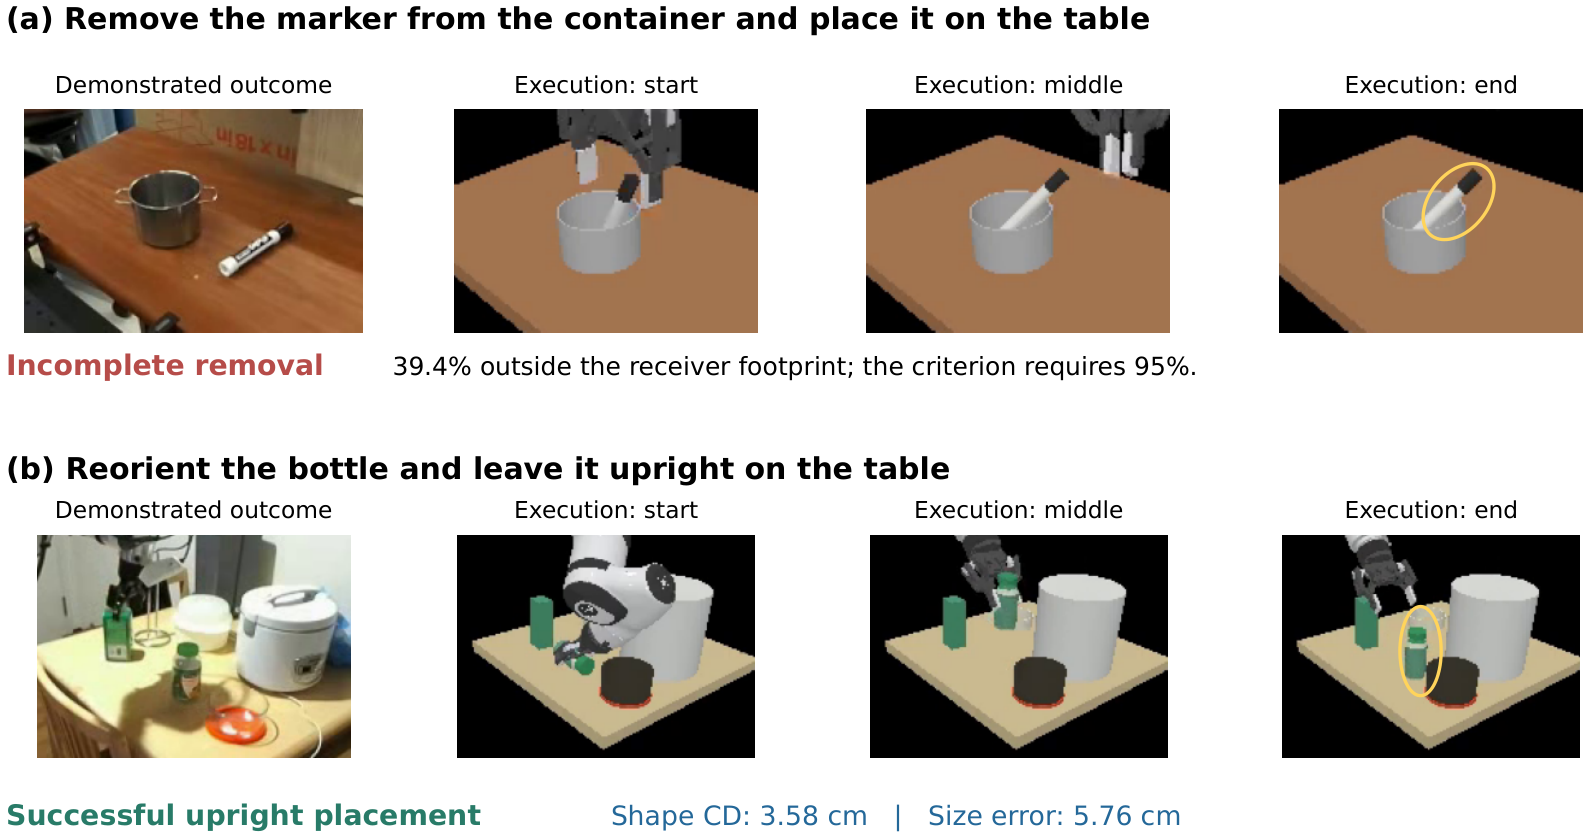
如果最后角度已经小于 30°、接触桌面也合格,但 grasping_final=true(仍被夹着),代码返回失败,原因是 still held or release unrecorded;缺少静止证据也失败。这是根据已核对代码推演的说明,不是本例实际日志。当前规则还要防止初始就已完成目标的偷懒提交;案例的旧公开 brief 曾有绝对终点限制,但当前评分用的是桌面支撑与直立语义条件,绝对位置误差另报。
该提交最终得到 Build=1、Task Success=1、Progress=100%;Scene CD 2.51 cm、Shape CD 3.58 cm、Size error 5.76 cm。按示范时刻比较平移的 T-APE 为 7.77 cm、比较朝向的 R-APE 为 9.27°;比较短时位移增量的 T-RPE 为 0.68 cm。T 表示平移,R 表示旋转。initial centre error(初始中心位置误差)达到 24.80 cm,但任务仍成功:瓶子在提交场景中完成了要求的交互,场景位置是否像原视频则另测。
3.7 几何、运动与复合分数怎么算
表面点之间的距离叫 Chamfer Distance(CD);每个时刻的位置或朝向误差叫 absolute pose error(APE);两时刻间变化的误差叫 relative pose error(RPE)。这里各指标保留不同信息,不能把“对齐”理解成给所有指标统一消除误差:
- Scene CD 比较可见场景表面,关键操作物体和接收物权重更高。它允许平移、最多 15° 旋转与 0.95–1.05 倍缩放后拟合;按对象计算的中位距离与反向加权中位距离相加,各方向截到 10 cm。它不是普通点云均值公式的直接套用。
- Shape CD 比较物体自身表面,先做旋转和平移的刚性对齐,不缩放。Size error 另比较按大小排序的包围盒三条边;Centre error 保留初始位置误差。Scene CD 的拟合变换不用于这些位置与轨迹测量。
- T-APE 在示范时间戳上比较物体位移,但各减去自己的初始位置,所以去掉的是恒定初始平移。T-RPE 比较约 0.2 秒间隔的位移增量。R-APE 比较对应物体坐标系的朝向,并按标注处理对称性;它不减去初始朝向。主运动指标不做时间伸缩,已完整执行却比示范短时才按规则延用最后状态。
绳索、软玩具、布料和只能观察到表面点的家居任务使用各自适用的表面或点轨迹指标,不能强行当成完整刚体位姿。上述误差越小越好,但都不替代任务判断。
对误差 e,先按阈值 τ 转成 [0,1] 的质量分 quality:
其中 Scene / Shape / Size 的 τ=10 cm,T-APE 为 20 cm,R-APE 为 90°,T-RPE 为 10 cm。然后:
G = 该实例适用的几何质量分均值
D = 该实例适用的动态质量分均值
V2WScore = Build × (F + G + D) / 3
分数先在每个实例内计算,再对同类任务汇总,最后对非空、评分适用的类别等权平均并乘 100。评分资格要求有任务标注,并至少有一项几何和一项运动测量。哪些项适用,由参考标注预先固定,不由候选决定;构建失败仍在分母内,复合分为 0。已适用测量缺失、版本错误或评分器执行失败,会使公开 scoring.py 报告 blocked,不能删除难项缩小分母。真正不适用的项才不进入该实例的 G/D。
单独报告的几何/运动误差均值与复合分的口径不同:它们只在构建成功且标注适用的实例上计算类内均值,再平均有测量的类别。因此不同方法可能覆盖不同连续误差子集;比较时需要同时看可评测数量。Build、Success、Progress 则保留构建失败为零。Progress 的任务阶段也不是所有环境统一“四步”:刚体任务计算同一次抓取尝试里按顺序完成的最长阶段前缀,原生 RoboDojo、布料和软体任务有各自规则。
把上述瓶子案例代入公开公式,可得到 F=1,G=((1−2.51/10)+(1−3.58/10)+(1−5.76/10))/3≈0.605;D=((1−7.77/20)+(1−9.27/90)+(1−0.68/10))/3≈0.814,重算结果约为 80.6 / 100。论文明确说这个完整案例没有发布正式的实例复合分;80.6 只用于解释公式,不是论文报告的官方数值。
4. Experiments:能构建与能完成任务之间的距离
Fable-5.1 的整体结果最好,GPT-6 Astra 的对象层几何误差更小,Claude Opus 5 的 Task Success 又高于 Astra;所有自动系统与人类辅助重建之间仍有明显距离。
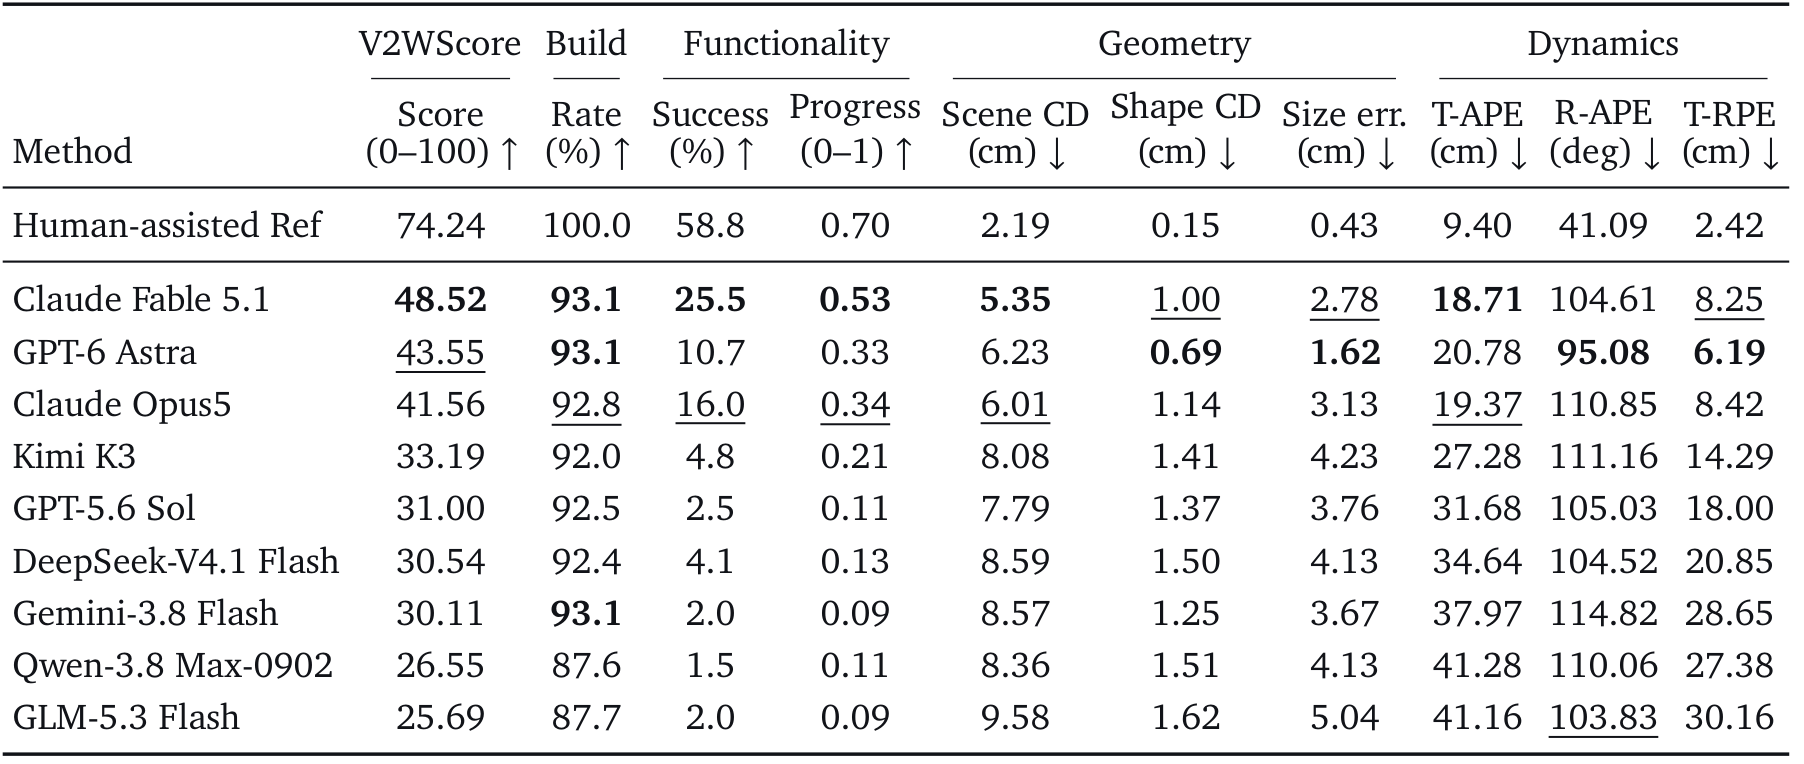
查看可复制的 Table 2 完整数值
| Method | V2WScore | Build | Success | Progress | Scene CD | Shape CD | Size | T-APE | R-APE | T-RPE |
|---|---|---|---|---|---|---|---|---|---|---|
| HAR | 74.24 | 100.0 | 58.8 | .70 | 2.19 | .15 | .43 | 9.40 | 41.09 | 2.42 |
| Fable-5.1 | 48.52 | 93.1 | 25.5 | .53 | 5.35 | 1.00 | 2.78 | 18.71 | 104.61 | 8.25 |
| GPT-6 Astra | 43.55 | 93.1 | 10.7 | .33 | 6.23 | .69 | 1.62 | 20.78 | 95.08 | 6.19 |
| Claude Opus 5 | 41.56 | 92.8 | 16.0 | .34 | 6.01 | 1.14 | 3.13 | 19.37 | 110.85 | 8.42 |
| Kimi K3 | 33.19 | 92.0 | 4.8 | .21 | 8.08 | 1.41 | 4.23 | 27.28 | 111.16 | 14.29 |
| GPT-5.6 Sol | 31.00 | 92.5 | 2.5 | .11 | 7.79 | 1.37 | 3.76 | 31.68 | 105.03 | 18.00 |
| DeepSeek V4.1 Flash | 30.54 | 92.4 | 4.1 | .13 | 8.59 | 1.50 | 4.13 | 34.64 | 104.52 | 20.85 |
| Gemini 3.8 Flash | 30.11 | 93.1 | 2.0 | .09 | 8.57 | 1.25 | 3.67 | 37.97 | 114.82 | 28.65 |
| Qwen3.8 Max | 26.55 | 87.6 | 1.5 | .11 | 8.36 | 1.51 | 4.13 | 41.28 | 110.06 | 27.38 |
| GLM-5.3 Flash | 25.69 | 87.7 | 2.0 | .09 | 9.58 | 1.62 | 5.04 | 41.16 | 103.83 | 30.16 |
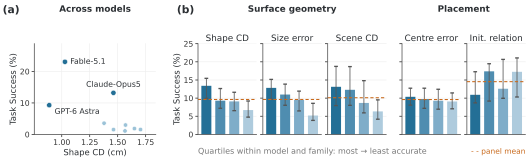
这些列必须分开读。Fable-5.1 的 V2WScore 48.52、Task Success 25.5% 和 Scene CD 5.35 cm 都是自动系统第一。Astra 的 Shape CD 0.69 cm、Size error 1.62 cm、R-APE 95.08° 和 T-RPE 6.19 cm 最好,但 Task Success 只有 10.7%,低于 Opus 5 的 16.0%。所以它更像“物体形状和部分轨迹指标更准”,不能概括成“整个重建最准确”。
4.1 HAR 不是“只看同一段 RGB 的人类上限”
Human-assisted reconstruction(HAR,人类辅助重建)可以使用原始 CAD 设计文件、RGB-D 图像与深度、相机标定、机器人日志、任务判据与隐藏分数,并反复人工调试。它的 V2WScore 是 74.24;Task Success 主表按类别等权平均为 58.8%。附录 C.5 却列 113/222(50.9% 实例率)及 57.3% 类别均值,与主表不完全一致,下文保留这个报告问题。
HAR 的试验历史还表明它不是同预算的人类上限:家具批次记录 128 次试跑,覆盖 64 个实例;一批人类视频接触搜索覆盖 20/66 个机械臂/机械手配置,每配置 26–31 条记录,其他来源没有同样完整的总数。作者没有系统记录人工工时,不能从试跑时长推算。家具执行条件也不同:HAR 终态观察 10 秒,Agent executor 静置 1 秒,并有自己的有界抓取对齐或零件保持近似。相同评分定义不等于完全相同的执行条件。
展开 HAR 来源和试验次数原图
4.2 成本、人工偏好与跨场景执行
九个系统合计约花费 9,700 美元、1,044 agent-hours 和 286 L40S GPU-hours。Fable 平均每次任务执行 14.03 美元、37.5 分钟;Astra 6.40 美元、14.6 分钟;Opus 13.83 美元、32.6 分钟;Kimi 平均 82.2 分钟,是最慢的一组。论文没有把性能、API 价格与实际经过时间合成一个效率指标。七种 OpenCode 配置用供应商账单,两个原生 harness 用 token 的标价等值;调用数记录也不一致。这不是精确同价格的成本对照。
人工偏好研究由 12 名内部评审完成,每个视频对交给三位评审,共保留 243 条有效判断,覆盖 81 个视频对、39 个案例。评审会同时看源示范和两份候选,判断哪份更忠实;“相当”和“两份都差”均按半胜半负进入 Bradley–Terry 相对偏好模型。68/243 条判断认为两份都差,不能把这种平局读成双方都成功。Human Preference Rating 的均值固定在 1000,是相对偏好分,不是成功百分比。评审来自作者与公司员工,区间按源视频重采样,不是独立外部人群的一致结论。
同一份场景和动作一起成功,不代表拆开后仍能用。 附录 D.1 已把动作和场景互换:Set A 选 20 个参考场景能被固定、读取物体状态的控制器完成的实例;Set B 选 44 个 HAR 动作在 HAR 场景中成功的实例。将 Agent 动作不变地放入 HAR 场景,两个子集的可用记录都只成功 2.3%;用隐藏初始物体位置平移整条动作后,分别升到 15.5% 和 15.1%。这说明初始位置错位影响很大,但并未单独控制其他差异。
在已经“自家动作+自家场景”成功的记录中,Set A 的 19/43、Set B 的 30/63 仍同时失败于两项互换测试:参考控制器在 Agent 场景中失败,平移后的 Agent 动作在 HAR 场景中也失败。论文据此指出场景和动作可能互相适配。44% / 48% 是成功记录中两项互换均失败的比例,不是全 benchmark 的失败率。固定控制器失败也不能证明场景无法被任何控制器使用;这些诊断只覆盖支持的类别,且有缺失配对记录。
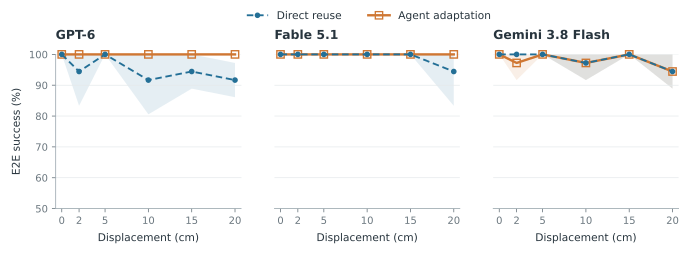
论文还测试了 9 段原视频、3 个模型在新布局上的执行:分别平移物体或目标,在两个方向取 2、5、10、15、20 cm 五档,每模型 180 次,共 540 次。直接复用原控制成功 525/540(97.22%);让 Agent 针对新位置调整动作后成功 536/540(99.26%)。调整时固定场景、物理参数与任务规则,每布局重新开上下文,最多 10 次执行或 10 分钟,最后清空状态重测。它修复了 15 个失败中的 13 个,同时破坏了 525 个原本成功中的 2 个;Gemini 的结果反而从 98.33% 降到 97.78%。这只覆盖初始重建已经成功、位移已由 HAR 验证可行的同九个任务,不能推成新任务泛化或策略训练收益。
展开新布局复用实验原图
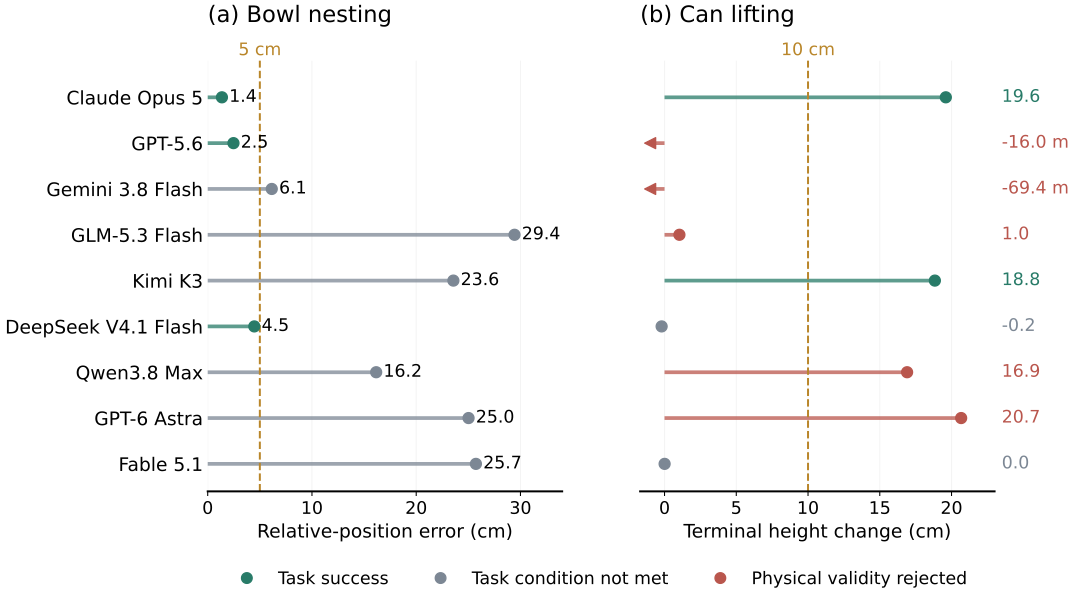
展开两个任务的九模型失败原因原图
5. Discussion:先对齐分母,再区分感知与控制的失败
后续实验首先要把每个实例、参考版本和失败计数公开对齐。 当前正文的 222 与附录 215、HAR 的 58.8% 与 57.3%,都需要作者解释。相同场景与任务在不同目标机器人下还应独立重跑,避免错误配置让一种系统永远无法通过。
算法比较可以固定模型与 harness,分别给真实几何、真实相机、真实动作中的一项额外信息,观察哪部分能恢复 Task Success。这样的对照才可以分清视觉估计、资源构建和控制生成的瓶颈;高质量 Shape CD 并不证明整个动作已成功。
作者已经用初态满足目标的灯罩、未完全取出的记号笔和方向判定错误的瓶子修过评分器,并对保留执行重新评分。后续应扩大反例覆盖和独立复核,而不是把这些已完成检查再写成新实验。动作/场景互换也已做过;更有区分力的延伸是让多种独立控制器在匹配执行条件下测试同一重建,并公开全部适用与失败记录。
6. Conclusion:可执行评测已经建立,可靠重建尚未解决
它最扎实地证明了:单段操作视频到可执行模拟程序包已经可以被标准化评测,强 coding-agent 系统能完成一部分任务,但可靠重建仍远未解决。
最明显的报告问题是统计分母。附录 C.4 说主评测固定使用 222 个实例、39 类任务,构建失败在 Build / Success / Progress 中计零;C.5 又列 S0=215、S2 primary=179、S1 HAR-pass=112。A2 段说没有成功参考的 18 个实例保留在主要集合,后面却说 S2 删除 A1 与 A2。79 页 v1 PDF 的 Table A12 说明本身就有未解析的“Table ??”,并非仅 HTML 转换丢失。论文也没有解释 222 与 215 的七个实例差额。本文按 Table 2 报主结果,将这些互相冲突的统计单列为待作者澄清,不能自行拼成一致的过滤流程。
Table 2 的 Fable 25.5% 是 39 类任务等权平均的 Task Success;Table A12 的 19.1% / 20.6% / 24.2% 则使用三个按实例计算的分母。两组数统计口径不同,不能互相代换。这个缺口不推翻主结果,但会妨碍复现者核对样本过滤和失败计零方式。
我的判断是:Video2World 已经给出一套完整的评测框架。它把提交包、真实物理执行和任务专用评分器组合起来,比只看截图的世界生成评测更接近可用系统。结果也保留了重要的失败:大量 Agent 可以生成能加载的场景,却无法把对象稳定抓起、移动并放到正确状态。下一步应把失败分别归到视频测量、场景构建、robot retargeting(把示范动作转换到目标机器人上)、控制器生成、物理参数校准和 judge 设计,再在相同 harness 与相同预算下比较方法。
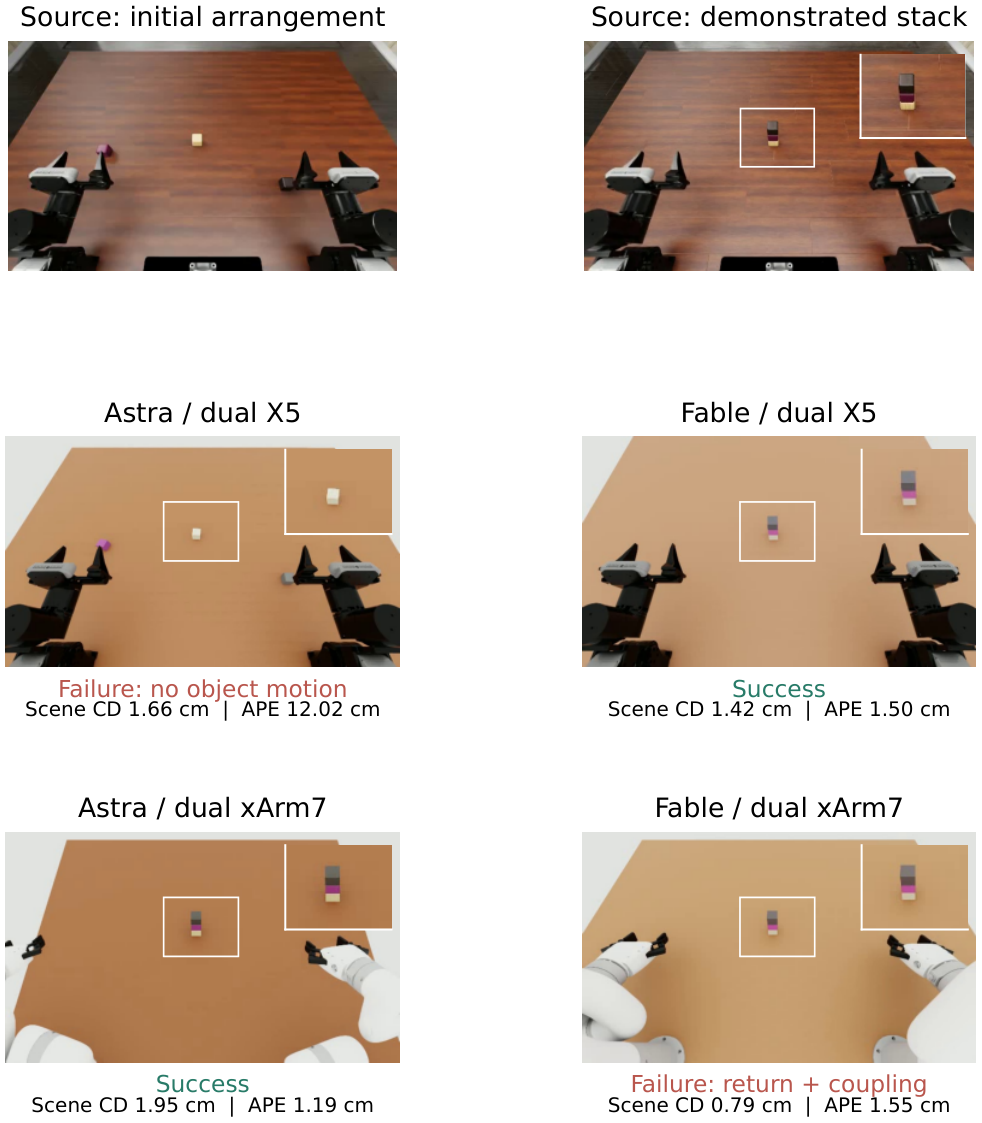
展开同一示范在两种机器人上的案例原图
主要来源:Video2World arXiv v1 全文与全部附录;官方仓库 revision 44b1760c52cc14e519aa88b5a91c374e09b81653;官方 benchmark 文档、评分实现 v2w/scoring.py、配置 v2w/config/score.json 与 task judge v2w/metrics/task.py。论文图像依 CC BY-SA 4.0 引用,官方代码为 Apache-2.0。检查日期:2026-10-20。
留言