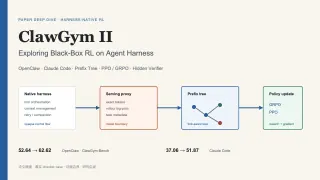
[2026-08-17] ClawGym II: Exploring Black-Box RL on Agent Harness
ClawGym II 保留 Claude Code 和 OpenClaw 的工具执行流程,通过模型调用记录和任务评分训练模型。本文解释分支怎样恢复、哪些生成不参与训练,并实际运行公开周报任务的检查程序,核对评分与实…
ClawGym II 保留 Claude Code 和 OpenClaw 的工具执行流程,通过模型调用记录和任务评分训练模型。本文解释分支怎样恢复、哪些生成不参与训练,并实际运行公开周报任务的检查程序,核对评分与实…
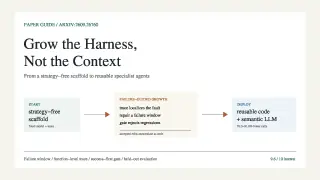
从空程序起步,把失败任务暴露出的重复处理步骤写进代码,供后续任务复用。用论文的 Repair 31 案例说明怎样找出错误、修改函数和验收,并核对成功率与成本的计算范围。
先为弱模型调整提示、工具和运行时检查,再让它完整模仿强模型,成绩反而下降。本文沿着两条真实失败记录,解释为何改用学生自己的执行记录,只修错误发生的那一轮,并核对数据和实验限制。
RIVER 先检查任务说明、容器和测试程序是否一致,再让强模型各试两次,从原训练集筛出约 3.5K 个环境。两条真实误判记录说明答案泄漏和脆弱测试怎样带偏训练,以及重复操作的扣分加在何处。
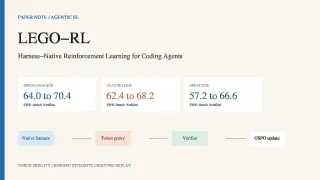
LEGO-RL 保留 Claude Code 等编码助手原有的执行流程,记录模型实际生成的内容,再按隐藏测试结果训练模型。用真实进度条修复任务讲清生成记录、任务筛选、评分和训练更新,并区分验证集最高分与最后一次验证。
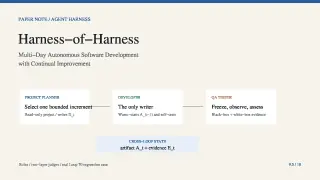
让现成编码助手反复规划、开发和独立测试同一个项目,保留代码与对应版本的验证记录。结合真实第 70 轮失败记录,核对方法、评分、成本,以及论文设计与公开实现的差别。
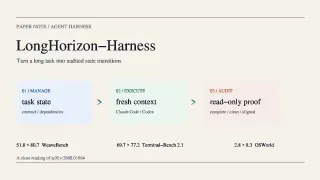
拆解 LongHorizon-Harness 如何单独保存任务进度、每轮重新启动执行会话并独立核验结果;结合真实失败案例,说明评分、成本与实验限制。
固定模型,自动读取失败记录,修改提示、工具代码、运行时检查和经验文件,再用下一轮测试验收。本文沿着误删图片、未完成采样两条实际失败记录,解释修改流程、计分和组件冲突。
训练时先审查模型准备执行的下一步,把专用工具与检查规则改写成普通 Bash 动作,再用执行记录微调模型。本文解释审查流程、表格案例、三个领域的评分与蒸馏失败的原因。
在给定 Godot 项目里补好玩法逻辑,怎样确认它每一步都守规则?从引擎与代码示例讲起,逐项拆解任务构建、真实案例、隐藏判分和实验分母。