[2026-10-01] Finetuning with Sampling: SFT Learns Better Than You Think
别人写出的正确解答未必适合学生模型直接学习。Sampling SFT 先让目标模型重写答案,再做普通监督训练。本文分开讲理论采样与公开贪心实现,用真实配平案例核对正确性与结果。
别人写出的正确解答未必适合学生模型直接学习。Sampling SFT 先让目标模型重写答案,再做普通监督训练。本文分开讲理论采样与公开贪心实现,用真实配平案例核对正确性与结果。
答对选项也可能看错图。V-Rubrics 把视觉事实、推理和输出要求分开判分,再将每项训练信号分配给回答的相应前缀。本文用公开潮汐题复算奖励,核对原论文图表与代码边界。
GAGAR 如何比较多次通过测试的代码修改质量,再重新分配训练权重;拆解判分 Agent、计算公式、训练结果、带上限的实现与未公开证据。
ASTRA 先生成工具调用示范,再把多步问答写成可执行的模拟工具,用模型自己的执行结果继续训练。本文分开解释数据构造、环境检查、训练奖励、行李加购真实样本及公开代码与论文的差异。
Agent 一边操作原软件弄清行为,一边写代码复刻,再运行自己的版本检查差异。本文用 Logbert 固定日志案例说明任务与隐藏测试的来源、两种评分通道、五平台结果和训练迁移。
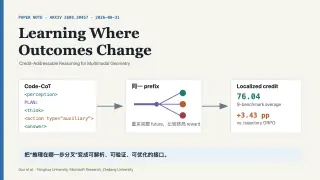
把几何解题过程写成带标签的步骤,固定某一步以前的内容,再从这里生成不同完整解法,用最终分数差训练后半段。结合等腰三角形真实案例,说明数据来源、评分、更新范围与实验限制。
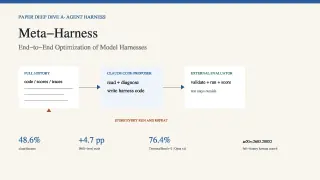
让 Claude Code 读取历次候选的代码、分数与执行记录,改进包在模型外的运行程序。本文说明搜索过程、真实样例的判分,以及分类、数学和终端实验各自能证明什么。
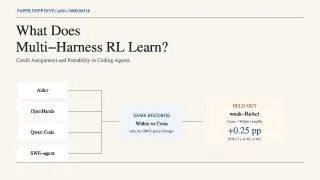
同一批编程执行记录,按接口分别比较成绩,或把同题不同接口的成绩合起来比较:两种训练都只有小幅提升,评测接口带来的差异更大;换到未见接口后,谁更好仍没有稳定证据。
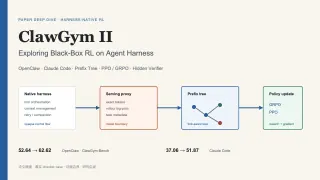
ClawGym II 保留 Claude Code 和 OpenClaw 的工具执行流程,通过模型调用记录和任务评分训练模型。本文解释分支怎样恢复、哪些生成不参与训练,并实际运行公开周报任务的检查程序,核对评分与实…
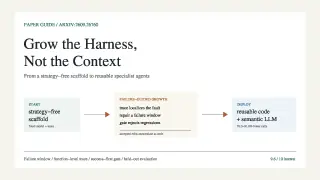
从空程序起步,把失败任务暴露出的重复处理步骤写进代码,供后续任务复用。用论文的 Repair 31 案例说明怎样找出错误、修改函数和验收,并核对成功率与成本的计算范围。