Video2World 要测的不是“模型能否看视频生成一张相似的 3D 图”,而是更难的一件事:coding agent 能否只看一段真实的人或机器人的操作视频,写出一个能在物理模拟器中重新执行该任务的完整 package。场景、物体尺寸、机器人位置和控制序列都要自己恢复;最终还要真的完成拿取、放置、开合或装配,而不是只让渲染结果看起来相似。
Q1. 为什么要评测“从视频重建可交互世界”?
因为真实示范最容易获得,但现有具身系统通常还要人工准备 scene assets、robot configuration、object state 和 task-specific controller,才能把一段示范变成可训练或可测试的模拟环境。
真实机器人数据集和第一视角人类视频越来越多,里面有完整的抓取、移动、装配和工具使用过程。但一段 RGB 视频不会直接告诉我们桌面坐标、相机内外参、物体 mesh、碰撞体、质量、关节位置,更不会自动给出能让另一台机器人复现动作的控制序列。传统 real-to-sim 流程要把这些部分逐项补齐,成本高,也很难扩展到大量新场景。
Video2World 的研究问题因此很具体:给 coding agent 一段视频,以及目标 simulator 和 robot 的公共接口说明,它能不能通过读图、写文件、执行自己的候选重建、观察报错和反复修改,最终交出一个可运行的环境?这同时考查视觉理解、几何估计、3D 资源制作、机器人控制、物理调试和长程工具使用。
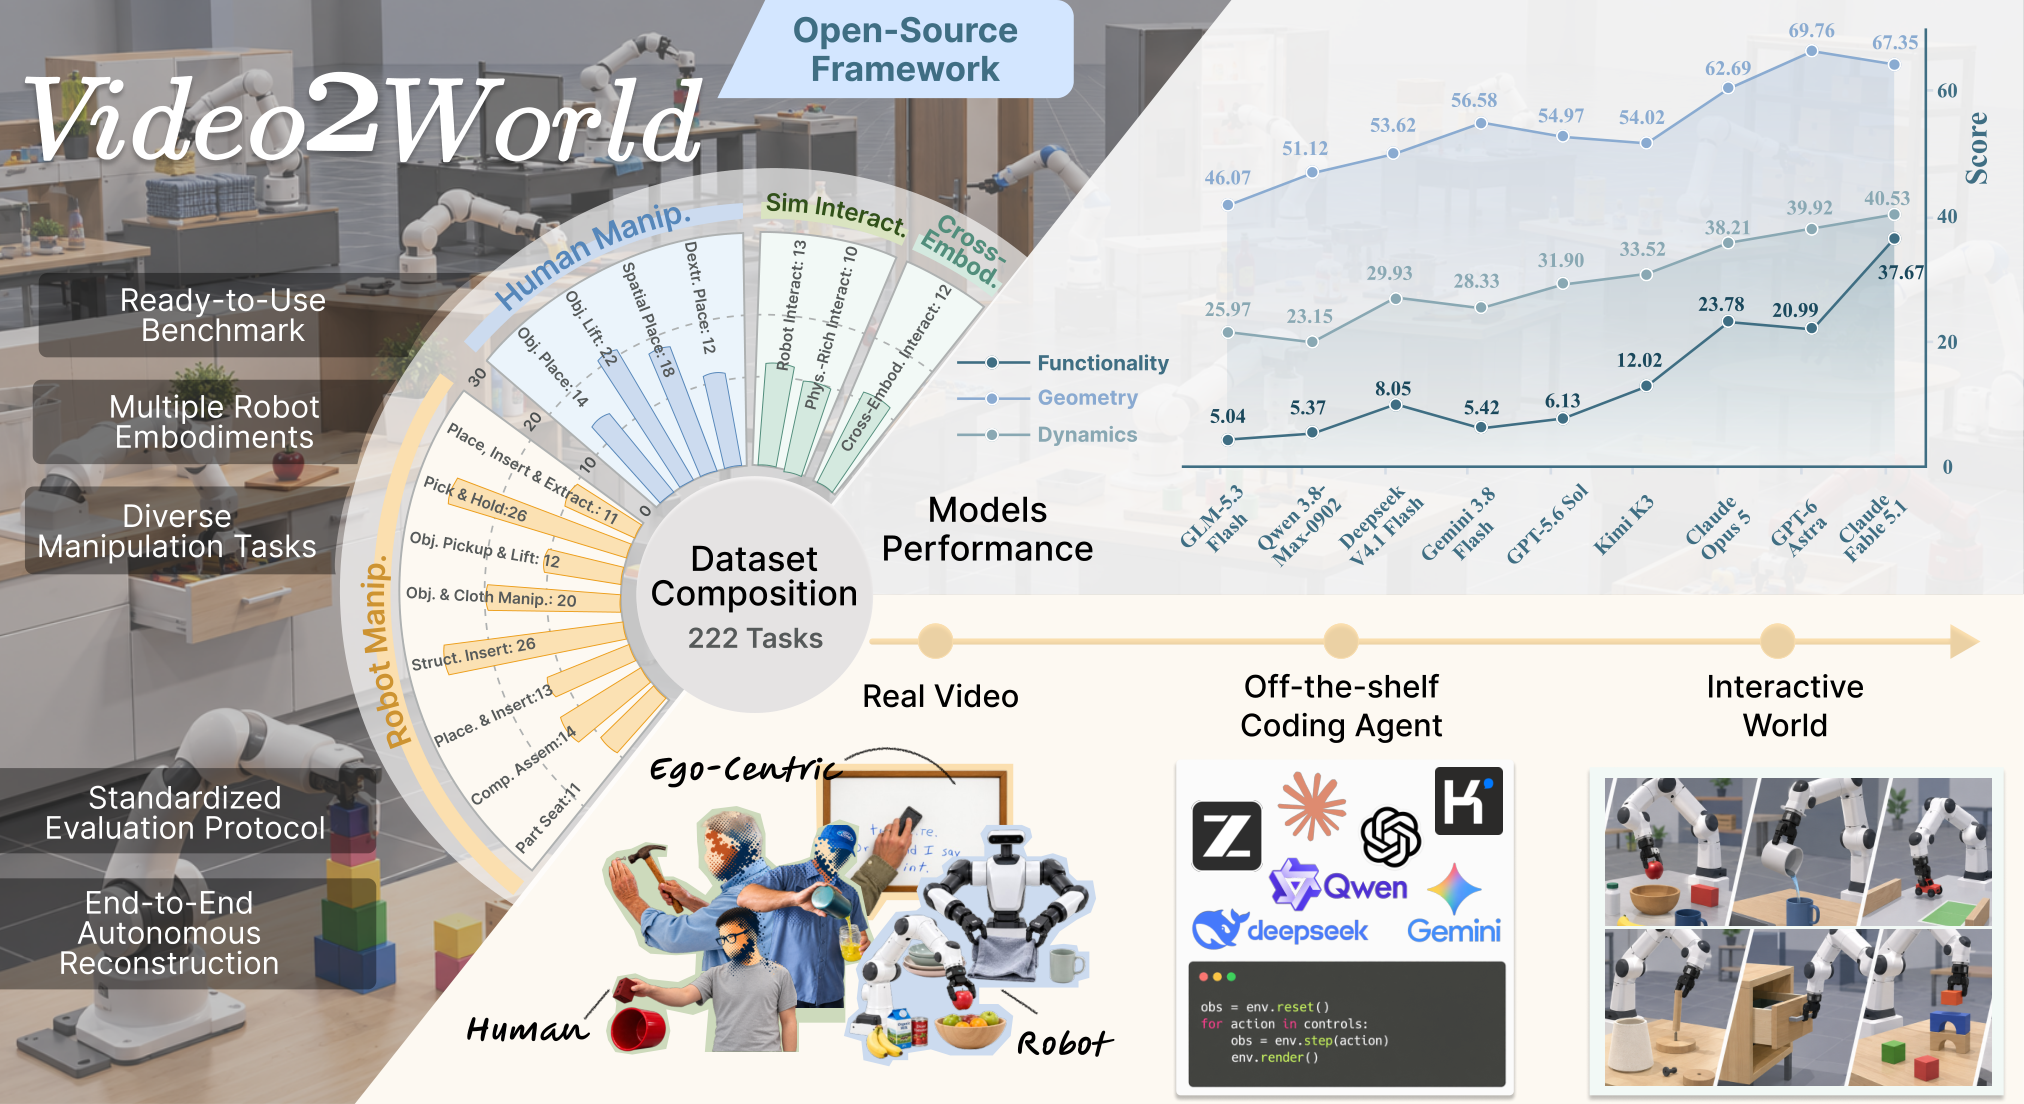
这个 benchmark 最有价值的地方是把“看起来像”和“真的能做”同时保留。只测 task success,Agent 可以用极简几何体甚至取巧完成目标;只测几何,又无法判断世界是否可以交互。Video2World 用功能、静态几何和动态轨迹三组指标把两种失败分开。
Q2. 它与相邻工作差在哪里?
Video2World 把视频理解、场景重建、目标 embodiment(要执行任务的机器人或手)转换和物理执行放进一次完整提交。
| 工作 | 输入与输出 | 主要检查 | 与 Video2World 的差别 |
|---|---|---|---|
| Video2Policy | 人类视频 → robot policy | 机器人能否模仿任务 | 重点是 policy learning,不要求 coding agent 交付完整 simulator scene 与 assets。 |
| Agentic Real2Sim | 真实观察 → 可执行 simulation | 自动化 real-to-sim reconstruction | 问题最接近;Video2World 更强调统一 benchmark、隐藏 reference 与九套 coding-agent 系统比较。 |
| BVB | 视频 → Blender scene / procedure | 视觉与场景重建 | 主要在 Blender 与视觉结果上评测,不把 robot actuation 和 task judge 作为中心。 |
| SceneActBench | 场景与动作描述 → 可执行 simulation | 场景、动作与物理合理性 | 强调 scene-action synthesis;Video2World 的任务规格主要来自 embodied video。 |
| CaP-X | 多模态观察 → code-as-policy | 代码能否控制机器人 | 侧重控制程序;Video2World 还要求恢复环境几何、相机与对象属性。 |
| EmbodiedSWE | 具身系统仓库 issue → patch | 软件测试是否通过 | 属于 embodied software engineering,交付代码 patch;这里交付的是新的可执行世界与控制轨迹。 |
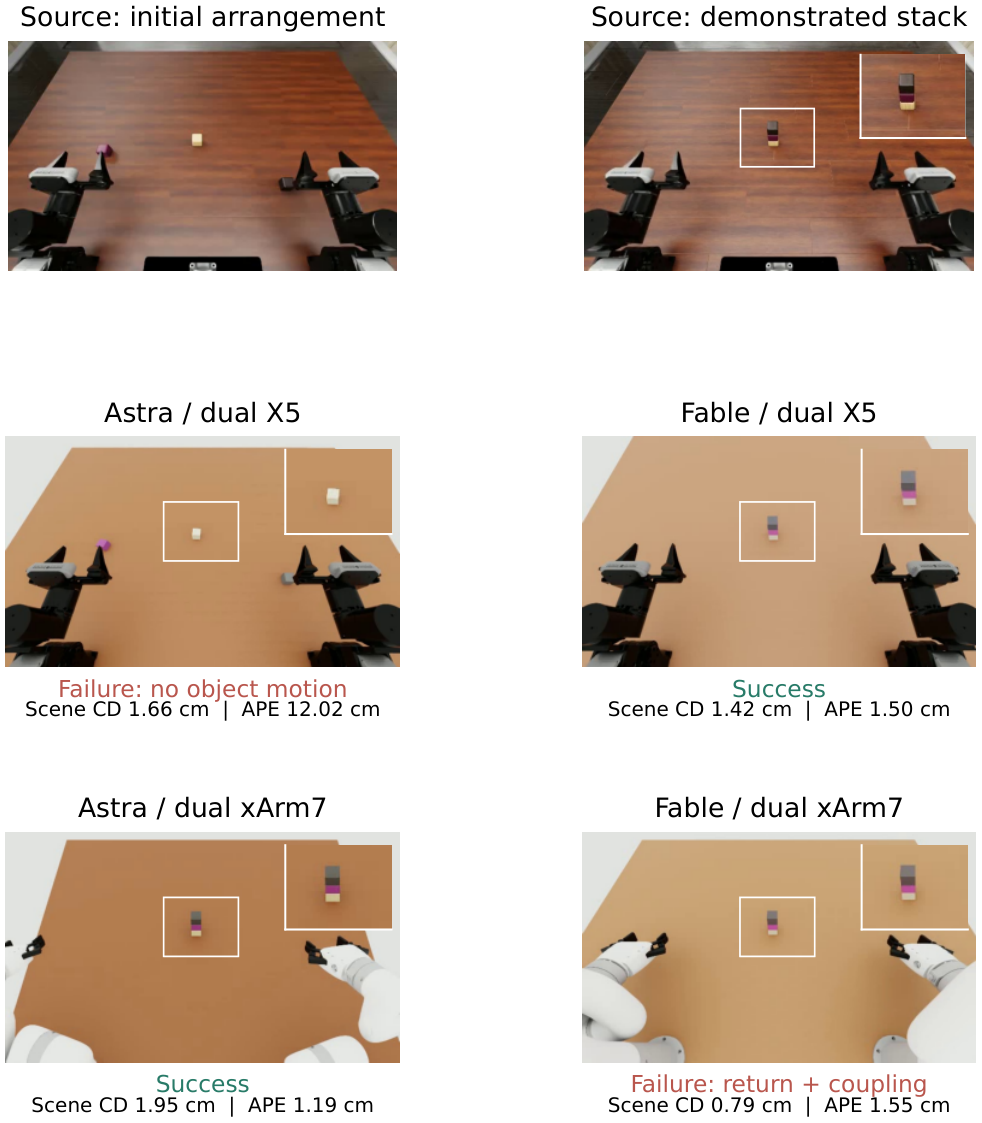
论文提供了一条完整的 coding-agent 评测链:统一的公开说明、提交格式、simulator runner(负责加载和执行提交的程序)、隐藏参考答案和按任务编写的 judge。结果表同时包含 OpenCode、Codex CLI 和 Claude Code 的原生 harness(给模型提供工具并管理执行的框架)。这些 harness 并不完全相同,因此 Table 2 是 system-level comparison(模型与执行框架整体比较),不能当作只更换模型的排行榜。
Q3. 189 段视频怎样变成 222 个实例,Agent 能看到什么?
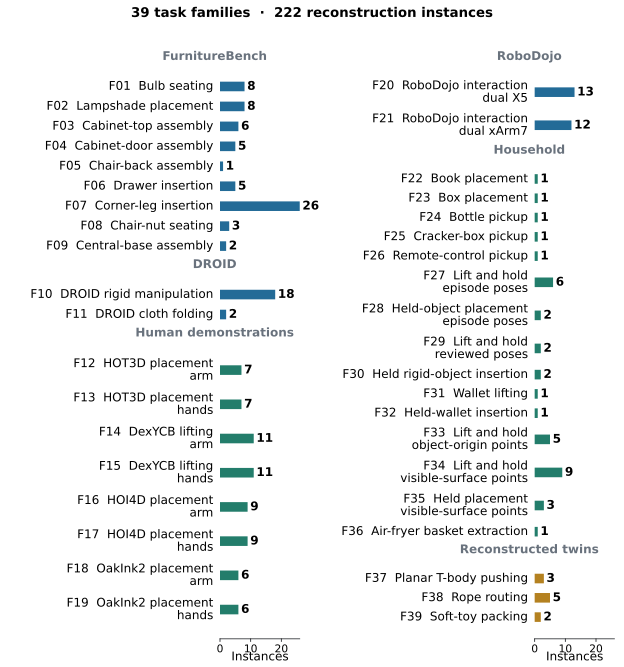
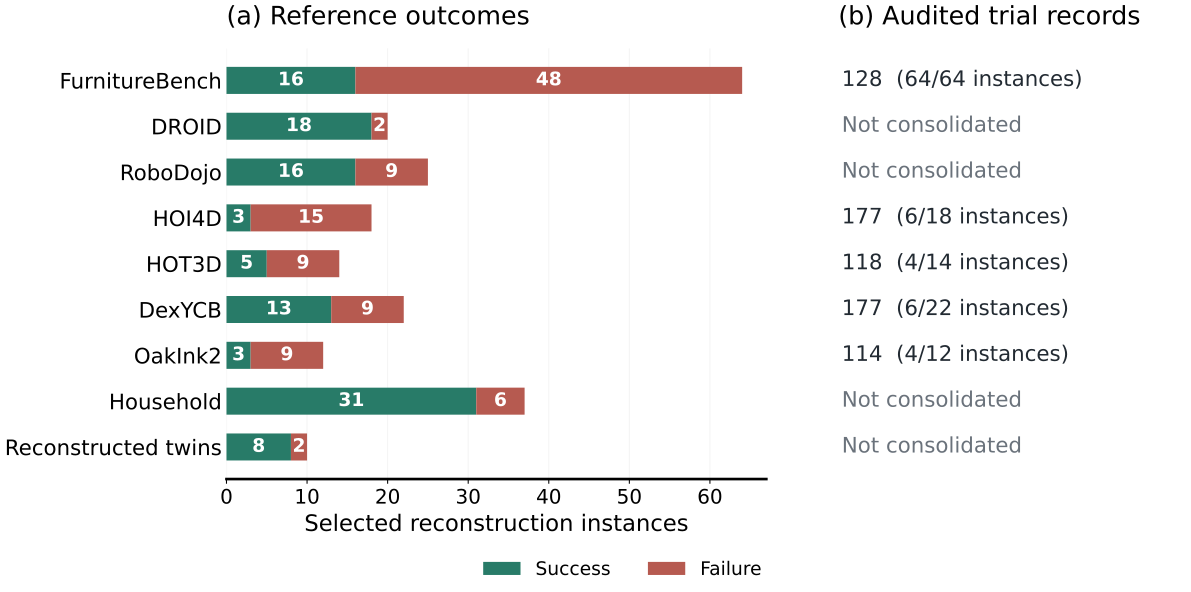
作者从八类数据来源收集 189 段视频,再根据目标 simulator、robot 与 end-effector(机器人末端工具)配置形成 222 个 reconstruction instances;其中 33 段人类视频同时对应机械臂和 paired-hand(成对机械手)两种目标配置。
| 来源 | 视频 / 实例 | 它补充的任务类型 |
|---|---|---|
| FurnitureBench | 64 instances | 家具零件操作与装配 |
| DROID | 20 | 真实机械臂日常物体操作 |
| RoboDojo | 25 | 跨任务机器人示范 |
| HOI4D | 9 videos / 18 instances | 第一视角 human-object interaction |
| HOT3D | 7 / 14 | 手部与物体交互 |
| DexYCB | 11 / 22 | 手-物体抓取 |
| OakInk2 | 6 / 12 | 双手物体操作 |
| in-house | 37 | 作者补采的真实示范 |
| reconstructed twins | 10 | 已经有模拟重建对照的任务 |
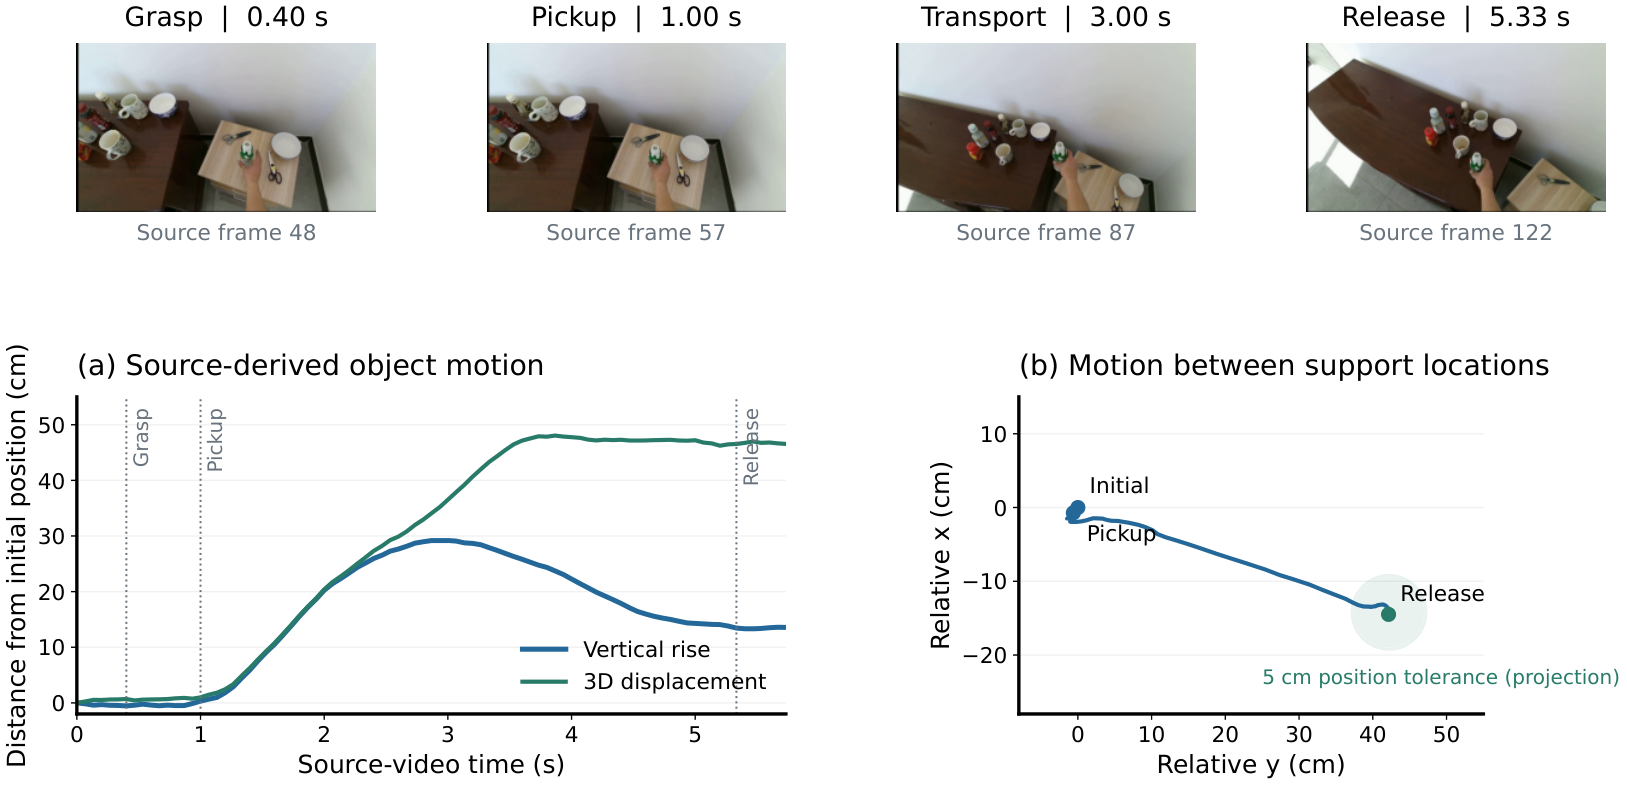
作者为每个实例准备 reference reconstruction(用于评分的参考重建)、任务定义、评测窗口和目标配置,并由人工复核。论文附录展示了标注界面:标注者需要确认视频窗口、任务阶段、关键对象和目标 simulator;参考重建还要经过物理有效性与成功执行检查。任务判定来自 benchmark 作者编写和复核的 task definition 与 evaluator 逻辑,具体门槛随 task family 改变,并不是模型自动生成一个 check.json 就直接充当答案。
Agent 得到什么?
- RGB 视频、分辨率、帧数和播放信息;
- 目标 simulator 与 robot 的公共说明、assets、joint limits 和 control format;
- shell、文件、图片查看和代码编辑工具;
- 自己候选重建的格式检查结果、执行视频(rendered rollout)和报错。
Agent 明确看不到什么?
- reference scene / mesh、测量得到的 source trajectories 和 source robot logs;
- 隐藏 camera calibration、reference controls 与 reference submission;
- task-specific success criteria 和 benchmark scores。
最终交付的 package 有什么?
核心文件是 protocol.json、actions.npy 和 scene.json 或 scene.xml,另加本地 3D meshes、textures(纹理)、source/ 与 report.md。某些机器人/模拟器配置还允许 expected/obj_poses.npy,但它只是 Agent 声明的预期物体轨迹,不能直接驱动物体。物体必须由 robot actuation(机器人控制)与 simulator physics 产生运动;否则任务 judge 和实际执行都不会认可。
评测的对象是九个完整 coding-agent configurations。七个模型运行在 OpenCode 1.18.29 的 managed executor;GPT-6 Astra 使用 Codex CLI 0.154.0-alpha.6.2,Fable-5.1 使用 Claude Code 2.1.276。每个实例只允许一次 construction attempt,wall-clock 上限 180 分钟,observed API cost 达到 60 美元后停止,最多提交三次,而且 Agent 看不到隐藏分数,不能用 benchmark score 选 checkpoint。
Q4. evaluator 怎样把一个 package 变成 PASS / FAIL?
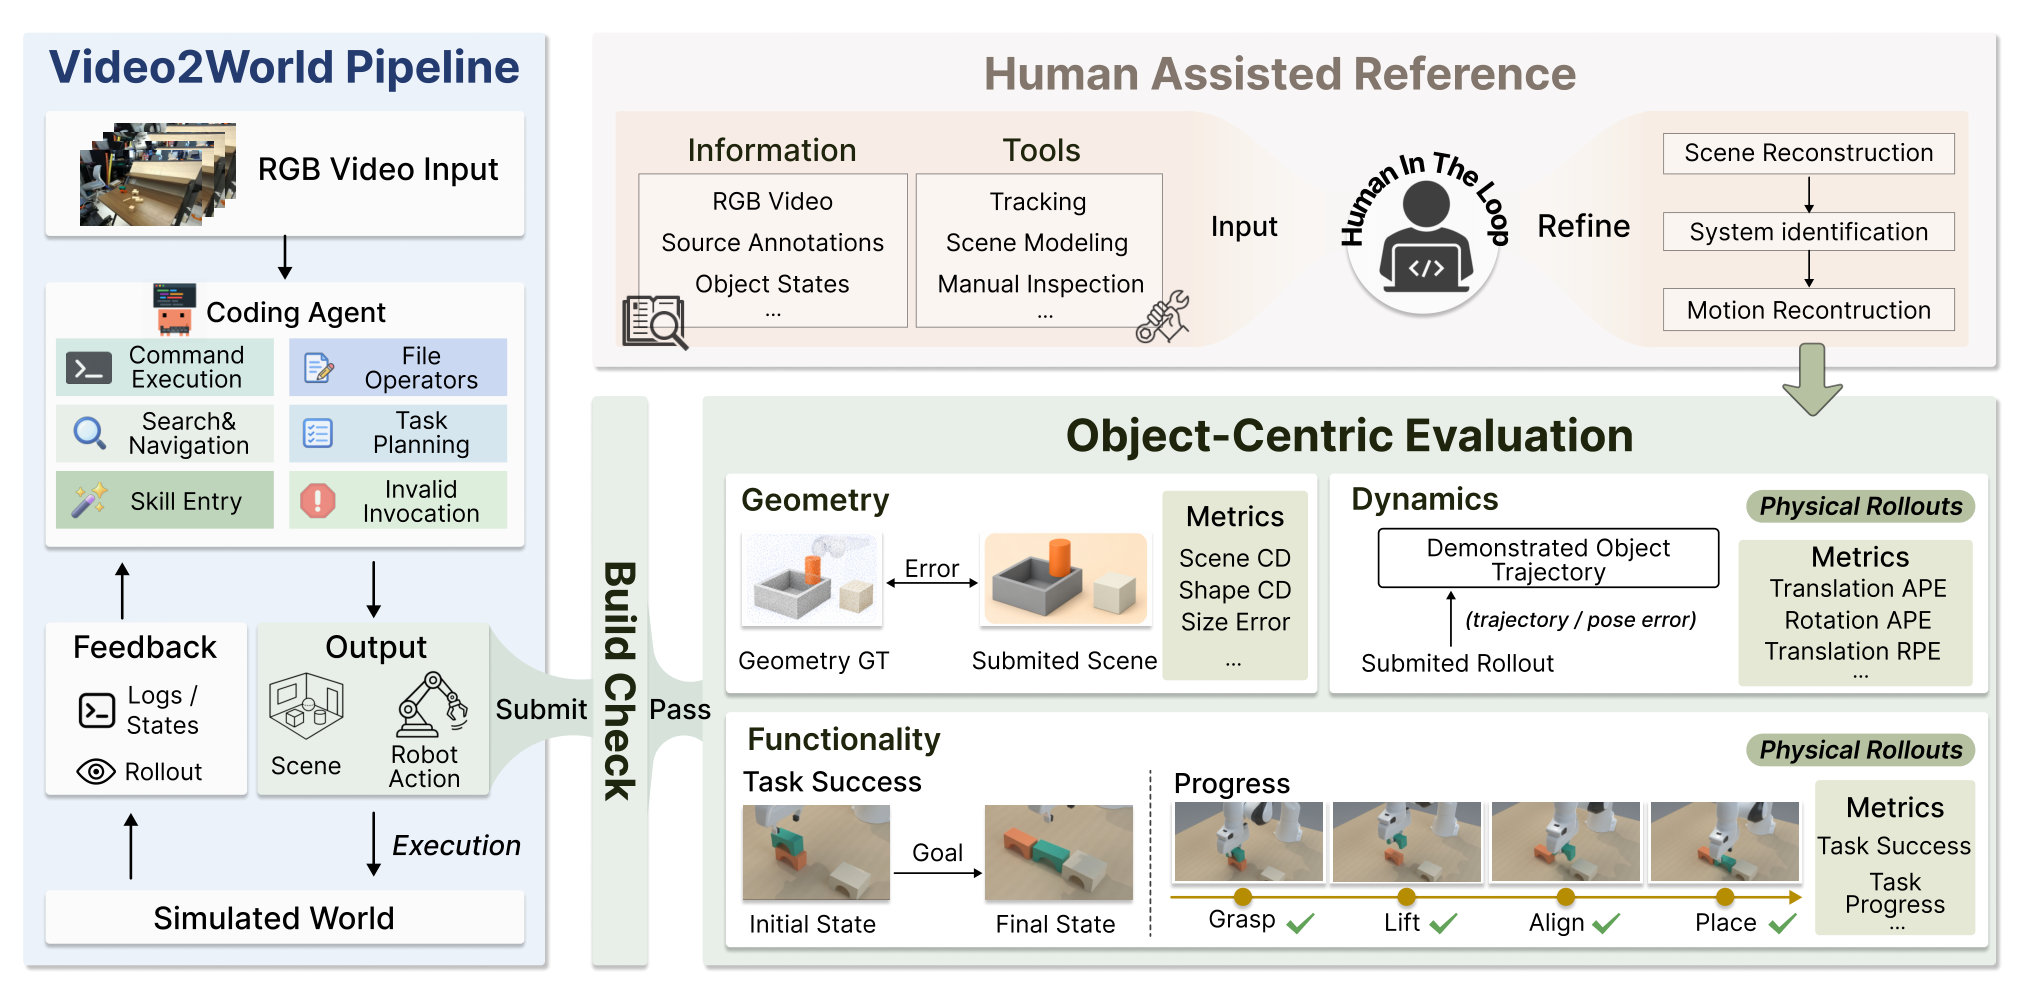
评测器先检查 package 能否构建,再在指定 simulator 中执行动作,记录 robot 与 object states;task judge 依据物理状态判定成功和进度,随后再把重建几何与运动轨迹对齐到隐藏 reference。
- 1 · VALIDATE检查文件、schema、asset path 与控制数组是否合法。
- 2 · BUILD在 SAPIEN、Isaac Sim 或 MuJoCo 中加载 scene 与 robot。
- 3 · EXECUTE按 `protocol.json` 的时间步执行 `actions.npy`。
- 4 · JUDGE用 task-specific predicates 检查接触、支撑、释放、姿态与静止状态。
- 5 · COMPARE在 reference 时间戳上计算 geometry、APE 和 RPE。
真实案例:把横放的小瓶立起来
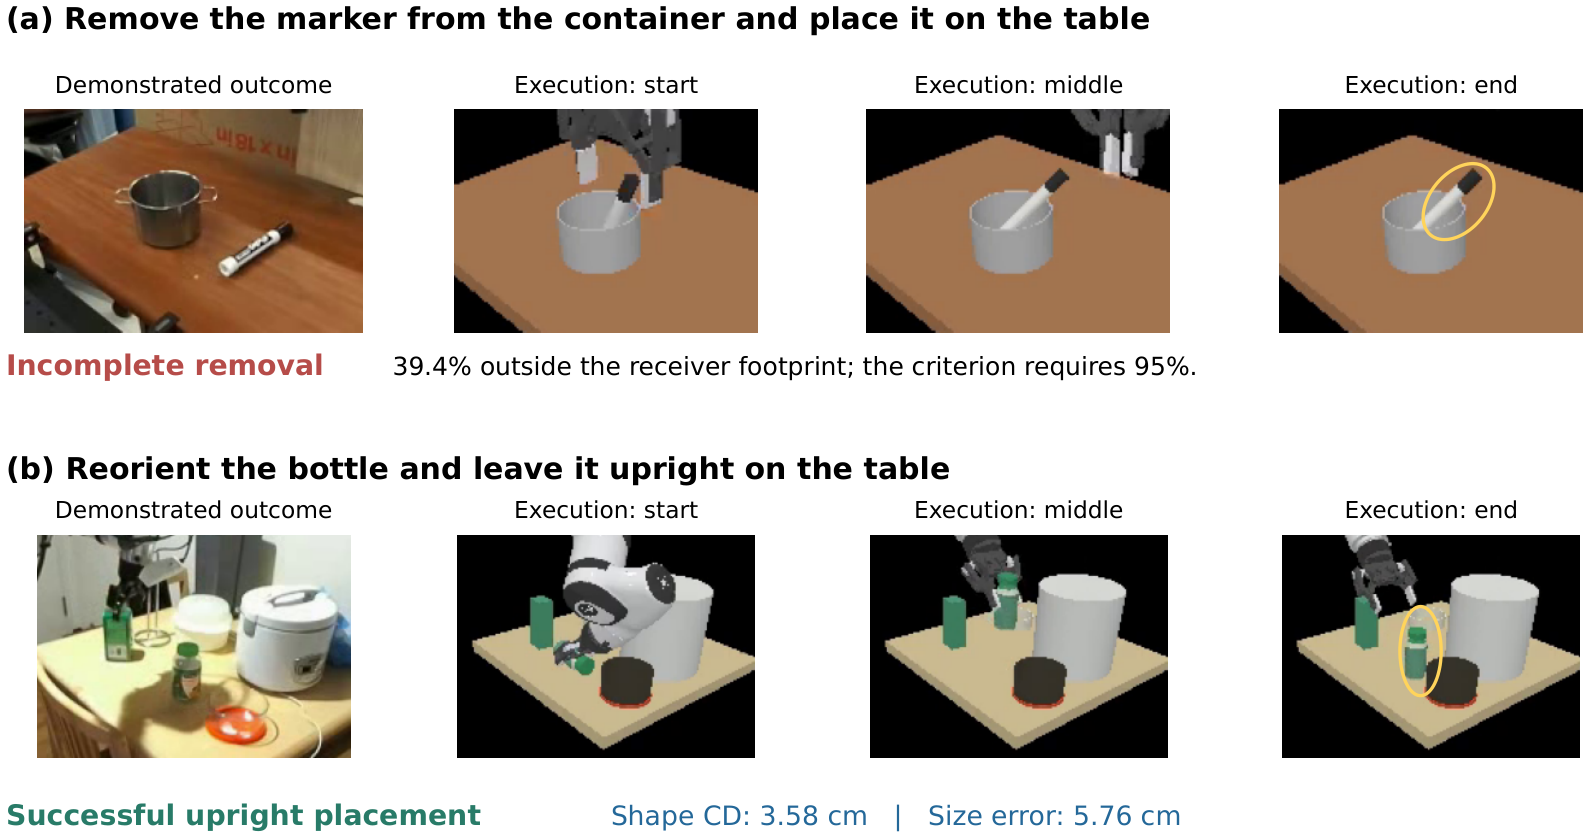
论文 Appendix 8.4 完整公开了一次 GPT-6 Astra 在视觉反馈下反复修改后的提交(visual-refinement submission)。输入来自 DROID:83 帧、640×640、7.5 Hz;原视频取第 64–228 帧,每隔一帧抽取一次,因此可见示范约 10.93 秒。任务是抓起横放在桌上的小瓶,把它转成直立姿态,重新放到桌面并松手;目标配置是 SAPIEN + Panda + Robotiq 2F-85。
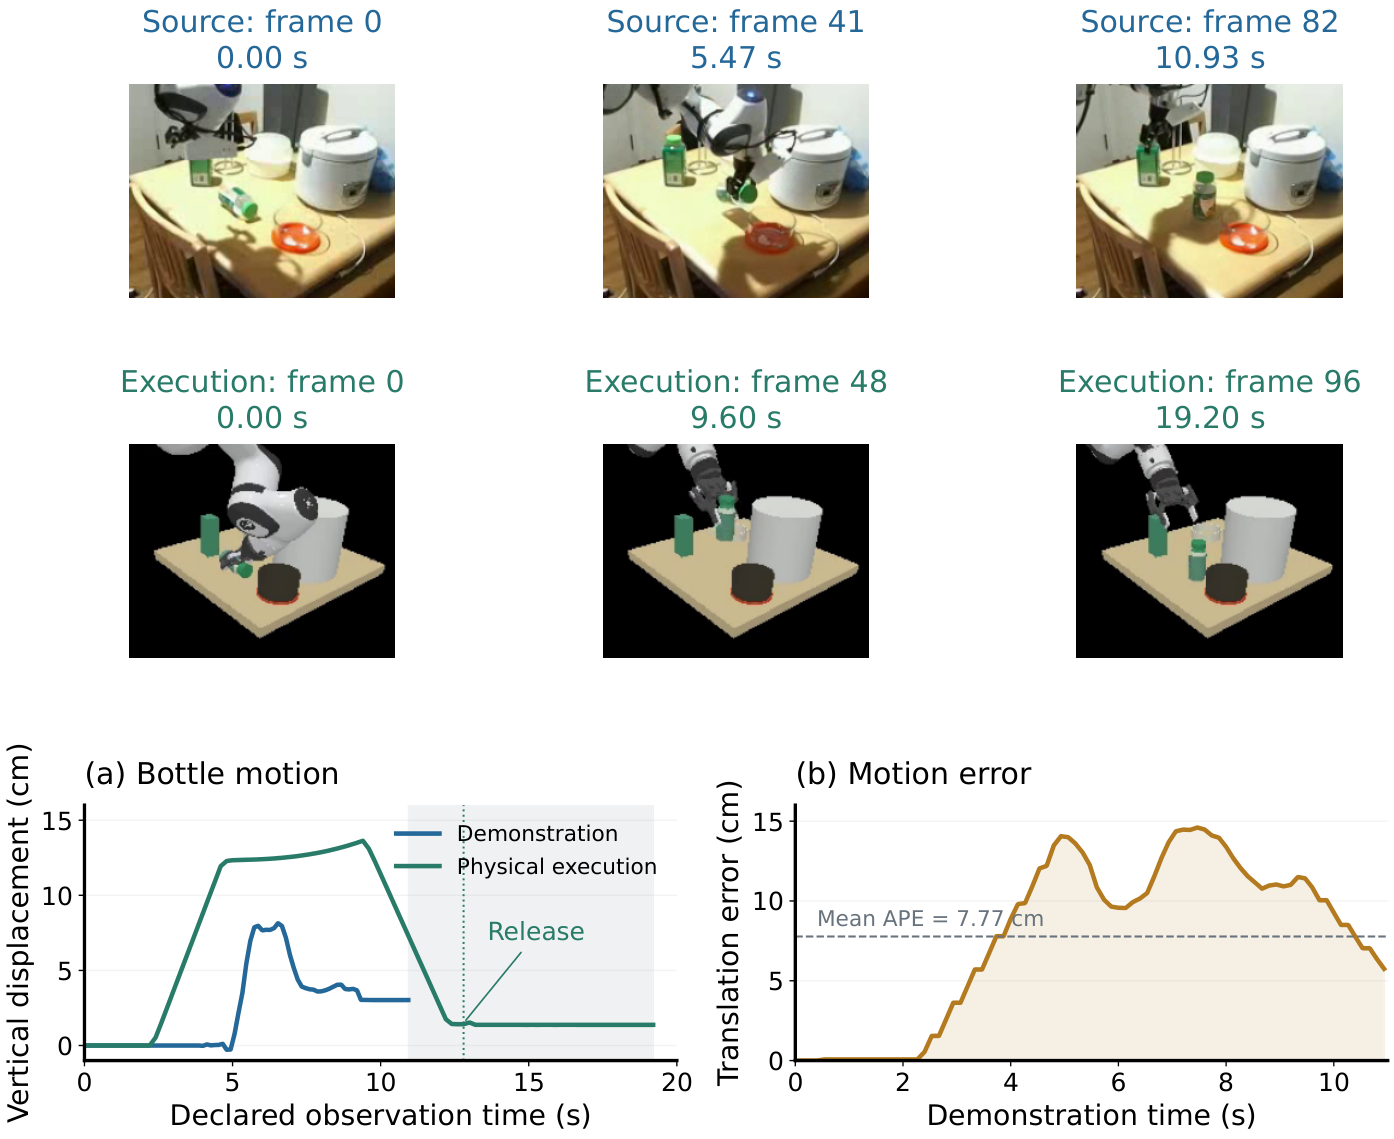
Agent 看到了视频帧拼图(contact sheet)、robot / TCP(tool center point,末端工具中心点)规范和提交格式,但没有相机标定参数、物体几何、参考轨迹、任务标注或分数。最终 package 包含瓶子 mesh、桌面与背景几何、估计的相机和 robot placement,以及 79×7 的控制数组(dt=0.2 s)和 83×7 的预期物体位姿。预期位姿仍然只是声明;evaluator 从实际 physics rollout(物理执行记录)中采集了 97 个物体状态。
执行时间线说明了为什么不能只比较视频帧:0.4 秒抓住瓶子,2.6 秒开始移动,12.8 秒松手,19.2 秒才完成终态判定。运动轨迹误差只在 83 个示范时间戳上比较;示范结束后的 41 个执行状态不进入 motion score,但 task judge 仍会用它们确认物体最后是否稳定。
Judge 具体看什么?
官方 v2w/metrics/task.py 中,这个 upright-bottle family 的最终逻辑可简化为:
# simplified from official task.py:652-675
geometry_ok = supported and angle_deg <= 30
success = geometry_ok and released and quiescent
还要先通过 gate_initial_goal:如果瓶子一开始已经直立,Agent 什么都不做不能得分。这个实例要求瓶子最后由提交中声明的 tabletop(桌面支撑体)托住,support gap 小于 0.01 mm,瓶轴和桌面法线约差 0.009°,机械手已经松开,且处于 quiescent/rest(物体运动足够小的静止状态)。公开门槛还包括 30° 的直立容差、1 cm 的支撑间隙和 5 mm 的桌面边界余量。
最终它得到 Build=1、Task Success=1、Progress=100%;Scene CD 2.51 cm、Shape CD 3.58 cm、Size error 5.76 cm、T-APE 7.77 cm、R-APE 9.27°、T-RPE 0.68 cm。initial centre error(初始中心位置误差)达到 24.80 cm,但任务仍然成功。judge 同时检查可执行结果与多类误差,并不要求第一帧完全一致。
V2WScore 怎样合成?
对一个越小越好的误差 e,先按阈值 τ 转成 [0,1] quality:
其中 Scene / Shape / Size 的 τ=10 cm,T-APE 为 20 cm,R-APE 为 90°,T-RPE 为 10 cm。然后:
G = applicable geometry qualities 的平均
D = applicable dynamics qualities 的平均
V2WScore = Build × (F + G + D) / 3
分数先在 instance 内计算,再对同一 task family 汇总,最后让 39 个 families 等权平均并乘 100。这样,大 family 不会仅凭实例多就支配总分,build failure 也会把该实例的复合分数压到 0。
把上述瓶子案例代入公开公式,可得到 F=1、G≈0.605、D≈0.814,重算结果约为 80.6 / 100。论文明确说这个 worked example 没有发布正式的 per-instance composite score;80.6 只用于解释公式,不是论文报告的官方数值。
Q5. 九个系统表现如何,这对下一步研究意味着什么?
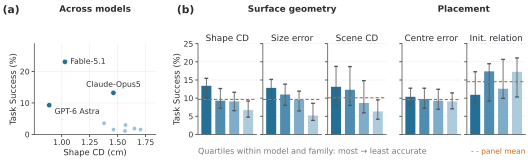
Fable-5.1 的整体结果最好,GPT-6 Astra 的对象层几何误差更小,Claude Opus 5 的 Task Success 又高于 Astra;所有自动系统与人类辅助重建之间仍有明显距离。
| Method | V2WScore | Build | Success | Progress | Scene CD | Shape CD | Size | T-APE | R-APE | T-RPE |
|---|---|---|---|---|---|---|---|---|---|---|
| HAR | 74.24 | 100.0 | 58.8 | .70 | 2.19 | .15 | .43 | 9.40 | 41.09 | 2.42 |
| Fable-5.1 | 48.52 | 93.1 | 25.5 | .53 | 5.35 | 1.00 | 2.78 | 18.71 | 104.61 | 8.25 |
| GPT-6 Astra | 43.55 | 93.1 | 10.7 | .33 | 6.23 | .69 | 1.62 | 20.78 | 95.08 | 6.19 |
| Claude Opus 5 | 41.56 | 92.8 | 16.0 | .34 | 6.01 | 1.14 | 3.13 | 19.37 | 110.85 | 8.42 |
| Kimi K3 | 33.19 | 92.0 | 4.8 | .21 | 8.08 | 1.41 | 4.23 | 27.28 | 111.16 | 14.29 |
| GPT-5.6 Sol | 31.00 | 92.5 | 2.5 | .11 | 7.79 | 1.37 | 3.76 | 31.68 | 105.03 | 18.00 |
| DeepSeek V4.1 Flash | 30.54 | 92.4 | 4.1 | .13 | 8.59 | 1.50 | 4.13 | 34.64 | 104.52 | 20.85 |
| Gemini 3.8 Flash | 30.11 | 93.1 | 2.0 | .09 | 8.57 | 1.25 | 3.67 | 37.97 | 114.82 | 28.65 |
| Qwen3.8 Max | 26.55 | 87.6 | 1.5 | .11 | 8.36 | 1.51 | 4.13 | 41.28 | 110.06 | 27.38 |
| GLM-5.3 Flash | 25.69 | 87.7 | 2.0 | .09 | 9.58 | 1.62 | 5.04 | 41.16 | 103.83 | 30.16 |
这些列必须分开读。Fable-5.1 的 V2WScore 48.52、Task Success 25.5% 和 Scene CD 5.35 cm 都是自动系统第一。Astra 的 Shape CD 0.69 cm、Size error 1.62 cm、R-APE 95.08° 和 T-RPE 6.19 cm 最好,但 Task Success 只有 10.7%,低于 Opus 5 的 16.0%。所以它更像“物体形状和部分轨迹指标更准”,不能概括成“整个重建最准确”。
HAR 不是“只看同一段 RGB 的人类上限”
Human-assisted reconstruction(HAR,人类辅助重建)可以使用原始 CAD、RGB-D、相机标定、robot logs、task predicates、隐藏分数并反复人工调试。它的 V2WScore 是 74.24;Task Success 按 39 个 families 等权平均为 58.8%,按实例计则是 113/222,即 50.9%。失败里有 19 个因物理有效性被拒,18 个所在 family 没有任何通过执行,7 个 near miss(接近成功)和 65 个 controller failures(控制器未完成任务)。作者没有系统记录人工工时,部分实验批次留下了大量物理试跑。因此 HAR 是使用额外信息和工程调试得到的参考结果,并非与 Agent 同信息条件的人类基线。
成本、人工偏好与跨场景执行
九个系统合计约花费 9,700 美元、1,044 agent-hours 和 286 L40S GPU-hours。Fable 平均每个 episode 14.03 美元、37.5 分钟;Astra 6.40 美元、14.6 分钟;Opus 13.83 美元、32.6 分钟;Kimi 平均 82.2 分钟,是最慢的一组。论文没有把性能、API 价格与 wall-clock 合成一个效率指标。
human study 由 12 名内部评审完成,共收集 243 个有效的两两比较、覆盖 39 个 cases,再用 Bradley-Terry 模型汇总成 Human Preference Rating。评审来自作者与公司员工,不是独立外部评测。它补充了人对场景和交互相似度的判断,不能替代隐藏物理 judge。
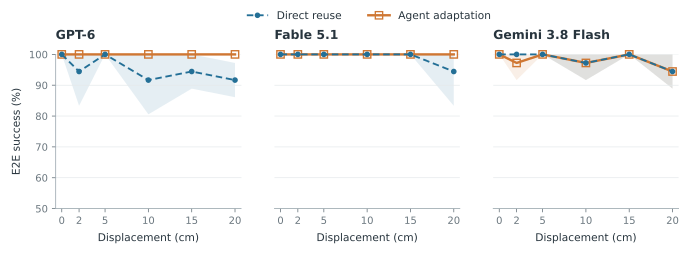
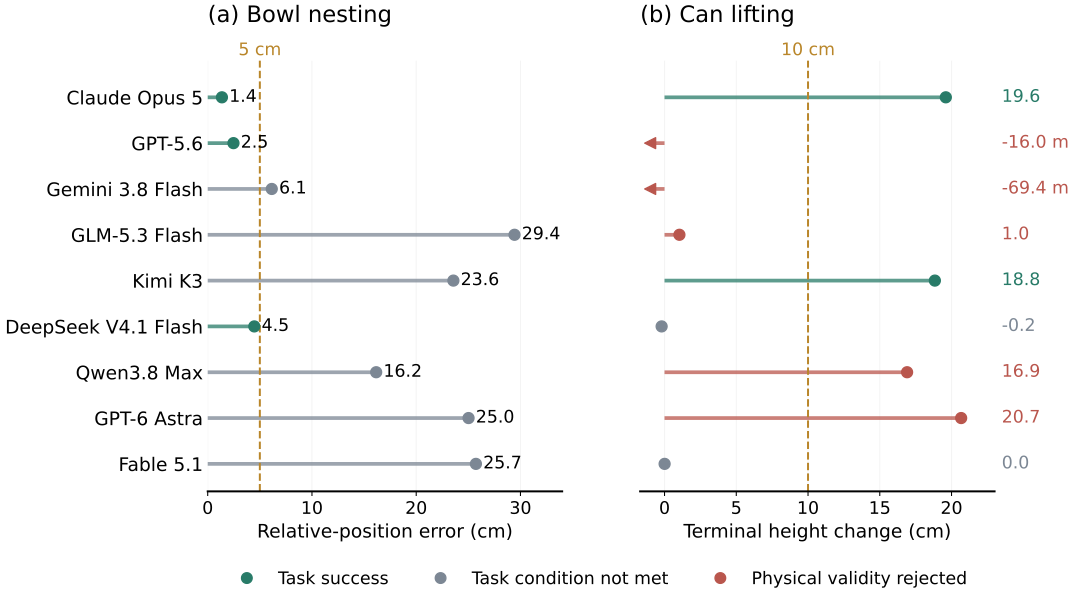
论文还测试了 9 段原视频、3 个模型在 shifted layouts(把物体或目标位置平移后的新布局)上的执行:每个模型 180 次,共 540 次。直接复用原控制成功 525/540(97.22%);让 Agent 做 adaptation(针对新位置调整)后成功 536/540(99.26%)。调整修复了 15 个直接复用失败案例中的 13 个,同时破坏了 525 个原本成功案例中的 2 个。这个结果只覆盖 initial reconstruction 已成功 的条件,不能解释最困难的“第一次从视频造出正确世界”。
Q6. 这篇论文真正证明了什么,还有哪些问题没解决?
它最扎实地证明了:单段 embodied video 到可执行 simulator package 已经可以被标准化评测,强 coding-agent 系统能完成一部分任务,但可靠重建仍远未解决。
最明显的报告问题是统计分母(denominator)。附录 9.4 说主评测固定使用 222 instances、39 families,build failure 在 Build / Success / Progress 中计零;附录 9.5 又列出 S0=215 个 Agent 实际评测的实例、S2 primary=179、S1 HAR-pass=112。Table A12 还写着“S2 is the primary set used in Table [missing label]”,但 HTML / LaTeXML 的交叉引用缺失。论文没有解释 222 与 215 的七个实例差额,也无法确定这里指哪张表。
Table 2 的 Fable 25.5% 是 39 个 families 等权的 Task Success;Table A12 的 19.1% / 20.6% / 24.2% 则使用三个按实例计算的分母。两组数统计口径不同,不能互相代换。这个缺口不推翻主结果,但会妨碍复现者核对样本过滤和失败计零方式。
我的判断是:Video2World 已经给出一套完整的 benchmark framework。它把 submission package、真实物理执行和 task-specific judge 组合起来,比只看截图的 world-generation 评测更接近可用系统。结果也保留了重要的失败:大量 Agent 可以生成能加载的场景,却无法把对象稳定抓起、移动并放到正确状态。下一步应把失败分别归到视频测量、场景构建、robot retargeting(把示范动作转换到目标机器人上)、控制器生成、物理参数校准和 judge 设计,再在相同 harness 与相同预算下比较方法。
主要来源:Video2World arXiv v1 全文与全部附录;官方仓库 revision 44b1760c52cc14e519aa88b5a91c374e09b81653;官方 benchmark 文档、评分实现 v2w/scoring.py、配置 v2w/config/score.json 与 task judge v2w/metrics/task.py。论文图像依 CC BY-SA 4.0 引用,官方代码为 Apache-2.0。检查日期:2026-10-06。
留言