同一组数学题上,Qwen2.5-3B 直接学习专家答案后,准确率从 0.315 降到 0.243。作者让基础模型先改写专家解答,再做监督微调(SFT:用固定题目与答案训练模型)。论文推导的是按接受概率采样的算法;公开代码只保留基础模型评分更高的改写。这两个算法的保证不能混用。
1. Motivation:正确答案也可能不适合学生直接学习
正确数据仍可能不适合当前模型学习,因为它的 token 序列离当前模型的生成分布太远。
普通 SFT 把专家回答当成唯一目标,不考虑基础模型原本会如何表达。模型为了拟合一条低概率轨迹,可能发生较大的参数更新,并让新任务的表述方式干扰旧能力。同策略强化学习和自蒸馏通常更稳定,因为训练样本来自当前模型附近;代价是困难样本很难生成成功回答。
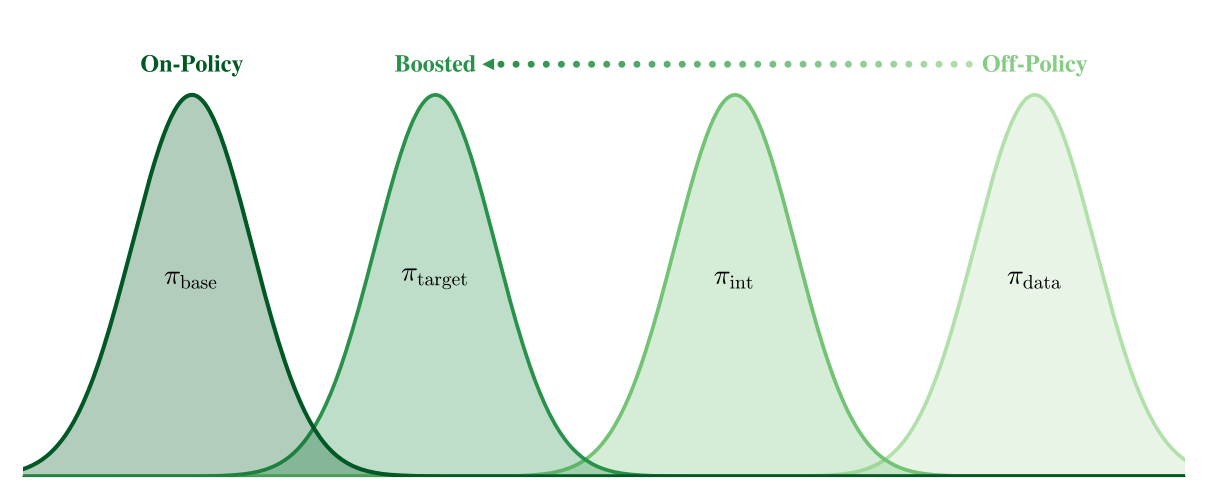
作者保留 SFT,但先用基础模型重写数据。专家解答仍放在生成提示词里,作为模型平时看不到的额外信息;新生成的后缀则来自基础模型。因此候选回答可以保留答案内容,同时更接近待训练模型自己的表达分布。
2. Related Work:改损失、在线训练与先改数据
这篇论文在训练前改写数据,让样本更接近待训练模型自己的分布。
GRPO 和自蒸馏用当前模型生成训练信号;重要性加权与 KL 约束方法改训练损失。Sampling SFT 仍用普通交叉熵,差别发生在训练开始前。下面的表保留了各方法取得专家信息的位置。
展开六种方法的输入与训练差别
| 方法 | 专家信息怎样进入 | 改变什么 | 困难任务的限制 |
|---|---|---|---|
| 普通 SFT | 直接拟合专家轨迹 | 不改训练目标,也不改数据 | 数据可能离学生模型的分布很远。 |
| 重要性加权 / KL 约束 SFT | 仍使用原始专家数据 | 修改损失函数,或增加 KL 约束来限制新旧模型的回答分布差异 | 需要可靠的重要性比率或正则项。 |
| GRPO | 普通基线不提供专家轨迹 | 按当前模型的多次回答和正确性奖励更新模型 | 全组答错的困难题没有相对训练信号。 |
| UFT(统一监督微调与强化学习) | 本实验把专家轨迹作为生成时的额外上下文 | 用专家信息帮助产生回答,再进行同策略训练 | 与普通 GRPO 的上下文不同,不能合并为同一信息设置。 |
| OPSD(同策略自蒸馏) | 基础模型在额外上下文下充当教师 | 做自蒸馏 | 每次训练需要教师分布或多次生成结果。 |
| Sampling SFT | 专家解答约束候选改写 | 先改变数据分布,再做普通 SFT | 需要大量生成计算,并依赖改写前后语义不变。 |
把 MCMC(马尔可夫链蒙特卡洛) 用于语言模型并非这篇论文首次提出。已有工作用 MCMC 让采样分布偏向外部奖励,或偏向更集中的推理分布;这里从别的策略提供的专家数据出发,改写后的结果用于继续微调,而不是只改善推理时生成的样本。
3. Method:目标分布、理论采样与公开近似
论文给出一个严格的目标分布和 Metropolis-Hastings(MH,一种按接受概率在候选答案间移动的采样算法)推导;实验代码采用更激进的近似。
固定一个问题,并令 C 表示所有与专家轨迹信息等价的回答。理想目标是:
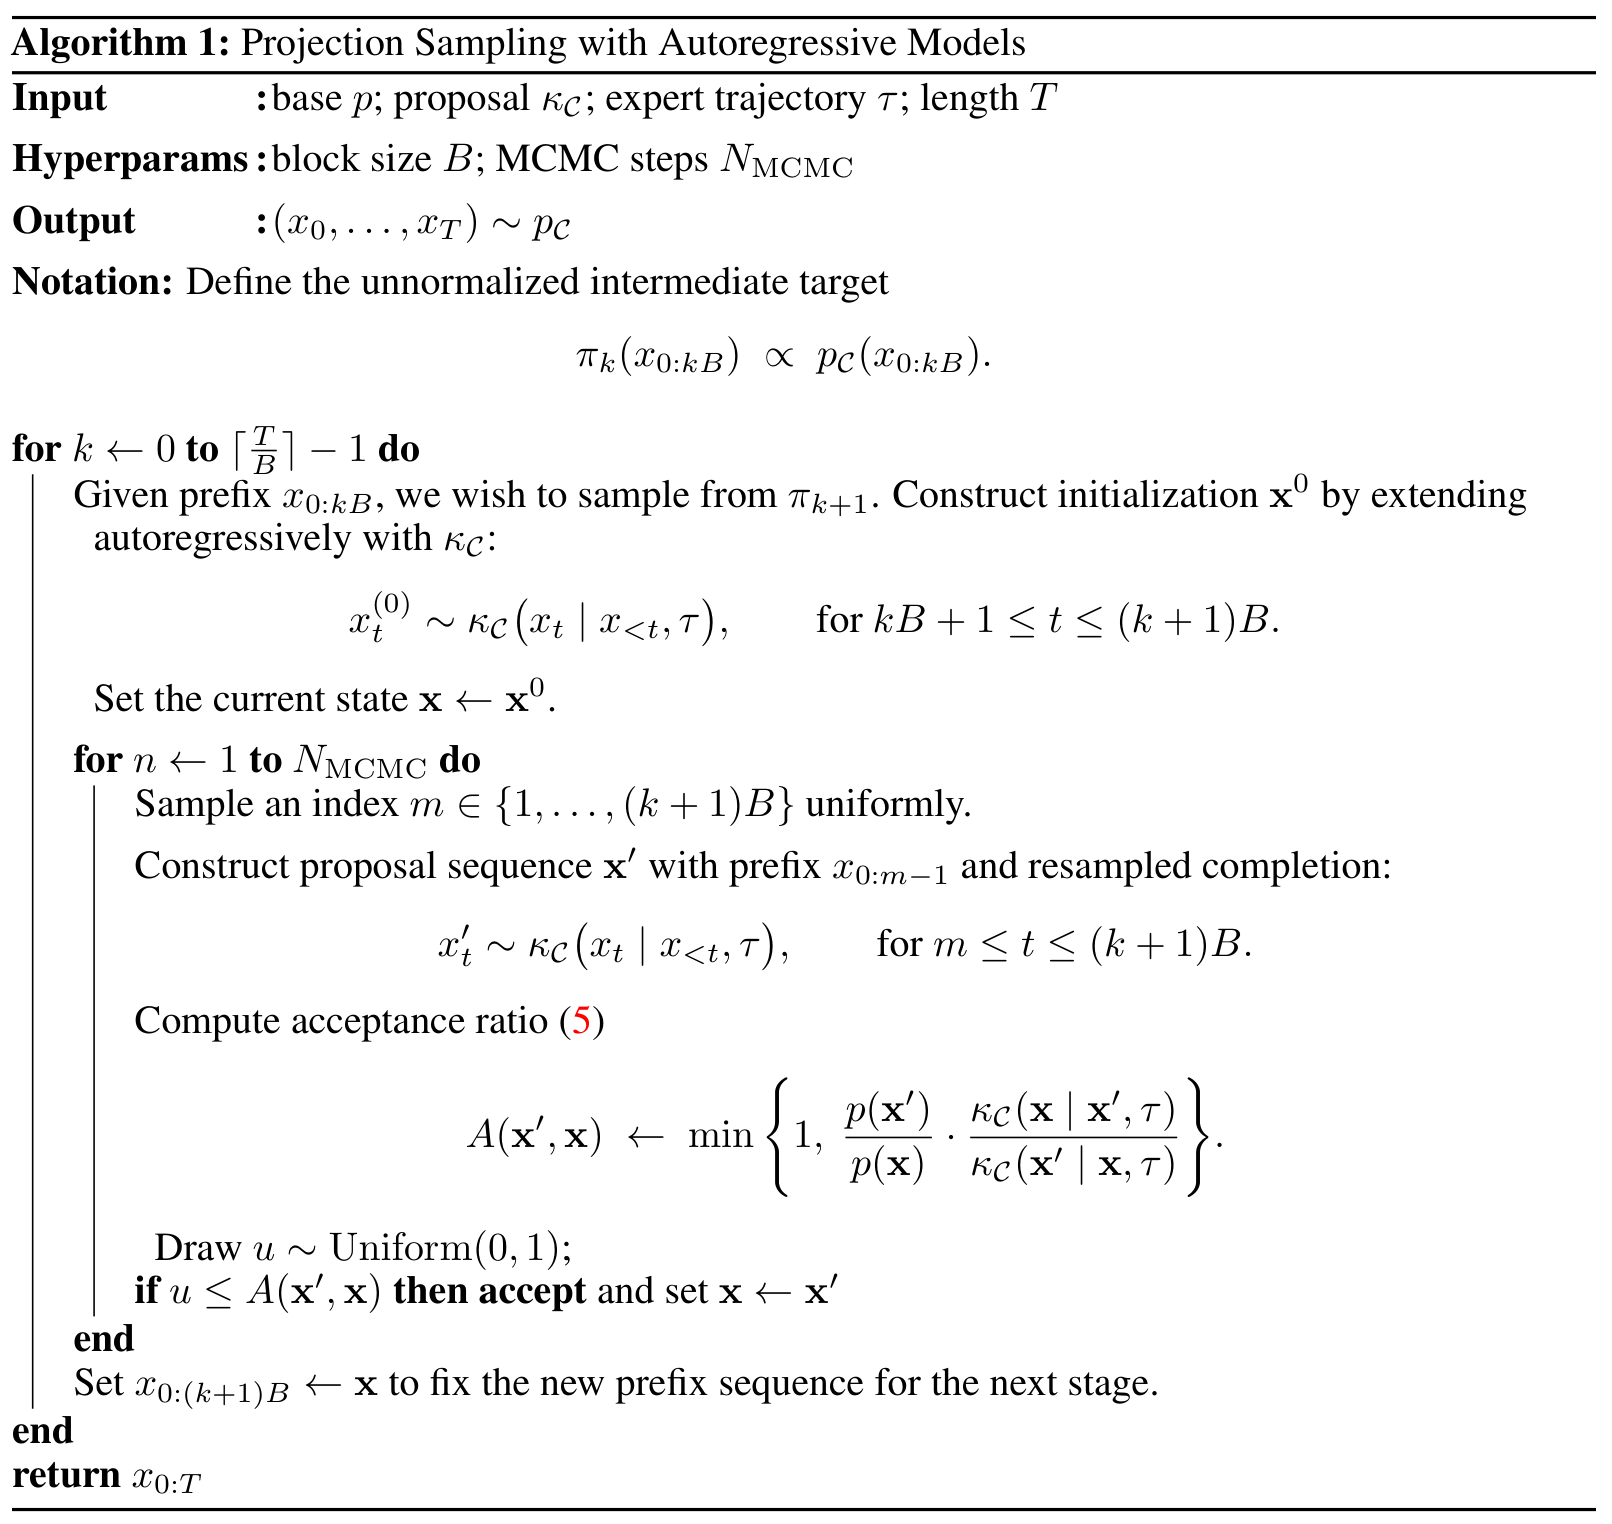
也就是把基础模型的分布限制在正确集合 C 内。第 4.2 节先讨论以专家轨迹为初始状态的理想链;具体算法 1 则把专家轨迹放入生成上下文,从空前缀逐块扩展回答。每次更新随机选择切分点,把当前前缀、原题和完整专家解答一起交给基础模型,让它重写后缀。理论接受概率还应考虑从旧回答提议新回答、以及反过来提议旧回答的概率。
3.1 一次公开实现的更新,模型看到什么
数据生成阶段基础模型冻结,没有梯度更新。proposal_vLLM 让它看到原题、完整专家解答和当前前缀,继续生成后缀;get_logprobs_vLLM 给候选打分时却只提供原题,不提供专家解答。这两个上下文必须分开:前者借答案引导改写,后者测学生不借答案时是否更容易生成这段文字。
脚本从空前缀开始,先扩展一个块,再在现有 token 中随机切分、重写后缀。当前 token 列表被候选替换,模型权重不变。全部数据生成完后,才用普通交叉熵 SFT 更新另一份基础模型副本。因而它不是每步都在线更新的 OPSD。
# 摘自官方 boost_sci.py / boost_math.py
target_log_prob_prop = get_logprobs_vLLM(p, question, prop)
if target_log_prob_prop[0] > target_log_prob_cur[0]:
    gen = prop
    target_log_prob_cur = target_log_prob_prop
get_logprobs_vLLM 返回回答中各 token 在基础模型下的平均对数概率。代码只在候选改写的平均对数概率更高时替换当前回答,没有计算正反向提议概率之比 κ(x|x') / κ(x'|x),也没有按照接受概率随机接纳概率下降的候选。因此公开实现更接近只向高处移动的贪心爬山。附录 C.2 将它称为近似,并说明这样做是为了少算一次反向提议所需的模型前向计算。
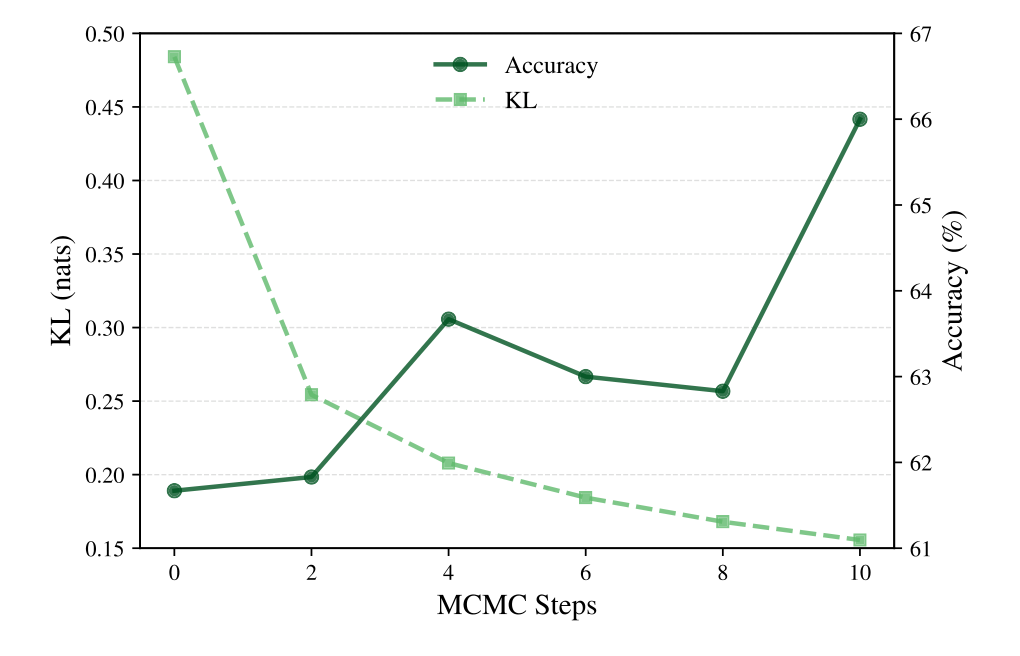
这处差别影响理论边界:论文关于 MH stationary distribution(经过足够多步后保持不变的目标分布) 和逐步逼近 p_C 的结论,只适用于理想的转移规则,不能直接当作公开代码的保证。图 5 只能说明在作者的化学实验中,随着更新次数增加,估计的 KL 距离降低且准确率上升。
3.2 三条理论保证分别说了什么?
论文的 Proposition 1 证明 p_C 是所有满足答案约束的分布中,对 p_base 做 KL 投影得到的唯一解。Proposition 2 把这个难以直接采样的目标改写成可执行的 MH 转移:对 p_C 使用普通 proposal,与对 p_base 使用保证答案等价的 proposal,会得到相同的接受规则。Proposition 3 说明,在这些条件成立时,第 k+1 步数据分布到基础模型的 KL 距离不会大于第 k 步,即 KL(π_{k+1} || p_base) ≤ KL(π_k || p_base)。
第三条保证说的是理想链每走一步都不会离基础模型更远,不代表每条样本的概率严格上升,也不适用于删去了完整接受概率的公开贪心代码。
3.3 逐块采样与计算成本
Algorithm 1 把专家轨迹作为 proposal 的输入,按块扩展当前答案。每生成一个新块,算法就在已有部分中随机选切分点,用原题、专家解答与保留的前缀生成同长度候选;随后按完整 MH 接受概率决定是否替换,并在当前块内重复 N 次。完成一块后固定当前结果,继续下一块,直到达到最长序列长度 T。论文实验使用 T=1,856、N=10、块大小 B=32。
附录 Eq. 9 给出的理论生成量是 T²N / (4B)。代入上述参数得到 1,856² × 10 / (4 × 32) = 269,120,也就是每条轨迹约 26.9 万个生成 token。它是一次性数据改写的量级估算,不含完整的打分前向计算、失败重试、GPU 吞吐或美元成本。换一个基础模型后,目标分布也随之改变,数据原则上需要重新采样。
展开原论文 Algorithm 1 的完整步骤与接受公式
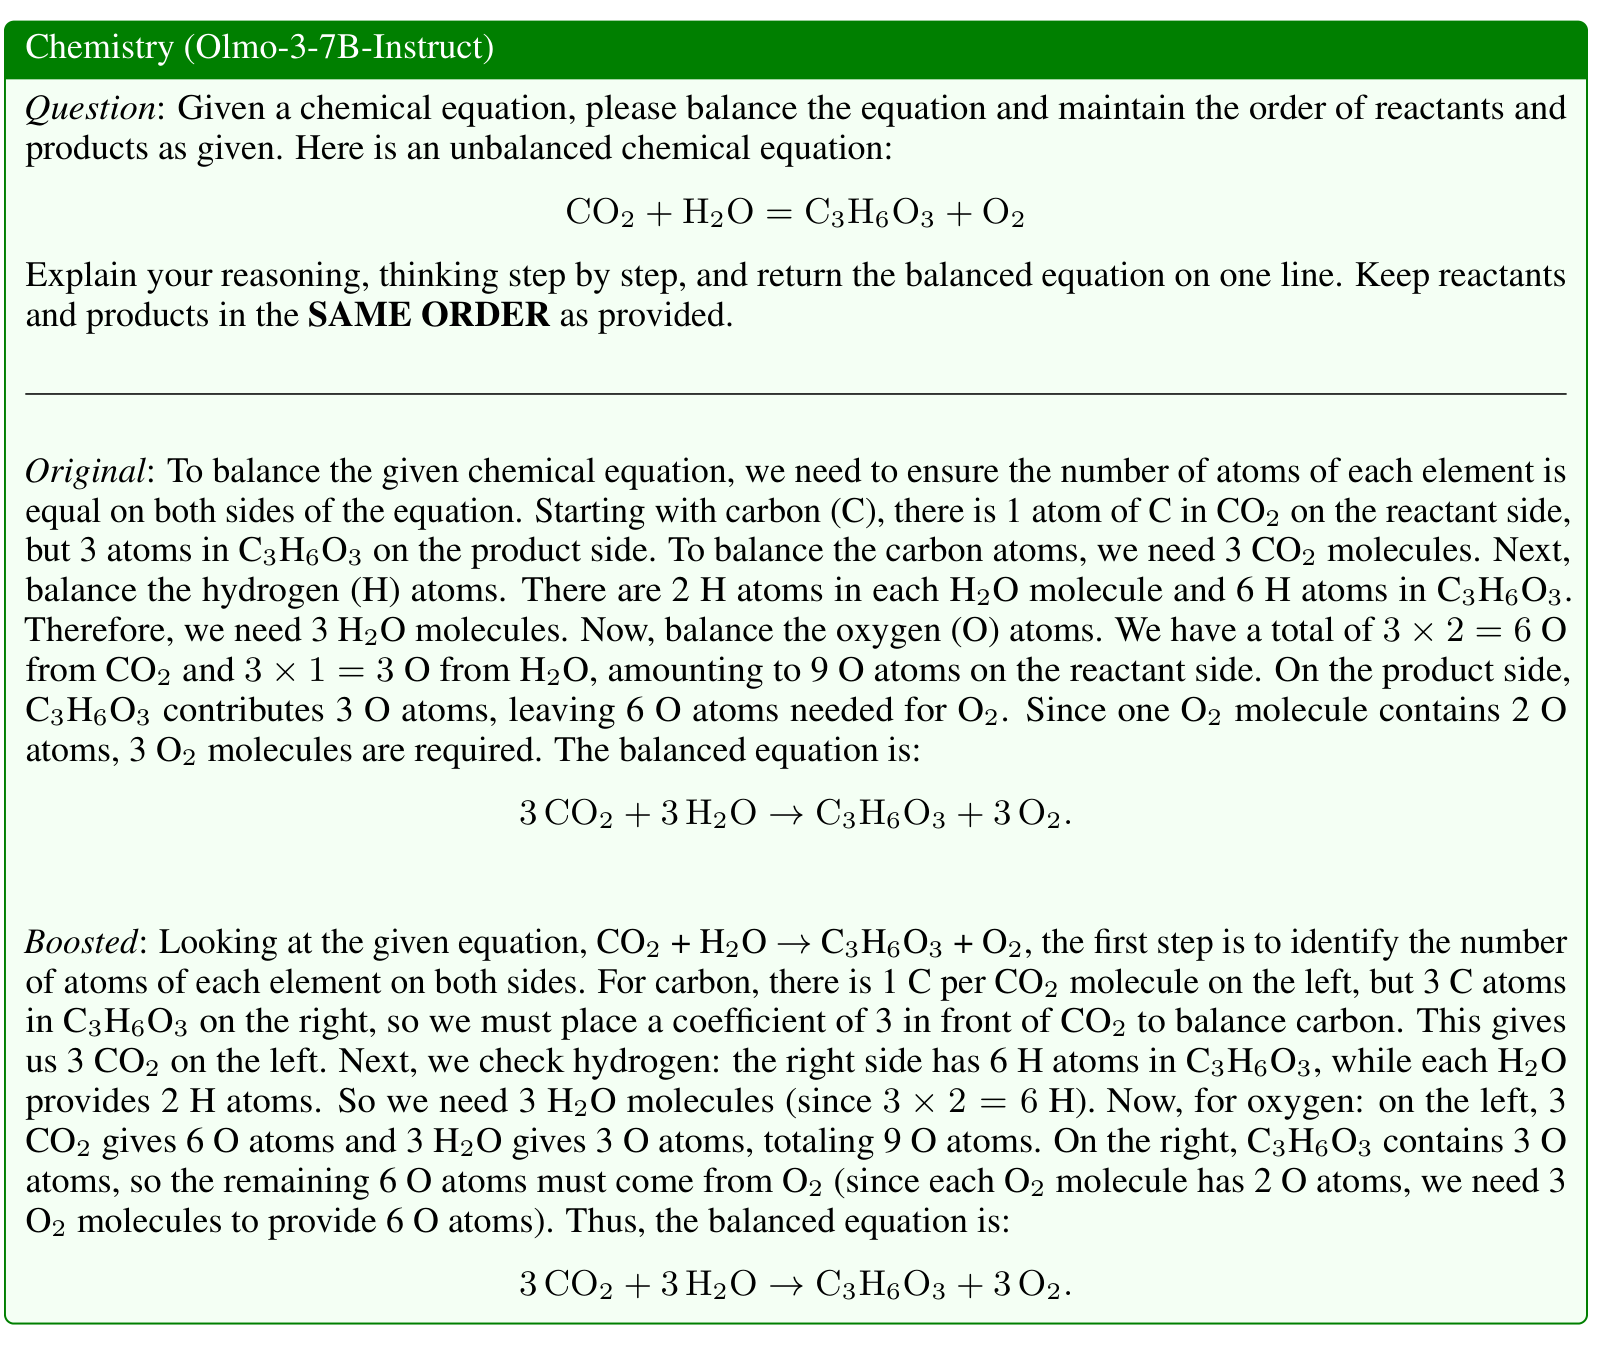
3.4 真实案例:附录 A 的化学方程式
CO₂ + H₂O → C₃H₆O₃ + O₂
- 来源:论文附录 A 的 Chemistry (Olmo-3-7B-Instruct) 发布了原始与改写回答;化学专家数据由 GPT-5 生成,改写逻辑对应公开
boost_sci.py,不是人工标注的逐步轨迹。 - 输入:问题要求配平方程,并保持反应物与生成物的原有顺序。专家解答给出正确系数和推理过程。
- 候选改写:代码随机选择一个 token 位置,把当前前缀与完整专家解答放进化学任务提示词,重新生成剩余后缀。
- 接受条件:只有候选改写在基础模型下的平均对数概率高于当前回答时,代码才会保留它。
- 生成结束后,官方
same_balanced_equation_olmo从回答末尾提取方程,统一 Unicode 下标和箭头,再把左右两侧解析成有顺序的“整数系数、分子式”列表,与参考答案逐项比较。返回的相等判断写入is_correct;它并不重新计算原子是否守恒。 - 公开结果:原回答与改写回答都给
3 CO₂ + 3 H₂O → C₃H₆O₃ + 3 O₂,系数为(3,3,1,3)。左边 C/H/O 为 3/6/9,右边也是 3/6/9。论文没有给逐轮候选的概率或接受日志,不能把上面的步骤冒充实测过程。
展开附录 A 的配平题原文与两版完整答案
这里有一个实际评分边界:把系数全乘二,(6,6,2,6) 仍满足原子守恒,却不等于参考的 (3,3,1,3),官方这条比较规则会判失败。若改变反应物顺序也会失败,因为题目要求保留顺序。这些是按已发布检查器推得的反例,不是实测模型日志。
下面用 Python 3 标准库检查本例的原子数;代码为本文编写,不能替代官方参考比较器,也没有跑模型。若末项系数改为 2,右边氧为 7、左边为 9,会违反配平规则。
# 本文的算术检查:按 C、H、O 的顺序
def atom_counts(coeffs):
    a, b, c, d = coeffs
    left = (a, 2*b, 2*a+b)
    right = (3*c, 6*c, 3*c+2*d)
    return left, right
assert atom_counts((3, 3, 1, 3)) == ((3, 6, 9), (3, 6, 9))
assert atom_counts((3, 3, 1, 2))[0] != atom_counts((3, 3, 1, 2))[1]
公开脚本会把 is_correct 写进数据行,随后无条件把整条记录追加到逐行 JSON(JSONL)文件。仓库说明(README)说这些输出可以转换为 SFT 的提示词/回答数据,却没有说明是否先过滤 is_correct=0。论文报告最终改写数据集的正确率在 93.94% 到 95.86% 之间,所以“答案信息保持不变”在实现中只是经验比例,不是严格条件。
附录还提供了更强的反例:另一条化学改写仍选对分子量 150.130 g/mol,却把 oxane / tetrahydropyran 错写成 five-membered ring(五元环);它实际是六元环(五个碳与一个氧)。最终答案正确,不代表整段知识和推理都保持正确。因此 94%–96% 的输出正确率也不能证明严格的信息等价。
另一个小问题是脚本接受 --seed 参数,却固定执行 random.seed(0);传入其他随机种子不会改变 Python 的随机切分序列。
4. Experiments:新任务收益、旧能力保留与反例
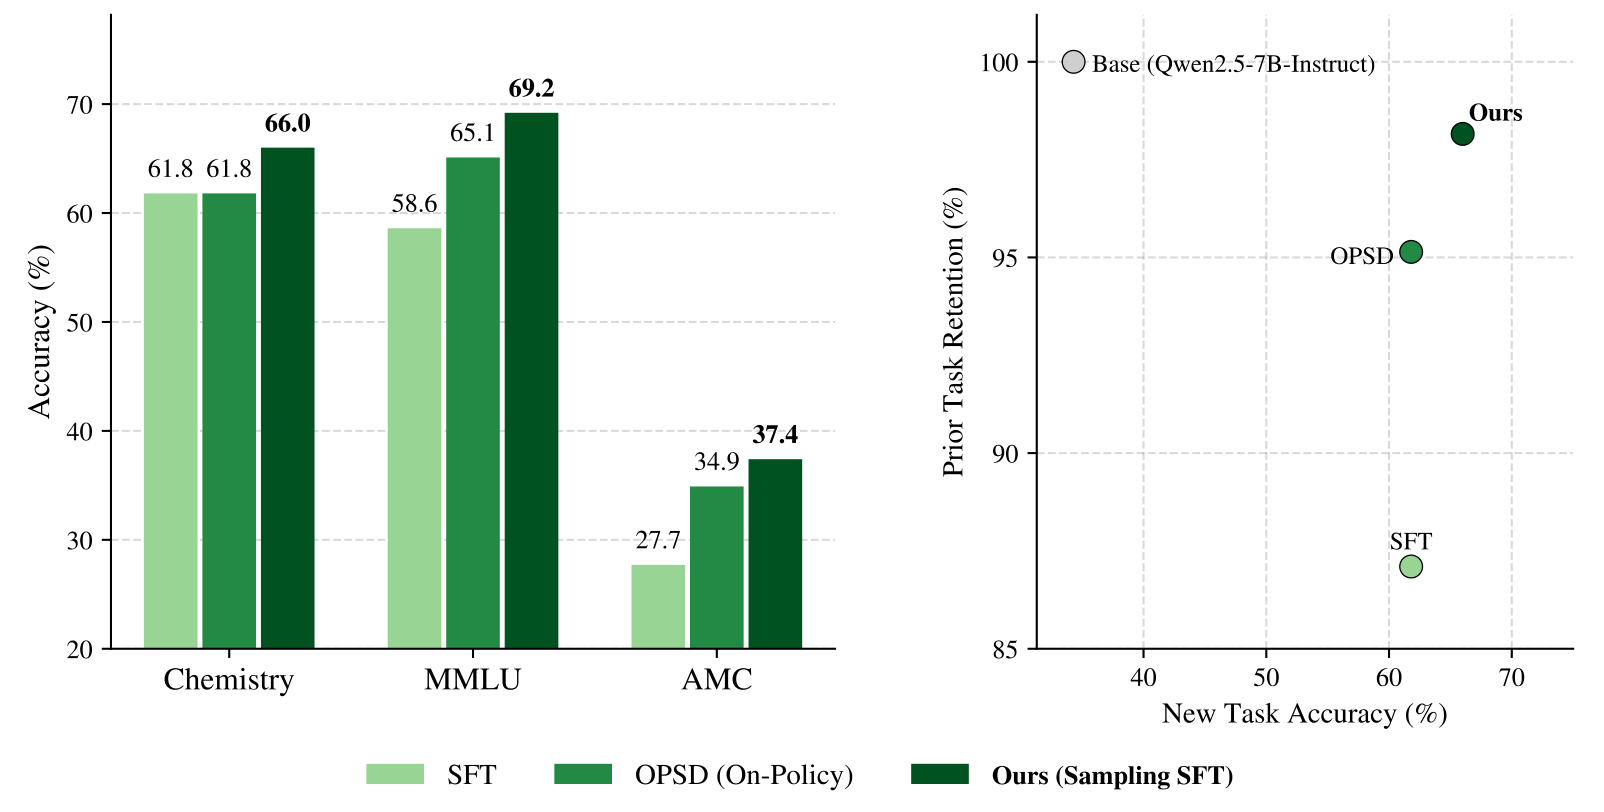
Sampling SFT 在 Qwen 数学新任务上得到 0.534,超过 GRPO 的 0.457 和 UFT 的 0.452;再接 GRPO 后达到 0.567。
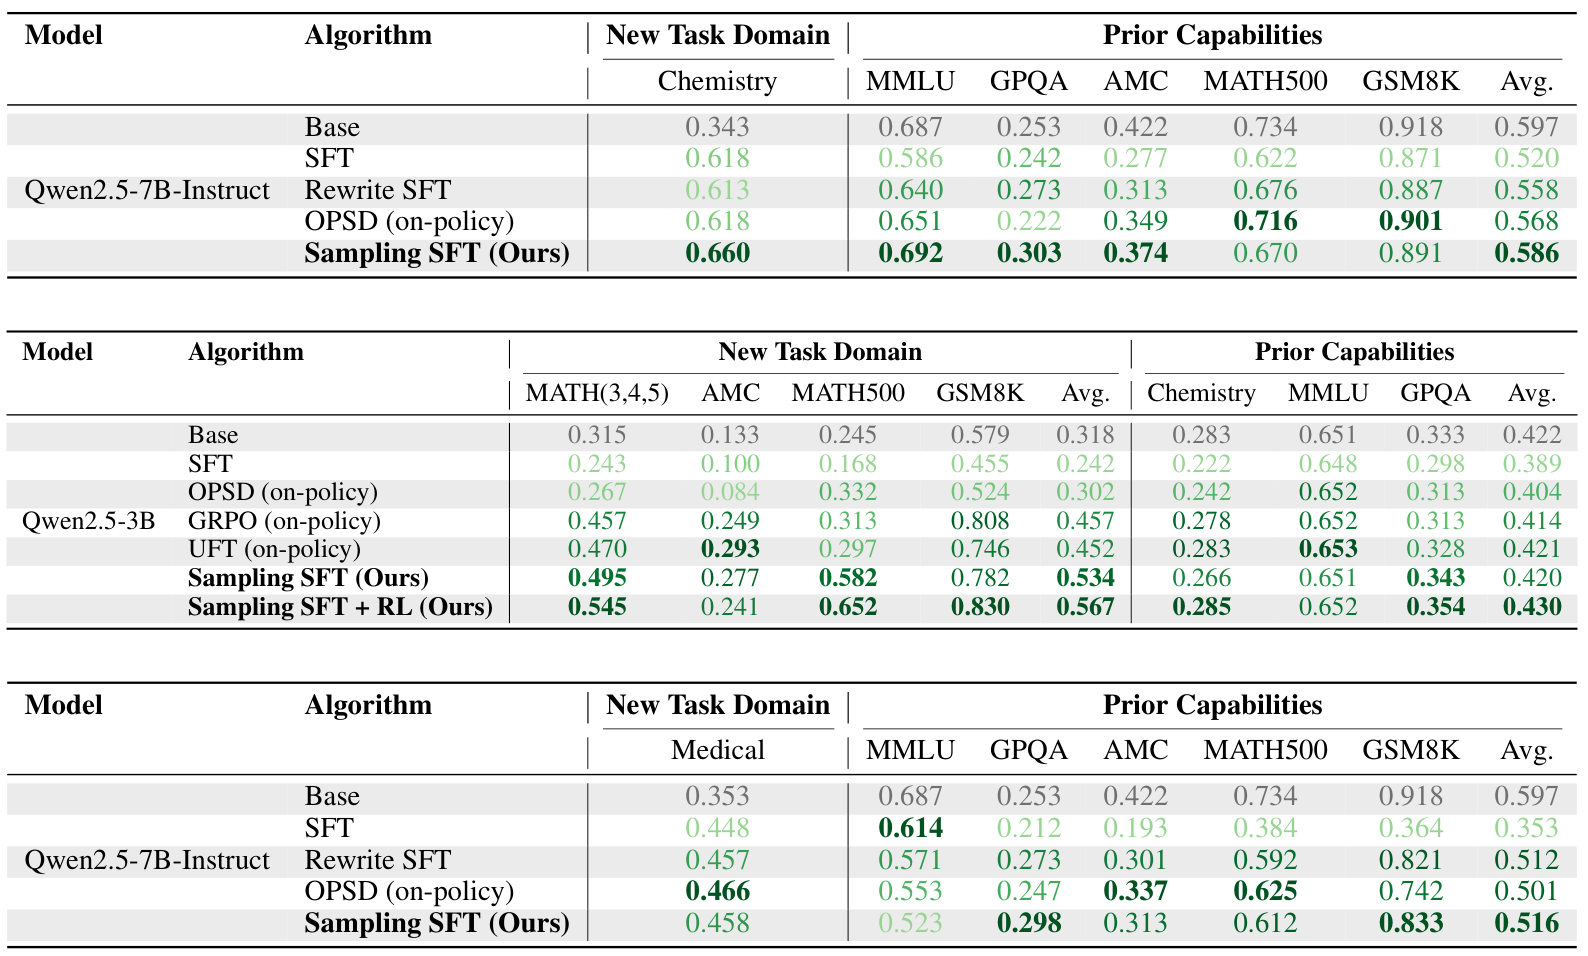
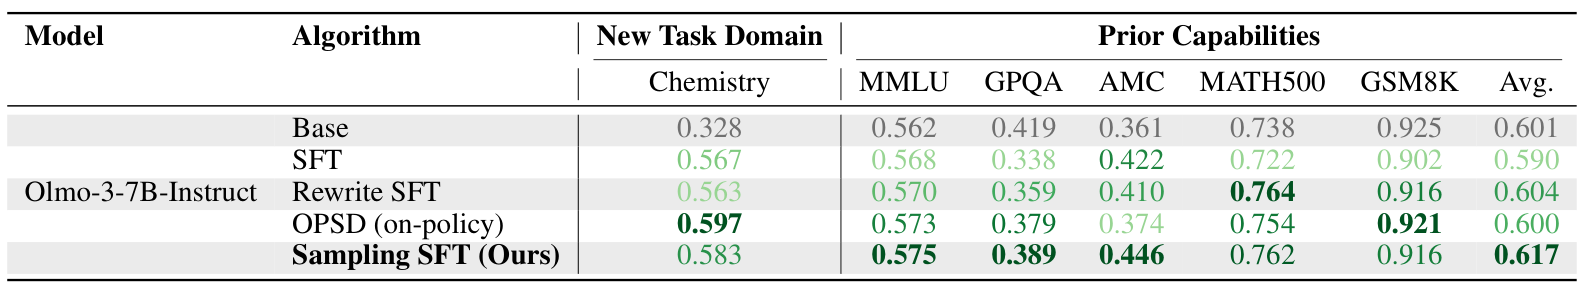
Table 1 也保留了反例:Qwen 医疗新任务上,Sampling SFT 的 45.8% 低于 OPSD 的 46.6%;附录 Table 2 的 Olmo 化学同样是 58.3% 对 59.7%。Olmo 的旧能力均分则为 61.7%,高于该表其他方法。这些比较的模型、任务和判分方式不同,不能合并成一个“全面胜出”的结论。
展开原论文 Table 2:Olmo 化学任务全部数值
在 MATH(3,4,5) 这个与训练题同分布的测试集上,Base 是 0.315,普通 SFT 降到 0.243,Sampling SFT 则达到 0.495。数学新任务平均分 0.534 等权汇总 MATH(3,4,5)、AMC、MATH500 和 GSM8K;它不是单个测试集的准确率。
旧能力方面,基础模型在 Chemistry、MMLU、GPQA 三项上的平均分是 0.422,Sampling SFT 为 0.420,保持率为 0.420/0.422≈99.5%。这只是平均数接近起点:Chemistry 实际从 0.283 降到 0.266,而 UFT 为 0.283;MMLU 为 0.651,也低于 UFT 的 0.653。UFT 的旧能力平均 0.421 略高,因此不能写成 Sampling SFT 在每项上都遗忘最少。
评测规则也按任务不同:化学选择题提取选项,配平题使用上面的参考方程比较;数学核对最终答案。医疗任务让 GPT-5-mini 读取问题、参考答案和模型回答,判断是否包含关键医学信息、有无错误或主要遗漏,最后只输出 CORRECT 或 INCORRECT。它没有独立验证整条临床推理,也没有报告人工判分一致性。
简单重写专家答案、不做后续候选更新的 Rewrite SFT 基线(论文称 0th-order MCMC)已存在:Qwen 化学为 61.3%,完整 Sampling SFT 为 66.0%。但不同方法的总生成计算没有匹配,不能只从这个差距得出迭代结构已胜过同成本重写。
一个支持作者机制解释的对照实验是跨模型数据错配:用 Olmo 改写的数据训练 Qwen,化学准确率只有 57.33%,低于普通 SFT 的 61.8%;把 Qwen 改写数据与原始数据各混一半,得到 62.14%,落在普通 SFT 与完整 Qwen Sampling SFT 之间。这说明效果依赖数据与目标基础模型的匹配,单纯把专家答案写得更流畅解释不了这组差异。
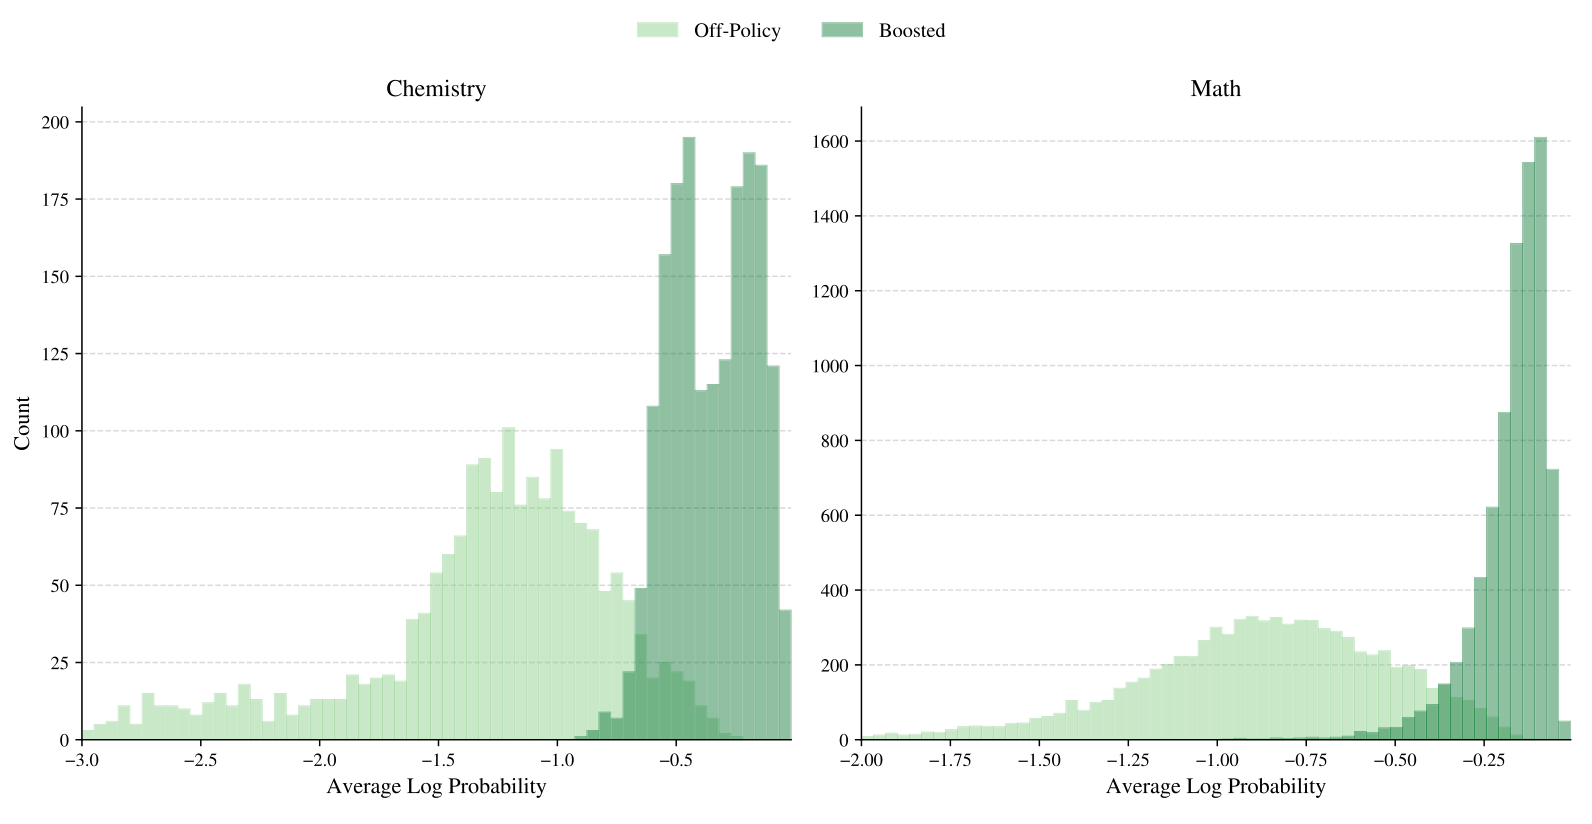
论文 Figure 3 还显示,改写后的化学和数学答案在各自基础模型下有更高的平均 token 对数概率。它验证了数据确实向模型较熟悉的表达移动;正确性则要另看附录 C.1 的约 94%–96%,不能由概率直方图推出。
展开 Figure 3:原答案与改写答案的模型概率分布
论文调过 SFT 的学习率、batch 和 epoch:学习率取 {5e−5,1e−5,5e−6},batch 取 {16,32,64},化学与数学 epoch 取 {1,2},医疗扩到 {1,2,4,6}。OPSD 按引用工作调参,RL 使用 UFT 的默认设置。它没有说明每个最终结果的全部选定参数与独立选择集,也没有给出多随机种子、置信区间或同成本对照;主表的 single-shot 只表示每题用一次回答,不代表所有训练方法同预算。
Figure 4 另做了 Olmo 化学的 pass@k:每题生成 k 次,只要有一次正确就算通过,最大检查到 k=64。Sampling SFT 在已测范围内保持高于起点的曲线,支持它扩大了可解题目范围;“64 次里一次没对”仍不能证明基础模型对该题的成功概率严格为零。医疗的 0.8 个百分点差距还依赖上述模型判分,不宜过度解读。
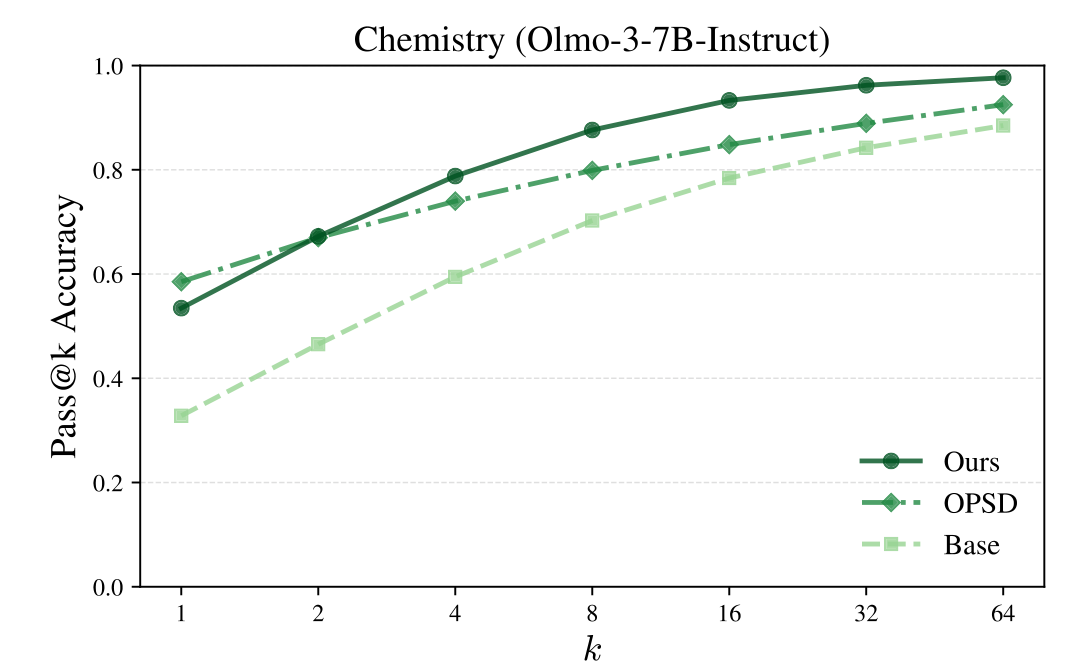
k,纵轴是至少一次答对的题目比例;它与 Table 2 的单次回答准确率是两种指标。Aayush Karan 等,原论文,CC BY 4.0。Figure 5 在 Qwen 化学任务上测试 0、2、4、6、8、10 次候选更新:估计的 KL 距离逐点下降,准确率总体上升,却在 4 到 8 步之间回落。这个观察支持继续测试采样计算量,不能当成公开贪心规则具有理论单调保证的证据。
展开 Figure 5:更新次数、KL 距离与准确率
5. Discussion:固定成本比较严格采样与简单重写
最需要的实验是在相同计算预算下,比较严格采样器、只接受概率上升的近似实现和简单改写。
第一组对照应实现论文里的完整接受概率,至少在较短序列上检查最终经验分布是否接近理论的 stationary distribution(经过足够多步后保持不变的目标分布)。第二组保留当前“只接受基础模型平均对数概率更高候选”的规则。第三组直接生成多个由专家答案引导的改写,再选平均对数概率最高的一条。三组固定候选生成次数与 token 预算,才能判断 MCMC 的转移结构是否真的贡献了额外效果。
数据方面,应明确 SFT 前是否过滤 is_correct=0,并同时报告过滤前后样本数、任务覆盖与最终准确率。若保留错误数据行,就需要解释它们为何仍属于正确集合 C;若过滤,则数据生成成本和筛选偏差都会改变。
最后,应该发布改写后的数据集、每轮候选被接受或拒绝的记录、模型存档,并补充多随机种子实验。当前仓库只包含化学/数学数据生成和评测脚本,没有医疗任务的数据生成流程,也没有声明仓库许可证。README 说明生成程序会输出接受轨迹字段 trace_boosted,仓库里仍没有作者实验对应的实际轨迹文件。
6. Conclusion:先改数据的价值与理论实现缺口
先改造训练数据再做 SFT 值得继续研究;实验显示它能改善新任务准确率与旧能力保留之间的折中,但“MCMC 保证”与公开算法之间仍有明显缺口。
最可复用的操作是让目标学生模型参与生成自己的训练答案:专家解答约束内容,学生模型重写表达,随后仍做普通 SFT。Qwen 化学和数学结果说明这条路可行;医疗与 Olmo 化学的负结果限制了适用范围。公开数据约 94%–96% 正确,代码也没有执行完整 MH 接受规则。我的判断是,下一步必须在相同生成预算下对照严格 MH、现有贪心实现和简单多次改写,才能说清增益来自哪里。
主要来源:论文 v1 全文与附录、官方仓库版本 aa7080885f114fdc5d141f19c09f53008a1c061e。论文原图按 arXiv 标注的 CC BY 4.0 引用,许可于 2026-10-20 核实;代码检查日期:2026-10-07。仓库未发布改写后的数据集、训练模型存档、实际接受轨迹或医疗任务的数据生成流程。
留言