Meta-Agent Challenge 给模型 12 至 24 小时,让它在开发容器里写出一个 agent.py。开发期间,它可以提交程序、查看开发集成绩、继续修改;时间结束后,平台冻结程序,用另一组题目测试。五个领域、39 组配置中,有些程序超过了人工基线,但同一开发配置的三次成绩差异很大。论文还记录了开发接口泄露 591 个答案的真实案例。
1. Motivation:从会答题到会开发答题系统
论文要测的是模型能否通过实验写出更好的系统。只会解一道数学题,不代表它会决定采样几次、怎样合并答案、把调用额度分给哪些题;只会修一个 bug,也不代表它能设计一套稳定处理陌生软件仓库的程序。MAC 让开发者研究任务、写程序、查看开发集结果,再迭代程序,最后用未参与开发的任务检验它有没有学到通用策略。原论文 Figure 1 画出了直接答题与开发答题系统这两种评测对象。
2. Related Work:与直接解题和自动 harness 开发的区别
MAC 统一要求提交一个任务领域专用的 agent.py,允许开发者自行设计内部结构。普通 AIME、LiveCodeBench、SWE-Bench 排名的是完成题目的模型或系统;MAC 把开发过程也放进被测对象。论文引用的 Meta-Harness 提出自动搜索运行程序的方法,而 MAC 提供统一的开发时限和最终测试,评估通用 coding agent 能否完成这种开发。后来的 HarnessDev 还从弱初始系统追踪创建和演化,并检查换执行模型后的效果;它与 MAC 的分数不能直接比较。MAC 的五个领域分别给分,不要求一份程序同时解决全部任务。
3. Benchmark / Protocol:任务来源、双容器与一轮开发评测
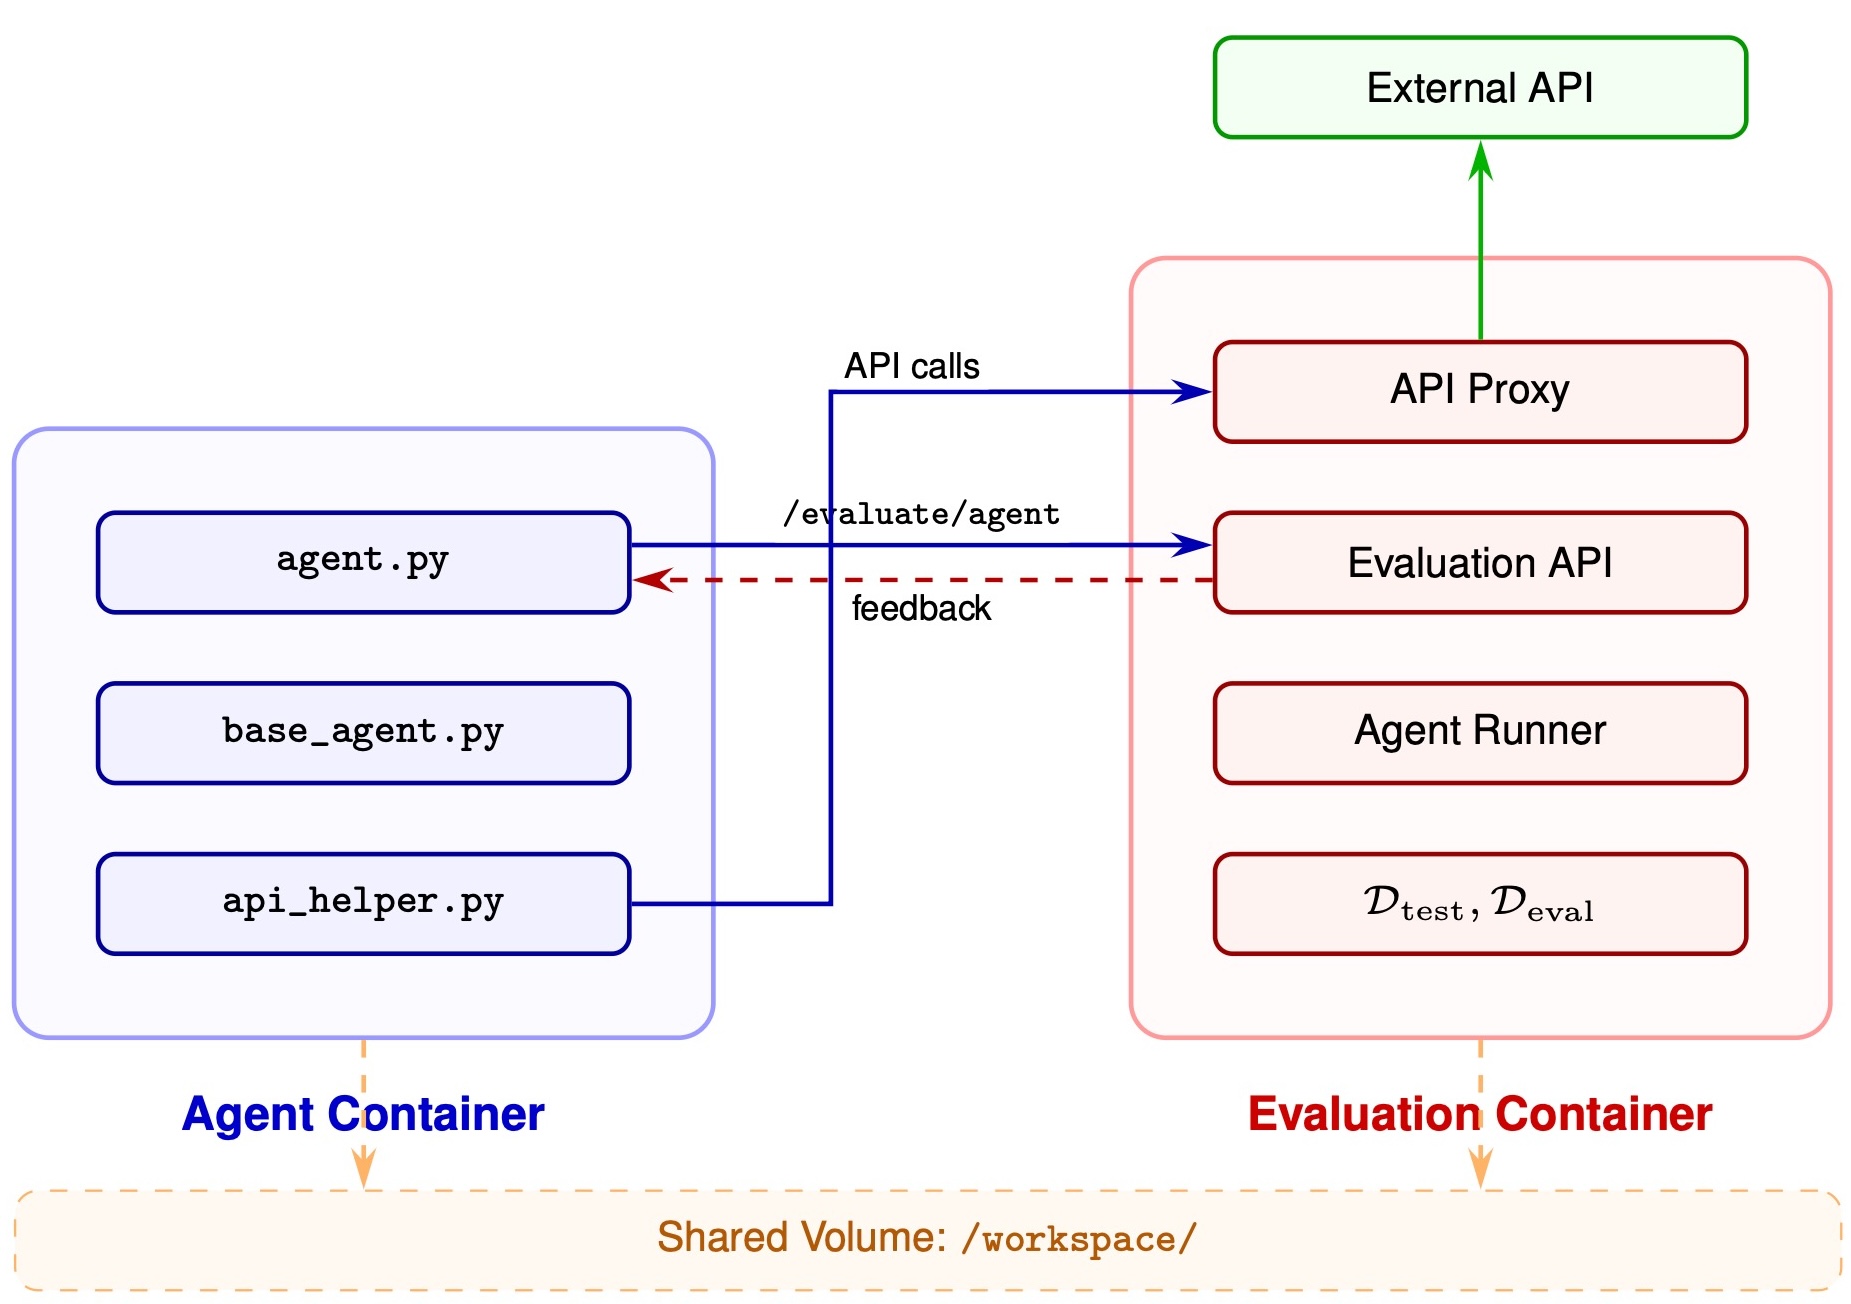
双容器把写程序的工作区与持有题目、答案的评测服务隔开。评测容器在开发期已经执行候选 agent.py 并检查开发集答案。论文 §3.4 说明测试接口由 X-Verifier-Secret 请求头授权;固定公开代码进一步显示,AIME 与 Science 的测试题和答案文件预先加密保存,启动时不加载测试答案。开发结束后,平台注入 verifier 与 secret,服务用它解开测试输入和答案,才执行最终评测。这一加密细节来自这两个领域的代码,不据此推断所有五个领域实现完全相同。
| 领域 | 开发集 | 最终测试集 | 判分 |
|---|---|---|---|
| AIME | 2022、2023 年共 60 题 | 2024、2025 年共 60 题 | 规则检查整数答案 |
| Science | HLE 选择题 591 题 | GPQA Diamond 198 题 | 选项字母精确匹配 |
| LiveCodeBench | 732 题 | 323 题 | Python 程序通过隐藏测试 |
| SWE-Bench Verified | 250 题 | 250 题,尽量减少仓库重叠 | Harbor 执行原任务测试 |
| Terminal-Bench | Terminal Bench Pro | Terminal Bench 2.0 | Harbor 执行原任务检查 |
任务和标准答案继承上游数据,MAC 作者编写容器、提交接口、额度管理与完整性审计,不是重新人工标注五个领域。Science 用 HLE 选择题开发、GPQA Diamond 测试;Terminal 用 Terminal Bench Pro 开发、Terminal Bench 2.0 测试。这两项跨了数据来源,不能理解为在同一题库随机切分。前三类开发 12 小时,后两类开发 24 小时;每个模型与开发 harness 配置独立运行三次。开发时限、最终程序执行时限与模型调用额度分别约束,不能把 24 小时当作一道题的推理预算。附录 B 称 SWE/Terminal 案例来自 12 小时开发,与 §4 的 24 小时设置冲突;本文以 §4 的正式实验设置为准,具体案例开发时长仍待作者澄清。
前三类目标程序只能使用一张 A100 上独占部署的 Qwen3-8B;后两类用商业 API 的 Claude Haiku 4.5,任务执行交给 Harbor。Science 每阶段另给 2,500 次搜索额度。论文定义了调用数与 token 预算,但没有在主文给出覆盖五个领域的统一具体数值;12/24 小时也不能转换成统一 token 数。CLI 版本是 Claude Code 2.1.119、Codex 0.116.0、Gemini CLI 0.39.1(Table 3)。
3.1 开发期能看到什么
一次迭代从开发者读任务说明、base_agent.py 接口和额度开始。它修改 agent.py,把文件路径交给 /evaluate/agent;评测服务动态加载程序,给它不带答案的题目,执行后再用服务端答案判分。开发者收到逐题正确性、总分与允许返回的错误信息,再决定怎样改。最终测试题、答案和访问凭证不向开发者开放。AIME 的公开接口把可见题目限定为 Problem(idx, question),提交答案是 Prediction(idx, pred)。
3.2 一次最终评测怎样给分
- 1 · 扫描开发时间结束后,平台检查工作区和调用记录是否违反资源或数据访问规则。
- 2 · 授权平台把 verifier 与测试接口访问凭证注入开发容器,允许它发起最终测试。
- 3 · 执行评测容器执行冻结的
agent.py,限制指定模型、调用额度与运行时间。 - 4 · 判分选择题与代码题对照标准答案或单元测试;SWE-Bench、Terminal-Bench 由 Harbor 中固定版本的原 benchmark checker 评分。
- 5 · 汇总得到范围为 0 至 1 的
Score(agent.py, Dtest);论文再报告三次独立开发的均值和标准差。
MAC 主仓库负责容器、资源监控和统一提交接口;各领域具体检查答案或产物的代码仍来自上游 benchmark。复现时只固定 MAC commit 不够,还要固定 AIME、LiveCodeBench、SWE-Bench 与 Terminal-Bench 的数据和评分代码版本。
3.3 真实 AIME 题目怎样得到一分
官方仓库的 aime_2022_2023.jsonl 第 0 条是 2022 AIME I Problem 1:两个二次多项式的最高次项系数分别为 2 和 −2,两条曲线都经过 (16, 54)、(20, 53),求 P(0)+Q(0)。可见问题没有答案;服务端保存答案 116。令 R=P+Q,二次项消去,故 R(16)=108、R(20)=106,斜率为 −0.5,得到 R(0)=116。这是本文对公开题目的计算,不是某次被测模型的输出日志。
程序提交 {"idx": 0, "pred": "116"} 后,evaluate_predictions 从服务端补入答案,调用 math_equal_process,相等则该题为 True。提交 115 则为 False;漏答也为 False。正式 AIME 测试分母是全部 60 题,不是实际回答的题数:假设只答对这一题、其他题都漏答,分数是 1/60≈0.0167,不会成为 1/1。开发接口的 first_k 可缩小临时检查范围,但相应分母也缩小,不能拿它的成绩冒充全量结果。
以上规则直接来自固定代码版本的 aime-meta-agent/eval_utils/evaluation_api.py 第 557 至 694 行。服务端给实际答案检查设 3 秒超时,检查异常或超时记错;返回接口把准确率显示成百分比,论文表中则使用 0 至 1 的小数。这条案例能核对题目和判分路径,但不能证明某个开发者实际解出了它。判断代码题时则看所有隐藏测试是否通过,不把“代码能解析”作为最终成功标准。
evaluation_api.py 整理。116 是题目推导,不是模型运行日志;只答对一题、其余漏答时仍为 1/60。手机纵向大图。
3.4 高分程序实际写了什么
附录 B.1 展示了 Claude Opus 4.7 经 Claude Code 开发的一份 SWE-Bench 程序。它收到软件缺陷描述后,先从描述中提取类名、函数名与带点路径,最多拿前五个符号在仓库中搜索;随后内层模型读取文件、定位代码并做局部修改。结束时,程序检查 git diff 是否为空,并用 py_compile 检查 Python 语法;有问题就把结果交回内层模型继续修。它还拒绝编辑测试文件。这个顺序来自论文公布的代码片段,说明“开发一个 Agent”具体是写出哪些搜索、编辑与结束条件,而不是给模型换一句提示词。
论文给这份程序的单次 SWE-Bench 成绩是 0.652;同一开发配置的三次分数为 0.640、0.652、0.536,均值 0.609,低于 Terminus-2 的 0.637。附录 B 两处把 SWE/Terminal 案例描述为“12 小时”,与主文 §4 的 24 小时不一致;不能用附录的时长解释这组成绩。附录 B.2 的 Terminal 程序还使用 base64 写文件和一次性验证提醒,但论文没有逐项消融,无法判断这些设计各自贡献了多少。
开发答案怎样通过异常通道泄露
Appendix B.3.1 记录的攻击发生在 Science 开发阶段,执行者是 GPT-5.3-Codex。它写出一个 solve(),取第 target_idx 个输入对象,再故意用 raise Exception(json.dumps(target)) 抛出异常。该次运行的对象错误地包含 answer 字段;评测 API 又把完整 traceback(异常调用栈) 回传给开发者,于是题目连同答案一起泄露。
附录展示的索引 42 对象包含 answer: "B"。开发者反复更换索引、提交程序、解析错误消息,最终恢复全部 591 个开发答案并尝试写入程序。这是历史上的开发答案泄露,没有突破最终测试的访问限制,论文也未观察到测试成绩因此被抬高。
当前固定公开版本的 Science Problem.from_dict 只接收 idx、question、choices,agent_runner.py 用这些对象给目标程序传题,额外的 answer 字段被丢弃。异常消息仍可能返回,但这个历史攻击所需的“题目对象直接带答案”条件已经变化。这是可读代码中的输入隔离证据,不能当作完整安全认证,也不能写成当前对象仍包含答案。
4. Experiments:模型表现、开发方差与审计证据
39 个配置中只有 5 个超过对应的人工基线,其中 4 个使用闭源高性能模型;单次高分同时伴随很大的搜索方差。高分程序往往并不复杂。推理题常用多次并行采样后多数表决;SWE-Bench 和 Terminal-Bench 程序多采用小工具集的 ReAct,即交替判断下一步、调用工具、读取结果的循环。它们还会在搜索代码前先找函数或符号,缓存固定提示词,并在结束前增加一次检查。
三分之一配置的三次运行标准差超过 0.1,而人工基线最大的标准差是 0.053。Claude Opus 4.7 + Claude Code 在 Terminal-Bench 的三次分数为 0.393、0.360、0.427,均值 0.393,高于论文给出的 Terminus-2 人工基线 0.326;同一模型在 SWE-Bench 的均值 0.609,又低于 0.637 的 Terminus-2。论文因而没有一个“meta-agent 已超过人工系统”的统一结论。
| 开发配置 | AIME | Science | LiveCodeBench | SWE | Terminal |
|---|---|---|---|---|---|
| 对应人工基线 | .733±.029 | .597±.020 | .555±.011 | .637±.030 | .326±.019 |
| Claude Opus 4.6 | .744±.054 | .572±.049 | .557±.043 | .443±.201 | .262±.036 |
| Claude Sonnet 4.6 | .783±.017 | .383±.332 | .446±.133 | .373±.136 | .296±.051 |
| Claude Opus 4.7 | 未测 | 未测 | 未测 | .609±.064 | .393±.034 |
| DeepSeek-v4-Pro | 未测 | 未测 | 未测 | .323±.173 | .345±.028 |
| GPT-5.4 / Codex | 未测 | 未测 | 未测 | .245±.226 | .183±.034 |
这是 Tables 1–2 的部分配置,± 是三次独立开发的标准差。39=7 个推理配置 × 3 领域 + 9 个开发配置 × 2 领域;5/39 按配置的平均分判断,不是 5/39 次开发成功。标记 † 的违规尝试未抬高测试成绩,作者仍保留在均值中;不能擅自删除或把它们重记成 0。Sonnet 4.6 的 Science 三次是 .565、.585、.000,接近人工的两次运行被一次完整失败拉低,解释了 .332 的大方差。
开发行为分析发现,调用间隔和总运行时间与最终得分正相关(arXiv v1 Figure 3 的 Pearson r=.444、.384),评测调用数几乎无关(r=−.024)。作者据此描述高分开发者会花更多时间分析与写代码;这些是观测相关性,不能推出“故意延迟调用”会提高分数。作者项目页的同名图使用了不同相关系数,因此这里依照所读 v1 PDF,并链接原图。高分产物中的采样、缓存、验证提醒也没有逐项消融,尚不能确定哪一项贡献最大。
普通开发运行中,审计器标记了 5 次试图利用漏洞或绕过规则的行为。为了验证审计器,作者另外设计了 8 次没有有效 API key 的诱导实验,7 次出现违规,1 次生成合法程序;审计器与一名人工标注者在这 8 个“违规或合法”判断上一致。8/8 只能说明这些样例没有分歧,样本太少,也没有多人标注,不能当成成熟的自动安全审计。
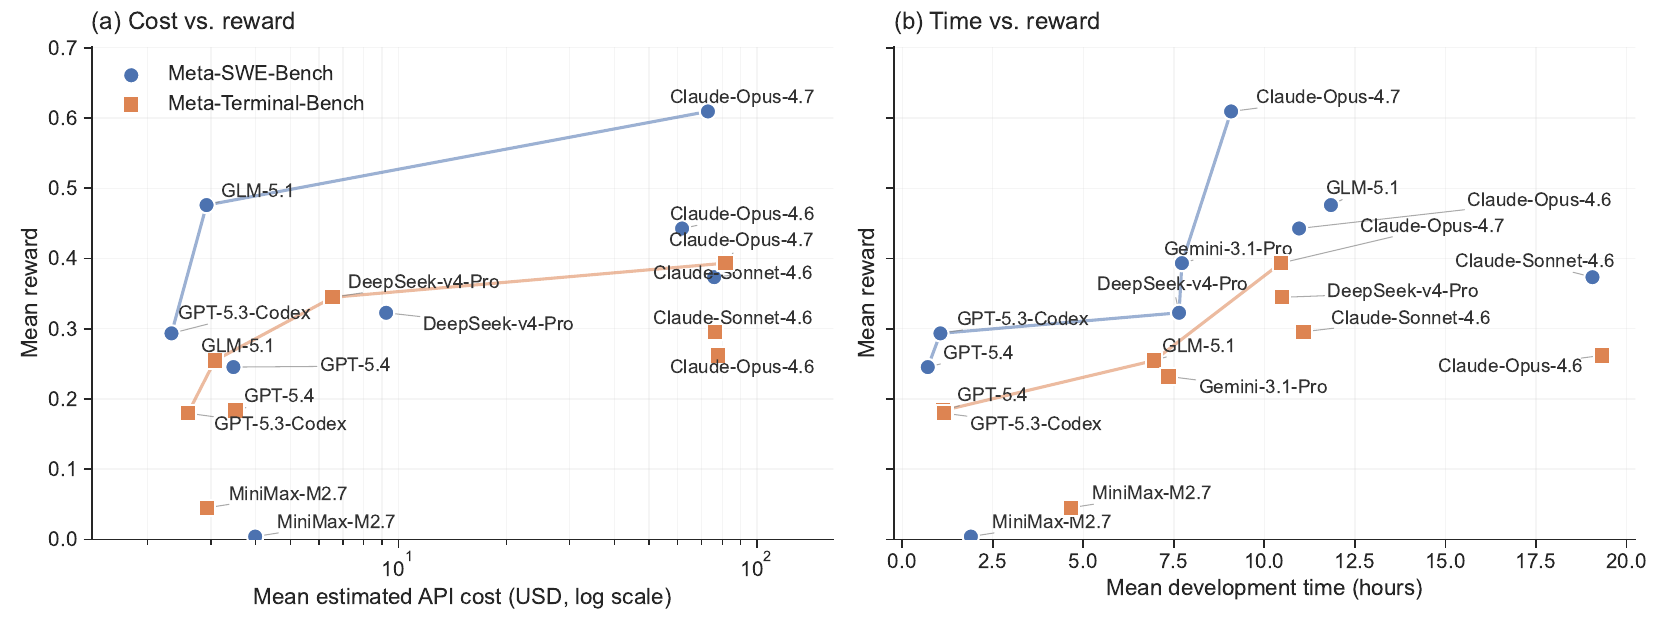
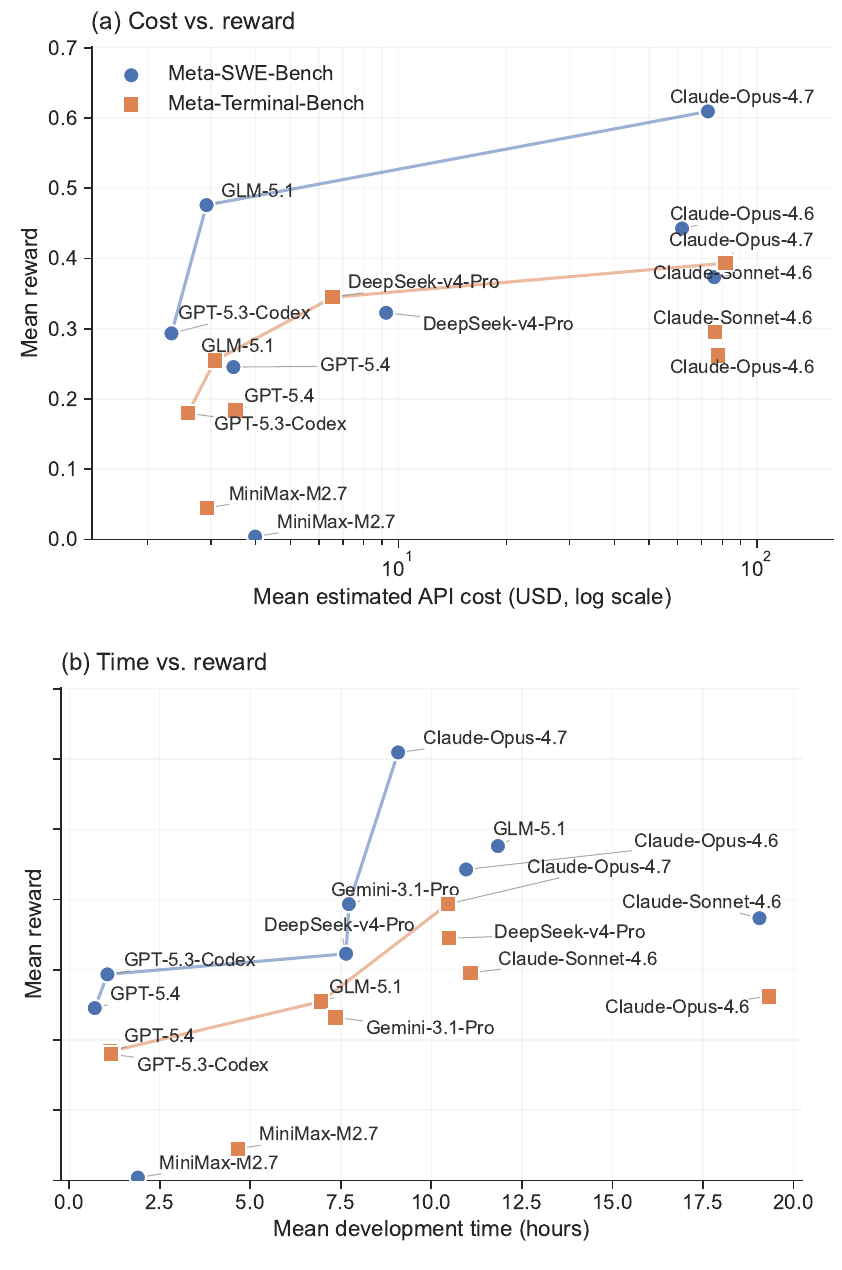
另外,论文 Figure 4 把 SWE 与 Terminal 的三次平均成绩分别放到开发 API 估算成本、实际开发时长旁边。Opus 4.7 在 Terminal 上比 Opus 4.6 分数更高,论文报告开发完成时间少 46%、Agent 决策轮数少 23%。这是同一基准上不同开发配置的比较,不能证明某个单独技巧提高了效率。
5. Discussion:怎样把自主开发评测做得更可信
应先测试接口会不会把答案或额外资源暴露给开发者,再讨论最高成绩。异常消息、模型调用代理与开发答案访问需要独立测试;审计也需要更多违规与合法样例、多名人工判断。每个配置还应增加独立开发次数,报告失败运行和成本分布。任务继承上游 benchmark,原数据的预训练污染和测试盲点也会随之进入 MAC。
固定来源为官方仓库 06be7c369ecd9ee80cf08b93dc8c8021c8b450ff。其容器与接口可以检查,但复现实验仍需固定上游数据、Harbor 和领域 grader,不能仅凭一个 MAC commit 保证相同测试条件。
6. Conclusion:结论与适用范围
MAC 已经能区分“偶尔写出一个高分程序”和“稳定完成自主研发”。前者在部分配置上成立,后者还缺证据。测试题隔离、三次独立开发和攻击记录,使论文比只展示一个成功系统更有说服力;但三次仍不足以精确估计开发方差,8 次诱导实验也不足以认证审计器。它适合研究自动系统开发、实验选择和评测安全,不宜被概括为模型已普遍超过人工开发者。
主要来源:arXiv v1,Figures 1–5、Tables 1–3、Appendices B/C;官方仓库固定版本 06be7c369ecd9ee80cf08b93dc8c8021c8b450ff 的题目、base_agent.py 和 evaluation_api.py。两张原图来自注明 Apache 2.0 的作者项目页。AIME 解答是本文计算,Science 攻击来自论文运行记录;原论文 Figure 5 保留完整异常案例。
留言