让模型依据失败记录修改执行程序,再核验和回滚
AHE 不更新模型权重。维护模型读执行记录,改提示、工具、调用前后处理和记忆;再看下一轮哪些题由失败变成功,哪些反而退化。
作者兴趣度 10 / 10改完整执行程序,至少要处理两类难点
各类文件有各自的作用
系统提示、工具参数、Python 实现、调用处理、技能、子 Agent 配置和记忆,不能按同一种文本修改。
轨迹长,关键步骤难找
一次任务可跨数百步。最后的成败很难说明是哪条命令、哪次拦截或清理造成结果。
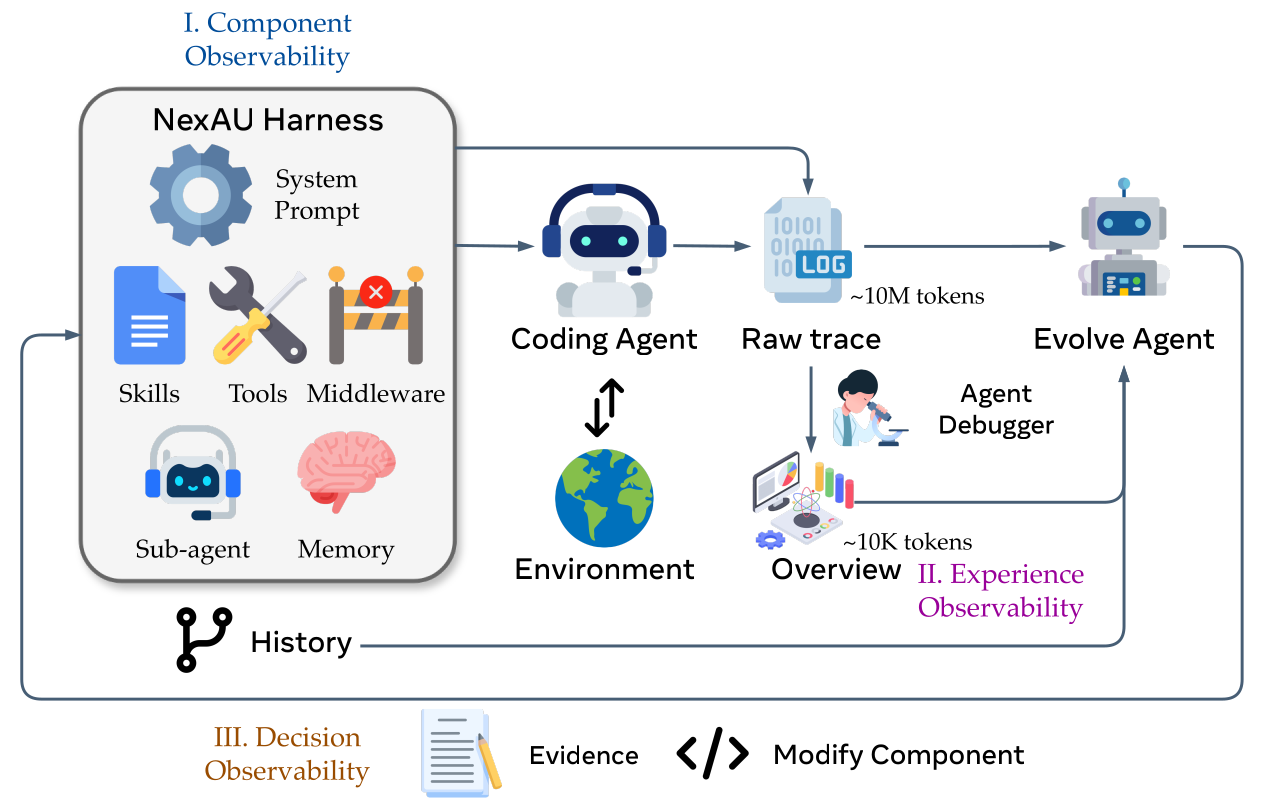
三个可观测层分别说明:能改哪里、哪里出错、改后怎样核验
01 / 可修改文件知道能改哪里
七类组件都落成固定路径下的文件。一个逻辑修改对应一个 Git commit,可以逐文件回滚。
02 / 执行记录知道哪里出错
负责整理记录的模型称为 Agent Debugger。它将约 1,000 万 tokens 的记录整理为总览与逐题报告,仍可回查原步骤。
03 / 修改预测知道改后怎么验
修改清单写出错误证据、原因、预计修好的题与可能退化的题;下一轮按实际成败变化核验。
维护模型可以直接读取组件文件、执行证据和修改预测
第 t 轮先评估第 t-1 轮的修改,再生成第 t 轮候选
每题 k 次
当前程序在新建 E2B 隔离工作区执行。
规范化轨迹
把消息、工具输出和验收结果写成文件。
结算旧预测
核验上一轮清单,并记录已评测的最佳版本。
生成报告
先读总览,必要时查逐题报告和原始记录。
改组件文件
维护模型按报告决定撤销或重做哪些修改。
独立提交
一项修改一个提交。新文件等下一轮执行后验收。
同一种失败模式,应落到最有执行力的组件层
汇总 89 题反复出现的错误类型。
逐题错误原因、成败对照与证据位置。
只有摘要不足时才回看原始消息和工具调用。
运行记录、验收器、追踪器和模型配置不可改,避免维护模型改变考试本身。
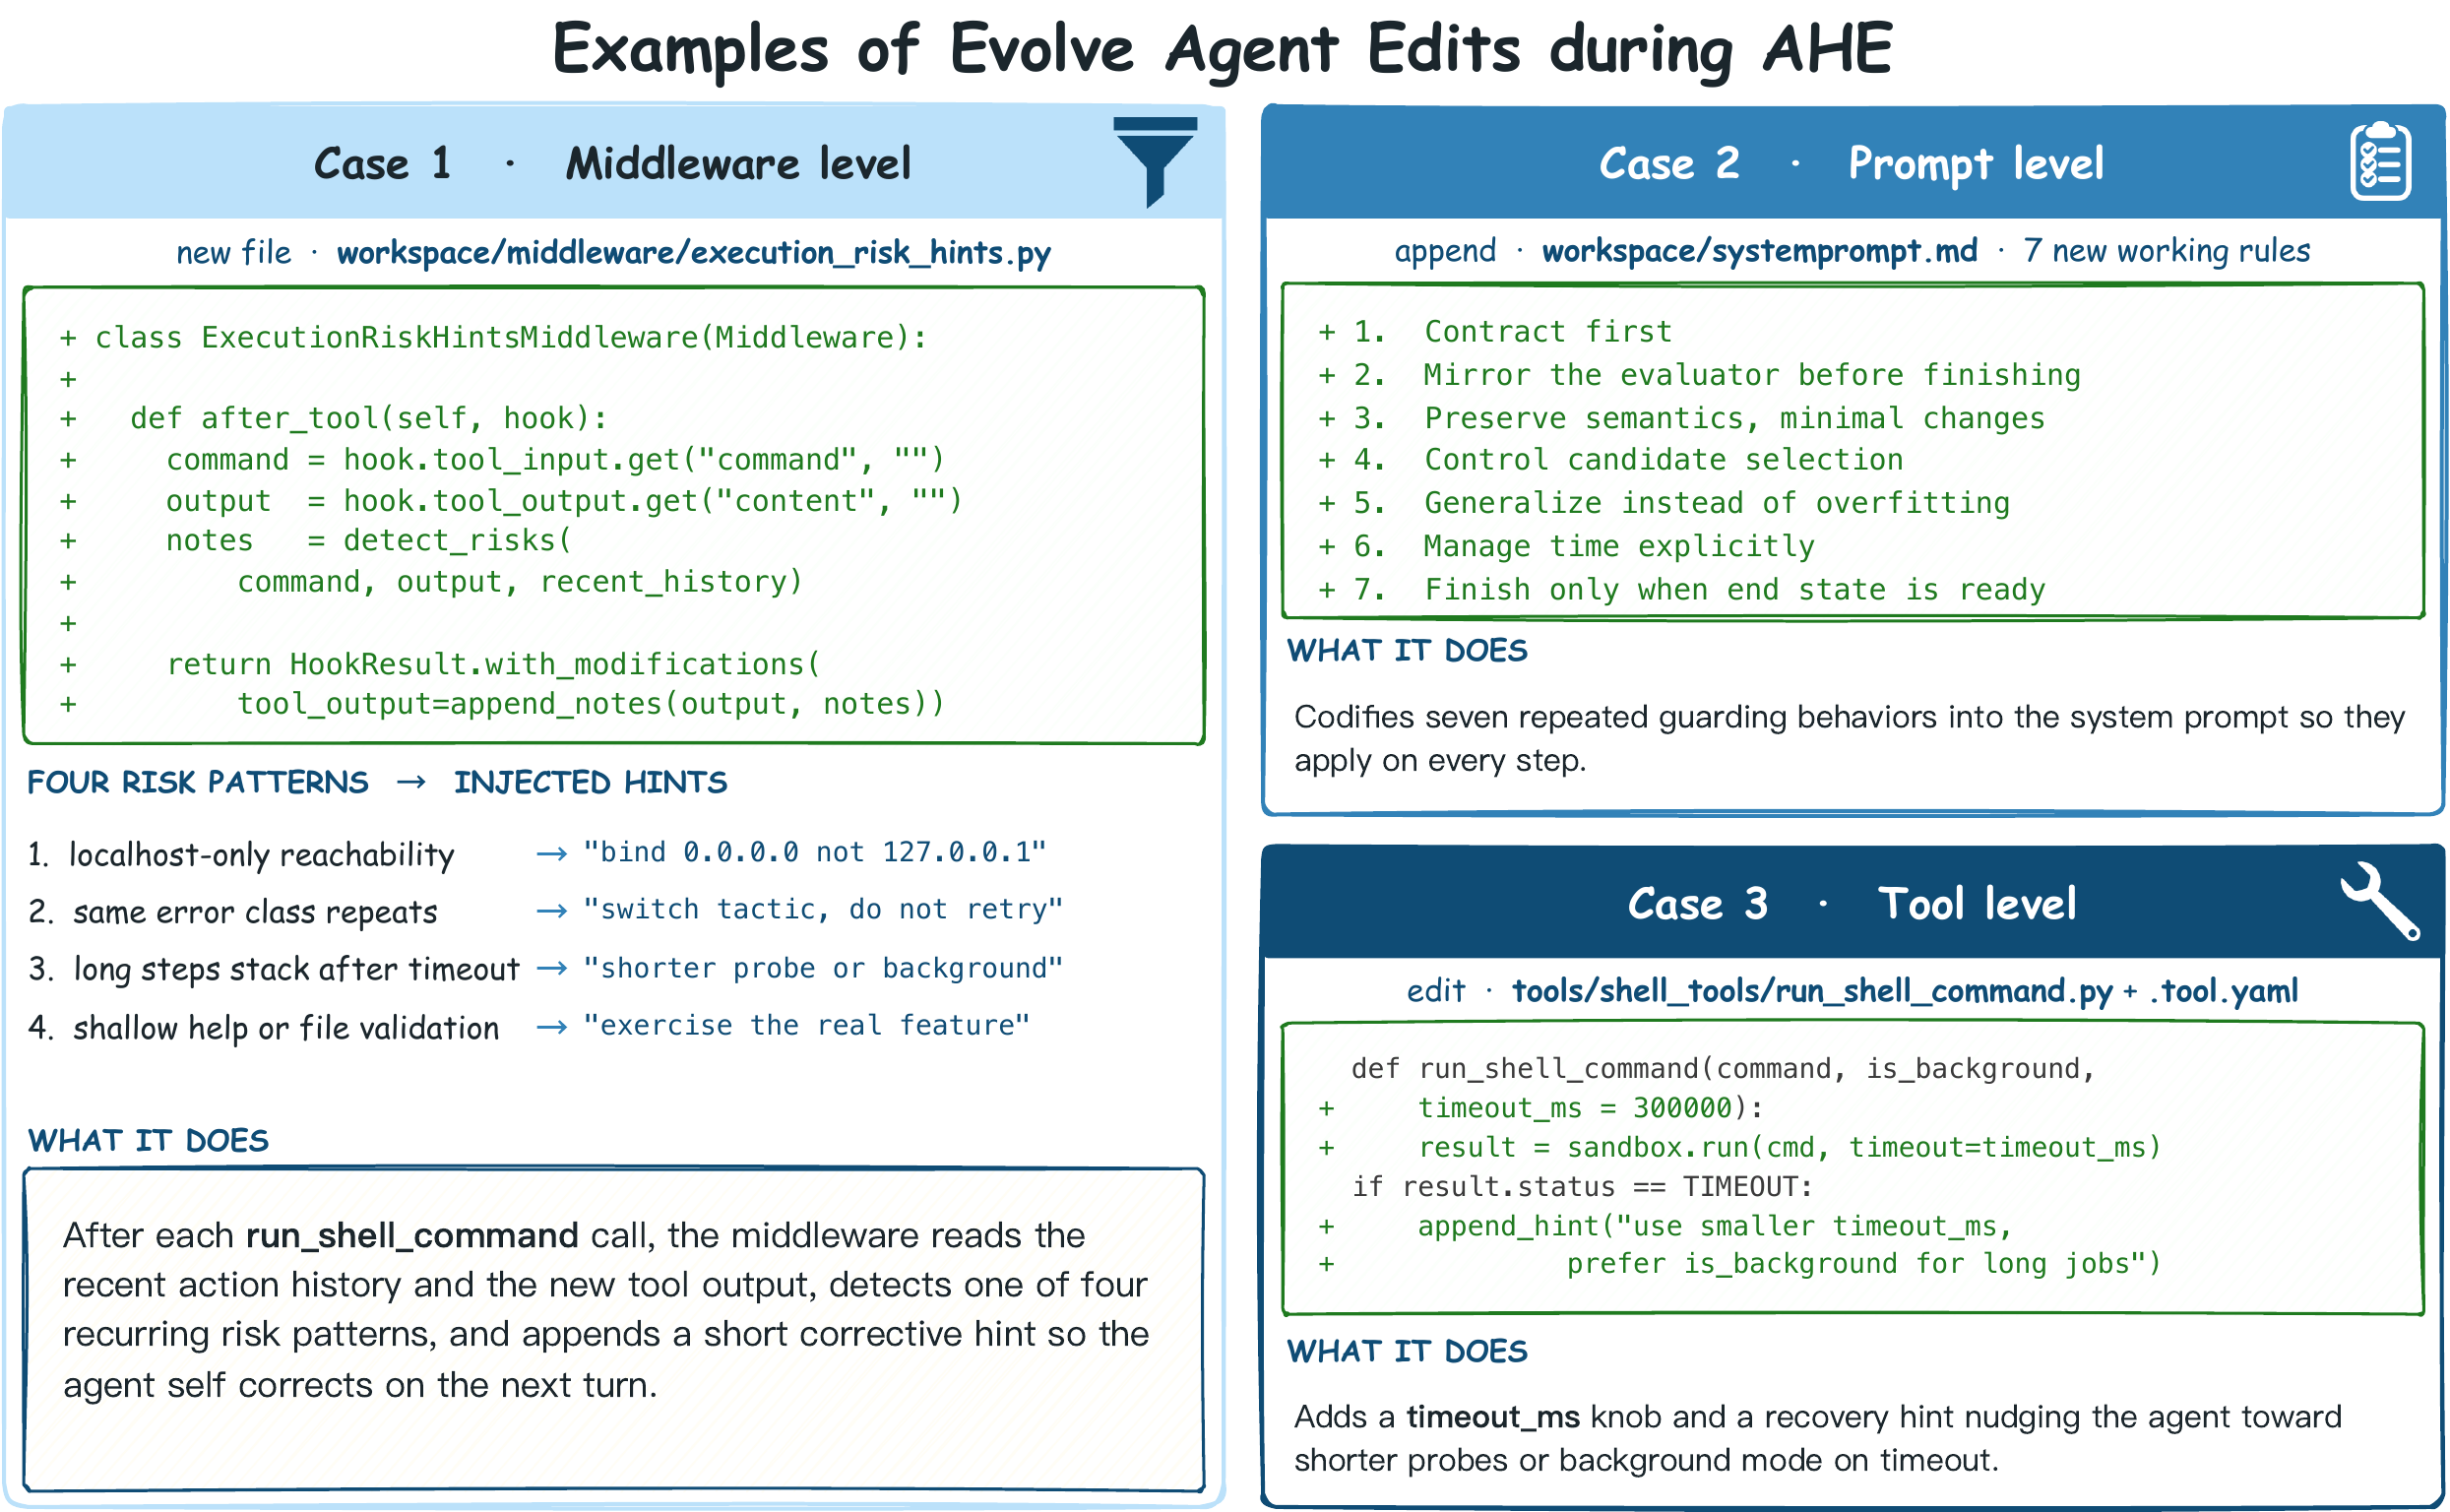
每次修改都写明:预计修好哪些题,哪些题可能退化
// change_manifest.json
{
  "id": "chg-8",
  "files": ["tools/.../run_shell_command.py"],
  "failure_pattern": "post-validation state destruction",
  "predicted_fixes": ["path-tracing", ...],
  "risk_tasks": [...],
  "constraint_level": "tool_impl"
}
path-tracing:从 0/2 到 2/2,靠的是执行层保护
任务与验收程序
Agent 要生成 /app/reconstructed.ppm。任务自带的验收程序称为 verifier,只读这个文件,与参考图逐像素比较。
失败尝试已生成正确图片并做过自检,随后为了“清理”执行 rm -rf ... /app/reconstructed.ppm。
图片生成正确,自检也已通过。
最后清理删掉唯一交付文件;命令退出码仍为 0,Agent 误以为可提交。
最终检查通过后,shell 工具记录要保护的文件和目录;后续删除命令在执行前被拦截。
Agent 收到拦截提示,保留图片。下一轮 2/2:验收器找到文件,逐像素匹配。
mcmc-sampling-stan:近似结果骗过自检,骗不过重新执行
任务与验收程序
安装 rstan 2.32.7,用 30 条观测估计不同观测的成功概率分布,即 beta-binomial 模型。alpha、beta 是描述该分布的参数。
要求通过反复采样估计参数(MCMC)。Verifier 重跑 analysis.R,要求均值 alpha ∈ [2.84, 2.91]、beta ∈ [16.1, 16.7]。
网格积分得到近似值后写文件,后台 MCMC 却被提前终止。自检只验文件存在;Verifier 重跑得到约 1.28e19 / 2.60e17,六项检查失败两项。
执行保护器保留 analysis.R;运行时检查识别替代计算和只验文件存在,在下一次回复前提醒。
完整跑 iter=100000,再在 /tmp 独立复跑,约 2.872 / 16.43;六项检查全过,后四轮保持 2/2。
同一种错误,可以用提示规则、动态提醒或执行前拦截处理
同一 GPT-5.4 high,AHE 达到 77.0%,但 Hard 仍低于 Codex
| Harness / loop | All | Easy | Medium | Hard |
|---|---|---|---|---|
| OpenCode | 47.2 | 75.0 | 52.7 | 33.3 |
| Terminus-2 | 62.9 | 75.0 | 74.5 | 40.0 |
| Codex | 71.9 | 75.0 | 80.0 | 56.7 |
| NexAU₀ | 69.7 | 87.5 | 78.2 | 51.7 |
| ACE | 68.9 | 91.7 | 78.2 | 48.9 |
| TF-GRPO | 72.3 | 100.0 | 79.4 | 55.6 |
| AHE | 77.0 | 100.0 | 88.2 | 53.3 |
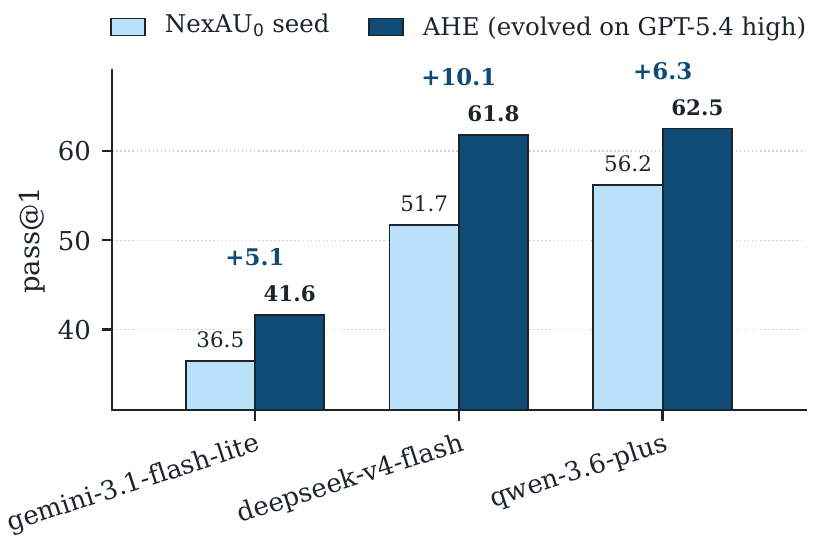
换任务集主要省 token;换模型的五种配置均有增益