01 · PAPER MAParXiv:2609.01481 · 2026-09-01 · CC BY 4.0
HARNESS-OF-HARNESS
怎样让 Codex 连续开发几天?
固定模型与编码助手的运行系统,由 Planner 规划、Developer 修改、QA Tester 独立测试。每轮保存项目与对应版本的验证记录。
生产项目只由 Developer 修改。QA 在副本上测试,验证记录进入下一轮规划;最终基准的隐藏分数不回流。
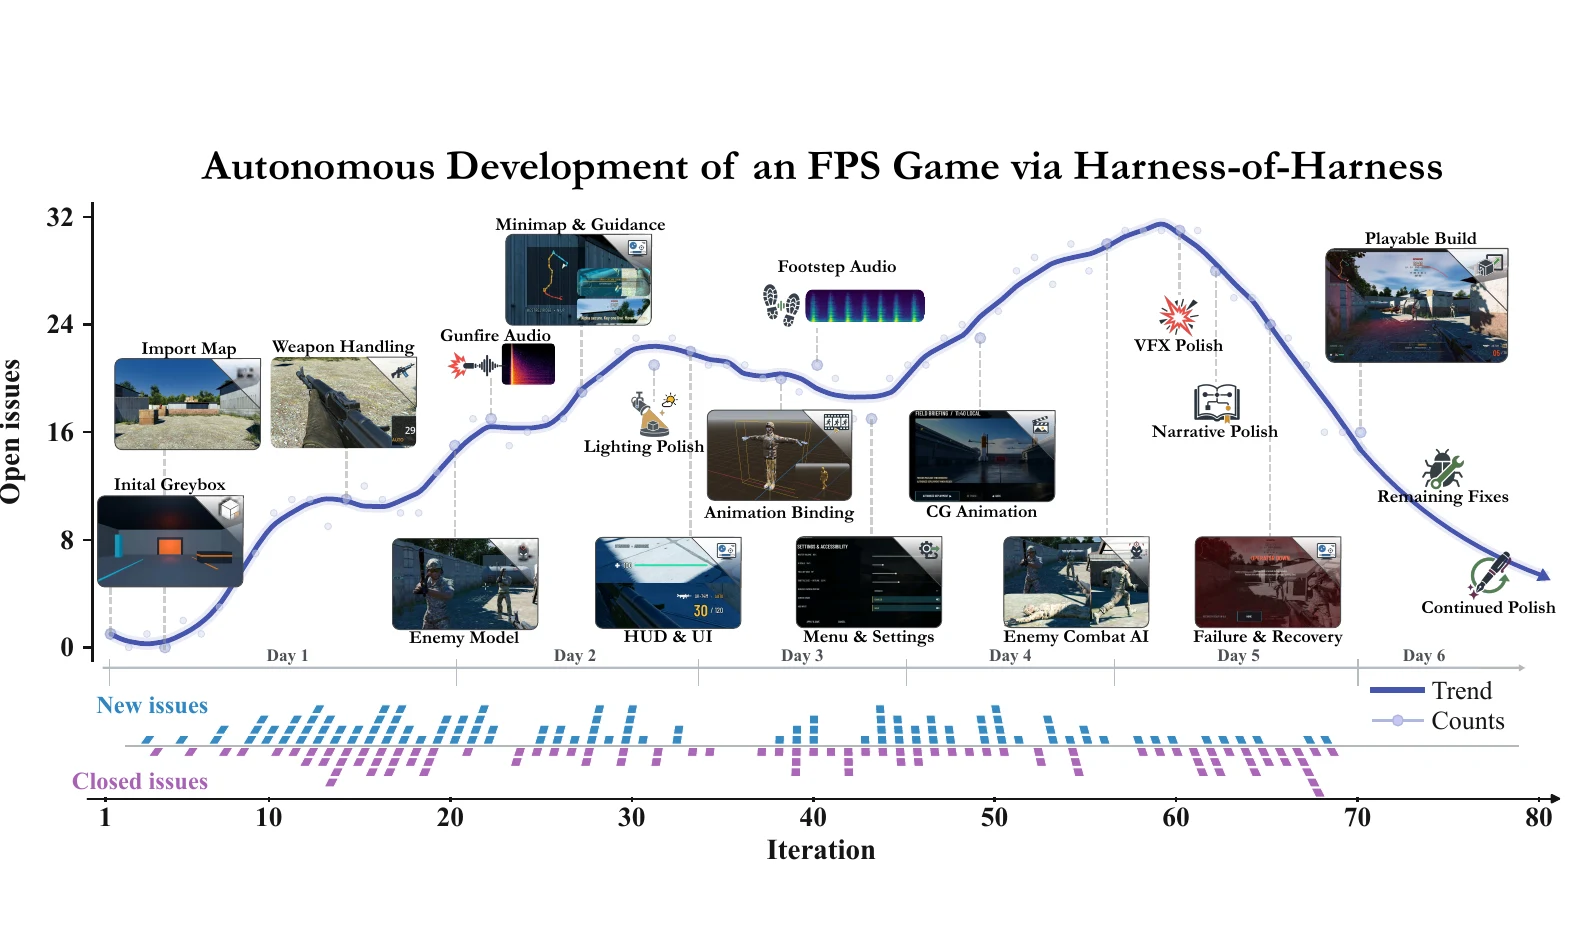
论文 Figure 1:FPS(第一人称射击游戏)Fusepoint 的前 70 轮开发记录,不等于完整产品已通过验收。
49.58 → 71.52GameCraft-Bench · Codex
0.31 → 0.54FrontierSWE · Codex
60.41 → 66.50ProgramBench · Codex
65 / 81第 70 轮已关闭问题
论文 Abstract、Figure 1、Table 1。
02 · MOTIVATION持续开发需要独立的状态与验证
代码会留下,关于代码的可靠认识却会不断过期
开发越久,代码、需求、已知问题和测试结论越容易对应不上。
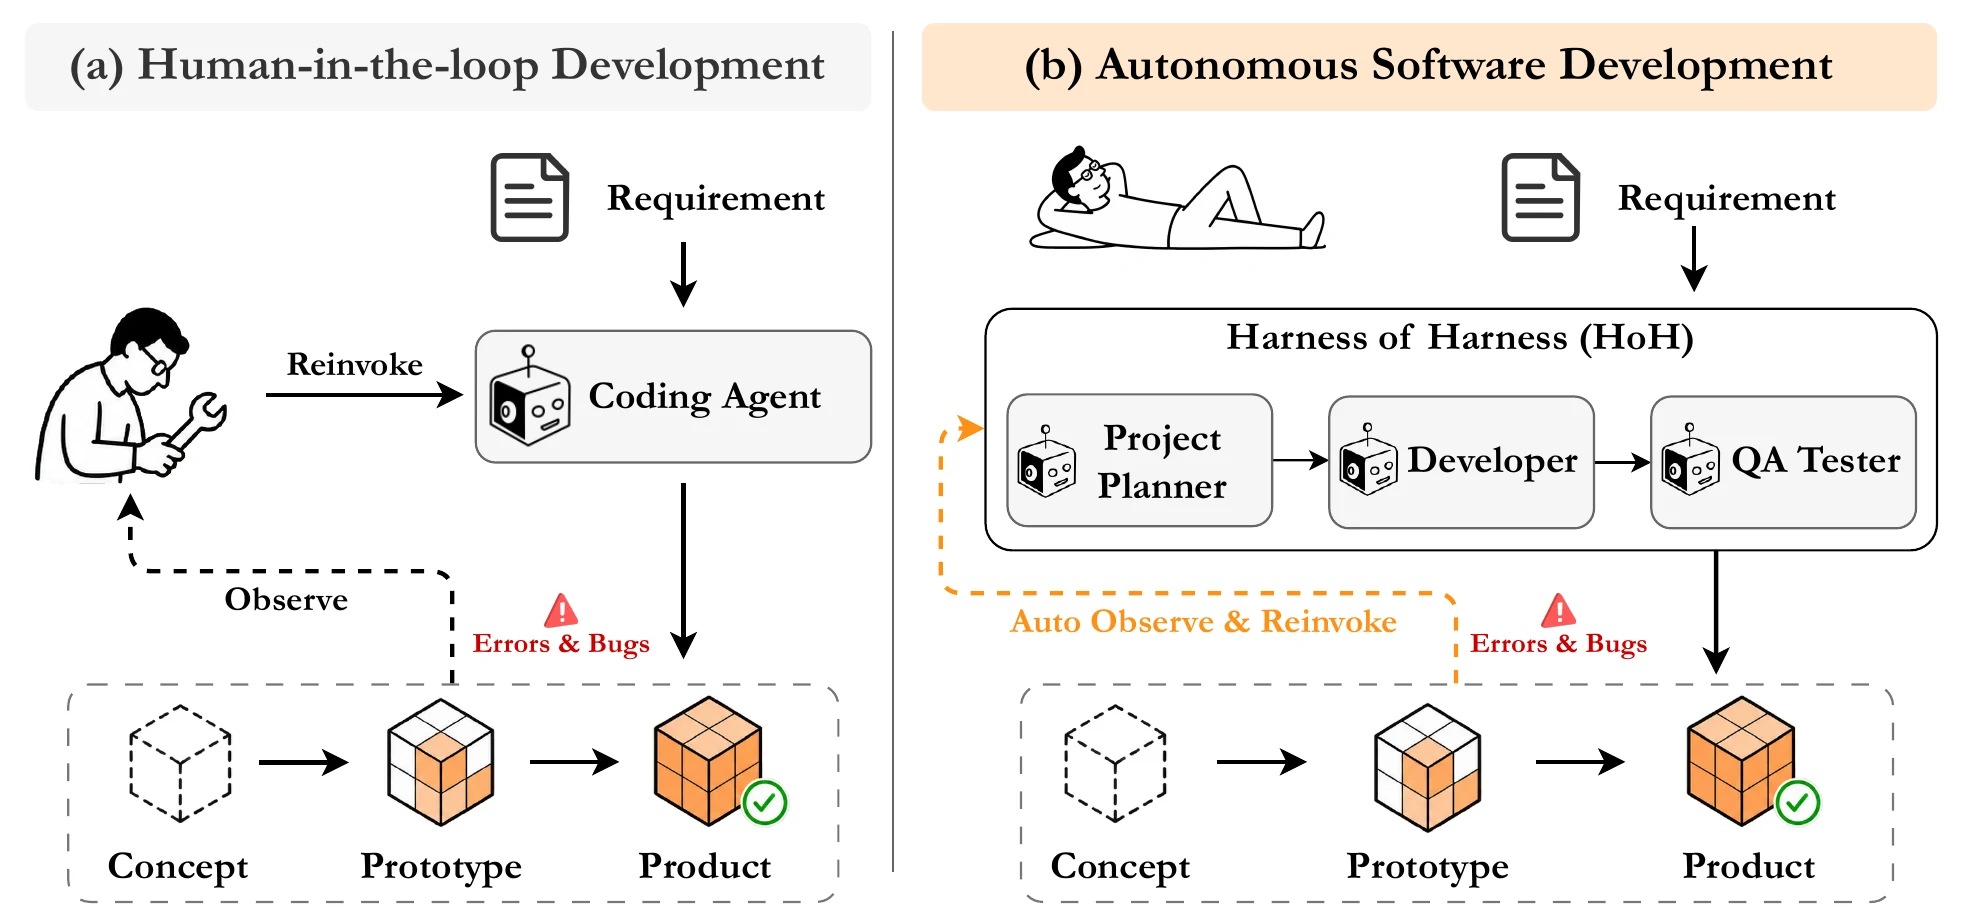
论文 Figure 2:右侧由系统自己观察问题、规划修改、开发和测试。
01
决定被遗忘早期需求、设计取舍和已知限制埋进历史,后续修改不知道什么不能破坏。
02
下一步没有唯一答案同一份公开产品需求文档(PRD)可以对应多条开发路线。
03
“能运行”不等于“做完”软件还需满足交互、画面、音频、流程和运行稳定性要求。
论文 §1、Figure 2。
03 · 改动范围固定 底层执行程序,持续改变 项目状态
HoH 不改 Codex,也不训练模型;它改的是外层开发协议
一次实验内固定
模型GPT-5.5 / DeepSeek-V4-Pro / MiniMax-M3
编码助手的运行系统(harness)Codex / OpenCode / Pi
角色规则每个角色的权限、输入、输出与调用顺序
→
每轮更新
开发文档 · Dt本轮范围、验收要求、不能改坏的已有行为
项目 · At实际代码、资源与配置;论文称 Artifact state
验证记录 · Et已通过项、缺证据项与版本标识;论文称 Evidence state
(At−1, Et−1) → Planner → Developer → QA Tester → (At, Et)
论文 §3;Supplementary §A.1。
04 · RELATED WORK角色名称相似,不代表控制对象相同
HoH 把验证证据绑定到候选版本,跨轮状态不再只是对话摘要
| 路线 | 优化或保存什么 | 验证从哪里来 | 与 HoH 的关键差异 |
|---|---|---|---|
| 长上下文/外部记忆 | 对话、摘要、历史 | 执行者的观察与判断 | 记住过去,不等于知道哪些功能在当前版本上通过测试 |
| MetaGPT / ChatDev | 角色文档与消息流程 | 角色间审查 | HoH 强调读写分工、待测版本与证据归属 |
| AgileCoder / EvoDev / EvoMAC | 开发迭代、功能依赖、测试反馈 | 迭代计划与测试 | HoH 分开保存项目文件和独立 QA 记录 |
| Meta-Harness / AHE | 提示词、工具、调用处理、执行程序 | 跨任务评测 | 它们改执行机制;HoH 固定执行机制,持续改项目 |
| LongHorizon-Harness | 单任务进度与核验报告 | Auditor 核验者 | 面向更通用的 GUI/CLI 任务;HoH 保留版本化软件与独立 QA |
| Harness-of-Harness | 项目与对应版本的验证记录 | 独立 QA;最终基准另外评分 | 同一 harness/model 按固定角色反复调用 |
论文 §2;此页比较为基于论文与官方实现的作者整理。
05 · FRAMEWORK三个角色,两条跨轮状态,一个只写者
一轮包含一次受控的状态提交
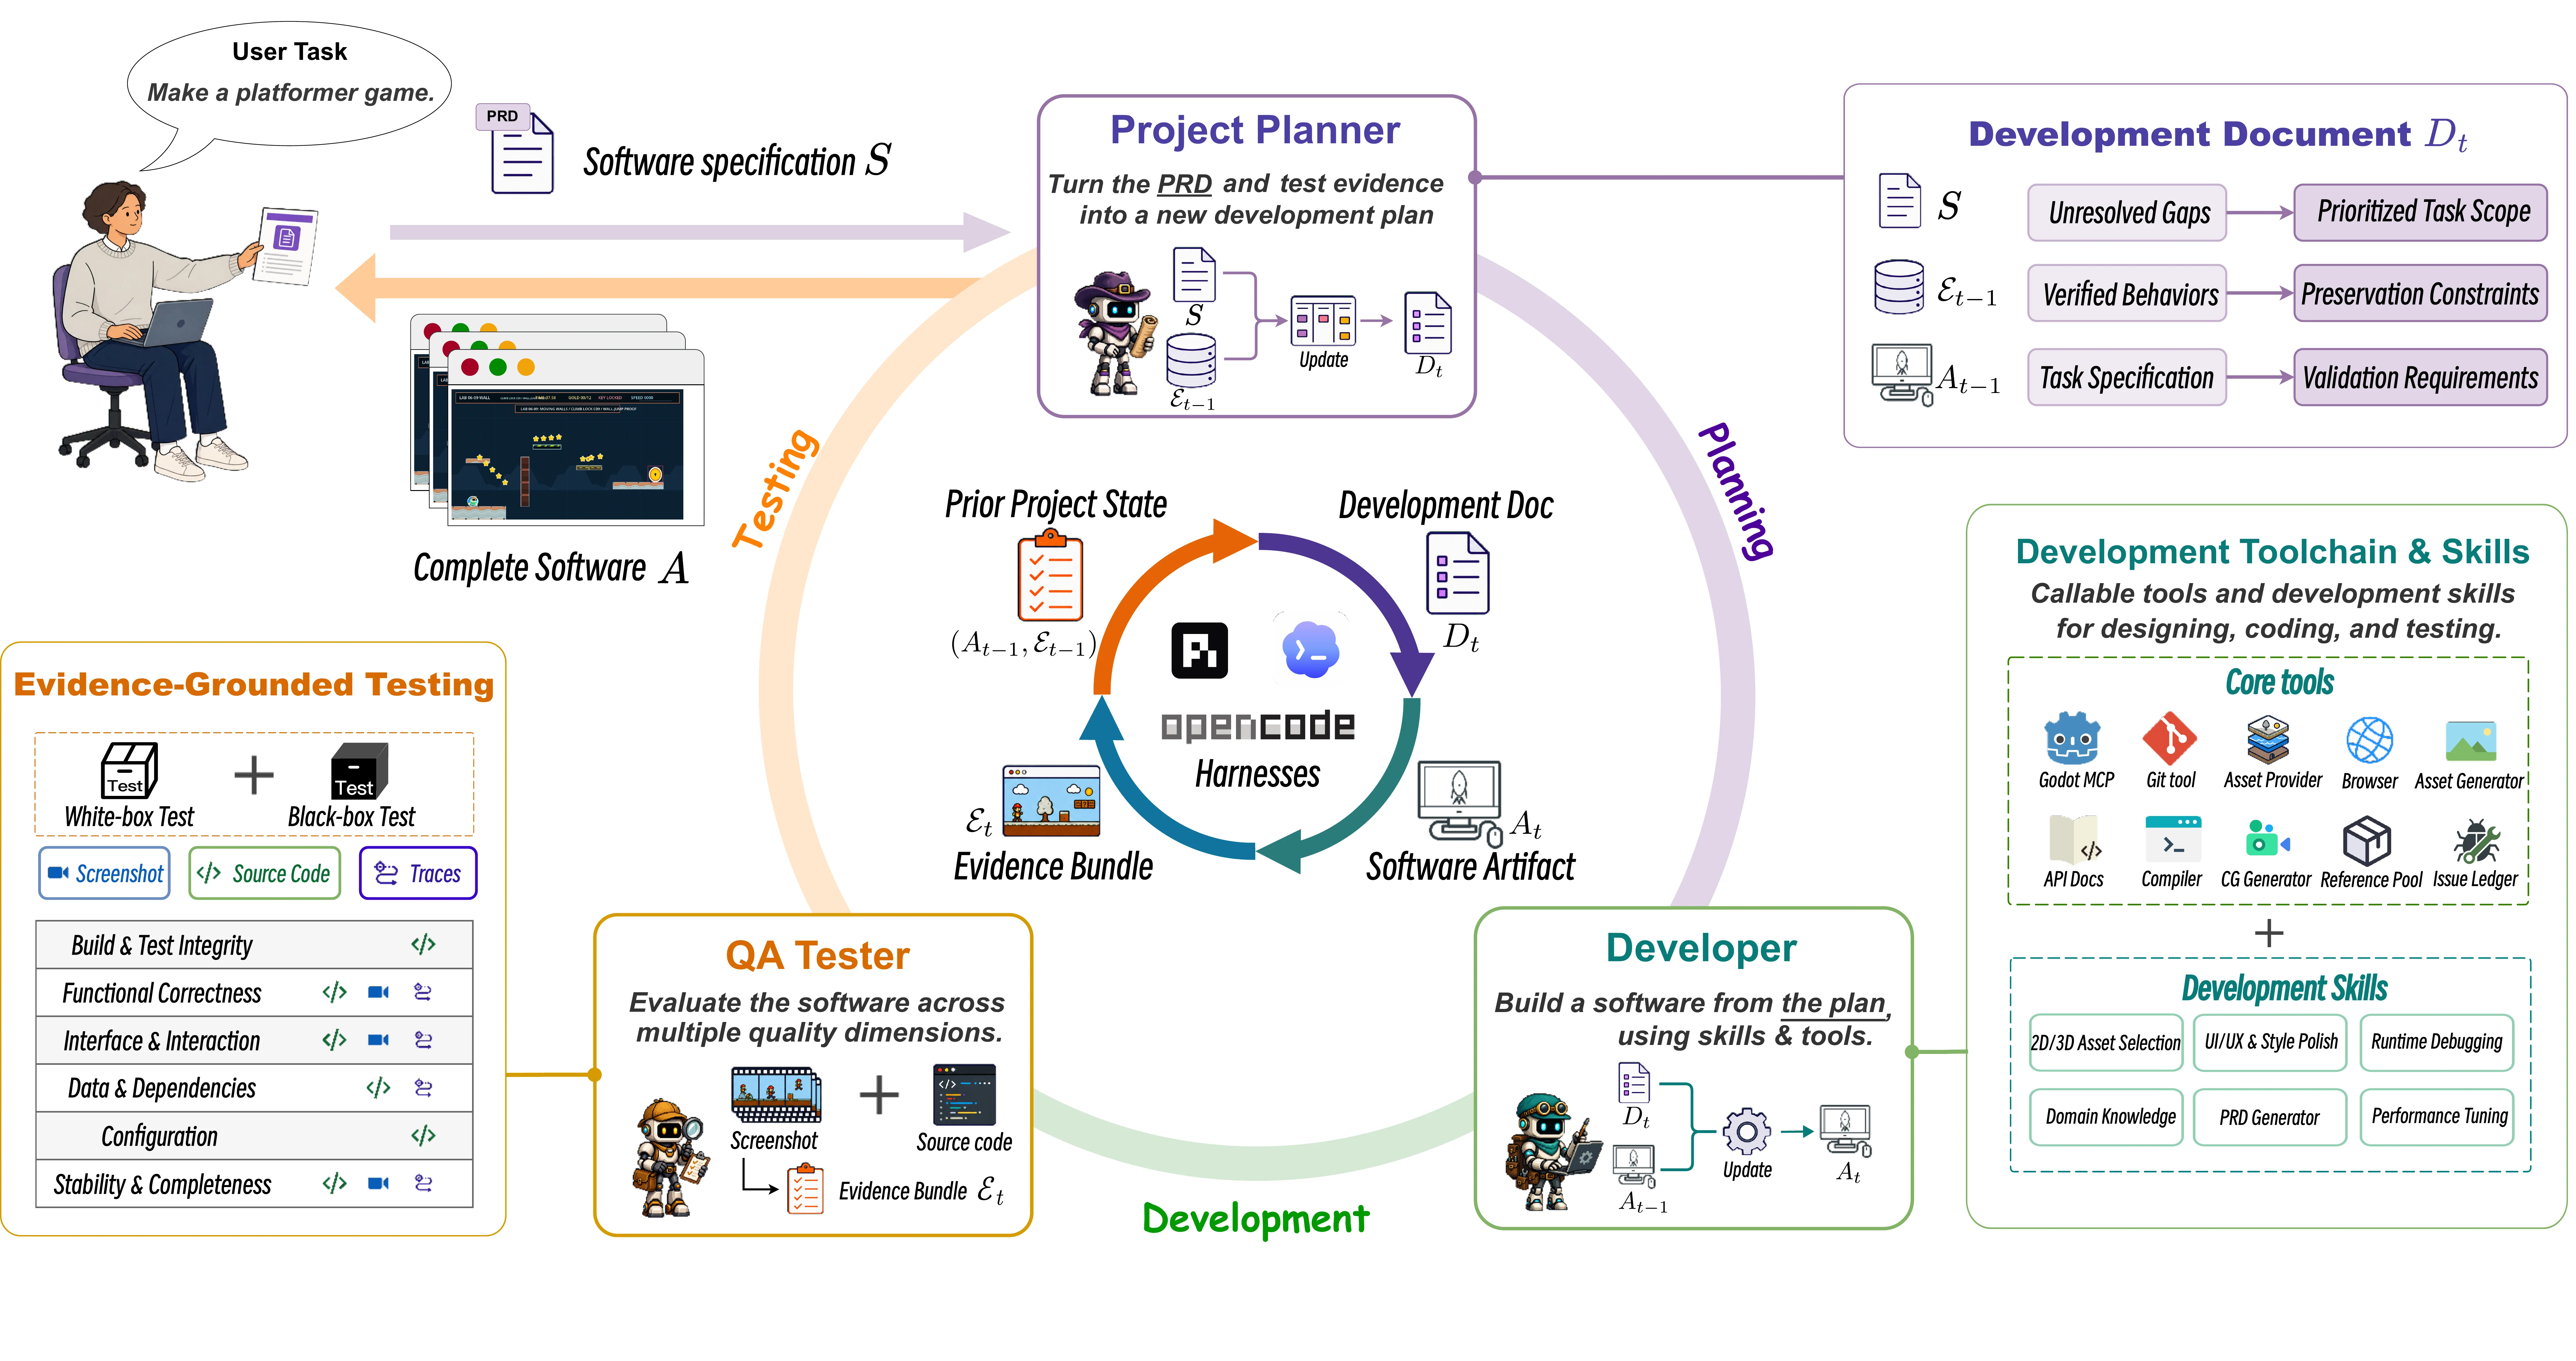
论文 Figure 3:模型、底层 harness、角色定义固定;artifact 与 evidence 逐轮变化。
06 · 跨轮记录项目保存代码,验证记录保存实际观察
代码和证据必须分开保存,又必须绑定到同一个候选
At
Artifact state:实际项目
- 代码、资源、配置与项目元数据
- Developer 从上一版
At−1继续开发 - 开发结束后复制到独立 QA 目录
- 版本标识防止测试结论被算到另一份代码上
+
Et
Evidence state:验证记录
- 哪些行为有证据支持
- 哪些要求未满足或出现回归
- 截图、操作回放、日志、运行状态、公开测试
- 下一轮修改后仍需重测,旧结论不会永久有效
本轮代码与本轮记录At 与 Et 共享待测版本标识
→
下一轮继续开发Planner 读 Et;Developer 修改 At 后,由 QA 重新验证
论文 §3.1–3.3;Supplementary §A.2–A.4。
07 · ROLE CONTRACTSDeveloper 是唯一写入者
生产项目只由开发者修改,测试者不现场补丁
01
Project Planner:规划
- 读取需求和上一轮验证记录
- 正文允许只读查看项目
- 公开模板禁止检查生产代码
- 公开实现只补本轮优先事项与验收要求
- 不修改生产项目
02
Developer:开发
- 从上一版项目继续
- 读取需求与本轮开发文档
- 先检查旧版,再修改和自测
- 保留已验证行为
- 唯一修改生产项目的角色
03
QA Tester:测试
- 运行本轮版本的隔离副本
- 实际运行与代码检查交叉验证
- 记录通过项和未满足项
- 看不到最终基准隐藏分数
- 原项目靠外层隔离保护
论文 §3.2、附录 Table 4;公开模板与固定实现 ae7cc6f。正文设计与公开实现不是同一权限描述。
08 · ALGORITHM 1每轮安排范围有限、可完整验收的任务
Planner 安排本轮任务,Developer 保存候选项目,QA 写验证记录
1 · Planner
安排本轮任务
读公开需求与旧验证记录,选出范围有限、可验收的改动。
2 · Planner
写清不能改坏的功能
把旧版通过的行为与重测方式写入本轮开发文档。
3 · Developer
先测修改前的项目
记录现有行为和失败,作为本轮改动的比较起点。
4 · Developer
修改后自测
检查目标是否实现,再重测原有功能有没有变坏。
5 · 宿主程序
保存待测版本
生成独立 QA 副本并记录版本标识,之后不再改原提交。
6 · QA Tester
记录通过项与缺项
在副本上实际测试,所得 Et 供下一轮 Planner 使用。
先保存版本,再独立测试。如果边测试边修改项目,验证记录就可能对应另一份代码;外部基准的隐藏分数不参与上述六步。
论文 Algorithm 1;Supplementary §A.1。
09 · RUNTIME ENFORCEMENT官方 hoh-lite · Python 3.12+ · Apache-2.0
配置检查与实际文件隔离是两层保护
class WorkspaceAccess(str, Enum): READ_ONLY = "read-only" READ_WRITE = "read-write" @dataclass(frozen=True) class RoleBinding: role: RoleName workspace_access: WorkspaceAccess godot_mcp: GodotMCPAccess def __post_init__(self): if self.role is not RoleName.DEVELOPER: if self.workspace_access is WorkspaceAccess.READ_WRITE: raise ValueError(...)
角色配置不允许把 Planner / Tester 配成生产项目写入者。这段还不是进程沙箱。
Planner 启动单独目录;Codex 默认 read-only,OpenCode 禁工具。公开模板不让它查生产代码。
GameCraft QA 启动副本可写报告/导入文件,原提交被 bubblewrap 隔离,另核对源码哈希。
ae7cc6f:roles.py、codex.py、opencode.py、runner.py。代码为压缩节选;QA 有显式无隔离开关。
10 · EVIDENCE SCHEMA“测试通过”不是可复用的跨轮状态
每条验证记录说明测试了哪个版本、看到了什么
{
"candidate_id": "loop-70-...",
"final_status": "FAIL",
"verified_records": [
{
"claim": "正常启动成功",
"method": "runtime replay",
"evidence": ["log", "screenshot"]
}
],
"gap_records": [
{
"claim": "encounter reaches combat",
"observed": "idle / walk only",
"impact": "完整用户路径受阻"
}
]
}对应具体版本QA 结论只属于它真正运行过的冻结候选,不能无条件继承给下一版。
多种执行证据允许截图、replay、日志、runtime trace、自动测试和结构检查共同支持一条 claim。
未满足项也保留失败不是丢掉一轮;gap 会成为下一轮 Planner 的输入。
示例说明此页 JSON 是根据论文 Listing 1 与 Fusepoint receipt 压缩的说明性结构,不是原文件逐字复制。
论文 Listing 1;Supplementary §A.4;Fusepoint Loop 70 Tester receipt。
11 · TWO JUDGES过程反馈与最终得分严格隔离
内部 QA 能帮助下一轮;外部隐藏验收程序 只能在结束后结算
内部 QA
生成 Et
- 输入:公开需求、本轮开发文档、待测版本
- 可用:运行、操作回放、截图、日志、公开测试
- 输出:通过项、未满足项与测试结论
- 结果会进入下一轮 Planner
║不可回流的边界
最终基准评测
生成论文分数
- GameCraft:运行门槛 + 四个评分维度
- FrontierSWE:官方逐题验收分数
- ProgramBench:隐藏行为测试
- 隐藏测试、分数及解释不进入 HoH
论文 §3–4、Supplementary §B–D。两层 judge 不能互相替代。
12 · EVALUATION三套任务,三种外部 verifier
先看提交经过什么 judge,再看表格里的数字
GameCraft-Bench
45 题
先前固定子集按 seed 20260707 补齐至 15 类各 3 题,不看模型分数选题。编译或运行失败时 B=0,Overall 归零;可运行后四项加权。
核心玩法 M、内容深度 D、功能视觉 V、艺术呈现 A:100B(0.15M+0.35D+0.15V+0.35A)。
FrontierSWE
15 / 17 题
4 道实现、9 道性能、2 道研究。排除需要不可用 Tinker API 登录的题,以及要求更高驱动版本的题。
官方程序逐题验收;平均 reward 是 15 题分数的算术平均,不是全题通过比例。
ProgramBench
本文题数未披露
Agent 用可执行文件与文档重建程序。先算每题隐藏测试通过比例,再对题目取均值。
不等于整题全部通过;本文未列完整任务数、清单、环境和逐题结果。
论文 §4.1、Table 1;Supplementary Tables 4–8、metric definitions。
13 · MAIN RESULTSVanilla → HoH@3;每种任务配置只跑一次有效实验
三种 harness/model 的总体指标都提高,但不能当成生成方差估计
| Harness + model | GameCraft Overall | FrontierSWE mean reward | ProgramBench Avg. Test Pass Rate |
|---|---|---|---|
| Codex + GPT-5.5 high | 49.58 → 71.52 | 0.31 → 0.54 | 60.41 → 66.50 |
| OpenCode + DeepSeek-V4-Pro | 26.90 → 48.98 | 0.23 → 0.31 | 45.27 → 57.56 |
| Pi + MiniMax-M3 | 42.16 → 58.78 | 0.26 → 0.55 | 35.83 → 52.68 |
总体结果平均指标在 3 套 benchmark、3 种完整 harness/model 组合上方向一致。
未做重复生成同题同配置没有重复生成;置信区间只重采样题目。
复核缺口ProgramBench 缺 task 数、逐题结果和运行环境,无法复核失败分布。
Table 1、Table 6。GameCraft:0–100;FrontierSWE:官方逐题 reward,可能超过 1,不能当成准确率。
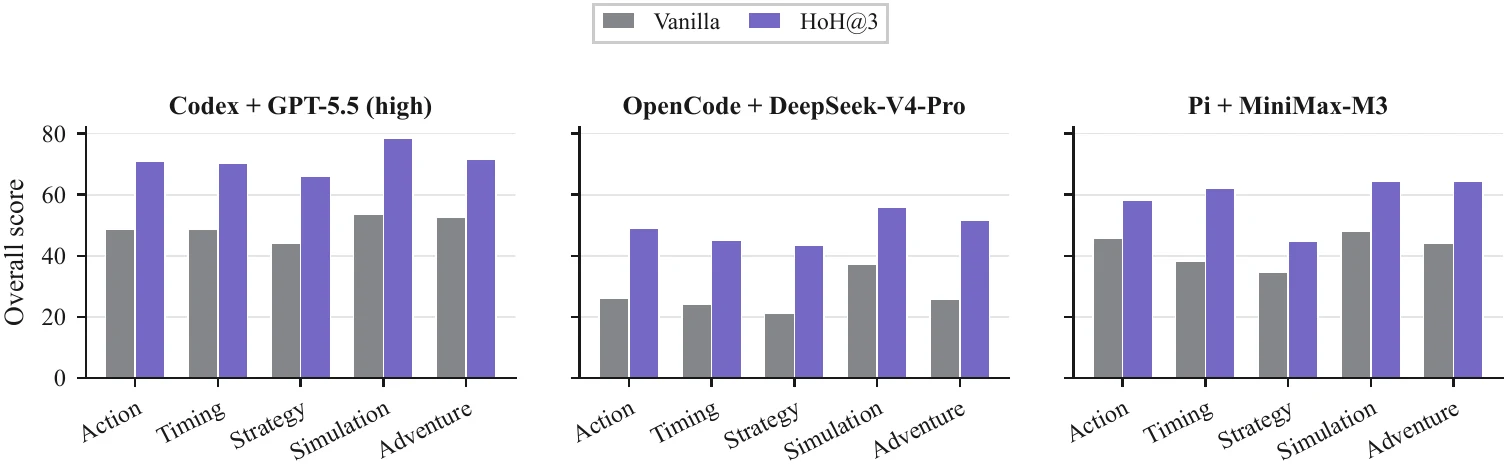
14 · GAMECRAFT COMPONENTS四个评分维度 都提升
提升不只来自“项目终于能启动”,内容深度和呈现也一起变化
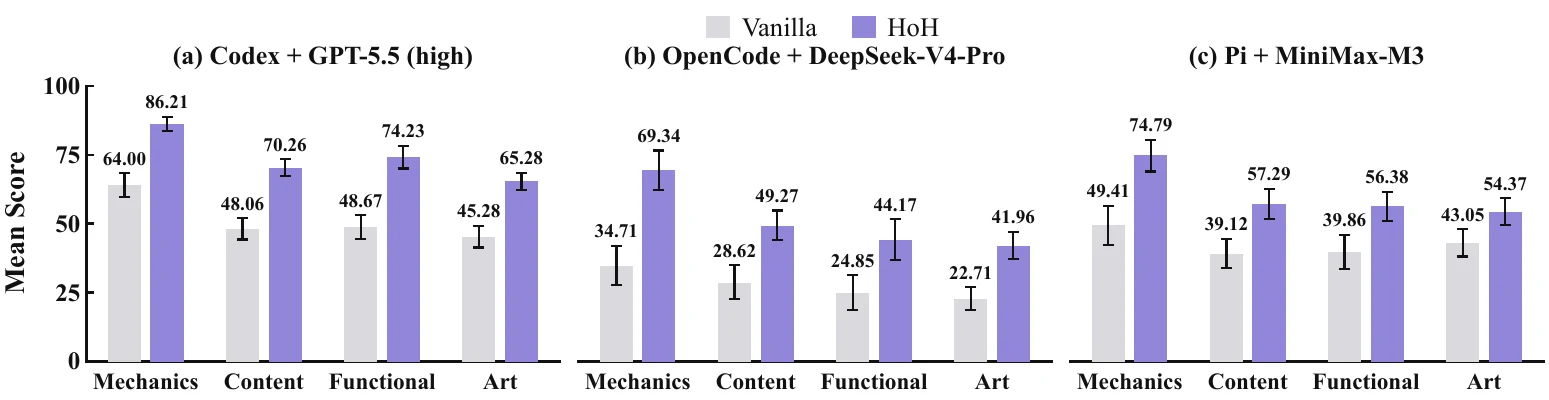
论文 Figure 4:对 45 题做 20,000 次 bootstrap(有放回重采样)的 95% 分位数区间。
Core Mechanics:核心玩法基础玩法与玩家交互。三种 harness/model 都提高。
Content Depth:内容深度关卡、挑战、目标和进展的丰富程度;权重与艺术呈现同为 0.35。
运行门槛仍先执行如果项目无法编译或运行,四项评分再高,Overall 仍是 0。
论文 Figure 4;GameCraft Overall = 100 · B · (0.15M + 0.35D + 0.15V + 0.35A)。
15 · QUALITATIVE ARTIFACTS图片展示结果,不能还原逐步失败轨迹
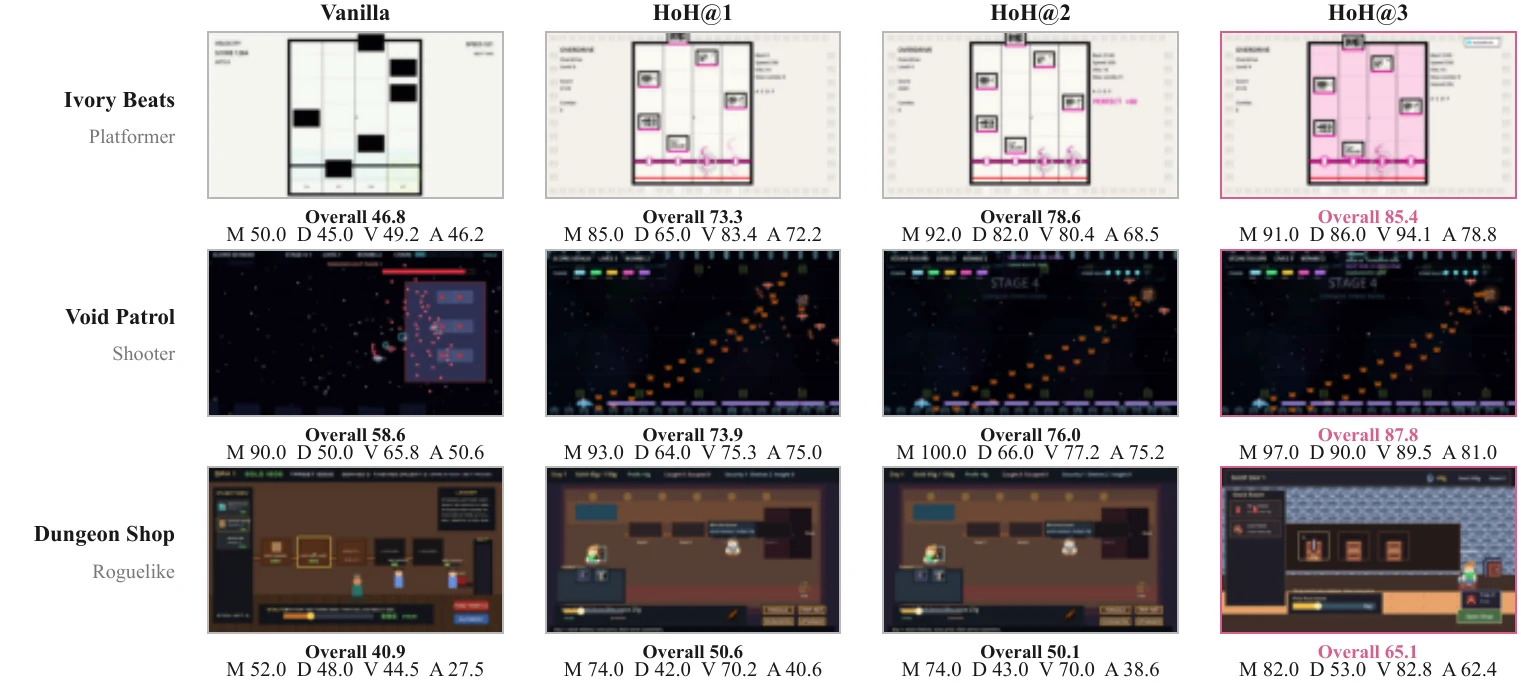
三轮 HoH 更常把核心交互、UI 和场景细节同时补齐
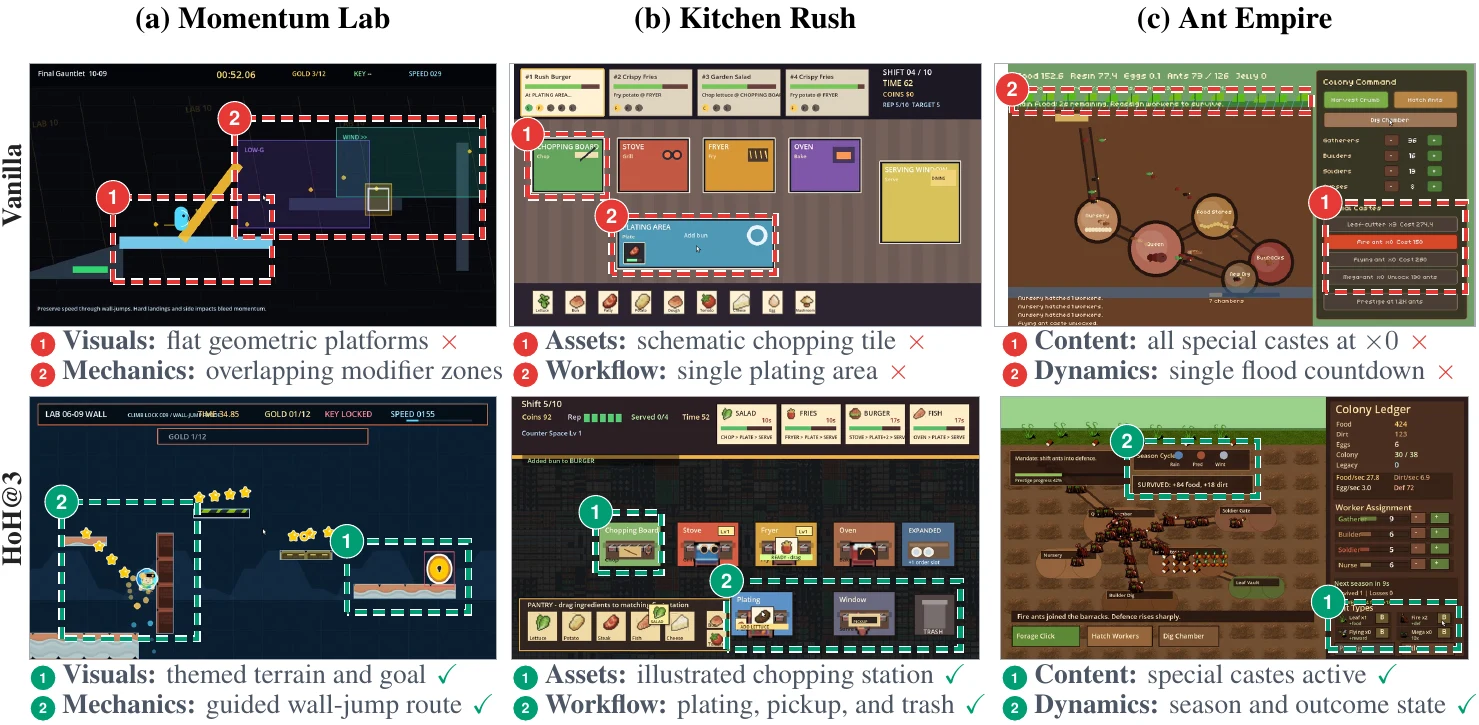
论文 Figure 6:Momentum Lab、Kitchen Rush、Ant Empire。
Momentum LabOverall 34.05 → 70.61;从基础平台场景走向更完整的动量玩法。
Kitchen RushOverall 42.62 → 73.38;订单、厨房状态与管理反馈更完整。
Ant EmpireOverall 65.52 → 87.88;殖民地状态、资源与进展展示更成熟。
证据边界这些是按结果展示的作者选择案例,不能替代同题重复生成或随机抽样案例。
论文 Figure 6;分数来自 Supplementary qualitative table。
16 · BUDGET CONTROL同样开发次数,有无新计划和独立测试
Repeated Vanilla 也会进步,但 HoH 每轮更有效地使用新增 token
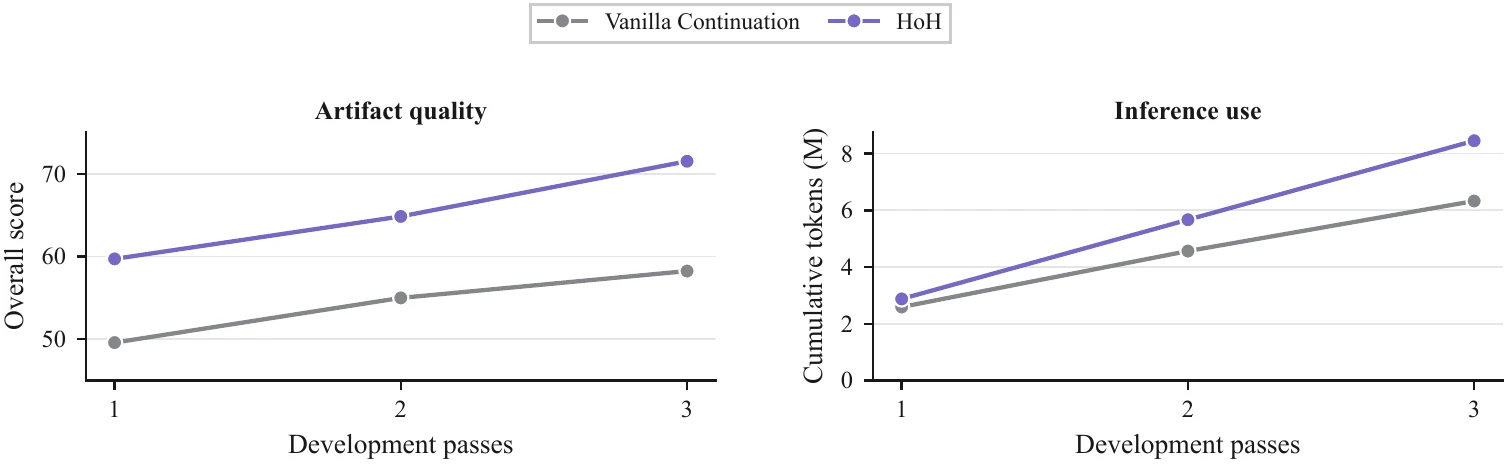
论文 Figure 9:累计 score 与 token trajectory。
| Protocol | Pass 1 | Pass 2 | Pass 3 | Tokens@3 |
|---|---|---|---|---|
| Vanilla / Continue | 49.58 | 54.99 | 58.24 | 6.33M |
| HoH | 59.71 | 64.84 | 71.52 | 8.41M |
同预算附近的关键点HoH@2 用 5.67M tokens 得到 64.84,已经超过三轮 Vanilla 的 58.24 / 6.33M。
仍不是严格等 computeMatched pass 不等于 matched wall-clock、invocation 数或 token;论文另用 budget efficiency 辅助解释。
论文 Table 2、Figure 9;Supplementary Tables 9–10。
17 · ABLATION分别固定计划、隐藏 QA 反馈、从初始项目重建
三项消融都降低均分,从头重建最费 token
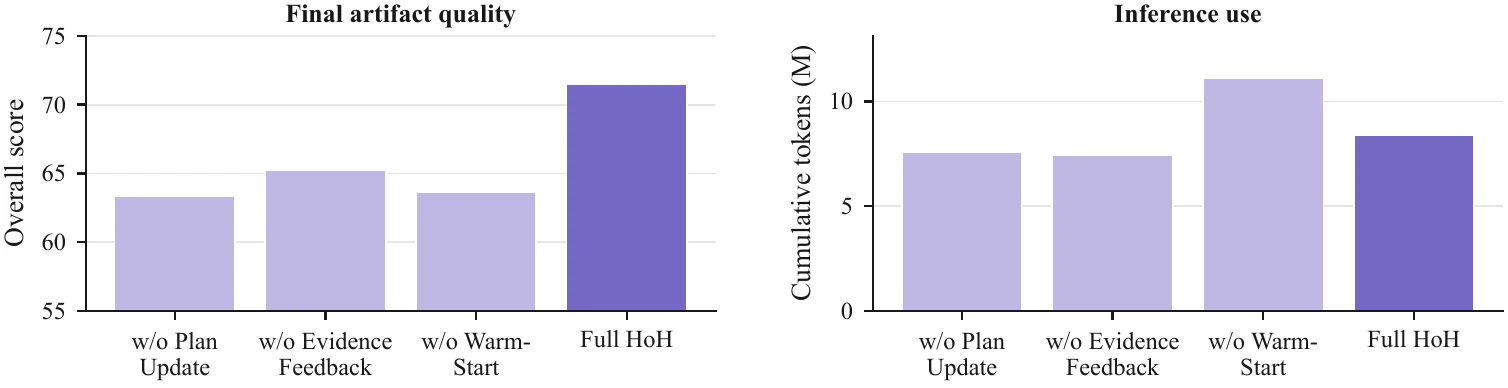
论文 Figure 10:最终均分与累计 token。Lighthouse 是单题反例:80.90 → 81.50(去掉 Warm-Start)。
Full HoH@3 · 71.52 / 8.41M更新计划、传递 QA 记录、沿旧项目继续全部保留。
w/o Plan Update · 63.39后续轮次固定使用第一轮开发文档。
w/o Evidence Feedback · 65.23QA 仍测试,但下一轮 Planner 看不到它的记录。
w/o Warm-Start · 63.67 / 11.12M每轮从初始工作区重建,整体更费 token。
Table 3、Figure 10、Table 22。消融降低总体均分;正文“每题都下降”的表述不符合 Lighthouse 一行。
18 · FRONTIERSWE持续迭代能提高部分任务,不保证跨过每个 verifier
Dominance 上升与长期零分可以同时存在
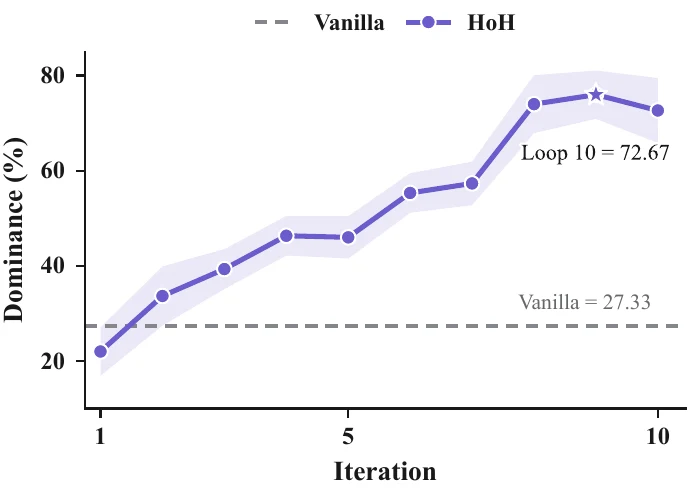
Figure 5:11 个 Codex 阶段互比,Vanilla 27.33%,HoH@10 72.67%;阴影 ±1 标准误。
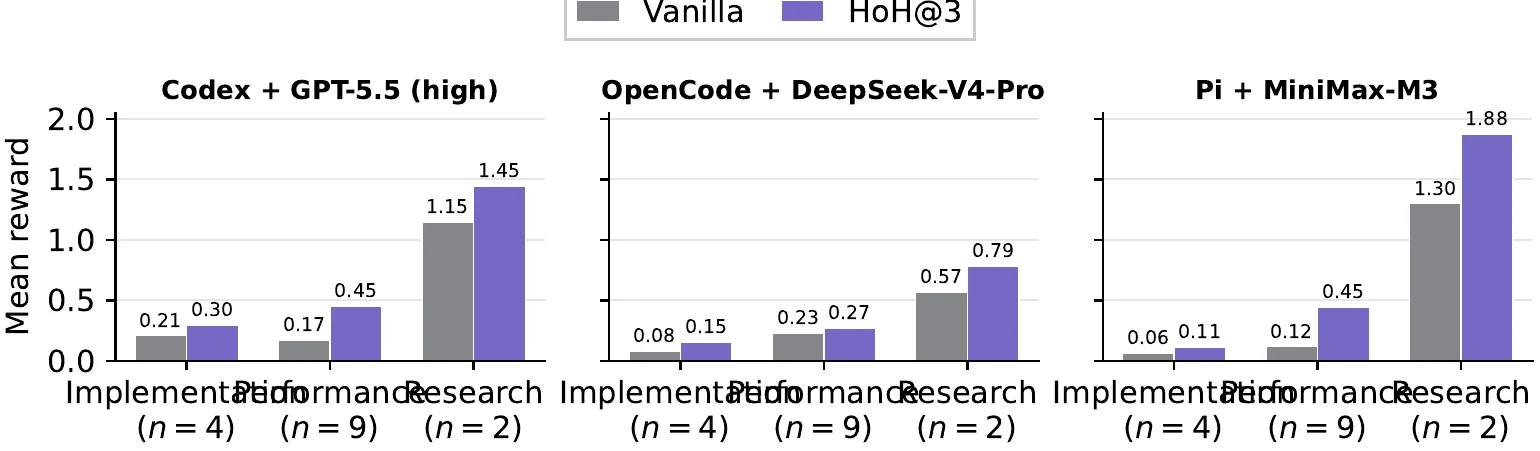
Figure 8 按任务类别显示均分。主表用三系统 × 四阶段,共 12 配置;同一 Vanilla 为 22%。比较池不同,不能把两值拼成准确率曲线。
Figures 5、8,§4 与 B.7。Codex 的 Cranelift、Dependent Type Checker、FFmpeg、Inference System 到 HoH@3 仍为 0。
19 · COST / NEGATIVE RESULTS不同服务商的 token 记账方式不能直接比较
总体平均上涨,不代表每个任务、每个阶段都变好
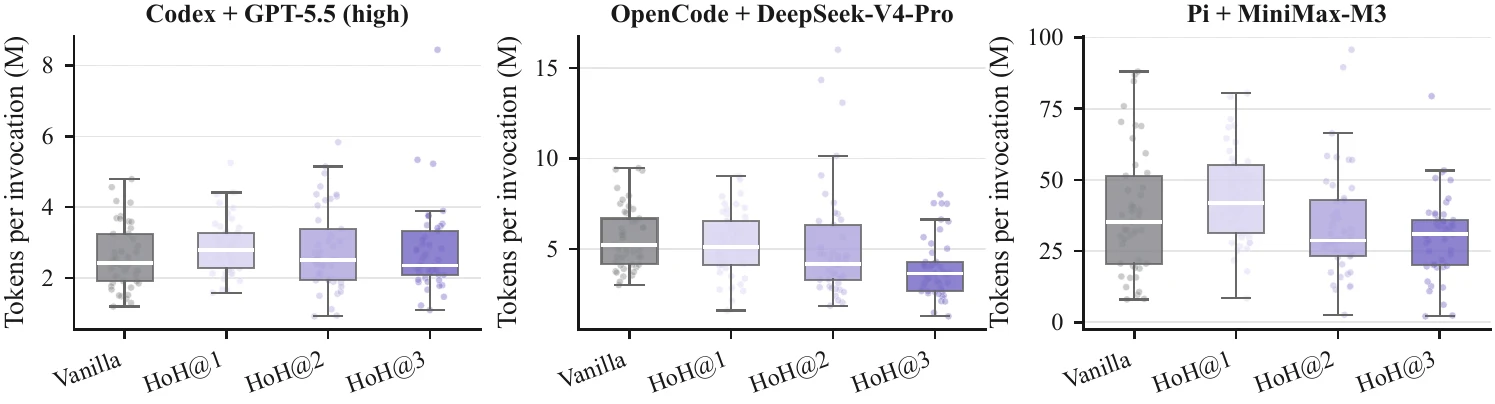
论文 Figure 11:每次开发调用的 token 分布。
单题回退Pi 的 Spire Descent 26.61 → 10.96,Pipe Crisis 53.26 → 37.65;总体均分上涨不等于每题上涨。
生成方差未知每种任务配置只跑一次有效实验,没有共同生成 seed,也没有同题重复采样。
不同 provider 不同记账缓存读入、输入和输出 token 的记账方式不同,Figure 11 适合看同一 harness/model 内部,不适合横向算单价。
论文 Figure 11;Supplementary complete task scores and token accounting。
20 · REAL RECEIPT / LOOP 70Fusepoint official repository · revision 55b442fc
代码版本改变后,仍要验证玩家能否走完这条路径
Planner 要修什么?
把 4 个战斗呈现问题安排为 3 项任务,同时保留:
- 正常启动
- A / B / C 三组敌人:3 / 5 / 10
- 鼠标视角、武器组件与结局逻辑
Loop 704 个问题
本轮待测版本:
下面的 QA 结论只属于这份代码。
loop-70-c3d32741612b下面的 QA 结论只属于这份代码。
规划
修动画绑定、准备完整敌人战斗测试、修剧情提示和反馈清理。
开发记录
源码哈希发生变化,产生新候选。公开开发回执只有版本锚点,没有完整修改过程。
局部通过
正常启动通过;步枪不再误用 Pistol_* 手枪动画。
仍未验证
没有完整瞄准、射击、换弹、受击与死亡流程的证据。
Fusepoint Loop 70 Planner / Developer receipts;官方仓库 revision 55b442fc。
21 · REAL RECEIPT / VERDICTsetup → action → observation → FAIL
局部修复通过,但玩家仍不能完成战斗和重新开局

Figure 1:前 70 轮发现 81 个问题,关闭 65、未解决 16;17 个曾关闭问题因回归重开。
准备与操作启动、进入游戏,准备三组遭遇战,再推进战斗;测试前后源码哈希一致。
观察 1有 3/5/10 个敌人,只看到待机与走路;未证明完整战斗动作。
观察 2Replay 后部署按钮无法重开;llvmpipe 软件渲染采样为 8 FPS,不能证明原生性能。
判定 · FAIL / BLOCKED必需检查未全部通过、仍有阻断项;局部启动 PASS 不能通过整轮验收。
公开 Tester 记录;此案例是 GPT-5.6-Sol / Godot 4.7 / 专用 skills,与主 benchmark 配置不同。未重新运行。
22 · QUALITATIVE ATLAS / TAKEAWAYS全部论文 Figure 1–16 已覆盖
最值得复用的是 与候选版本绑定的证据;最需要补的是重复实验与 QA 校准
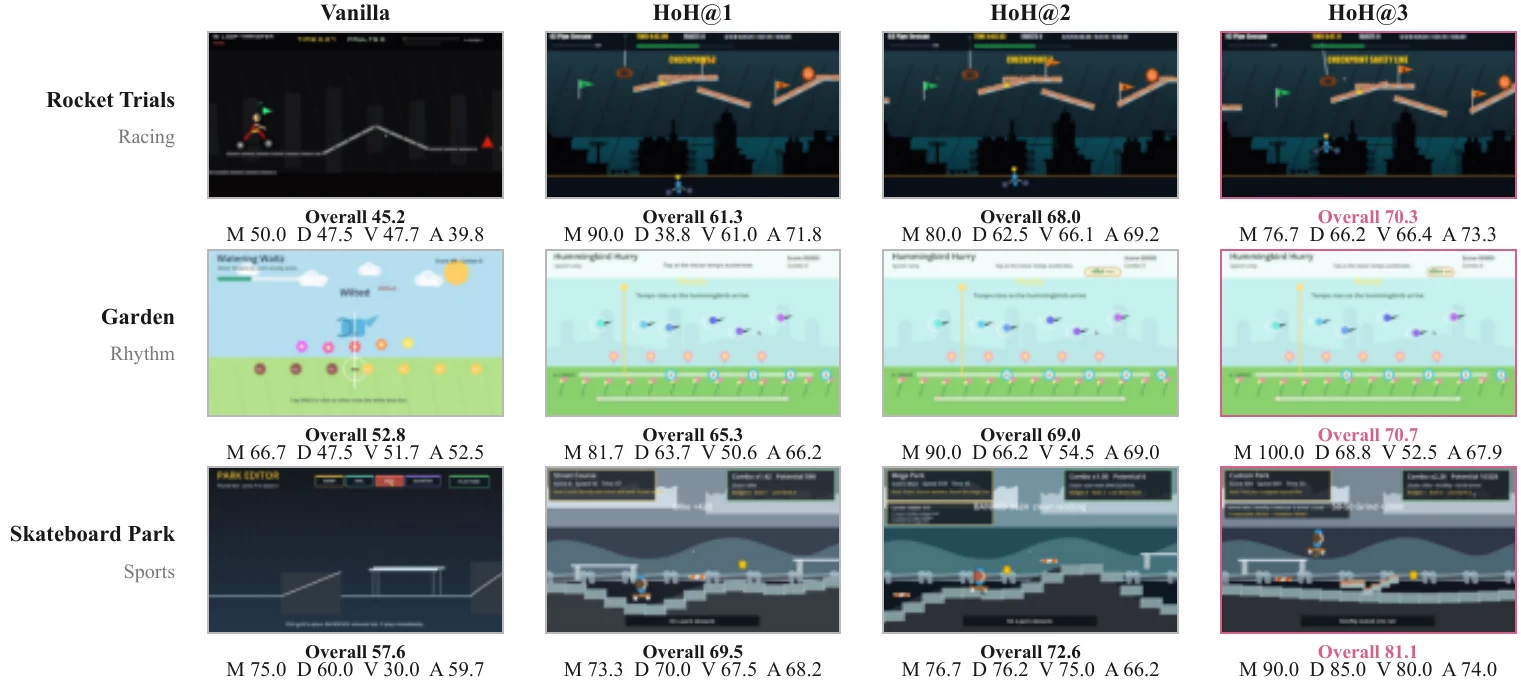
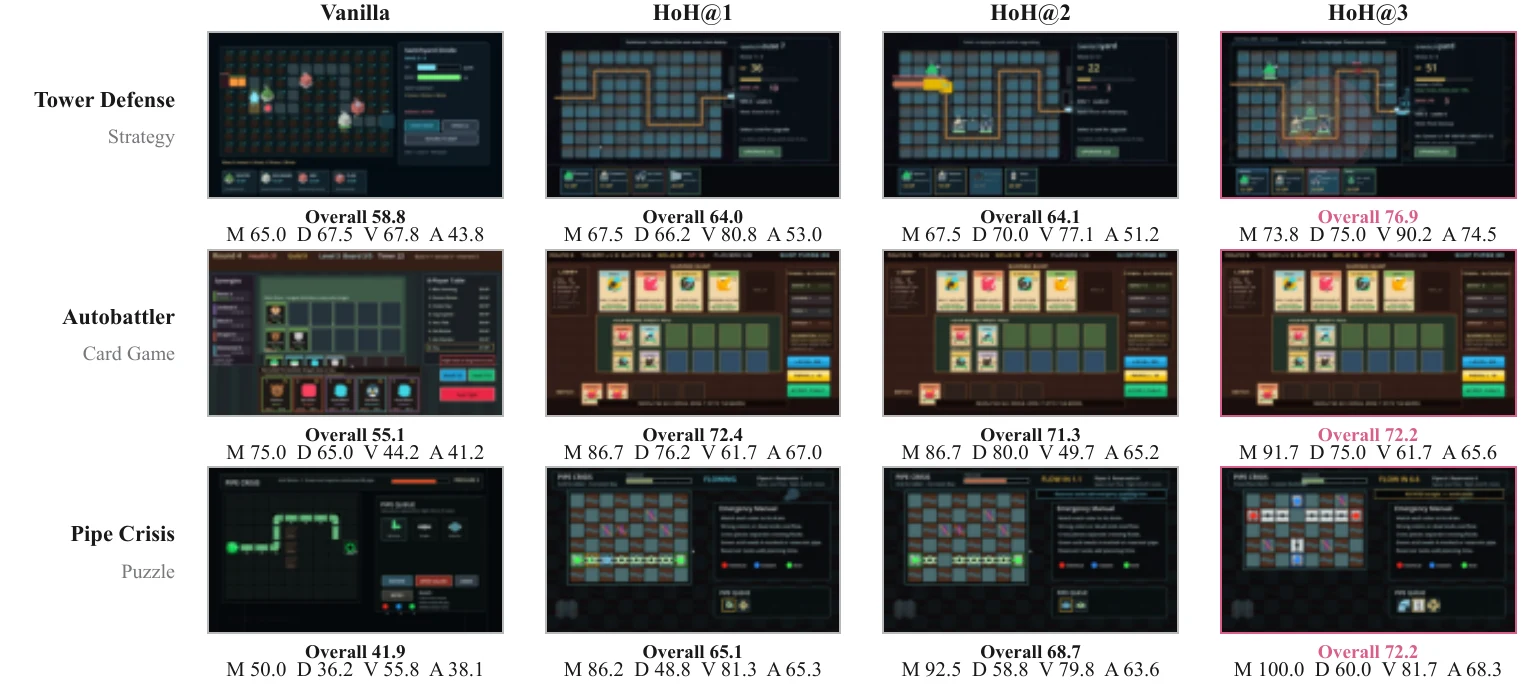
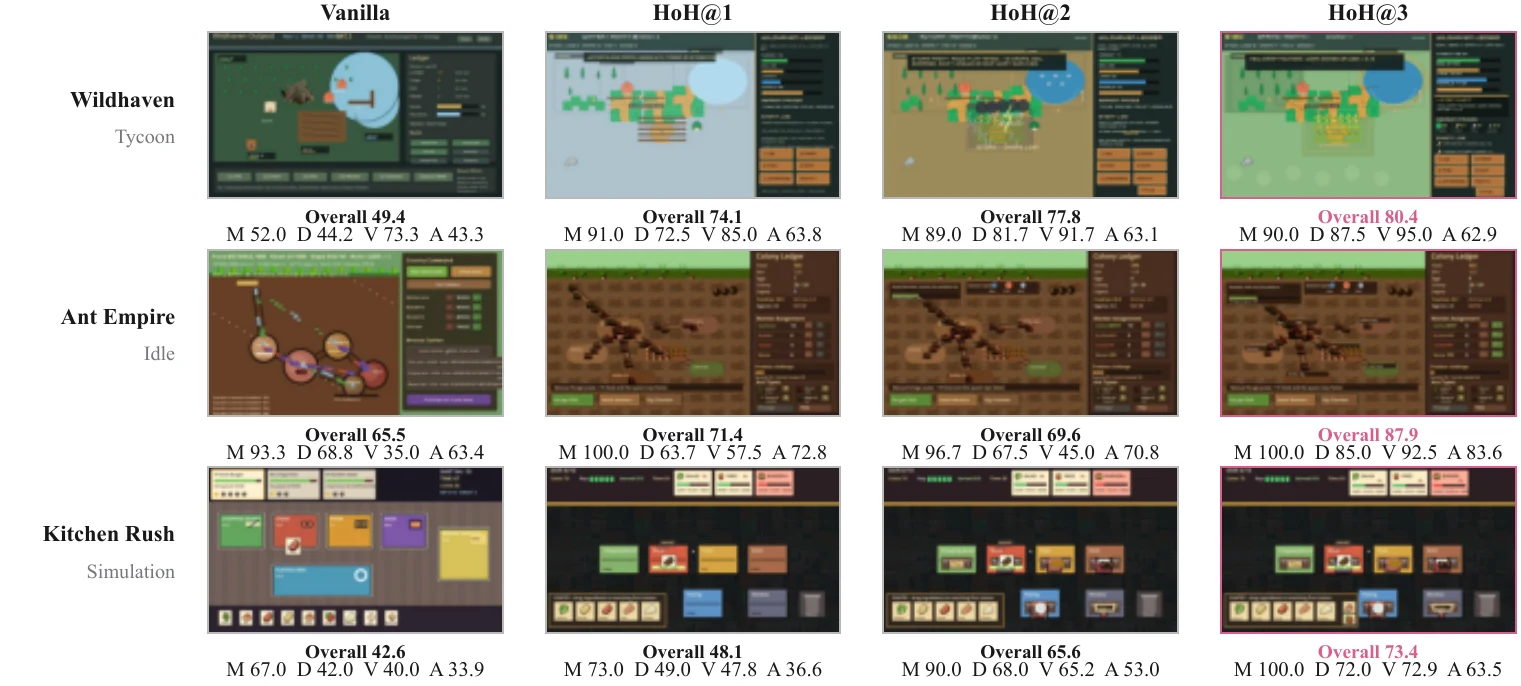
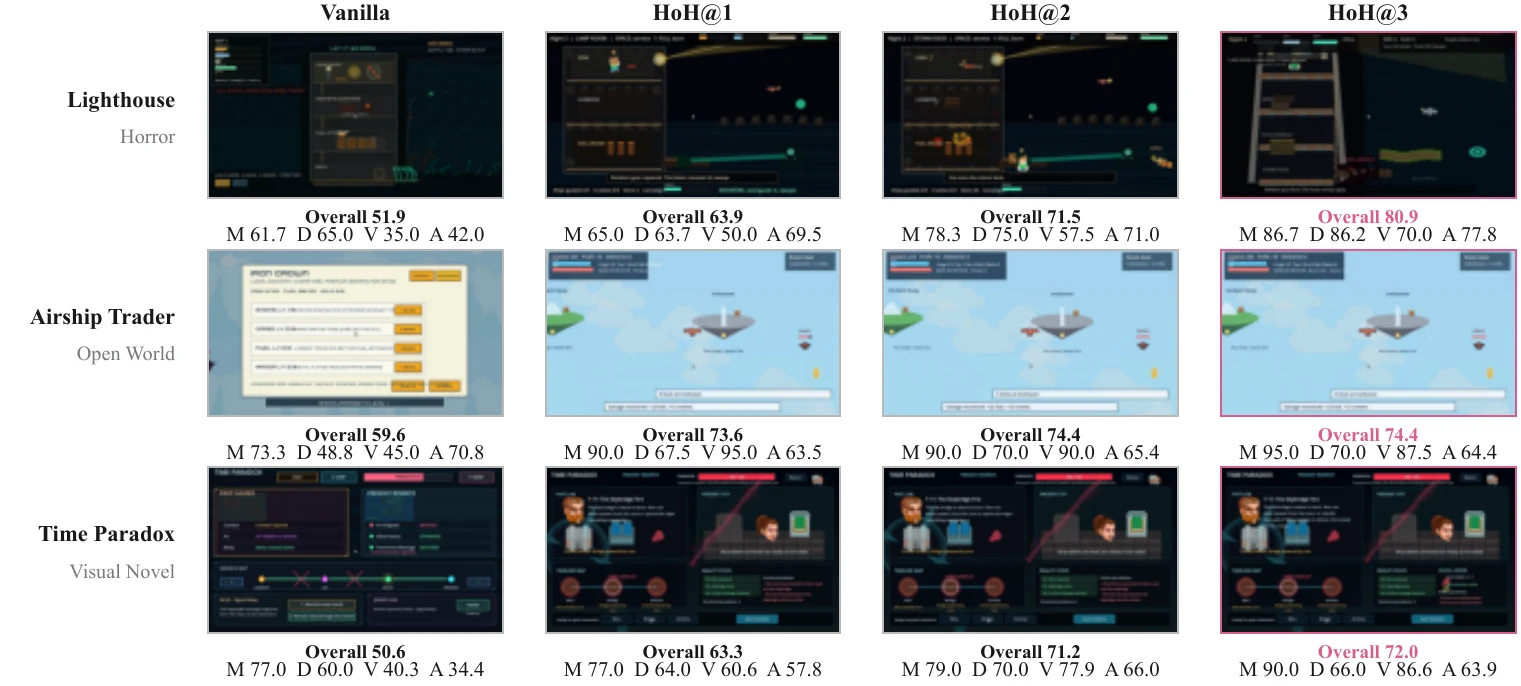
实验支持完整 HoH 协议有效三种 harness/model、三套 benchmark 的总体指标均高于 Vanilla;同开发次数比较与三项消融支持跨轮记录有用。
未验证没有同题生成方差一次有效实验 无法回答稳定性;bootstrap 只重采任务。
待补实验QA 还未校准需要测 误判通过/失败率、停止条件、何时回滚,以及固定预算的分配。
作者兴趣度9.5 / 10对 Claude Code、Codex 式完整 harness 的多日自治开发非常直接。