这份报告把 GPT 6 Astra 放进模拟机器人:每次看图、读取机械臂状态,再通过工具让机器人移动。作者比较两种用法:Astra 自己构造所有动作(Direct);先让已有的机器人动作模型 π0.5 提出一段动作,再由 Astra 决定接受还是纠正(Hybrid)。研究问题是,理解目标和掌握操作技巧这两类能力,怎样配合才有用。
博客作者本人的兴趣程度:8 / 10。本文依据网页版技术报告和固定代码版本,未复现机器人实验,也未核实到报告的 arXiv 条目。数值图表与流程图按项目自有文档的 MIT 许可引用,去掉第三方模型标志,保留原英文与数值;版权说明。视频中的模拟资产许可未完全核清,本文链接原片,不再分发视频或其截图。
1. Motivation:看懂任务以后,还要把动作做出来
Astra 的语义判断能否弥补机器人策略的错误,而机器人策略能否补上 Astra 的操作细节?“把木制玩具放进右篮”至少有两种失败:模型认错物体或篮子;模型认对了,却没抓稳、撞上篮沿或太早松手。前一种主要涉及任务理解,后一种需要处理连续的运动与接触。
π0.5 从机器人数据中学过抓取、搬运等动作模式,作者将这些已学到的习惯称为动作先验(action prior)。它也可能抓错目标,或者在上一步失败后继续下一步。Astra 可以显式检查目标和执行反馈,但每段都独立构造动作既慢,也不一定稳定。报告要检验的就是两者一起使用是否优于 Astra 独自控制。
2. Related Work:比较的是运行时分工,没有新的训练算法
最接近的路线是通用模型直接控制机器人,以及通用模型调用已训练的动作策略。原报告的 Related Work 主要梳理社区探索,未给出全面的同条件算法对照。下面按控制方式比较,不跨项目比较成功率。
| 路线 / 原文举例 | 输入与输出 | 与本报告的区别 |
|---|---|---|
| π0.5 等 VLA | 图像、指令、机器人状态 → 一段连续动作 | 依靠训练出的操作模式;本报告再让 Astra 检查具体候选和上一段结果 |
| Robocurve 等直接控制实验 | 图像和反馈 → 夹爪目标或低层控制命令 | 通用模型自行构造动作;这里的 Direct 是使用同一任务说明与末端接口的对照 |
| 示范学习 / 策略调用 | 示范、当前观察或分解后的子任务 → 机器人动作 | 本报告不是只分解任务、调用一次技能;Astra 在每段审查 π0.5 的具体运动建议 |
报告用 System 1 / System 2 类比“熟练动作”和“显式思考”,不是神经结构证明。源码里的 teacher 指 Astra,student 指 π0.5,两者在这里都没有做蒸馏训练。对 LLM / Agent 研究更直接的借鉴是怎样提供候选、反馈和受限执行工具。
3. Method:候选、审查、短段执行,再重新观察
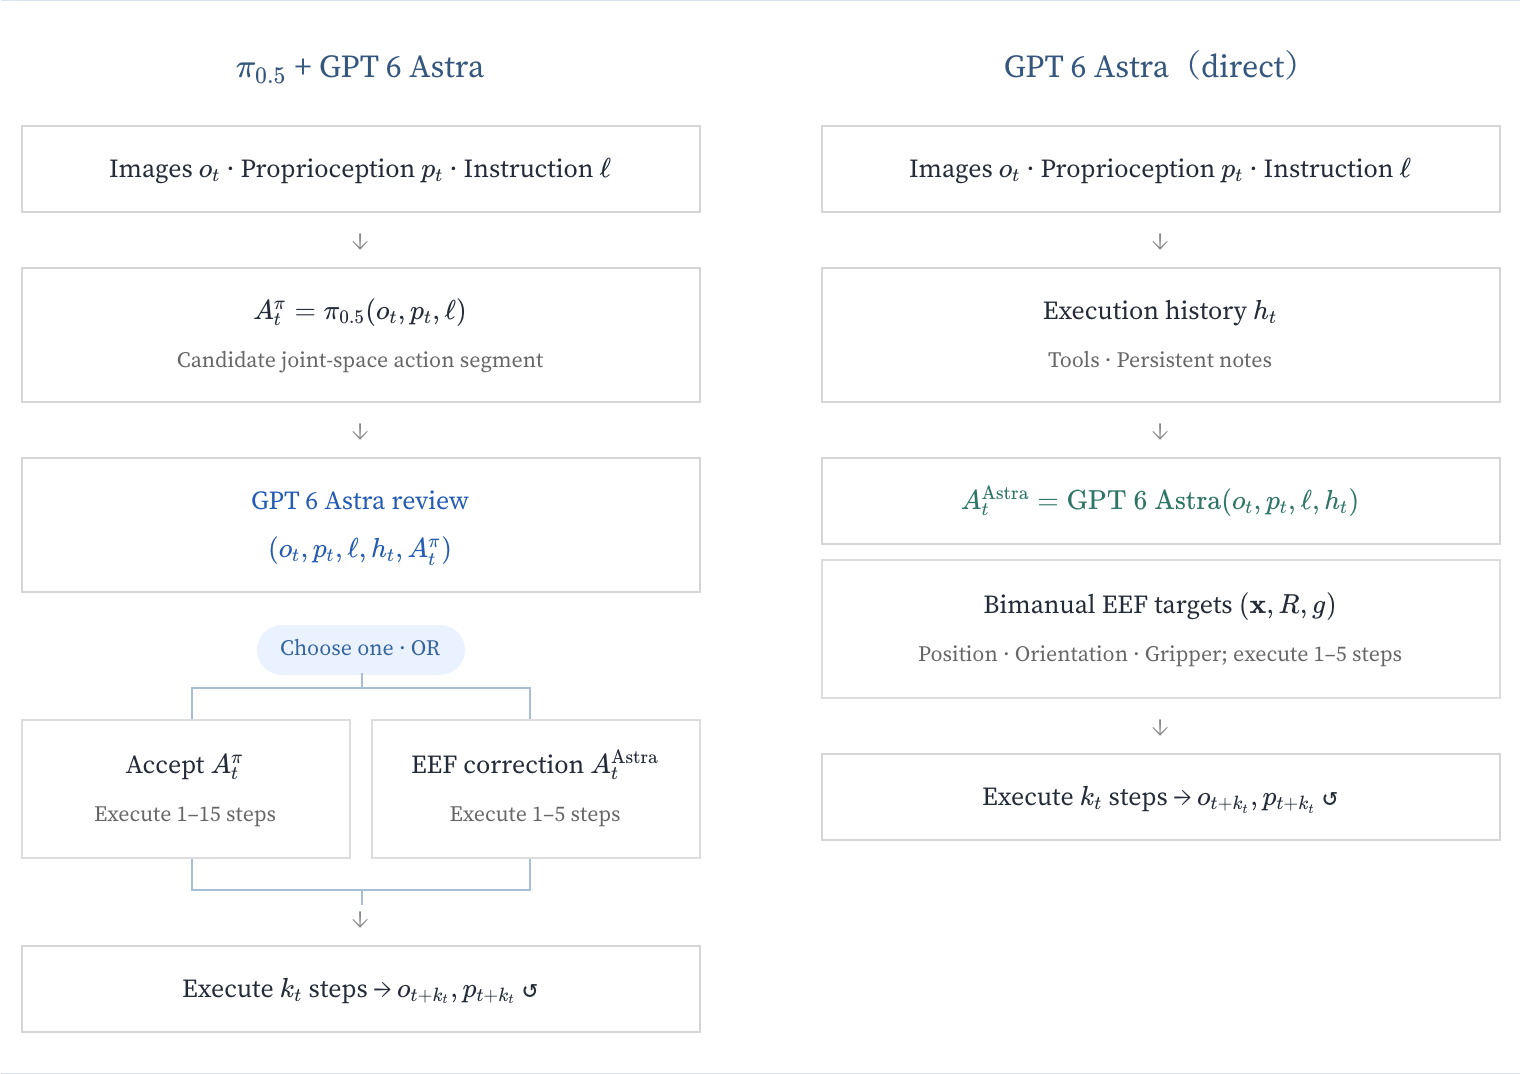
Hybrid 让 π0.5 提供动作,让 Astra 决定这一段如何执行;Direct 的所有动作都由 Astra 构造。两边 Astra 都用 xhigh(较高的推理计算档位),并保留 Codex 的读文件、看图、计算和笔记工具。
3.1 一次决策,模型和控制程序分别做什么
RoboDojo 使用双 ARX X5 机械臂。观察包括头部和左右腕部的三张 640×480 RGB 图,以及 14 维机器人状态:左臂 6 个关节角、左夹爪开合命令、右臂 6 个关节角、右夹爪开合命令。关节角和夹爪位姿有测量反馈;夹爪开合值却是最近下达的命令,不是实际指间距离。
- π0.5 读取这次观察与原始指令,生成 50×14 个绝对关节目标。控制程序根据机器人几何计算每步对应的夹爪位置与朝向,即 FK(forward kinematics)。这只计算机器人,不预演物体、碰撞或抓取结果。
- Astra 看当前图像、机器人状态、上一段执行记录和候选夹爪轨迹。它判断“上一段实际怎样了”以及“下一段建议是否符合当前子目标”。默认图像预览最长边约 480 px,也可以打开原始图像。
- 选择
student就原样执行候选前 1–15 步;选择edit就对候选夹爪轨迹加位移、旋转或开合修正,执行 1–5 步;选择eef就给左右夹爪显式目标,执行 1–5 步。夹爪这样的末端执行部件称为 EEF(end-effector)。 - 控制程序验证范围并执行;
edit/eef用 IK(inverse kinematics) 把夹爪目标转成关节目标。每个实际控制步后,根据测量状态重新计算局部 IK。动作段结束才给 Astra 新观察;候选中没执行的部分丢弃,π0.5 从新状态重新生成。
Direct 完全不启动 π0.5:Astra 从观察和历史生成双臂 EEF 目标,通过同一局部 IK 执行 1–5 步,再观察。每臂一次修正最多 5 cm / 0.35 rad(约 20°);更小的内部增量与关节限位也受约束。这些限制减少突变,不保证轨迹无碰撞、目标可达或物体抓稳。
3.2 何时允许修正:失败与选错子目标分开判断
Astra 必须先报告两种状态:execution_status 说上一段是否进展、失败或仍不确定;intent_status 说下一段候选是否符合当前目标。例如物体没有随夹爪抬起是执行证据;尚未抓住就开始运往篮子,是下一步的前置条件有问题。候选的“意图”是从运动建议推断的,不是读取 π0.5 的内部思维。
1 | # 根据官方 gate_assessment.py 简化改写;Python 3,非完整检查器。 |
只有上述任一状态成立才允许修正;“不确定”或“不喜欢这个姿势”不够。已经失败,也可以接受 π0.5 合理的重试。Python 检查的是 Astra 填的字段与动作范围,不会独立证明它的语义判断正确;如果 Astra 把正确候选误判成目标错误,字段检查也未必能发现。
执行 Agent 能看到图像、机器人测量、历史、任务说明与完成要求;不能查询隐藏物体真值、未来物理状态或评分来规划,也不能回滚。是否完成由模拟器自带的检查规则判定,报告称为 native evaluation(原生评测)。固定 RoboDojo 案例禁止模型提前宣告停止;基础设施中断与原生失败不是同一种记录。
3.3 真实案例:木制玩具应该进右侧红篮
案例来自公开记录 classify_objects_by_language__standard__g0__l0。RoboDojo 的任务代码从场景里各组物体类别生成英文指令:汽车进左篮、手表进中篮、木制玩具进右篮,然后双臂归位。指令与检查条件都由 benchmark 的 Python 任务代码生成或注册,未另行提供人工逐条标注的判定文件。记录里的 Score 是任务的部分完成分数,具体规则在下一小节。
视频中的 Decision 是 Astra 的决策序号,Control 是累计控制步。Decision 29 接受 π0.5:释放左篮中的绿色汽车并向上撤回。到 Decision 33 / Control 409,Astra 将手里木制玩具的候选方向修正到右侧红篮:左臂位移修正为 (+4.5 cm, 0, +0.1 cm),维持闭合,执行 5 步。稍后 Decision 47 又接受 π0.5,接近剩下的木制狮子。这说明一次局部纠正怎样接回已有策略,而不是 Astra 接管整题。
最终 Hybrid 用 794/1,100 个控制步、73 个动作段,其中 130 步由 Astra 修正,原生结果为成功、Score=100。配对 Direct 用尽 1,100 步、220 段,失败、Score=40。公开视频覆盖了这段行为,公开摘要给出终态;未发布完整逐步 checker 结果,不能进一步断言 Direct 最后究竟哪组物体放错。
3.4 Judge:判断的是场景几何,不是让 VLM 看图打分
所核查的 RoboDojo 版本中,run_reward() 要求:三组物体全部在各自篮子范围内,物体参考点不高于篮子包围盒顶部 1 cm 以上,双臂归位。具体的“在篮内”检查是物体 root point(模型坐标系的参考点,不一定是重心)投影在篮子水平多边形内,且高于其底部;它不检查物体整个网格都在容器内部。归位容差是每个位置坐标偏差 ≤15 cm、朝向差 ≤20°。
因此,若汽车进了中篮,即使抓取和搬运都顺利,汽车组的指定篮检查仍失败;这是假设动作按已发布规则推得的失败例,不是未公开的模型日志。另一种容易忽略的失败是物体放对、双臂没归位:最终成功仍为 0。
部分分数也不是“放对物体的百分比”:该任务按完成任一类、完成任意两类、完成三类给 10、40、100 分,各阶段还要求释放夹爪、指定篮内没有其他类别。控制程序逐步检查,至多每步晋级一次;最终没通过成功检查,100 分档退回 40。Score=40 表示到过相应评分阶段,不足以反推出最后的完整物体状态。任务与几何规则是程序编写的,报告未披露独立人工复核或标注一致性研究。
代码与核查:原生条件、公开案例、可离线复算的指标
案例原始指令:Put car objects into the left basket, watch objects into the middle basket, and wooden_toy objects into the right basket, then reset the robot arm.
两次记录的场景与策略随机种子均为 0。
代码来源分别为 任务定义、几何条件与 分阶段评分。任务代码的三个类别前缀是 cat0/cat1/cat2,分别对应 basket0/basket1/basket2;gen_instruction 从当次场景读出类别名字,再生成指令。不是模型自己定义类别对应关系。
本文提供 100 条公开结果的指标字段和Python 3 核查脚本。把两者放在同一目录,运行 python3 verify_metrics.py。只重算记录中的成功率、Score、步数与 token,不能重现未公开的动作日志,也不需要 GPU、API key 或模拟器。
4. Experiments:RoboDojo 有收益,RoboLab 给出相反结果
两套环境支持一个有条件的结论:已有动作策略可能帮忙,但不能保证加入它就更好。先明确每个分数的分母,再看结果。
4.1 RoboDojo:同场景配对,但任务不是均匀采样
作者把官方 π0.5 成功率的 0–72% 划为四个等宽区间,从低到高选 6、2、1、1 个任务。十项各跑五次,共 50 次;数字排列、装箱、叠衣服为 2 次标准加 3 次随机场景,其余为五次标准布局。Direct / Hybrid 对齐任务、场景及记录的 seeds(控制随机场景与策略采样的随机种子);源码不保证完整物理状态逐位一致。
成功率 = 成功次数 / 50。平均 Score = 对有分数的运行逐次求均值,并转成 0–100:Hybrid 为 100 × 31.30 / 50 = 62.60;Direct 为 100 × 18.15 / 48 = 37.8125。Direct 有两条未得到原生终态判定的记录:成功率按未成功计入 50 次,Score 则缺失,只用 48 次。不能把缺分补零,也不能把这两条说成已由原生规则判定失败。整体 Score 不是简单平均十个任务的平均数。
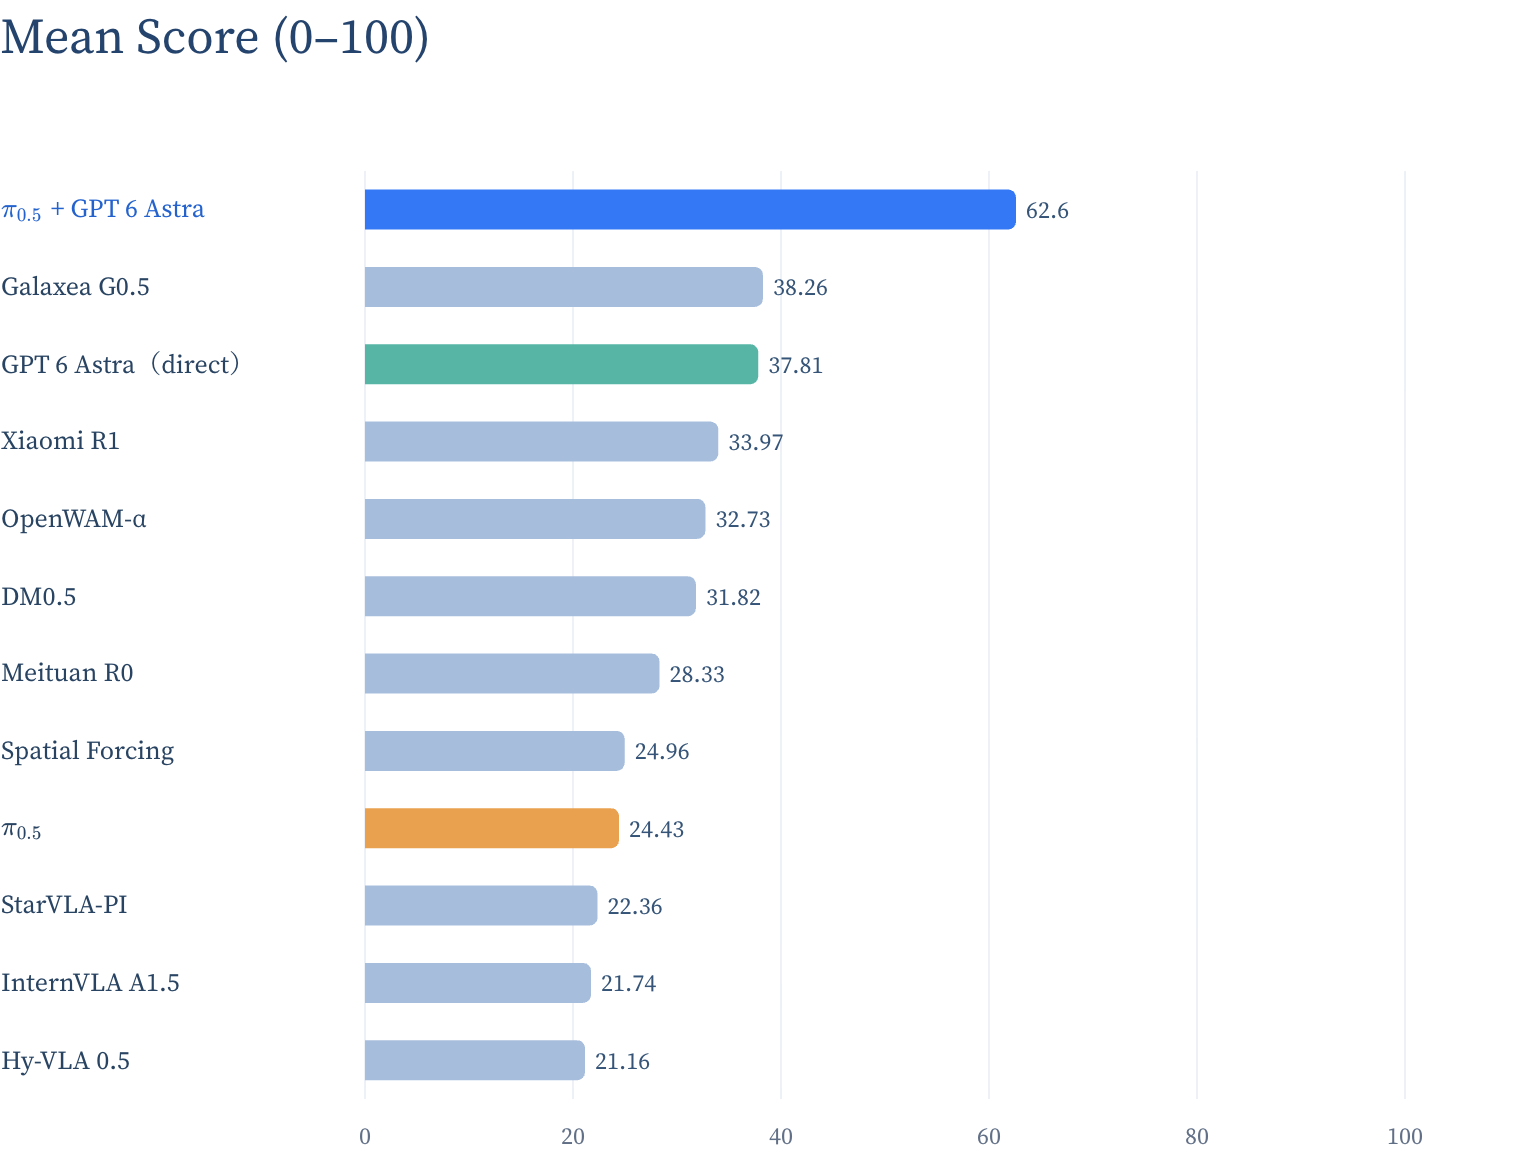
成功率 Hybrid 48%、Direct 26%;π0.5 公开参照为 15.67%,Score 24.43。后一个比较不具备前两个方法那样的配对条件。改善集中在叠衣服(5/5 对 2/5)、瓶子入桶(5/5 对 1/5)、搭塔(3/5 对 0/5)等;语言分类反而是 1/5 对 2/5,整理桌面两边均 0/5。刚才的成功案例用于解释方法,不能替代这张逐任务成绩单。五次测试也不足以稳定估计一个任务的成功概率。
展开:Figure 3 成功率、Table 1 两种指标、Figure 1 开篇原图
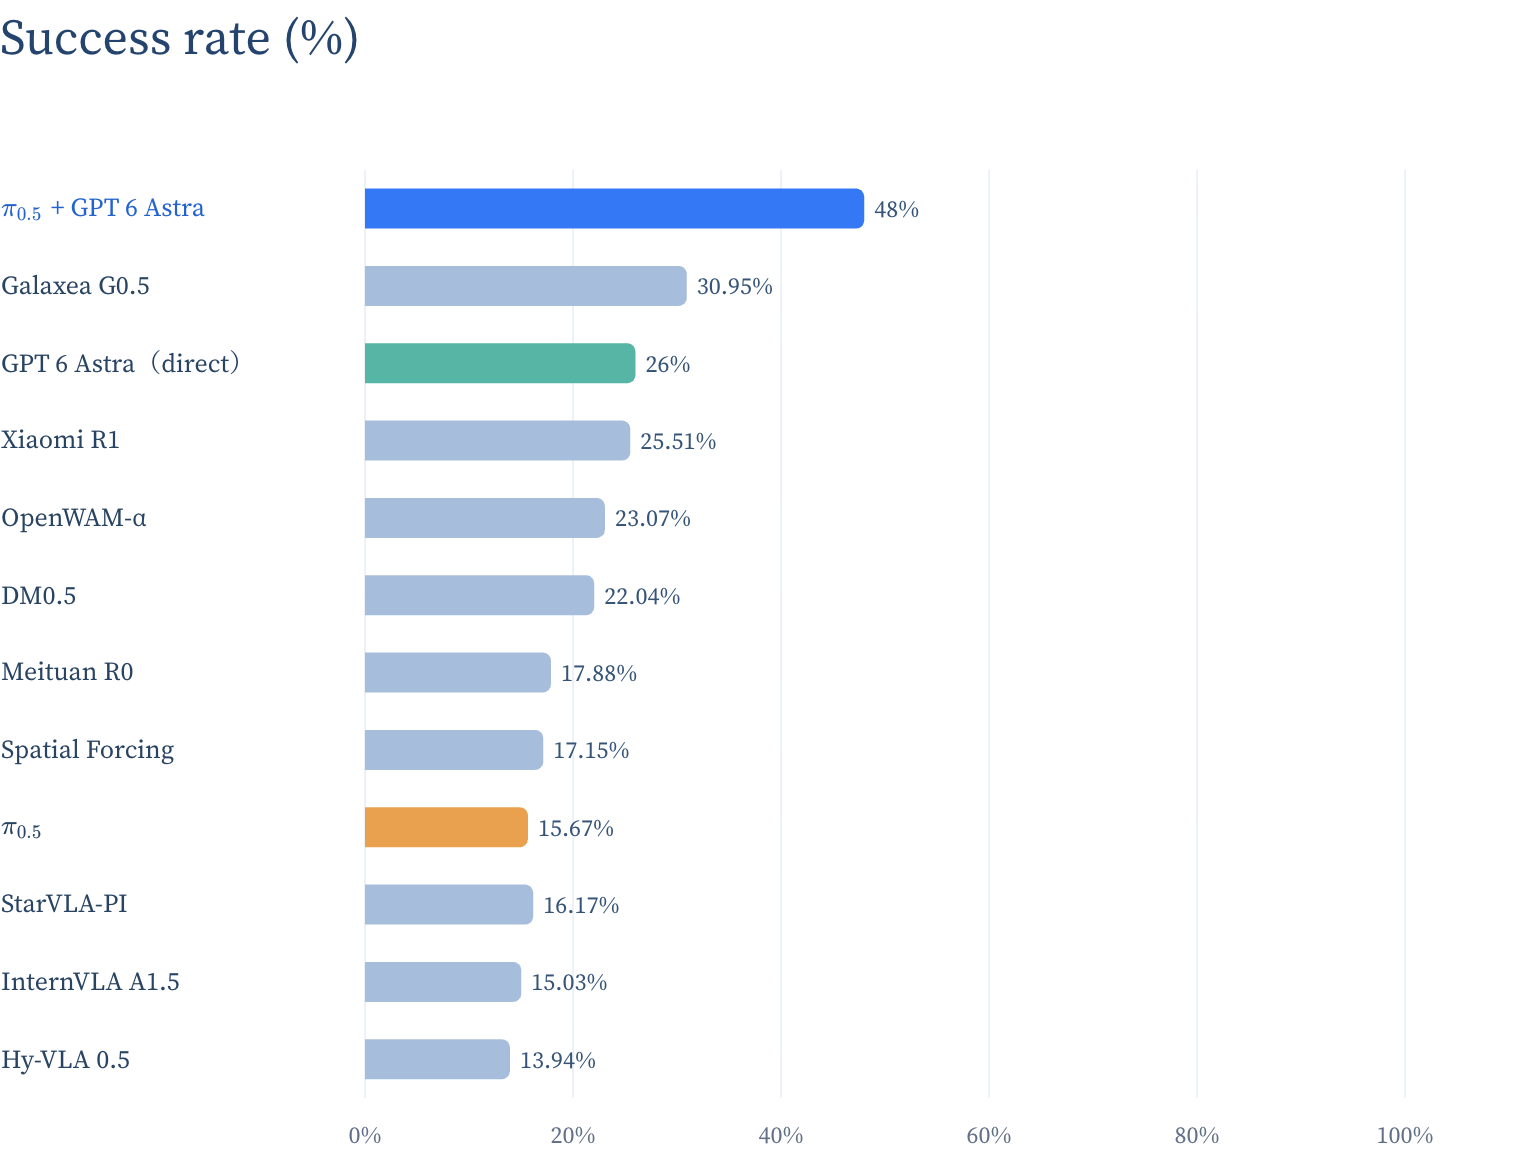
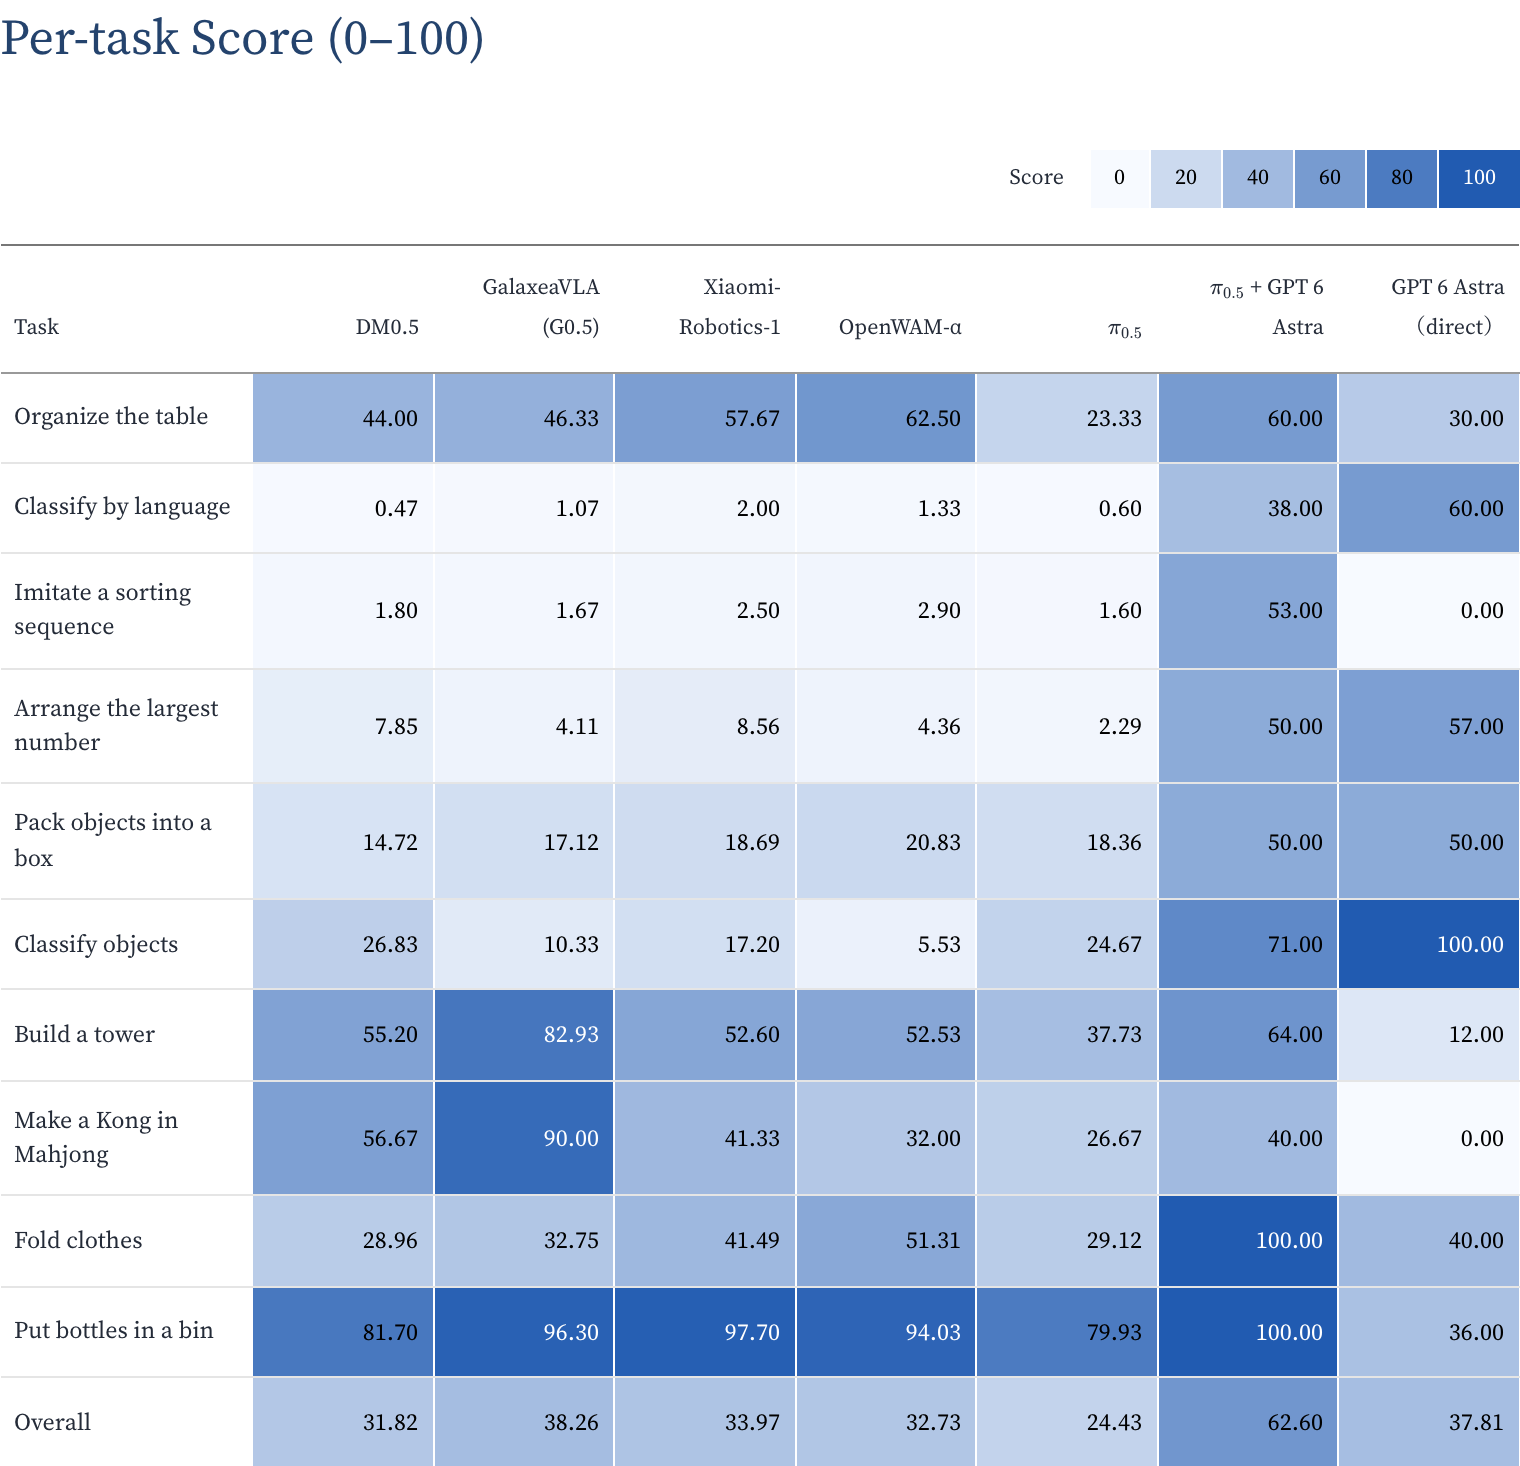
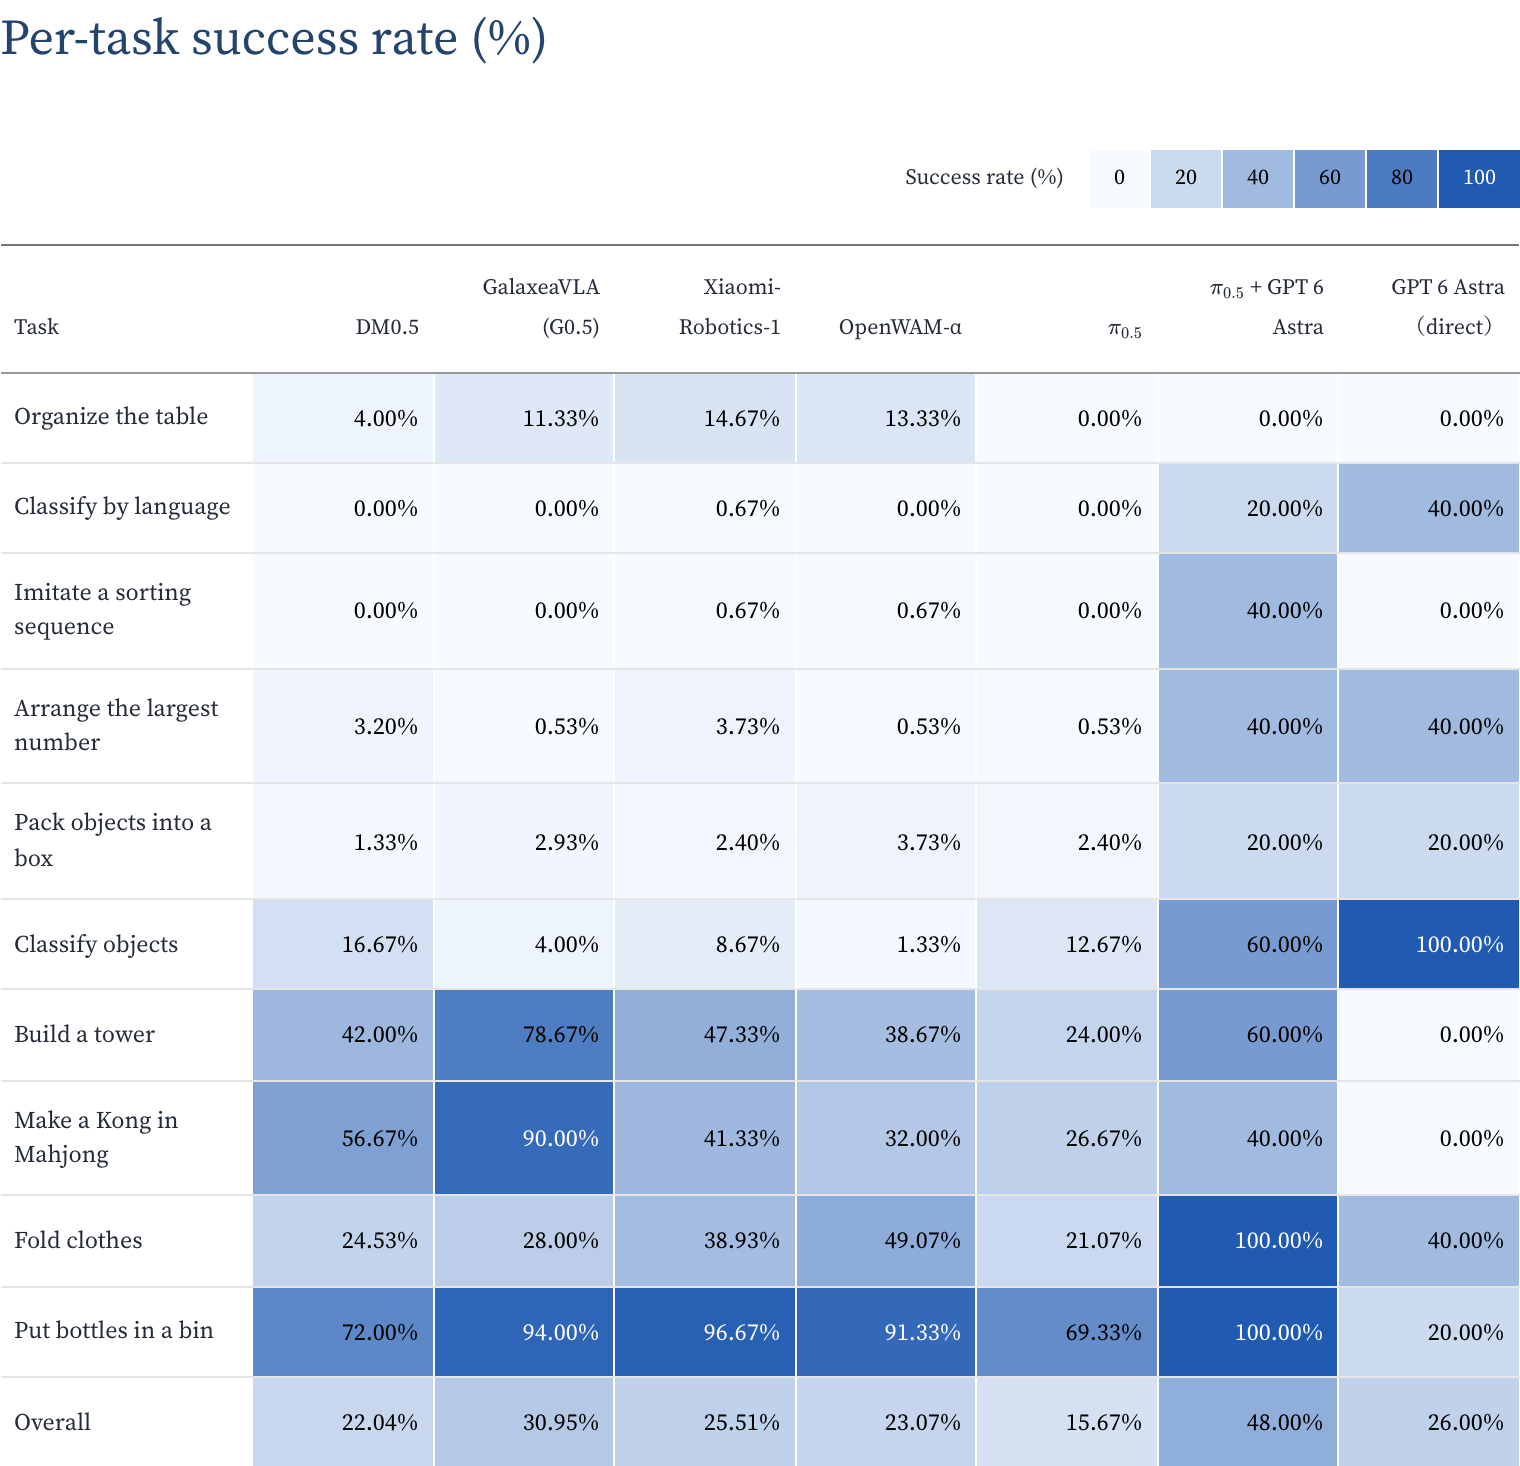
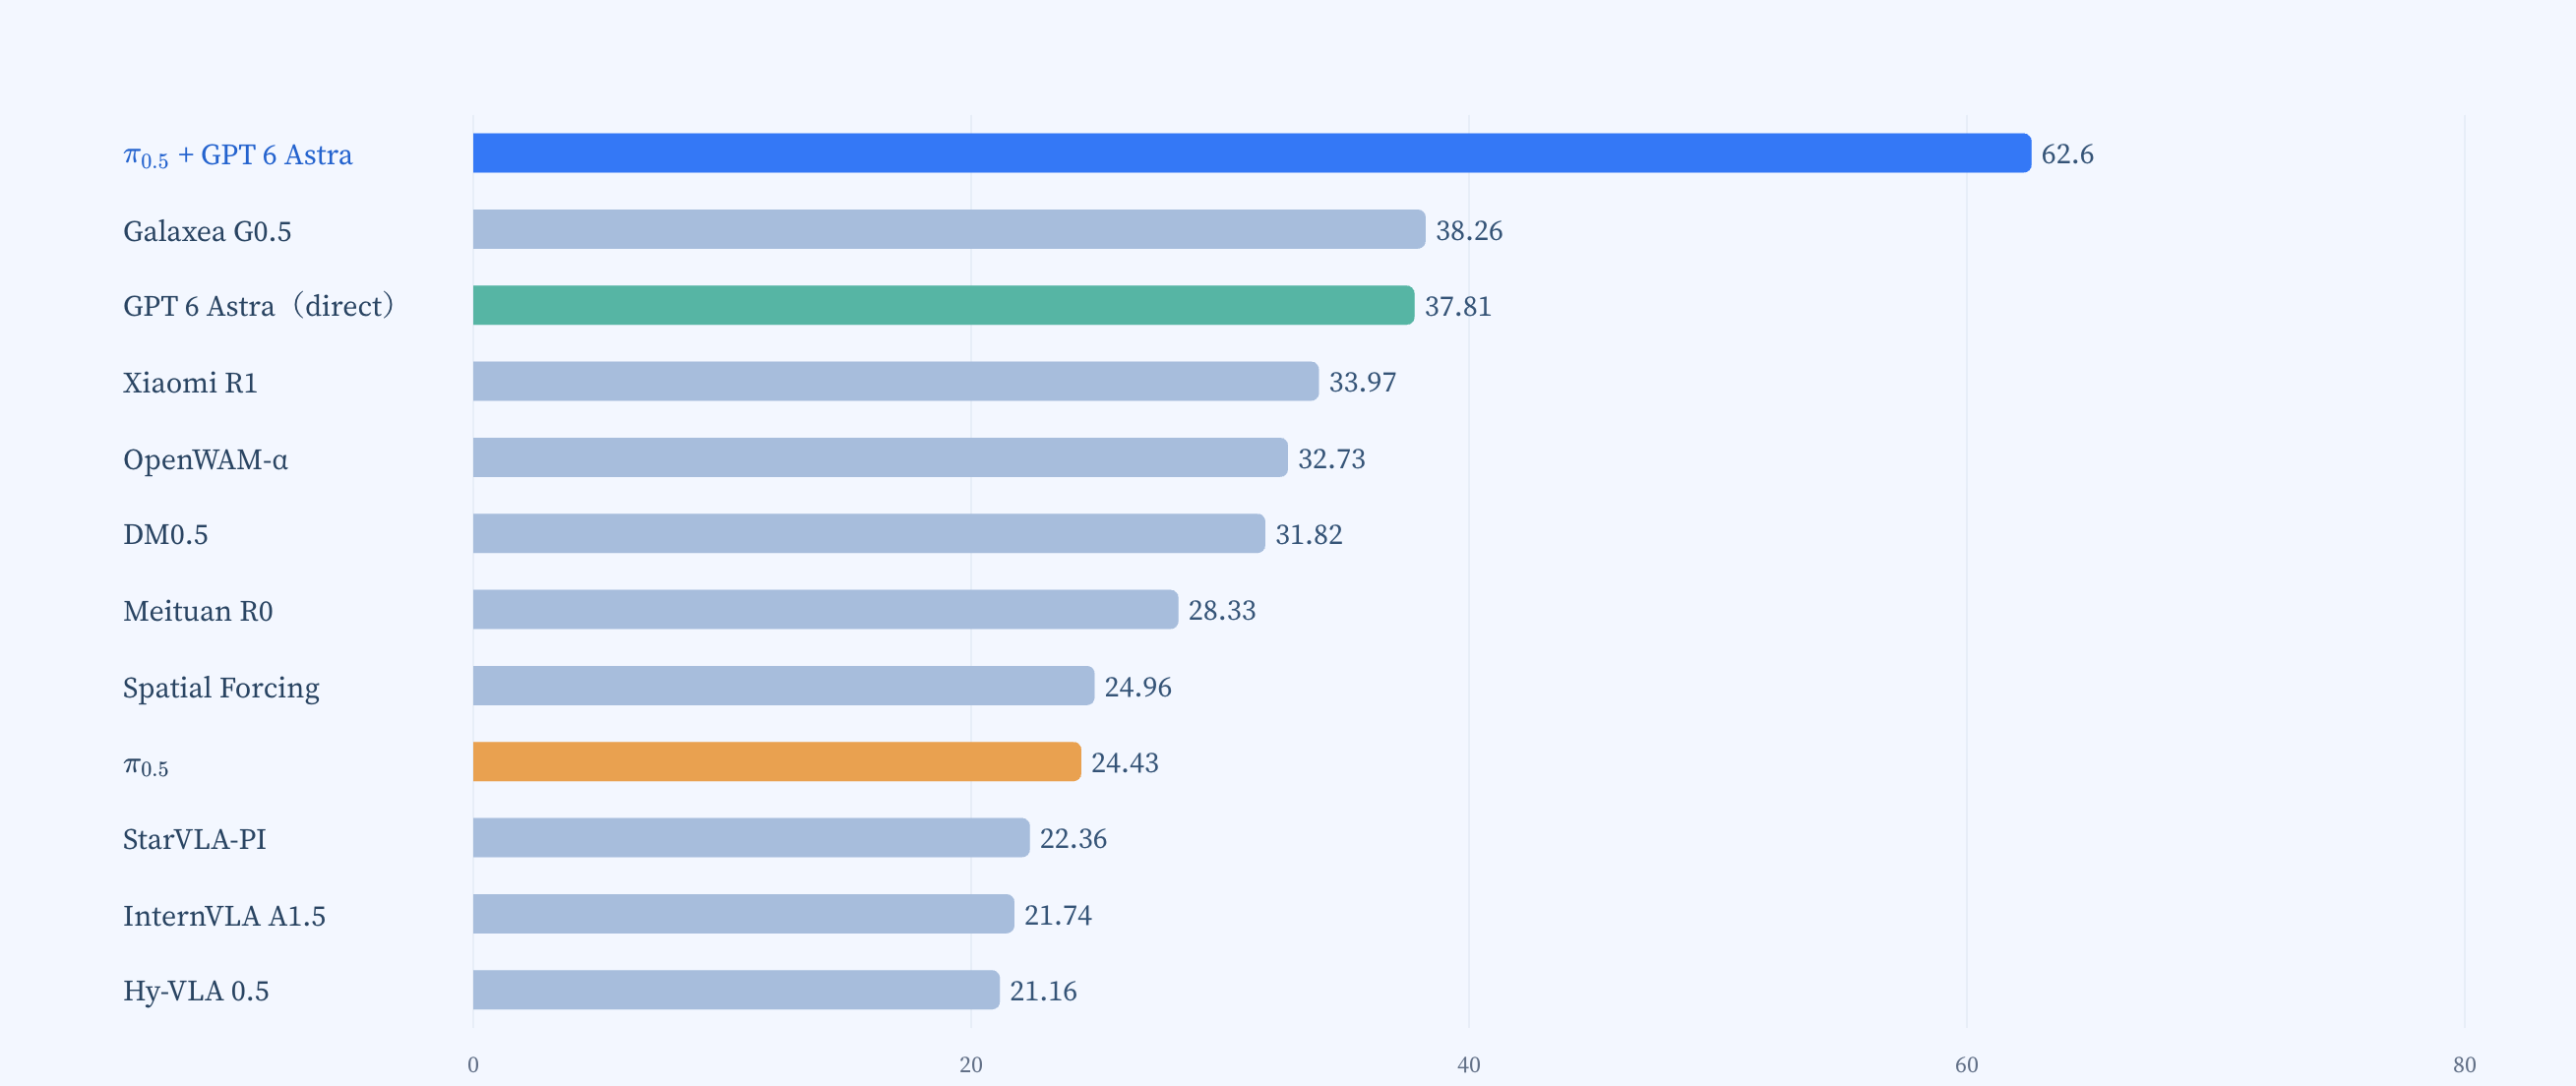
两条缺分记录是 gpt__classify_objects_by_language__standard__g0__l1(257/1,100 步)与 gpt__pack_objects_into_box__random__g0__l2(960/1,300 步)。摘要标为 status=idle、native_complete=false,成功与分数的原生字段为空;公开字段不足以确定为什么中断。
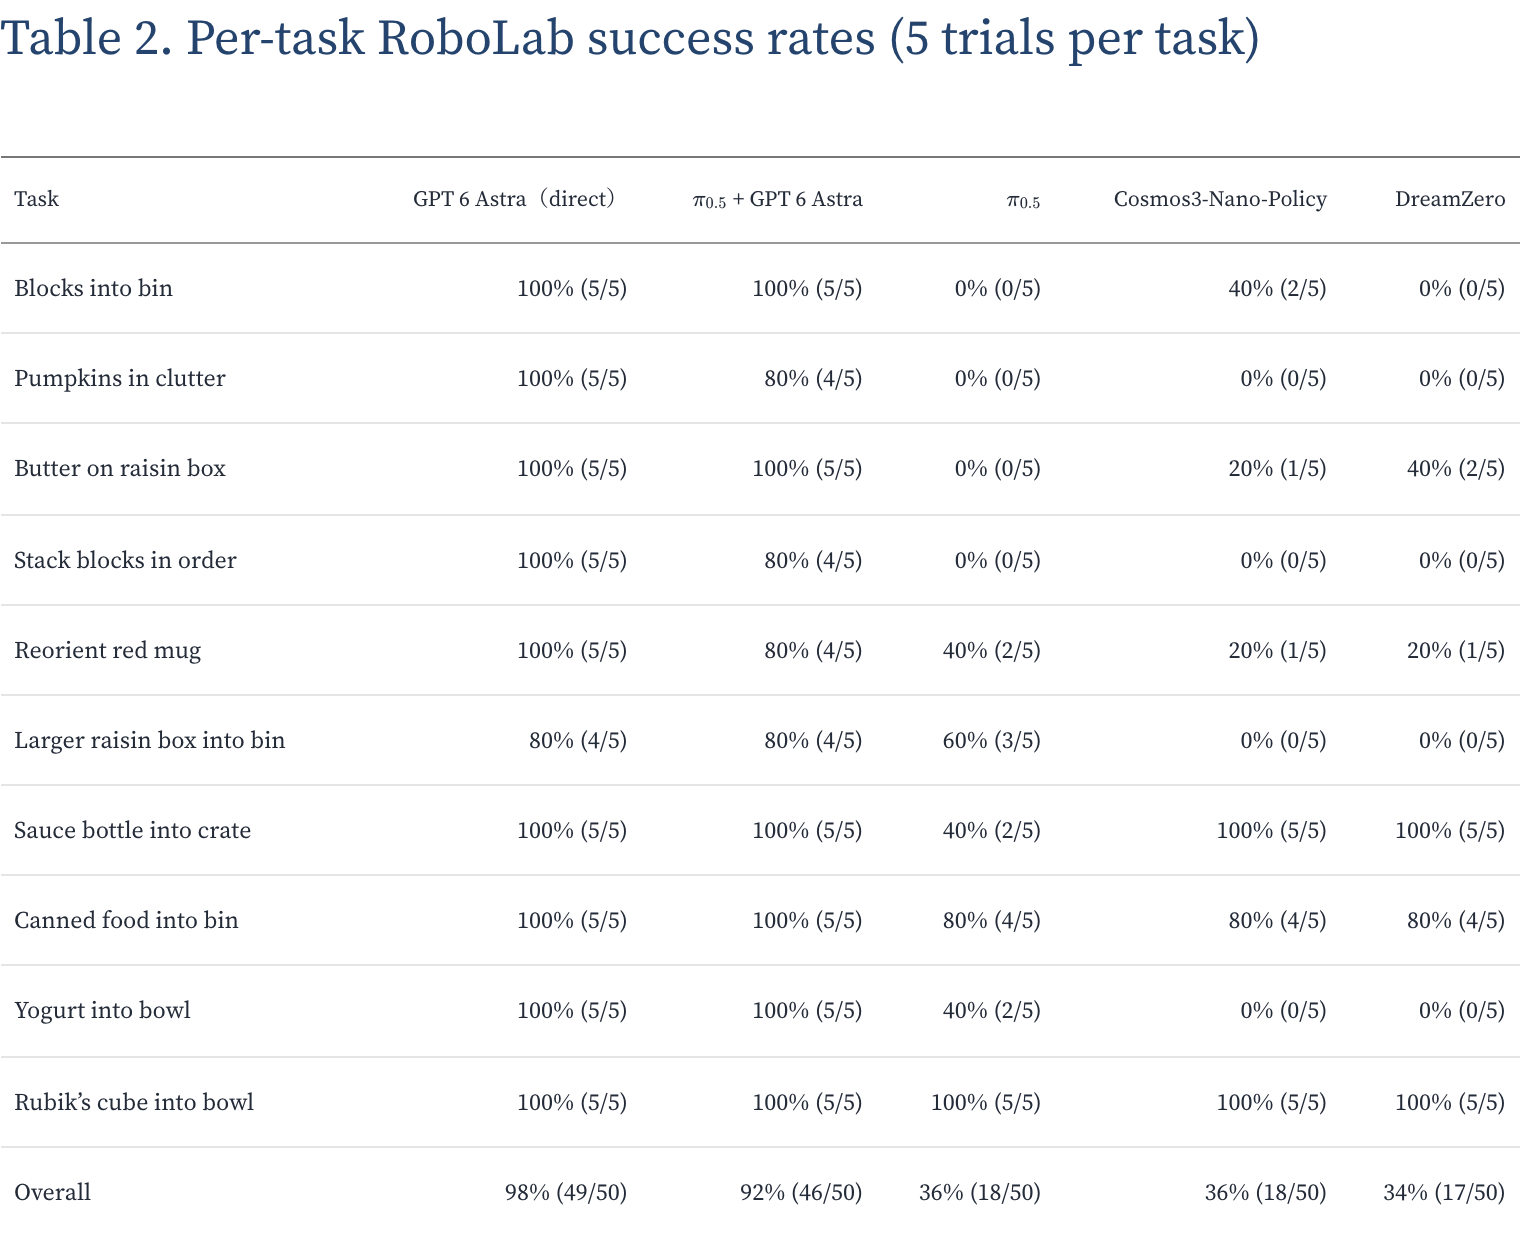
4.2 RoboLab:Direct 更好,且不是同预算的新配对试验
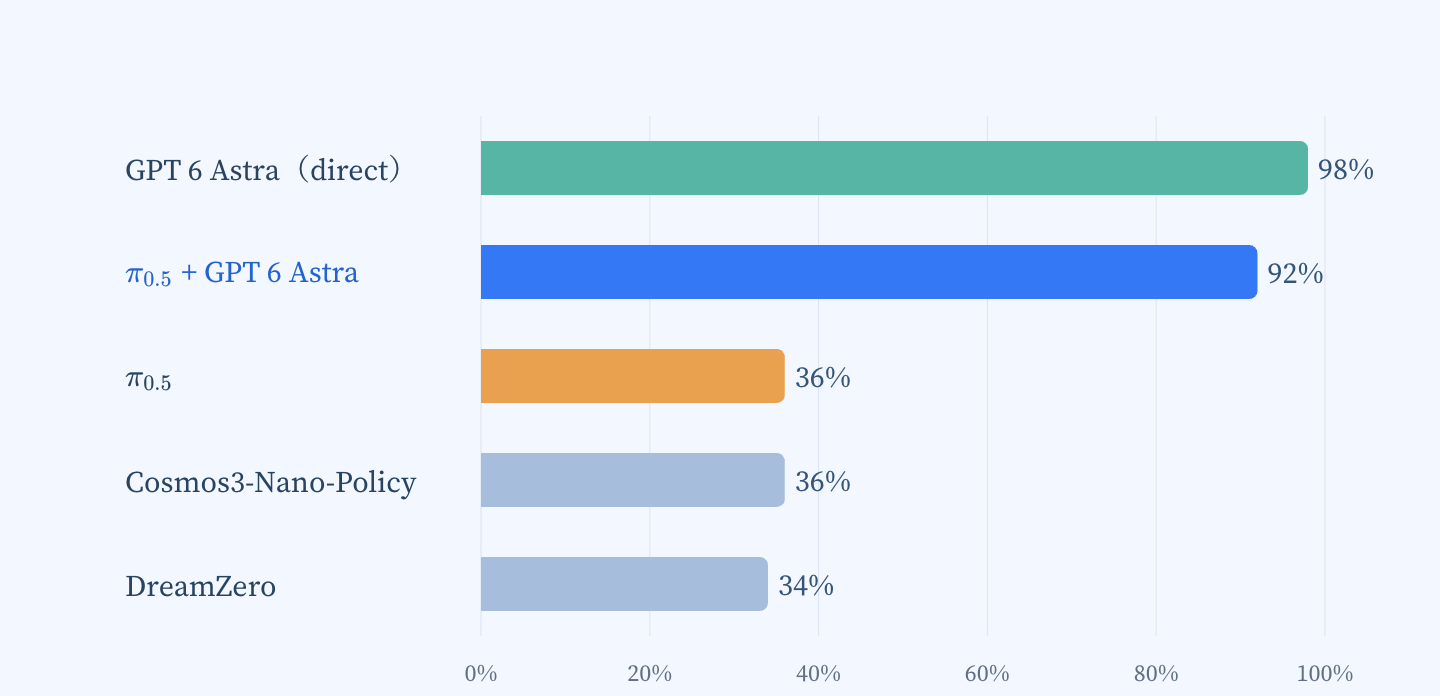
Direct 49/50、Hybrid 46/50;π0.5 和 Cosmos3-Nano-Policy 各 18/50,DreamZero 17/50。这套任务以带语义要求的抓取放置为主,也包含按顺序叠块与杯子转向。RoboDojo 用任务微调过的 π0.5;RoboLab 的三个既有策略则用机器人操作数据集 DROID 训练的权重,未在这些测试任务上微调。
作者据此提出:候选策略如果不适合当前任务,检查和纠正它可能不如直接规划。但这是解释假设,没有固定任务、只改变 π0.5 适配程度的消融来证明原因。
更重要的是协议:Astra 两边包括保留的历史结果与授权重试,初始状态未严格对齐;最后两次 Direct 的 BlocksInBin 重试把决策上限从 180 改到 500(模拟器总步数与成功规则不变)。三个基线取 2026 年 6 月历史记录中每任务按顺序的前五次,包含失败,未核实与 Astra 使用相同任务版本和控制设置。因此 98% 应读作选定最终记录的描述性成绩,不能宣称一次尝试、同预算条件下达到 98%。
展开:RoboLab 的全部逐任务原表(Table 2)
4.3 少执行修正,不等于少调用 85.6% 的模型
RoboDojo Hybrid 共执行 42,750 个控制步,6,174 步为 Astra 修正,比例为 6,174 / 42,750 = 14.44%。但每个动作段都要经过 Astra,Hybrid / Direct 分别有 3,776 / 7,729 段。接受 π0.5 时允许更长的段,这也减少了重新观察和决策的次数。
所选运行记录 token 为 624,762,828 / 1,132,343,772,Hybrid 少 44.8%。这包含大量重复的缓存输入,不是账单金额,也不含全部早期重试。25 Hz 控制意味着每控制步对应 0.04 s;Hybrid 平均物理运动 34.20 s、Direct 30.58 s,均排除模型思考的等待。失败早停也会缩短运动时间,不能据此判断谁端到端更快。
展开:原始用量表(Table 3)与时间口径
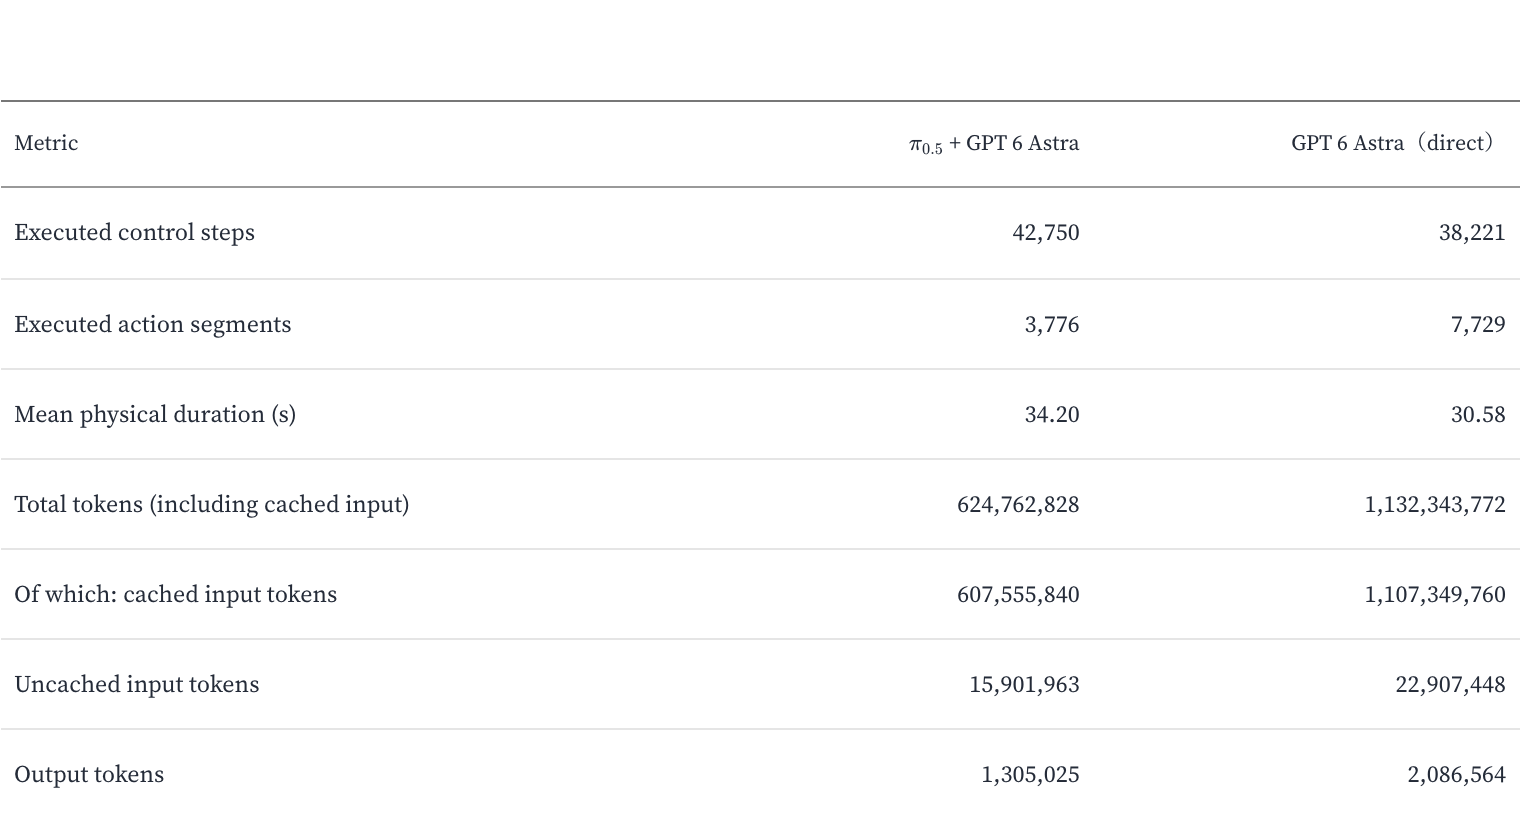
Control steps ×0.04 s 不含推理等待;媒体时长还可能包含初始画面,例如分类 Hybrid 795 帧视频为 31.8 s,794 控制步对应 31.76 s。视频秒数、物理控制时间与真实经过的时间不能混用。
5. Discussion:更值得检验的是候选如何帮到下一步
报告证明了一个组合系统在所选 RoboDojo 任务上更有效,还没有隔离出收益来自哪项设计。Direct / Hybrid 同时改变候选来源、动作接口和最长执行段;没有“相同段长、有无候选”的对照,不能把全部提升归于 Astra 的判断,或全部归于 π0.5 的先验。
对于做 LLM / VLM / Agent 的读者,这里比较具体的启发是:模型可以对已有方案检查前置条件、执行结果和目标选择,必要时只改一小段。下一步实验应固定接口、执行长度与观察频率,再改变候选质量;记录有多少失败被真正修好、多少正确候选被误改,以及实际等待时间。这样才能区分“建议本身好”和“审查有效”。
机器人端还需要继续测动作段里的滑落、接触失败和篮沿碰撞。原报告的视频展示这些问题,但挑选的片段不能估计失败类型比例;模型继续尝试也不保证最终恢复。它没有报告真实机器人部署的成功率或实时延迟实验。
6. Conclusion:配合有价值,前提与代价不能省略
已有动作策略提供可执行建议,通用模型提供检查和局部纠正;这套分工在 RoboDojo 所选任务上有效。RoboLab 的反向结果提示我们,还要看候选是否适合任务。14.4% 是控制步占比,98% 带有选择与重试条件,25 Hz 是控制节拍而非 Astra 推理速度。保留这几个区别,才能理解报告的贡献和它尚未解决的问题。
证据范围:主报告正文、折叠的工具 / 控制说明、图表与行为分析;代码固定 8f3d362,原生 RoboDojo checker 固定 ee67a146。本文提供全部 4 Figures / 3 Tables;21 个行为视频逐项登记,未再分发,源站仍可观看。研究时生成的 44 页网页打印件不是作者发表的 44 页论文。来源与核查清单。
留言