汽车→左篮
手表→中篮
木制玩具→右篮
最后双臂归位。真实配对记录:Hybrid 成功;Direct 失败。具体动作与判分见第 7–8 页。
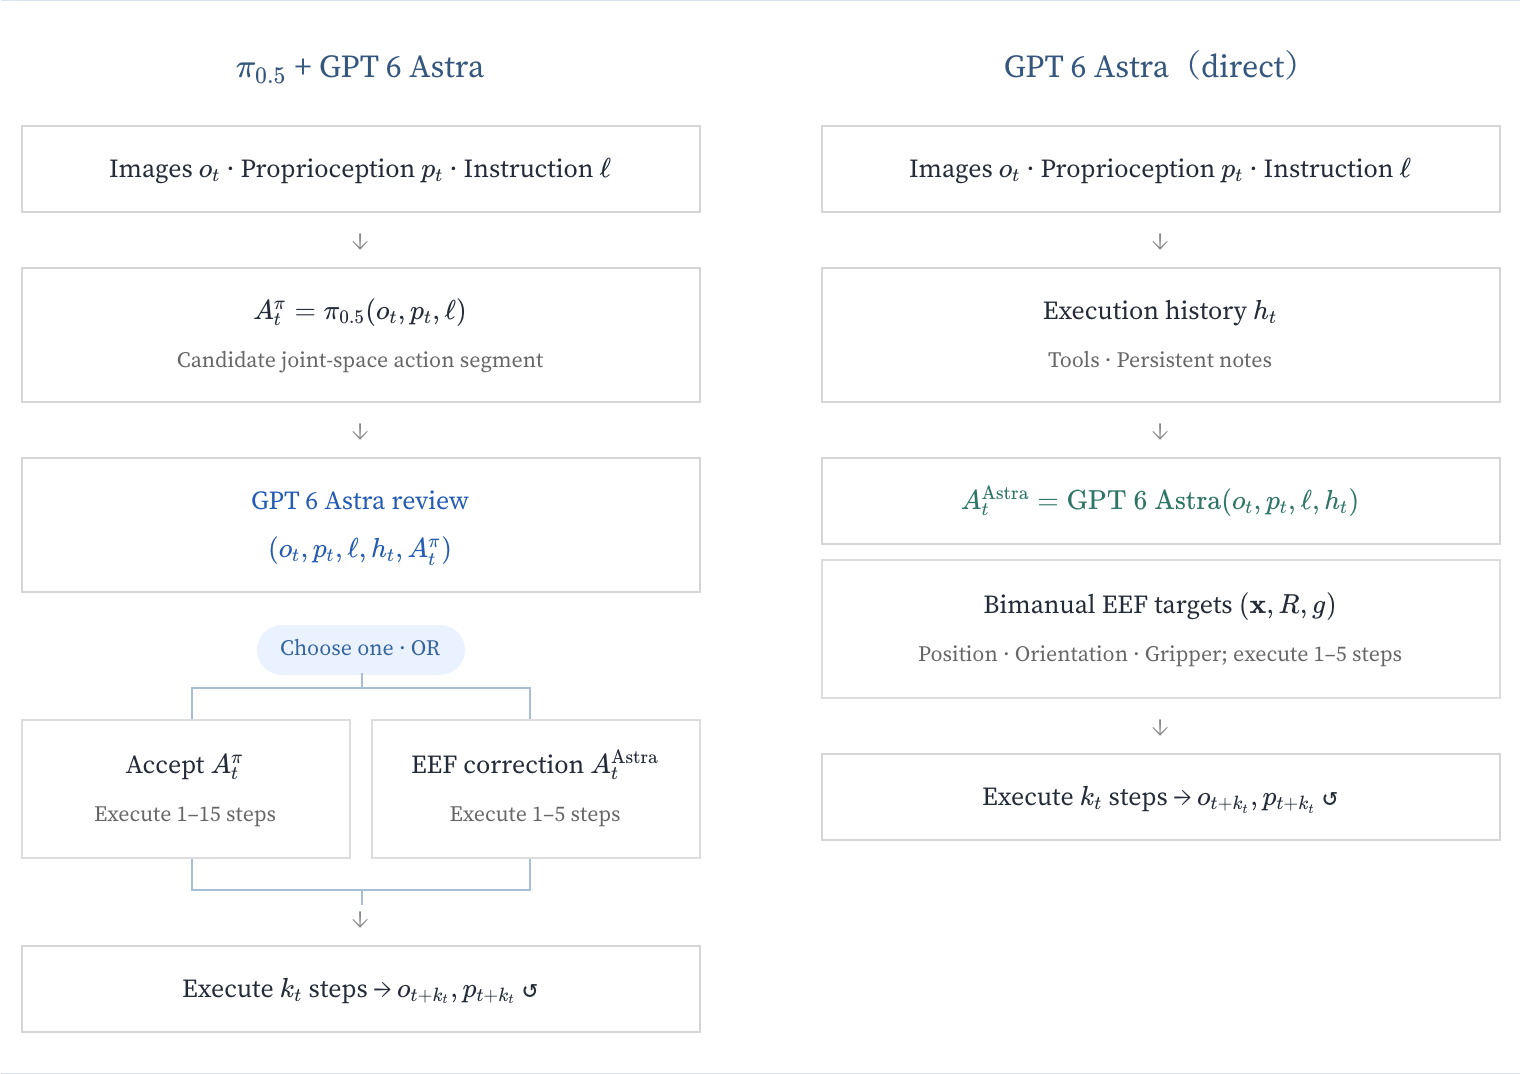
Astra 每段自己构造机器人动作,称为 Direct。
动作模型 π0.5 先给建议,Astra 检查后接受或纠正,称为 Hybrid。
案例来自双机械臂模拟环境 RoboDojo。研究的是运行时配合,没有新训练或蒸馏;分类任务整体并非 Hybrid 更好。
GPT 6 Astra as an Embodied Policy · Galbot01 / 12
Astra 每段自己构造机器人动作,称为 Direct。
动作模型 π0.5 先给建议,Astra 检查后接受或纠正,称为 Hybrid。
案例来自双机械臂模拟环境 RoboDojo。研究的是运行时配合,没有新训练或蒸馏;分类任务整体并非 Hybrid 更好。
报告 §1–2 · classify_objects_by_language / standard / g0 / l0原始报告
Part 0 · 面向 LLM / VLM 读者02 / 12
π0.5 是 VLA(Vision-Language-Action):读图与指令,输出动作。每臂 6 个关节 + 1 个开合值,两臂共 14 个数。
夹爪等末端执行部件叫 EEF(end-effector)。这里开合状态是最近的命令,不是测量的手指间距,更不能证明已抓住。
执行模型看不到隐藏物体真值、评分或未来物理状态。基础概念的详细说明在文章底部,可从正文跳转。
报告工具 / 控制说明 · 固定 client.py / gate_assessment.py基础补充
Method · Direct03 / 12
每次执行 1–5 步。IK(inverse kinematics)根据希望夹爪到达的位置,求关节怎样改变;它不保证无碰撞、抓稳或物体不滑落。Direct 不启动 π0.5。
Figure 2 右列阶段裁剪 · Su et al. · MIT完整原图
Method · Hybrid / 104 / 12
π0.5 提供 50×14 个绝对关节目标。一次输出的动作序列叫 action chunk(动作段)。
FK(forward kinematics)从关节角算夹爪的位置、朝向,提供可检查的候选轨迹。
FK 只算机器人几何,没有预演物体、碰撞或抓取结果。
Figure 2 左列上部裁剪 · Su et al. · MIT;官方 client.py完整原图
Method · Hybrid / 205 / 12
student:原样执行候选前 1–15 步。
edit:在候选夹爪轨迹上加修正,执行 1–5 步。
eef:给显式夹爪目标,执行 1–5 步。
修正每个实际控制步都用反馈重新求局部 IK;模型在整段结束才得到新观察。余下候选不缓存接着用,π0.5 从新状态重新提议。
Figure 2 左列下部裁剪 · Su et al. · MIT;固定控制代码完整原图
Method · 什么允许修正06 / 12
execution_status:上一段是否失败?闭合以后物体没随手抬起,需要结合前后图像。
intent_status:下一段是否选错子目标?没抓住就开始搬运,前置条件没有满足。
# 根据官方 gate_assessment.py 简化改写,Python 3
failure = assessment["execution_status"] == "failed"
wrong_intent = assessment["intent_status"] == "misaligned"
if response["mode"] in ("edit", "eef"):
    if not (failure or wrong_intent):
raise ValueError("Takeover requires observed failure or wrong task intent")不确定或姿势“不好看”不够。失败也能接受合理重试。程序检查的是 Astra 填的状态,不独立验证判断是否正确。
固定 gate_assessment.py · 状态来自模型,非隐藏真值官方代码
Case · Decision:决策序号 / Control:累计控制步07 / 12
接受 π0.5:释放左篮里的绿色汽车,向上撤回。
手里拿着木制玩具。Astra 修正候选,让它往右红篮移动。
Δxyz=(+4.5,0,+0.1) cm
维持闭合,执行 5 步。
重新接受 π0.5,接近剩余的木制狮子。
Hybrid:794/1,100 步,73 段
成功 · Score 100
Direct:1,100/1,100 步,220 段
失败 · Score 40
实际动作见原片 Video 1;终态分数见公开摘要。逐步 checker 日志未公开,不能从 40 分推断 Direct 最后哪件物体放错。该任务整体 Hybrid 1/5,Direct 2/5。
原报告 Video 1 / 公开配对记录 · 视频资产只链接、不再分发看原片
Judge · RoboDojo 自带 Python 规则08 / 12
任务的 gen_instruction() 从场景类别生成指令,汽车→左、手表→中、木制玩具→右。
检查每个物体参考点在指定篮的水平范围内,高于篮底且不超过篮顶 +1 cm。
由任务代码检查场景几何,不用 VLM 看图打分;参考点通过不等于整个网格都在篮内。
| 完成类别数 | Score |
|---|---|
| 任一类 | 10 |
| 任意两类 | 40 |
| 三类 | 100 |
阶段还要求松手、篮内无混类。每控制步最多晋一级;最终成功未通过,100 分退回 40。
成功还要求双臂归位:每个位置坐标偏差 ≤15 cm、朝向差 ≤20°。物体放对但未归位,仍失败。报告没有披露独立人工校验的一致性研究。
原生 checker revision ee67a146 · classify / func_parser / reward_manager原生任务代码
Experiments · 10 个所选任务 × 5 次09 / 12
成功:Hybrid 24/50(48%) / Direct 13/50(26%)。Score:62.60 / 37.81;Direct 有两条无原生终态的记录,成功率按未成功计入 50 条,Score 仅用 48 条。
任务按 π0.5 原成功率四档选 6/2/1/1 个,偏向低分段。π0.5 的 15.67% / 24.43 是重加权公开参照,没有同 seed 重跑。分类任务反而 Direct 更好,两边整理桌面均 0/5。
Figure 3 上部细节 · Su et al. · MIT;完整图表在正文公开指标摘录
Experiments · RoboLab / 单臂 Franka10 / 12
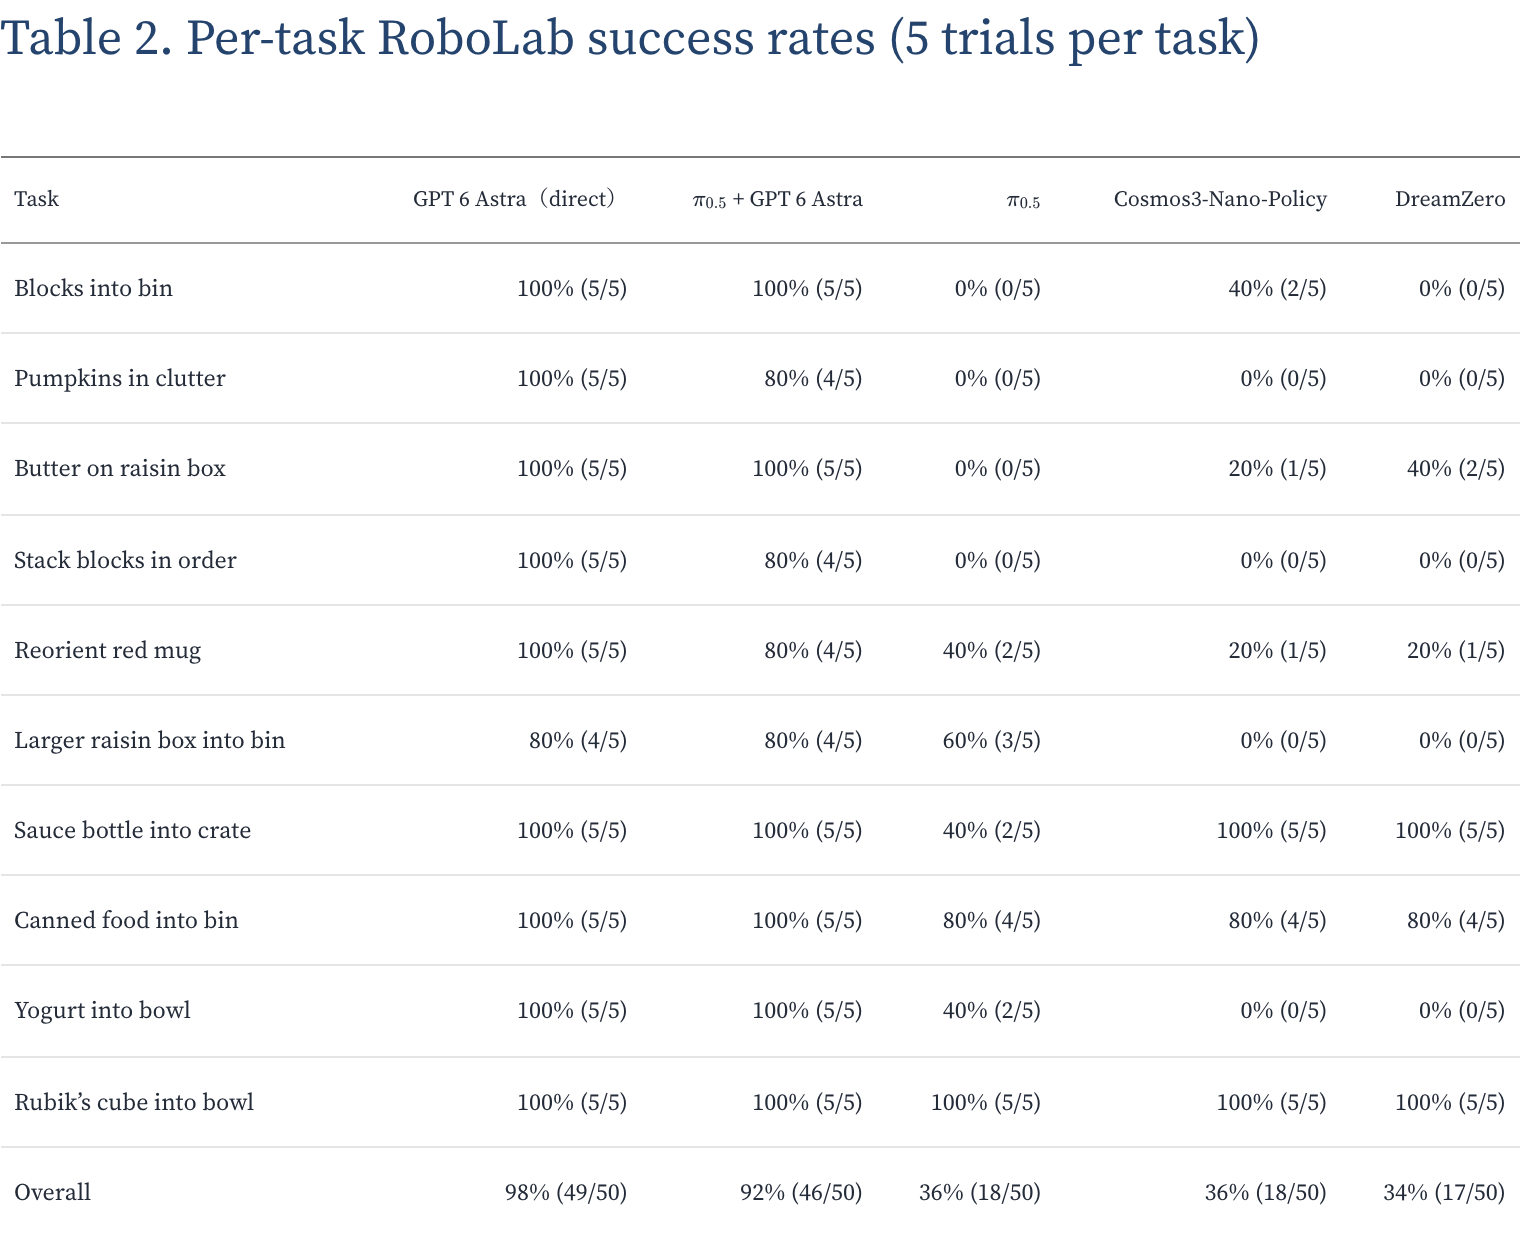
98% 是选定最终记录的描述性成绩:含历史结果与重试,最后两次 Direct 把决策上限 180→500;各方法没有严格配对相同状态与预算。
此处 π0.5 用机器人数据集 DROID 的训练权重,未在测试任务微调;RoboDojo 则微调过。“候选不适合任务”尚无对应因果消融。
Figure 4 · Su et al. · MIT;官方 RoboLab selection / notes / report_baselines.py逐任务原表
Experiments · 仅 RoboDojo 各 50 条记录11 / 12
Hybrid 修正 6,174/42,750=14.44% 控制步,但每段都经过 Astra 审查。记录 token 为 624.8M / 1.13B,少 44.8%,含缓存输入,不能等同账单。
25 Hz 是控制节拍:一步 0.04 s;15 步为 0.6 s,5 步为 0.2 s。模拟器停住等模型思考,这些秒数都不含等待,不证明实时运行。
Table 3 控制行裁剪 · Su et al. · MIT;本文 Python 3 算术核查离线核查脚本
Discussion / Conclusion12 / 12
已有动作策略给建议,通用模型检查执行与目标,必要时改一小段。这套系统在所选 RoboDojo 上提高成功率,也减少记录 token。
目前同时改变了候选来源、动作接口和执行长度。没有同接口、同段长下的“有无候选”消融,不能把收益全部归于某一个部件。
对 Agent 研究,可以固定观察频率、接口与段长,再改变候选质量,测真实修复、误改正确候选和实际等待时间。
没有训练 / OPD;没有真实机器人部署或实时延迟实验。RoboLab 是重要反例:候选加入后可能更差。原图、完整表格、代码依据与机器人基础见正文。
全文、原图与固定代码核查 · 未复现机器人实验读完整文章