ASTRA 想训练能连续使用工具的模型。它先根据工具说明生成多轮示范,让模型学会选工具、填参数和理解返回结果;再把多步问答写成可运行的 Python 模拟工具,让模型自己做任务,按完成程度和调用次数获得奖励。示范数据与可执行环境来自两条不同的生成流程,最后接成两阶段训练。
1. Motivation:工具调用示范与可训练环境缺一不可
模型先要会基本调用,才有机会从自己的长任务失败中学习。 ASTRA 同时解决示范覆盖与环境扩展,避免只拥有其中一边。
SFT 能让模型模仿固定示范,但不会针对它当下的错误给反馈。直接做 RL 又可能出现起步困难:模型连工具和参数都选不对,很少完成任务,奖励无法区分好坏。如果每次工具返回都由另一个 LLM 临时编写,同一动作还可能产生不同结果,奖励就不稳定。ASTRA 因此先教基本调用,再把第二阶段的环境固定成可执行代码。
两阶段各自准备的材料是:
- 按工具之间可能连续调用的关系组织数据,生成跨领域的多轮示范,先做 SFT;
- 按多步问答的依赖关系生成每条样本的 Python 环境,再做多轮 online RL。
SFT 使用事先生成的完整示范,RL 则让当前模型在固定工具上重新做任务,按结果更新。论文用 static tool topology 指工具之间可能连续调用的关系,用 semantic topology 指答案之间的依赖关系。两种图组织不同材料,并不代表 SFT 只学“怎么调用”、RL 只学“何时调用”;阶段效果仍要看后面的分项实验。
2. Related Work:生成轨迹与生成环境的交叉点
它的组合点是两阶段训练,不是首次使用工具图或 GRPO。 GRPO 按同一道题的多次尝试的相对奖励更新模型。工具图组织可能连续调用的接口,问答依赖图组织完成任务所需的中间事实;它们服务于不同数据流程。
相邻工作对照:四条路线的输入、产物与 ASTRA 的位置
| 路线 | 代表工作 | 主要解决什么 | ASTRA 的位置 |
|---|---|---|---|
| 工具调用示范 | ToolLLM、ToolACE、Toucan | 从 API / MCP 工具清单生成请求、调用与返回值 | 同样从工具文档起步;额外组织同一服务内的调用关系,生成完整多轮记录。 |
| 多轮轨迹生成 | MAGNET、ToolACE-MT、APIGen-MT | 用图、任务蓝图或模拟器构造连续调用 | 最接近 SFT 流程;ASTRA 用这些固定示范初始化模型,再接第二阶段在线 RL。 |
| 按模型弱点更新数据 | LoopTool、GEM | 围绕模型错误生成新数据,或从文本恢复隐含流程 | 除了生成离线轨迹,还把多步问答依赖写成能执行的独立工具。 |
| 自动扩展环境 | EnvScaler、AutoForge、AgentScaler、CuES、GenEnv | 自动生成环境、任务、检查器或训练课程 | 这是 ASTRA 的最近邻;它组合问答生成环境、F1 奖励、无关工具混入与两阶段训练。 |
论文对较早的多轮工具训练的一个重要批评是:有的方法虽然先生成多轮数据,训练时却把它拆成独立单步样本,模型难以学习“读完上一条工具返回,再决定下一步”。ASTRA 保留整段模型与工具的交互,并允许在线执行最长 32 轮。
论文的 fully automated 指不需要逐条人工标注,不代表每步都有独立事实来源。SFT 主要由模型评分;RL 工具由模型根据目标问答生成,再检查是否返回那份问答的目标。这能规模化造训练材料,但不能当作现实 API 的完整复刻。
3. Method:先造示范,再造环境,最后用奖励训练
两条生成流程最后分别提供离线示范与在线训练环境。 第一条流程只在同一 MCP server 内组织工具,不跨服务编排。
作者从开放 MCP 注册表、RapidAPI、内部工具说明和公开数据集收集文档,统一成 OpenAI 风格的函数调用格式。工具少于三个、说明含糊或格式无法转换的服务被丢弃;最后保留 1,585 个 MCP 服务、19,036 份工具文档、41 个领域。论文明确限制组合发生在同一 server 内,不做跨服务的调用流程。
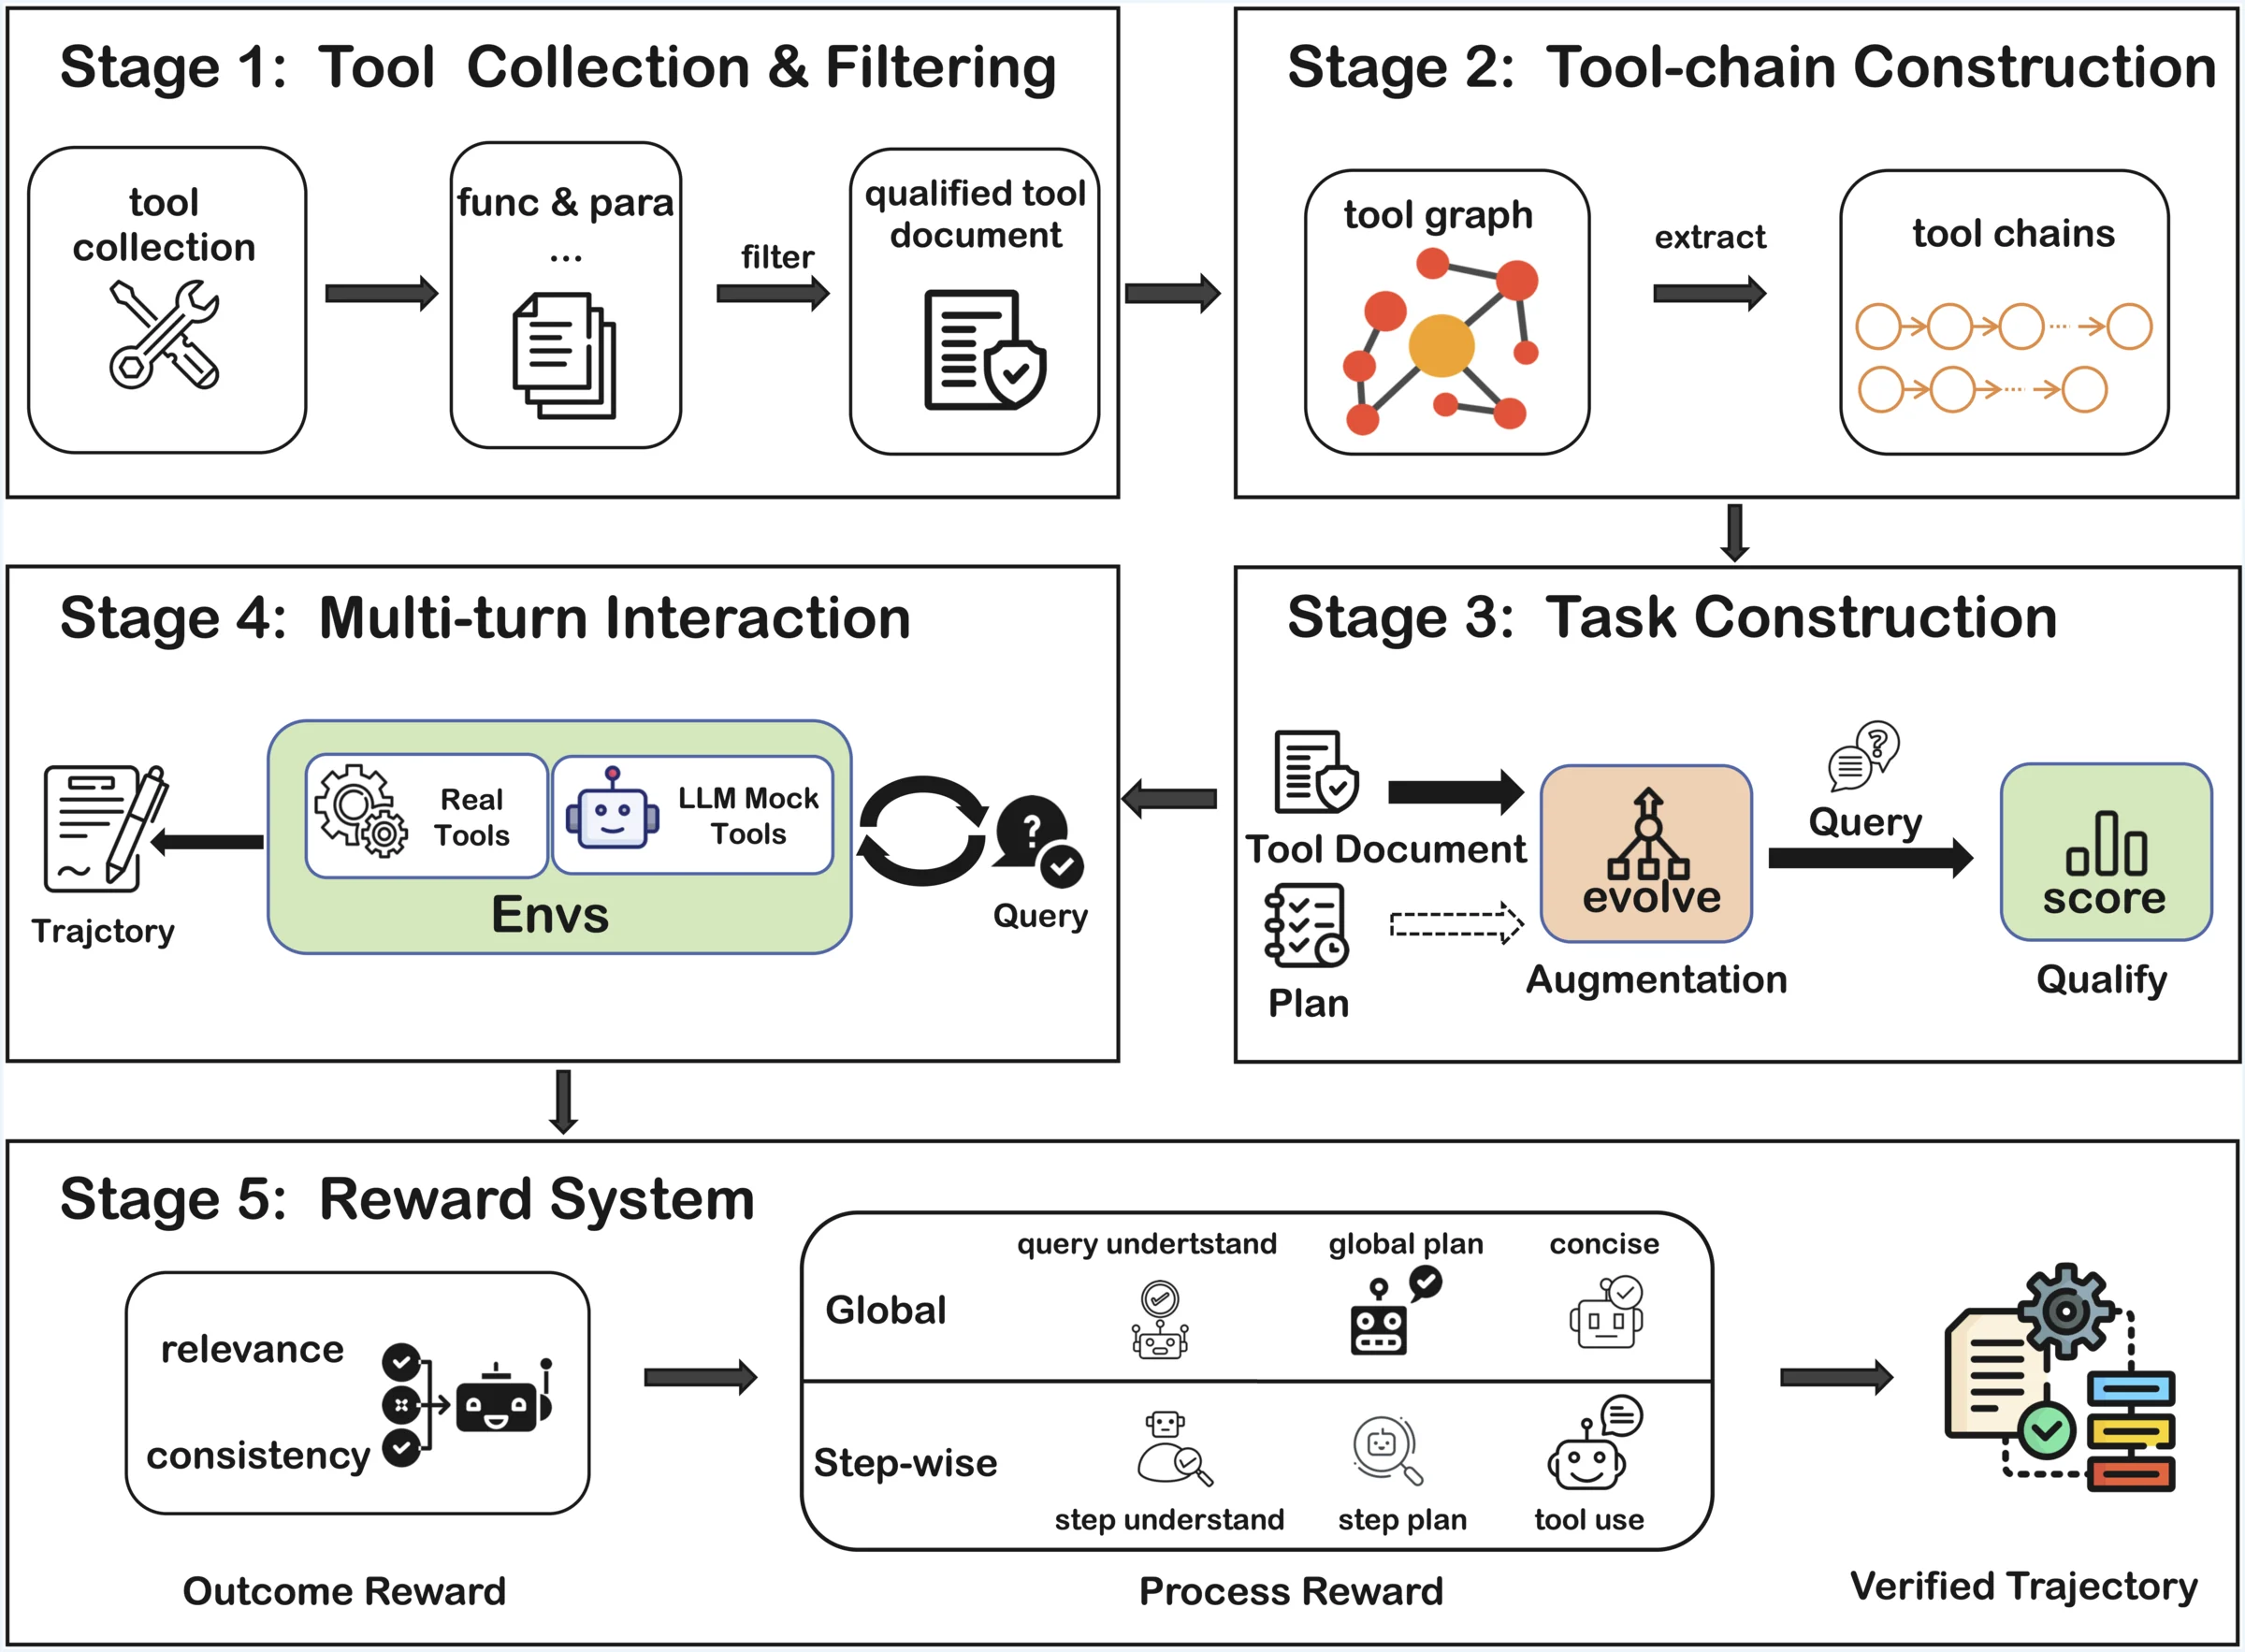
assets/sft-pipeline.png(Apache-2.0),对应论文 Figure 2。图中依次是工具收集、调用链构造、任务生成、多轮执行与示范评分。- 1 · 收集工具清洗参数格式,按来源服务分组,过滤不可用文档。
- 2 · 连调用图LLM 提出任务和可能的调用链;连续工具形成有向边,再沿图随机行走,限制链长。
- 3 · 验参数依赖后续必需参数应能来自请求或前面返回值,任务也应与调用链一致。
- 4 · 生成任务分别按调用链或只按服务文档生成任务,再改写表达、复杂度和用户身份。
- 5 · 执行并筛选Qwen-Agent 调真实 MCP 或保存状态的模拟器,记录完整过程后评分。
任务先经过问题质量、场景真实性、是否确需工具三项筛选。生成示范时,已部署的 MCP 直接执行;只有文档、没有可用后端的工具,由另一个能保存前序交互状态的 LLM 模拟器返回结果。为了让模型遇到失败后继续处理,模拟调用以 20% 概率注入超时或服务不可达一类错误。
3.1 示范筛选:七项评分不能代替环境验证
示范评分分成七个维度,最后取算术平均,覆盖对请求与工具返回的理解、调用成功率、调用是否必要,以及最终回答是否忠实于工具结果。
七项示范评分的具体维度
| 维度 | 看哪一段 | 判断内容 |
|---|---|---|
| Query Understanding | 最初模型回答 | 是否正确理解用户请求。 |
| Query Planning | 最初模型回答 | 初始计划是否可行、完整。 |
| Tool-call Understanding | 当前步骤的交互上下文 | 是否正确读懂上一条工具返回。 |
| Tool-call Planning | 当前步骤的交互上下文 | 下一步行动是否由当前证据支持。 |
| Tool-call Success | 执行记录 | 调用是否成功完成。 |
| Tool Conciseness | 完整执行记录 | 是否有重复或不必要调用。 |
| Final Answer | 最终回答与工具结果 | 是否相关、完整,并忠实于执行结果。 |
这里有一个论文正文没强调、但公开实现值得注意的细节:评分请求抛异常,或返回对象没有 score 字段时,代码会写入 1.0。
if isinstance(result, Exception):
    scores.append(1.0)
else:
    scores.append(result.get("score", 1.0))
这叫 fail-open:评分服务出错时不拒绝样本,而给满分。论文没有报告触发次数,不能断言训练集显著污染;复现时应重试,仍失败则隔离,并统计比例。
公开代码与论文公式还有一个小差异。论文 Equation 8 把成功调用记为 1、失败调用记为 0;reward.py 实际计算的是 (1.0 × success + 0.5 × fail) / total_calls,因此失败调用仍有 0.5 分。这个差异不会改变“七项求平均”的框架,却会改变示范轨迹的具体排序,复现实验时应该固定以论文还是代码为准。
最终 SFT 数据包含 54,885 段对话、580,983 条消息,每条平均 10.59 条消息和 4.42 次工具调用,覆盖 6,765 个不同工具函数。公开 Hugging Face 数据是 1,000 条样本,不是论文中的完整 54,885 条。
3.2 第二条流程:从多步问答生成可执行环境
这条流程从主问题与答案出发,拆出需要哪些中间事实、前后依赖什么的问答。需要外部信息的子问题会被写成 Python 工具;检查器先验证目标输入是否返回目标答案。后面训练的 F1 奖励则检查整次任务完成了多少中间目标、用了多少调用,二者不是同一层检查。
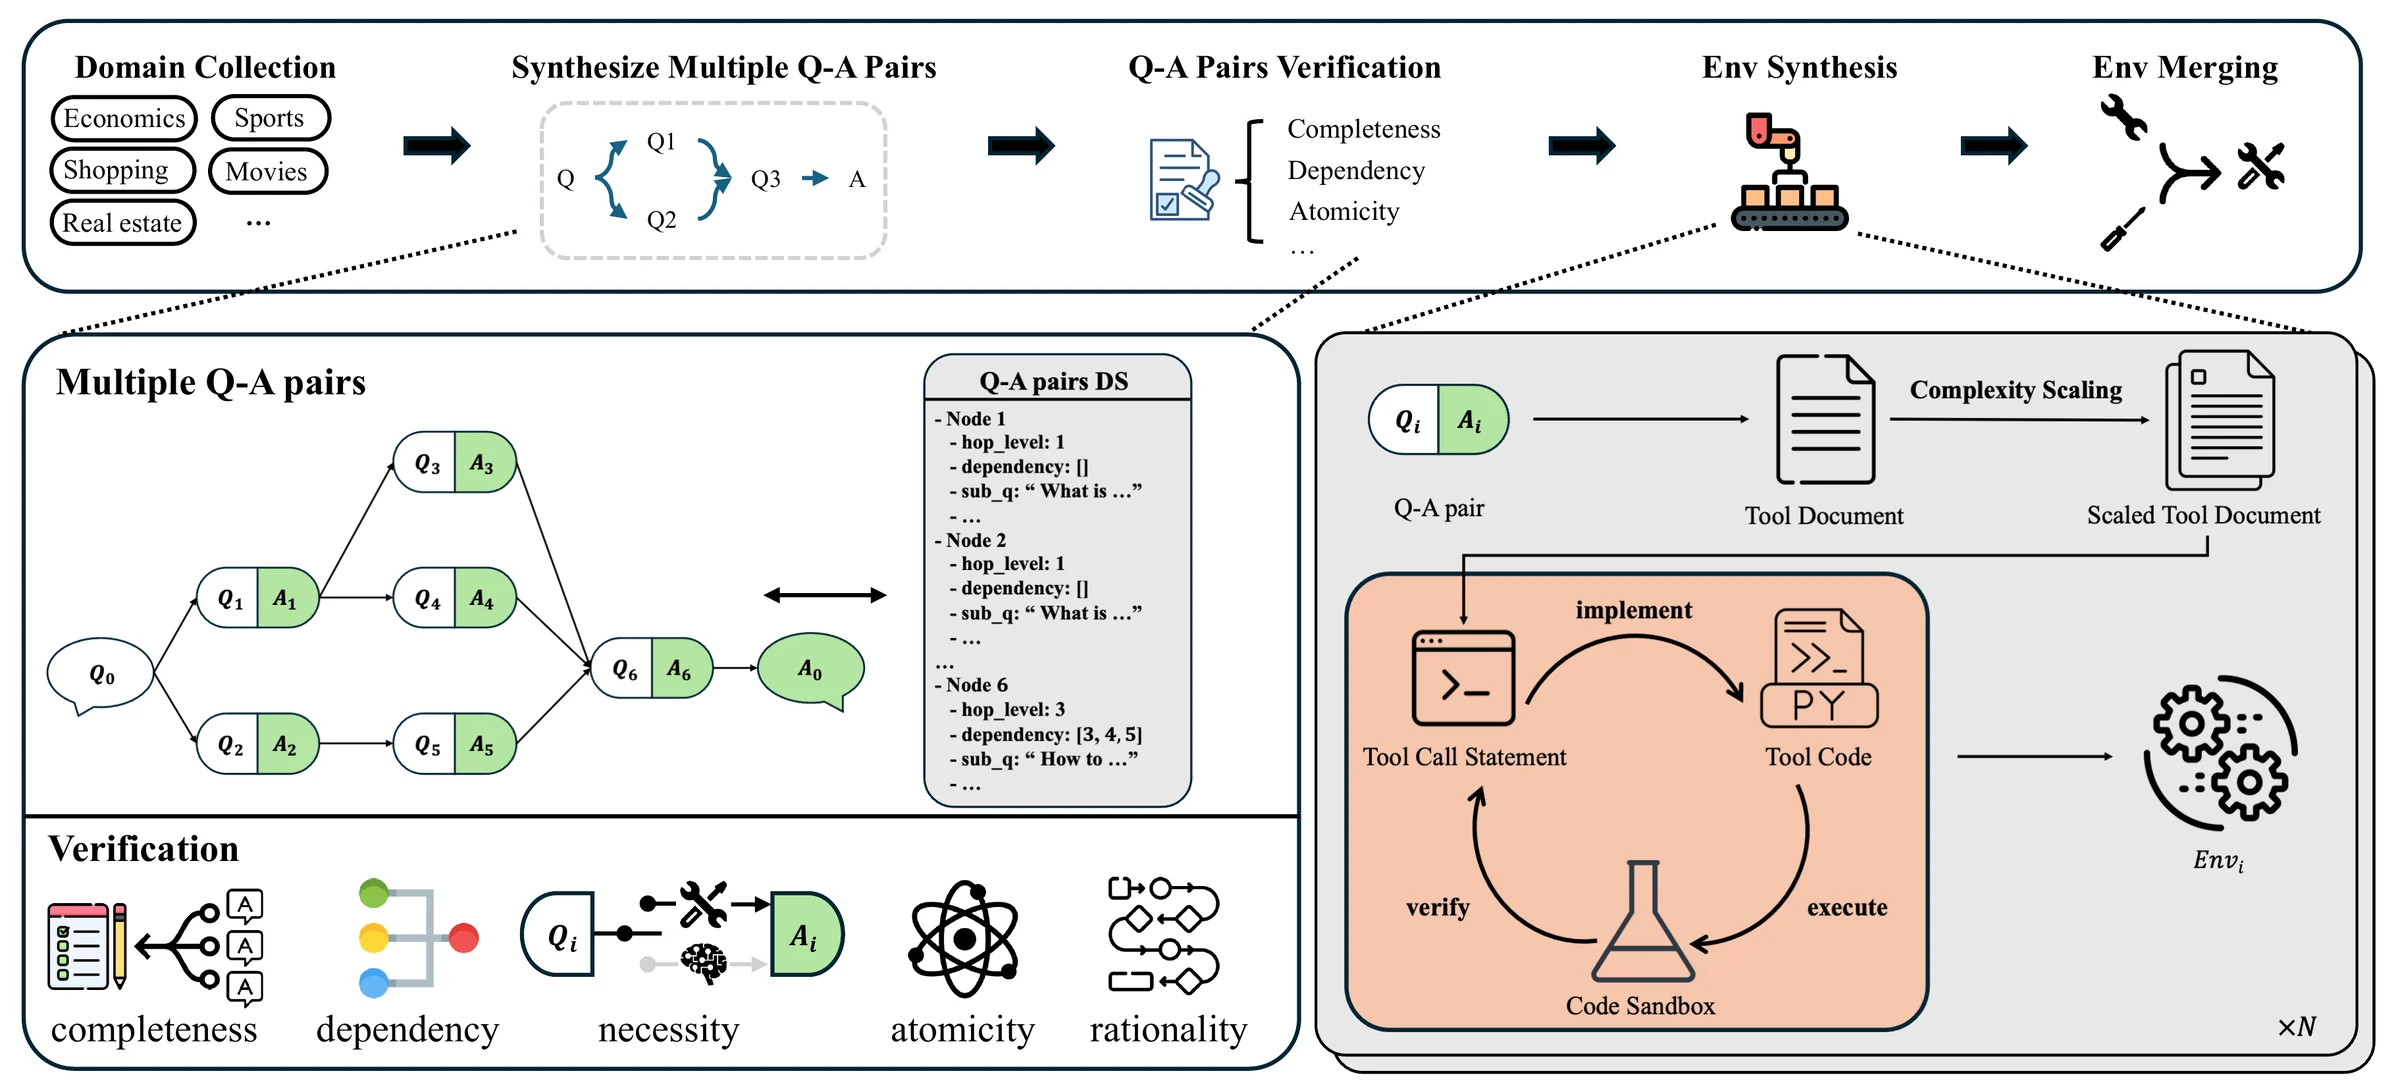
assets/env.png(Apache-2.0),对应论文 Figure 3。问答拆解、工具必要性检查、质量验证、环境生成与工具合并都属于构造阶段;后面训练奖励另行计算。主问题先被拆成若干子问题,标出哪些可以并行、哪些依赖前一步答案。LLM 随后检查依赖是否合理、每题是否只要求一个事实、执行顺序是否正确,以及合起来是否足以回答主问题。需要工具的节点依次生成文档、参数、调用语句和 Python 实现。
论文还做了局部合并校验:同功能、不同参数的节点可以共用一个工具。每向实现中加入一条记录,就在沙箱重放该工具已有的调用语句,检查所有对应答案仍然返回。这项检查确实存在,但不等于最终所有工具名称、调用依赖和奖励目标都已统一验证;后面的公开行李样本仍有具体不一致。
问答可以根据已有主问题生成,也可以让 LLM 依据领域材料 K 和允许的推理步骤数 H 从头生成。论文只把 K 说明为文本语料一类知识源,没有列出上游出处、许可、去重规则或训练/测试泄漏检查。公开仓库带有可运行的 knowledge/en/*.jsonl 与 knowledge/zh/*.jsonl 输入,其中也能找到下文行李 case 的来源场景,但仓库同样没有交代这些文本由谁编写或从哪里采集。问题拆解和四项质量检查全部由 LLM 完成,没有加入人工标注,也没有标注者一致性数据。
训练时,policy 看到用户请求、当前工具说明和每次执行结果。sub_qa_dict 中的目标答案用于算奖励,不作为作答提示交给 policy;每条样本的 Python 环境彼此隔离,不共享状态。
3.3 环境准入:目标字符串出现在执行输出
公开 step_04_env_synthesis.py 的关键通过条件如下:
call_ans = get_code_sandbox_ans(final_code)
if call_ans["status"] == "Success":
    if q_a_pairs["answer"] in call_ans["run_result"]["stdout"]:
        is_success = True
也就是说,生成的 Python 代码在沙箱中执行成功,而且标准输出 stdout 包含目标答案,就算通过;失败则重新生成。这个检查建立的是可执行的自洽性:生成代码在已知输入上返回合成问答指定的答案。它不连接真实数据库,也不验证其他输入,所以没有证明外部事实或整个接口行为正确。
数据规模是 6,596 条样本、28,794 个子问题;91.3% 的子问题需要工具,平均 4.37 个推理步骤。任务中 71.2% 为英文、28.8% 为中文;47.8% 是能并行处理部分中间目标的 Parallel Multi-Hop,34.8% 是顺序依赖中间答案的 Multi-Hop。公开数据同样只放出 1,000 条。
3.4 训练奖励:完成程度与调用效率一起算
设一个任务有 n 个目标子任务,当前执行命中 n_hat 个,工具一共调用 c 次:
做全 4 项、正好调用 4 次,reward 接近 1;做全 4 项却调用 6 次,F1 约为 0.80;只做对 3 项、调用 4 次,约为 0.75。这里的 recall 是完成目标的比例,precision 是“每次工具调用解决了多少目标子任务”的效率分,不是分类准确率。这些数字是条件代入,忽略 ε 的极小修正,不是任何公开样本的实测奖励。一次对话轮次可以发多个调用,不能把轮数当成公式里的 c。
作者还给工具列表混入高、中、低三档相似的无关选项。具体是用 Qwen3-Embedding-8B 编码工具文档,算余弦相似度,再按每个目标工具的最小/最大相似度归一化到 0-1;排除同领域候选后,按 >0.85、0.4-0.85、<0.4 分档,每档最多抽 K 个。论文没有写出 K 的具体数值。消融曲线显示不加无关工具最差,随机加 5-9 个优于不加,但低于分档采样;论文没有提供曲线终点的精确表格值,因此不应从图上臆测具体提升。
3.5 真实样本:四个行李加购目标如何变成奖励
ASTRA-RL-1k train row 0 重绘,revision dbc70e26。图中“命中”来自指定输入的本地核对,不是公开的 policy 运行记录或完整 RL 得分。公开环境与四个评分目标的核对
- Hugging Face 的
ASTRA-RL-1ktrain row 0 由论文的数据生成流程产生,没有逐行人工标注。Policy 能看请求、工具说明和返回结果,不能看用于评分的目标答案。 Amit Kumar 要修改 Bengaluru City 与 Chennai Central 之间、9 月 20 日去程和 9 月 23 日返程的预订,把行李额度从 1 件加到 3 件;先告知费用,再用钱包支付。请求没有指定年份。 sub_qa_dict保存四个目标字符串:Reservation ID: RES987654、Current baggage allowance: 1 bag、Extra charge: ₹600、Payment successful. Transaction ID: TXN123456789。它们由问答生成流程写入数据,不是运行真实航空或支付接口取得的事实。- 理想情况下,四个目标都命中、调用四次,
n_hat=4, n=4, c=4,F1 reward 接近 1。重复查预订或费用会增加c,即使最终答案完整也会扣分。 - 公开
tool_schema有 9 项,其中两个都叫payment_processor;按名称索引的tool_dict只剩 8 个不同名称。保留下来的实现需要payment_instrument_id和charge_type,返回Charge processed successfully...,交易编号通常随机生成,与目标支付字符串不同。若按另一份同名 schema 只传reservation_id、金额和货币,会因缺少两个必填参数而报错。
我对这四个已检查的模拟函数做了本地调用核对,前三项返回值包含目标,支付项不包含。这个核对有两处需要明说:预订函数只在代码写死的 2024-09-20 / 2024-09-23 上返回该预订,我按这个分支选了年份;支付调用中的钱包编号也是为测试函数填的输入,不是模型从公开执行日志中取得的结果。前三个目标命中,验证的是这些已知输入下的模拟分支。
公开预订实现把去返程日期写成了 2024 年。下面保留条件摘录(Python;省略返回值与其他参数检查):
查看预订函数对 2024 年日期的条件检查
if (passenger_name == "Amit Kumar" and
    origin == "Bengaluru City" and
    destination == "Chennai Central" and
    travel_date == "2024-09-20" and
    trip_type == "round_trip" and
    return_date == "2024-09-23"):
    # 该分支返回 Reservation ID: RES987654
    ...
这里没有复现官方 RL 得分,也没有一条真实 policy 的完整执行日志。 若奖励按上述字符串命中数计算、且四次调用仅命中前三项,代入公式才得到约 0.75;公开仓库缺少完整 RL 奖励实现,不能把这个条件计算写成样本实测分数。论文 Appendix A.2 的股票与轮胎示例也只展示推理文本,未给出实际工具调用、返回值与评分日志。
这是公开 1k 子集中的一行缺陷,不能据此推断内部全部 6,596 个环境都有问题。论文已有同功能工具插入数据后的局部重放,公开样本却仍出现工具重名和随机交易编号。最终数据还需在实际按名称注册的工具集合上重放全部目标调用,确认工具名唯一,返回值与奖励目标一致。
3.6 一次 RL 更新:哪些数据固定,哪些参数改变
SFT 用已生成的完整示范做训练。进入 RL 后,每个样本的 Python 工具与目标答案固定;当前 policy 接收请求和工具 schema,生成多次完整调用记录。环境执行调用,奖励程序比较已解决的子目标与调用数。训练只更新 policy 参数,不在每步重新训练工具或问答生成器。
训练设置:SFT 与 RL 的批次、长度和学习率
SFT 从 Qwen3-14B 和 Qwen3-32B 开始,各遍历示范数据 2 次(2 epochs),每批 32 条,最大序列长度 20k tokens(token 是模型处理的文本单位),不把多条短记录拼接训练;学习率分别为 5e-6 与 2e-6。用余弦学习率调度,前 5% 步骤预热。长序列分摊到设备处理的 Context Parallelism,14B 设置 CP=2,32B 设置 CP=4。
RL 使用 GRPO,batch size 与 mini-batch size 都是 256,学习率 2e-6;输入上限 25,600 tokens,回答上限 49,152 tokens,论文对 user 与 assistant 各写了最多 32 轮。作者去掉 KL 正则(限制回答分布偏离起点的项)与熵奖励(鼓励生成多样性的项),在整个 batch 的 token 上取平均损失。
同一道题的一组执行记录如果奖励完全相同,GRPO 没有组内好坏对比,学习信号为零。Adaptive Batch Filling 是筛选并凑足这种有效训练组的操作:只保留奖励标准差高于阈值的组,多余记录缓存在下一步使用。它改变训练 batch 的组成,不改变环境如何判定目标。
4. Experiments:外部评测的增益来自哪个阶段
最终 RL 在三项工具使用评测上都提高,但部分离线训练子项会先退化。 下面比较固定基座、SFT 后和最终 RL,避免把合成数据内部奖励当成外部能力。
| Benchmark | 测什么 | 论文 protocol | 需要注意 |
|---|---|---|---|
| BFCL-v3 MT | 多轮函数调用,含正确工具缺失、参数缺失、长上下文 | vLLM 推理服务,temperature 0.6 | 四个子项平均为总分;未报告重复试验或置信区间。 |
| τ²-Bench | 模型与模拟用户共同操作环境 | 排除 airline;GPT-5.1 模拟用户;temperature 0;4 次试验;报告 pass^1 | pass^1 是单次尝试的成功概率估计,不是“重试四次只要成功一次”。airline 因先前报告指出标准评分质量问题而排除。 |
| ACEBench | 多轮与多步工具使用 | Agent 分组 50 题;GPT-4.1 模拟用户;temperature 0.6;重复 4 次 | 报告平均准确率;50 个不同任务重复四次,仍不是 200 个独立任务。 |
| AIME 2024/2025 | 检查无工具数学推理是否退化 | temperature 0.6、top-p 0.95;top-k 20 与 -1 各生成 32 次 | 两种生成参数的通过率再平均。 |
表中的 temperature、top-p、top-k 是回答采样参数;top-k=-1 表示不限制候选数。论文 Table 1 与 Table 2 的基座成绩不完全相同:14B 的 τ² 为 46.05 对 44.55,32B 的 BFCL 为 49.63 对 47.88,没有解释为何变化。下文只用 Table 2 的同组基座做阶段比较,不能把两张表的更高值混用。
14B 从 base 到最终 RL,BFCL-MT 为 44.50→58.13,τ²-Bench 为 44.55→57.70,ACEBench 为 51.67→68.96。32B 分别是 47.88→64.25、49.70→63.70、59.79→71.88。最终模型三榜方向一致,阶段贡献却不同:
- 14B 的 BFCL:SFT +4.00,后续 RL +9.63;τ²:SFT +5.90,RL +7.25。
- 14B 的 ACE:SFT 已从 51.67 升到 67.71(+16.04),后续 RL 只升到 68.96(+1.25)。+17.29 是两阶段总增益,不能全算给 RL。
- 32B 同样是 BFCL 与 τ² 的 RL 增量更大,ACE 的 SFT +7.92 大于后续 RL +4.17。
但 SFT 不是所有子项都变好。BFCL Missing Function 在 14B 上从 39.50 降到 25.50,在 32B 上从 52.50 降到 40.00;RL 后才分别升到 56.00 与 65.50。这说明离线示范能改善常规调用习惯,却可能让 policy 更倾向“总要找个 tool 用”;加入无关工具和在线奖励后,拒绝不存在功能的能力才恢复。
AIME 用于检查工具训练是否损害数学推理。14B 在两种生成参数下的平均分别为 73.45→73.40 与 72.60→72.60;32B 为 74.90→74.85 与 74.15→75.15。可以说没有观察到系统性退化,但它不是一般能力的全面评测。
Table 4 还报告 BFCL-MT 的每次调用平均输出长度:32B 从 1,145.3 tokens 变成最终 RL 的 1,130.1 tokens,变化很小;不能据此声称大幅降低推理成本。表中“平均调用次数 × 每次平均长度”也不能直接当作“每题平均总长度”,三者的汇总对象不同。
5. Discussion:先修最终环境,再隔离训练组件的贡献
应在最终注册的环境上验完整目标调用。 论文已有局部函数合并重放;下一层应要求名称唯一、参数有效、输出与所有奖励目标一致。遇到评分模型异常,应重试或隔离样本,避免满分默认值混进示范。公开行李样本给出了具体的测试目标。
然后用真实 API 或独立模拟器做未见任务迁移,检查 mock 工具学到的调用策略能否复用。固定轨迹预算与随机种子,分别拿掉初始示范、相似度分档的无关工具和 Adaptive Batch Filling,再比较 F1 与只算完成程度或只算调用效率的奖励。这才能区分更多数据、环境设计与训练算法的贡献;不是论文已经完成的全组件控制实验。
6. Conclusion:训练分层的价值与公开实现的边界
最值得保留的是四层检查分开:任务质量、示范质量、环境能否返回目标、外部评测是否真正提高。 它们不能互相替代。公开代码的评分默认值与行李样本又说明,训练奖励必须依赖一致的最终工具与目标。
trajectory_synthesis/data 则有 1,482 行 MCP 服务记录与 941 行任务记录。F1 奖励把完成目标和少用工具放在同一个可计算值里。论文曲线显示只追求目标覆盖或只追求调用效率的版本后期退化,组合更稳定;但好公式仍依赖最终工具与目标一致,名称覆盖或随机交易编号会直接改变学习信号。
留言