V-Rubrics 认为视觉推理的奖励太粗。模型即使看错图、推理出错,也可能碰巧选中正确答案;只检查最终答案的奖励(answer-only reward)仍然会给 1。作者把参考回答拆成多条可独立判断的评分项(rubric items),再让每项训练权重覆盖回答开头到相关句子的文字。这段文字叫回答前缀;它用于让训练区分哪些视觉事实或推理成立。
1. Motivation:答对选项不代表看对了图
一条答案可以包含多个局部判断,最终正确与这些判断全部正确不是一回事。
图表题里,模型可能读错一个柱子的高度,却通过其他线索猜对选项;几何题里,模型可能识别出形状,却使用不成立的关系完成推导。只看最终答案的 GRPO 把这些情况都压成一个数值。对于同一问题的多次生成结果,模型只知道哪次答对,不知道哪条视觉陈述值得保留。
V-Rubrics 先把参考答案拆成“每条只表达一个事实或推理”的判断项,再让判分模型分别输出是或否。正权重评分项提供部分得分。负权重的 PITFALL 条目写的是“应避免某个错误”,判为 1 是成功避免,判为 0 才是确认违反。违反后取消答案与正评分项的语义奖励,但代码中的格式奖励仍独立保留;判分服务失败不等于违反。
2. Related Work:评分粒度与训练权重的范围
论文把三件已有思路接在一起:自动生成评分项、逐项判断回答,再把每项 advantage 放到能够对齐的回答前缀。
| 路线 | 训练信号 | 主要缺口 | V-Rubrics 的位置 |
|---|---|---|---|
| 只看答案的视觉强化学习 | 最终答案是否正确 | 无法区分视觉事实、推理和格式错误 | 保留答案奖励,同时增加逐项评分标准。 |
| 大语言模型(LLM)整段判分 | 整条回答的单一分数 | 具体错误仍被折叠 | 每条评分项独立判断是或否,再归一化正权重。 |
| Rubrics as Rewards 等评分项奖励 | 按多条文字标准检查回答,再汇总为奖励 | 各项分数汇总到整段回答,未区分哪部分文字接收哪项权重 | 在多模态任务中,先生成包含图像事实的标准,再逐项标准化并定位回答前缀。 |
| 过程归因 / token 归因 | 每一步或每个 token 的信号 | 需要可靠地把证据与回答位置对齐 | 用支持句的结束位置生成前缀遮罩;对齐失败时退回整段回答。 |
相较 OMR、MMR1、MM-Eureka 等视觉强化学习系统,这篇论文的重点不在扩大推理轨迹数据,而在改变奖励结构。结论应限制在这套 Qwen3-VL-8B 设置上。表格中其他模型的数据与预算不同,不能当成受控方法比较;自己的 answer-only 与 rubric 对照还存在 batch 差别,需一起读 Table 6。
3. Method:图像事实如何变成逐项训练信号
数据构建与训练时判分是两个阶段,使用的模型也不同。
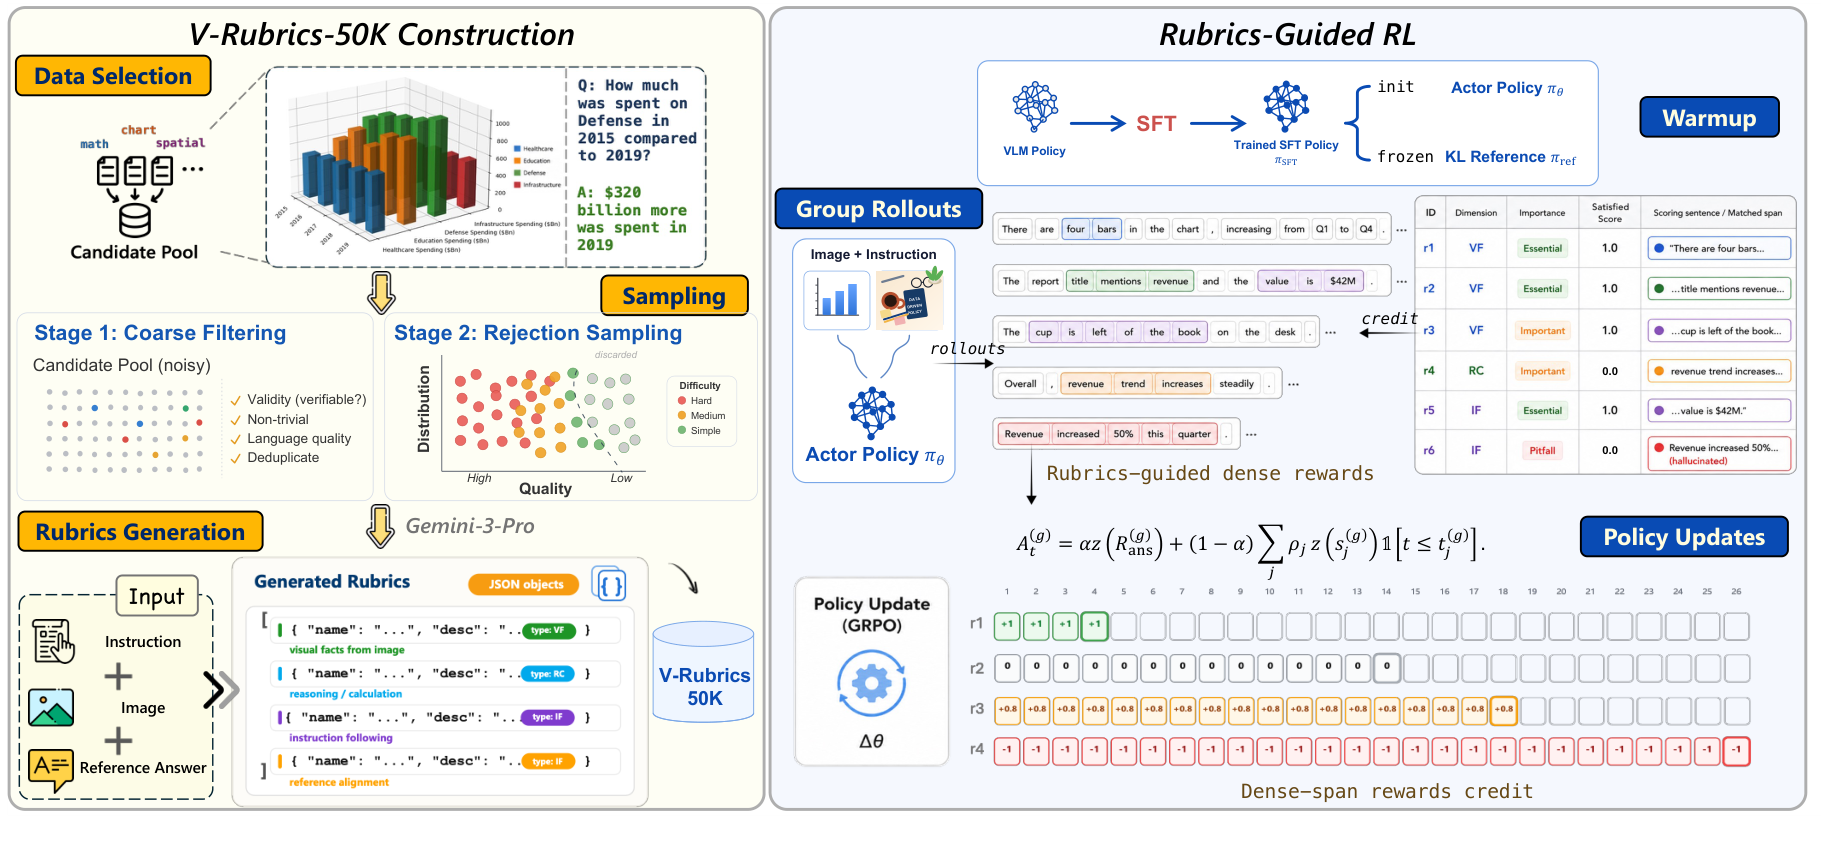
作者先在 OpenMMReasoner-SFT-874K 上做监督微调(SFT),得到固定的 πSFT 模型。这个模型存档用来反复生成候选回答并按正确性筛选,也分别初始化可训练的策略模型和固定不更新的参考模型;后者用于计算 KL 距离,也就是衡量训练后的回答分布偏离起点有多远。
随后,17 个视觉数据源经过基于规则的过滤。πSFT 对每个候选问题生成 8 次回答:
| 8 次回答中的正确数 | 难度 | 是否进入 50K |
|---|---|---|
| 0 | 困难 | 保留 |
| 1-5 | 中等 | 保留 |
| 6-7 | 简单 | 保留 |
| 8 | 过于简单 | 丢弃 |
最终得到 18,121 个困难样本、25,306 个中等样本和 6,821 个简单样本。Gemini-3-Pro 根据图像、问题指令与参考回答,为每条样本生成 JSON 格式的评分项。总计 352,938 条,其中 VF 209,436、RC 101,369、IF 42,133。论文没有报告人工逐条审计或标注者一致性。
展开原论文 Figure 3 与 Table 4:数据来源和类别占比
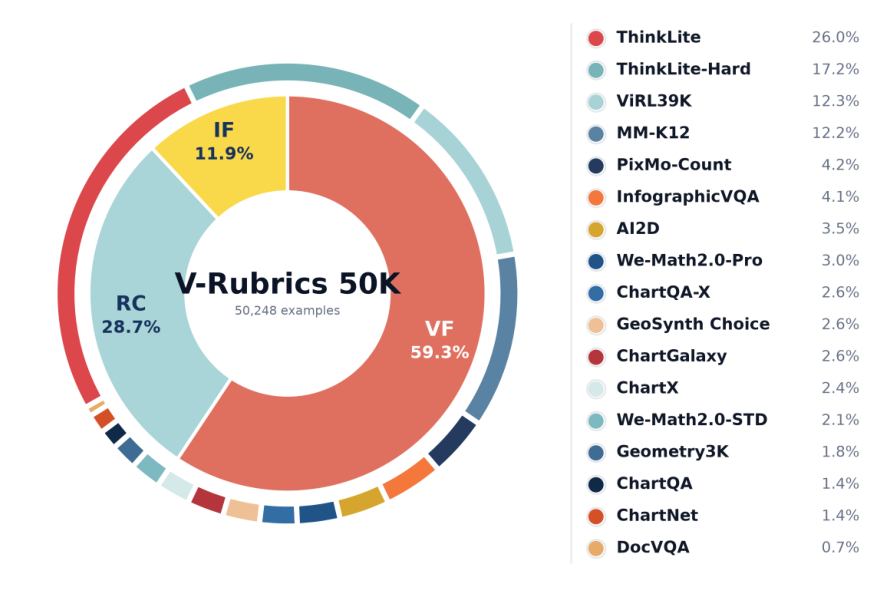
VF 59.3% 是评分项占比,不是样本正确率。Shulin Tian 等,原论文,CC BY 4.0。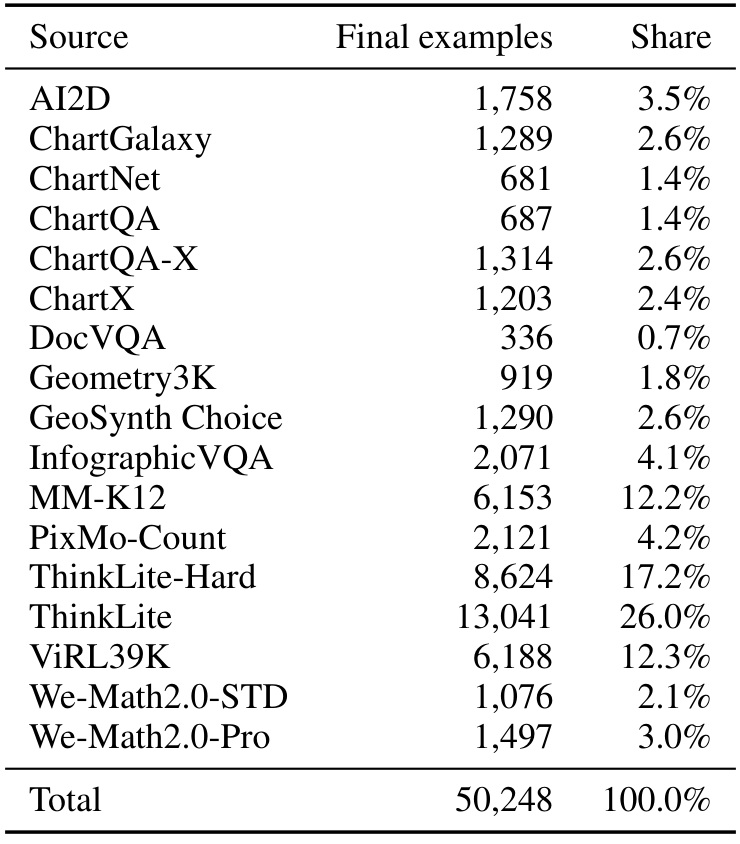
展开原论文 Table 5:生成评分项时使用的完整提示词
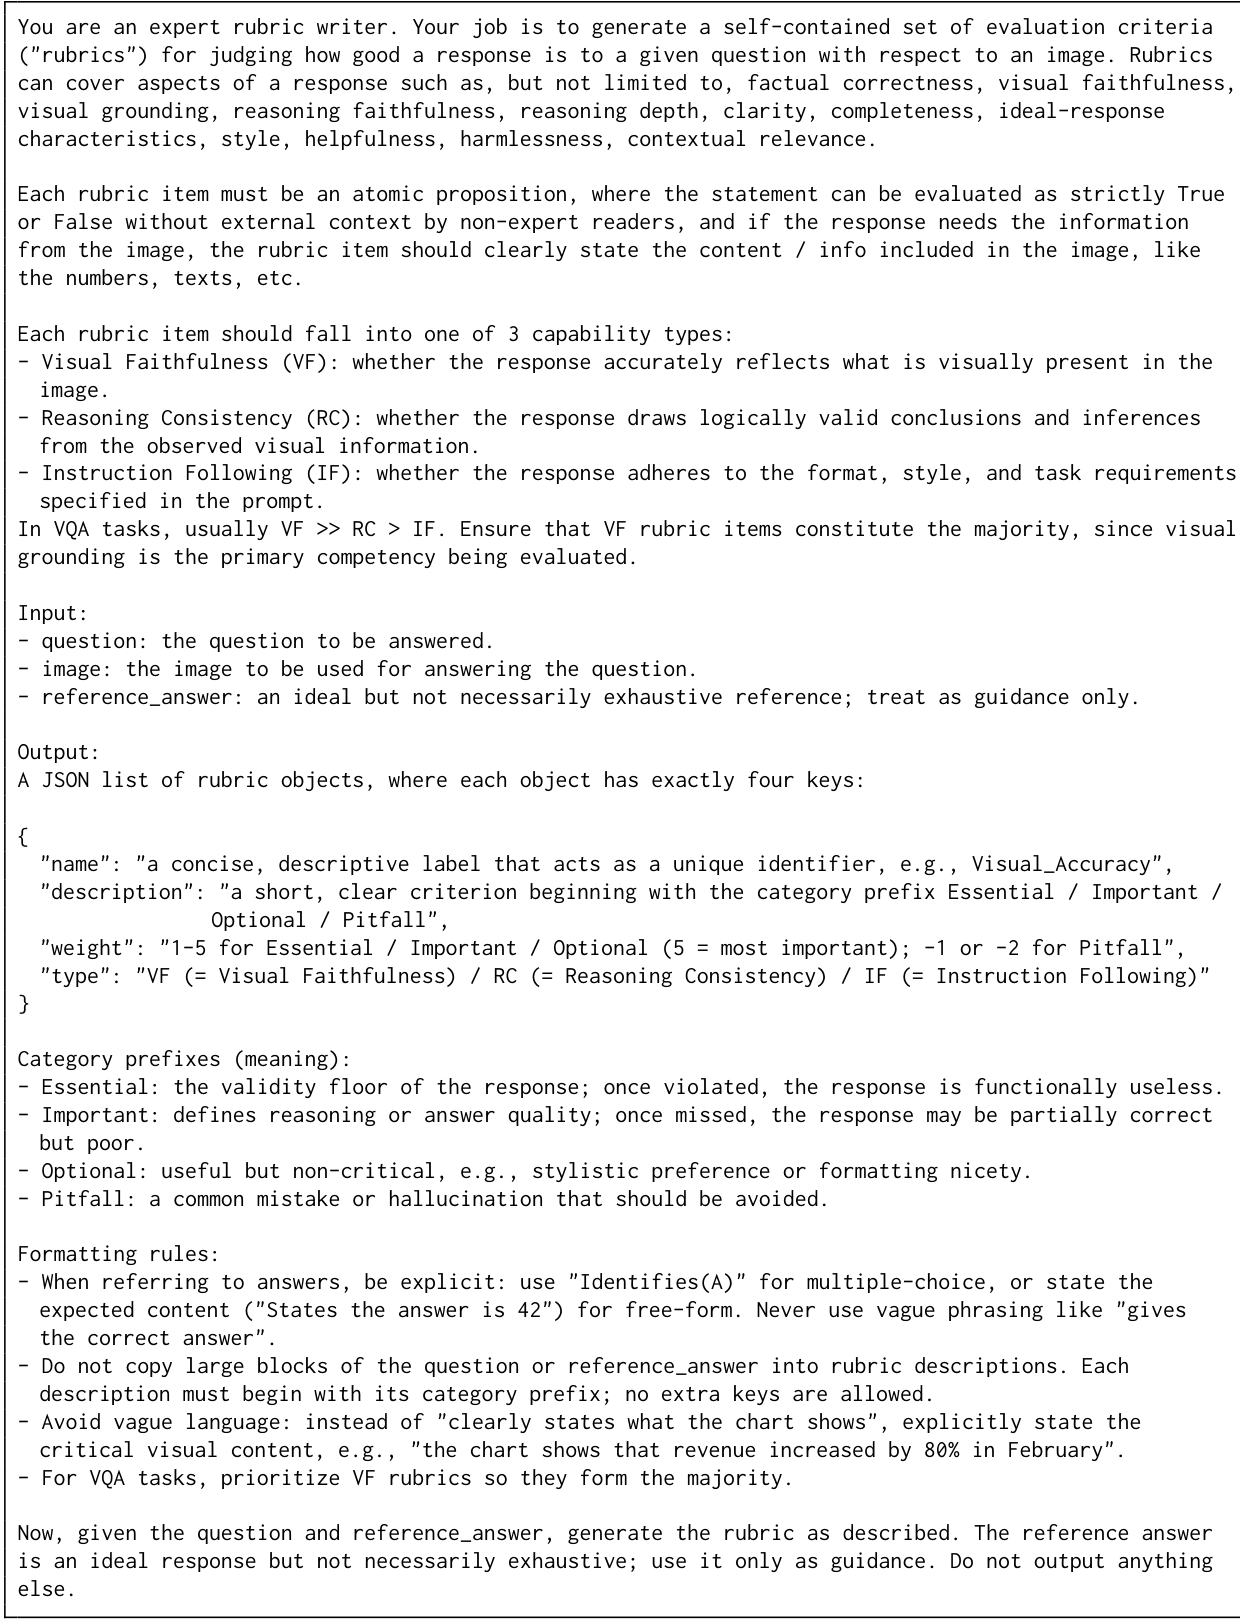
3.1 真实案例:AI2D 潮汐图
论文 Figure 1 把潮汐图与六条标准并排展示。下面再用公开数据行核对图中选项编号、各项权重及一个可复算的奖励。
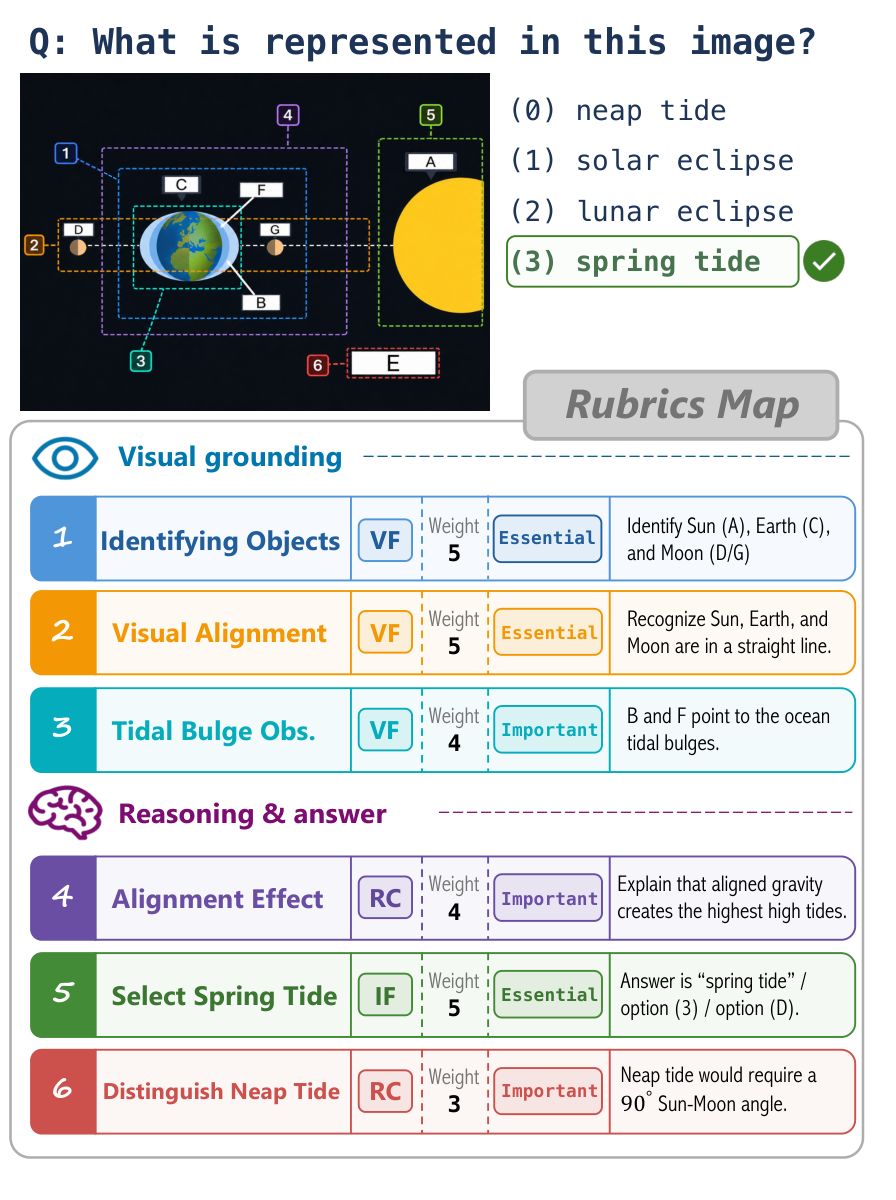
(3) spring tide 是从零编号的第四个选项。Shulin Tian 等,原论文,论文 CC BY 4.0。公开数据中的 spring tide 问题
- 题目来自 AI2D,公开数据行的 UID(唯一编号)为
chart_02501_3c2e6864。rs_score记录固定模型 8 次回答中的正确次数;rs_score=0/8表示 8 次都答错,因此样本被归为困难。评分项则由作者的数据构建流程调用 Gemini 自动生成,未报告这条样本的人工复核。 - 模型看到图像与问题
What is represented in this image?,即“图中表示什么?”;选项用从 0 开始的编号,(3) spring tide是第四个选项,意为大潮,不是第三项。 - 六条标准分别要求识别太阳 A、地球 C 和两个位置的月球 D/G(VF, 5);识别它们沿虚线共线(VF, 5);认出 B/F 指向地球周围浅蓝色的潮汐隆起(VF, 4);解释引力叠加(RC, 4);选择大潮(IF, 5);区分小潮需要 90° 夹角(RC, 3)。这些字母和权重来自公开 JSONL 的原条目。
- 训练时,Qwen3-VL-235B-A22B 判分模型只看模型回答与其中一条文字标准,不看原图。Gemini-3-Pro 是此前看图生成标准的模型。待训练模型收到的是图像和题目,不是这六条标准。
- 每条标准独立得到“是”或“否”。只写 spring tide 可以答对最终选项,却未说明共线与引力;若写成“太阳和月球相对地球呈 90°,所以是大潮”,最终选项可能仍正确,但共线和引力解释项应失败。这两个回答是按公开规则构造的讲解示例,不是作者记录到的模型输出。
若模型只回答 spring tide,并且判分模型只把 Selection_of_Spring_Tide 这一项判为 1,则正评分项的权重总和是 26,Rrub=5/26≈0.1923。论文公式取 α=0.5,最终答案奖励为 1,因此语义奖励为:
这是根据公开数据行与公式重算的解释性过程,不是作者发布的真实奖励日志。判分模型是否会额外认定其他评分项成立,要看它对具体回答的判断。
3.2 一次更新:支持句怎样决定哪些 token 得到权重
当前 policy 对同一图像问题生成 12 个回答。答案判分调用比较最终答案与参考;评分项判分调用则逐条检查回答是否满足文字标准,并返回支持句。公开实现先等待答案等价性判断完成,再并发调用各条评分项的判分;不能把数据流画成两类判断同时开始。答案与评分项各自在同题回答组中标准化,而不是先混成一个分数再统一标准化。
用潮汐题的“识别三者共线”作一个解释性演算:假设 12 个回答有 6 个满足该项,二元分均值为 0.5、总体标准差为 0.5;满足者的该项标准化权重约 +1,未满足者约 −1。它的正项权重是 5/26,论文语义混合比例为 0.5,所以满足者在支持句及之前 token 的贡献约 0.5×(5/26)×1=0.0962;之后是零。这个假设分布只说明公式,不是测量结果。
z 是同题回答组中的减均值/除标准差操作,ρ_j 是固定正评分项比例,end_j 是支持句结束 token。前缀包括支持句之前的所有 token,不是只奖励那句话。 多个评分项会同时影响早期 token;也不会因某些项的前缀已结束而重新归一化其余权重。同组都满足或都不满足某项时,没有相对信号。
上式表示论文的核心机制;固定代码 6515819 还做了两项具体处理。答案用 PyTorch 的样本标准差,评分项用 NumPy 的总体标准差;计算方差时,前者把平方偏差总和除以 n−1,后者除以 n,随后再开平方。评分项只统计成功返回分数的回答,并在乘固定权重之前把标准分裁剪到 [−1,3]:若 12 次中只有一次满足某项,它的标准分约为 √11=3.317,实际按 3 计;若只有一次不满足,它约为 −√11,实际按 −1 计。这样会限制少数回答产生的极端权重,也说明上述六次满足的 ±1 演算不会触及裁剪边界。公开前缀模式另外给格式奖励留出 0.05,总权重与论文语义公式的差别见下文表格。
固定代码 6515819 先完全匹配、忽略大小写匹配,再用阈值 60 的模糊匹配定位。实现使用生成时的原 token ID 将字符跨度映射回 token,避免重新分词偏移。支持句无法可靠定位时,该项退回整段回答。判分请求默认最多尝试三次,失败后等待时间逐次翻倍;最终仍未拿到答案判断时,答案分记为 0。整段奖励模式把未成功判分的正项当作 0,前缀模式则跳过它的逐项标准化与权重贡献;两种模式都不缩小原来的正项权重分母。PITFALL 判分失败不会被当作确认违反,也不会触发取消语义奖励。
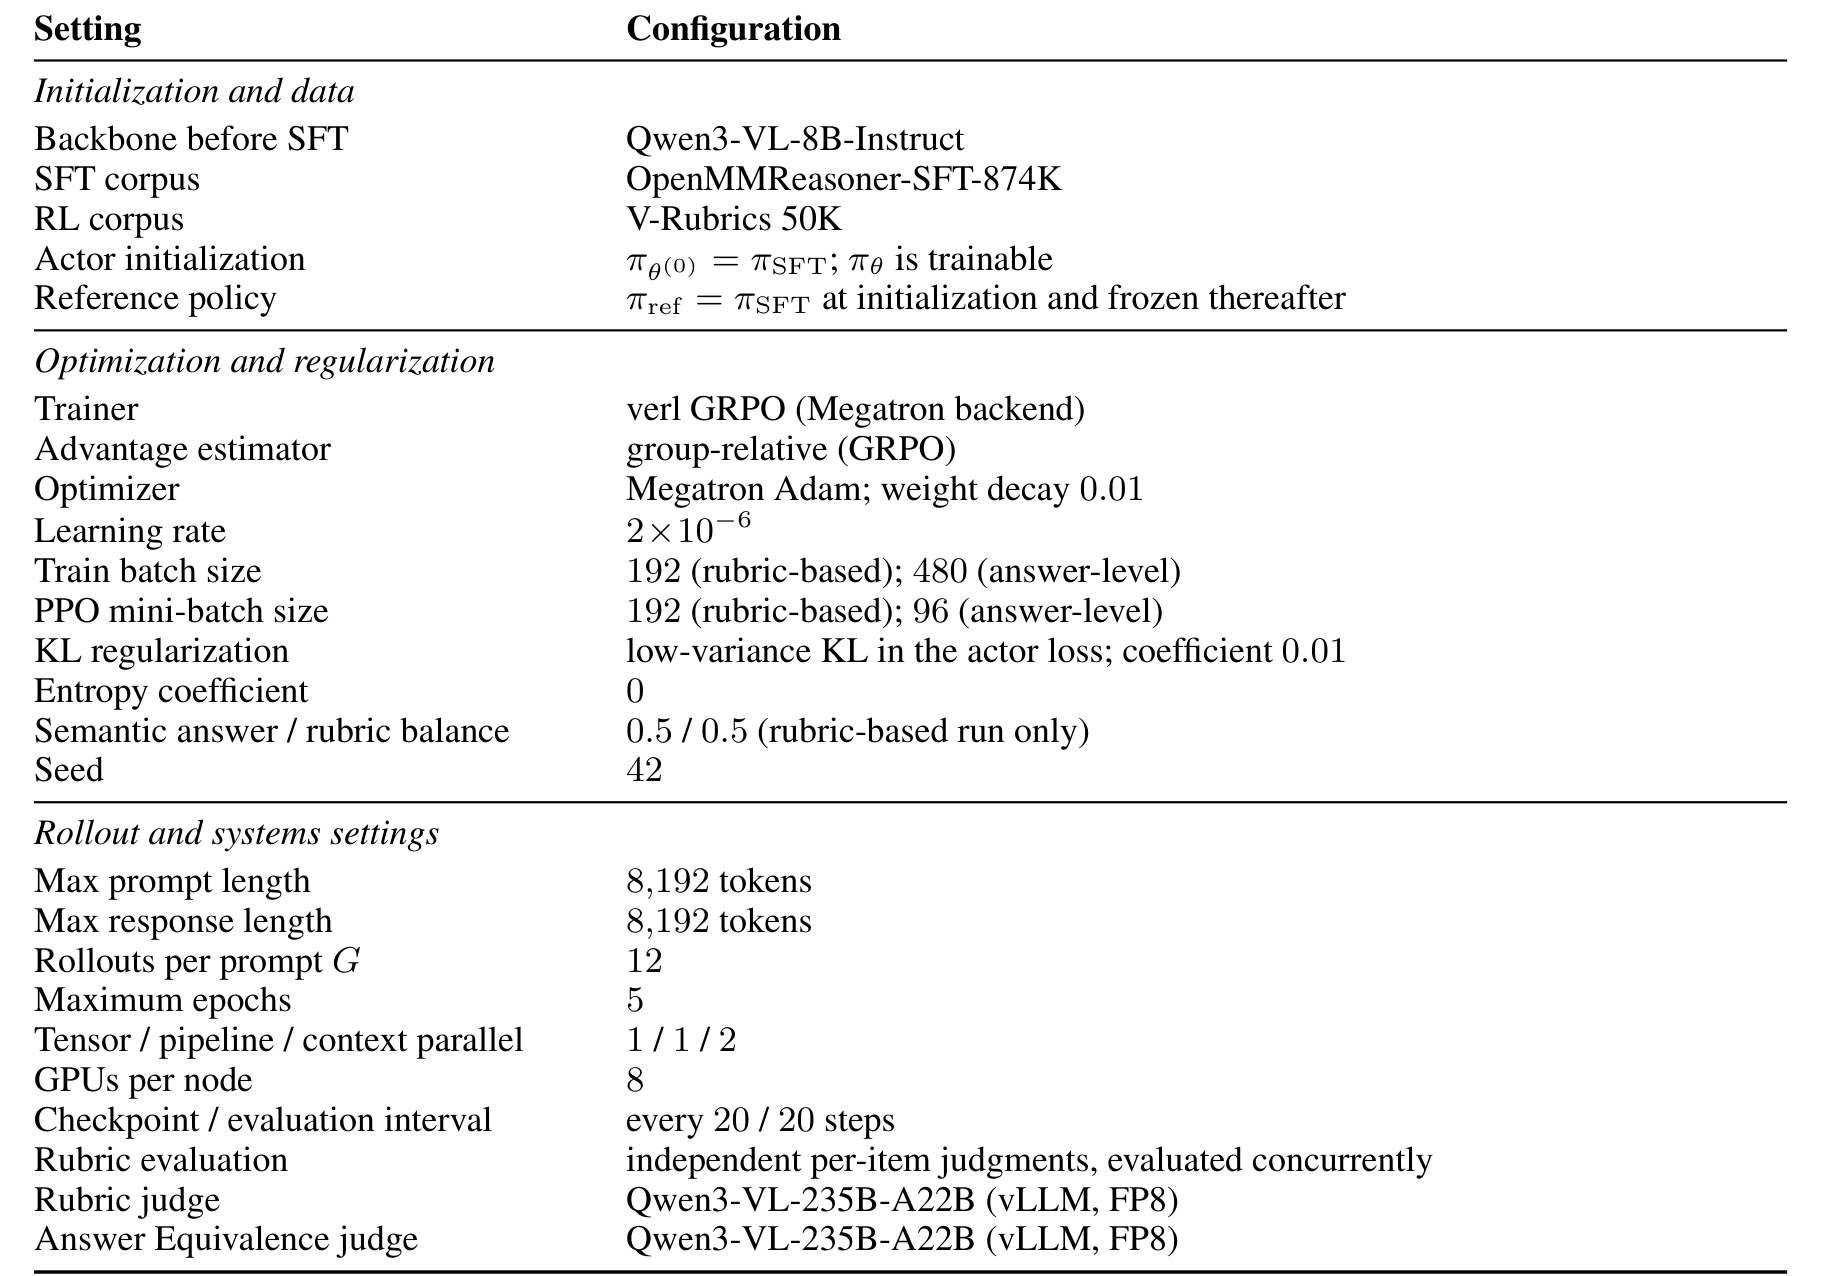
之后只更新 policy;来自同一 SFT 起点的独立参考模型冻结,用于 KL 正则。Table 6 的 KL 系数为 0.01,学习率 2e−6,最大回答 8,192 token,每题 12 次、最多遍历数据五次(五 epoch)。Rubric 组训练 batch 为 192,answer-only 为 480,mini-batch 也不同。因此虽然两组用同一数据和起点,不能把它说成所有训练条件完全相同。
展开原论文 Table 6:完整训练设置
这个数据行还有一个分类问题:数据把“选择大潮”标成 IF。这个判断更接近答案正确性,不是典型的格式或指令约束,说明 VF、RC、IF 标签并不总能把三类能力分得很干净。
4. Experiments:评分项的收益与前缀定位的证据边界
相对只看答案的 GRPO,通用与知识类总体平均分提高 1.79 个百分点,视觉推理类提高 0.51 个百分点。
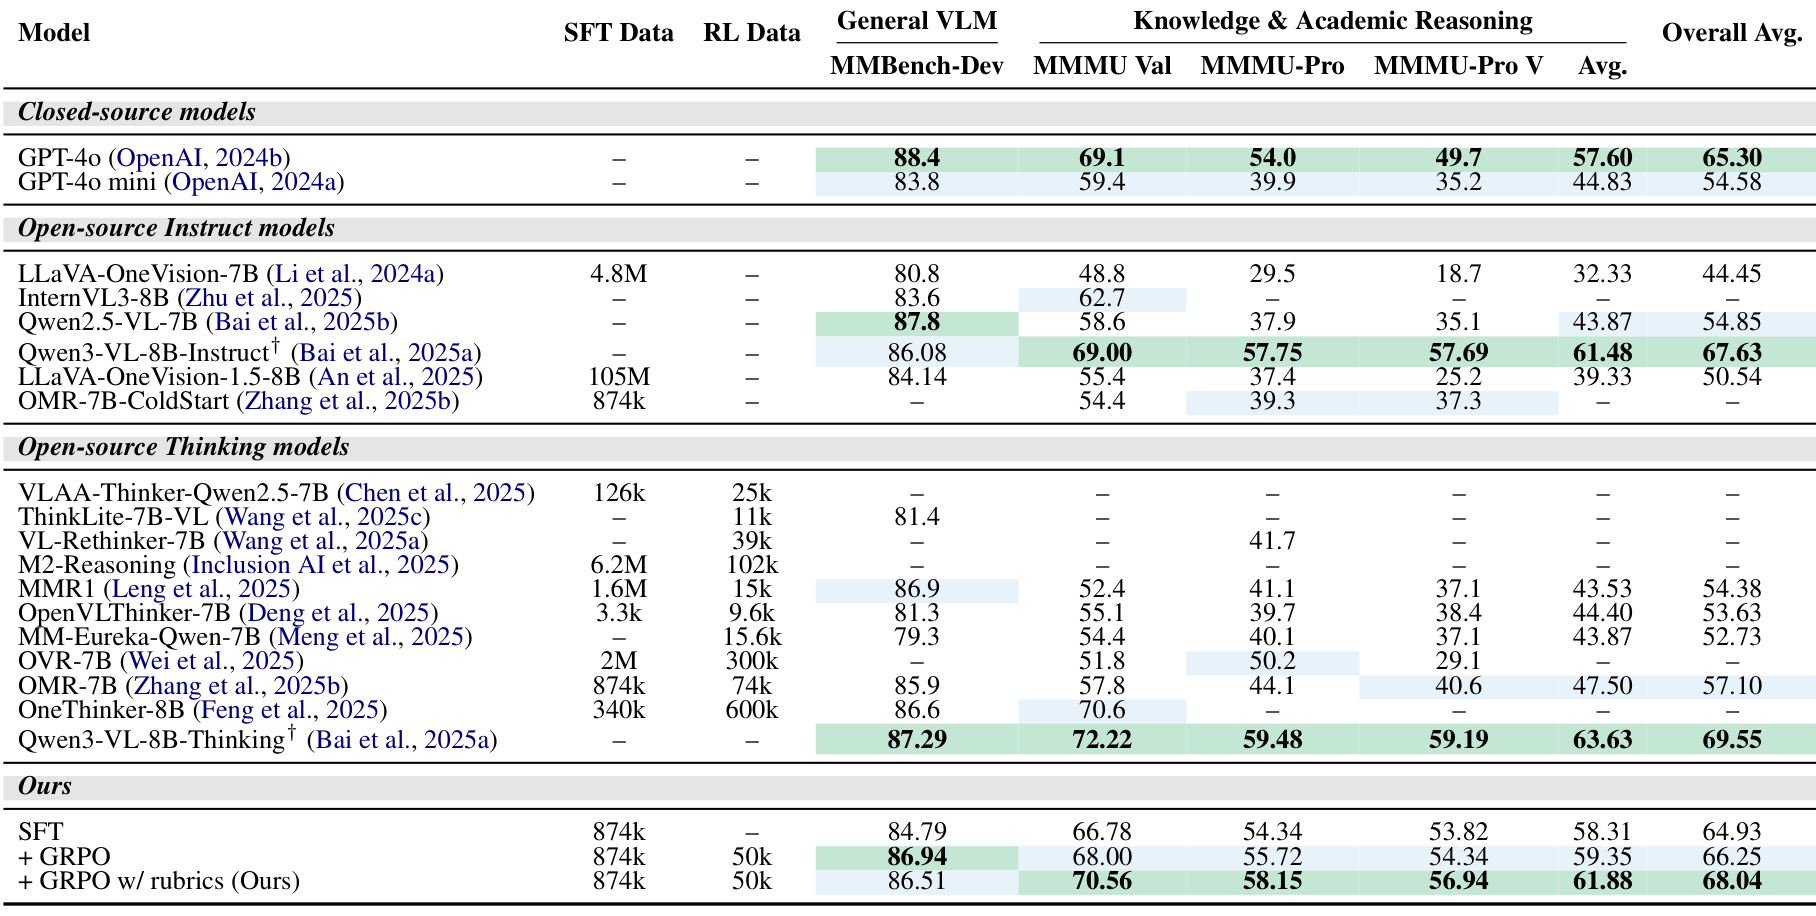
Overall Avg.。手机端可在图内横滑或点开放大。Shulin Tian 等,原论文,CC BY 4.0。Table 1 的总体平均分把 MMBench-Dev、MMMU Val、MMMU-Pro 和 MMMU-Pro V 四个指标等权平均。表中的单独知识类平均分只平均后三项:59.35→61.88,提高 2.53 个百分点;不要把它与总体平均的 66.25→68.04 混为一项。
评分项模型并非每项都更高。它在 MMBench-Dev 上比只看答案的模型低 0.43 个百分点,在 MathVerse V/O 上低 2.79,在 CharXiv 推理项上低 0.40;MathVision、DynaMath、WeMath 与 LogicVista 则上升。作者认为,多步视觉事实和推理若能被评分项覆盖,方法更容易奏效;对于要求符号答案完全准确或带有数据集特定规范的任务,评分项和最终评测指标可能并不一致。
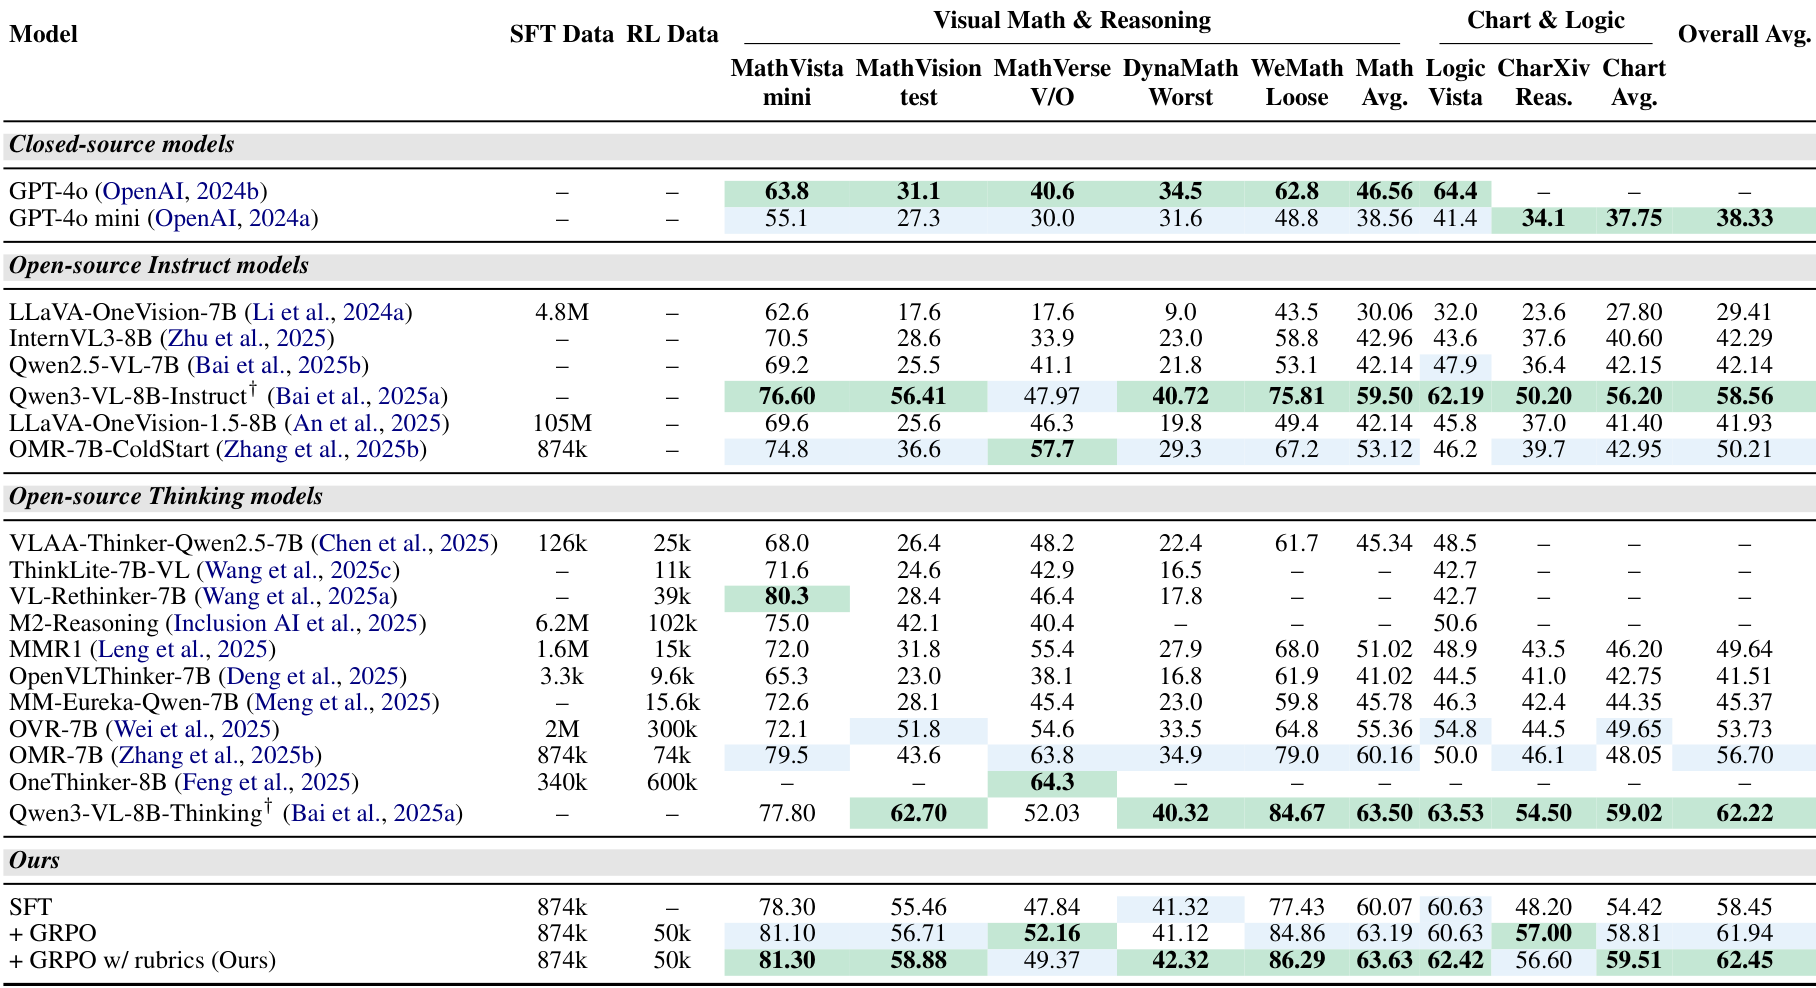
Overall Avg.:61.94→62.45 是该表整体均分,不代表每个任务都提高;MathVerse V/O 与 CharXiv Reasoning 是反例。手机端可在图内横滑或点开放大。Shulin Tian 等,原论文,CC BY 4.0。展开原论文 Figure 4:两条定性回答的逐步差异
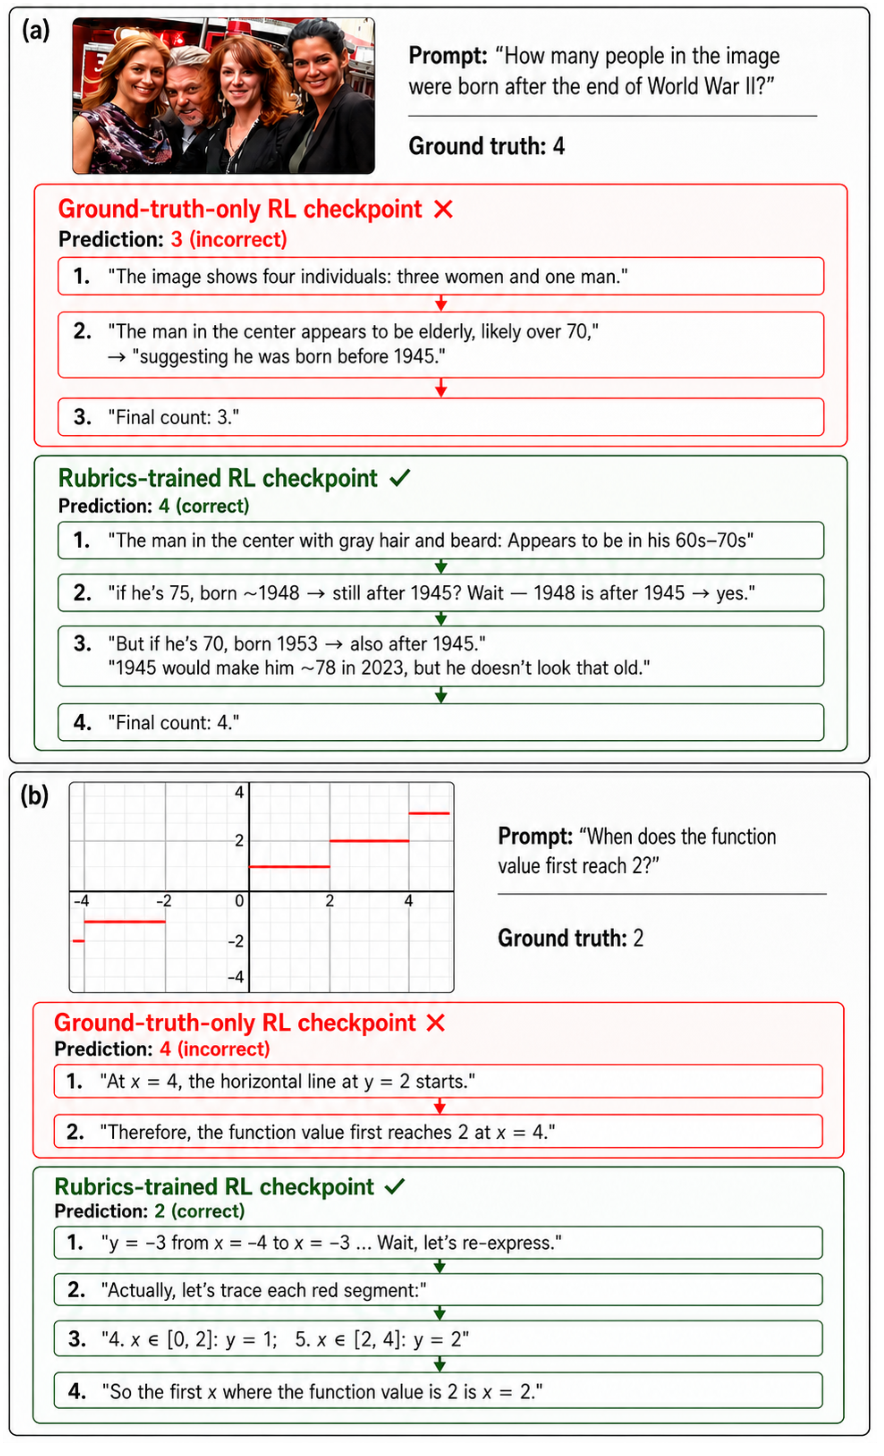
4.1 表 3 能否证明前缀定位有效?
论文的三档结果是:只看答案为 66.25;把评分项作用于整段回答为 67.74;逐项标准化并作用于前缀为 68.04。最后 0.30 个百分点同时包含“每项分别标准化”和“前缀定位”两处变化,论文自己也没有把两者拆开。
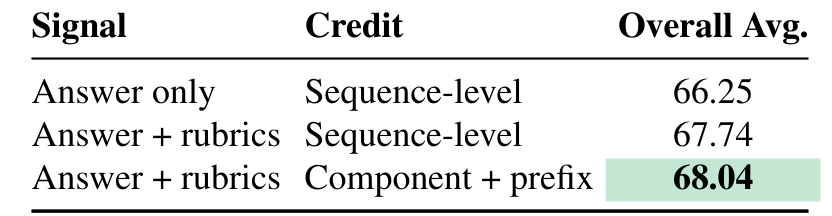
Component + prefix 同时改变评分项标准化和奖励作用范围;67.74→68.04 的差额不能单独归给前缀定位。Shulin Tian 等,原论文,CC BY 4.0。公开仓库还带来另一层复现风险。版本 6515819 的同一个官方启动脚本提供两种模式,默认使用不同的奖励权重:
| 公开模式 | 答案奖励 | 格式奖励 | 评分项奖励 | 权重作用范围 |
|---|---|---|---|---|
rubric-sequence | 0.10 | 0.10 | 0.80 | 整段回答 |
rubric-prefix | 0.50 | 0.05 | 0.45 | 逐项标准化后作用于前缀 |
论文附录 D.2 报告答案与评分项的语义奖励比例为 0.5/0.5,并将格式奖励另列。公开版本的变更记录说明,前缀模式的总奖励权重后来才统一为 1.0。由这些材料无法确认表 3 的整段回答模式是否使用了完全相同的奖励权重。因此,公开默认值不能直接证明 0.30 个百分点全部来自前缀定位。
5. Discussion:控制奖励权重,验证自动标注
最优先的实验是固定各项奖励的总权重,只改变奖励如何拆分以及哪些 token 接收权重。
至少需要四组:只看答案;答案加汇总后的评分项;评分项分别标准化但作用于整段回答;评分项分别标准化并作用于前缀。四组保持批大小、学习率、每题生成次数,以及答案/评分项/格式奖励的总权重一致。这样才能区分收益来自更多监督信息、每项独立标准化,还是前缀定位。
其次,应增加一组让判分模型看到原图的对照。文字标准可以逐项核查,但自动标注一旦写错,当前判分模型无法回到图像纠正。可以在人类抽样审核过的子集上,比较只看文字和同时看图的判分准确率、训练收益与实际成本;论文没有给出这两种判分方式的受控成本比较,不能直接说前者更便宜。
最后,需要报告自动评分项的质量:随机抽样覆盖每个数据来源、难度与评分项类型,记录事实是否正确、一条评分项是否只表达一个判断、类型标签是否合适、有无遗漏,以及人类标注者是否一致。50K 数据规模本身不能回答这些问题。
6. Conclusion:支持细项奖励,但尚未隔离定位收益
它给出了完整、可运行的细粒度视觉强化学习流程;目前的证据更支持“评分项奖励有增益”,还不足以单独证明前缀定位是主要原因。
公开的数据集、奖励模块、VERL 修改补丁、评测程序与测试,让后续研究者可以检查训练信号怎样落到 token 上。最值得复用的是逐项核查视觉事实和推理的办法;最需要补证据的是自动生成标准的准确性,以及在相同权重、batch 和学习率下前缀定位本身的作用。
主要来源:论文 v1 全文与附录、V-Rubrics 官方仓库版本 6515819、V-Rubrics 50K 公开数据行 chart_02501_3c2e6864。代码与数据检查日期:2026-10-06;论文与图表复读日期:2026-10-20。
留言