[2026-09-01] HarnessDev: Can LLMs Create and Evolve Their Own Agent Harness?
模型先编写一套能调用工具、修改文件和检查结果的 Agent 程序,再根据执行反馈继续改进。本文说明开发与隐藏评测的边界、真实失败案例、跨模型迁移,以及 2,207 个下游实例上的结果。
模型先编写一套能调用工具、修改文件和检查结果的 Agent 程序,再根据执行反馈继续改进。本文说明开发与隐藏评测的边界、真实失败案例、跨模型迁移,以及 2,207 个下游实例上的结果。
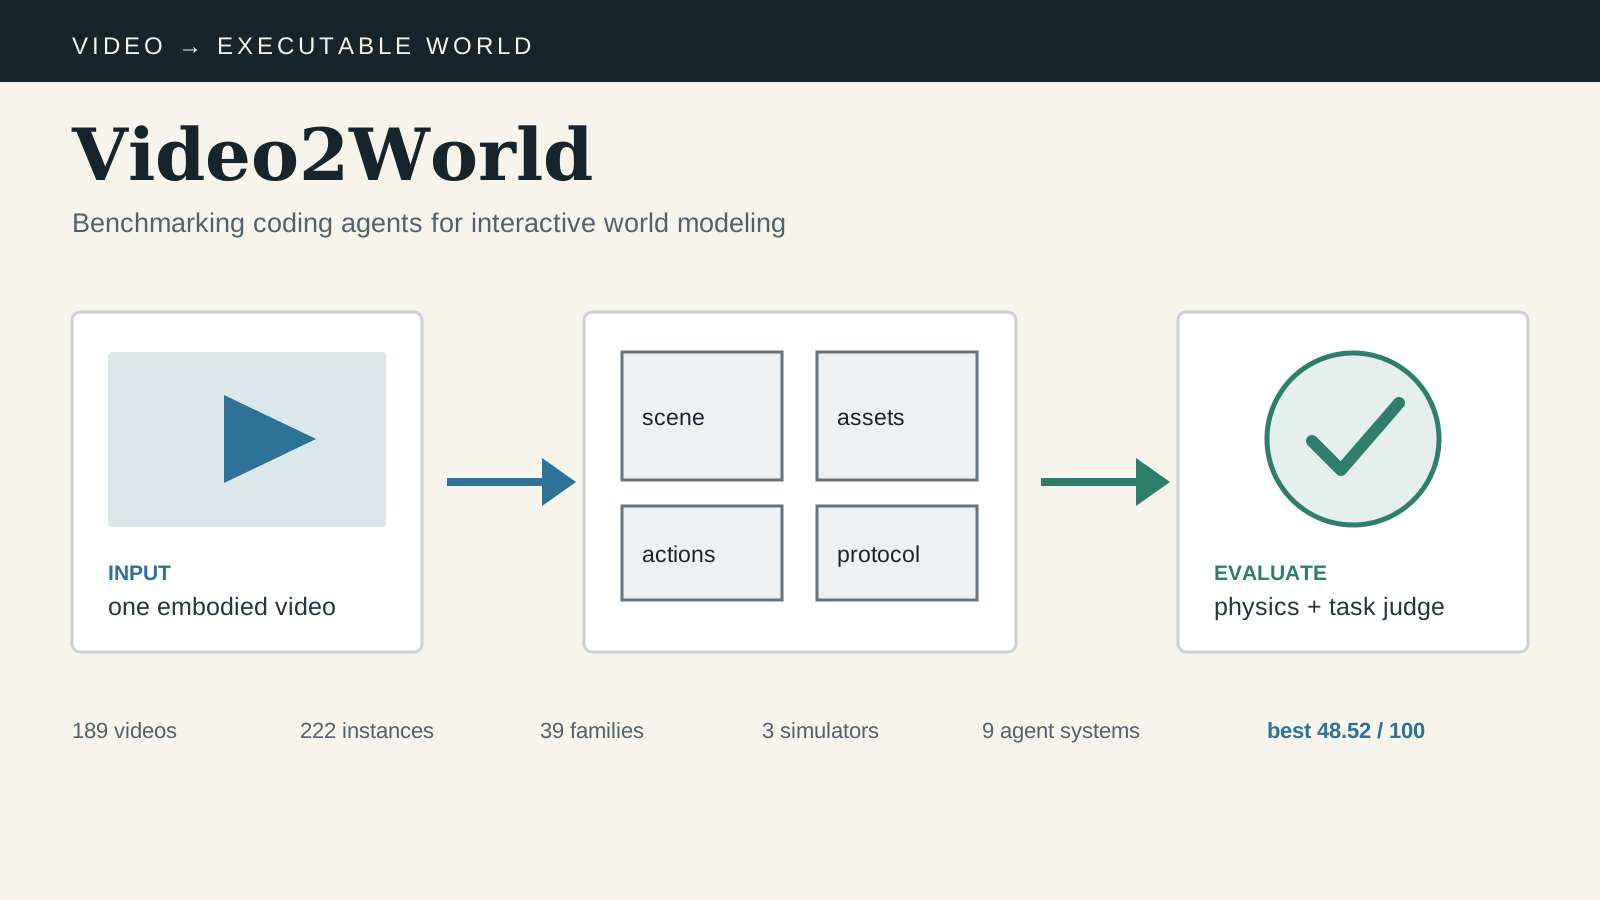
只给一段操作视频,Agent 要写出能在物理模拟器里完成同一任务的场景与控制代码。本文用立瓶子的完整案例说明输入、隐藏标注、执行状态、成功判据、评分公式与九套系统的结果。
Agent 一边操作原软件弄清行为,一边写代码复刻,再运行自己的版本检查差异。本文用 Logbert 固定日志案例说明任务与隐藏测试的来源、两种评分通道、五平台结果和训练迁移。
ClawGym II 保留 Claude Code 和 OpenClaw 的工具执行流程,通过模型调用记录和任务评分训练模型。本文解释分支怎样恢复、哪些生成不参与训练,并实际运行公开周报任务的检查程序,核对评分与实…
RIVER 先检查任务说明、容器和测试程序是否一致,再让强模型各试两次,从原训练集筛出约 3.5K 个环境。两条真实误判记录说明答案泄漏和脆弱测试怎样带偏训练,以及重复操作的扣分加在何处。
在给定 Godot 项目里补好玩法逻辑,怎样确认它每一步都守规则?从引擎与代码示例讲起,逐项拆解任务构建、真实案例、隐藏判分和实验分母。
47 个浏览器游戏怎样验收:谁写测试、编码模型系统看见哪些材料、真实拖拽如何判失败,以及为什么运行检查平均通过率 93.2% 只对应 26/47 个完整成功任务。