Meta-Harness 研究怎样自动改进包在模型外的运行程序,包括提示词、记忆、检索和工具调用流程。外层的 Claude Code 读取历次候选的源码、分数与执行记录,再写出新候选。独立评测程序检查候选、运行任务并计分;被调用的基础模型始终不更新权重。
1. Motivation:单个分数为什么不够诊断完整执行程序?
因为 harness 的错误往往隔很多步骤才显现,而现有优化器通常在提案模型看见历史之前就把反馈压缩掉了。 一次检索选错例子,可能十轮后才出现错误答案;一次结束条件修改,可能让已经做完的 Agent 又检查几十步。单个总分只能告诉提案模型“变差了”,不能指出哪次调用或状态更新出了问题。
论文估算,所列文本优化器一次产物评测可产生约 100 到 30,000 tokens 的反馈;最重的 harness 评测一次可产生约 1,000 万 tokens。这是可供诊断的材料量,不是一次实际模型输入的长度,也不是各方法按相同预算测得的值。 Meta-Harness 把源码、分数、模型回复、工具调用和状态更新存到文件系统,让代码 Agent 用 grep、cat、脚本和局部读取选择相关证据。
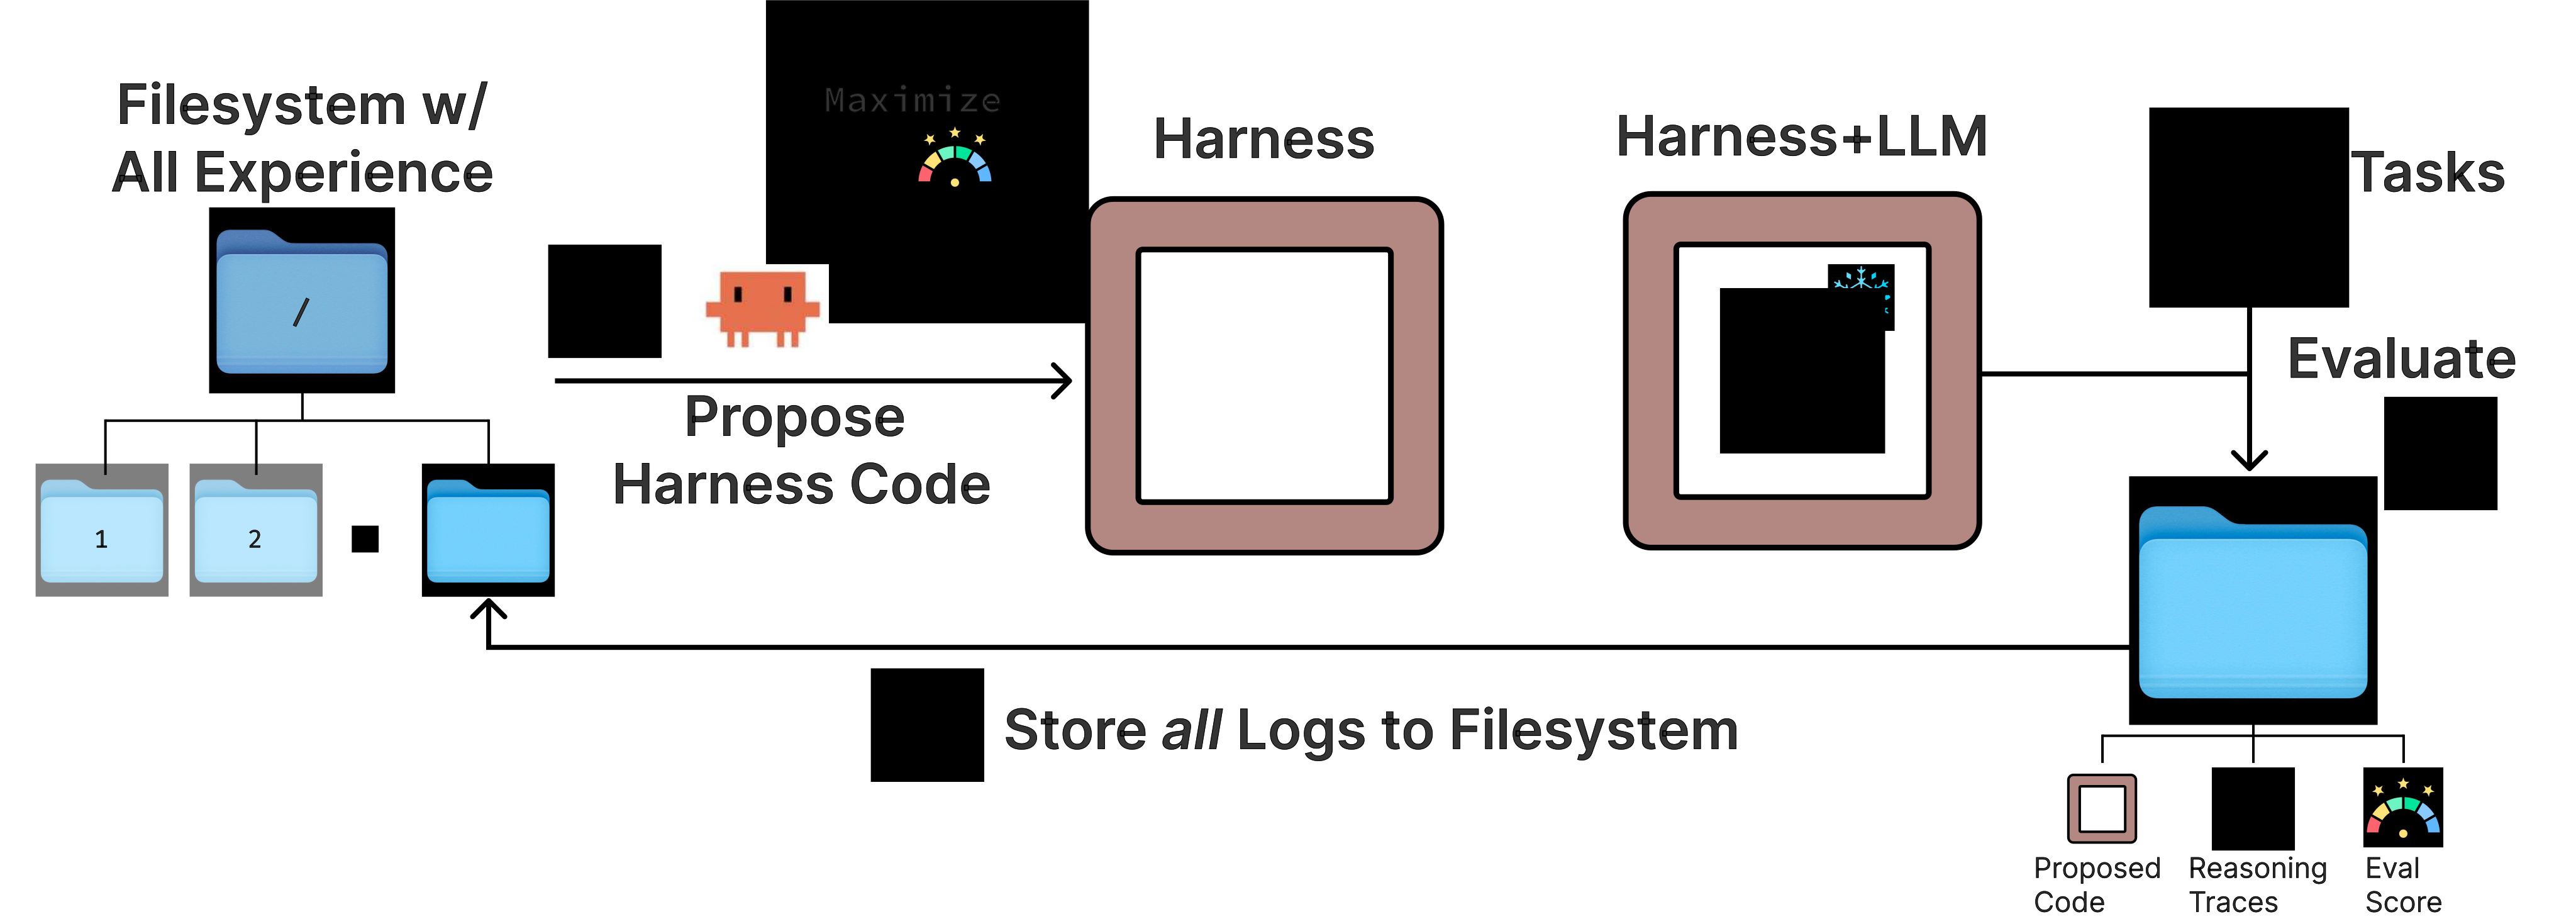
TerminalBench 搜索中的读取记录说明提案模型确实使用了这套历史:十轮里,每轮读取 69 到 99 个文件,中位数 82 个;其中 41% 是旧 harness 源码,40% 是原始执行记录,只有 6% 是分数或摘要文件。它会跨候选查证,不是只在最新版本附近做局部修改。
2. Related Work:与提示词优化、程序搜索和共同进化的区别
Meta-Harness 改完整代码,允许读取所有旧候选的原始执行记录,但不更新被包裹模型的权重。 它没有新增复杂的候选选择规则。外层程序保存历次候选和 Pareto frontier,但读哪个旧版本、改哪一层、局部修改还是整体重写,由提案模型决定。
| 工作 | 优化对象 | 反馈接口 | 与本文的关键边界 |
|---|---|---|---|
| GEPA | 提示或其他文本产物 | 一个候选的执行反馈或摘要 | 反馈不只是总分,但不能自由检索所有候选的原始记录。 |
| AlphaEvolve / OpenEvolve | 指定函数或可执行程序 | 历史程序与评测分数 | 同样搜索代码;Meta-Harness 额外让提案模型自由检查完整执行记录。 |
| TTT-Discover | 推理时生成的程序等产物 | 近期方案片段;PUCT 优先复用高分且少访问的候选 | 依赖预设搜索结构;本文让提案模型自己选证据和修改范围。 |
| ACE / MCE | 在线记忆或自然语言技能描述 | 样例、反思与技能库 | 它们是分类实验里的手写执行程序基线;Meta-Harness 搜索新的检索与提示构造程序。 |
| HarnessForge / Co-Harness | 程序与模型权重 | 失败原因分析与成功记录 | 共同更新模型和程序;本文只改程序,可以再换基础模型测试。 |
Table 3 直接检验了这条边界。分类搜索中,只看分数组的候选准确率中位数 / 最高值是 34.6 / 41.3;加入模型摘要后是 34.9 / 38.7;能检索原始执行记录的完整组达到 50.0 / 56.7。这些数字是候选在搜索集上的表现,不是最终测试成绩。至少在这项对照里,摘要不能代替原始执行记录。
3. Method:搜索循环与一次真实失败诊断
提案模型修改程序,外层执行程序独立评分;失败代码和日志继续保留,供下一轮查错。
3.1 主循环的责任边界
- 1 · 读历史提案模型检索历史代码、分数和原始执行记录。
- 2 · 查原因它提出失败原因与可检验的改动。
- 3 · 写候选生成新的单文件 Python harness。
- 4 · 初步检查论文要求接口验证;公开分类版本先检查能否导入。
- 5 · 跑任务固定基础模型在搜索任务上运行。
- 6 · 存记录新代码、分数和执行记录写入文件系统。
论文中的一个典型搜索约 20 轮、评测 60 个候选。多目标场景不先把准确率与上下文成本压成单一分数,而是保留 Pareto frontier。最终测试结果不回传给提案模型;只测试搜索阶段留下的折中候选。
官方分类实验代码中,meta_harness.py 先调用 Claude Code,读取 pending_eval.json(提案模型写出的待评测候选清单),随后在有 30 秒超时的子进程里检查候选能否导入,再由 benchmark.py 评分、更新前沿。导入成功不等于接口行为已验证。论文 Appendix D 建议另做实例化和方法调用的小样例,公开分类版本的这一步没有实现那整套检查。
--test 是显式最终测试入口。这里的测试隔离是运行协议,不靠文件权限实现。公开仓库中仍有测试数据,复现实验时需要保证搜索程序和提案模型都不拿最终测试成绩选候选。
3.2 TerminalBench:前六轮失败后,第七轮只补环境信息
TerminalBench-2 的搜索日志给出了一条可追踪的诊断与修改过程。起点 Terminus-KIRA 的搜索分数是 64.4%。第 1 轮同时删特殊标记、加循环中止逻辑、清理提示并补检查清单,分数降到 58.9%;第 2 轮改结束条件,却继续沿用新提示,降到 57.8%。
第 3 轮提案模型查到两个失败候选共享一份强调清理的提示:Agent 会在任务真正结束前删掉仍有用的状态。它恢复原提示,只保留控制流程修复,分数回到 63.3%。仍低于基线,但缩小了回退,支持“新提示干扰了结构修改”的诊断。
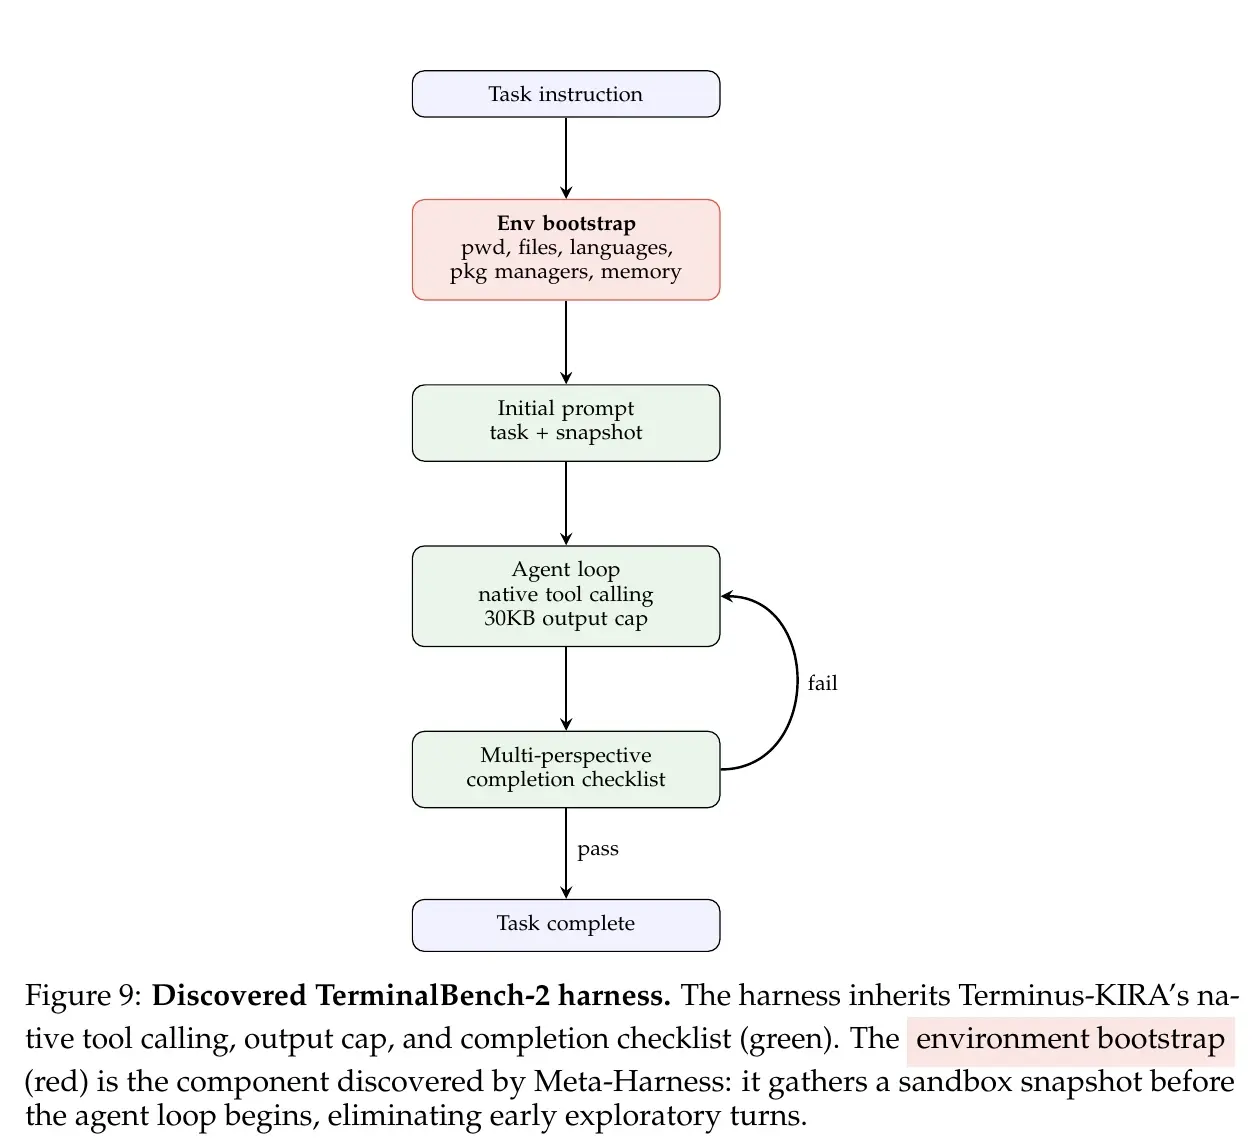
第 4–6 轮继续修结束标记、弱化清理要求和调整等待策略,仍然退步。第 7 轮换了策略:不再碰已知脆弱的提示、结束流程或观察处理,只在第一次模型调用前追加环境快照。 提案模型根据前六轮失败,把改动从“重写控制流”收缩为“额外提供信息”。
官方发布代码中 _gather_env_snapshot() 收集哪些环境信息
- 运行
pwd,列出/app;超过 25 行时只保留前 20 个条目和剩余数量。 - 查询 Python、GCC、G++、Node、Java、Rust 与 Go 版本。
- 查询
pip3、pip、apt-get与可用内存。 - 内部命令超时 15 秒;外层
asyncio.wait_for超时 20 秒。 - 成功时把
[Environment Snapshot]追加到初始提示;任何异常都返回空串或被捕获,Agent 回到原本的探索路径。
下面两段分别摘自官方 agent.py 的环境查询函数和后续循环入口(revision 57fefdb)。它们依赖 Harbor 的任务环境,不是独立可运行脚本;第一段省略了前面的命令构造与后面的输出解析,没有补写不存在的辅助函数。
1 | # _gather_env_snapshot 内的实际节选 |
1 | # _run_agent_loop 内的实际节选 |
作者认为,提前提供环境信息可减少 2 到 4 轮 ls、which python3 等探索调用,尤其帮助依赖生物信息学库、渲染程序、棋类引擎或密码学工具的任务。公开材料没有给出逐任务调用数的受控对照,不能把节省轮数当成独立验证的因果结果。论文报告,相比 Terminus-KIRA,89 个任务中有 7 个的通过表现改善,最大改善出现在 protein-assembly 与 path-tracing;“7 个任务有增益”不等于“新增解出 7 道整题”。
4. Experiments:分类、数学和终端实验:评分与泛化含义不同
三类实验都提高了最终测试分,但候选搜索预算、输入长度单位和泛化划分必须分别读。
4.1 在线分类:准确率和上下文成本
作者用 GPT-OSS-120B 做固定分类模型,在 LawBench、Symptom2Disease 和 USPTO-50k 上搜索 40 个候选。三类任务分别从案情选罪名、从症状选疾病标签、从产物分子预测反应物。程序可以保存此前获得的带标签样例,再根据当前问题选择提示中的例子。
先看一个真实输入怎样计分。官方分类代码 revision 0cbc31e 中,data/symptom_diagnosis/test.jsonl 第一行来自上游 metaevo-ai/mce-artifact,不是 Meta-Harness 新标注的样例。题目原文是:
I have a burning sensation in my stomach that comes and goes. It’s worse when I eat and when I lie down. I also have heartburn and indigestion.
也就是间歇性胃部烧灼感,吃东西或躺下时更明显,并伴有烧心和消化不良。文件中的标准标签为 peptic ulcer disease(消化性溃疡)。分类模型收到症状文本和程序提供的历史例子,当前题的标准标签用于判分;它不能把标签先放入当前题的提示再声称预测正确。这个数据标签也不应当作医疗诊断意见。
data/evaluators.py 先提取 JSON 的 final_answer 或 [DIAGNOSIS] 标签内容,再统一大小写、连续空白和末尾的 .!?,最后做标签字符串的精确匹配。本文直接调用固定版本的这个函数:说明输出 {"final_answer": "Peptic ulcer disease."} 得 1;{"final_answer": "gastritis"} 得 0。两种输出都由本文编写,官方发布材料没有提供这条测试样例的生成回复。这项检查只验证判分函数,不代表重跑了模型或整套实验。
data/evaluators.py:79–99 绘制。输入与标准标签来自发布数据;两条待评分输出由本文编写,只演示判分,不代表模型成功率。其他两项也有确定性检查:LawBench 比较解析后的罪名集合是否完全相同;USPTO 比较用句点分开的反应物字符串集合是否完全相同。F1 或 Jaccard 相似度是额外诊断字段,不是这张准确率表的得分。USPTO 这段代码也没有验证两种不同 SMILES 写法是否化学等价。
公开 inner_loop.py 的准确率是答对数除以样例数。Table 2 再把三个数据集的准确率等权平均:(14.0 + 86.8 + 45.0) / 3 = 48.6%,不是把三份不同大小的测试集直接合并后计分。最终 harness 比 ACE 的 40.9% 高 7.7 pp,比 MCE 的 40.0% 高 8.6 pp;论文 Table 2 报告的输入长度是 11.4K,而 ACE 为 50.8K。
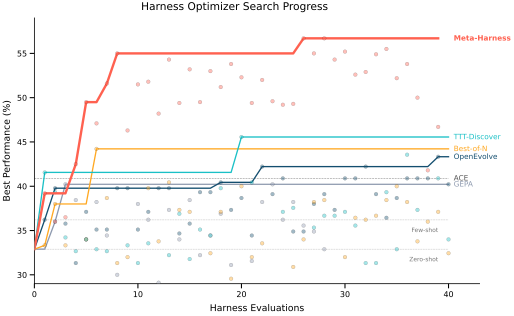
搜索留下了多个准确率与输入成本不同的程序,Appendix B.1 详述两个代表。
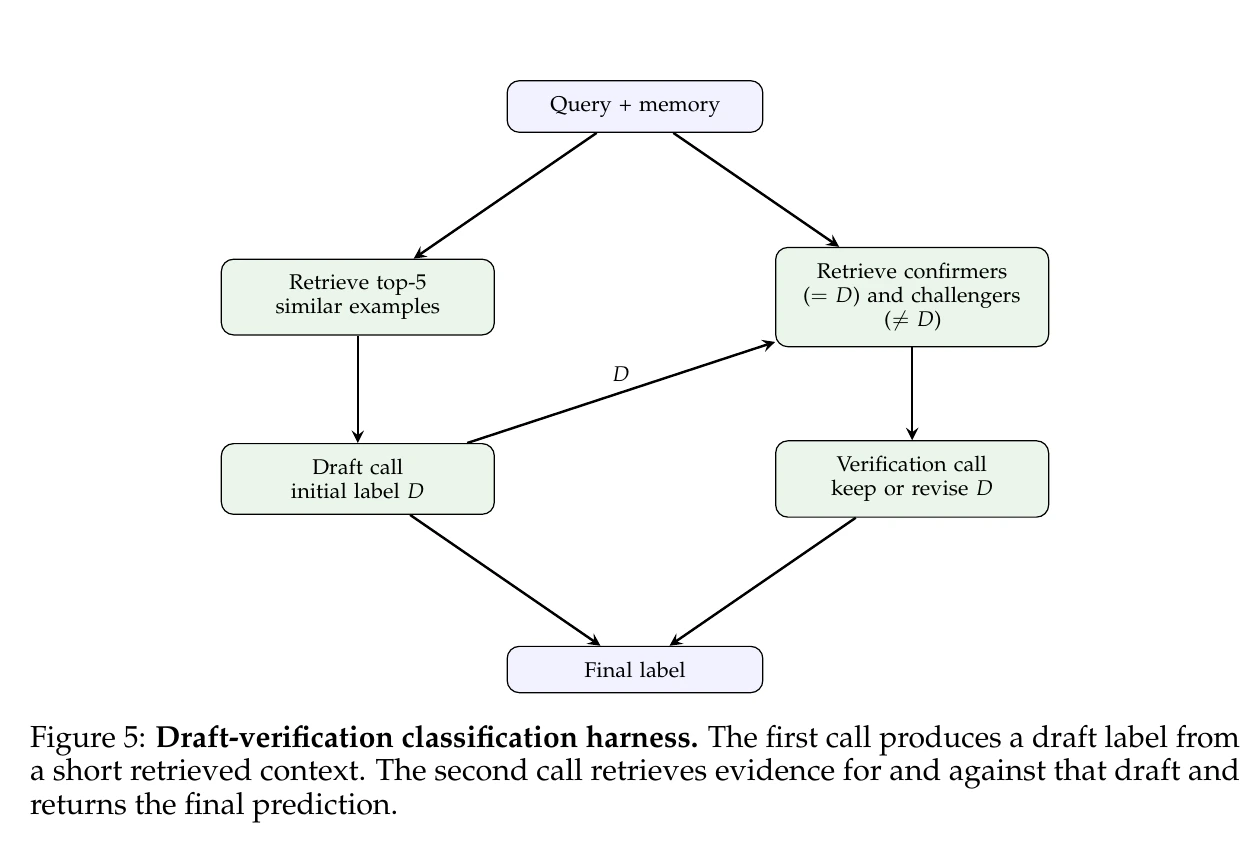
成本较低的 Draft Verification 先检索 5 条最相似的带标签样例,让模型给出草稿标签;再根据这个标签检索 5 条同标签例子和 5 条不同标签例子,让同一个模型决定保留还是改答案。这里的 confirmers / challengers 是检索出的数据行,不是十个额外模型。历史不足 5 条时,它退回一次普通带示例调用。Table 9 中,这个程序平均准确率 40.1%,额外输入约 5.4K 字符。
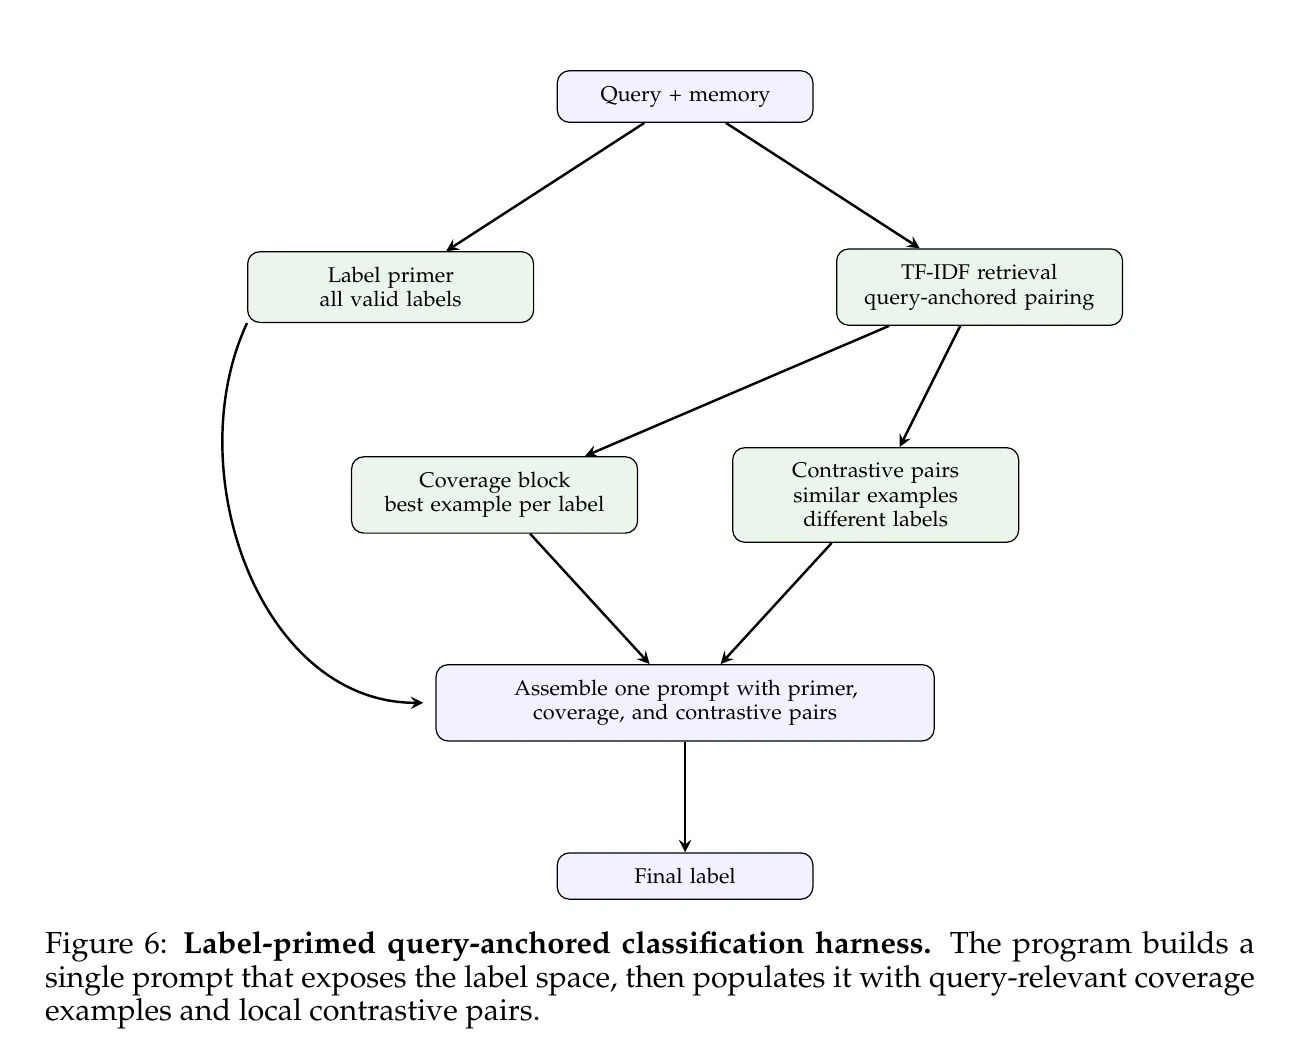
主结果用的是准确率较高的 Label-Primed Query:一次较长调用里先列出全部合法标签,再为每个已知标签放一条与当前问题最相关的历史例子,最后把相似但标签不同的局部例子成对排列。程序用 TF-IDF(一种按词项统计计算文本相似度的方法)选取例子。模型同时看到答案范围、各类代表和容易混淆的区别。
九个搜索未用过的数据集(论文称 OOD datasets,指这里的跨数据集评测)上,平均准确率为 73.1%,ACE 为 70.2%;Meta-Harness 在 6/9 个数据集上最好。
这里有一个原论文没有解释的记账冲突:Table 2 把 context 标成 tokens,Figure 3 和 Appendix Table 9 却写 characters。 因而“11.4K vs 50.8K”可以安全地视为论文内部同表比较,但不能把图表的横轴单位无条件当成 token 精确换算。
发布的分类目录是整理后的参考实现:默认用 API 调 GPT-OSS-120B、只初始化 no_memory 和 fewshot_all 两个基线,配置还有单一 seed 42 等设置;论文搜索则初始化零样例、带样例、ACE 和 MCE 四类程序,使用本地 vLLM 模型。不能把仓库默认配置当成 Tables 2–4 的完整复现包。
4.2 数学:怎样选示例比是否检索更重要
数学搜索用 GPT-OSS-20B 在 250 道奥赛难度题上跑 40 轮,产生 109 个候选。最终程序先按关键词和正则表达式把当前题分到组合、几何、数论、代数/其他之一,只运行被选中的一路,不汇总四路答案。BM25 是按词项匹配程度排序的文本检索方法;这里还保留 LaTeX 片段作为词项。
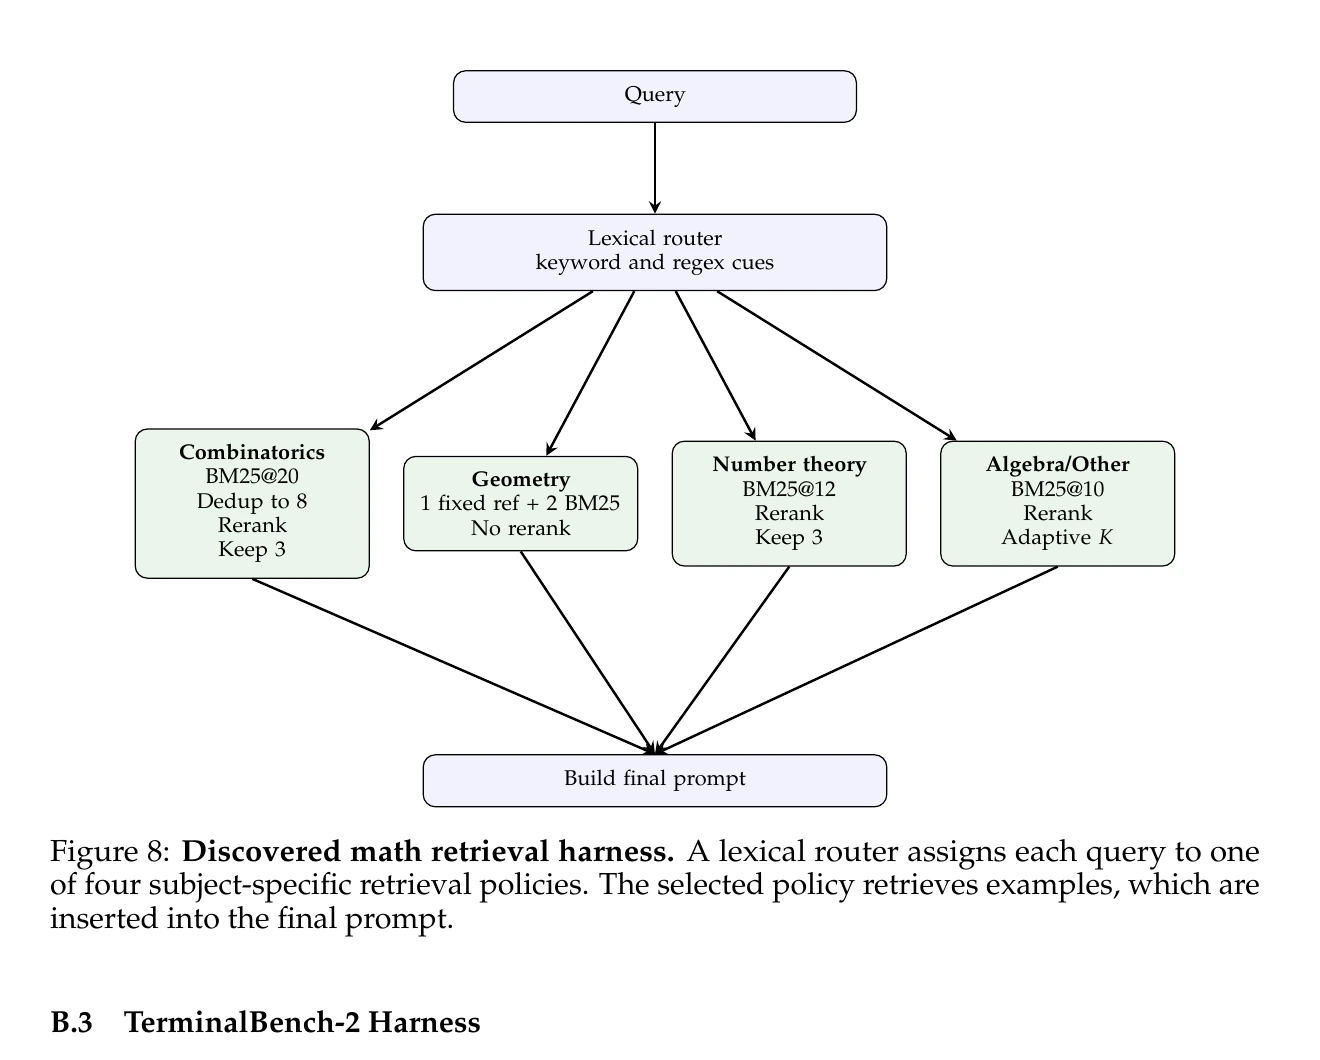
四路的具体差别是:组合题先取 20 个候选、去重至 8 个,按词项分数与难度重排后取 3 个;几何题放 1 条较难的 NuminaMath 参考解与 2 条原始 BM25 近邻;数论题取 12 个候选,除相似度和难度外,给较早交代解法的例子小额加分;默认路线取 10 个候选,重排后根据高分候选是否集中调整例子数。题型规则、分数项和例子数都是搜索产物,不是作者事后手写四个专家模型。
检索库由八个公开数据集合成,共 535,356 题。作者过滤部分来源、对同题多解去重,并用前缀匹配与 Jaccard 相似度阈值 0.8 排除与搜索题、测试题相似的条目。运行时只检索非空且短于 4,000 字符的解,放入提示时再截到 3,000 字符。这是字符串层面的去重检查,不足以证明改写后的相似题绝无泄漏。
最终 200 道题由 IMO-AnswerBench 100 题、IMO-ProofBench 60 题、ArXivMath 2025 年 12 月 17 题和 2026 年 1 月 23 题组成,包含答案题、证明题和研究风格题。每题采样三次后平均计 pass@1,不是三次有一次答对就整题得分。No Retriever 平均 34.1%,固定 BM25 为 37.5%,Meta-Harness 为 38.8%。五个模型列都比无检索高,平均提升 4.7 pp。
与最强固定检索的差距小得多:Dense Retrieval(5 条例子)平均 38.1%,只低 0.7 pp;Gemini-3.1-Flash-Lite 上它反而是 37.1%,高于 Meta-Harness 的 34.9%,Gemini-3-Flash 上也是 47.2% 高于 46.3%。因此,“每个模型都比无检索好”成立,“每个模型都胜过其他检索方法”不成立。
公开参考仓库与项目页没有提供这组数学语料、逐题模型回复和完整数学判分器。论文引用既有评测协议,但没有交代各类证明怎样转换为二值结果、判分模型和提示。本文能复算表中均值,不能据此展示一个可复现的官方证明题 PASS / FAIL。
不过论文把它写成“five held-out models”略显宽松:GPT-OSS-20B 同时参与搜索选程序和最终测试;未参与搜索的基础模型是 GPT-5.4-nano、GPT-5.4-mini、Gemini-3.1-Flash-Lite 与 Gemini-3-Flash 四个。更准确的结论是:harness 在未见题上有效,并迁移到了四个未见模型。
4.3 TerminalBench-2:强结果,但不是独立任务泛化
这组实验从 Terminus 2 与 Terminus-KIRA 出发,在 TerminalBench-2 的全部 89 个公开任务上搜索;最终也在同一 89 题上评测。作者把它明确称为在公开测试任务上发现程序的实验。人工与正则表达式检查代码是否写入特定题目字符串,但没有另留独立任务。
官方实验材料报告 Claude Opus 4.6 上 89 题 × 5 次尝试 = 445 次尝试,总体通过率 76.4%;论文中的 Terminus-KIRA 是 74.7%。每次尝试的通过由任务自身的测试程序判定,模型自述“完成”不算通过;先对各题五次结果平均,再平均 89 题,等价于平均这 445 次二值结果。这里不是五次有一次通过就计整题成功。搜索日志的 64.4、58.9、63.3 是搜索阶段分数,不应直接当成最终五次评测值。按难度分层,Easy 4 题为 100.0%,Medium 55 题为 81.1%,Hard 30 题为 64.7%。在 Claude Haiku 4.5 上,Meta-Harness 为 37.6%,高于当时列出的 Goose 35.5%。
因此这组结果能支持“自动搜索可以在一个公开、竞争激烈的 benchmark 上找到比强手写 harness 更好的实现”,不能单独支持“这段环境预先查询代码对未见终端任务也有相同增益”。
5. Discussion:应复用的历史记录与验收规则
改完整执行程序时,历史记录必须能查回具体操作。 诊断通常要一起看旧代码、命令输出、工具返回、超时和测试日志。目录、稳定文件名和检索脚本也影响提案模型能否找到原因。
Proposer 写候选,外层决定接口验证、任务划分、超时处理、评分、候选保留和最终测试。修改者自己的“已经修好”不能代替验收结果。
失败版本也值得保留。TerminalBench 前六轮留下了提示和结束条件改动带来的退步,第七轮才有依据避开这些修改。后续提案可以对照旧代码核查这个判断。
泛化证据需要写清测试对象。未见样本、未见任务/数据集、未见模型、未见评测接口回答的是不同问题。本文三个领域分别覆盖不同部分;搜索任务与最终任务重合时,不能用“没有硬编码题名”代替未见任务测试。
可补的对照:分别优化 Claude Code、Codex CLI 和简化 ReAct,在独立搜索集上选择候选,再交叉测试未见任务与执行接口。这样才能检验环境信息策略能否普遍复用,而不是只适合某个运行程序。
6. Conclusion:能支持的结论与仍缺的对照
Meta-Harness 让代码 Agent 根据历次源码与执行记录修改程序,再用外部评测选择候选。 分数、摘要与原始记录的消融说明,读取完整记录确实影响搜索结果。TerminalBench 第 1 到 7 轮还展示了提案模型怎样从失败版本中缩小修改范围。
但结论需要收窄:
我的最终判断是:Meta-Harness 的消融支持保留原始执行历史比只给分数或摘要更有效;它还没有证明同一搜索方法能自动产出跨任务基准的通用执行程序。 对准备研究 Claude Code、Codex 等完整系统的人,这两句话都很重要:前一句给出可复用方法,后一句规定下一篇论文该补的实验。
来源说明:论文为 CC BY 4.0,本文复用的原图均在图注标明 Figure 编号。代码行为核查基于官方 meta-harness revision 0cbc31e 与 meta-harness-tbench2-artifact revision 57fefdb;代码库自述为整理后发布的版本,本文没有把它等同于完整训练日志。
留言