META-HARNESS · 论文图解arXiv:2603.28052v1 · 2026-03-30

让 Claude Code 看完整历史,再改模型外的执行程序

保存历次候选的代码、分数和原始执行记录;提案模型自己查错和改代码,基础模型权重始终不更新。

1 · Claude Code 读历史,写出新候选用文件搜索和脚本查旧代码及原始记录,不必先把所有失败压成一份摘要。
2 · 独立程序检查接口、执行任务、计分候选提出者不能自己决定评测结果;每个候选的源码、分数和记录再进入下一轮历史。
分类、数学、终端结果要分开读分类准确率 48.6%;奥赛数学 38.8%;TerminalBench-2 上 Opus 4.6 为 76.4%。终端搜索与终测使用同一批 89 道公开任务。

博客作者兴趣度 9.6 / 10:完整 harness 自动工程化。Harness 指包在基础模型外的提示构造、记忆、检索和调用程序。

TerminalBench-2 · 同一批 89 道公开题
Opus 4.6 · Meta-Harness76.4%
Opus 4.6 · Terminus-KIRA74.7%
Haiku 4.5 · Meta-Harness37.6%
Haiku 4.5 · Goose35.5%

原论文 Figure 1,CC BY 4.0。查看完整原图;终端搜索与终测用的是同一批任务。
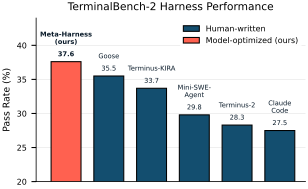
原论文 Figure 1 的 TerminalBench-2 执行系统成绩,Opus 4.6 为 76.4%

原论文 Figure 1(CC BY 4.0)。终端实验不是独立保留题上的泛化成绩。

标题:Meta-Harness: End-to-End Optimization of Model Harnesses
02 · 优化对象模型权重始终冻结

Harness 包含系统提示,也包含围绕模型运行的程序

保存状态

存什么

记忆、历史样例、环境状态与中间结果。

检索规则

取什么

检索规则、路由、去重、排序和输入长度限制。

调用流程

何时交给模型

构造提示、执行工具、检查完成状态和重试。

来源:论文 §1、§3。搜索目标是执行程序代码;被调用的基础模型固定。
03 · 搜索循环提案 → 检查代码 → 评测 → 保存记录

提案模型写候选代码;外层程序控制验证、计分和版本选择

1 · 保存历史文件系统保留每个候选的代码、搜索分数和原始执行记录。
2 · 提案模型选读并改写Claude Code 自己检索相关文件,写出一个新 harness;基础模型权重不变。
3 · 外层程序独立评测检查候选接口,运行任务,产生分数与新的执行记录。
4 · 记录并继续搜索新候选回到文件系统;前沿保留准确率与成本互不全面胜出的程序。

原论文 Figure 2 可左右滑动查看完整流程
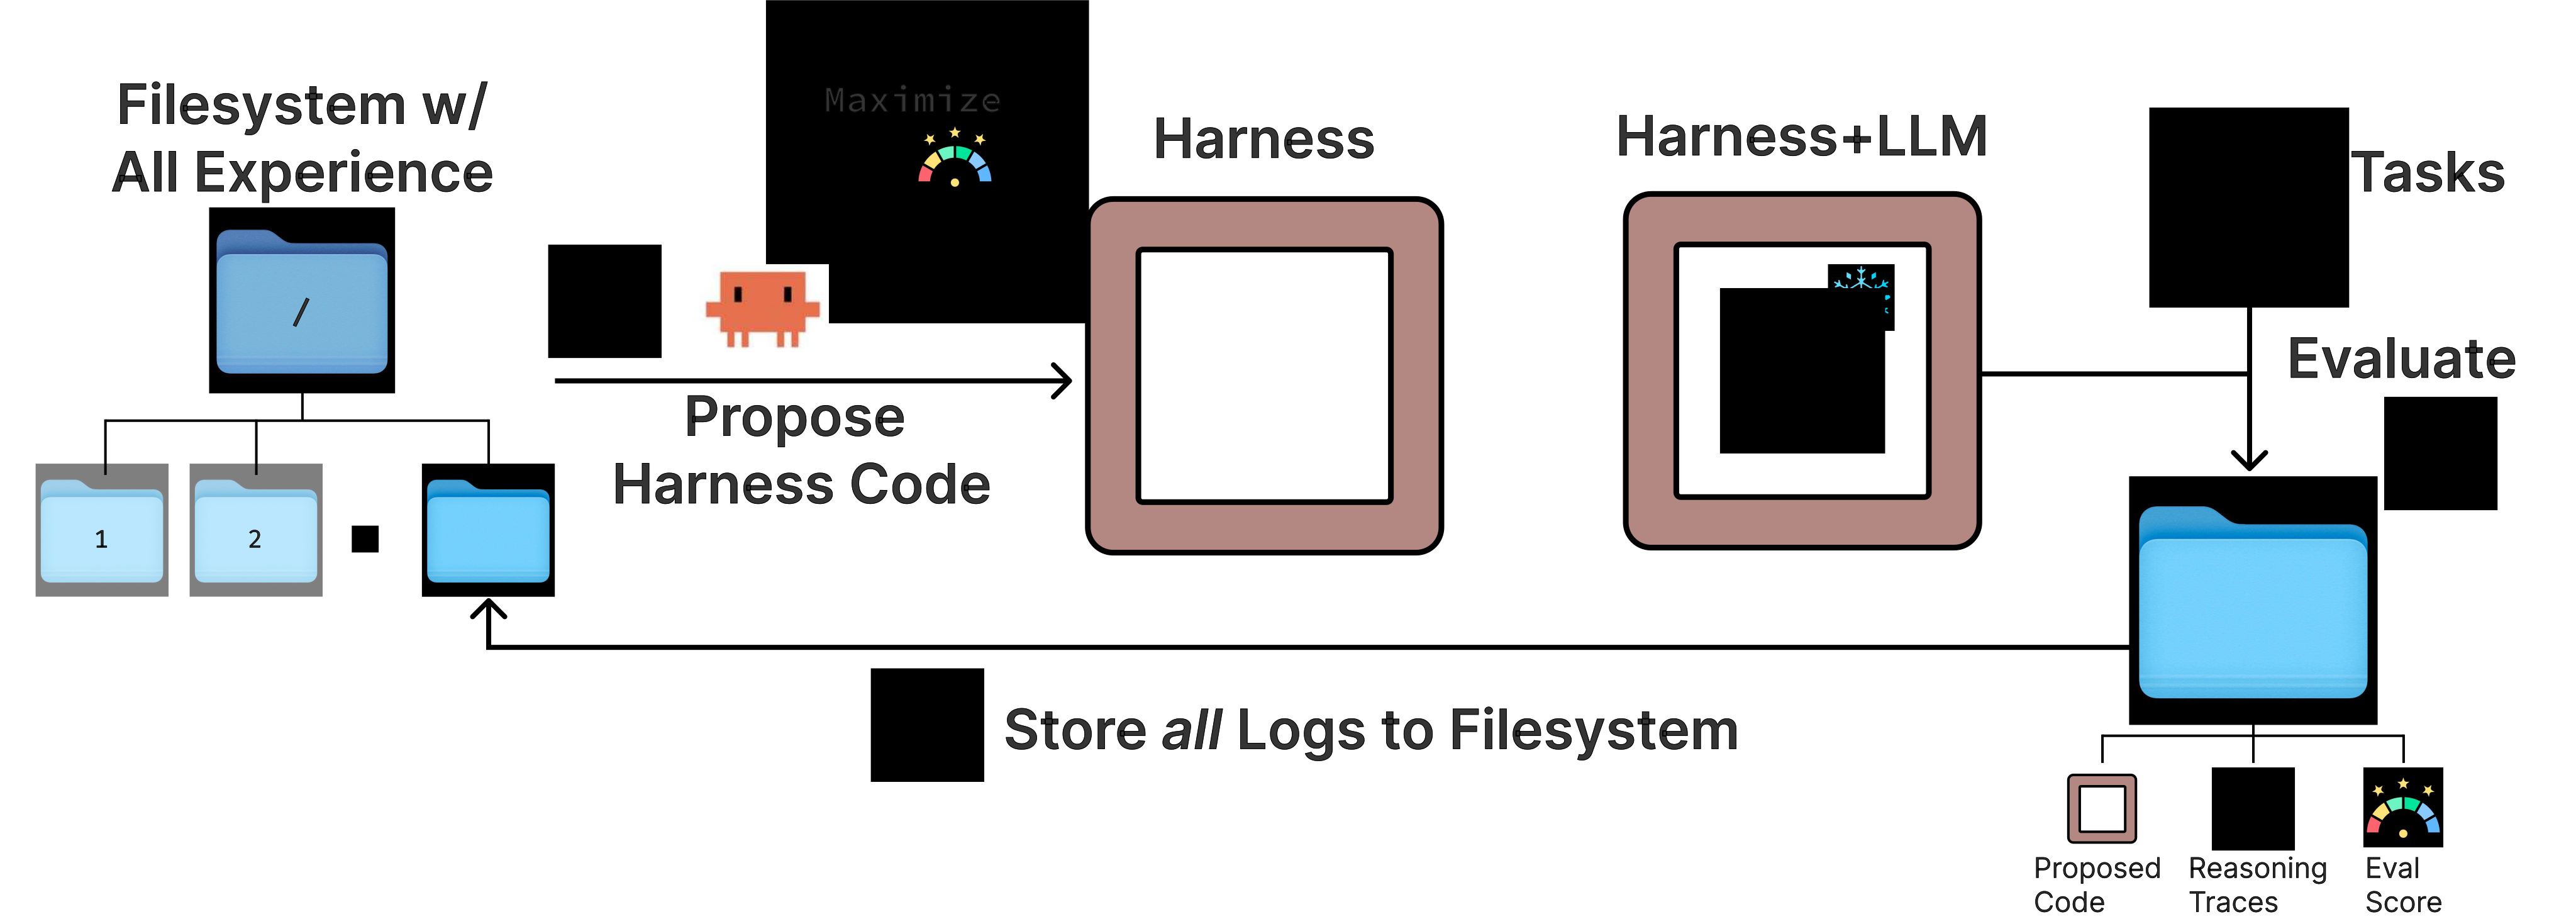
Meta-Harness search loop
原论文 Figure 2,CC BY 4.0。每个候选的代码、分数、执行记录 都进入下一轮可检索文件系统。
04 · 诊断材料可用记录量与实际模型输入不同

一次评测可产生约 1,000 万 tokens 的记录,提案模型只读取其中相关部分

压缩后的反馈

先替提案模型筛选历史

只看分数会丢掉执行细节;摘要压缩多次失败;近期窗口舍弃早期候选。

如果真正的错误来自十轮前的提示变化,相关记录可能在提案模型读到前就被删掉。

META-HARNESS

把历史变成外部工作区

Claude Code 自己用 grep、cat 和脚本选择要读的代码、分数与原始记录。

TerminalBench 搜索中,每轮读取文件数的中位数是 82;源码占 41%,执行记录占 40%。

来源:Tables 1、8。1,000 万是作者估算的最重评测材料量,不是一次输入长度或统一预算对照。
05 · 邻近路线改什么 · 看什么反馈 · 谁负责更新

提案模型能检索历次代码与原始记录,不必只读摘要

路线改什么提案模型看什么与 Meta-Harness 的边界
GEPA提示或其他文本产物一个候选的执行反馈或摘要反馈较丰富,但不保留所有候选的原始记录。
AlphaEvolve / OpenEvolve指定函数或程序历史程序与汇总分数搜索代码;可读到的原始排错记录较少。
TTT-Discover推理时产生的程序等产物近期窗口;PUCT 优先复用高分且少访问的候选搜索规则不同;提案输入受预设结构限制。
ACE / MCE记忆与自然语言技能描述在线样例与反思用作待优化执行程序的基线,不是通用代码优化器。
HarnessForge / Co-Harness执行程序与模型权重失败归因与成功轨迹共同优化模型与程序的配合;本文只改程序。
GEPA · 改提示与文本

提案者读取单个候选的执行反馈或摘要;原始记录不会作为全部候选的历史供它自由检索。

AlphaEvolve / OpenEvolve · 搜索代码

可看历史程序与汇总分数;原始排错记录较少。

TTT-Discover · 推理时搜索

读取近期窗口,用 PUCT 复用高分且少访问的候选;输入受预设结构限制。

ACE / MCE · 改记忆与技能文本

利用在线样例与反思;本文将其作为分类任务中的执行程序基线。

HarnessForge / Co-Harness · 程序与模型共同优化

利用失败归因与成功轨迹;Meta-Harness 只改模型外程序,基础模型权重保持冻结。

来源:论文 §2、Appendix F;HarnessForge arXiv:2606.01779;Co-Harness arXiv:2607.22688。
06 · 原始记录消融相同分类搜索设置

去掉原始执行记录后,最优候选也低于完整历史组的中位数

只看代码与分数
34.6 / 41.3

候选准确率的中位数 / 最高值;可看代码和分数,不能看执行记录。

再加摘要
34.9 / 38.7

加入模型生成的摘要,仍低于完整记录组。

完整历史
50.0 / 56.7

代码、分数与原始执行记录。

来源:论文 Table 3。这里是搜索集上候选的分数分布,不是独立最终测试成绩。
07 · 分类搜索40 个候选 · 3 个搜索数据集

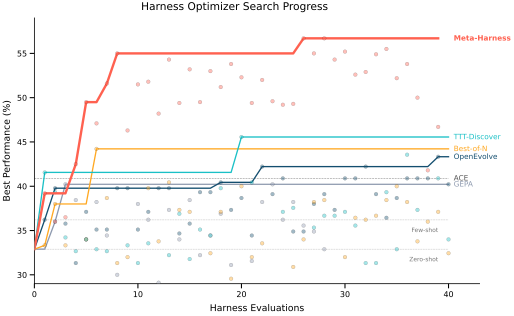
四次评测追平其他优化器的最终水平,40 次后拉开十余点
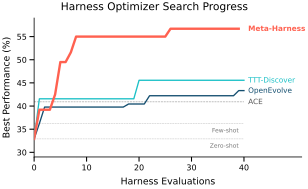
Harness optimizer search progress
Figure 1 左:历次候选最高搜索准确率
Search curves across optimizers
Figure 4:各候选分数与历次最高分曲线
原论文 Figures 1、4,CC BY 4.0。比较使用同一 Opus 4.6 提案模型与相同候选评测次数。
08 · 分类测试不参与候选选择的测试题

平均准确率 48.6%,比 ACE 高 7.7 个百分点;输入约四分之一
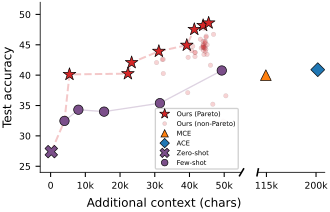
Accuracy versus context Pareto frontier
Meta-Harness准确率 48.6%;Table 2 报输入长度 11.4K。
ACE准确率 40.9%;输入长度 50.8K。
单位冲突Table 2 写 tokens;Figure 3 与 Appendix Table 9 写 characters。论文未解释换算,不能把两者混用。
原论文 Figure 3,CC BY 4.0;Table 2、Appendix Table 9。
09 · 搜索得到的程序检索与提示构造方式各不相同

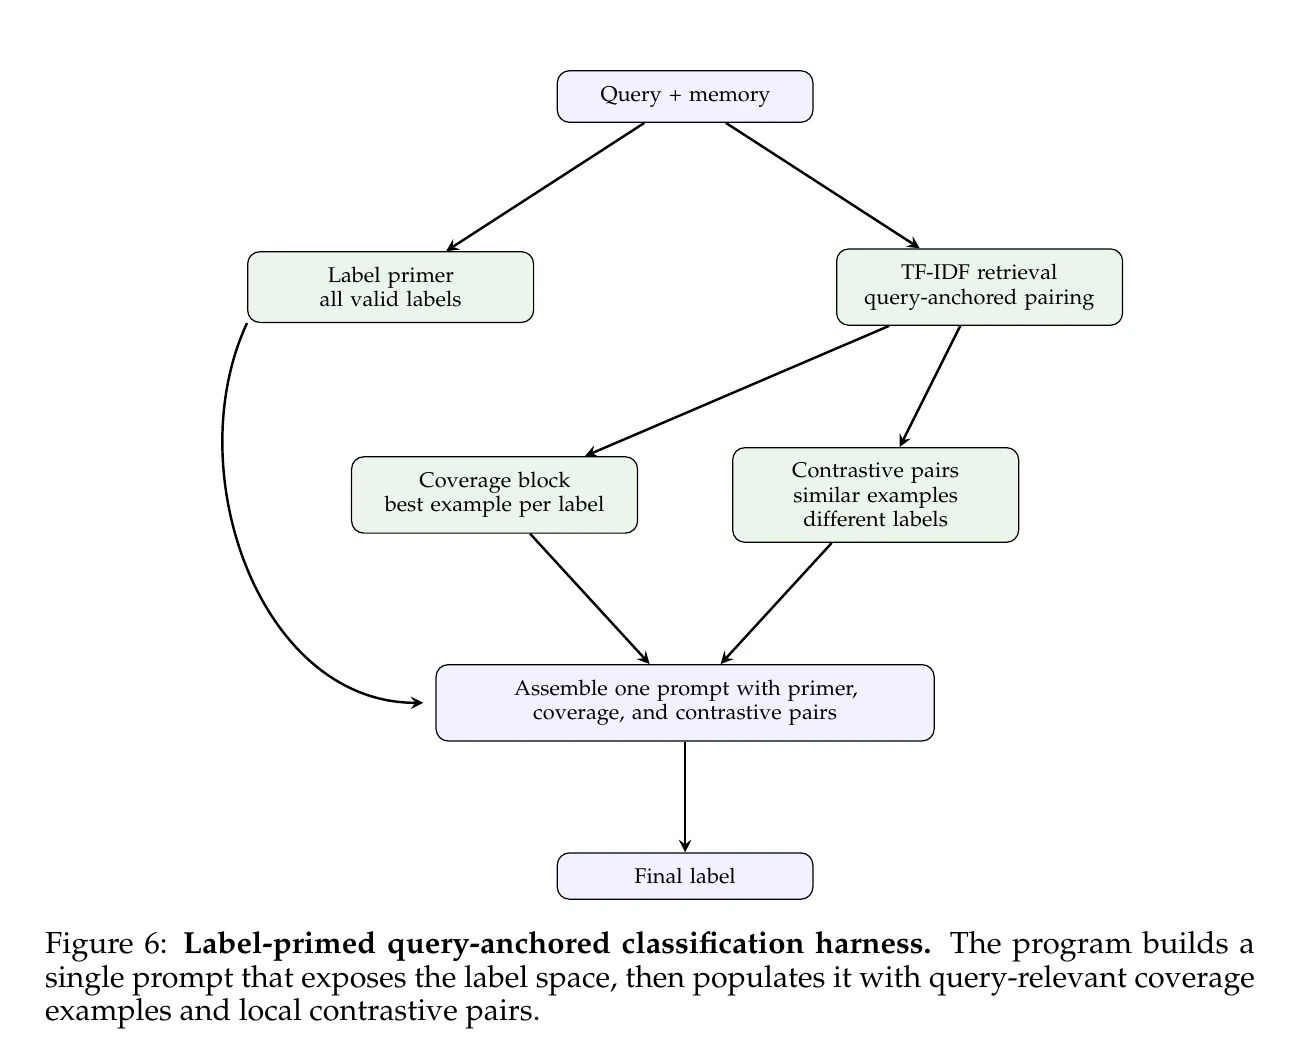
搜索得到的是不同检索与提示构造程序

Figure 5 · 两次模型调用先取 5 个近邻给出草稿标签,再取同标签和异标签样例验证草稿;不足 5 条时改为单次调用。
Figure 6 · 一次模型调用把合法标签、类别覆盖与相近异标签对照组装成一个提示;论文最终 48.6% 的分类系统使用这一版。
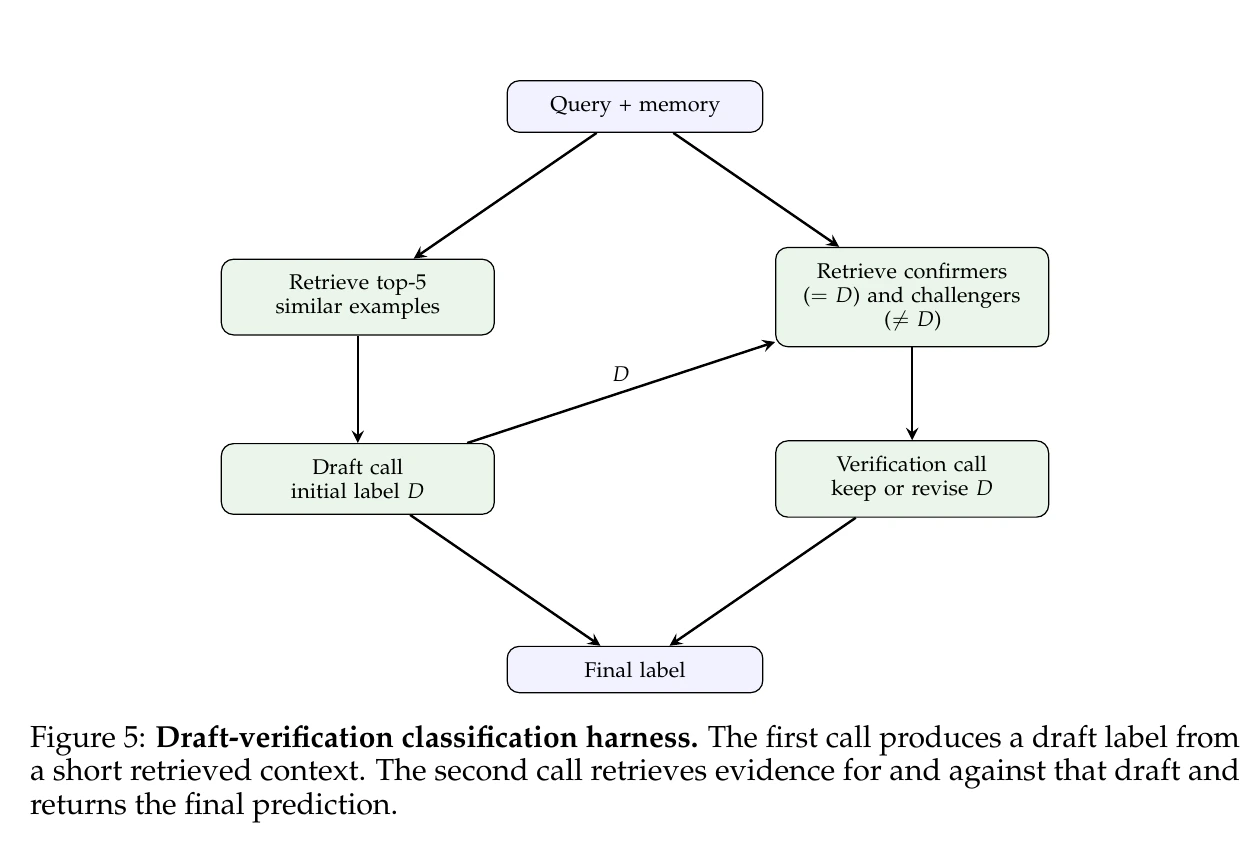
Draft-verification harness
Figure 5:先拟定分类,再检索支持与反对它的样例
Label-primed query-anchored harness
Figure 6:标签说明、类别覆盖和相近样例对比
Figure 5:5 个近邻→草稿→5 条同标签与 5 条异标签样例;不足 5 条则单次调用。48.6% 系统采用右侧 Figure 6。
10 · 数据划分分类实验的证据范围

候选按搜索集分数选,最终测试在选择后才运行
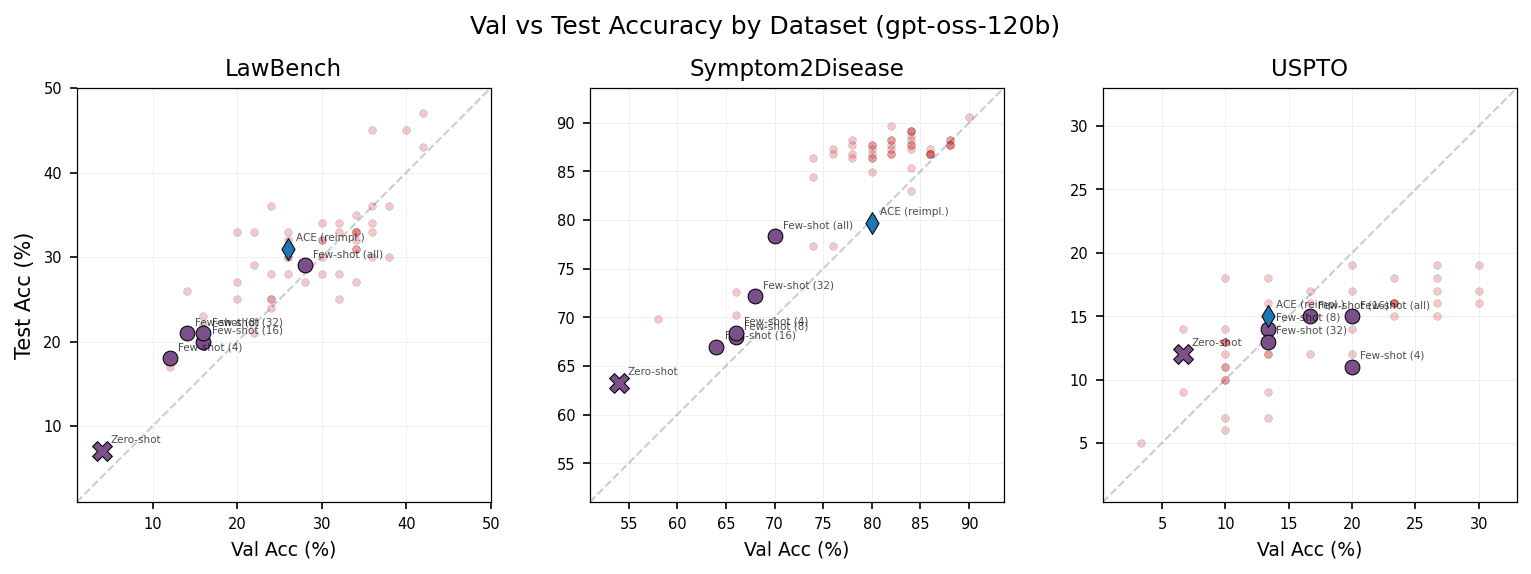
Search versus test accuracy
论文协议提案模型不看测试分数;从准确率与输入长度的折中候选中选定后,才做最终测试。
公开代码meta_harness.py 将验证集演化与显式 --test 最终测试分开。
但不是访问控制公开仓库含测试数据;隔离依赖运行流程,不是文件权限。
原论文 Figure 7;论文 §3;官方 repo revision 0cbc31e。
11 · 真实分类题meta-harness@0cbc31e

症状分类比较的是标准疾病标签,不是模型自述“诊断合理”

发布测试集第一行

I have a burning sensation in my stomach that comes and goes. It's worse when I eat and when I lie down. I also have heartburn and indigestion.

当前输入是症状文本;标准标签 peptic ulcer disease 用于计分。

提取答案 → 归一化 → 精确匹配

JSON final_answer 或 [DIAGNOSIS] 内容转小写、整理空白、去掉末尾标点。

说明输出 A:Peptic ulcer disease. → 相同 → 1。

说明输出 B:gastritis → 不同 → 0。

数据集准确率 = 答对数 / 样例数;Table 2 等权平均三个数据集。

data/symptom_diagnosis/test.jsonl:1;data/evaluators.py:79–99。A/B 是本文说明输出,非模型记录;数据标签不是医疗建议。
12 · 数学检索250 道搜索题 · 200 道未见测试题

同一个 BM25 检索器,搜索得到四种按题型选择证据的策略
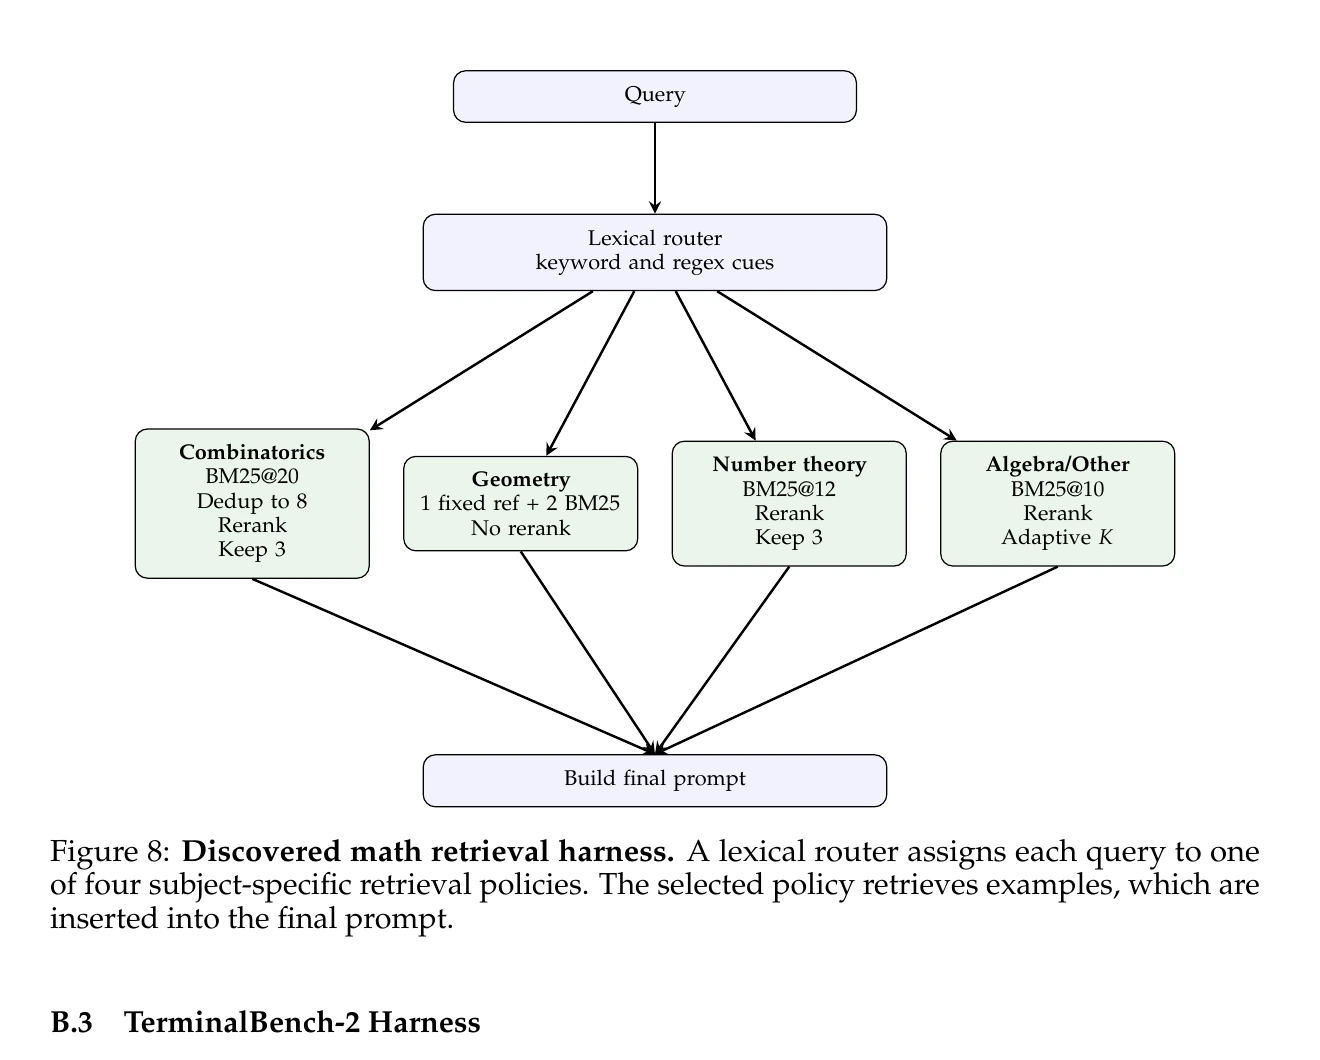
Discovered math retrieval harness
搜索阶段GPT-OSS-20B 在 250 题上挑选 109 个候选中的最终 harness。
最终测试200 道未见题,包含答案题、证明题和研究风格题;每题三次采样。
精确说法GPT-OSS-20B 既参与搜索又参与测试;另外四个模型才未参与搜索。
原论文 Figure 8,CC BY 4.0;§4.2、Appendix C.2–C.3。
13 · 数学结果pass@1:每题三次采样结果平均

38.8% 平均准确率,比无检索高 4.7 个百分点;五列都上涨

HarnessGPT-5.4 nanoGPT-5.4 miniGemini 3.1 FLGemini 3 FlashGPT-OSS-20BAvg
No Retriever23.028.828.642.647.634.1
Dense Retrieval (5)31.128.337.147.246.738.1
BM2530.229.232.846.648.937.5
Meta-Harness31.730.434.946.350.638.8
测试模型无检索Meta
GPT-5.4 nano23.031.7
GPT-5.4 mini28.830.4
Gemini 3.1 FL28.634.9
Gemini 3 Flash42.646.3
GPT-OSS-20B47.650.6
五列平均34.138.8

最强固定策略 Dense Retrieval 的平均分是 38.1;在 Gemini 3.1 FL 和 Gemini 3 Flash 两列,它的 37.1、47.2 都高于 Meta-Harness 的 34.9、46.3。完整四组数字见原论文 Table 6。

Table 6:相比最强固定检索平均仅 +0.7 pp,两列落后;每题三次结果平均,不是任一次答对。完整数学 judge 未发布。
14 · 同题搜索搜索和最终计分使用同一批 89 道公开题

TerminalBench-2 在同一批公开题上搜索与计分,不是独立题目泛化实验

搜索

89 道公开任务

候选用同一整套任务获得反馈;起点为 Terminus 2 与 Terminus-KIRA。

核查

人工与正则检查

检查代码是否写入特定题目的字符串;没有另留独立任务集。

终测

89 题 × 5 次尝试

官方 artifact 的 76.4% 是 445 次尝试的汇总。

来源:论文 §4.3;官方 TerminalBench artifact README revision 57fefdb。
15 · 第 1 到 7 轮对照历次修改与搜索分数

前六轮未超过起点;第七轮不再改控制循环,转而增加环境信息

起点64.4%Terminus-KIRA 搜索分数。
第 1 轮58.9%终端标记修复、重复循环处理与提示清理同时改。
第 2 轮57.8%完成检查改了,仍沿用同一套提示。
第 3 轮63.3%发现多种改动混在一起,只保留结构修复。
第 4 到 6 轮仍退步完成流程、提示和等待规则的修改仍未见改善。
第 7 轮换策略不改循环,只在首次模型调用前加入环境快照。
修改范围只加信息提供环境信息,同时不触碰已经验证的控制顺序。
来源:论文 Appendix A.2。这些是搜索阶段分数,不能与最终五次尝试汇总的 76.4% 混用。
16 · 公开代码agent.py · revision 57fefdb

_gather_env_snapshot() 在 Agent 开始前一次性查询隔离环境

# _gather_env_snapshot 内:省略前面的命令构造与后面的输出解析
try:
    result = await asyncio.wait_for(
        env.exec(command=bootstrap_cmd, timeout_sec=15),
        timeout=20,
    )
except Exception:
    return ""

# 以下另摘自 _run_agent_loop;并非与上面连续的代码
try:
    snapshot = await self._gather_env_snapshot()
    if snapshot:
        initial_prompt = f"{initial_prompt}\n\n{snapshot}"
except Exception:
    pass
实际代码节选:agent.py:904–910、985–992,revision 57fefdb;依赖 Harbor 环境,不能作为独立脚本运行。
17 · 最终终端程序Terminus-KIRA + 环境查询

首次调用前提供环境信息;节省 2 到 4 轮是作者解释,未单独受控验证
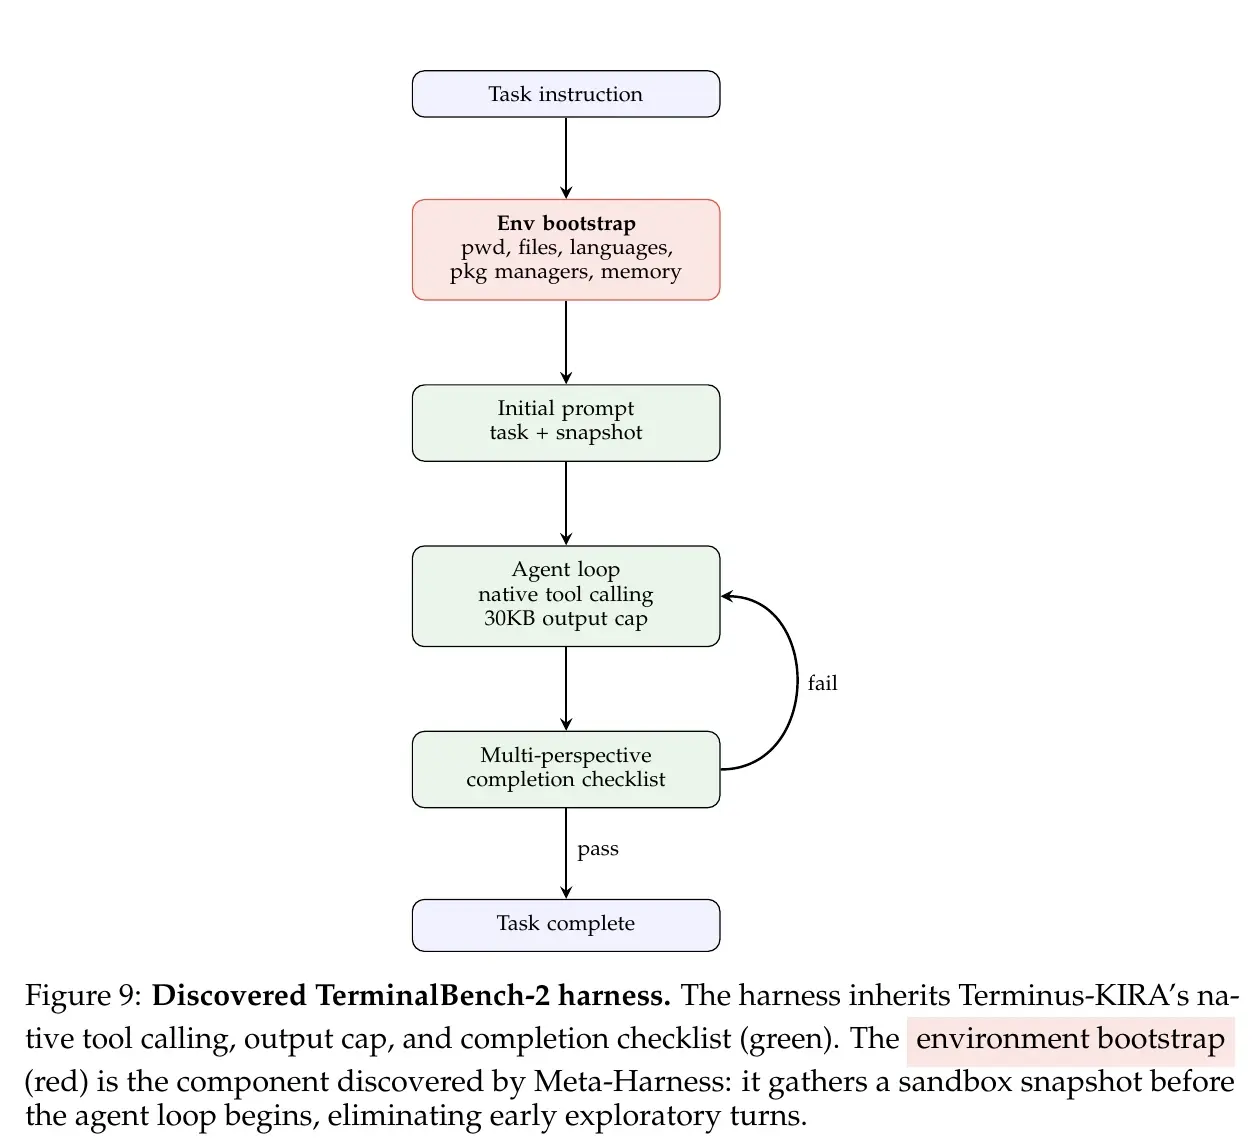
Discovered TerminalBench harness
Claude Opus 4.676.4%;Terminus-KIRA 74.7%。官方 artifact:89 题 × 5 次尝试。
Claude Haiku 4.537.6%;下一名 Goose 35.5%。
改善集中在哪里89 个任务中有 7 个的通过表现改善,最大改善在 protein-assembly 与 path-tracing;不是新增解出 7 道整题。
Figure 9、§4.3、Appendix B.3。公开材料没有逐任务探索调用数的受控对照;原图 CC BY 4.0。
18 · 三组证据每组实验回答不同问题

同一套 Meta-Harness,在三类任务上回答的是三种不同问题

任务搜索反馈未参与搜索的部分可以说什么不能说什么
文本分类3 个数据集的搜索划分原数据集测试题与 9 个其他数据集程序策略能换数据集使用输入长度有 token / 字符单位冲突
数学250 题与 GPT-OSS-20B200 题与另 4 个模型检索策略能换题目与模型使用GPT-OSS-20B 已参与搜索
TerminalBench-2全部 89 道公开题没有独立题目划分同题搜索可超过强手写程序未证明新分布任务的泛化
文本分类 · 换数据集

搜索反馈来自 3 个数据集的搜索划分;原数据集测试题及另外 9 个数据集未参与候选选择。

程序策略可迁移到其他分类数据;输入长度的 token / 字符单位冲突仍未解释。

数学 · 换题目与模型

在 250 题与 GPT-OSS-20B 上搜索;最终用 200 道未见题和另 4 个模型测试。

GPT-OSS-20B 本身参与了搜索,因此五模型均值不能说成五个未见模型。

TerminalBench-2 · 同题搜索

候选用全部 89 道公开题获得反馈,最终也在这 89 题上做五次尝试。

可说同题搜索超过强手写程序,不能据此声称对新任务分布的泛化。

来源:论文 §3–§5、Appendix C;结合官方代码与 artifact 复核。
19 · 结论与限制保留结果,也保留适用范围

可检索的完整历史能改善程序搜索;跨任务基准的泛化仍需验证

已经验证

原始记录有用

提案模型读原始记录、写代码;外层程序检查导入、跑评测、记录候选,并在选定后做最终测试。

搜索产物可检查,也能换基础模型测试。

尚未验证

泛化与归因仍不完整

只研究 Claude Code + Opus 4.6 提案模型;TerminalBench 没有独立题目;开源仓库是整理后的版本,仅确认能运行。

还需比较不同提案模型、独立测试任务、搜索成本与代码复杂度。

核心结论1 / 19